- 每一块 = 老师 PDF 的一页,标题旁蓝色胶囊是页码;每块开头可展开原页截图,插图页默认展开。
- 正文是逐句对照:蓝灰色衬线字是西语原句,下面带「中」标签的是逐句翻译,一句不漏。
- 句子后面紧跟「考点 / 陷阱 / 记忆钩子」,告诉你这句在 SIELE 式西语答题和专业课考试里怎么用。
- 带虚下划线的西语词,鼠标悬停显示中文;代码高亮行、轨迹表红底行是必考重点。
- 打印时自动隐藏导航、指南与截图,一页一块不切断。
一、导论与实验工具
p.1–p.5Portada · 封面
▸ 原页截图 p.1
Sistemas Concurrentes y de Tiempo Real
并发与实时系统(课程名,缩写 SCTR)。
Grado en Ingeniería Telemática
远程通信工程本科(你的专业名,答题写课程归属时会用到)。
Tema 3: Comunicación y sincronización con memoria compartida. Parte 1. Espera activa
主题 3:基于共享内存的通信与同步。第 1 部分:忙等待(自旋等待)。
Índice de contenidos · 目录
▸ 原页截图 p.2
Índice de contenidos
目录 / 内容索引。
Hebras vs Recursos
线程 vs 资源(谁在干活、谁被使用)。
El problema de los jardines (exclusión mutua)
花园问题(互斥)。
El problema del productor consumidor (condiciones de sincronización)
生产者—消费者问题(同步条件)。
Solución al problema del productor consumidor con espera activa
用忙等待解决生产者—消费者问题。
Solución al problema de la exclusión mutua con espera activa para dos hebras
用忙等待解决两个线程的互斥问题。
El problema de la panadería
面包店问题(Lamport 算法,N ≥ 2)。
Corrección de un programa concurrente
并发程序的正确性。
Justicia
公平性(调度器给不给机会)。
Hebras vs Recursos · 线程与资源
▸ 原页截图 p.3
En un programa concurrente intervienen tres tipos de entidades:
一个并发程序里会出现三类实体:
– Entidades activas: modeladas como hebras
— 活动实体:建模为线程(hebra)。
– Entidades pasivas: son recursos que necesitan las hebras para realizar su trabajo
— 被动实体:是线程为了完成工作而需要的资源。
• Con control de acceso: para acceder a algunos recursos es necesario que se satisfagan ciertas condiciones de seguridad, como por ejemplo la exclusión mutua.
• 带访问控制:访问某些资源必须先满足特定的安全条件,例如互斥。
• Sin control de acceso: recursos a los que se puede acceder en cualquier momento.
• 无访问控制:任何时候都能访问的资源。
Ejemplo Hebras vs Recursos · 图示
▸ 原页截图 p.4(插图页)
Ejemplo Hebras vs Recursos
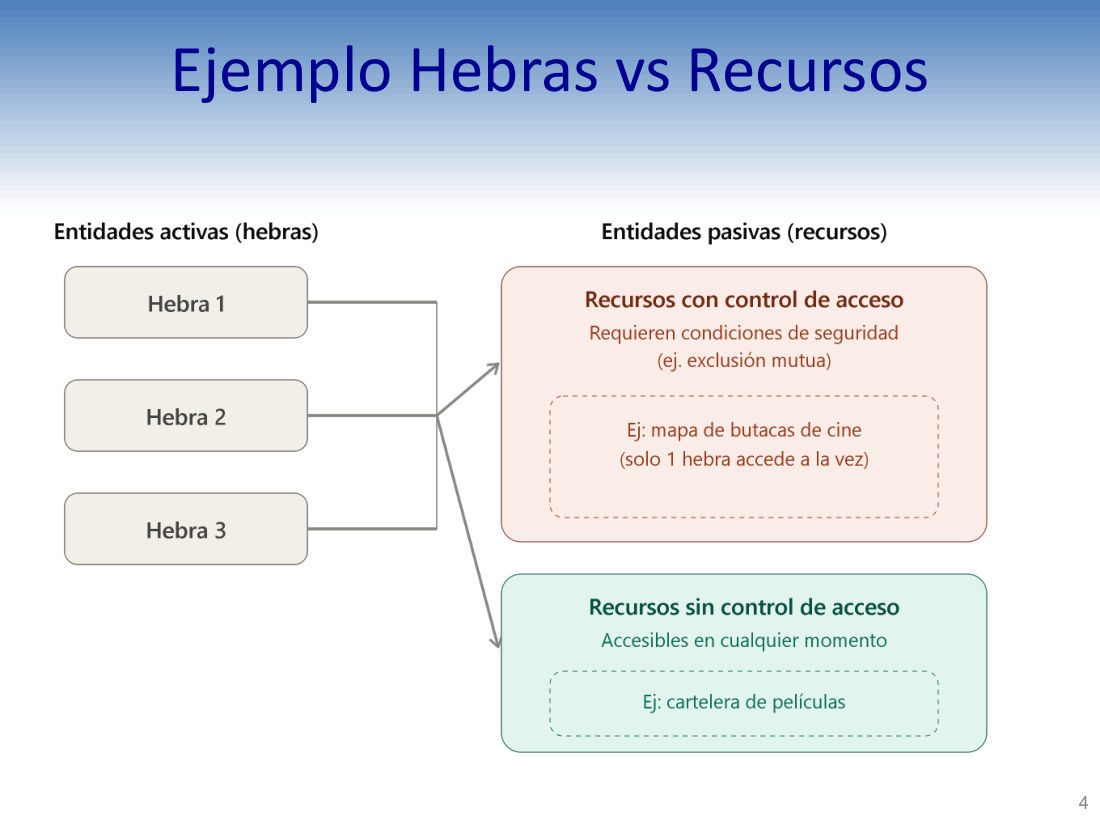
「线程 vs 资源」示例(本页只有一张示意图,没有正文)。
p1 → cont ← p2(箭头方向:hebra 指向 recurso)
两个线程 p1、p2 各自有一条箭头指向共享变量 cont:表示它们都要使用这个资源。
cont
被共享的全局变量,就是「被动实体 = 资源」。
inc() inc()
两个线程各自调用一次自增函数,箭头落在同一个 cont 上 → 冲突点。
taskset · 单核实验环境
▸ 原页截图 p.5
Para probar de forma adecuada los ejercicios de este tema hay que asegurarse de estar utilizando solamente un núcleo/procesador
要正确测试本章的练习,必须确保只用一个核 / 一个处理器。
Para ello tenemos 2 opciones
为此有两种做法:
– Configurar nuestra máquina virtual con un único procesador
— 把虚拟机配置成单处理器。
• En VirtualBox: Configuración / Sistema / Procesador
• 在 VirtualBox 里:设置 / 系统 / 处理器(把 CPU 数量调成 1)。
– Utilizar el comando taskset
— 使用 taskset 命令。
• taskset -c 0 ./nombre_ejecutable
• 把程序绑定到 0 号核上运行。
taskset -c 0 ./programa。原因:多核时两个线程是真并行,p.13–p.17 那种「交叉执行」的轨迹在单核上才稳定复现;绑单核后靠时间片轮转,错误才可重复观察。taskset -c 1 就以为一样——讲义明确是 -c 0(第 0 号核)。虽然功能上等价,但考试按讲义写更稳。二、花园问题:互斥与竞态
p.6–p.17El problema de los jardines · 题目设定
▸ 原页截图 p.6(插图页)
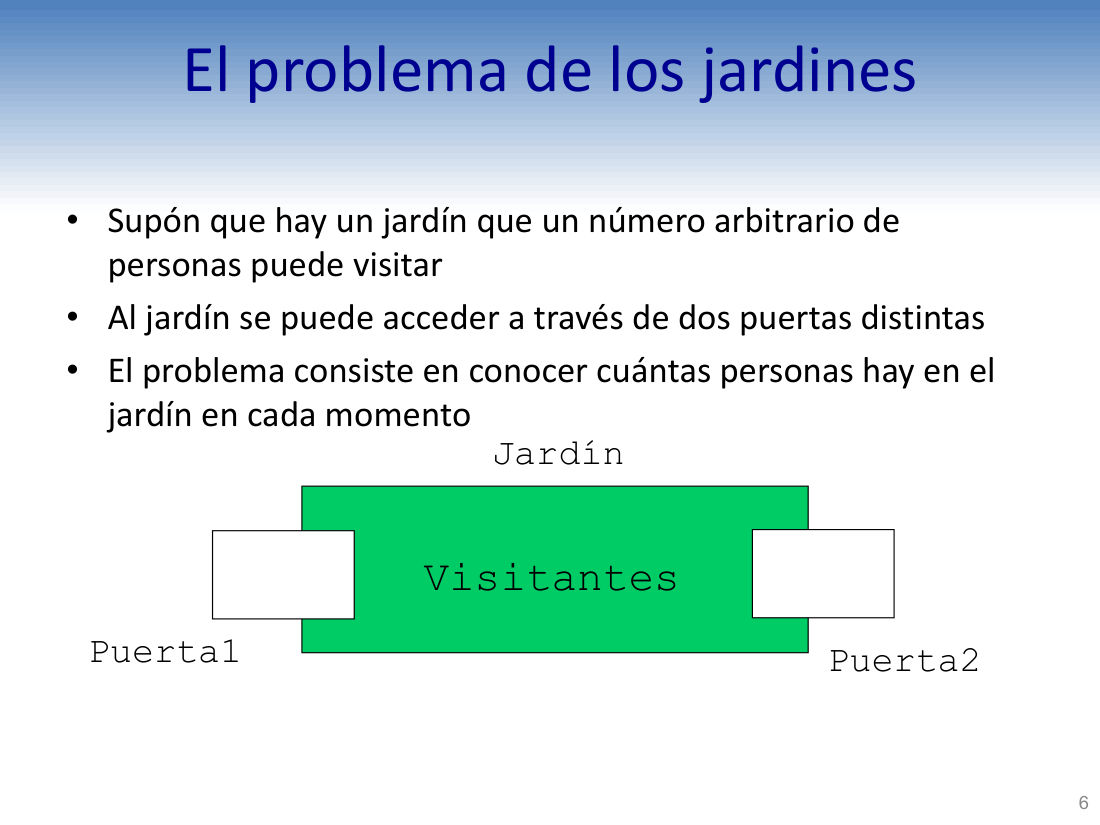
Supón que hay un jardín que un número arbitrario de personas puede visitar
假设有一个花园,任意数量的人都可以参观。
Al jardín se puede acceder a través de dos puertas distintas
花园可以经由两扇不同的门进入。
El problema consiste en conocer cuántas personas hay en el jardín en cada momento
问题在于:要随时知道花园里此刻有多少人。
Jardín · Puerta1 · Puerta2 · Visitantes
图示标签:花园 · 1 号门 · 2 号门 · 参观者。
El problema de los jardines · 建模
▸ 原页截图 p.7(插图页)
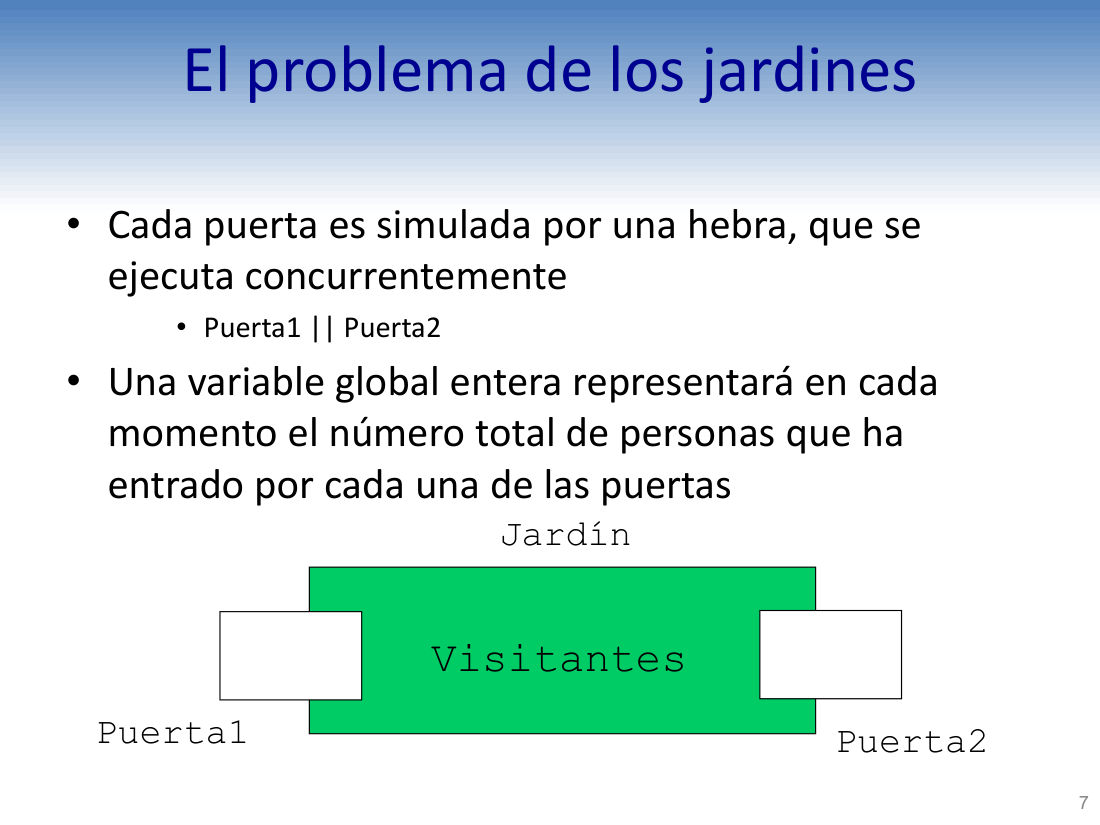
Cada puerta es simulada por una hebra, que se ejecuta concurrentemente
每扇门由一个线程模拟,两个线程并发执行。
Puerta1 || Puerta2
|| 是并发运算符,读作「并行于」:门 1 并行 门 2。
Una variable global entera representará en cada momento el número total de personas que ha entrado por cada una de las puertas
用一个全局整型变量表示「经由各扇门进来的总人数」。
|| 常出现在题干,如 P1 || P2;它的对立面是 ;(顺序执行)。答题时写「Puerta1 || Puerta2」比写「两个线程同时跑」专业得多。El problema de los jardines · 代码 v1
▸ 原页截图 p.8
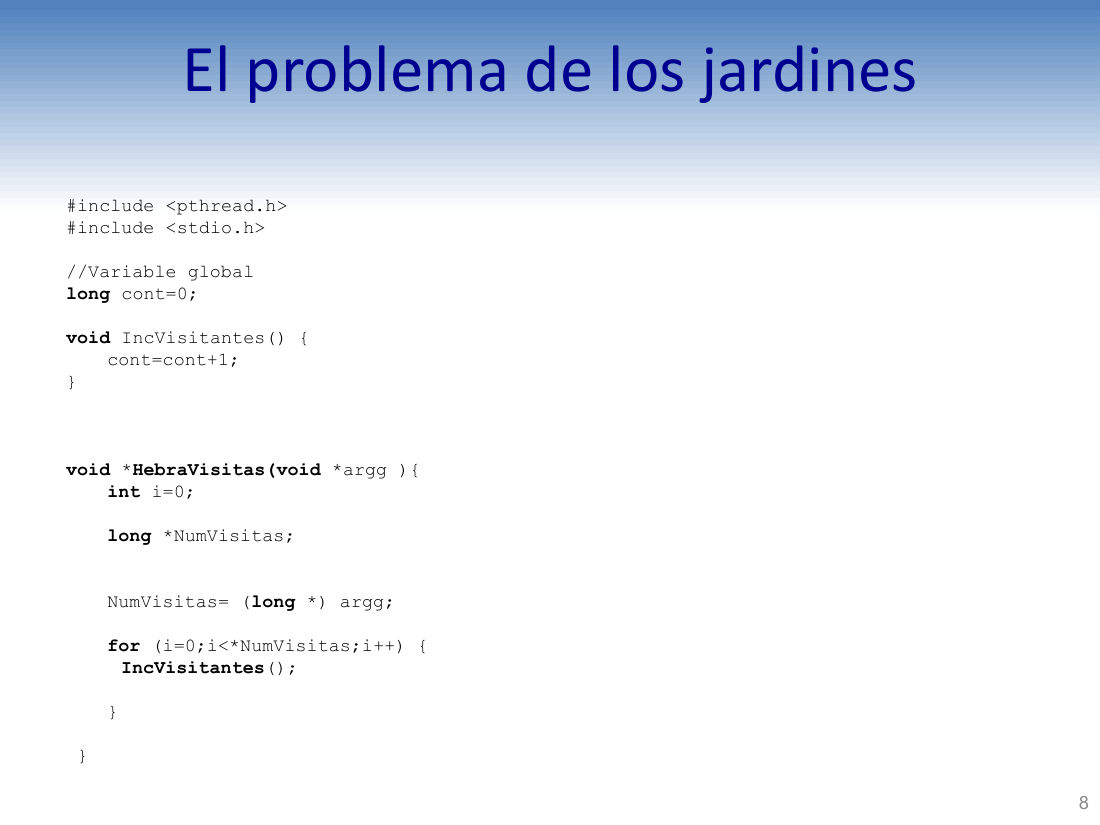
#include <pthread.h> · #include <stdio.h>
包含 POSIX 线程库与标准输入输出头文件(Linux 下编译需加 -lpthread)。
//Variable global · long cont=0;
全局变量 cont,初始 0,记录总参观人数。
void IncVisitantes() { cont=cont+1; }
自增函数:把人数加 1。看似一行,编译后是三条机器指令(p.10 会拆)。
void *HebraVisitas(void *argg)
线程函数:参数是 void*,返回 void*——pthread 的固定签名。
NumVisitas = (long *) argg;
把 void* 强制转换成 long*,这样才能取出调用者传进来的次数。
for (i=0;i<*NumVisitas;i++) { IncVisitantes(); }
循环 *NumVisitas 次,每次调用一次自增。注意是解引用 *NumVisitas,不是指针本身。
#include <pthread.h>
#include <stdio.h>
// Variable global
long cont = 0;

void IncVisitantes() {
    cont = cont + 1;          // 危险:读-改-写 三步
}

void *HebraVisitas(void *argg) {
    int i = 0;
    long *NumVisitas;
    NumVisitas = (long *) argg;
    for (i = 0; i < *NumVisitas; i++) {
        IncVisitantes();
    }
    return NULL;
}cont = cont + 1;。它同时「读」和「写」同一个共享变量,是最典型的 data race(数据竞争)。考试常问「¿Dónde está el problema?」,答这一行 + 说明它不是原子操作即可。El problema de los jardines · main 与两个提问
▸ 原页截图 p.9
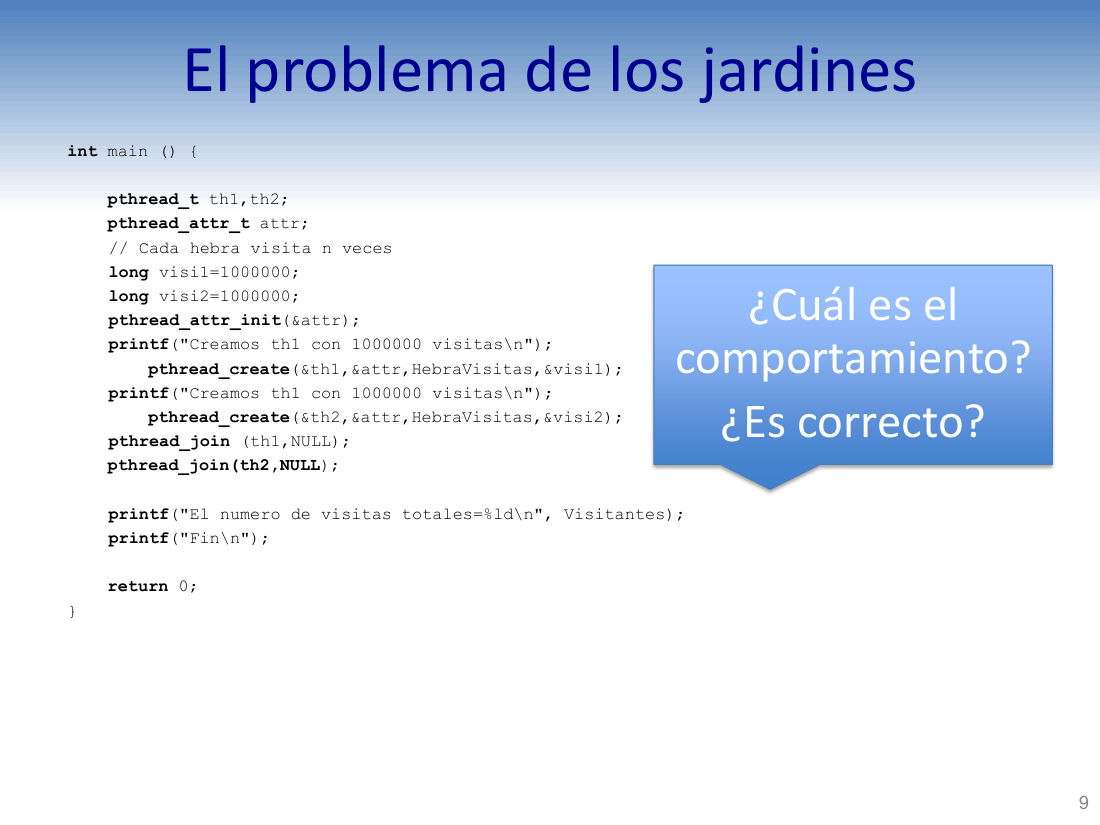
pthread_t th1,th2; · pthread_attr_t attr;
声明两个线程句柄和线程属性对象(属性需 pthread_attr_init 初始化)。
// Cada hebra visita n veces · long visi1=1000000; long visi2=1000000;
每个线程参观 100 万次——次数足够大,竞态才容易暴露。
pthread_create(&th1,&attr,HebraVisitas,&visi1);
创建线程 1,把 visi1 的地址作为参数传入。
pthread_join (th1,NULL); pthread_join(th2,NULL);
主线程等待两个线程结束——不 join 就打印,结果会不准。
printf("El numero de visitas totales=%ld\n", Visitantes);
打印总人数(讲义这里变量名写成了 Visitantes,实际全局变量叫 cont,属笔误)。
¿Cuál es el comportamiento? ¿Es correcto?
老师留的两个问题:实际行为是什么?它正确吗?
int main () {
    pthread_t th1, th2;
    pthread_attr_t attr;
    // Cada hebra visita n veces
    long visi1 = 1000000;
    long visi2 = 1000000;
    pthread_attr_init(&attr);
    printf("Creamos th1 con 1000000 visitas\n");
    pthread_create(&th1, &attr, HebraVisitas, &visi1);
    printf("Creamos th2 con 1000000 visitas\n");
    pthread_create(&th2, &attr, HebraVisitas, &visi2);
    pthread_join(th1, NULL);
    pthread_join(th2, NULL);
    printf("El numero de visitas totales=%ld\n", cont);
    printf("Fin\n");
    return 0;
}cont++ 不是原子操作,两个线程会丢失更新。El problema de los jardines · 三条结论与指令拆分
▸ 原页截图 p.10(含示意图)
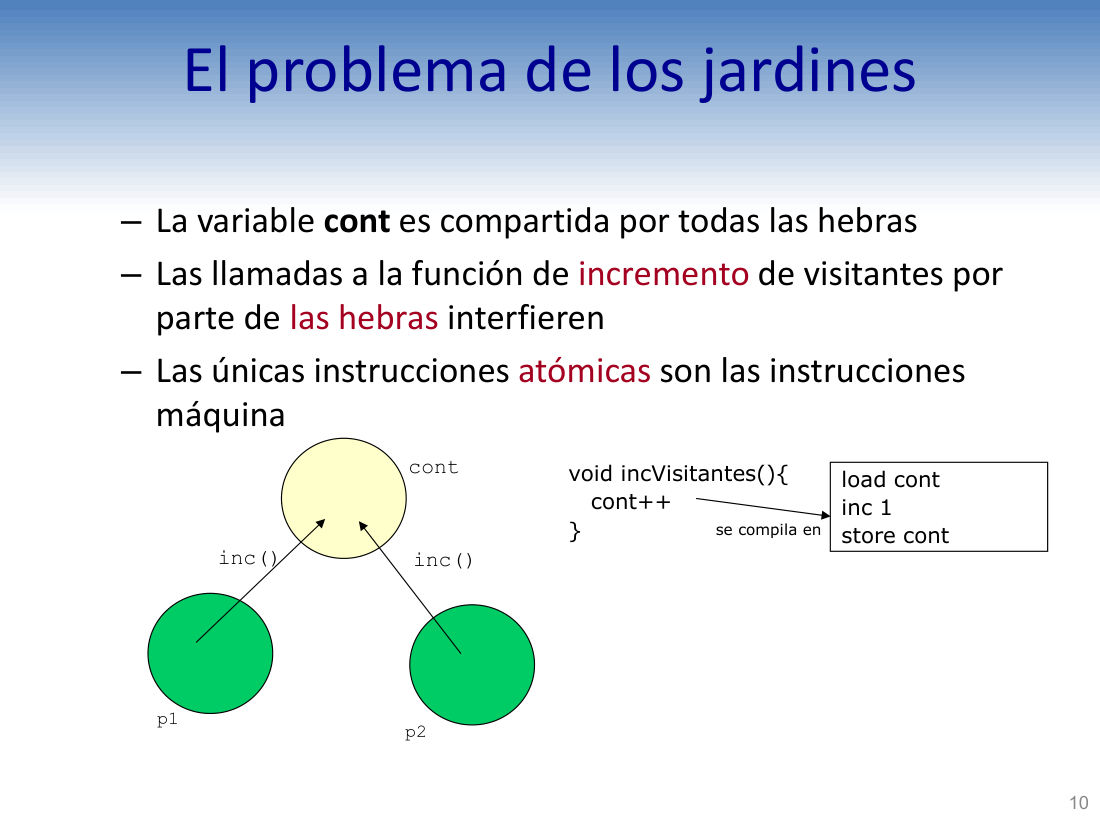
– La variable cont es compartida por todas las hebras
— 变量 cont 被所有线程共享。
– Las llamadas a la función de incremento de visitantes por parte de las hebras interfieren
— 各线程对自增函数的调用会相互干扰(interferir:干扰、冲突)。
– Las únicas instrucciones atómicas son las instrucciones máquina
— 唯一具有原子性的指令是机器指令。
void incVisitantes(){ cont++ } se compila en → load cont / inc 1 / store cont
一句 cont++ 被编译成三条机器指令:从内存读入寄存器 → 寄存器加 1 → 写回内存。
cont++ 很短,但它由三条指令组成,中间随时可能被切走。Traza de ejecución · 第 1 步:p1 load
▸ 原页截图 p.11
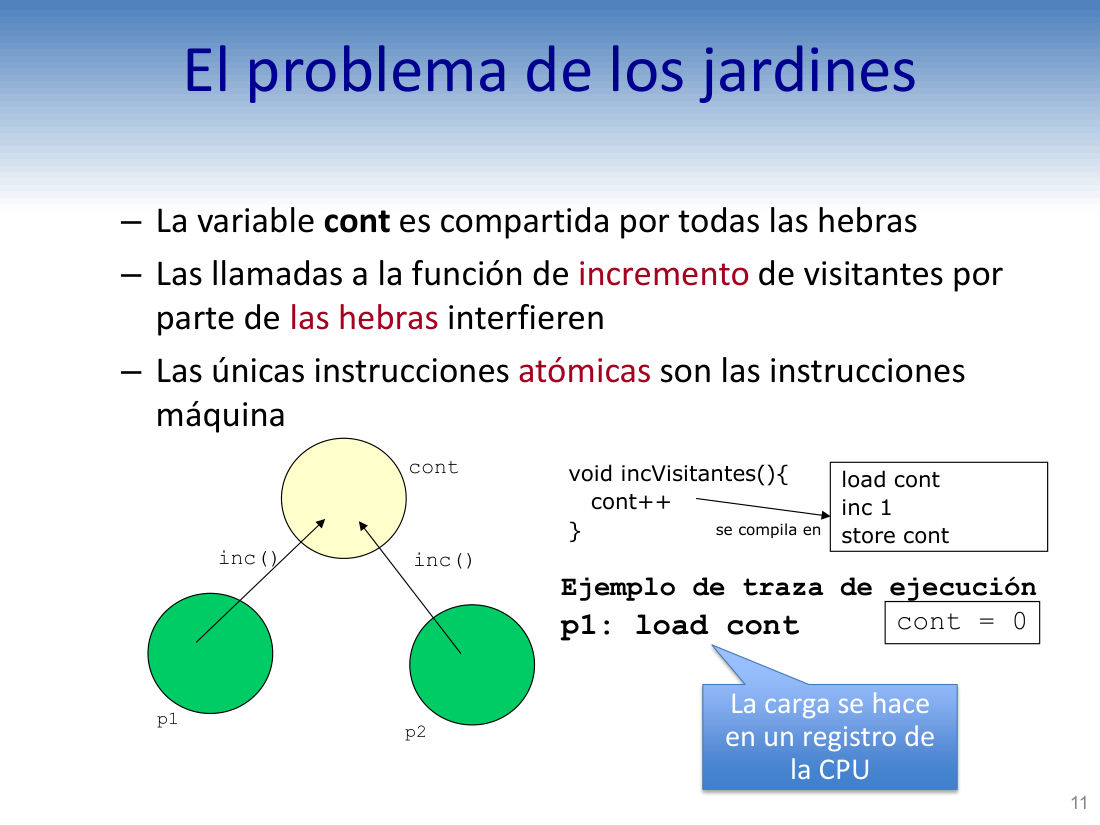
Ejemplo de traza de ejecución
执行轨迹示例(traza = 轨迹 / 执行序列)。
p1: load cont
线程 p1 执行第一步:把 cont 从内存读到寄存器。
cont = 0
此时内存中 cont 仍是 0。
La carga se hace en un registro de la CPU
这次「加载」发生在 CPU 的寄存器里,不是内存。
| 步骤 | 执行 | 内存 cont | p1 寄存器 | p2 寄存器 |
|---|---|---|---|---|
| 1 | p1: load cont | 0 | 0 | — |
load cont 之后 cont 就变了。完全没变!load 只是把值抄进寄存器,内存原地不动。Traza · 第 2 步:p1 inc
▸ 原页截图 p.12
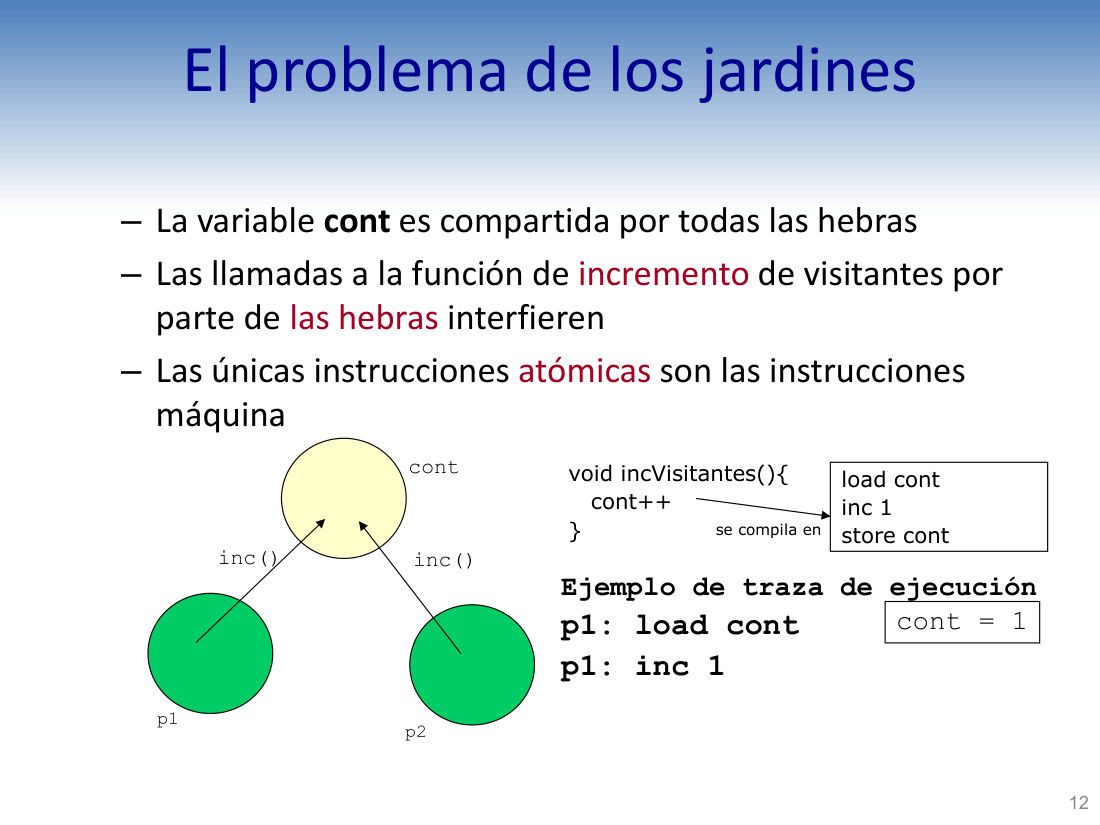
p1: load cont
第 1 步:(上面已讲)p1 读入 cont。
p1: inc 1
第 2 步:p1 的寄存器值 加 1,从 0 变成 1。
cont = 1
注意:这里讲义标注的 cont = 1 指的是 p1 寄存器里的值为 1,内存中的 cont 仍然是 0。
| 步骤 | 执行 | 内存 cont | p1 寄存器 | p2 寄存器 |
|---|---|---|---|---|
| 1 | p1: load cont | 0 | 0 | — |
| 2 | p1: inc 1 | 0 | 1 | — |
Traza · 第 3 步:p2 load(关键交叉点)
▸ 原页截图 p.13
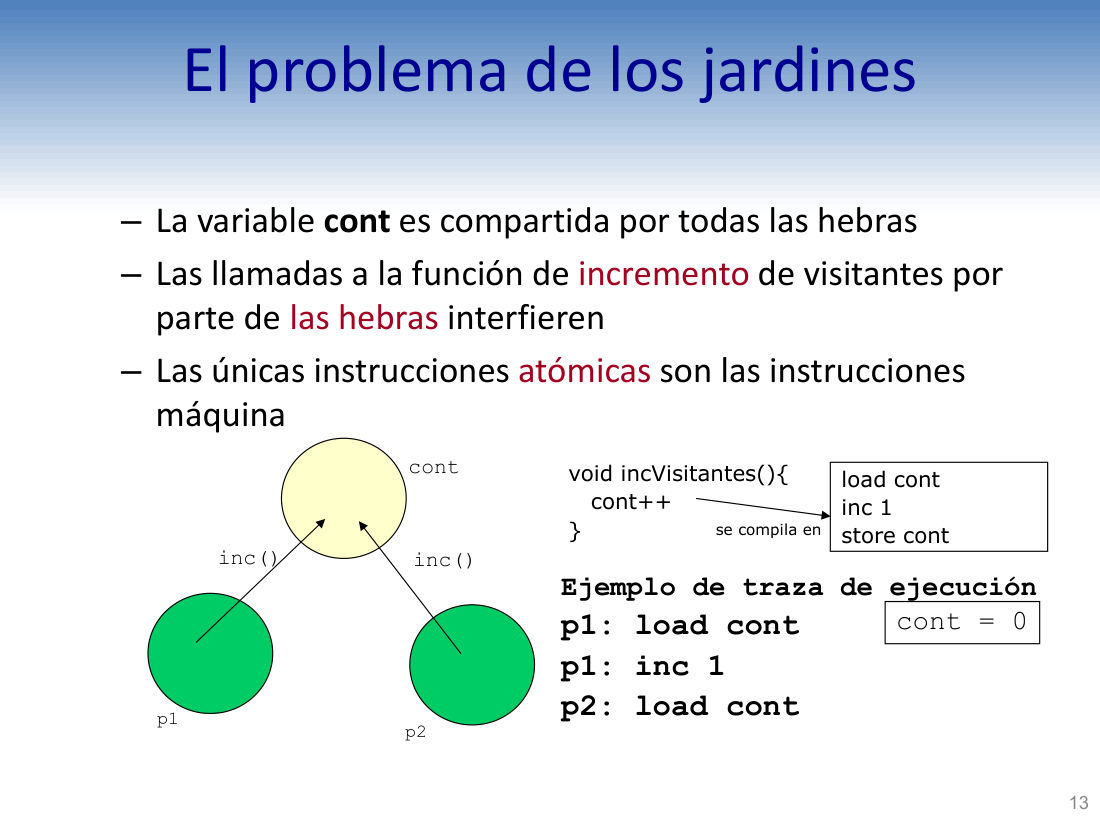
p1: load cont · p1: inc 1
p1 已完成「读 + 加」,寄存器里是 1,但还没写回内存。
p2: load cont
此时 p2 也开始执行,它读到的 cont 是 0(因为 p1 还没 store)。
cont = 0
内存里 cont 依然是 0 —— 这就是错误诞生的瞬间。
| 步骤 | 执行 | 内存 cont | p1 寄存器 | p2 寄存器 |
|---|---|---|---|---|
| 1 | p1: load cont | 0 | 0 | — |
| 2 | p1: inc 1 | 0 | 1 | — |
| 3 | p2: load cont | 0 | 1 | 0 |
Traza · 第 4 步:p2 inc
▸ 原页截图 p.14
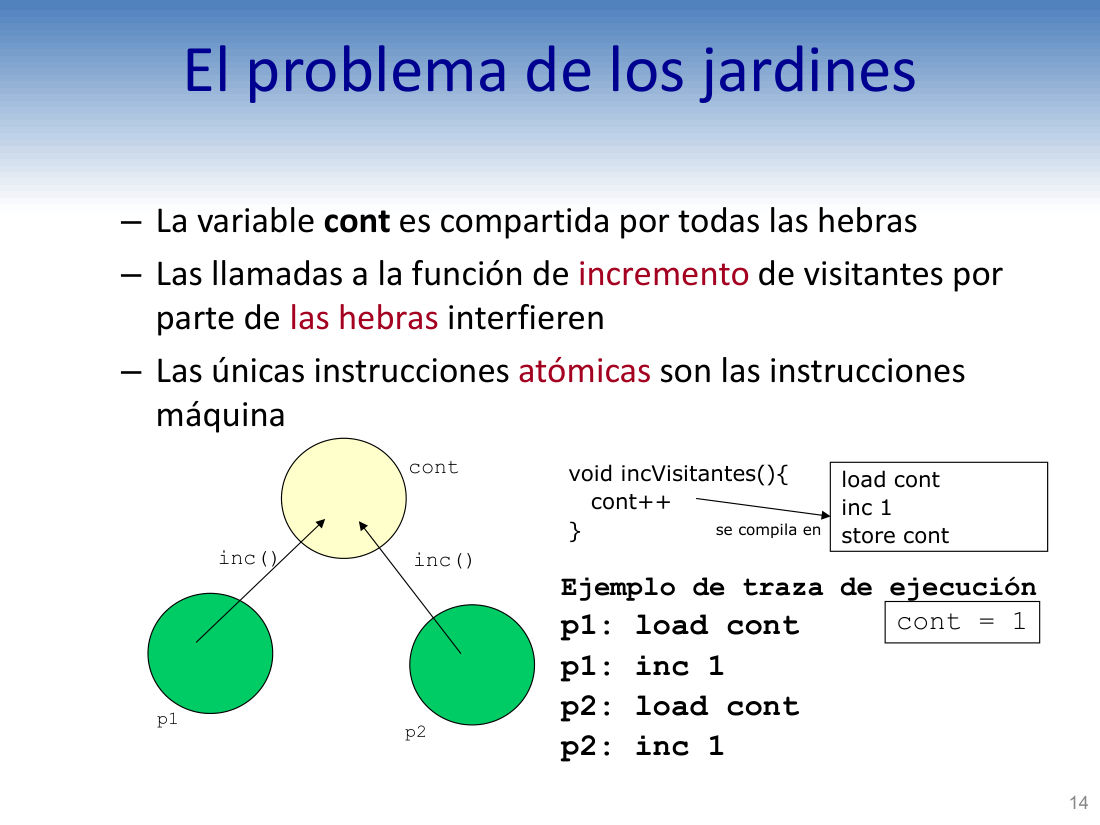
p2: load cont
p2 读到旧值 0。
p2: inc 1
p2 的寄存器也加 1,变成 1。
cont = 1
同样,这个 1 只存在于 p2 的寄存器。
| 步骤 | 执行 | 内存 cont | p1 寄存器 | p2 寄存器 |
|---|---|---|---|---|
| 1 | p1: load cont | 0 | 0 | — |
| 2 | p1: inc 1 | 0 | 1 | — |
| 3 | p2: load cont | 0 | 1 | 0 |
| 4 | p2: inc 1 | 0 | 1 | 1 |
Traza · 第 5 步:p1 store
▸ 原页截图 p.15
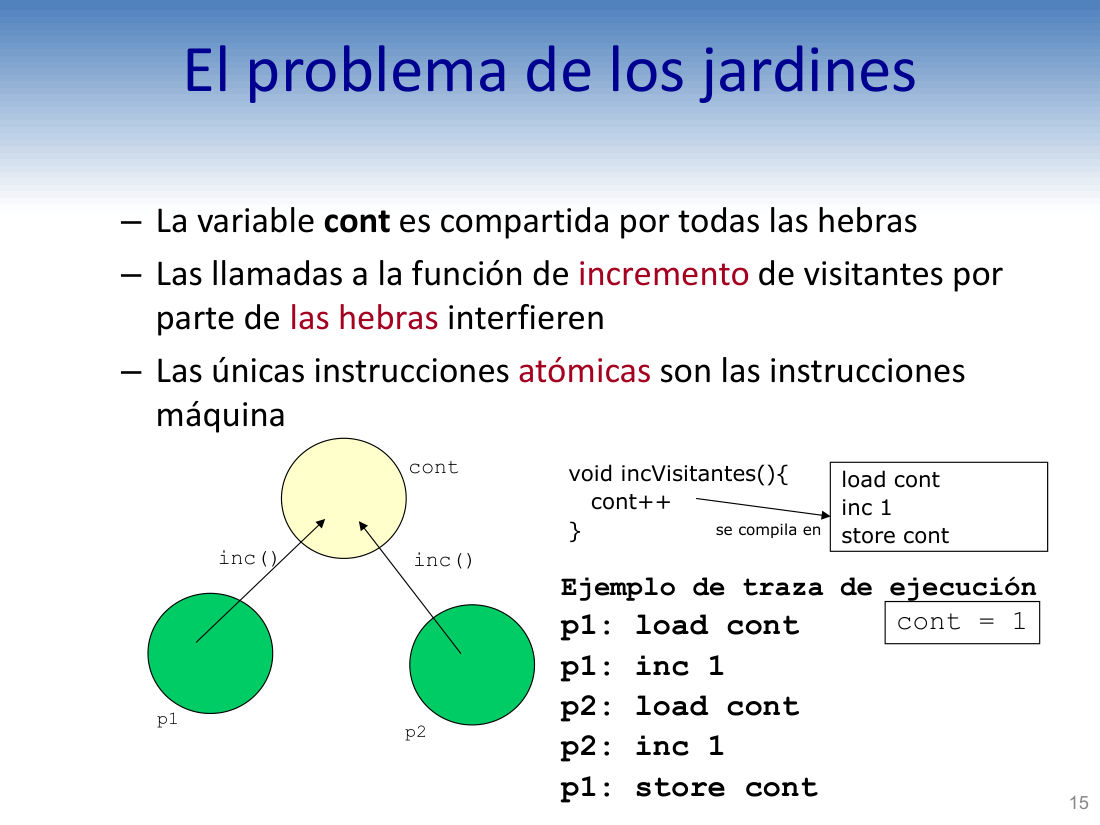
p1: store cont
p1 把寄存器里的 1 写回内存。
cont = 1
内存 cont 首次变成 1(正确,因为 p1 那次自增生效了)。
| 步骤 | 执行 | 内存 cont | p1 寄存器 | p2 寄存器 |
|---|---|---|---|---|
| 1 | p1: load cont | 0 | 0 | — |
| 2 | p1: inc 1 | 0 | 1 | — |
| 3 | p2: load cont | 0 | 1 | 0 |
| 4 | p2: inc 1 | 0 | 1 | 1 |
| 5 | p1: store cont | 1 | 1 | 1 |
Traza · 第 6 步:p2 store → 丢失更新
▸ 原页截图 p.16
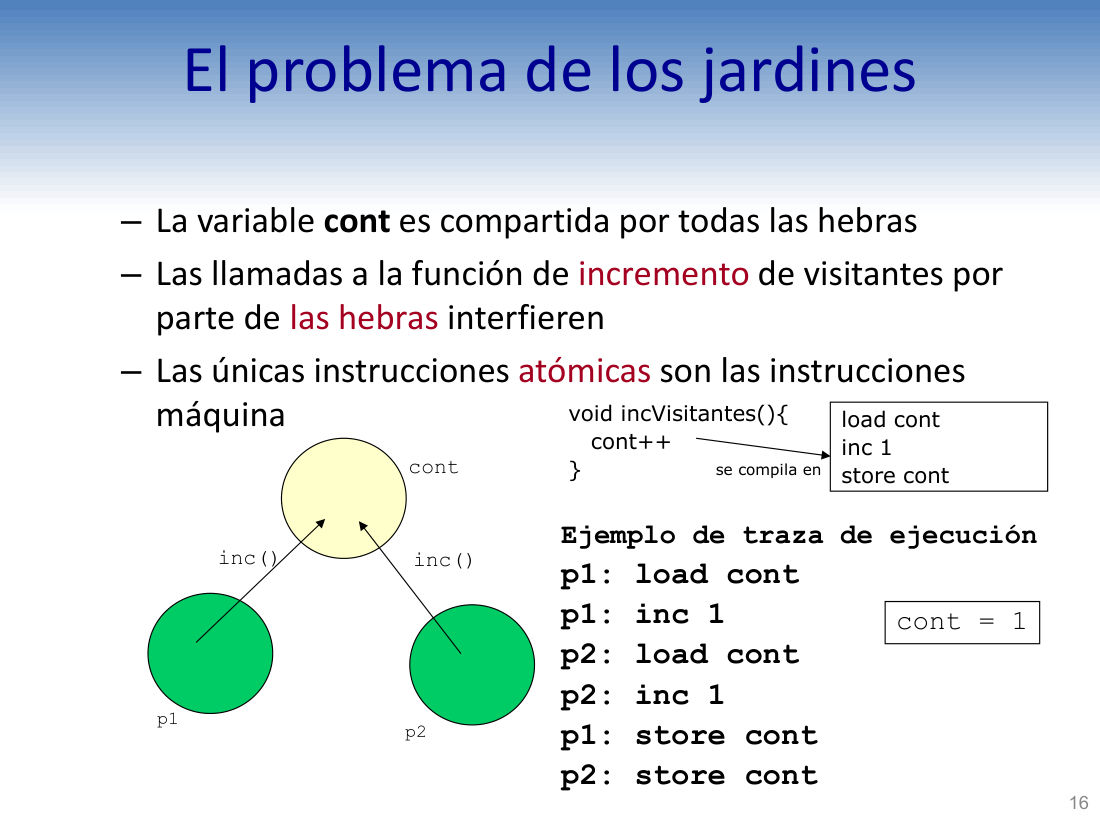
p2: store cont
p2 也把自己寄存器里的 1 写回内存 —— 覆盖了 p1 刚写的 1。
cont = 1
最终 cont = 1,而正确值应为 2。一次自增凭空消失。
| 步骤 | 执行 | 内存 cont | p1 寄存器 | p2 寄存器 |
|---|---|---|---|---|
| 1 | p1: load cont | 0 | 0 | — |
| 2 | p1: inc 1 | 0 | 1 | — |
| 3 | p2: load cont | 0 | 1 | 0 |
| 4 | p2: inc 1 | 0 | 1 | 1 |
| 5 | p1: store cont | 1 | 1 | 1 |
| 6 | p2: store cont | 1(应为 2) | 1 | 1 |
四个核心定义:SC / EM / sincronizar / race condition
▸ 原页截图 p.17
Este problema muestra uno de los grandes problemas de la programación concurrente
这个问题展示了并发编程的重大难题之一。
– Detectar cuándo un recurso (cont) compartido necesita algún control de acceso para asegurar su integridad
— 判断共享资源(cont)何时需要访问控制以保证其完整性。
– Debemos impedir que varias hebras utilicen simultáneamente el recurso para que no se produzcan interferencias como las descritas.
— 必须阻止多个线程同时使用该资源,以免出现上述干扰。
– El código de acceso al recurso en cada una de las hebras se denomina
— 各线程中「访问该资源的那段代码」称为临界区(sección crítica,缩写 SC)。
– La no interferencia entre secciones críticas significa que su ejecución no debe solaparse en el tiempo
— 临界区之间「不干扰」的意思是:它们的执行在时间上不能重叠(solaparse:交叠)。
• Las secciones críticas deben aparecer como códigos atómicos para el resto de las hebras
• 对其他线程而言,临界区必须表现得像原子代码块。
– Cuando dos secciones críticas no se interfieren se dice que se ejecutan en
— 两个临界区互不干扰时,称它们以互斥方式执行。
– Garantizar la exclusión mutua requiere
— 保证互斥需要对相关线程进行同步。
• Si P1 quiere ejecutar su sección crítica cuando P2 la está ejecutando, P1 debe esperar a que P2 termine y viceversa
• 若 P2 正在执行临界区而 P1 想进入,P1 必须等 P2 结束,反之亦然。
– Este tipo de problemas donde el resultado depende del orden de ejecución, se conoce también como
— 这类「结果取决于执行顺序」的问题,也称为竞态条件。
代码:访问共享资源的那几行。
性质:这些代码在时间上不重叠。
三、生产者 / 消费者:同步条件
El problema del productor/consumidor · 生产者 / 消费者问题
▸ 原页截图 p.18(插图页)
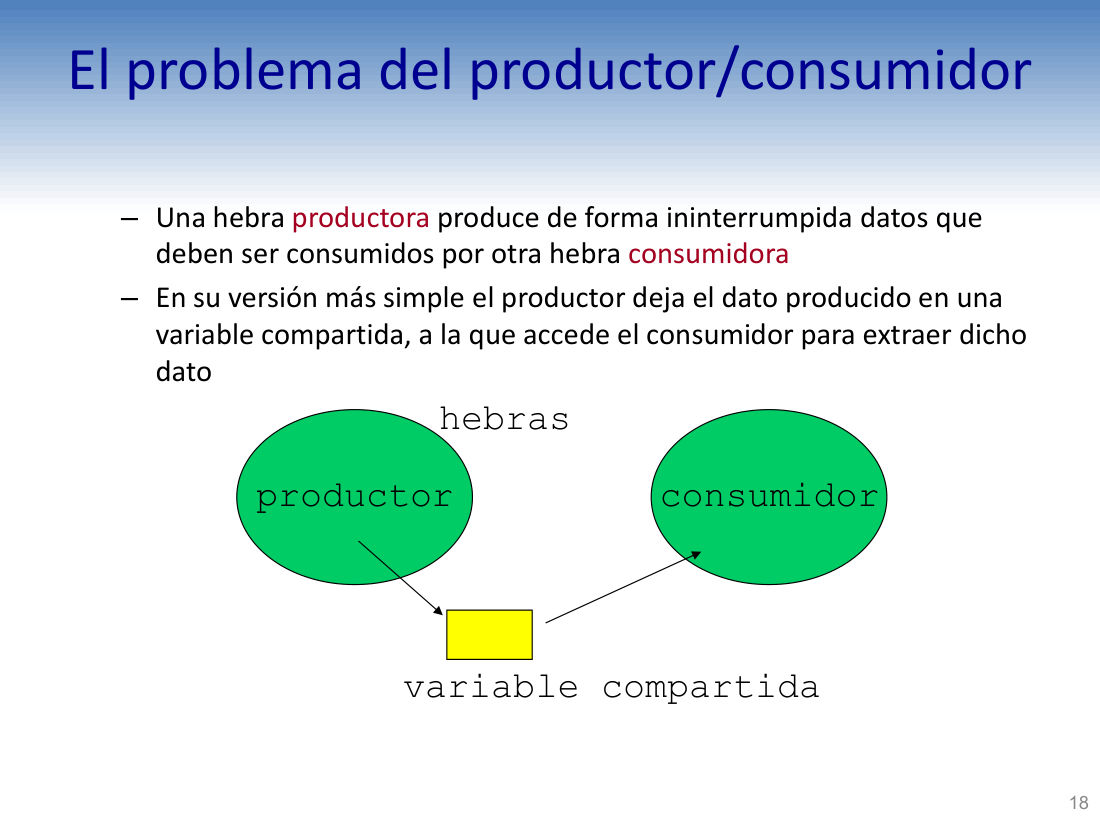
El problema del productor/consumidor
生产者 / 消费者问题(el problema del productor/consumidor)—— 并发编程的第二个经典模型。
– Una hebra productora produce de forma ininterrumpida datos que deben ser consumidos por otra hebra consumidora
— 一个生产者线程不间断地产生数据,这些数据必须由另一个消费者线程消费掉(de forma ininterrumpida:不间断地)。
– En su versión más simple el productor deja el dato producido en una variable compartida, a la que accede el consumidor para extraer dicho dato
— 在最简版本中,生产者把产出的数据放进一个共享变量(variable compartida),消费者访问该变量以取出这个数据。
Productor/consumidor: principal · 主程序 main
▸ 原页截图 p.19
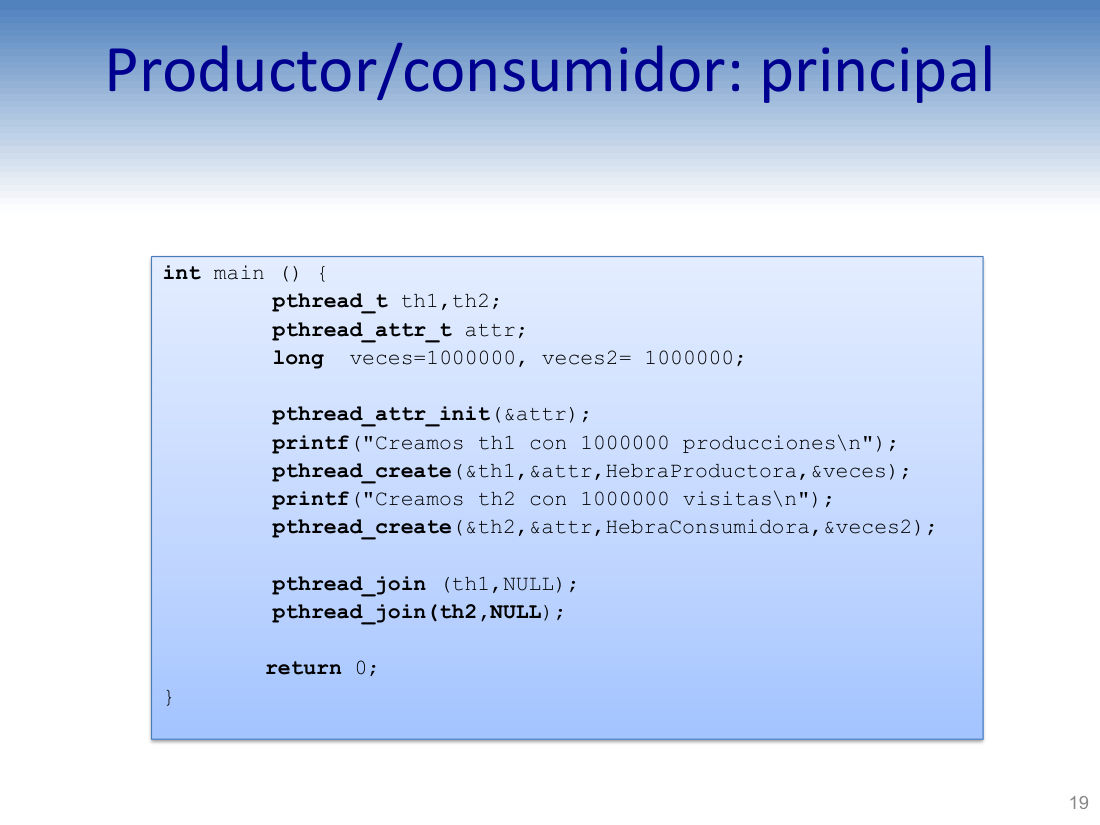
Productor/consumidor: principal
生产者 / 消费者:主程序(principal = main)。
pthread_t th1, th2; pthread_attr_t attr;
两个线程句柄 th1 / th2,一个线程属性对象 attr。
long veces = 1000000, veces2 = 1000000;
两个计数:生产者做 100 万次生产,消费者做 100 万次读取。
pthread_attr_init(&attr);
初始化线程属性(默认属性:joinable)。
printf("Creamos th1 con 1000000 producciones\n");
打印「创建 th1,100 万次生产」。
pthread_create(&th1, &attr, HebraProductora, &veces);
创建生产者线程,入口函数 HebraProductora,参数是 veces 的地址。
printf("Creamos th2 con 1000000 visitas\n");
打印「创建 th2,100 万次访问」——注意讲义这里写的是 visitas(访问),其实对应消费。
pthread_create(&th2, &attr, HebraConsumidora, &veces2);
创建消费者线程,入口函数 HebraConsumidora。
pthread_join(th1, NULL); pthread_join(th2, NULL); return 0;
主线程等待两个线程结束(join),然后返回 0。
Productor/consumidor: Hebras · 两个线程函数 + Set/Read
▸ 原页截图 p.20
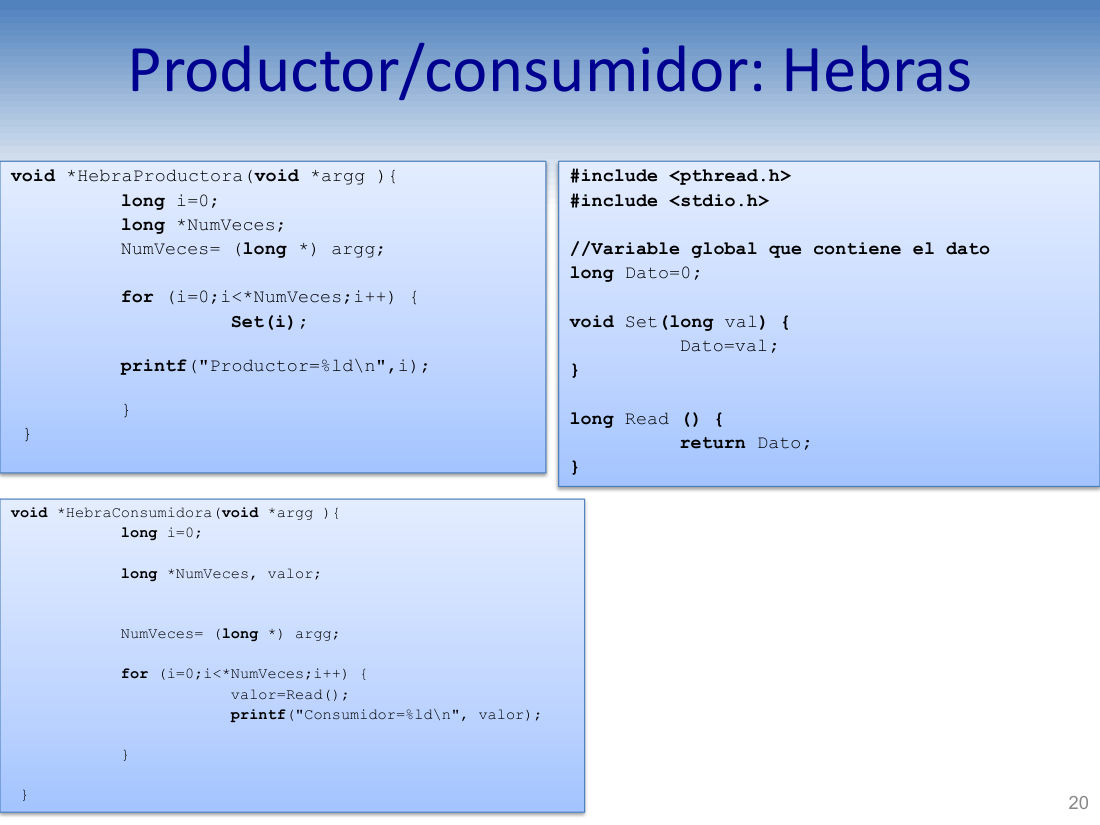
void *HebraConsumidora(void *argg) { long i = 0; long *NumVeces, valor; NumVeces = (long *) argg;
消费者线程函数:把参数强转成 long * 得到循环次数指针 NumVeces,valor 存每次读到的值。
for (i = 0; i < *NumVeces; i++) { valor = Read(); printf("Consumidor=%ld\n", valor); }
循环 100 万次:每轮调用 Read() 取出数据并打印「Consumidor=值」。
void *HebraProductora(void *argg) { … for (i = 0; i < *NumVeces; i++) { Set(i); printf("Productor=%ld\n", i); } }
生产者线程函数:循环 100 万次,每轮调用 Set(i) 写入当前下标,再打印「Productor=值」。
//Variable global que contiene el dato
注释:存放数据的全局变量(全局 = 两个线程都能看到,正是「共享」的来源)。
long Dato = 0; void Set(long val) { Dato = val; } long Read() { return Dato; }
全局变量 Dato 初值 0;Set 把参数写进去;Read 把它读出来。这两个函数就是临界区的雏形。
//Variable global que contiene el dato
long Dato = 0;
void Set(long val) { Dato = val; }   // 写共享变量
long Read()        { return Dato; }  // 读共享变量

void *HebraProductora(void *argg) {
  long *NumVeces = (long *) argg;
  for (long i = 0; i < *NumVeces; i++) {
    Set(i);  // 生产
    printf("Productor=%ld\n", i);
  }
}
void *HebraConsumidora(void *argg) {
  long *NumVeces = (long *) argg;
  for (long i = 0; i < *NumVeces; i++) {
    long valor = Read();  // 消费
    printf("Consumidor=%ld\n", valor);
  }
}Una ejecución · 一次真实执行 + 两条同步条件
▸ 原页截图 p.21(含输出截图)
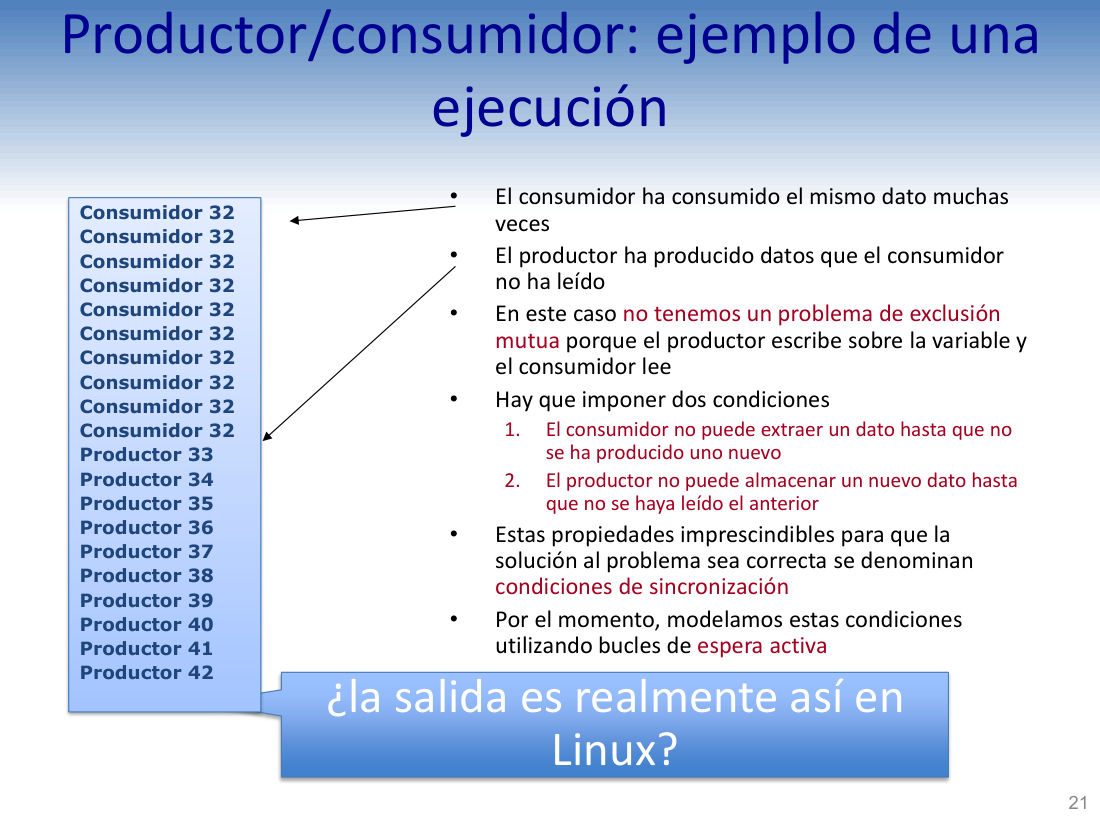
Productor/consumidor: ejemplo de una ejecución
生产者 / 消费者:一次执行的例子。
• El consumidor ha consumido el mismo dato muchas veces
• 消费者把同一个数据消费了很多次(输出里 Consumidor 32 连刷 10 行)。
• El productor ha producido datos que el consumidor no ha leído
• 生产者产出的很多数据消费者根本没读到(被后来的值覆盖了)。
• En este caso no tenemos un problema de exclusión mutua porque el productor escribe sobre la variable y el consumidor lee
• 这个场景不存在互斥问题——因为生产者只是写、消费者只是读,两者并不「同时改同一个值」。
• Hay que imponer dos condiciones
• 必须施加两个条件(注意:是条件,不是互斥):
1. El consumidor no puede extraer un dato hasta que no se ha producido uno nuevo
1. 在新数据被生产出来之前,消费者不能取数据。
2. El productor no puede almacenar un nuevo dato hasta que no se haya leído el anterior
2. 在上一个数据被读走之前,生产者不能存新数据。
• Estas propiedades imprescindibles para que la solución al problema sea correcta se denominan
• 这些「解要正确就必须满足」的性质,称为同步条件(condiciones de sincronización)。
• Por el momento, modelamos estas condiciones utilizando bucles de espera activa
• 目前我们用忙等待循环(bucles de espera activa)来建模这些条件。
// 输出(真实执行片段)
Consumidor 32
Consumidor 32      ← 同一个数据被反复消费
Consumidor 32
...
Productor 33
Productor 34       ← 生产了但没被读走
Productor 35
...Primer intento · 第一次尝试:两个布尔变量
▸ 原页截图 p.22
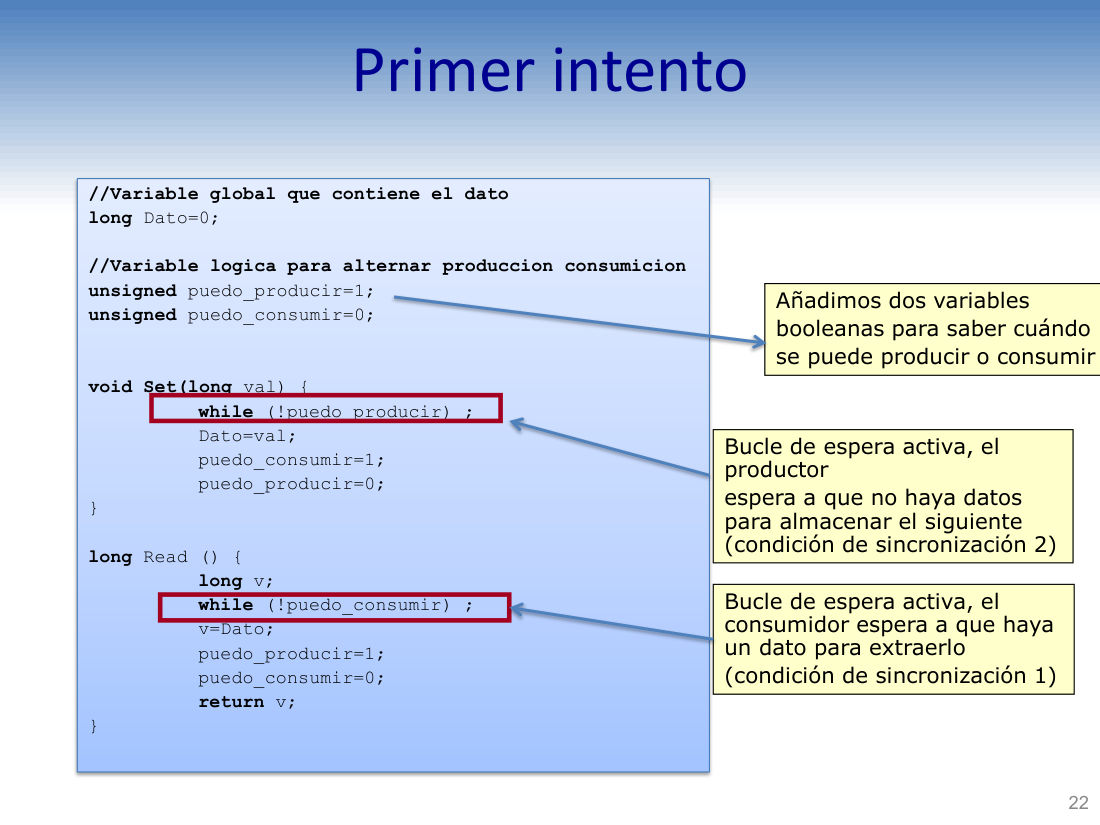
Primer intento
第一次尝试(primer intento)。
long Dato = 0; //Variable global que contiene el dato
全局共享变量 Dato,初值 0。
//Variable logica para alternar produccion consumicion
注释:用于交替「生产 / 消费」的逻辑变量(lógica = 布尔)。
unsigned puedo_producir = 1; unsigned puedo_consumir = 0;
两个布尔量:能生产初值 1、能消费初值 0——一开始盘子里没东西,所以只能生产。
void Set(long val) { while (!puedo_producir) ; Dato = val; puedo_consumir = 1; puedo_producir = 0; }
生产者:忙等直到允许生产 → 写入值 → 打开「可消费」→ 关掉「可生产」。
long Read() { long v; while (!puedo_consumir) ; v = Dato; puedo_producir = 1; puedo_consumir = 0; return v; }
消费者:忙等直到允许消费 → 读值 → 打开「可生产」→ 关掉「可消费」→ 返回读到的值。
Añadimos dos variables booleanas para saber cuándo se puede producir o consumir
老师批注(右上):加两个布尔变量,用来知道什么时候能生产、什么时候能消费。
Bucle de espera activa, el consumidor espera a que haya un dato para extraerlo (condición de sincronización 1)
批注(消费者侧):忙等待循环,消费者等「有数据可取」——这就是同步条件 1。
Bucle de espera activa, el productor espera a que no haya datos para almacenar el siguiente (condición de sincronización 2)
批注(生产者侧):忙等待循环,生产者等「没有数据」以便存下一个——这就是同步条件 2。
long Dato = 0;
unsigned puedo_producir = 1;
unsigned puedo_consumir = 0;

void Set(long val) {
  while (!puedo_producir) ;   // 同步条件 2
  Dato = val;
  puedo_consumir = 1;
  puedo_producir = 0;
}
long Read() {
  long v;
  while (!puedo_consumir) ;   // 同步条件 1
  v = Dato;
  puedo_producir = 1;
  puedo_consumir = 0;
  return v;
}Solución · 定稿:单变量 HayDato
▸ 原页截图 p.23
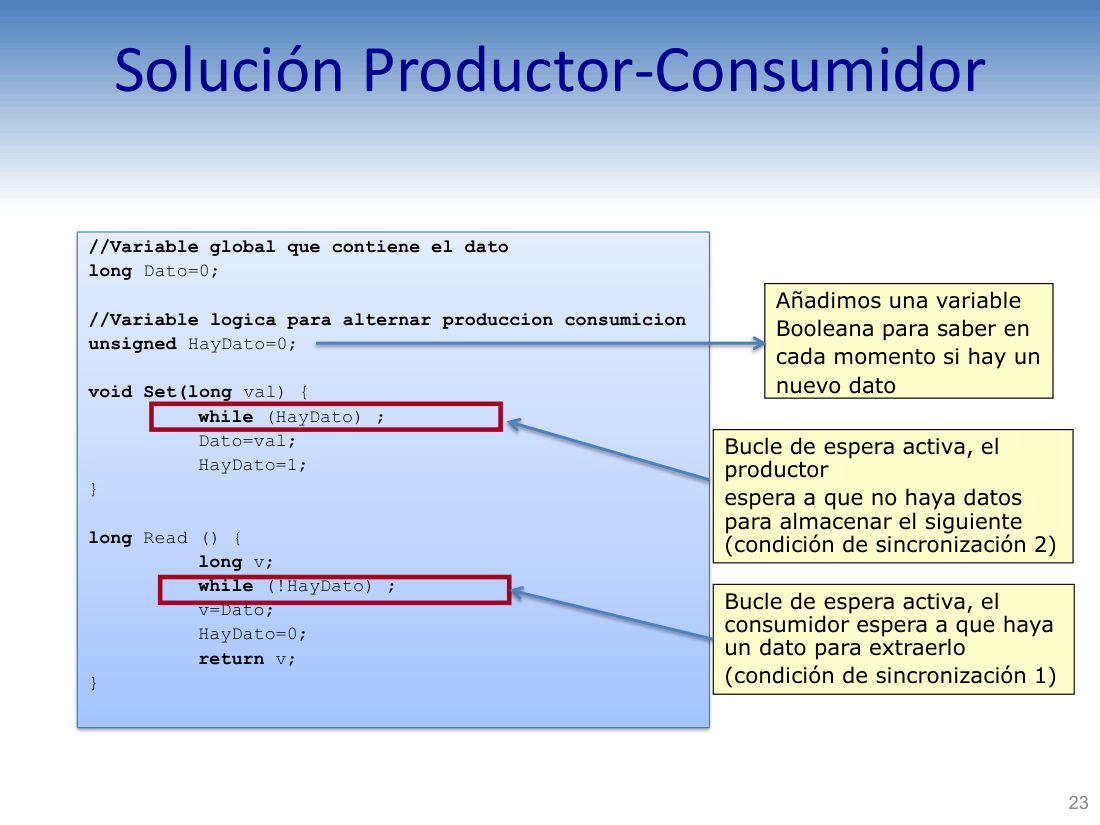
Solución Productor-Consumidor
生产者-消费者解法(solución = 定稿答案)。
long Dato = 0; //Variable global que contiene el dato
共享变量 Dato,初值 0。
//Variable logica para alternar produccion consumicion
注释仍然是「交替生产 / 消费的逻辑变量」,但这次只需要一个。
unsigned HayDato = 0;
只有一个布尔量 HayDato(有没有数据),初值 0 = 盘子空。
void Set(long val) { while (HayDato) ; Dato = val; HayDato = 1; }
生产者:只要已有数据就等(条件 2)→ 写入 → 标记「有数据」。
long Read() { long v; while (!HayDato) ; v = Dato; HayDato = 0; return v; }
消费者:只要没数据就等(条件 1)→ 读值 → 标记「空」→ 返回。
Añadimos una variable booleana para saber en cada momento si hay un nuevo dato
批注(右上):加一个布尔变量,用来随时知道「当前是否有新数据」。
Bucle de espera activa, el consumidor espera a que haya un dato para extraerlo (condición de sincronización 1)
批注:忙等待,消费者等有数据才取 —— 同步条件 1。
Bucle de espera activa, el productor espera a que no haya datos para almacenar el siguiente (condición de sincronización 2)
批注:忙等待,生产者等没数据才存下一个 —— 同步条件 2。
| 对比项 | p.22 两个变量 | p.23 一个 HayDato |
|---|---|---|
| 变量数 | puedo_producir + puedo_consumir | HayDato |
| 生产者等待 | while(!puedo_producir) | while(HayDato) |
| 消费者等待 | while(!puedo_consumir) | while(!HayDato) |
| 本质 | 两个状态互相取反(冗余) | 一个状态表达「有 / 无」 |
Salida revisada · 修正后的输出 + 四条局限
▸ 原页截图 p.24(含输出截图)
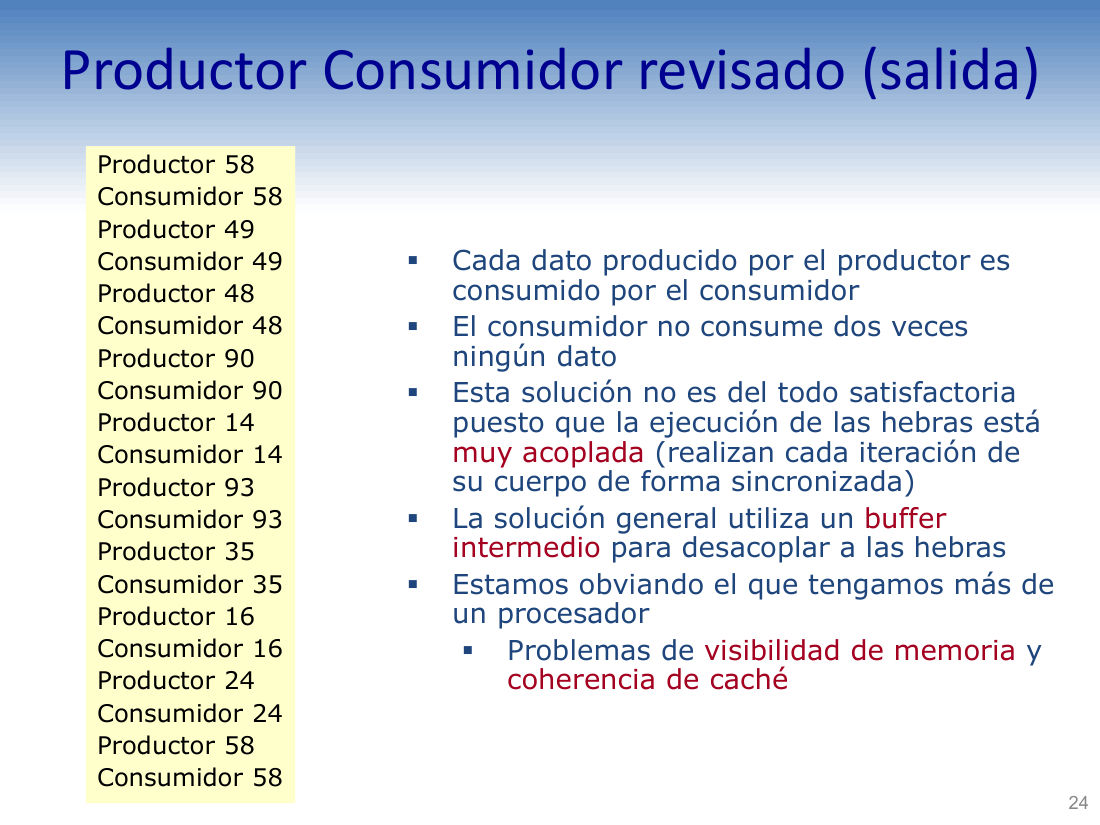
Productor Consumidor revisado (salida)
生产者消费者「修正版」的输出(revisado = 已修订)。
Productor 58 / Consumidor 58 / Productor 49 / Consumidor 49 …
输出变成严格一问一答:58→58、49→49、48→48……
▪ Cada dato producido por el productor es consumido por el consumidor
▪ 生产者产出的每一个数据都被消费者消费了。
▪ El consumidor no consume dos veces ningún dato
▪ 消费者不会重复消费同一个数据。
▪ Esta solución no es del todo satisfactoria puesto que la ejecución de las hebras está muy acoplada (realizan cada iteración de su cuerpo de forma sincronizada)
▪ 但这个解并不完全令人满意:两个线程执行耦合太紧(acoplada)——它们的每一轮循环都被强制同步成一问一答。
▪ La solución general utiliza un buffer intermedio para desacoplar a las hebras
▪ 通用解法是引入中间缓冲区(buffer)来解耦(desacoplar)两个线程。
▪ Estamos obviando el que tengamos más de un procesador
▪ 我们一直忽略(obviando)了「系统可能有多个处理器」这件事。
▪ Problemas de visibilidad de memoria y coherencia de caché
▪ 由此带出内存可见性(visibilidad de memoria)与缓存一致性(coherencia de caché)问题。
// 输出(修正后)
Productor 58
Consumidor 58
Productor 49
Consumidor 49
Productor 48
Consumidor 48
...耦合:一问一答,谁都跑不快。
缓冲:解耦,各跑各的。
可见性:一个核写的,另一个核可能看不到。
一致性:每个核的缓存副本不同步。
La función sched_yield · 主动让出 CPU
▸ 原页截图 p.25
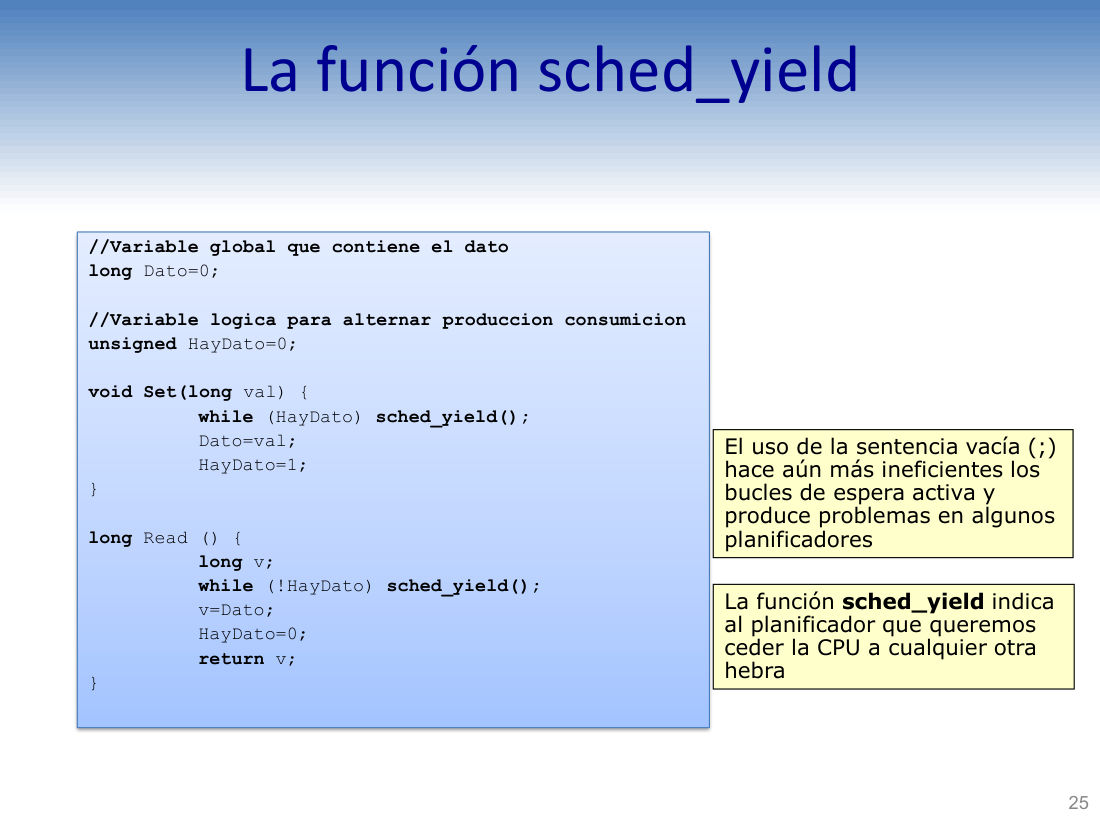
La función sched_yield
sched_yield 函数(yield = 让出)。
void Set(long val) { while (HayDato) sched_yield(); Dato = val; HayDato = 1; }
生产者:忙等时每轮调用 sched_yield(),把 CPU 让出去;然后写入、置位。
long Read() { long v; while (!HayDato) sched_yield(); v = Dato; HayDato = 0; return v; }
消费者:同样在忙等循环里调用 sched_yield();然后读值、清位、返回。
La función sched_yield indica al planificador que queremos ceder la CPU a cualquier otra hebra
批注:sched_yield 告诉调度器(planificador)「我愿意把 CPU 让给任何其他线程」。
El uso de la sentencia vacía (;) hace aún más ineficientes los bucles de espera activa y produce problemas en algunos planificadores
批注:用空语句 (;) 会让忙等待循环更低效,还会在某些调度器上出问题(线程一直占着 CPU 空转)。
| 写法 | 行为 | 评价 |
|---|---|---|
| while (HayDato) ; | 纯空转,死死占着 CPU | 低效,可能饿死别人 |
| while (HayDato) sched_yield(); | 每轮主动让出 CPU | 好一些,但仍是忙等 |
四、互斥的通用骨架与三次失败尝试
Exclusión mutua con espera activa · 通用骨架 + Requisito 1
▸ 原页截图 p.26(骨架图)
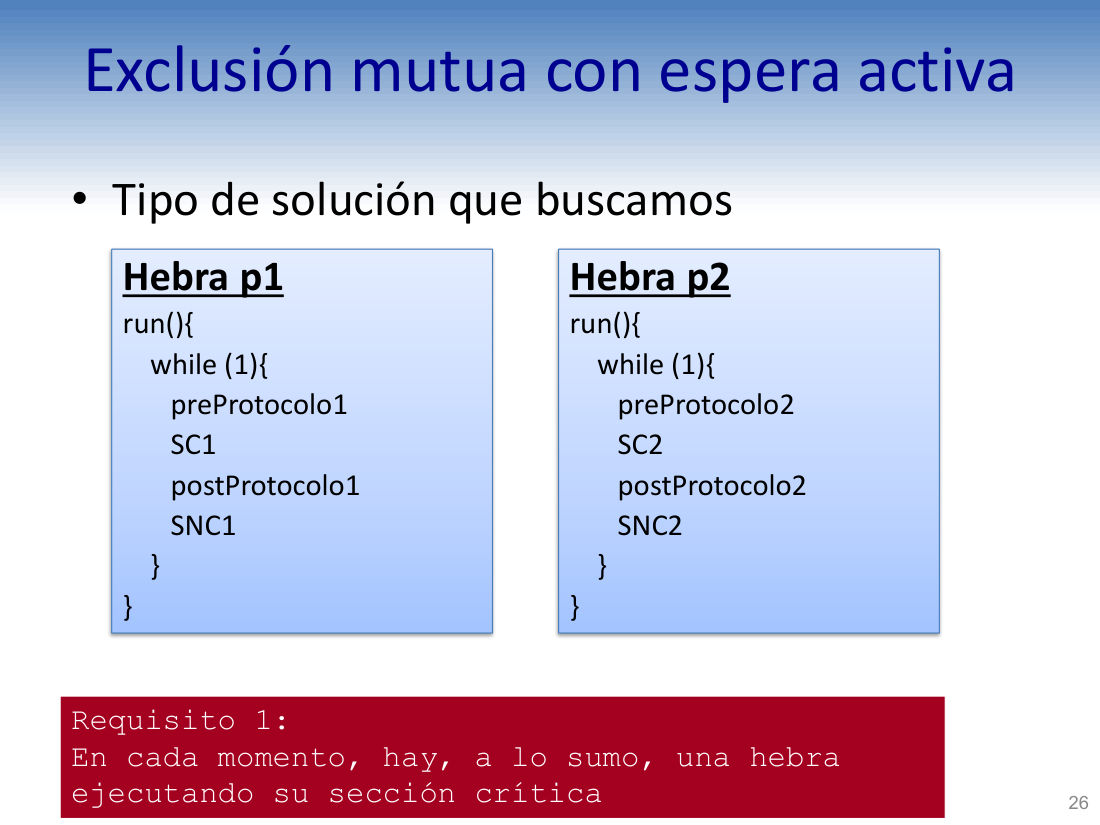
Exclusión mutua con espera activa
用忙等待实现互斥(本节标题,也是整章的「报名表」)。
• Tipo de solución que buscamos
• 我们要找的解的类型(Tipo de solución = 解的结构)。
Hebra p1: run() { while (1) { preProtocolo1 → SC1 → postProtocolo1 → SNC1 } }
线程 p1 的死循环:前协议(preProtocolo)→ 临界区(SC)→ 后协议(postProtocolo)→ 非临界区(SNC)。
Hebra p2: run() { while (1) { preProtocolo2 → SC2 → postProtocolo2 → SNC2 } }
线程 p2 结构完全相同,只是编号不同。
Requisito 1: En cada momento, hay, a lo sumo, una hebra ejecutando su sección crítica
需求 1:任何时刻,至多只有一个线程在执行它的临界区(a lo sumo = 至多)。
// 每个线程的通用结构
while (1) {
  preProtocolo   // 进门协议:想进 + 等
  SC              // sección crítica:改共享资源
  postProtocolo  // 出门协议:放行别人
  SNC             // 非临界区:随便跑
}Primer intento (f[2]) · 第一版:f[] 标志数组
▸ 原页截图 p.27
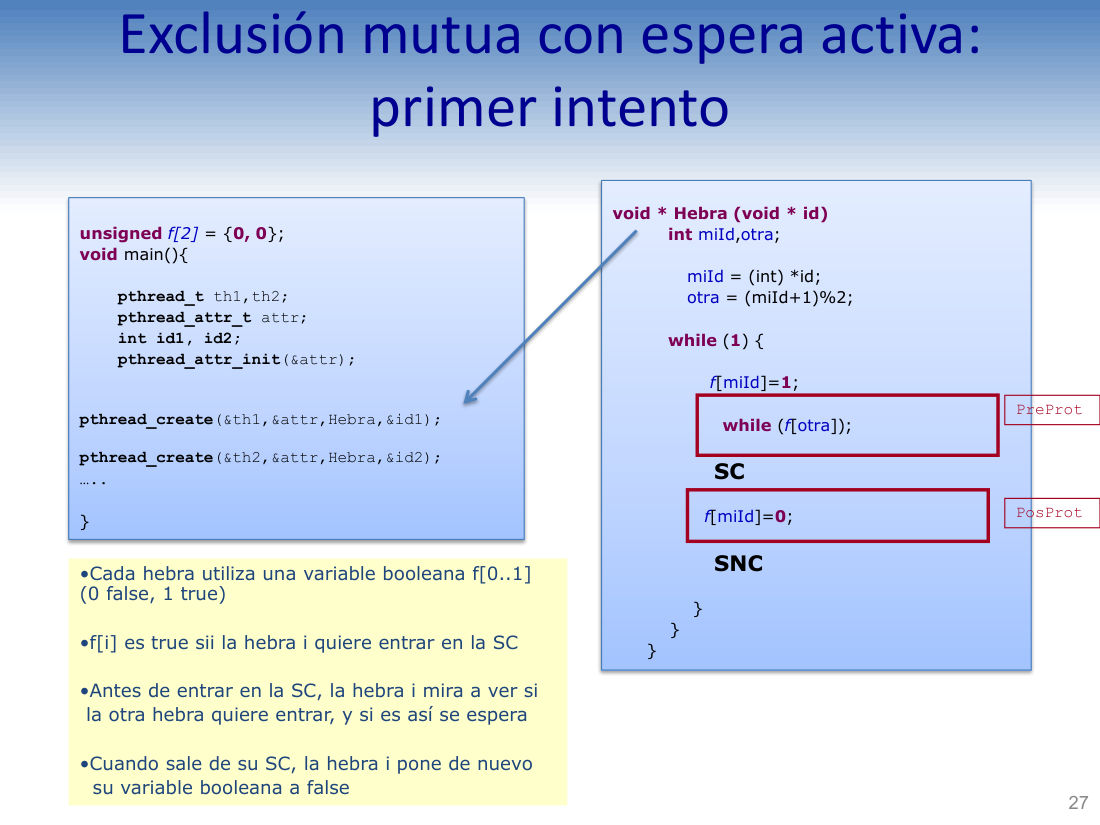
Exclusión mutua con espera activa: primer intento
忙等待互斥:第一次尝试。
unsigned f[2] = {0, 0};
全局数组 f[2],两个元素初值都是 0(谁都不想进)。
void main() { pthread_t th1, th2; pthread_attr_t attr; int id1, id2; pthread_attr_init(&attr); pthread_create(&th1, &attr, Hebra, &id1); pthread_create(&th2, &attr, Hebra, &id2); }
主程序:初始化属性,创建两个线程,参数分别是 id1、id2 的地址。
void *Hebra(void *id) { int miId, otra; miId = (int) *id; otra = (miId + 1) % 2;
线程函数:miId = 我是谁(0 或 1),otra = 另一个((miId+1)%2,0↔1 互换)。
while (1) { f[miId] = 1; while (f[otra]); SC; f[miId] = 0; SNC }
循环:先举手(f[miId]=1)→ 看对方是否举手(while f[otra] 就等)→ 进 SC → 放下手(f[miId]=0)→ SNC。
• Cada hebra utiliza una variable booleana f[0..1] (0 false, 1 true)
• 每个线程用一个布尔量 f[0..1](0 = false,1 = true)。
• f[i] es true sii la hebra i quiere entrar en la SC
• f[i] 为 true 当且仅当(sii = si y solo si)线程 i 想进临界区。
• Antes de entrar en la SC, la hebra i mira a ver si la otra hebra quiere entrar, y si es así se espera
• 进 SC 前,线程 i 先看对方想不想进;如果对方也想,就等。
• Cuando sale de su SC, la hebra i pone de nuevo su variable booleana a false
• 出 SC 后,线程 i 把自己的布尔量重新置回 false(= 放下手)。
unsigned f[2] = {0, 0};

void *Hebra(void *id) {
  int miId = (int) *id;
  int otra = (miId + 1) % 2;
  while (1) {
    f[miId] = 1;     // PreProt: 举手「我想进」
    while (f[otra]);  // PreProt: 对方举手我就等
    SC;
    f[miId] = 0;     // PosProt: 放手
    SNC;
  }
}Prueba de R1 · 为什么第一版满足互斥
▸ 原页截图 p.28
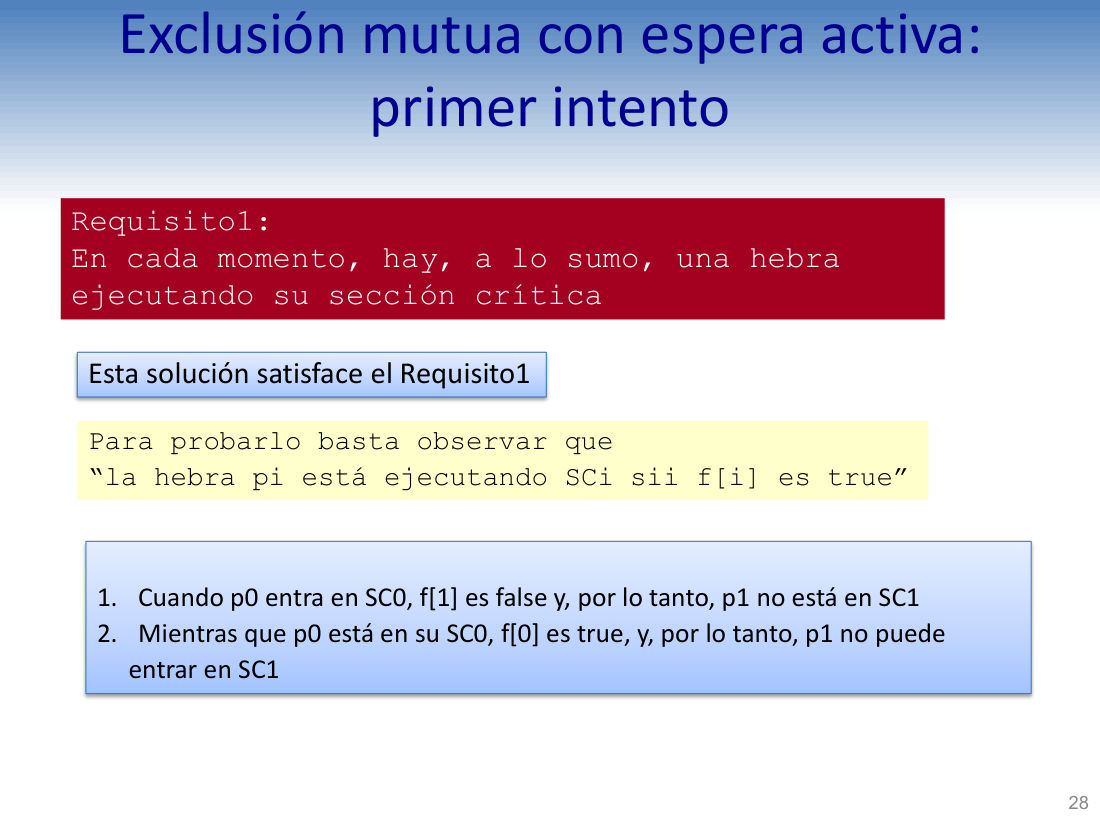
Requisito 1: En cada momento, hay, a lo sumo, una hebra ejecutando su sección crítica
需求 1(原文重复一遍,作为证明对象):任何时刻至多一个线程在 SC 里。
Esta solución satisface el Requisito 1
这个解满足需求 1。
Para probarlo basta observar que "la hebra pi está ejecutando SCi sii f[i] es true"
要证明它,只需观察这个不变量:「线程 pi 正在执行 SCi 当且仅当 f[i] 为 true」。
1. Cuando p0 entra en SC0, f[1] es false y, por lo tanto, p1 no está en SC1
1. 当 p0 进入 SC0 时,f[1] 是 false,因此 p1 不在 SC1 里。
2. Mientras que p0 está en su SC0, f[0] es true, y, por lo tanto, p1 no puede entrar en SC1
2. 只要 p0 还在 SC0 里,f[0] 一直是 true,因此 p1 进不来 SC1。
不变量:在 SC 里 ⟺ 举着手。
f[otra]=false ⟹ 对方不在 SC。
f[miId]=true ⟹ 对方进不来。
Livelock · 死锁式空转 + Requisito 2
▸ 原页截图 p.29
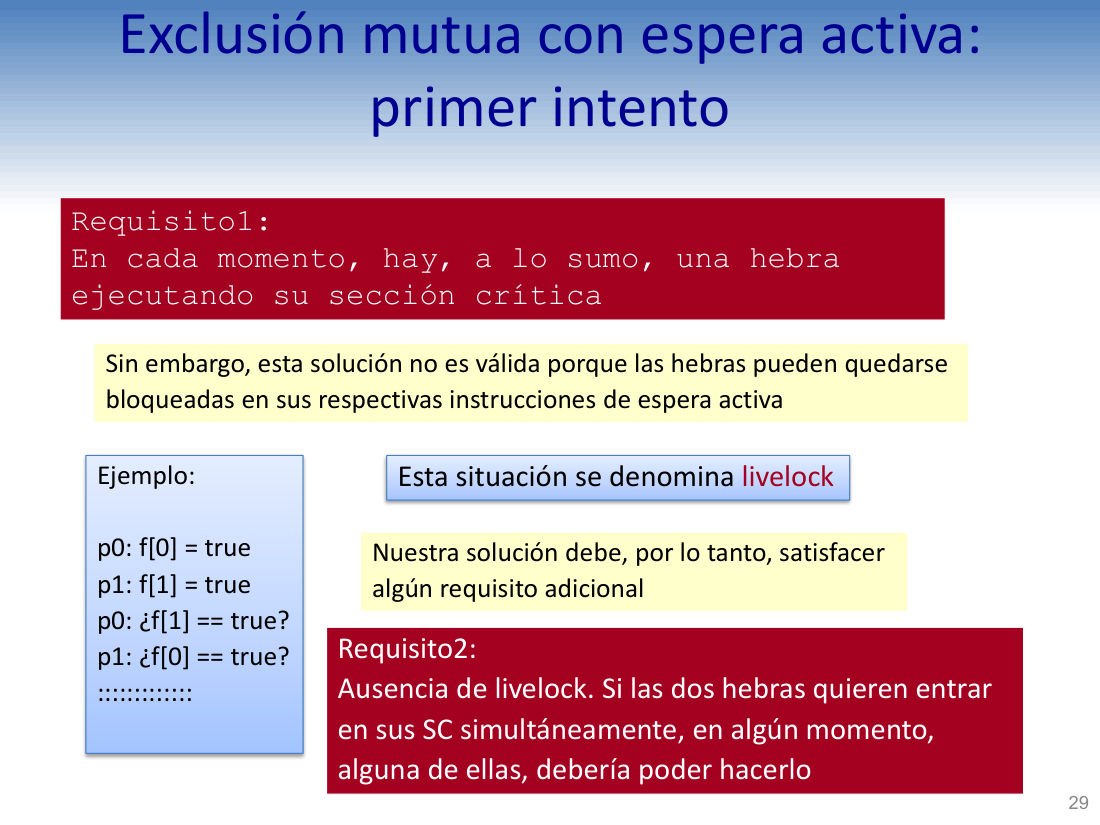
Sin embargo, esta solución no es válida porque las hebras pueden quedarse bloqueadas en sus respectivas instrucciones de espera activa
但是,这个解无效——两个线程可能各自卡在自己的忙等待指令里(bloqueadas = 被卡住)。
Ejemplo: p0: f[0] = true / p1: f[1] = true / p0: ¿f[1] == true? / p1: ¿f[0] == true? ………
例子:p0 举手、p1 举手,然后 p0 看 f[1] 是 true、p1 看 f[0] 也是 true —— 互相谦让,谁都不进。
Esta situación se denomina
这种情形称为活锁(livelock)——线程还在跑,但没有任何进展。
Nuestra solución debe, por lo tanto, satisfacer algún requisito adicional
因此我们的解必须满足额外的需求。
Requisito 2: Ausencia de livelock. Si las dos hebras quieren entrar en sus SC simultáneamente, en algún momento, alguna de ellas, debería poder hacerlo
需求 2:无活锁。如果两个线程同时想进 SC,那么在某个时刻,至少有一个应该能进去。
| 步 | p0 | p1 | f[0] | f[1] |
|---|---|---|---|---|
| 1 | f[0] = 1 | — | 1 | 0 |
| 2 | — | f[1] = 1 | 1 | 1 |
| 3 | while(f[1]) → 卡住 | while(f[0]) → 卡住 | 1 | 1 |
Segundo intento · 第二版:交换两行顺序
▸ 原页截图 p.30
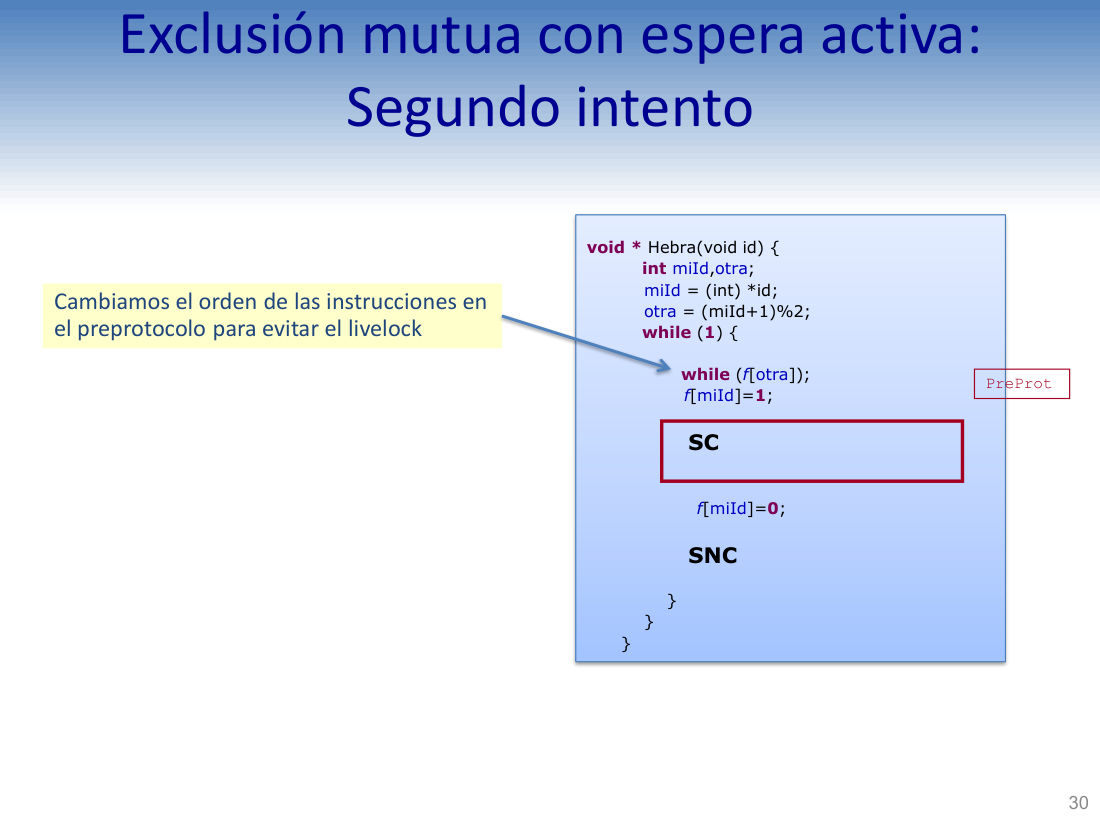
Exclusión mutua con espera activa: Segundo intento
忙等待互斥:第二次尝试。
void *Hebra(void id) { int miId, otra; miId = (int) *id; otra = (miId + 1) % 2;
线程函数开头不变:算出 miId 和 otra。
while (1) { while (f[otra]); f[miId] = 1; SC; f[miId] = 0; SNC }
循环里把两行顺序调换:先看对方(while f[otra]),再举手(f[miId]=1)。
PreProt: Cambiamos el orden de las instrucciones en el preprotocolo para evitar el livelock
批注:我们调换了前协议里两条指令的顺序,目的是避免 livelock。
// 与 p.27 的区别只在这一处顺序
while (1) {
  while (f[otra]);   // 先看对方(原来是第二行)
  f[miId] = 1;      // 再举手(原来是第一行)
  SC;
  f[miId] = 0;
  SNC;
}ERROR · 互斥被破坏:两个都在 SC 里
▸ 原页截图 p.31
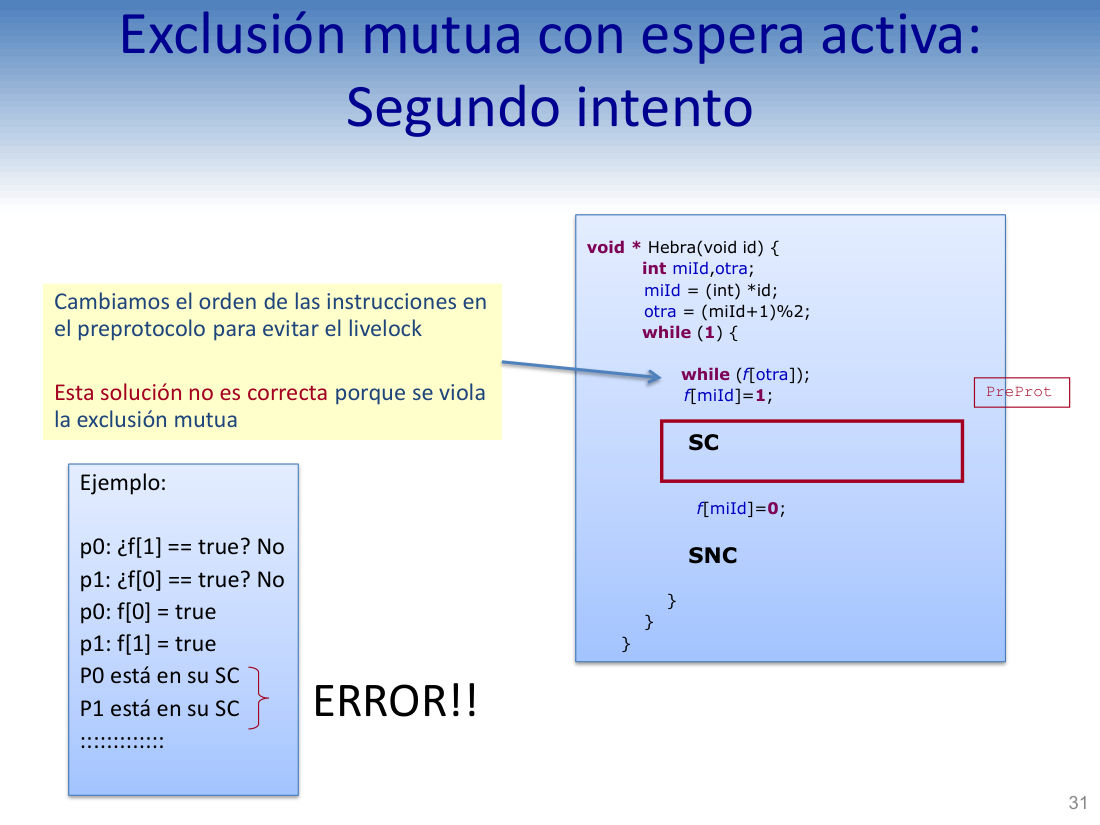
Esta solución no es correcta porque se viola la exclusión mutua
这个解不正确,因为互斥被破坏了(se viola = 被违反)。
Ejemplo: p0: ¿f[1] == true? No
例子:p0 看 f[1],答案是 No(p1 还没举手)。
p1: ¿f[0] == true? No
同一时刻 p1 看 f[0],答案也是 No(p0 也还没举手)。
p0: f[0] = true
然后 p0 举手 —— 但它已经通过了检查。
p1: f[1] = true
然后 p1 也举手 —— 它也早就通过了检查。
P0 está en su SC / P1 está en su SC / ::::::::::::: / ERROR!!
结果 P0 在 SC 里、P1 也在 SC 里 —— ERROR,互斥彻底失效。
| 步 | p0 | p1 | f[0] | f[1] |
|---|---|---|---|---|
| 1 | while(f[1]) → false,通过 | — | 0 | 0 |
| 2 | — | while(f[0]) → false,通过 | 0 | 0 |
| 3 | f[0] = 1 | — | 1 | 0 |
| 4 | — | f[1] = 1 | 1 | 1 |
| 5 | 进入 SC0 | 进入 SC1 | 1 | 1 |
Tercer intento · 第三版:单个 turno 变量
▸ 原页截图 p.32
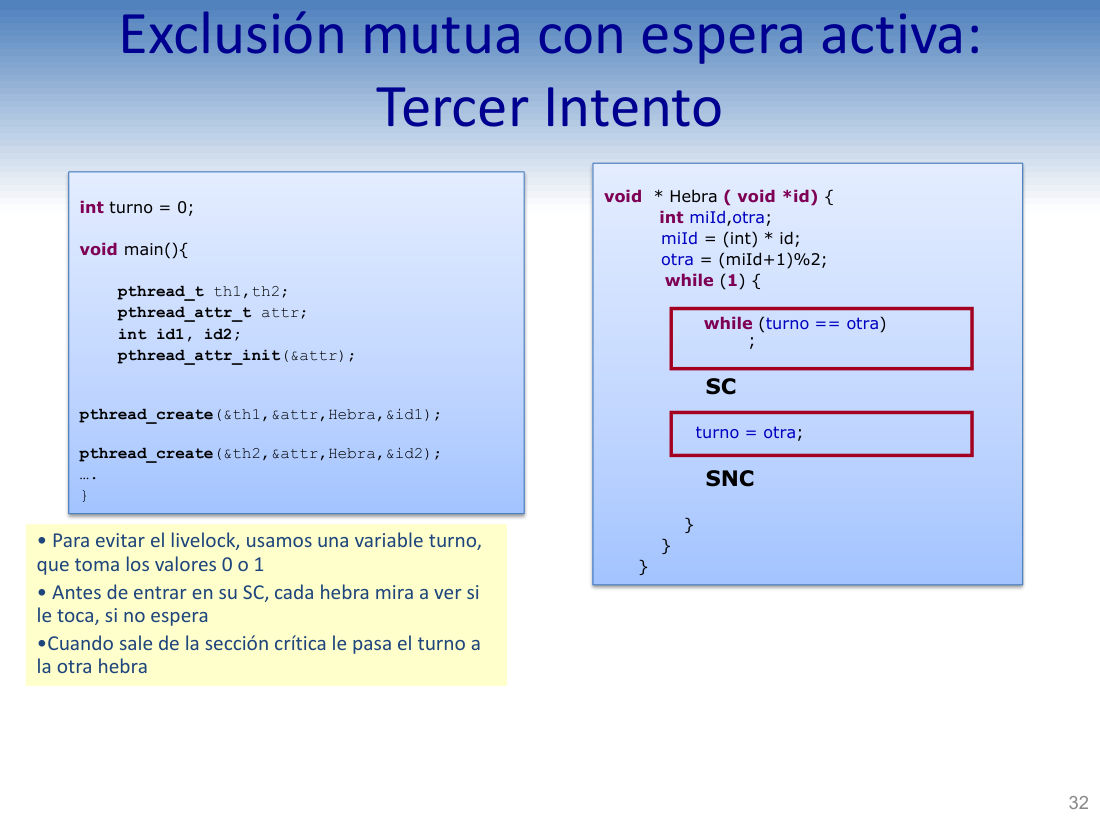
Exclusión mutua con espera activa: Tercer Intento
忙等待互斥:第三次尝试。
int turno = 0;
全局变量 turno(轮次),初值 0 = 轮到 0 号。
void main() { … pthread_create(&th1, &attr, Hebra, &id1); pthread_create(&th2, &attr, Hebra, &id2); }
主程序和之前一样,创建两个线程。
while (1) { while (turno == otra) ; SC; turno = otra; SNC }
循环:只要还没轮到我(turno == otra)就等 → 进 SC → 把轮次交给对方(turno = otra)→ SNC。
• Para evitar el livelock, usamos una variable turno, que toma los valores 0 o 1
• 为了避免 livelock,引入变量 turno,取值只有 0 或 1。
• Antes de entrar en su SC, cada hebra mira a ver si le toca, si no espera
• 进 SC 前,每个线程先看是否轮到自己(si le toca),没轮到就等。
• Cuando sale de la sección crítica le pasa el turno a la otra hebra
• 出临界区时,把轮次交给另一个线程。
int turno = 0;

void *Hebra(void *id) {
  int miId = (int) *id;
  int otra = (miId + 1) % 2;
  while (1) {
    while (turno == otra);  // 没轮到我 → 等
    SC;
    turno = otra;           // 交给对方
    SNC;
  }
}R3 被违反 · 严格轮流导致「想进也进不去」
▸ 原页截图 p.33
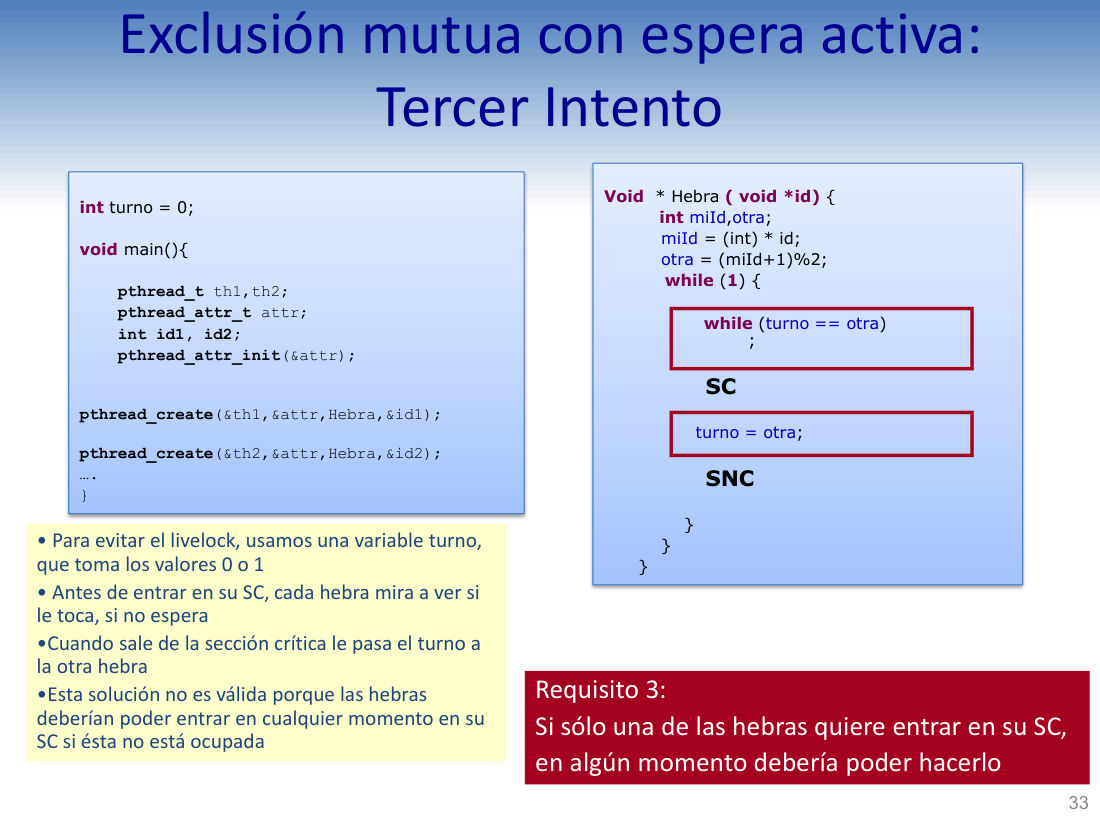
• Esta solución no es válida porque las hebras deberían poder entrar en cualquier momento en su SC si ésta no está ocupada
• 这个解仍然无效:只要 SC 空着,线程就应该能随时进去。
Requisito 3: Si sólo una de las hebras quiere entrar en su SC, en algún momento debería poder hacerlo
需求 3:如果只有一个线程想进 SC,那么它迟早应该能进(不能被无关的轮次卡住)。
| 情形 | turno | p1 想进 SC1 | 结果 |
|---|---|---|---|
| 正常轮流 | 1 | turno == miId,直接进 | OK |
| p0 不想进 | 0 | while(turno==otra) 永远为真 | p1 无限等(SC 明明空着) |
五、Peterson 算法:两个线程的完美解
Solución de Peterson · 第一次登场
▸ 原页截图 p.34
Exclusión mutua con espera activa: Solución de Peterson
忙等待互斥:Peterson 解法(并发课的「必修神作」)。
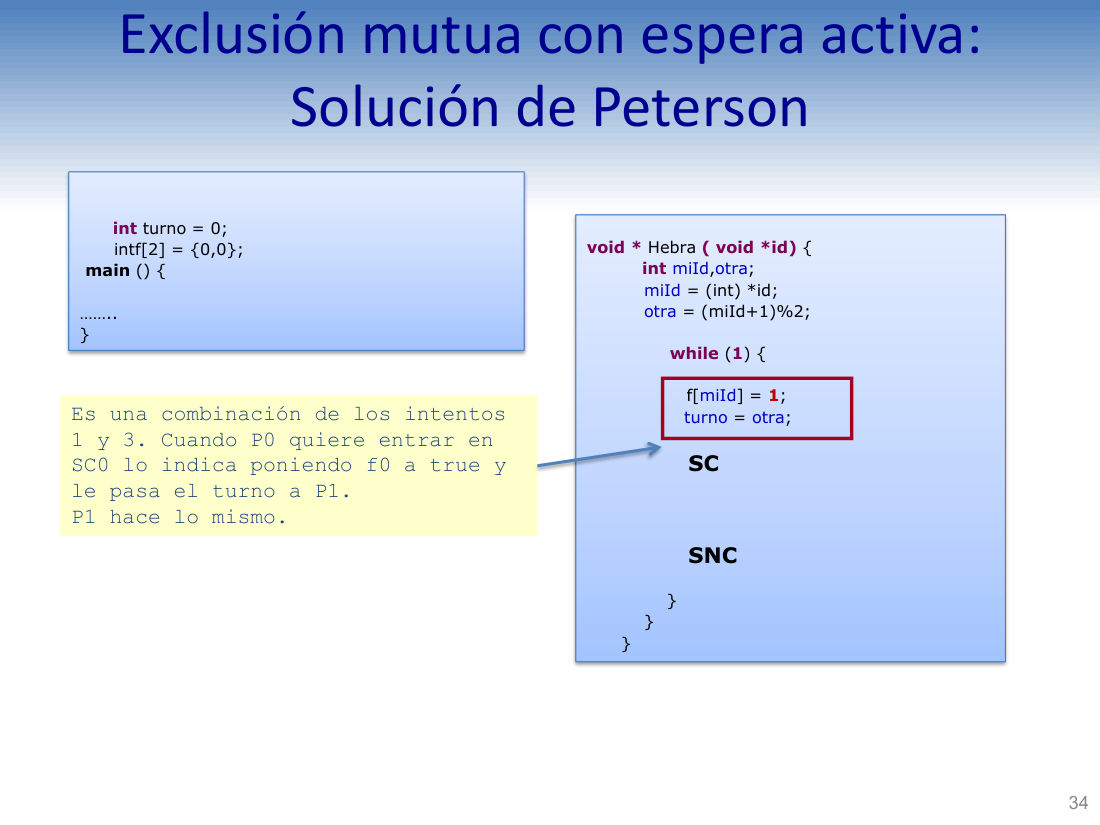
int turno = 0; int f[2] = {0, 0};
两个全局量:轮次 turno + 标志数组 f[2](讲义这里印成 intf[2],是排版漏空格)。
Es una combinación de los intentos 1 y 3.
它是第一次尝试(f[])和第三次尝试(turno)的结合。
Cuando P0 quiere entrar en SC0 lo indica poniendo f0 a true y le pasa el turno a P1.
当 P0 想进 SC0,它把 f[0] 置 true(= 举手),并把轮次让给 P1。
P1 hace lo mismo.
P1 做同样的事(f[1]=true,turno=0)。
while (1) { f[miId] = 1; turno = otra; SC; SNC }
循环:举手 → 让轮次 → SC → SNC。(注意本页代码不完整,见下方红框)
// 讲义 p.34 原样(不完整)
int turno = 0;
int f[2] = {0, 0};

void *Hebra(void *id) {
  int miId = (int) *id;
  int otra = (miId + 1) % 2;
  while (1) {
    f[miId] = 1;
    turno = otra;
    SC;
    SNC;
  }
}Peterson 完整代码(以本页为准)
▸ 原页截图 p.35
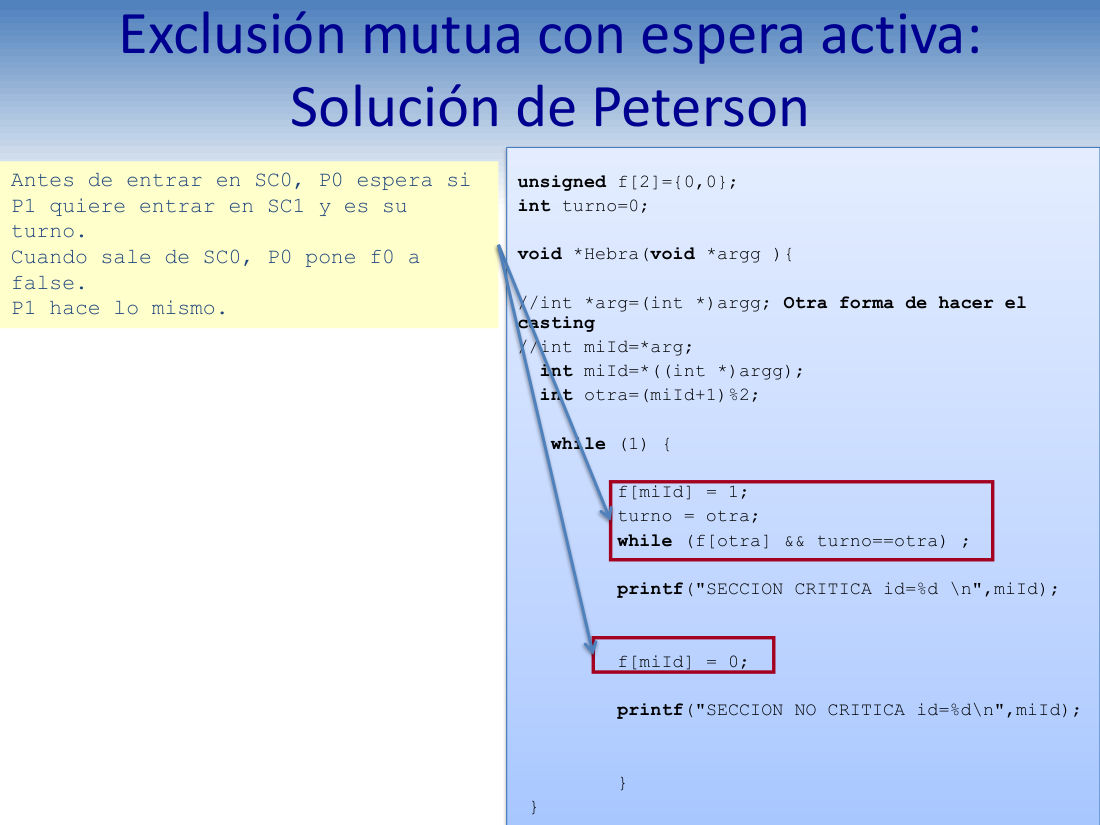
unsigned f[2] = {0, 0}; int turno = 0;
标志数组 + 轮次,初值全 0。
void *Hebra(void *argg) { // int *arg = (int *)argg; Otra forma de hacer el casting
线程函数:注释里给了另一种强制转换写法(先建指针再解引用)。
int miId = *((int *)argg); int otra = (miId + 1) % 2;
一行式转换:先把 argg 转成 int *,再解引用得 miId;otra 是同伙的编号。
while (1) { f[miId] = 1; turno = otra; while (f[otra] && turno == otra) ;
核心三步:举手 → 把轮次给对方 → 只有当「对方也想进」且「轮次在对方」时才等(&& 是逻辑与)。
printf("SECCION CRITICA id=%d \n", miId); f[miId] = 0;
进 SC 打印 → 出 SC 立刻放手(f[miId]=0)。
printf("SECCION NO CRITICA id=%d\n", miId); } }
打印 SNC,进入下一轮。
Antes de entrar en SC0, P0 espera si P1 quiere entrar en SC1 y es su turno.
批注:进 SC0 前,若「P1 想进」并且「轮次是 P1 的」,P0 就等。
Cuando sale de SC0, P0 pone f0 a false. P1 hace lo mismo.
出 SC0 时把 f[0] 置 false;P1 同理。
unsigned f[2] = {0, 0};
int turno = 0;

void *Hebra(void *argg) {
  int miId = *((int *)argg);   // 一行式 casting
  int otra = (miId + 1) % 2;
  while (1) {
    f[miId] = 1;                        // 1. 举手:我想进
    turno = otra;                        // 2. 谦让:轮次给你
    while (f[otra] && turno == otra);   // 3. 两个条件都成立才等
    printf("SECCION CRITICA id=%d \n", miId);
    f[miId] = 0;                        // 4. 出门放手
    printf("SECCION NO CRITICA id=%d\n", miId);
  }
}Peterson: R1 · 互斥成立,证法同第一版
▸ 原页截图 p.36
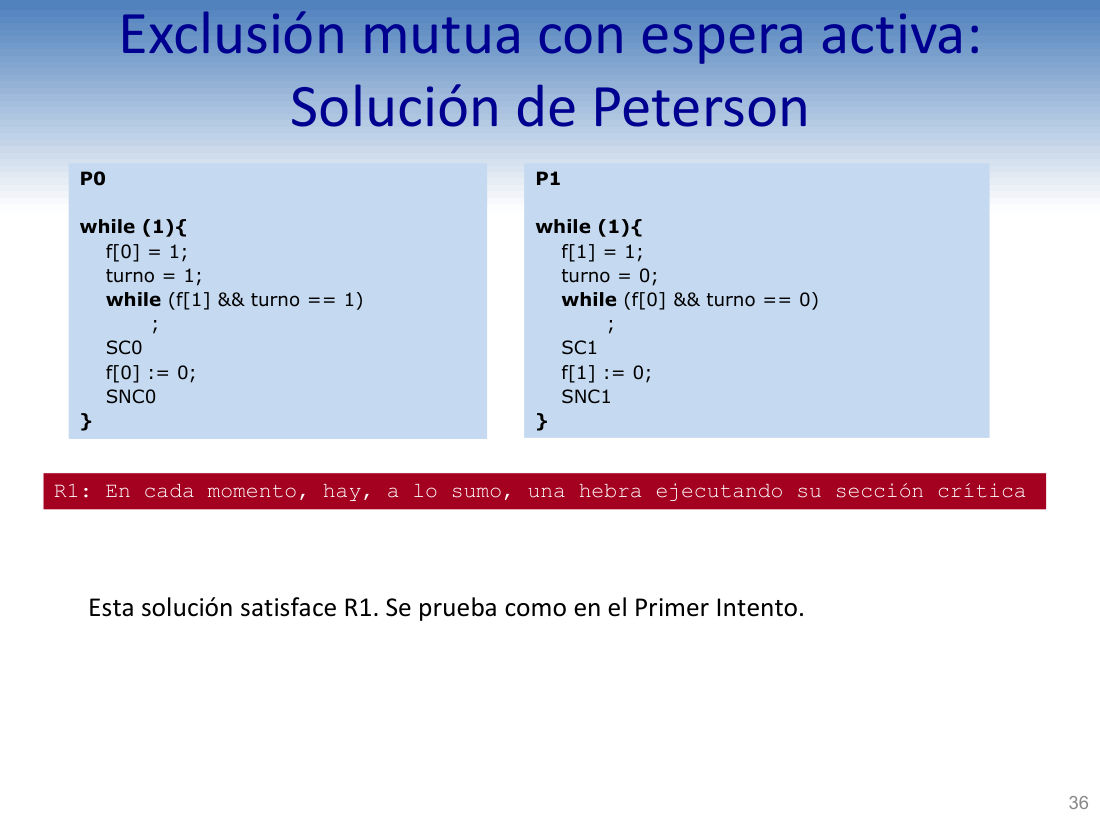
P0: while (1) { f[0] = 1; turno = 1; while (f[1] && turno == 1) ; SC0; f[0] := 0; SNC0 }
P0 的代码,把 miId / otra 全部展开成 0 / 1 的常量,方便逐步推演。
P1: while (1) { f[1] = 1; turno = 0; while (f[0] && turno == 0) ; SC1; f[1] := 0; SNC1 }
P1 的代码,完全对称:举手 f[1]、让轮次给 0、等条件是 (f[0] && turno==0)。
R1: En cada momento, hay, a lo sumo, una hebra ejecutando su sección crítica
R1:任何时刻至多一个线程在 SC 里。
Esta solución satisface R1. Se prueba como en el Primer Intento.
本解满足 R1,证明方法和第一次尝试相同(用不变量 f[i] ⟺ 在 SCi)。
f[0]=1 → turno=1 → while(f[1] && turno==1)
f[1]=1 → turno=0 → while(f[0] && turno==0)
Peterson: R2 · 为什么不会 livelock
▸ 原页截图 p.37
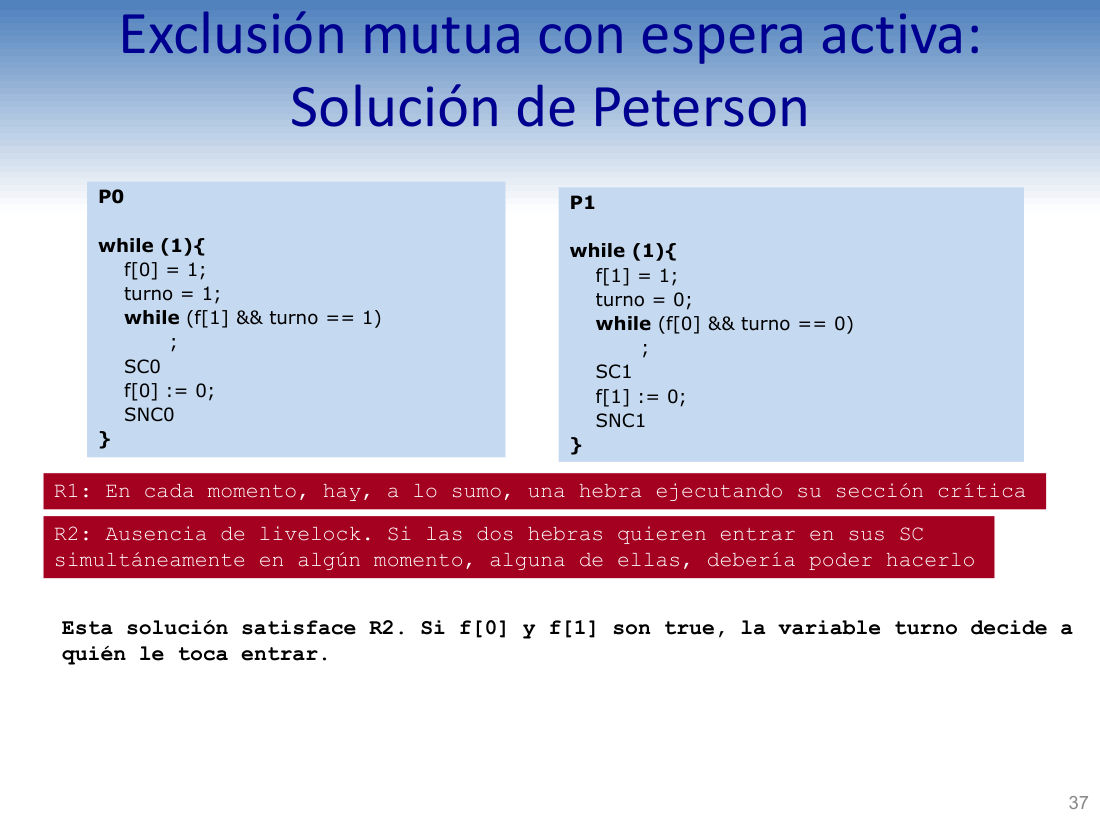
R2: Ausencia de livelock. Si las dos hebras quieren entrar en sus SC simultáneamente en algún momento, alguna de ellas, debería poder hacerlo
R2:无活锁。如果两个线程同时想进,那么某个时刻总有一个能进。
Esta solución satisface R2.
本解满足 R2。
Si f[0] y f[1] son true, la variable turno decide a quién le toca entrar.
如果 f[0]、f[1] 都是 true(都想进),那么 turno 决定谁能进——因为两人的等待条件里都有 turno == otra,turno 只能等于其中一个值,所以必然有一个人的条件为假,直接进。
| turno | P0 等待条件 f[1]&&turno==1 | P1 等待条件 f[0]&&turno==0 | 谁进 |
|---|---|---|---|
| 0 | true && 0==1 → false | true && 0==0 → true | P0 进,P1 等 |
| 1 | true && 1==1 → true | true && 1==0 → false | P1 进,P0 等 |
Peterson: R3 · 一个人想进时一定能进
▸ 原页截图 p.38
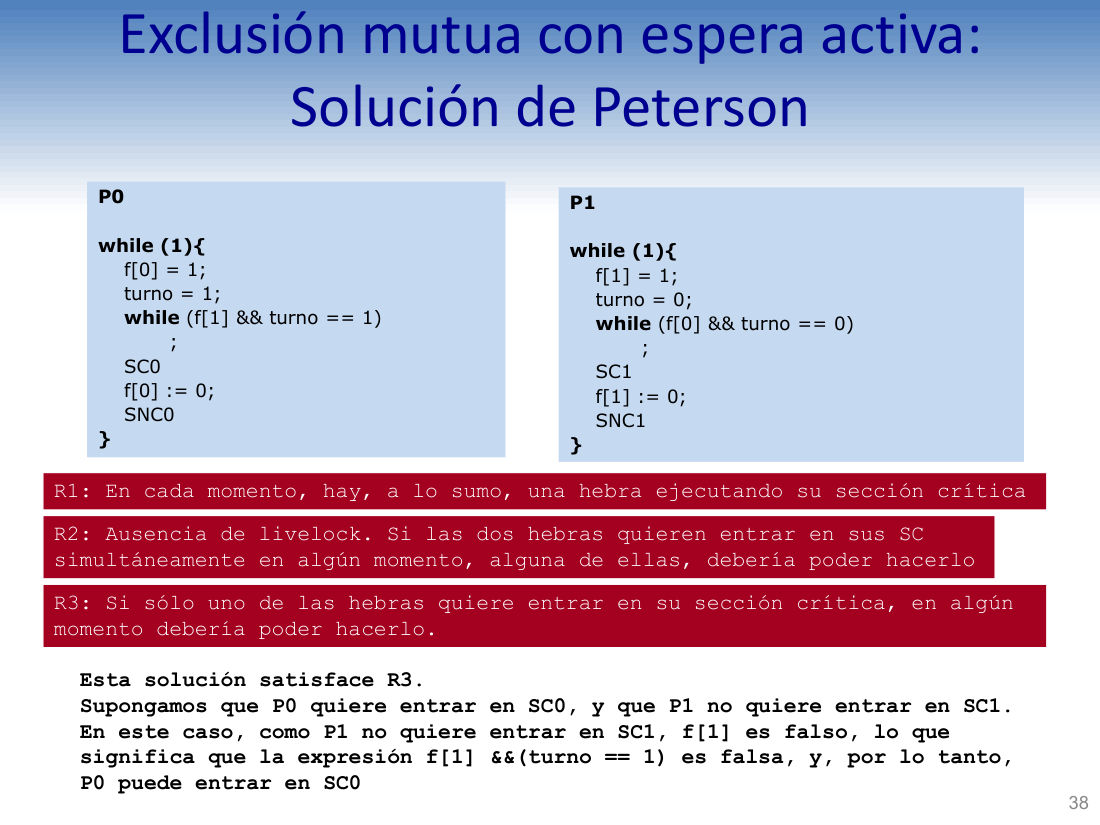
R3: Si sólo uno de las hebras quiere entrar en su sección crítica, en algún momento debería poder hacerlo.
R3:如果只有一个线程想进 SC,它迟早应该能进。(原文写 uno de las,应为 una de las,属笔误。)
Esta solución satisface R3.
本解满足 R3。
Supongamos que P0 quiere entrar en SC0, y que P1 no quiere entrar en SC1.
假设 P0 想进 SC0,而 P1 不想进 SC1。
En este caso, como P1 no quiere entrar en SC1, f[1] es falso,
这时,因为 P1 不想进,所以 f[1] 是 false。
lo que significa que la expresión f[1] && (turno == 1) es falsa,
这意味着表达式 f[1] && (turno == 1) 为 false(&& 有一个假就整体假)。
y, por lo tanto, P0 puede entrar en SC0
因此 P0 立刻能进 SC0——不管 turno 是多少。
f[1]=false ⇒ f[1]&&… = false ⇒ while 不进循环。
turno 被「与」短路了,一个人也能进。
Peterson: R4 公平性 · 「他自己把路堵上了」
▸ 原页截图 p.39
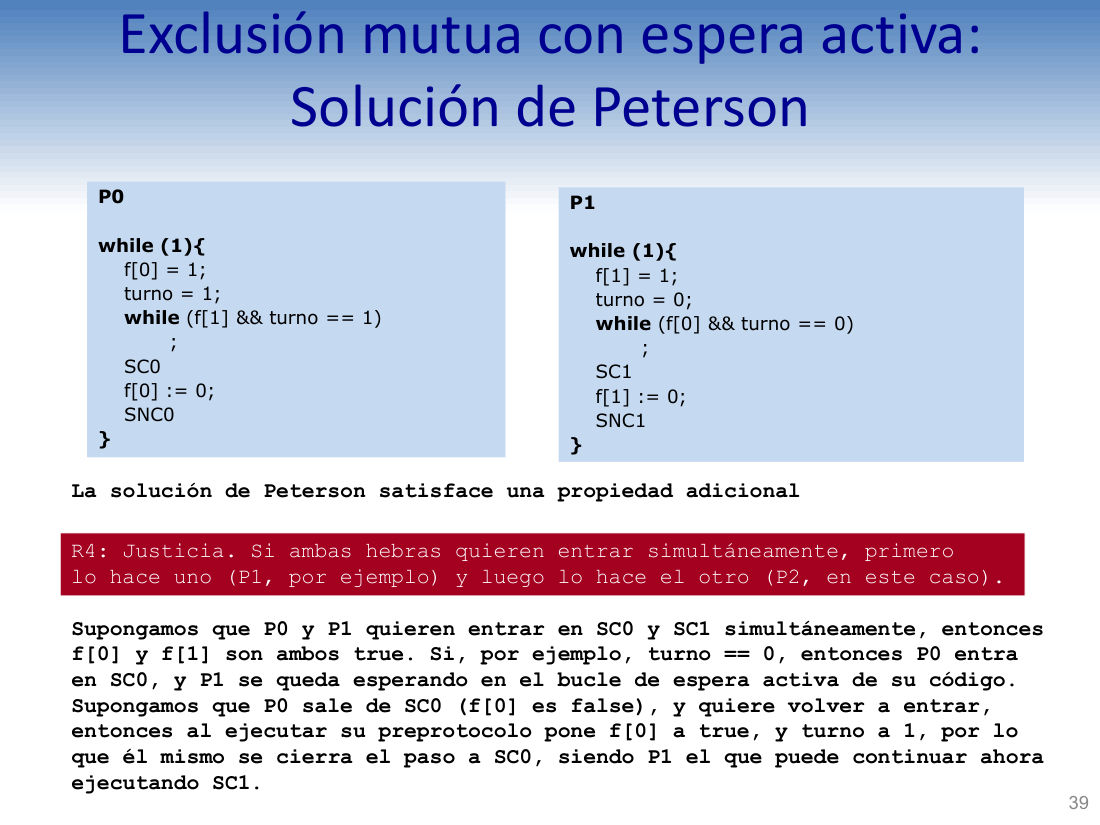
R4: Justicia. Si ambas hebras quieren entrar simultáneamente, primero lo hace uno (P1, por ejemplo) y luego lo hace el otro (P2, en este caso).
R4:公平性。若两者同时想进,则一个先进,然后另一个再进——不能有人一直被插队。
La solución de Peterson satisface una propiedad adicional
Peterson 还满足一条额外性质(即 R4)。
Supongamos que P0 y P1 quieren entrar en SC0 y SC1 simultáneamente, entonces f[0] y f[1] son ambos true.
假设 P0、P1 同时想进,则 f[0]、f[1] 都为 true。
Si, por ejemplo, turno == 0, entonces P0 entra en SC0, y P1 se queda esperando en el bucle de espera activa de su código.
若此时 turno == 0,则 P0 进 SC0,P1 留在忙等循环里。
Supongamos que P0 sale de SC0 (f[0] es false), y quiere volver a entrar,
假设 P0 出了 SC0(f[0]=false),又想再进一次。
entonces al ejecutar su preprotocolo pone f[0] a true, y turno a 1, por lo que él mismo se cierra el paso a SC0,
那它执行前协议时会把 f[0] 置 true、turno 置 1 —— 于是它自己把进 SC0 的路堵死了。
siendo P1 el que puede continuar ahora ejecutando SC1.
轮到 P1 可以继续去执行 SC1。
| 阶段 | f[0] | f[1] | turno | 谁在 SC |
|---|---|---|---|---|
| 同时想进 | 1 | 1 | 0 | P0 进,P1 等 |
| P0 出门后想再进 | 1 | 1 | 1 | P1 进(P0 自己让出) |
六、Lamport 面包店算法:推广到 N 个线程
El algoritmo de la panadería · 问题陈述
▸ 原页截图 p.40
El algoritmo de la panadería (Lamport)
面包店算法(Lamport)—— 名字来源:面包店取号排队。
• El algoritmo de la panadería resuelve el problema de la exclusión mutua para N >= 2 hebras, utilizando espera activa como mecanismo de sincronización
• 面包店算法解决 N ≥ 2 个线程的互斥问题,同步机制仍是忙等待。
• No es un algoritmo justo porque no trata a todas las hebras del mismo modo
• 它不是「公平」算法——因为它不把所有线程一视同仁(先来的优先,后来的排队)。
• Enunciado: Se supone que tenemos N clientes que desean ser atendidos en una panadería.
• 题目陈述:假设有 N 个顾客想在面包店被服务。
El dependiente representa el recurso compartido que debe ser utilizado en exclusión mutua por todos los clientes
店员(dependiente)代表共享资源,必须被所有顾客互斥使用。
(no se puede atender a dos o más clientes simultáneamente)
(不能同时服务两个或更多顾客。)
N 个顾客 = N 个 hebras。
店员 = recurso compartido(不是 hebra)。
号码牌 = 排队顺序。
Peterson 只解决 2 个,这里推广到 N 个。
Ilustración · 图示:小店只能进一个人
▸ 原页截图 p.41(插图页)
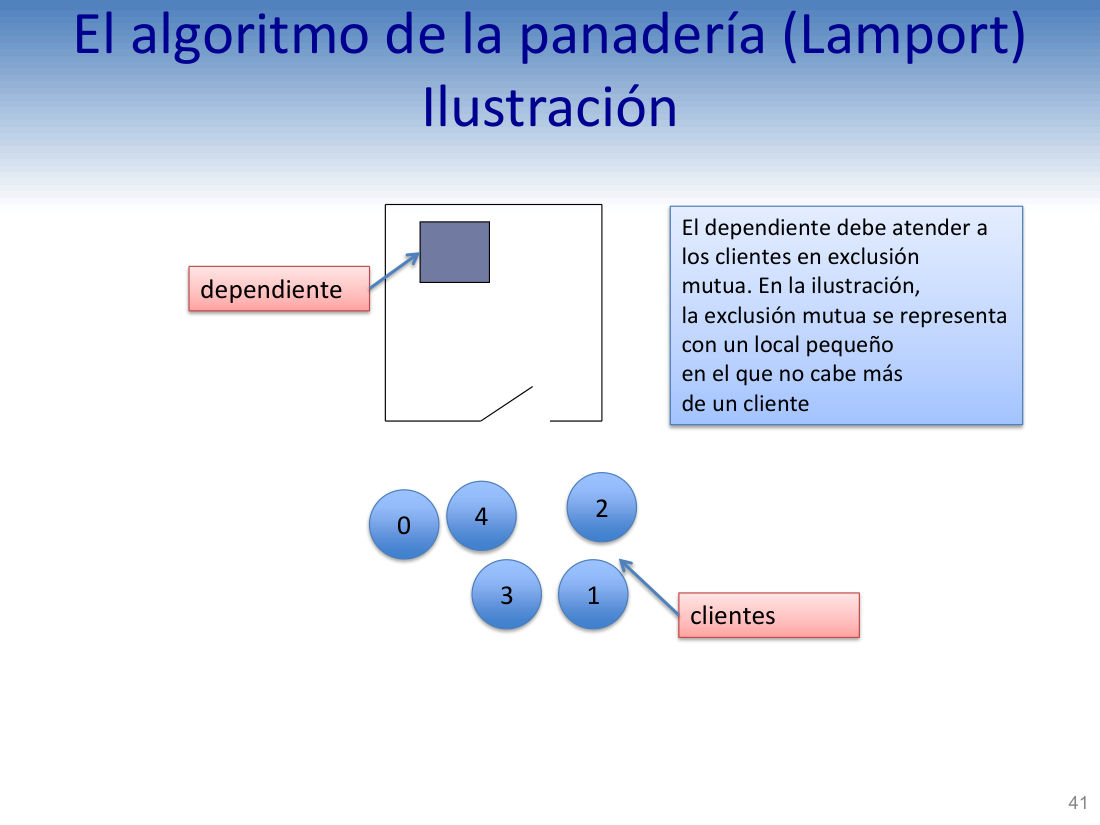
El algoritmo de la panadería (Lamport) — Ilustración
面包店算法 —— 图示。
El dependiente debe atender a los clientes en exclusión mutua.
店员必须互斥地服务顾客。
En la ilustración, la exclusión mutua se representa con un local pequeño en el que no cabe más de un cliente
图中用一个很小、只容得下一个顾客的店面来表示互斥(no cabe más de un cliente = 装不下一个以上)。
Estructura del Código: Hebras · 代码骨架
▸ 原页截图 p.42
Estructura del Código: Hebras
代码结构:线程部分。
/*Preprotocolo*/ // el cliente id es atendido por el dependiente
前协议:顾客 id 被店员服务。
/*Posprotocolo*/ // el cliente id sale de la panadería
后协议:顾客 id 离开面包店。
• N (=15) clientes llegan a la panadería y son atendidos en exclusión mutua.
• N(=15)个顾客来到面包店,被互斥地服务。
• El empleado es el recurso compartido, es decir, una entidad pasiva, que no hace falta implementar como hebra.
• 店员是共享资源,也就是一个被动实体(entidad pasiva),不需要实现成线程。
void *Hebra(void *argg) {
  int id = *((int *)argg);   // 我是几号顾客
  /* Preprotocolo */            // 取号 + 排队等
  SC;                            // 被店员服务(共享资源)
  /* Posprotocolo */            // 号码归零,离店
}Ilustración · 进门先问「¿cuál es mi turno?」
▸ 原页截图 p.43(插图页)
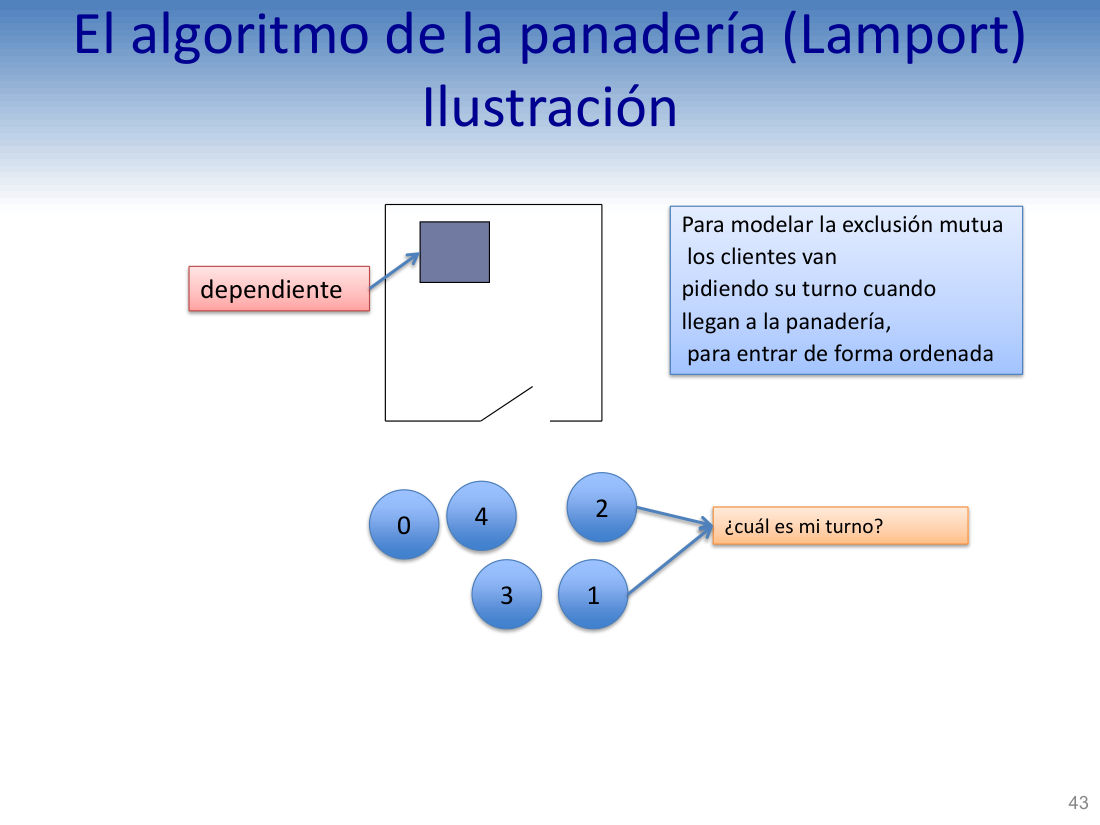
Para modelar la exclusión mutua los clientes van pidiendo su turno cuando llegan a la panadería, para entrar de forma ordenada
为了建模互斥,顾客一到面包店就取号(pidiendo su turno),以便有序进入(de forma ordenada)。
¿cuál es mi turno?
「我的号是几?」——图上的对话气泡,就是调用 siguiente()。
Estructura del Código: turno · 号码数组
▸ 原页截图 p.44
Estructura del Código: turno
代码结构:turno 数组。
• Para modelar el turno, usamos un array con N componentes (una por hebra)
• 用长度为 N 的数组表示号码,每个线程一个分量。
• Para cada hebra id, turno[id] == 0 sii no quiere acceder a su sección crítica.
• 对线程 id 而言,turno[id] == 0 当且仅当它不想进临界区。
Por eso, inicialmente todos los turnos están a 0, que es como decir que todos los clientes están fuera de la panadería
因此初始时所有号码都是 0——相当于所有顾客都还在店外。
int N = 15;
int turno[N];   // 全 0:没人排队(都在店外)

// turno[id] = 0  ⟺  hebra id no quiere entrar
// turno[id] > 0 → 拿到的号码,越小越早被服务| turno[i] | 含义 |
|---|---|
| 0 | 不在排队(不在店里 / 已离开) |
| 1, 2, 3 … | 号码,数值越小越先 |
Estructura del Código: siguiente · 取号函数
▸ 原页截图 p.45
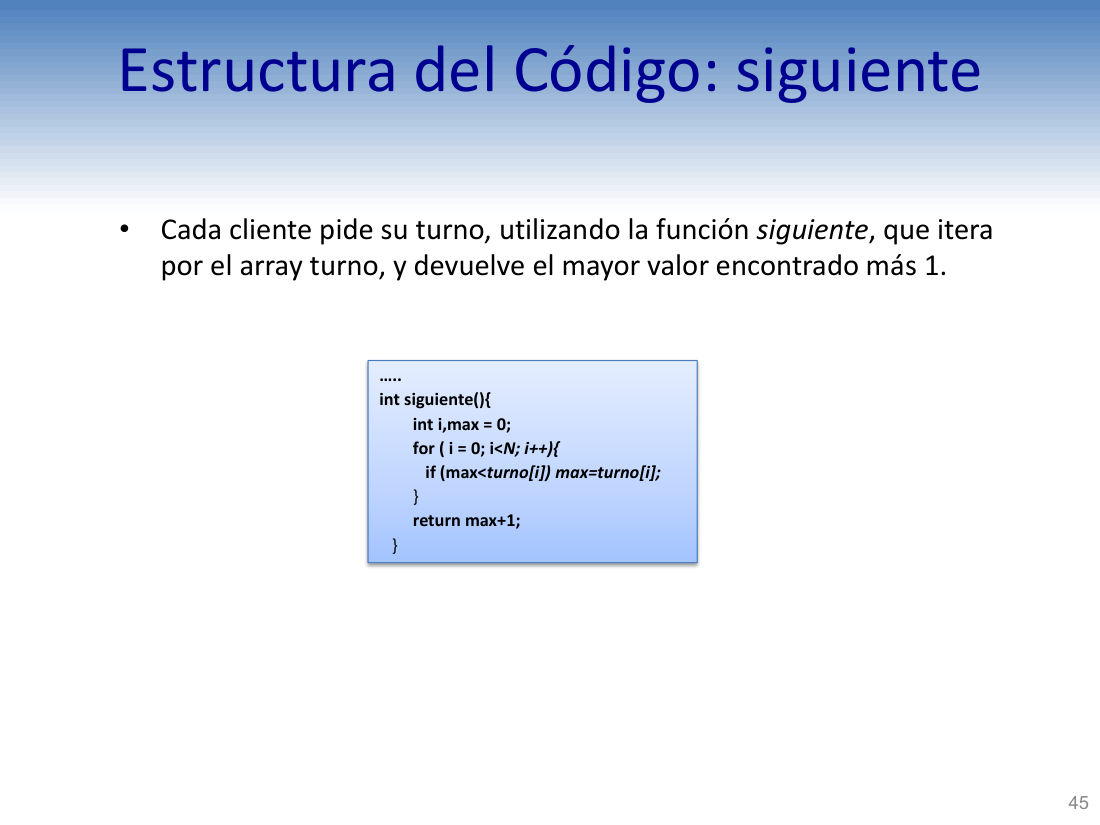
Estructura del Código: siguiente
代码结构:siguiente(下一个号)。
int siguiente() { int i, max = 0; for (i = 0; i < N; i++) { if (max < turno[i]) max = turno[i]; } return max + 1; }
遍历整个 turno 数组求最大值,然后返回 max + 1 = 下一个号。
• Cada cliente pide su turno, utilizando la función siguiente, que itera por el array turno, y devuelve el mayor valor encontrado más 1.
• 每个顾客用 siguiente 取号:它遍历 turno 数组,返回找到的最大值加 1。
int siguiente() {
  int i, max = 0;
  for (i = 0; i < N; i++) {
    if (max < turno[i])
      max = turno[i];   // 找当前最大号
  }
  return max + 1;          // 新号 = 最大 + 1
}| 当前 turno[] | max | siguiente() 返回 |
|---|---|---|
| [0,0,0,0,0] | 0 | 1 |
| [1,0,0,0,0] | 1 | 2 |
| [1,0,2,0,0] | 2 | 3 |
Ilustración · 第二位顾客取号 → 2
▸ 原页截图 p.46(插图页)
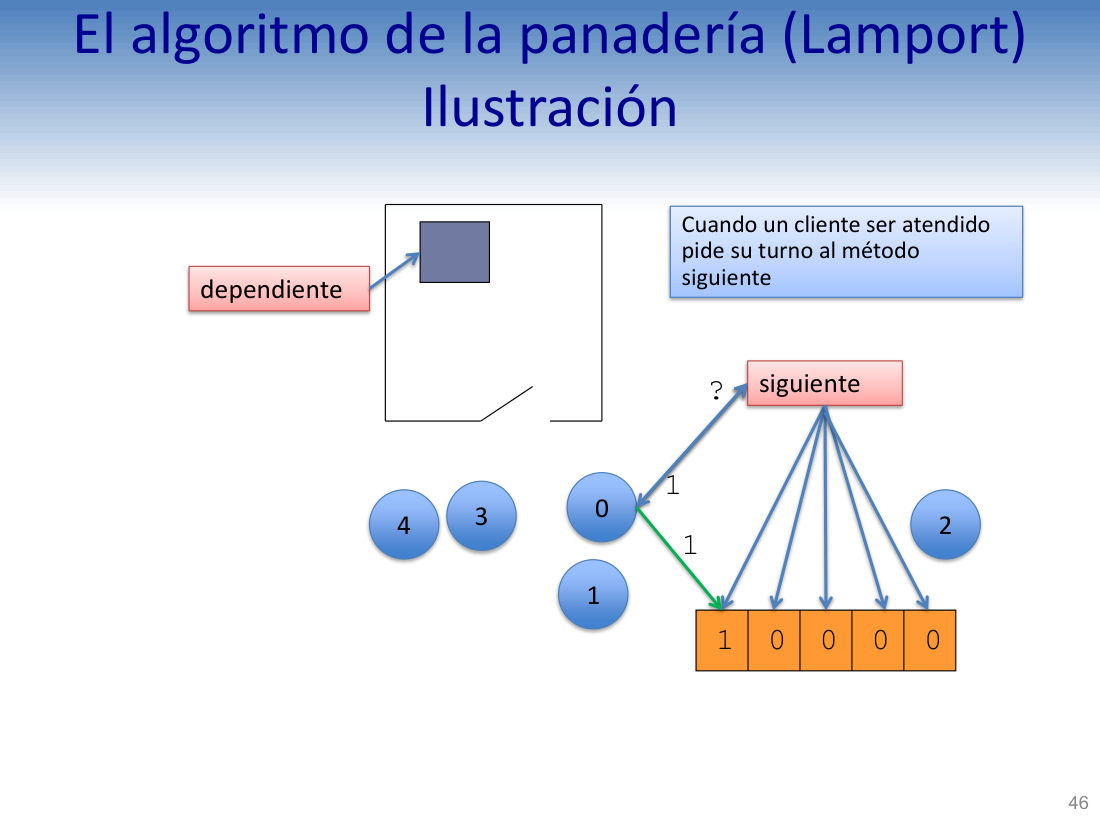
Cuando un cliente ser atendido pide su turno al método siguiente
当一个顾客要被服务时,向 siguiente 方法取号(原文 ser 应为 va a ser,属笔误)。
turno: 1 0 0 0 0 → siguiente → 1
数组里已经有一个 1,其他都是 0 → max = 1 → 返回 2(图上「?」的位置)。
Ilustración · 第三位顾客取号 → 3
▸ 原页截图 p.47(插图页)
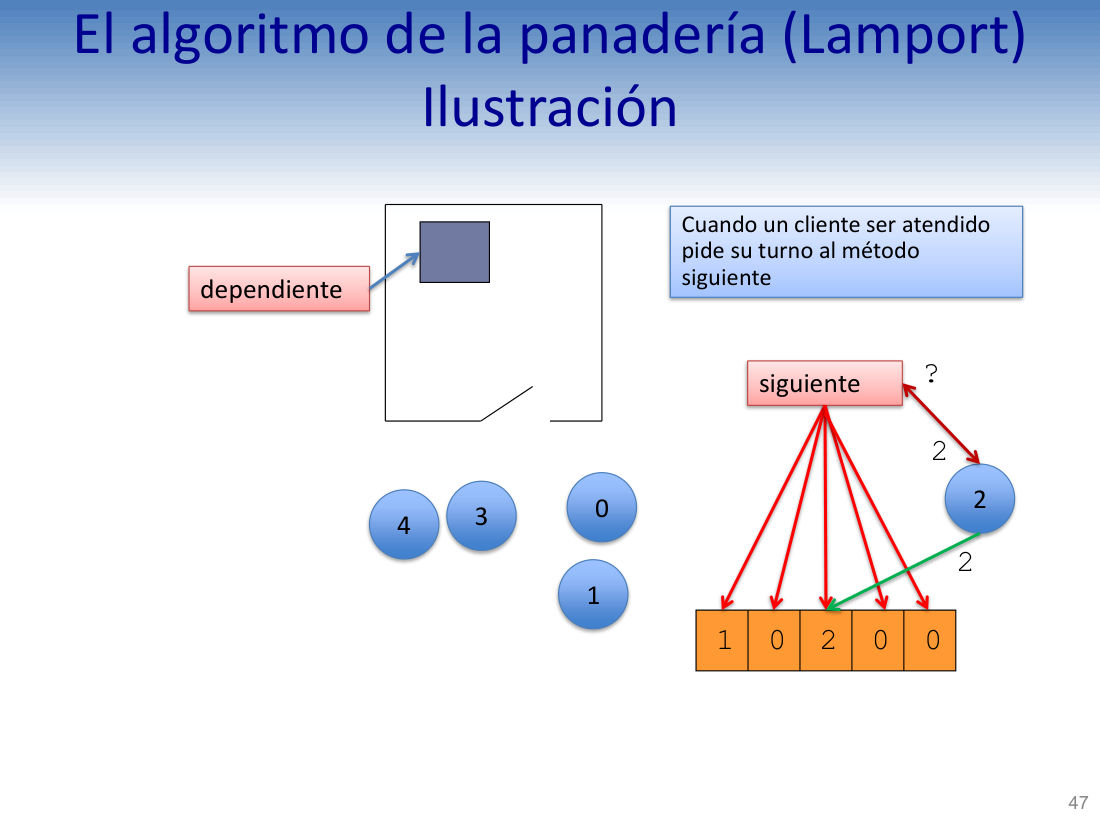
Cuando un cliente ser atendido pide su turno al método siguiente
同样是「顾客取号」的场景,只是数组又变了。
turno: 1 0 2 0 0 → siguiente → 2
数组里已有 1 和 2 → max = 2 → 新号 = 3(图上「?」处)。
Ilustración · meToca:比较谁的号更小
▸ 原页截图 p.48(插图页)
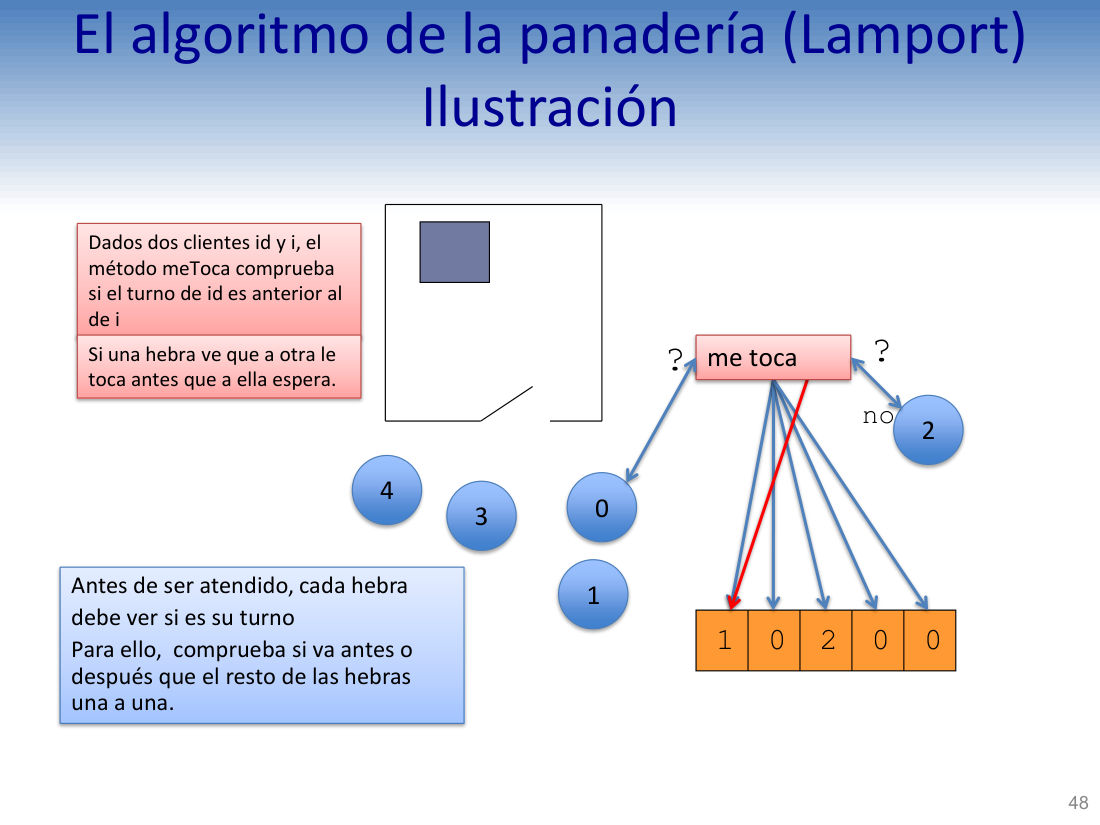
Dados dos clientes id y i, el método meToca comprueba si el turno de id es anterior al de i
给定两个顾客 id 和 i,meToca 方法判断:id 的号码是否早于(anterior)i 的号码。
Antes de ser atendido, cada hebra debe ver si es su turno
被服务之前,每个线程必须确认是不是轮到自己。
Para ello, comprueba si va antes o después que el resto de las hebras una a una.
为此它要逐个(una a una)与其余所有线程比较先后。
Si una hebra ve que a otra le toca antes que a ella espera.
如果某线程发现有别人比自己更早,它就等。
me toca → ? → no → ?
图上的判断链:「轮到我吗?」→ 否 → 继续等。
「id 是否应该排在 i 前面?」
要和每一个 i 都比一遍,全通过才进。
Estructura del Código: meToca · 完整实现
▸ 原页截图 p.49
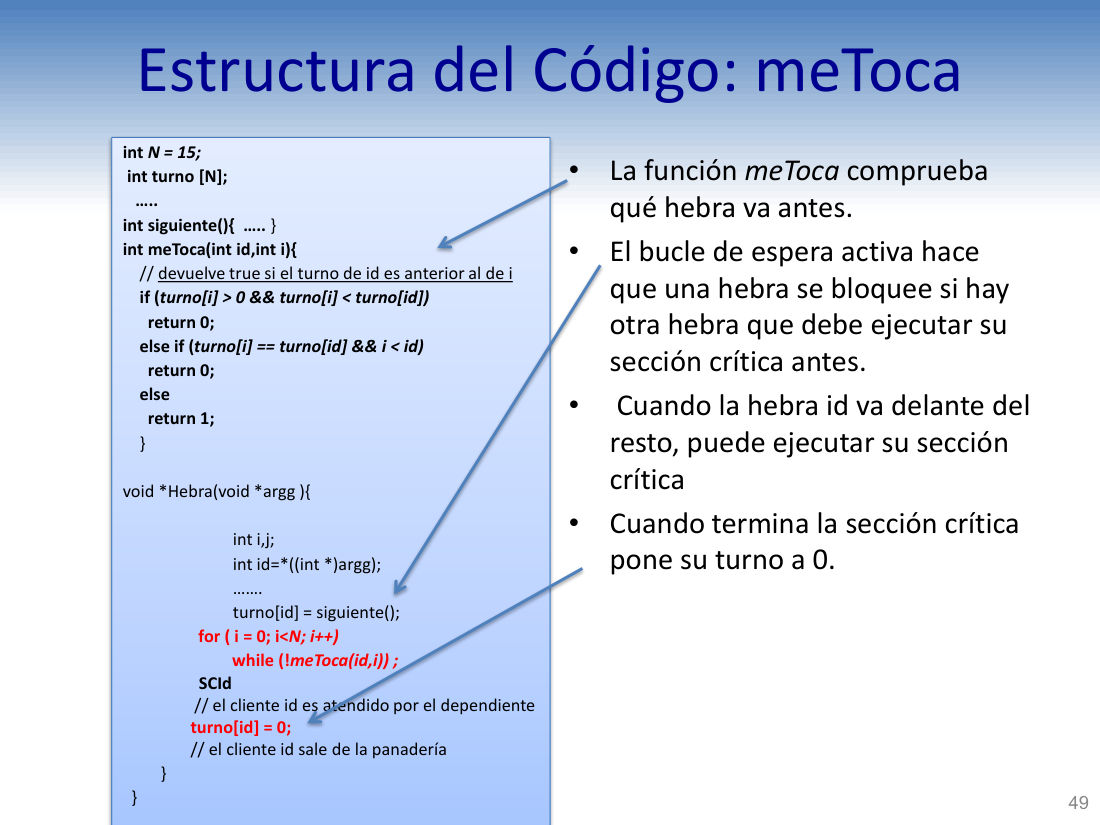
int N = 15; int turno[N];
15 个线程,号码数组长度 15。
int meToca(int id, int i) { // devuelve true si el turno de id es anterior al de i
返回值语义:若 id 的号早于 i 的号 → 返回 true(可以进)。
if (turno[i] > 0 && turno[i] < turno[id]) return 0;
分支 1:i 在排队(>0)且号比我小 → 我不能进(返回 0 = false)。
else if (turno[i] == turno[id] && i < id) return 0;
分支 2:号码相同(平局)且 i 的 id 更小 → 也让我等(返回 0)。这就是打破平局的规则。
else return 1;
分支 3:其他所有情况 → 返回 1(true,我能进)。
void *Hebra(void *argg) { int i, j; int id = *((int *)argg); turno[id] = siguiente();
线程函数:先取号,存进 turno[id]。
for (i = 0; i < N; i++) while (!meToca(id, i)) ;
对每个 i(0 到 N-1)忙等,直到「轮到我」为止。
SCId // el cliente id es atendido por el dependiente
进临界区:被店员服务。
turno[id] = 0; // el cliente id sale de la panadería
号码归零 = 离店,放行后面的人。
• La función meToca comprueba qué hebra va antes.
• meToca 判断哪个线程更靠前。
• El bucle de espera activa hace que una hebra se bloquee si hay otra hebra que debe ejecutar su sección crítica antes.
• 忙等循环让线程在「有人该先执行 SC」时卡住等。
• Cuando la hebra id va delante del resto, puede ejecutar su sección crítica
• 当 id 排在所有人前面时,才能执行自己的临界区。
• Cuando termina la sección crítica pone su turno a 0.
• 临界区结束后把自己的号码置 0。
int N = 15;
int turno[N];

int meToca(int id, int i) {
  if (turno[i] > 0 && turno[i] < turno[id]) return 0;   // i 号更小 → 让
  else if (turno[i] == turno[id] && i < id) return 0;  // 平局:id 小者优先
  else return 1;                                     // 我先进
}

void *Hebra(void *argg) {
  int id = *((int *)argg);
  turno[id] = siguiente();              // 1. 取号
  for (int i = 0; i < N; i++)
    while (!meToca(id, i));             // 2. 逐个比较,等
  SC;                                   // 3. 被服务
  turno[id] = 0;                       // 4. 离店,号归零
}缺陷 · siguiente 不在互斥中执行 → 可能重号
▸ 原页截图 p.50(插图页)
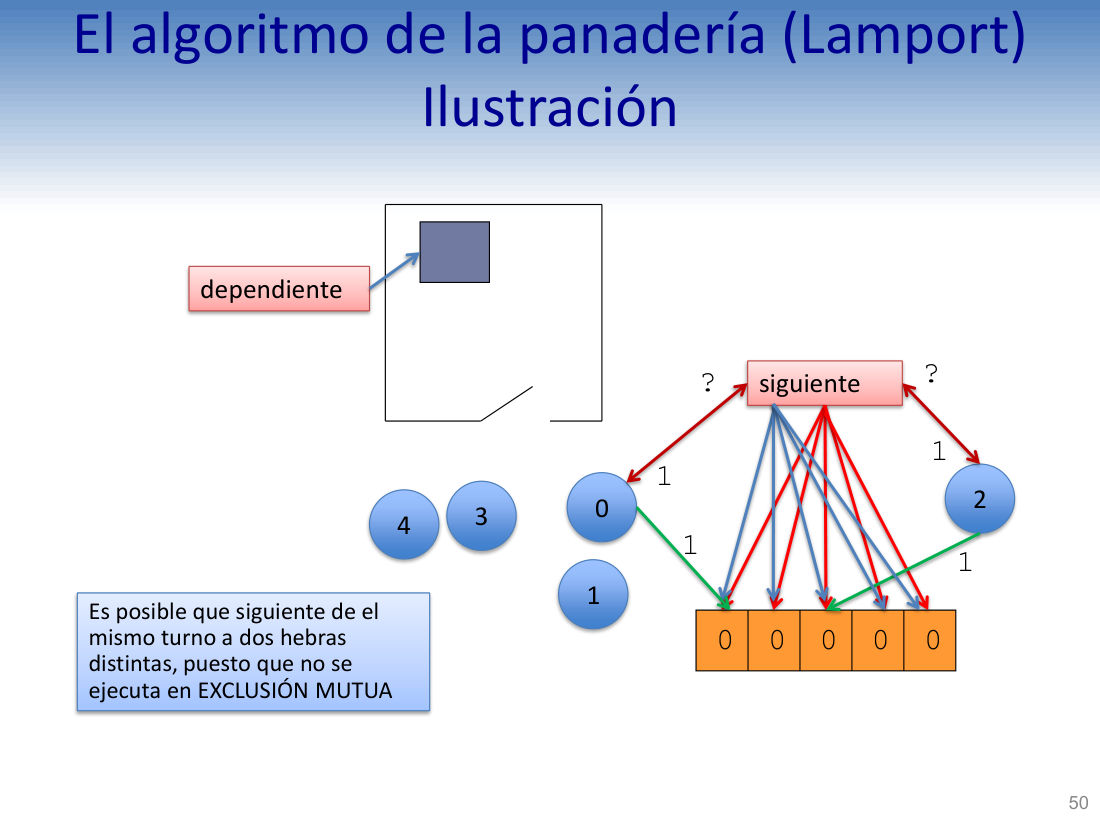
Es posible que siguiente de el mismo turno a dos hebras distintas, puesto que no se ejecuta en EXCLUSIÓN MUTUA
siguiente 可能给两个不同的线程发同一个号,因为它本身不是在互斥下执行的(大写 EXCLUSIÓN MUTUA 就是老师划的重点)。
| 步 | p0 | p1 | turno[] |
|---|---|---|---|
| 1 | siguiente() 读到 max=0 | — | [0,0,0,0,0] |
| 2 | — | siguiente() 读到 max=0 | [0,0,0,0,0] |
| 3 | turno[0] = 1 | turno[1] = 1 | [1,1,0,0,0] 重号! |
七、面包店的致命缺陷与修补:pidiendoTurno
El algoritmo de la panadería · Ilustración:两个人同时取到 1 号
▸ 原页截图 p.51(插图页)
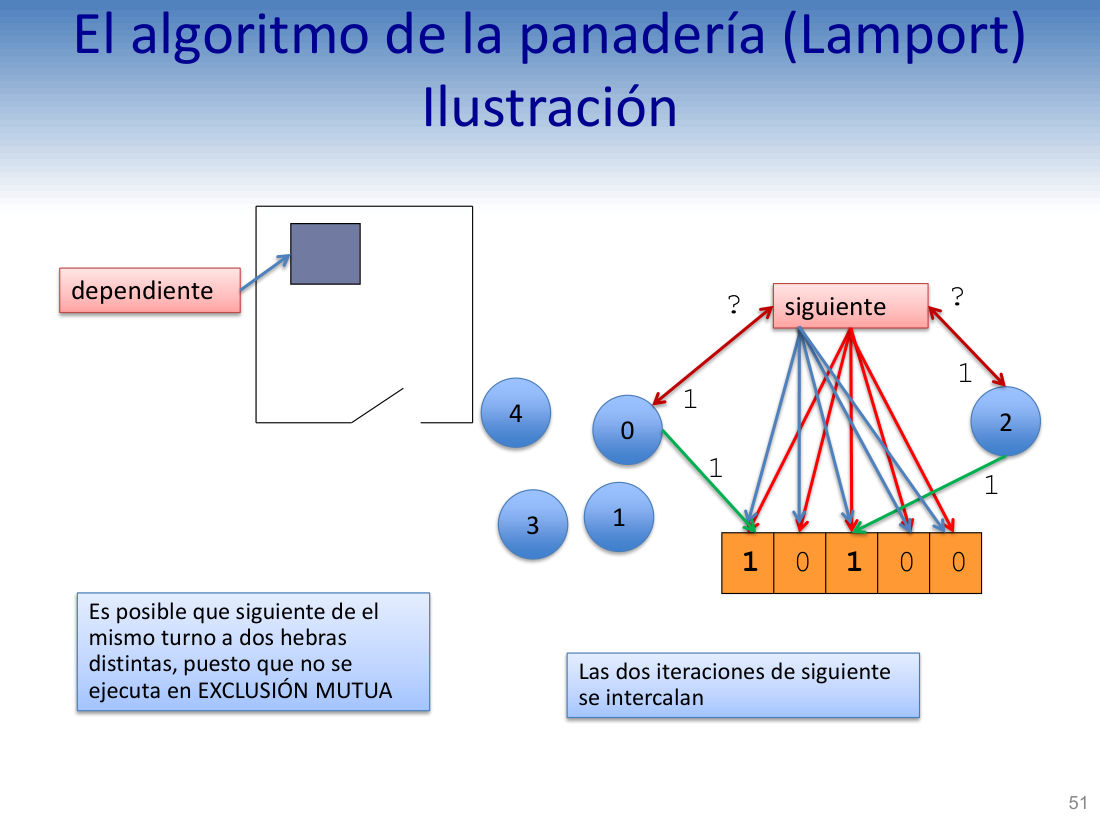
Es posible que siguiente dé el mismo turno a dos hebras distintas, puesto que no se ejecuta en EXCLUSIÓN MUTUA
siguiente 完全可能给两个不同线程发同一个号,因为它自己不是在互斥下执行的(原文写 «de el»,应为 «dé el»,属笔误;大写 EXCLUSIÓN MUTUA 是老师划的重点)。
Las dos iteraciones de siguiente se intercalan
两次 siguiente() 的迭代交错(se intercalan)执行了——这就是重号的根源。
dependiente
「店员」——图中间那个负责叫号的人,对应代码里的临界区执行者。
图上五位顾客 0 1 2 3 4 都在店里,turno 数组当时是 [1,0,1,0,0]:顾客 0 和顾客 2 手上都拿着 1 号。看图顺序:先看下面那排 turno,再往右看 siguiente 的返回值(打「?」的地方)。
| 步 | hebra 0 | hebra 2 | turno[] |
|---|---|---|---|
| 1 | siguiente() 读到 max = 0 | — | [0,0,0,0,0] |
| 2 | (被抢占,还没存) | siguiente() 读到 max = 0 | [0,0,0,0,0] |
| 3 | turno[0] = 1 | turno[2] = 1 | [1,0,1,0,0] 重号! |
Estructura del Código: meToca · 三行判断的完整版
▸ 原页截图 p.52
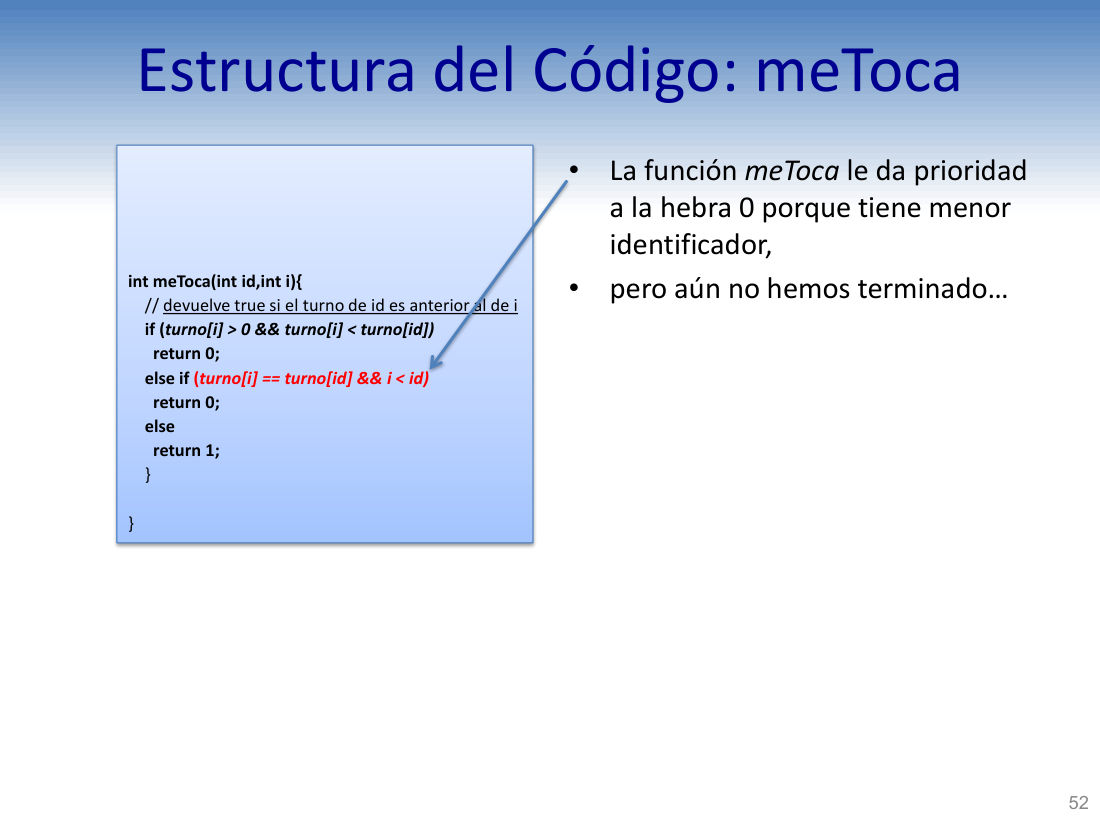
int meToca(int id, int i){
函数签名:判断「我的号是否该排在 i 前面」,id 是我,i 是别人。
// devuelve true si el turno de id es anterior al de i
注释:若 id 的号早于 i 的号就返回 true(注意代码里用 1/0 表示 true/false)。
if (turno[i] > 0 && turno[i] < turno[id]) return 0;
分支①:i 在排队(>0)且号比我小 → 让(返回 0)。
else if (turno[i] == turno[id] && i < id) return 0;
分支②:重号(平局)且 i 的 id 更小 → 也让(返回 0)。
else return 1;
分支③:其余情况 → 我能进(返回 1)。
La función meToca le da prioridad a la hebra 0 porque tiene menor identificador
meToca 让 0 号线程天然占优,因为它 id 最小——平局时 i < id 永远判 0 号赢。
pero aún no hemos terminado…
但我们还没完……(老师留的悬念:这个「id 小的优先」会在 p.53 出大问题)。
int meToca(int id, int i) {
  // devuelve true si el turno de id es anterior al de i
  if (turno[i] > 0 && turno[i] < turno[id]) return 0;   // ① 别人号更小 → 让
  else if (turno[i] == turno[id] && i < id) return 0;  // ② 重号:id 小者赢
  else return 1;                                     // ③ 我进
}Estructura del Código: Traza de error · 互斥被打破的全过程
▸ 原页截图 p.53(含错误轨迹表)
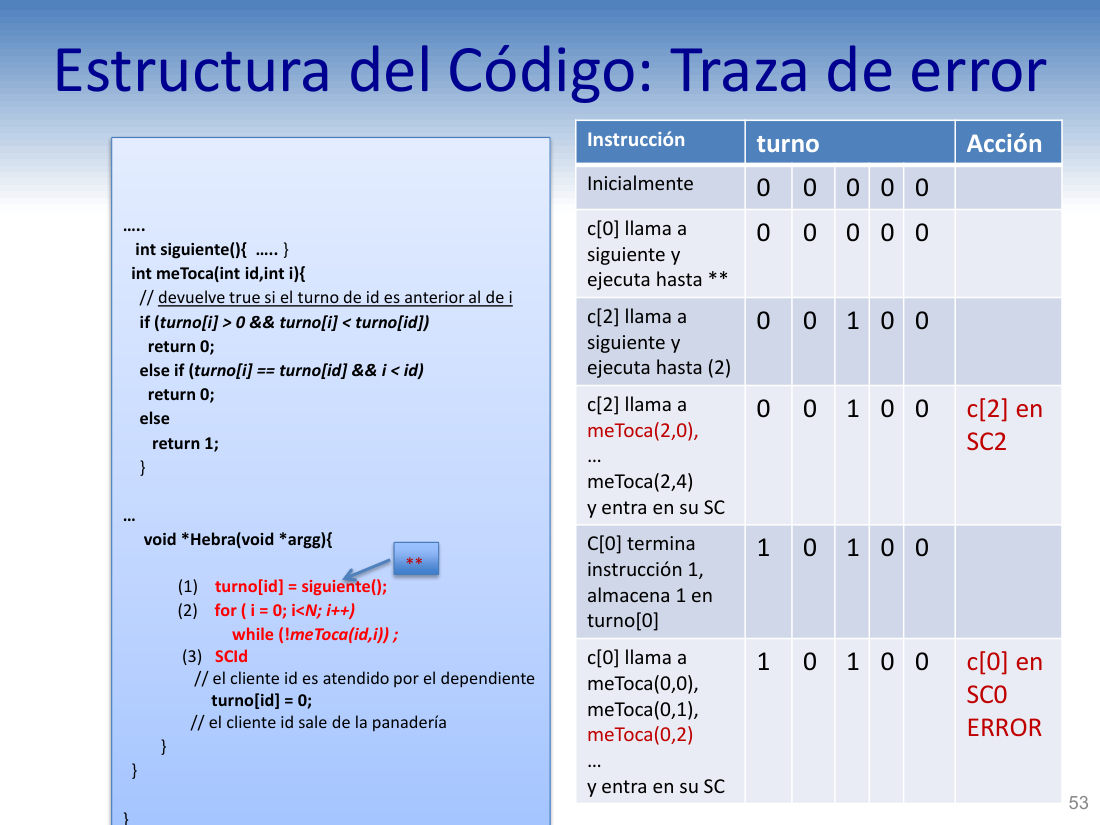
int siguiente(){ ….. }
取号函数,内部会遍历整个数组求 max——它自己不加锁。
int meToca(int id,int i){ … }
三行判断照旧,不做修改。
void *Hebra(void *argg){
线程主体,三处带编号的关键行就是轨迹表里的 (1)(2)(3)。
(1) turno[id] = siguiente();
(1) 取号——注意这一行本身就是「读 max + 写数组」两步,不是原子的。
(2) for ( i = 0; i<N; i++) while (!meToca(id,i)) ;
(2) 逐个比较,比完就该进 SC 了。
(3) SCId // el cliente id es atendido por el dependiente
(3) 进临界区,被店员服务。
turno[id] = 0; // el cliente id sale de la panadería
号码归零 = 离店,放行后面的人。
| Instrucción | turno | Acción |
|---|---|---|
| Inicialmente | 0 0 0 0 0 | 五人都在店外 |
| c[0] llama a siguiente y ejecuta hasta ** | 0 0 0 0 0 | c0 读到 max=0,还没存就被打断(** = 断点) |
| c[2] llama a siguiente y ejecuta hasta (2) | 0 0 1 0 0 | c2 拿到 1,比完所有人 |
| c[2] llama a meToca(2,0), …, meToca(2,4) y entra en su SC | 0 0 1 0 0 | 此时没人有更小的号 → c2 进入 SC2 |
| c[2] en SC2 | 0 0 1 0 0 | c2 正在被服务 |
| C[0] termina instrucción 1, almacena 1 en turno[0] | 1 0 1 0 0 | c0 醒来把 1 写进去 → 重号 |
| c[0] llama a meToca(0,0), meToca(0,1), meToca(0,2), … | 1 0 1 0 0 | 比到 i=2 时:turno[2]==turno[0] 且 2 < 0 为假 → 返回 1 |
| c[0] en SC0 · ERROR | 1 0 1 0 0 | SC0 与 SC2 同时执行 → 互斥被破坏 |
Estructura del Código: pidiendoTurno · 「取号中」举牌机制
▸ 原页截图 p.54
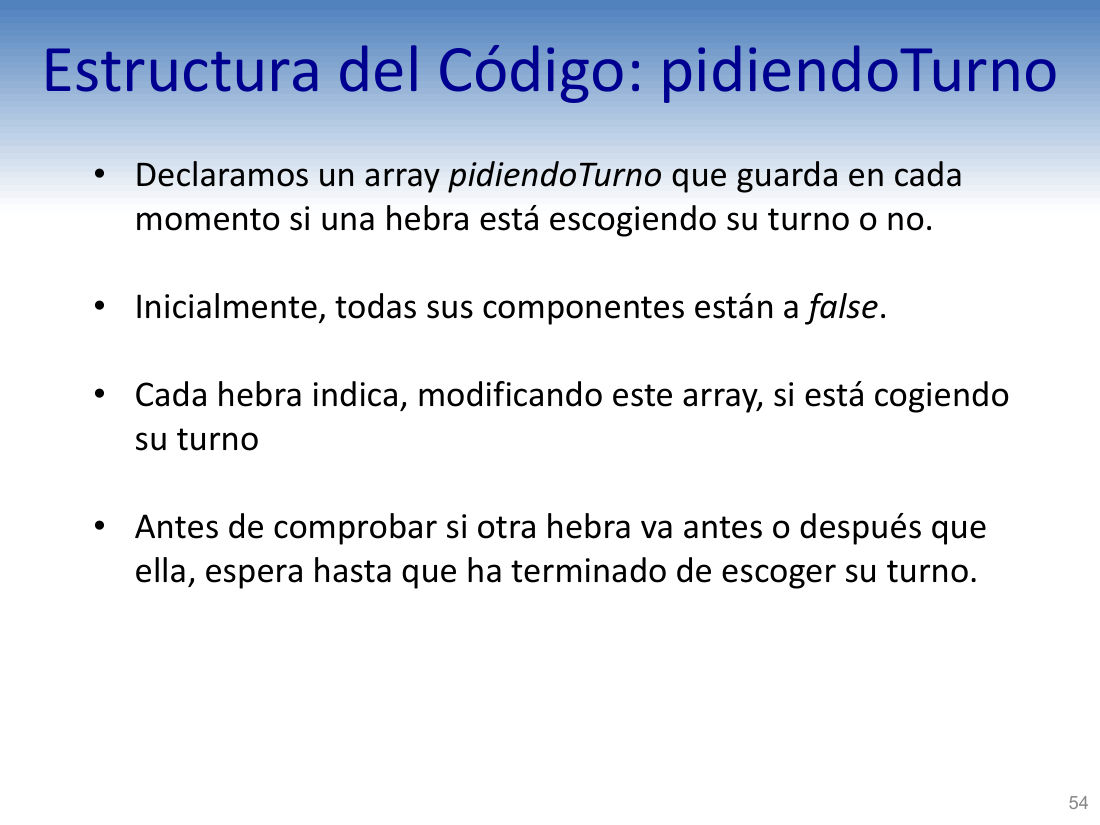
Declaramos un array pidiendoTurno que guarda en cada momento si una hebra está escogiendo su turno o no.
新增一个数组 pidiendoTurno,随时记录每个线程此刻是不是正在取号。
Inicialmente, todas sus componentes están a false.
初值全为 false(C 里全局数组自动清零,所以不用手写初始化)。
Cada hebra indica, modificando este array, si está cogiendo su turno
每个线程通过改这个数组,公开宣告「我正在取号」。
Antes de comprobar si otra hebra va antes o después que ella, espera hasta que ha terminado de escoger su turno.
在比较谁先谁后之前,先等对方把号取完——这一句就是整个修补的灵魂。
pidiendoTurno[id] = 1;          // 举牌:我在取号
turno[id] = siguiente();        // 取号(读 max + 写回)
pidiendoTurno[id] = 0;          // 放下牌子:取完了

for (j = 0; j < MAXT; j++) {
  while (pidiendoTurno[j]) ;  // 等你取完号,再跟你比
  while (!meToca(id, j)) ;      // 再判断谁先
}j 正在「读 max → 写数组」这段路上。
空转等它落地,保证比号时看到的是最终值。
Panadería: Código definitivo · 最终定稿代码
▸ 原页截图 p.55(定稿代码,建议对着图看缩进)
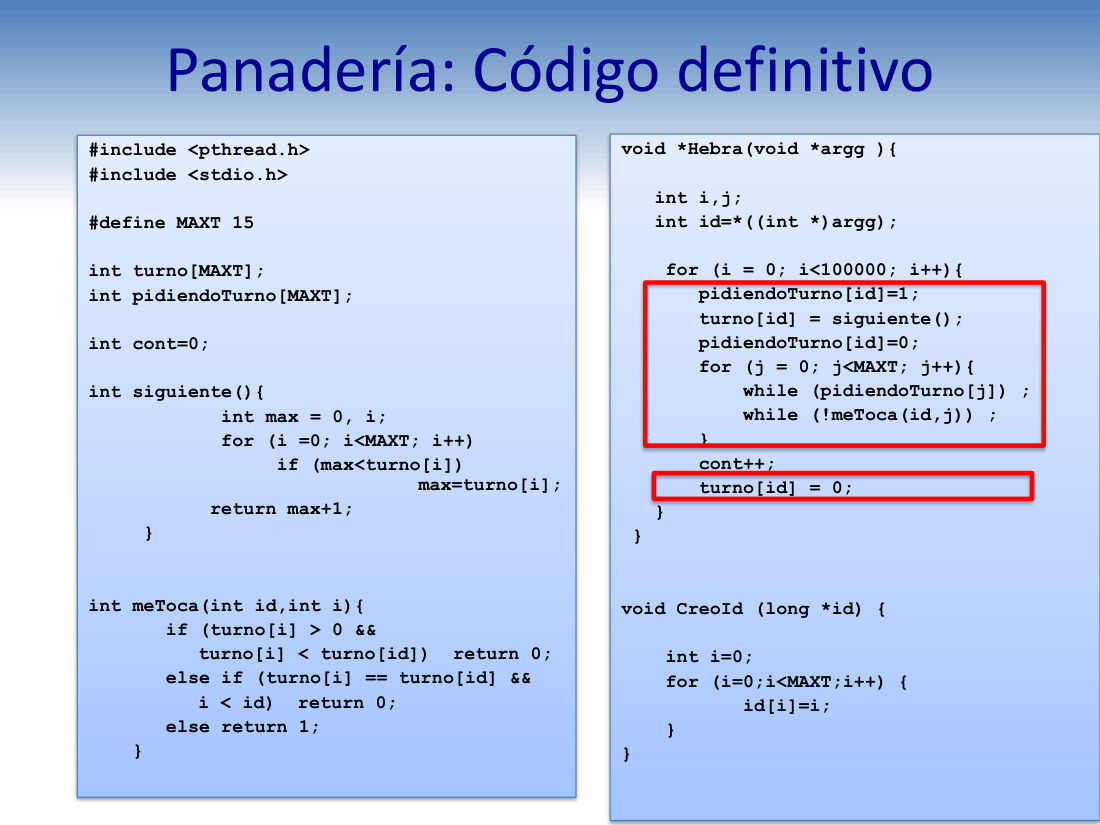
#define MAXT 15
最多 15 个线程(MAXT = máximo de threads)。注意后文 siguiente 与循环都用 MAXT 而不是实际线程数。
int turno[MAXT]; int pidiendoTurno[MAXT];
两个全局数组:号码 + 取号中标志。全局变量在 C 中自动初始化为 0。
int cont=0;
被保护的共享计数器——它就是 临界区里真正要干的事(对应 p.49 的 SCId)。
int siguiente(){ int max = 0, i; for (i = 0; i < MAXT; i++) if (max < turno[i]) max = turno[i]; return max+1; }
取号:扫全表求最大号,返回 max+1。没人排队时返回 1。
int meToca(int id,int i){ … }
三行判断不变:号码小的先,重号则 id 小的先。
void *Hebra(void *argg ){ int i, j; int id = *((int *)argg);
线程入口,从参数里取出自己的 id(这就是 p.56 要传 &id[i] 的原因)。
for (i = 0; i<100000; i++){
每个线程循环 10 万次「进店—被服务—离店」。
pidiendoTurno[id]=1; turno[id] = siguiente(); pidiendoTurno[id]=0;
举牌 → 取号 → 放牌,三行连写,中间不许插入别的逻辑。
for (j = 0; j<MAXT; j++){ while (pidiendoTurno[j]) ; while (!meToca(id,j)) ; }
逐个 j:先等对方取完号,再判断谁先。两个 while 都过了才能往下走。
cont++; turno[id] = 0;
临界区(就一行 cont++)+ 离店把号归零。
void CreoId (long *id) { int i=0; for (i=0;i<MAXT;i++) { id[i]=i; } }
辅助函数:把 id 数组填成 0,1,2,…,14,这样每个线程拿到唯一编号。
#include <pthread.h>
#include <stdio.h>
#define MAXT 15
int turno[MAXT];
int pidiendoTurno[MAXT];
int cont = 0;

int siguiente() {
  int max = 0, i;
  for (i = 0; i < MAXT; i++)
    if (max < turno[i]) max = turno[i];
  return max + 1;                      // 最大号 + 1
}

int meToca(int id, int i) {
  if (turno[i] > 0 && turno[i] < turno[id]) return 0;
  else if (turno[i] == turno[id] && i < id) return 0;
  else return 1;
}

void *Hebra(void *argg) {
  int i, j;
  int id = *((int *)argg);
  for (i = 0; i < 100000; i++) {
    pidiendoTurno[id] = 1;               // 举牌
    turno[id] = siguiente();              // 取号
    pidiendoTurno[id] = 0;               // 放牌
    for (j = 0; j < MAXT; j++) {
      while (pidiendoTurno[j]) ;        // 等你取完
      while (!meToca(id, j)) ;          // 谁先?
    }
    cont++;                              // 临界区
    turno[id] = 0;                        // 离店
  }
}

void CreoId(long *id) {
  int i = 0;
  for (i = 0; i < MAXT; i++) id[i] = i;
}Panadería: Código definitivo · main 与线程创建
▸ 原页截图 p.56
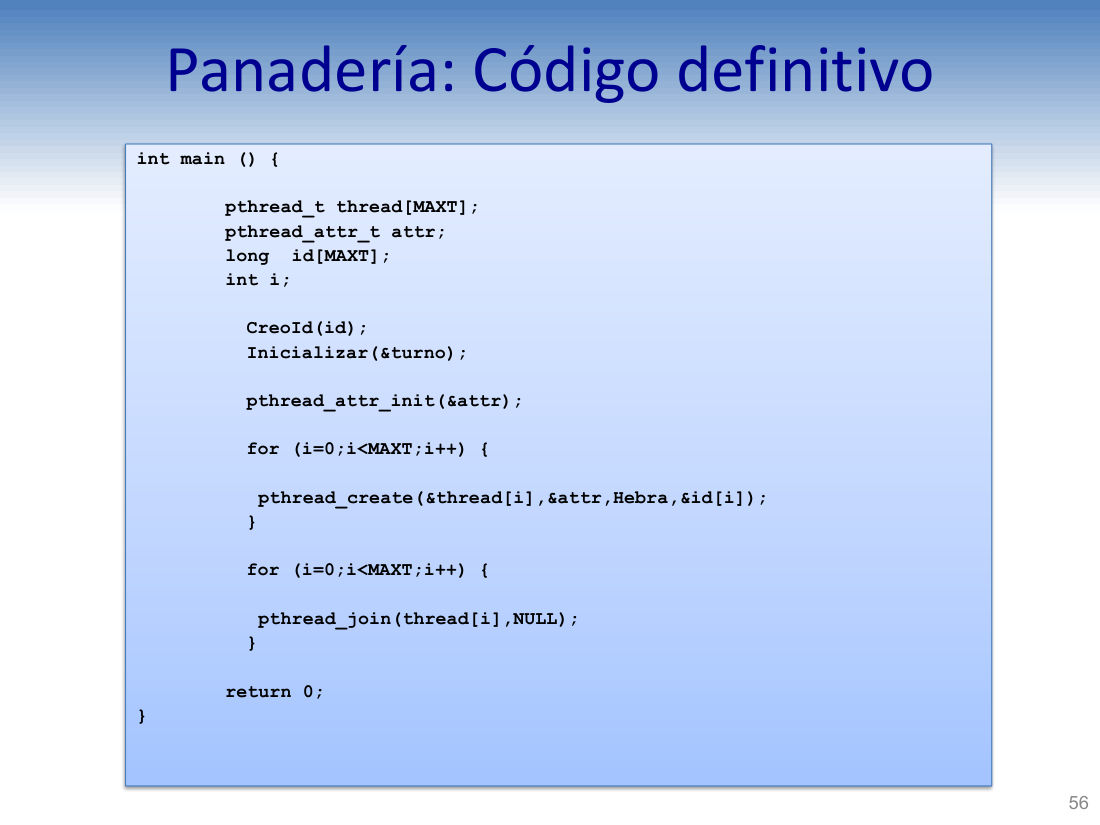
int main () {
主线程:只负责创建和等待,不参与抢号。
pthread_t thread[MAXT];
存放 15 个线程句柄的数组。
pthread_attr_t attr;
线程属性对象——本例用默认属性,写出来是为了示范标准写法。
long id[MAXT];
给每个线程准备的专属编号数组,值为 0…14。
CreoId(id);
填号:id[i] = i。
Inicializar(&turno);
把 turno 清零(讲义未给出该函数体,实质就是置 0)。
pthread_attr_init(&attr);
初始化属性结构体,用属性版 create 前必调。
for (i=0;i<MAXT;i++) { pthread_create(&thread[i],&attr,Hebra,&id[i]); }
循环创建 15 个线程,第 4 个参数传 &id[i]——每个线程拿到自己的号。
for (i=0;i<MAXT;i++) { pthread_join(thread[i],NULL); }
逐个 join:主线程等所有子线程结束才继续。
return 0;
(严格说 printf 打印 cont 应在 join 之后——p.9 那种写法。)
int main() {
  pthread_t thread[MAXT];
  pthread_attr_t attr;
  long id[MAXT];
  int i;
  CreoId(id);
  Inicializar(&turno);
  pthread_attr_init(&attr);
  for (i = 0; i < MAXT; i++)
    pthread_create(&thread[i], &attr, Hebra, &id[i]);   // 每人一个专属 id
  for (i = 0; i < MAXT; i++)
    pthread_join(thread[i], NULL);                       // 等全部结束
  return 0;   // 此处可 printf("%d", cont)
}八、历史定位、正确性判定与公平性
Los algoritmos de Peterson y Lamport en la actualidad · 今天的它们还灵吗
▸ 原页截图 p.57
Peterson y Lamport fueron soluciones basadas únicamente en Software para resolver el problema de la exclusión mutua
Peterson 和 Lamport 是纯软件方案——不靠任何特殊机器指令,只用普通读写变量就能解决互斥。
Con el tiempo, la tendencia fue utilizar soluciones basadas en hardware (que además existían desde los primeros tiempos del multiprocesamiento) con instrucciones atómicas como test-and-set o compare-and-swap
后来趋势转向基于硬件的方案(其实多处理器早期就有了),用 test-and-set、compare-and-swap 这类原子指令。
Además, estos algoritmos pueden no funcionar en hardware moderno cuando hay varios núcleos y modelos de consistencia de memoria relajados
而且在多核 + 松散内存一致性模型(relajados)的现代硬件上,这些算法可能失效。
「把标志置 1,并返回旧值」,一条指令完成读+写。
「若当前值等于期望值,则换成新值」,同样不可被打断。
Corrección de un programa concurrente · 安全性 vs 活性
▸ 原页截图 p.58(两大类性质对照)
Propiedades de seguridad: las que afirman que el sistema “nunca” va a entrar en un estado “malo” o de error
安全性(seguridad):断言系统「永远不」会进入某个「坏」状态——关键词 nunca。
Exclusión mutua
例①:互斥——两个线程永不同时在 SC 里。
Condiciones de sincronización para el productor/consumidor
例②:生产者/消费者的同步条件——不会在没数据时读、不会在满时写。
Ausencia de bloqueo (deadlock)
例③:无死锁。
Deadlock es el estado del sistema en el que todas las hebras están bloqueadas esperando algún evento.
死锁定义:系统中所有线程都被阻塞、在等某个(永远不会发生的)事件的状态。
Propiedades de viveza: las que afirman que “en algún momento” ocurre algo “bueno” en el sistema
活性(viveza):断言「在某个时刻」会发生某件「好」事——关键词 en algún momento。
R3: Si sólo una hebra quiere entrar en su SC, en algún momento debe poder hacerlo
R3:只有一个线程想进 SC 时,它最终必须能进。
R2: Si las dos hebras quieren entrar en su sección crítica, en algún momento alguna de ellas debe poder hacerlo (ausencia de livelock)
R2:两个都想进时,最终至少有一个能进(= 无活锁 livelock)。
R4: Ausencia de posposición indefinida (starvation): todas las hebras del sistema tienen la oportunidad de evolucionar en su código
R4:无无限延迟(starvation):每个线程都有机会推进自己的代码。
| 类别 | 关键词 | 典型条目 | 反例 |
|---|---|---|---|
| seguridad | nunca | 互斥、同步条件、无死锁 | 两人同时在 SC |
| viveza | en algún momento | R2 / R3 / R4 | livelock、starvation、deadlock |
Corrección de un programa concurrente · 动态工具 vs 模型检验
▸ 原页截图 p.59
Herramientas dinámicas:
动态工具(运行时检测):
Analizan el programa mientras se está ejecutando.
在程序运行过程中分析。
Detectan problemas que aparecen en las ejecuciones realizadas.
只能发现本次实际执行中真正出现的问题。
Ejemplo: ThreadSanitizer, para detectar data races.
例:ThreadSanitizer,专门检测 data races(数据竞争)。
Limitación: no garantiza que un error que no haya aparecido en una ejecución no pueda aparecer en otra.
局限:这次没出现的错误,不能保证换个执行次序也不会出现。
Model checkers:
模型检验器:
No necesitan ejecutar el programa original: trabajan sobre un modelo del sistema.
不需要运行原程序,而是在系统的模型上工作。
Exploran sistemáticamente sus posibles estados y ejecuciones.
系统性地穷举所有可能状态与执行路径。
Permiten comprobar propiedades de seguridad y viveza, como deadlock, starvation o ausencia de determinadas situaciones.
可以验证安全性和活性,例如死锁、饿死、或「某情况永不发生」。
Ejemplos: SPIN y TLA+/TLC.
例:SPIN 与 TLA+/TLC。
真跑真测;只能证明有 bug,不能证明没 bug。TSan 报 race 就一定有问题。
不跑代码、穷举模型;能给出「无 bug」的证明(限于模型),代价是状态爆炸。
Justicia (fairness) · 公平调度器与活锁
▸ 原页截图 p.60(含 fin1/fin2 代码)
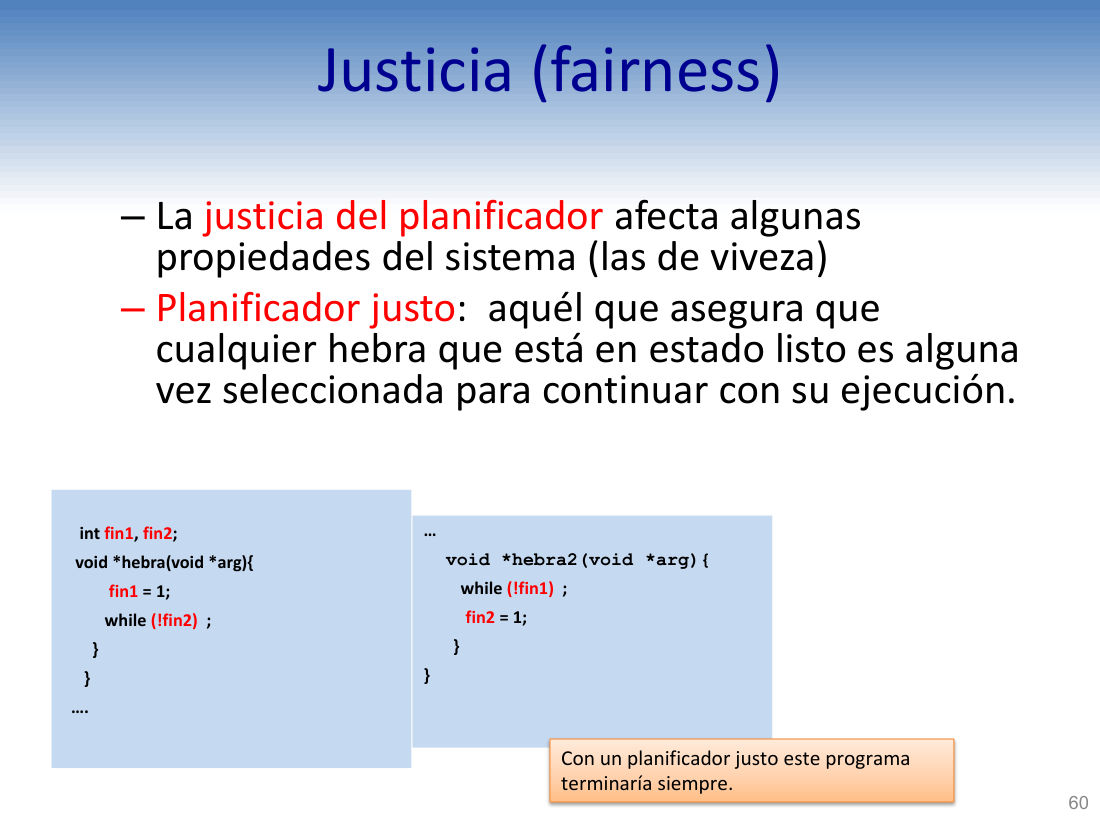
La justicia del planificador afecta algunas propiedades del sistema (las de viveza)
调度器的公平性会影响系统的某些性质——正是活性(viveza)那一类。
Planificador justo: aquél que asegura que cualquier hebra que está en estado listo es alguna vez seleccionada para continuar con su ejecución.
公平调度器:保证任何处于就绪态的线程,迟早会被选中继续执行。
int fin1, fin2;
两个全局标志,初值 0。
void *hebra(void *arg){ fin1 = 1; while (!fin2) ; }
hebra1:先置 fin1=1,然后空转等 fin2。
void *hebra2(void *arg){ while (!fin1) ; fin2 = 1; }
hebra2:空转等 fin1 变 1,看到后置 fin2=1。
Con un planificador justo este programa terminaría siempre.
在公平调度器下,这个程序一定终止。
int fin1, fin2;                       // 全局,初值 0

void *hebra1(void *arg) {
  fin1 = 1;                          // 通知对方:我到了
  while (!fin2) ;                    // 等对方也到
}

void *hebra2(void *arg) {
  while (!fin1) ;                    // 等对方先到
  fin2 = 1;                          // 通知对方:我也到了
}Justicia · 弱公平 vs 强公平(本题的分水岭)
▸ 原页截图 p.61(弱/强公平对照代码)
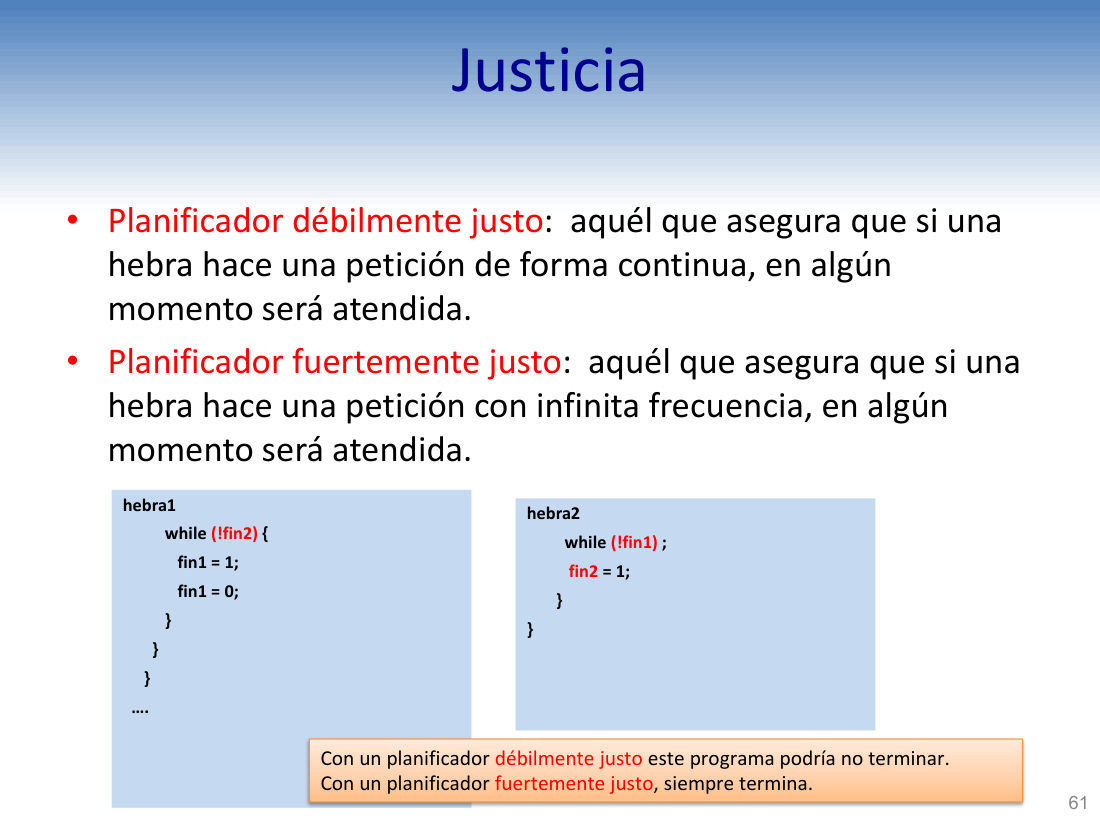
Planificador débilmente justo: aquél que asegura que si una hebra hace una petición de forma continua, en algún momento será atendida.
弱公平调度器:若某线程持续不断地(de forma continua)提出请求,它最终会被满足。
Planificador fuertemente justo: aquél que asegura que si una hebra hace una petición con infinita frecuencia, en algún momento será atendida.
强公平调度器:若某线程无限频繁地(con infinita frecuencia)提出请求,它最终会被满足——允许请求中间有间断。
hebra1: while (!fin2) { fin1 = 1; fin1 = 0; }
hebra1:反复把 fin1 置 1 又清 0——请求是「一闪一闪」的,不是连续的。
hebra2: while (!fin1) ; fin2 = 1;
hebra2:一直空转等 fin1 为 1,看到就置 fin2=1。
Con un planificador débilmente justo este programa podría no terminar.
弱公平下,这个程序可能永远不终止。
Con un planificador fuertemente justo, siempre termina.
强公平下,它一定终止。
void *hebra1(void *arg) {
  while (!fin2) {
    fin1 = 1;                       // 请求…
    fin1 = 0;                       // …又撤回(连续不断 → 变成「无限频繁」)
  }
}

void *hebra2(void *arg) {
  while (!fin1) ;                  // 一直等,属于「连续请求」
  fin2 = 1;
}En resumen… · 本部分小结
▸ 原页截图 p.62
En esta parte del tema hemos visto algunos de los aspectos más importantes de la programación concurrente:
本部分我们看了并发编程中最重要的几个方面:
Exclusión mutua
互斥——同一时刻只有一个线程在临界区。
Sincronización
同步——线程之间按条件互相等待/通知。
Los métodos de espera activa son una aproximación inicial para acostumbrarnos a pensar en la resolución de programas concurrentes
忙等方法是一个「入门级」近似方案,目的是训练我们用并发的方式思考。
优点:无需 OS 支持、纯软件可实现。缺点:白烧 CPU,且依赖公平调度。
Parte 2 用 semáforos 等真正的阻塞机制替换忙等。
九、专有名词总表
A–Z · 全章 62 页专有名词速记表(A–Z)
按西语字母排序,点页码直接跳回对应页块。最后一列是「一句话记住 / 易错点」——考前只扫这一列也能救急。
| 西语术语 | 中文 | 页 | 一句话记住 / 易错点 |
|---|---|---|---|
| A | |||
| acoplamiento | 耦合:生产者与消费者之间不必要的相互依赖 | p.24 | 用了共享变量就自动耦合——能不用就别用 |
| algoritmo de la panadería | 面包店算法(Lamport):N 个线程的互斥,取号 + 比号 | p.40 | 现实类比:取号排队,号小的先被服务 |
| aproximación inicial | 入门级近似——讲义对忙等的定性 | p.62 | 别说「忙等是错的」,要说「初步方案」 |
| ausencia de bloqueo | 无死锁 | p.58 | 属于 seguridad(nunca) |
| ausencia de posposición indefinida | 无无限延迟 = 无饿死 = R4 | p.58 | posposición = 被一再推迟 |
| B | |||
| bloqueo (mecanismo de) | 阻塞机制:让出 CPU 去等 | p.62 | 忙等的升级版,Parte 2 才登场 |
| buffer | 缓冲区:存放数据的有限容量容器 | p.24 | 容量有限 ⇒ 必须加同步条件 |
| C | |||
| caché | 缓存 | p.24 | 可见性问题的物理根源 |
| compare-and-swap (CAS) | 比较并交换:值等于期望才换成新值 | p.57 | 硬件原子指令,和 TAS 成对必背 |
| condición de carrera | 竞态条件:结果取决于执行次序 | p.17 | 不是「跑得快」,是「顺序不同结果不同」 |
| condiciones de sincronización | 同步条件:生产者/消费者的两条约束 | p.21 | 关键句:这里「没有」互斥问题,只有同步问题 |
| consistencia de memoria relajada | 松散内存一致性模型 | p.57 | Peterson/Lamport 在现代多核失效的原因 |
| contador compartido | 共享计数器 | p.7 | 花园问题的 cont,就是被争抢的资源 |
| control de acceso | 访问控制:对资源的同步约束 | p.3 | 是同步概念,不是操作系统的权限 |
| D | |||
| data race | 数据竞争:无同步地访问同一内存且至少一个在写 | p.59 | ThreadSanitizer 抓的就是它(≠ race condition) |
| deadlock | 死锁:所有线程都阻塞、等一个永不发生的事件 | p.58 | 谁都动不了,全场卡死 |
| dependiente | 店员:面包店图里叫号的那个人 | p.51 | 他就是临界区的执行者 |
| débilmente justo | 弱公平:「持续不断」的请求终会被满足 | p.61 | continua = 一刻不停;中间一断就管不着 |
| E | |||
| entidad activa / pasiva | 主动实体 / 被动实体:线程 vs 资源 | p.3 | 主动的会跑,被动的只能被访问 |
| espera activa | 忙等待:不释放 CPU、原地空转地等 | p.1 | 本章主题,「站门口一直敲门」 |
| estado listo | 就绪态:可以跑、只差 CPU | p.60 | 公平调度器必须最终选中它 |
| exclusión mutua | 互斥:同一时刻只有一个线程在 SC 里(= R1) | p.17 | 属于 seguridad |
| F | |||
| fuertemente justo | 强公平:「无限频繁」的请求终会被满足 | p.61 | 强 ⊃ 弱,能处理「一闪一闪」的请求 |
| H | |||
| hebra | 线程:共享同一地址空间的执行流 | p.3 | 和 proceso 的区别就在「共享内存」 |
| I | |||
| instrucciones atómicas | 原子指令:不可被打断的机器指令 | p.57 | test-and-set / compare-and-swap 都属于它 |
| intercalado | 交错执行:两条指令序列相互穿插 | p.51 | 重号的直接原因(se intercalan) |
| J | |||
| justicia | 公平性:调度器的公平程度 | p.60 | 只影响 viveza,不影响 seguridad |
| L | |||
| livelock | 活锁:都在动、都在让,谁也进不去 | p.29 | 「您先请~您先请~」 |
| M | |||
| memoria compartida | 共享内存:线程之间通信的方式 | p.1 | 一块公共白板,谁都能写 |
| meToca(id, i) | 「该不该我进」的判定函数 | p.52 | 三分支:号码小 / 平局看 id / 兜底放行 |
| model checker | 模型检验器:穷举模型的所有状态 | p.59 | SPIN、TLA+/TLC;能给「无 bug」的证明 |
| P | |||
| pidiendoTurno[] | 「取号中」标志数组 | p.54 | 修补 TOCTOU 的关键:举牌 |
| planificador justo | 公平调度器:就绪线程终会被选中 | p.60 | 公平性 ⇒ 影响活性 |
| postProtocolo | 后协议:出 SC 之后要做的收尾 | p.26 | 骨架四段之末(放行别人) |
| preProtocolo | 前协议:进 SC 之前要做的申请 | p.26 | 骨架四段之首 |
| productor / consumidor | 生产者 / 消费者:一方写一方读 | p.18 | 只同步、不互斥(这是本章最大误解) |
| propiedades de seguridad | 安全性:「nunca」进入坏状态 | p.58 | 关键词 nunca |
| propiedades de viveza | 活性:「en algún momento」发生好事 | p.58 | 关键词 algún momento |
| pthread_create / pthread_join | 创建线程 / 等待线程结束 | p.19 | 第 4 个参数别传局部变量地址 |
| R | |||
| R1 | 互斥 | p.28 | seguridad 性质 |
| R2 | 两个都想进 → 最终至少一个能进(无活锁) | p.29 | viveza |
| R3 | 只有一个想进 → 它终能进 | p.33 | viveza |
| R4 | 无饿死:每个线程都有机会推进 | p.39 | viveza |
| recurso compartido | 共享资源 | p.3 | 被动的那一方 |
| registro | 寄存器 | p.11 | 轨迹表里 p1 / p2 那两列 |
| S | |||
| sección crítica (SC) | 临界区:必须互斥执行的那段代码 | p.17 | 「房间,一次只进一个」 |
| sección no crítica (SNC) | 非临界区 | p.26 | 骨架的首尾两段 |
| siguiente() | 取号函数:返回当前最大号 + 1 | p.45 | 它自己不加锁 ⇒ 可能重号 |
| sincronización | 同步:按条件互相等待 / 通知 | p.62 | 和互斥不是一回事,别混 |
| starvation | 饿死:无限期轮不到 | p.39 | 属于 viveza,被 R4 排除 |
| SCId | 线程 id 的临界区动作 | p.49 | 定稿版里它就是 cont++ |
| T | |||
| test-and-set (TAS) | 测试并置位:置 1 并返回旧值 | p.57 | 硬件原子指令,一行干完读 + 写 |
| ThreadSanitizer | 动态数据竞争检测工具 | p.59 | 动态 = 只抓这次真跑出来的 |
| TOCTOU | 检查与使用之间状态被改(time-of-check to time-of-use) | p.31 | 三次失败尝试的共同病根 |
| turno[] | 号码数组:0 = 不来,> 0 = 排队中 | p.44 | 下标是 id,不是名次 |
| V | |||
| visibilidad | 可见性:一个线程的写何时被别的线程看到 | p.24 | 和 caché 成对出现 |
R1–R4 速记(考试最爱单独抽一条)
记忆口诀:「一互斥,二不卡,三孤能进,四不饿」——R1 管安全,R2/R3/R4 全是活性。
| 编号 | 西语原文关键词 | 中文 | 性质 | 页 |
|---|---|---|---|---|
| R1 | Exclusión mutua | 同一时刻只有一个线程在 SC 里 | seguridad | p.28 |
| R2 | ausencia de livelock | 两个都想进 → 最终至少一个能进 | viveza | p.29 |
| R3 | Si sólo una hebra quiere entrar… | 只有一个想进 → 它终能进 | viveza | p.33 |
| R4 | Ausencia de posposición indefinida | 无饿死:每个线程都有机会推进 | viveza | p.39 |
最容易混的 12 对(左 ≠ 右)
这 12 对是改错题、判断题、名词解释题的固定雷区。看到其中任何一对,先默念一遍区别再动笔。
同一时刻只能一个人进——管「不能同时」
按条件等 / 通知——管「先后次序」
全都卡住、谁都动不了
都在动、都在让,还是进不去
关键词 nunca(不许出事)
关键词 algún momento(总得成事)
占着 CPU 空转
让出 CPU,等唤醒
共享地址空间,切换便宜
独立地址空间,隔离好
无同步访问同一内存 + 至少一个写
范围更大:结果依赖执行次序
「不停请求」会满足
「无限频繁请求」也满足(更强)
发号:max + 1
判号:我该不该进
不排队(还没来 / 已离开)
正在排队,数字越小越早
必须互斥的那段
可以随便并发的那段
置 1 并返回旧值
等于期望值才换
只解决 2 个线程
解决 N 个线程