- 每一块 = 老师 PDF 的一页,标题旁蓝色胶囊是 PDF 物理页码;每块开头可展开原页截图,图示页默认展开。
- 正文是逐句对照:蓝灰衬线字是西语原句,下面带「中」标签的是逐句翻译,一句不漏。
- 句子后面紧跟「考点 / 陷阱 / 记忆钩子 / 补充」,直接能当答题句子用。
- 术语双向悬停:西语行里带底色的词,悬停显示中文;中文行里带虚下划线的词,悬停显示西语原词。代码块保留原始西语标识符不翻译。
- 打印时自动隐藏导航、指南与截图,一页一块不切断。
一、封面与内容索引
p.1–p.2Portada · 课程封面
▸ 原页截图 p.1
Grado en
Índice de contenidos · 目录
▸ 原页截图 p.2
Índice de contenidos
目录
•
•
•
•
2
页脚页码 2(讲义自印页码,与 PDF 物理页序一致)
二、消息传递模型与分类
p.3–p.7Paso de mensajes · 消息传递与弱耦合系统
▸ 原页截图 p.3
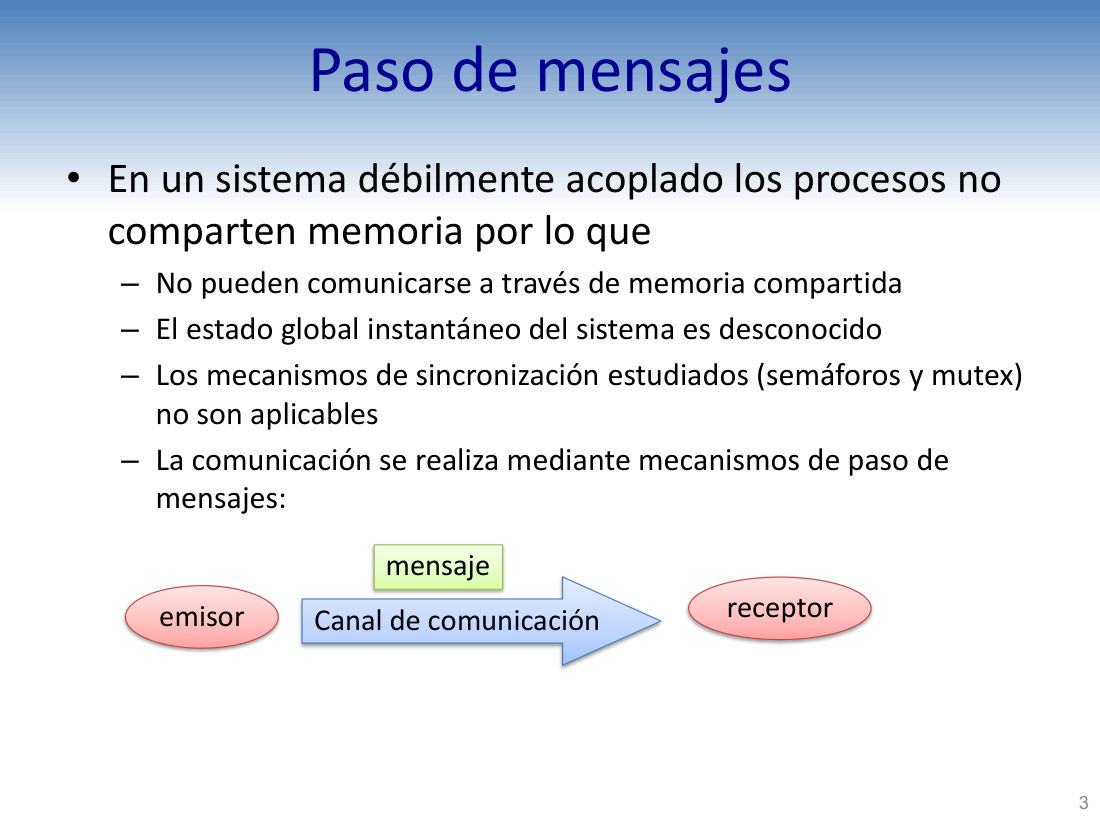
• En un
• 在一个
– No pueden comunicarse a través de
– 它们不能通过
– El
– 系统的
– Los mecanismos de
– 已学过的
– La comunicación se realiza mediante mecanismos de
– 通信改为通过
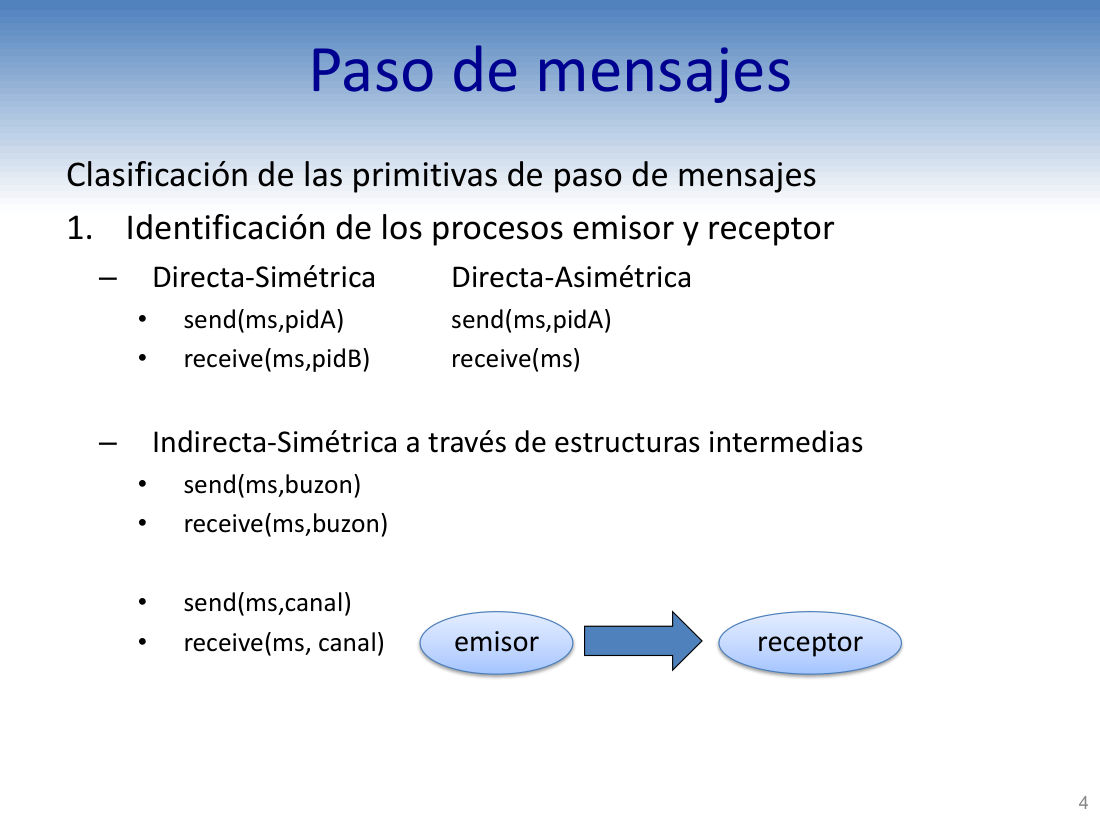
Clasificación de las primitivas · 原语分类①:进程标识方式
▸ 原页截图 p.4
消息传递
1.
1.
–
–
• send(ms,pidA)
• 发送:把消息 ms 发给进程 pidA(发送方必须写清收件人)
• receive(ms,pidB)
• 接收:只从进程 pidB 收消息(接收方也必须写清指定寄件人)
• send(ms,pidA)
• 发送:仍然要写清收件人 pidA
• receive(ms)
• 接收:不写寄件人,任何人的消息都收(谁先来收谁)
–
– 通过
• send(ms,buzon)
• 发送:把消息投进
• receive(ms,buzon)
• 接收:从同一个邮箱 buzon 取消息
• send(ms,canal)
• 发送:把消息写进
• receive(ms, canal)
• 接收:从同一个通道 canal 读消息
图注:
Clasificación · 间接通信的两种拓扑:点对点
▸ 原页截图 p.5
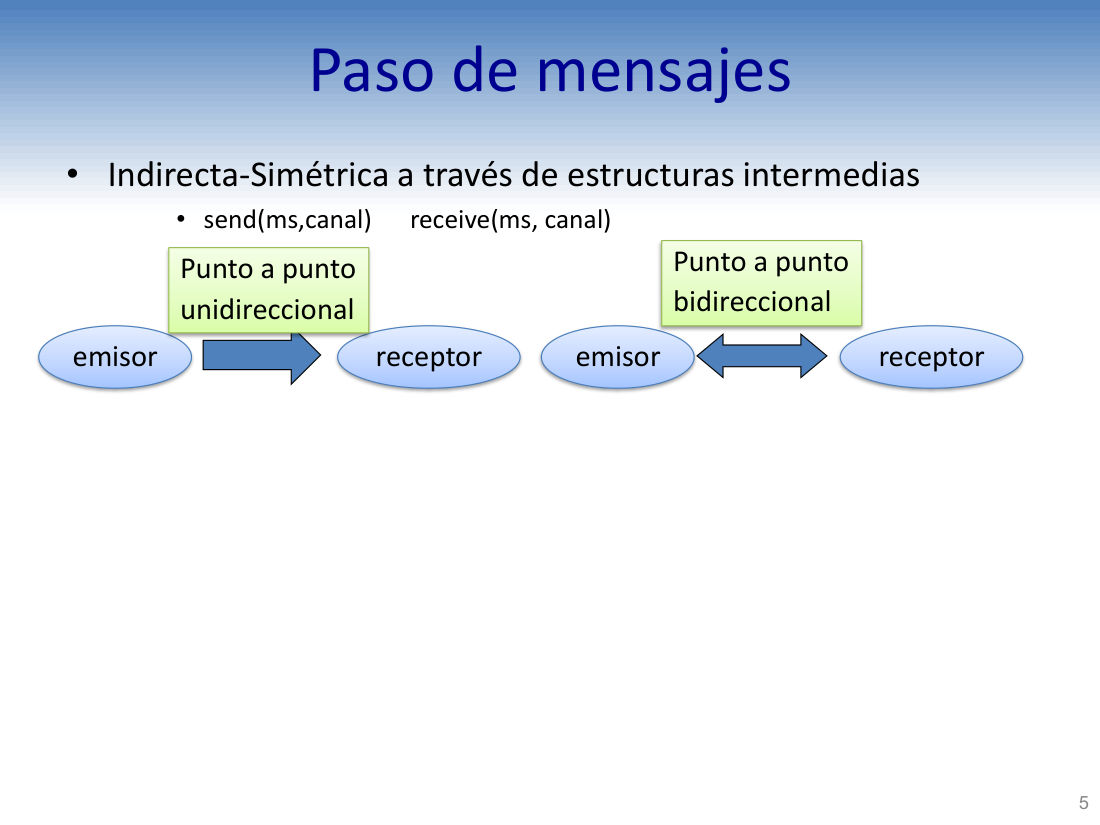
•
• 经由
• send(ms,canal) receive(ms, canal)
• 发送方写 send(ms,canal),接收方写 receive(ms, canal)——两边共用同一个通道名 canal
图注:
图注(第二幅):
Clasificación · 一对多与多对一
▸ 原页截图 p.6
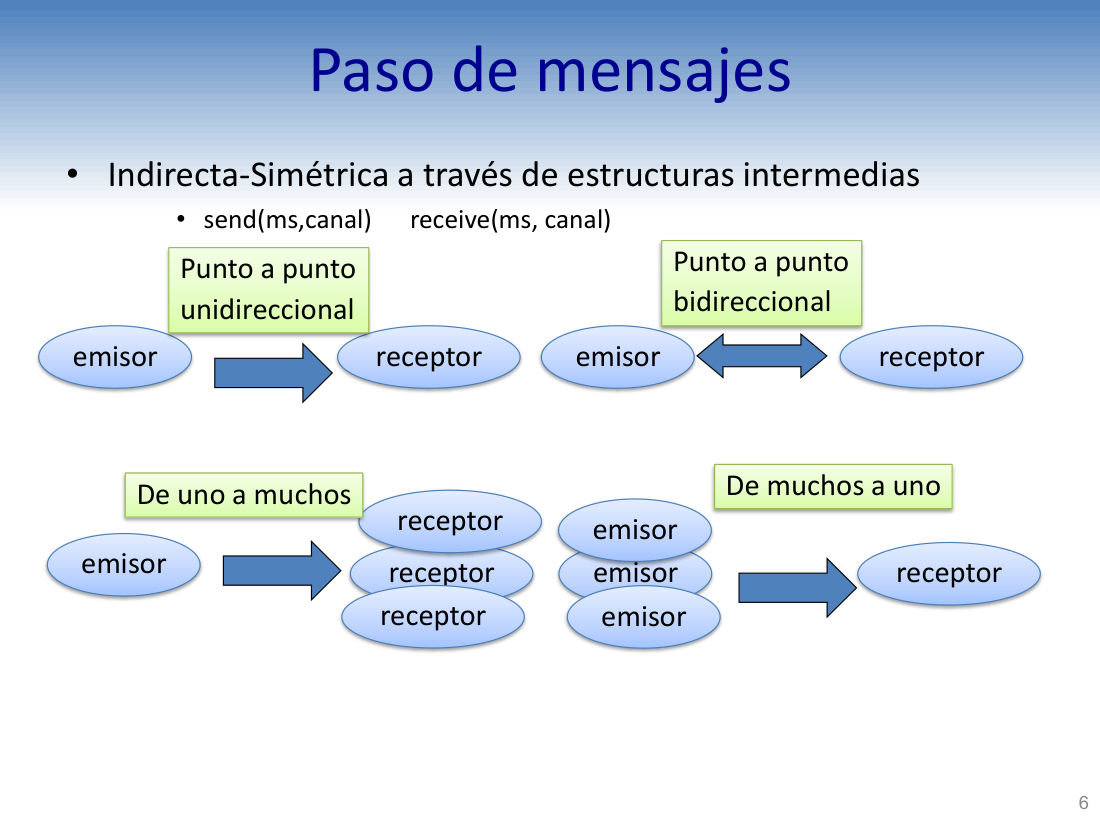
•
• 经由
• send(ms,canal) receive(ms, canal)
• 收发双方都针对同一个 canal 操作
图注:一个
图注(下幅):一个
图注:三个
(页末重复给出对照图)
图注:
Clasificación · 多对多
▸ 原页截图 p.7
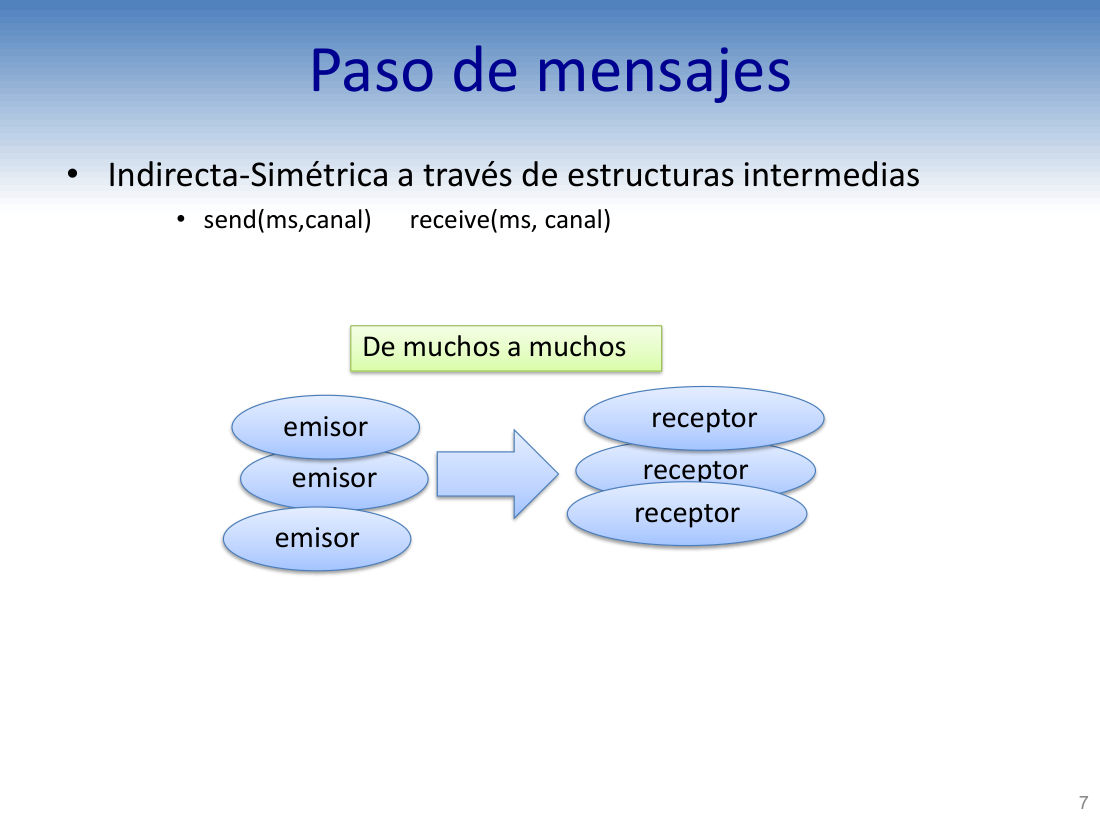
•
• 经由
• send(ms,canal) receive(ms, canal)
• 所有参与者都对同一个 canal 收发,彼此不必知道对方是谁
图注:三个
图注:三个
三、同步与异步:谁在等谁
p.8–p.132. Sincronización · 异步通信:接收方等消息
▸ 原页截图 p.8
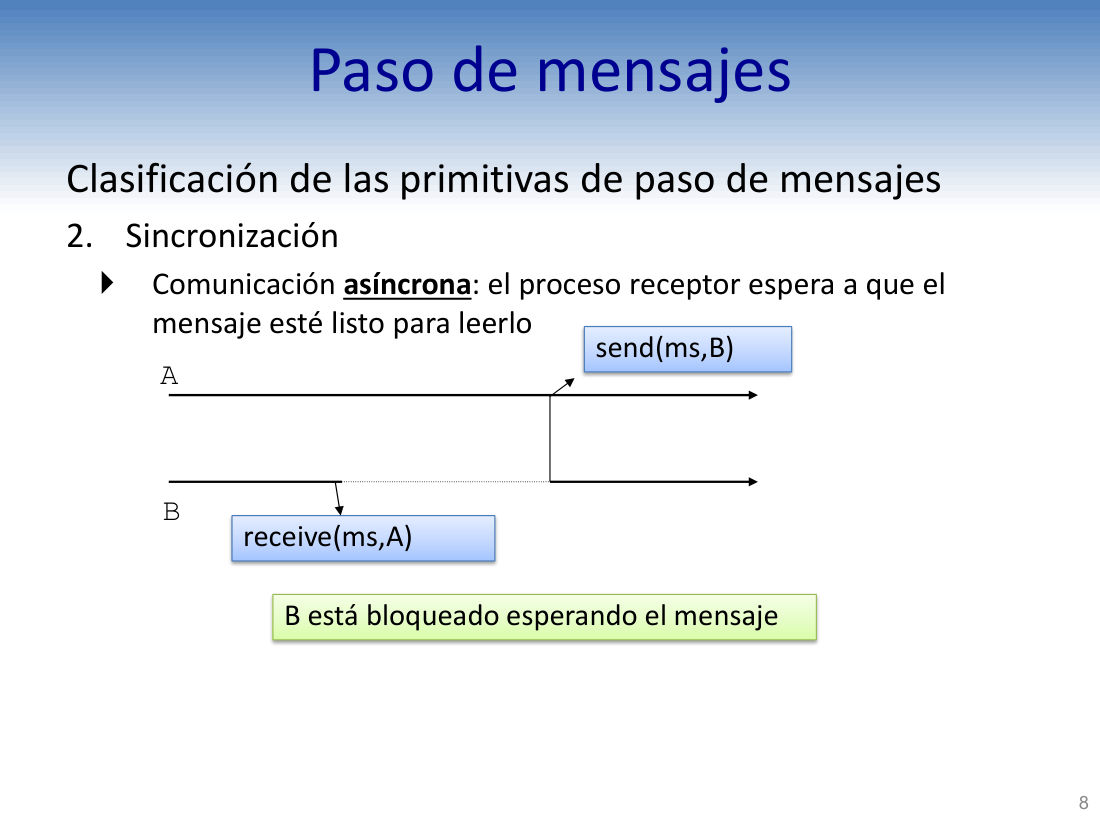
消息传递
2.
2.
A
A(发送方进程)
B
B(接收方进程)
send(ms,B)
A 执行 send(ms,B):把消息发给 B
receive(ms,A)
B 执行 receive(ms,A):从 A 收消息
B está
B 处于
2. Sincronización · 异步通信:传输瞬间谁都不阻塞
▸ 原页截图 p.9
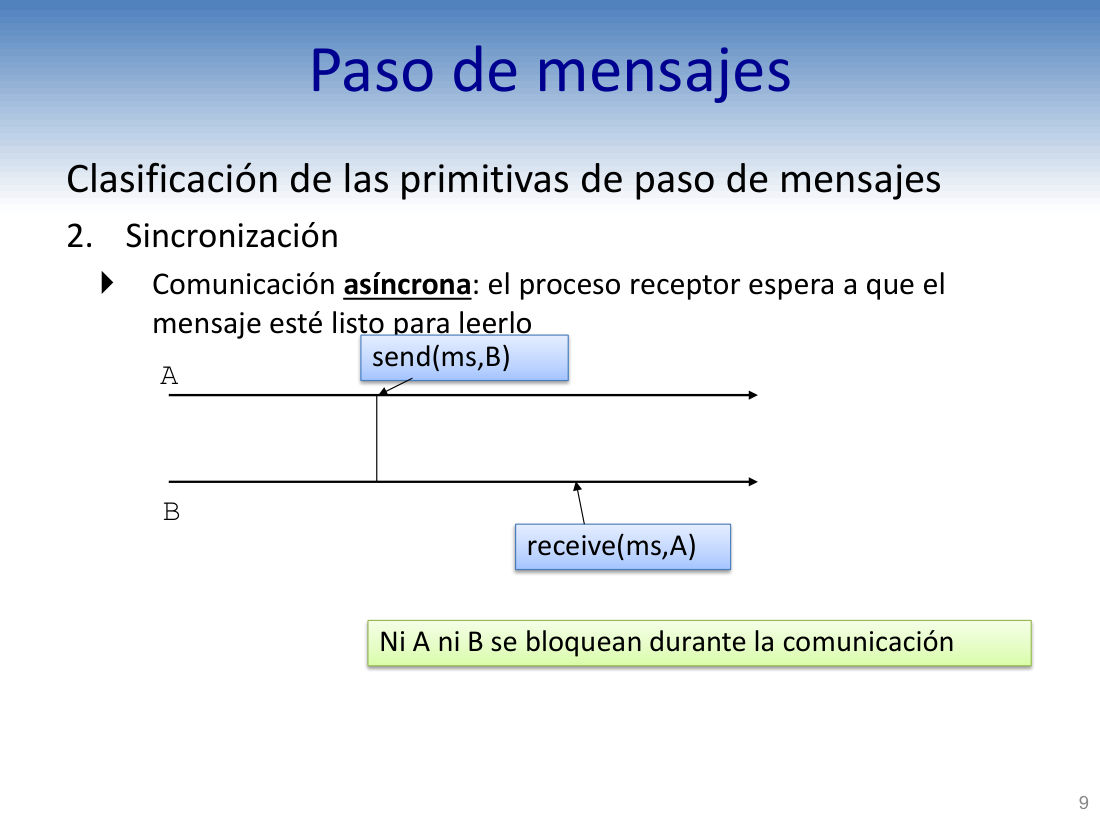
消息传递
2.
2.
A
A(发送方进程)
B
B(接收方进程)
send(ms,B)
A 执行 send(ms,B)
receive(ms,A)
B 执行 receive(ms,A)
Ni A ni B se bloquean durante la comunicación
通信进行中,A 和 B 都不阻塞(图中 A、B 两条时间轴的箭头段都是实线,没有平段)
2. Sincronización · 同步通信:约会(cita)
▸ 原页截图 p.10
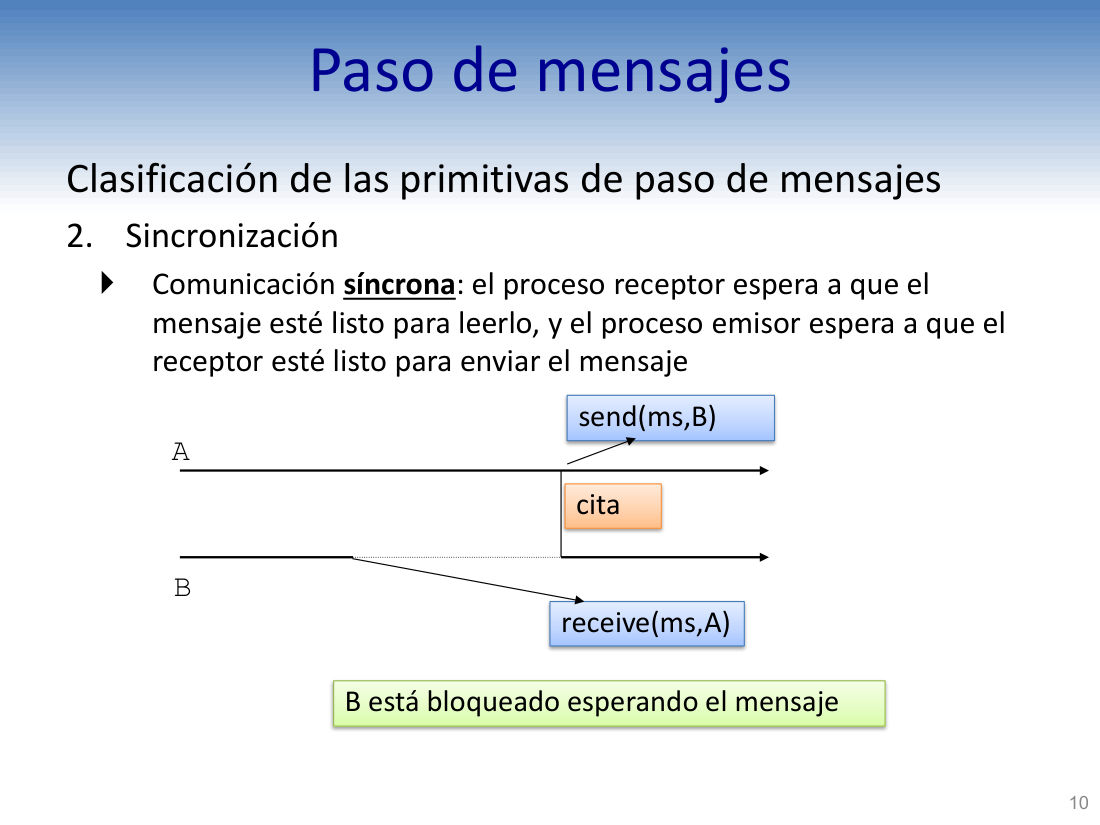
消息传递
2.
2.
A
A(发送方进程)
B
B(接收方进程)
send(ms,B)
A 执行 send(ms,B)(必须等 B 进入接收状态才能返回)
receive(ms,A)
B 执行 receive(ms,A)
B está
B 阻塞等待消息
| 时刻 | 发送方 A | 接收方 B | 说明 |
|---|---|---|---|
| t1 | send(ms,B) 调用 | 尚未 receive | A 阻塞,等 B 就绪 |
| t2 | 阻塞中 | receive(ms,A) 调用 | 双方会合,消息直传 |
| t3 | send 返回 | receive 返回 | 两人同时解除阻塞 |
2. Sincronización · 同步通信:握手(handshake)
▸ 原页截图 p.11
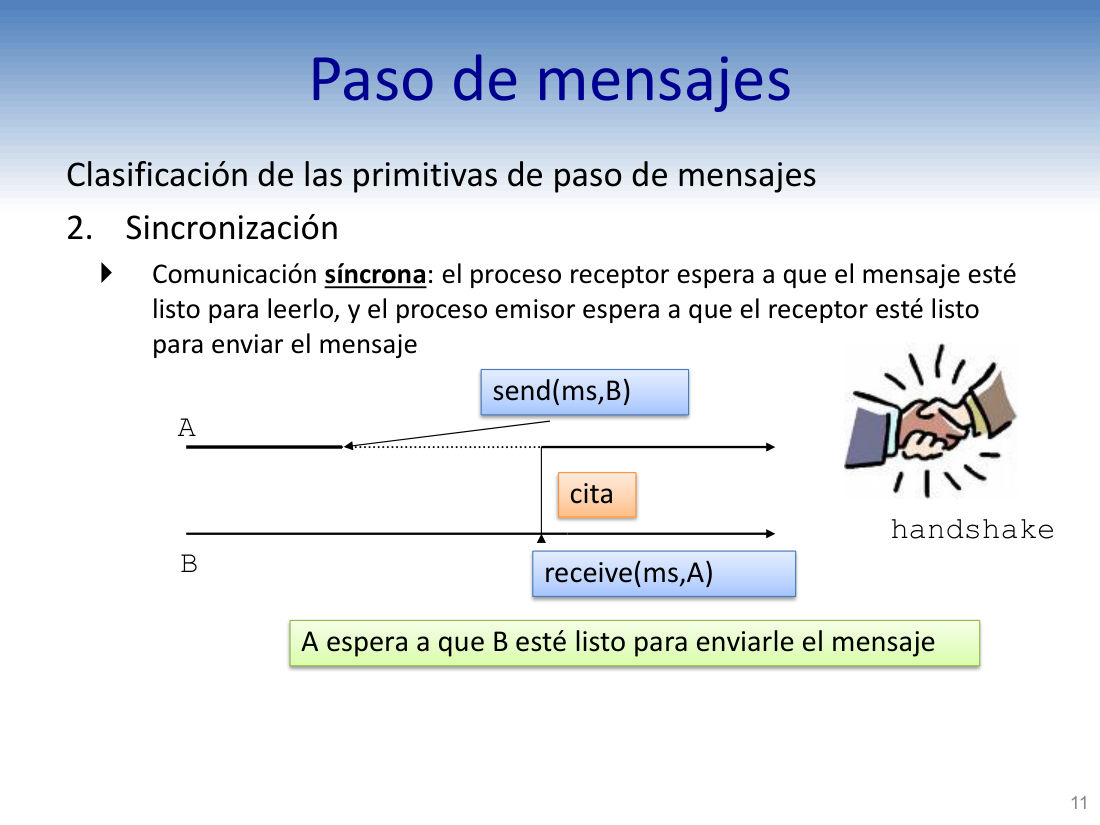
消息传递
2.
2.
A
A(发送方进程)
B
B(接收方进程)
send(ms,B)
A 执行 send(ms,B)
receive(ms,A)
B 执行 receive(ms,A)
A espera a que B esté listo para enviarle el mensaje
A 等待 B 准备好接收,才能把消息交给它
2. Sincronización · 同步扩展通信:还要等回复
▸ 原页截图 p.12
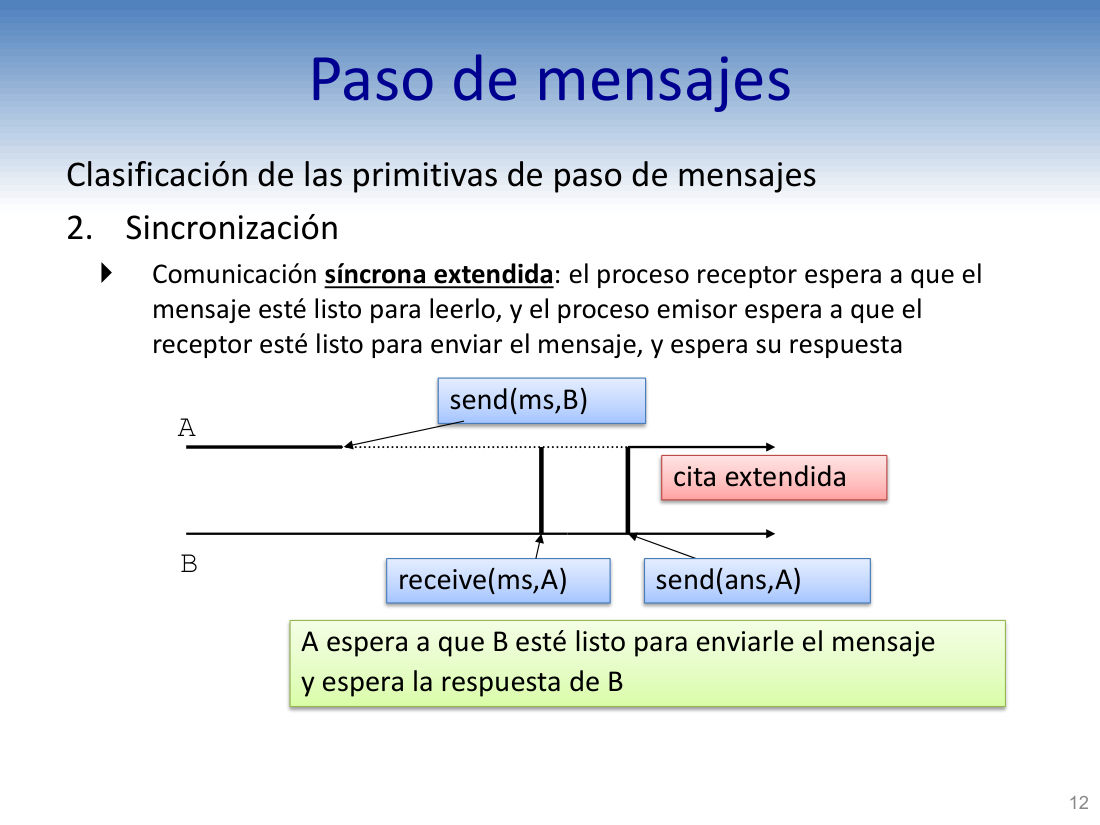
消息传递
2.
2.
A
A(发送方进程)
B
B(接收方进程)
send(ms,B)
A 发出请求消息 ms 给 B
receive(ms,A)
B 从 A 收到请求消息
A espera a que B esté listo para enviarle el mensaje
A 等 B 准备好接收
y espera la respuesta de B
并且(发送完成后)继续等 B 的应答
send(ans,A)
B 用 send(ans,A) 把应答 ans 回给 A
2. Sincronización · 同步扩展:从接收方视角看
▸ 原页截图 p.13
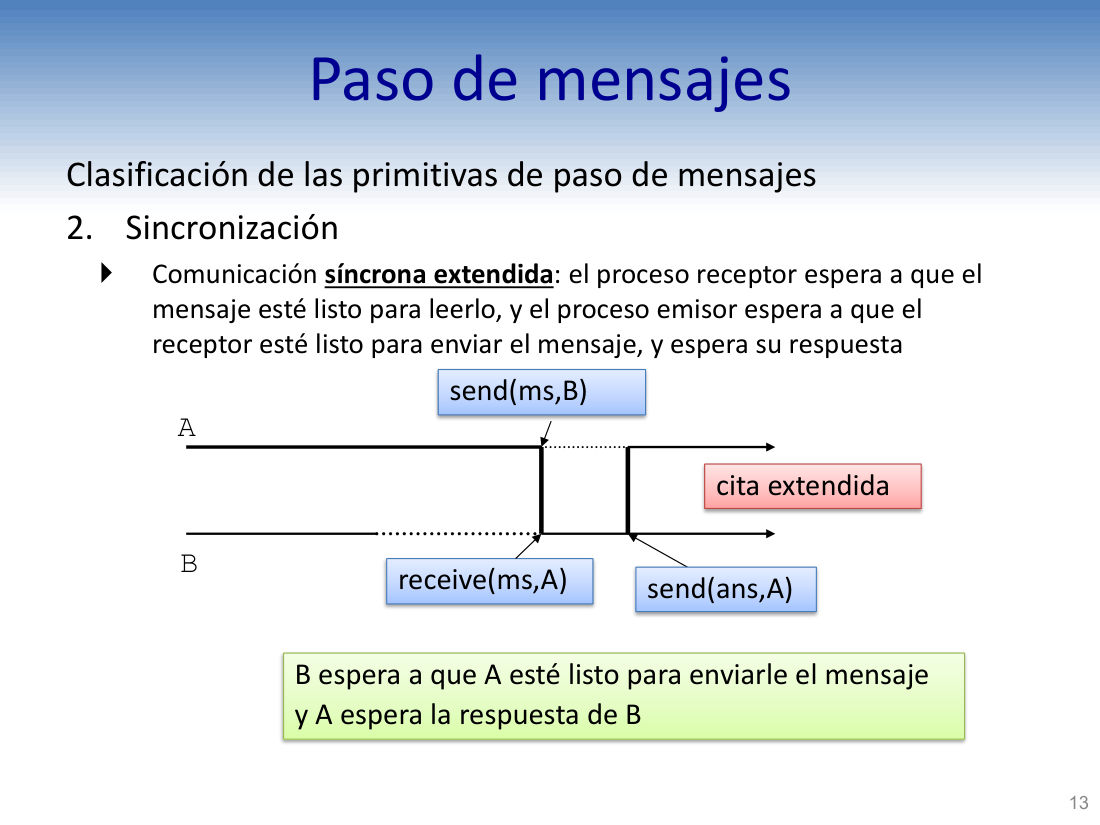
消息传递
2.
2.
A
A(发送方进程)
B
B(接收方进程)
send(ms,B)
A 发出请求消息 ms
receive(ms,A)
B 收到来自 A 的请求
B espera a que A esté listo para enviarle el mensaje
B 等待 A 就绪(即 B 自己阻塞在 receive 上,等 A 来消息)
y A espera la respuesta de B
而 A 则在等 B 的应答
send(ans,A)
B 执行 send(ans,A) 发出应答
| 模式 | 发送方阻塞? | 接收方阻塞? | 消息次数 | 讲义用词 |
|---|---|---|---|---|
| 异步 | 否 | 是(等消息) | 1 | asíncrona |
| 同步 | 是(等对方就绪) | 是(等消息) | 1 | síncrona / cita / handshake |
| 同步扩展 | 是(还要等回复) | 是 | 2 | síncrona extendida / cita extendida |
四、POSIX 消息队列:从概念到 API
p.14–p.18Colas de mensajes · 消息队列与管道的四点差异
▸ 原页截图 p.14
• Un mecanismo
• 一种
• Es parecido a los
• 它很像 Linux 的
– Las colas de mensajes tienen una
– 消息队列具有
– Se puede asignar una
– 可以给消息指定
– El
–
– Se puede conocer el
– 可以查询消息队列的
Colas de mensajes · mq_open:创建/打开队列
▸ 原页截图 p.15
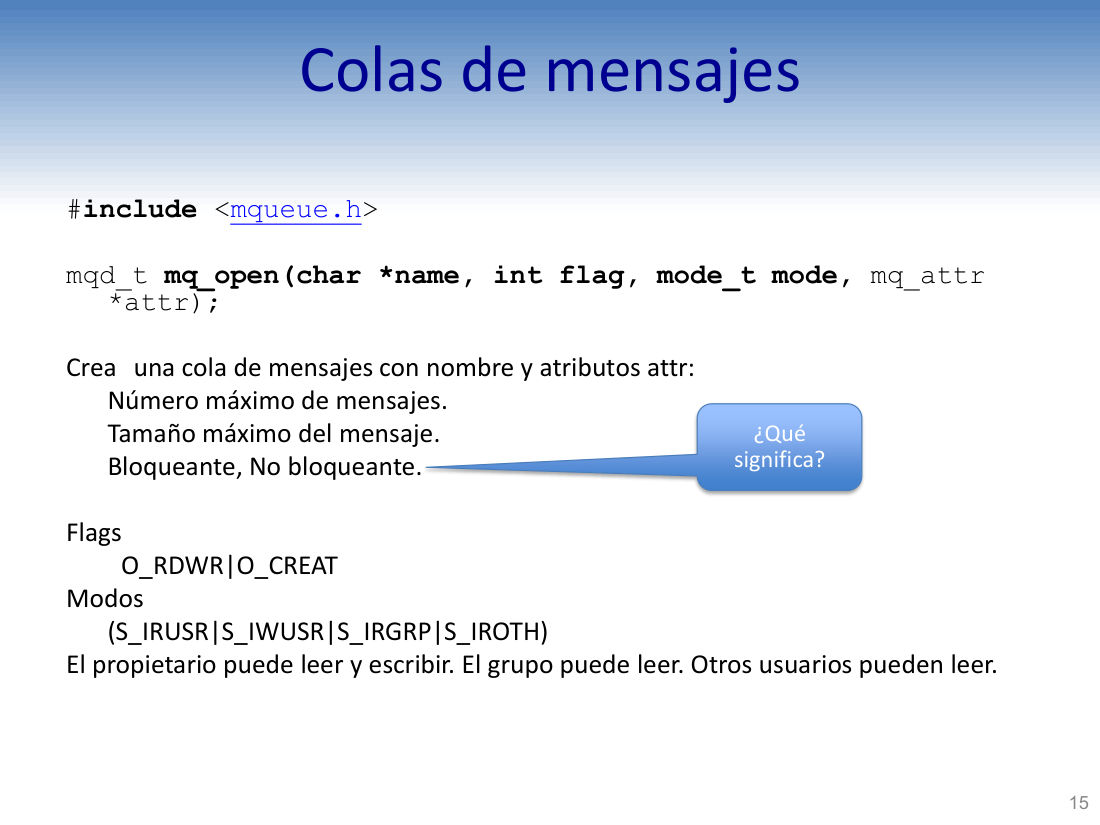
#include <mqueue.h>
头文件:#include <mqueue.h>(POSIX 消息队列全部原语都在这里)
mqd_t mq_open(char *name, int flag, mode_t mode, mq_attr *attr);
mqd_t mq_open(char *name, int flag, mode_t mode, mq_attr *attr);——打开或创建队列,返回队列描述符
Crea una cola de mensajes con nombre y atributos attr:
创建一个带名字、带属性 attr 的消息队列:
Número máximo de mensajes.
(attr 第 1 项)队列中消息的最大条数。
Tamaño máximo del mensaje.
(attr 第 2 项)单条消息的最大字节数。
Bloqueante, No bloqueante.
(attr 第 3 项)阻塞 / 非阻塞标志。
Flags
Flags(打开方式标志)
O_RDWR|O_CREAT
O_RDWR|O_CREAT:可读写,且不存在就创建
Modos
Modos(权限位)
(S_IRUSR|S_IWUSR|S_IRGRP|S_IROTH)
(S_IRUSR|S_IWUSR|S_IRGRP|S_IROTH):属主读+写、同组读、其他读
El
¿Qué significa?
「这是什么意思?」(教师旁注气泡,指向上面 attr 的三个字段)
/* 原页函数原型(逐字照抄) */
mqd_t mq_open(char *name, int flag, mode_t mode, mq_attr *attr);

/* 实际调用时的四个实参 */
idcola = mq_open("/PC",                       /* name:以 / 开头的名字 */
                 O_RDWR|O_CREAT,              /* flag:可读写 + 不存在则创建 */
                 (S_IRUSR|S_IWUSR|S_IRGRP|S_IROTH), /* mode:权限 */
                 &attr);                       /* attr:队列属性 */
mq_open 调用形态 · Tema 4 · Paso de mensajes · p.15
Colas de mensajes · struct mq_attr 与 mq_close
▸ 原页截图 p.16
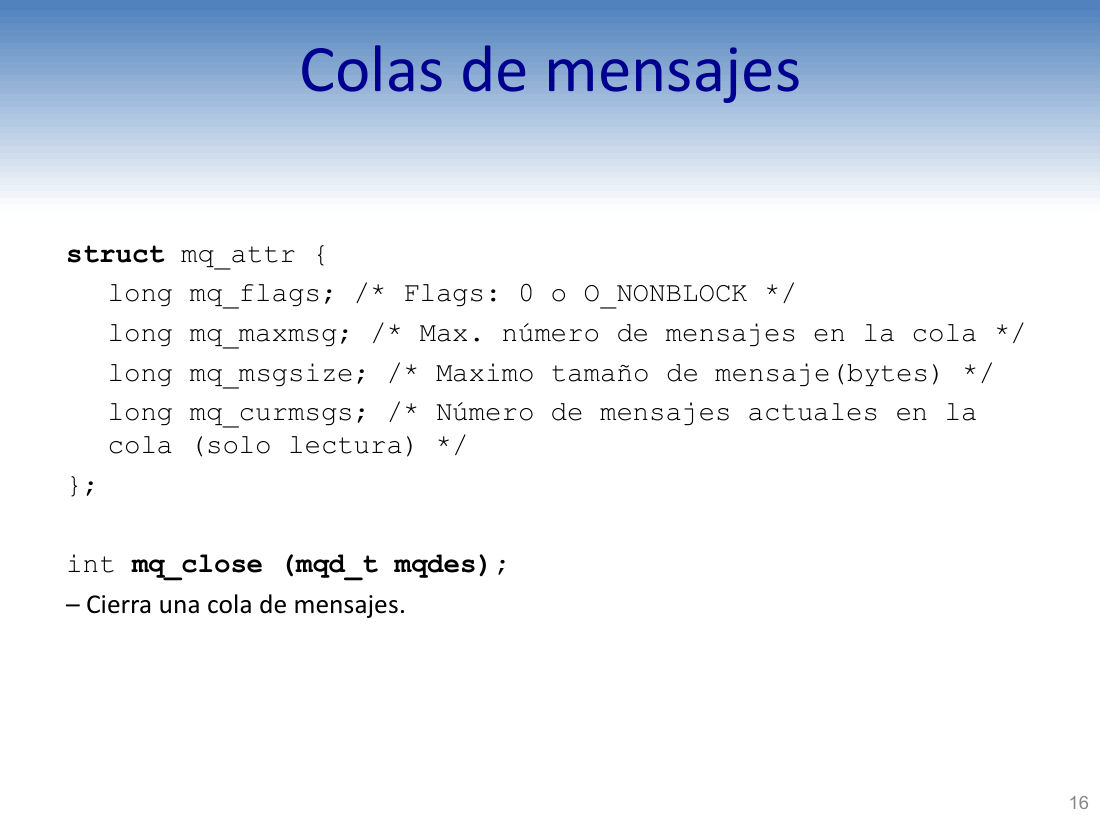
struct mq_attr {
struct mq_attr {——队列属性结构体开始
long mq_flags; /* Flags: 0 o O_NONBLOCK */
long mq_flags; 标志位:0 或 O_NONBLOCK
long mq_maxmsg; /* Max. número de mensajes en la cola */
long mq_maxmsg; 队列中消息的最大条数
long mq_msgsize; /* Maximo tamaño de mensaje(bytes) */
long mq_msgsize; 单条消息的最大字节数
long mq_curmsgs; /* Número de mensajes actuales en la cola (solo lectura) */
long mq_curmsgs; 队列当前消息条数(只读)
};
};——结构体结束
int mq_close (mqd_t mqdes);
int mq_close (mqd_t mqdes);——关闭队列描述符
– Cierra una cola de mensajes.
– 关闭一个消息队列(只释放本进程的句柄,不删除队列本身)
| 字段 | 西语注释读法 | 中文含义 | 可写? |
|---|---|---|---|
| mq_flags | «flags: cero o o-nonblock» | 阻塞/非阻塞标志 | 可写 |
| mq_maxmsg | «máximo número de mensajes en la cola» | 队列容量上限(条) | 创建时写 |
| mq_msgsize | «máximo tamaño de mensaje, en bytes» | 单条消息最大字节 | 创建时写 |
| mq_curmsgs | «número de mensajes actuales» | 当前条数 | 只读 |
Colas de mensajes · mq_send 与 mq_receive
▸ 原页截图 p.17
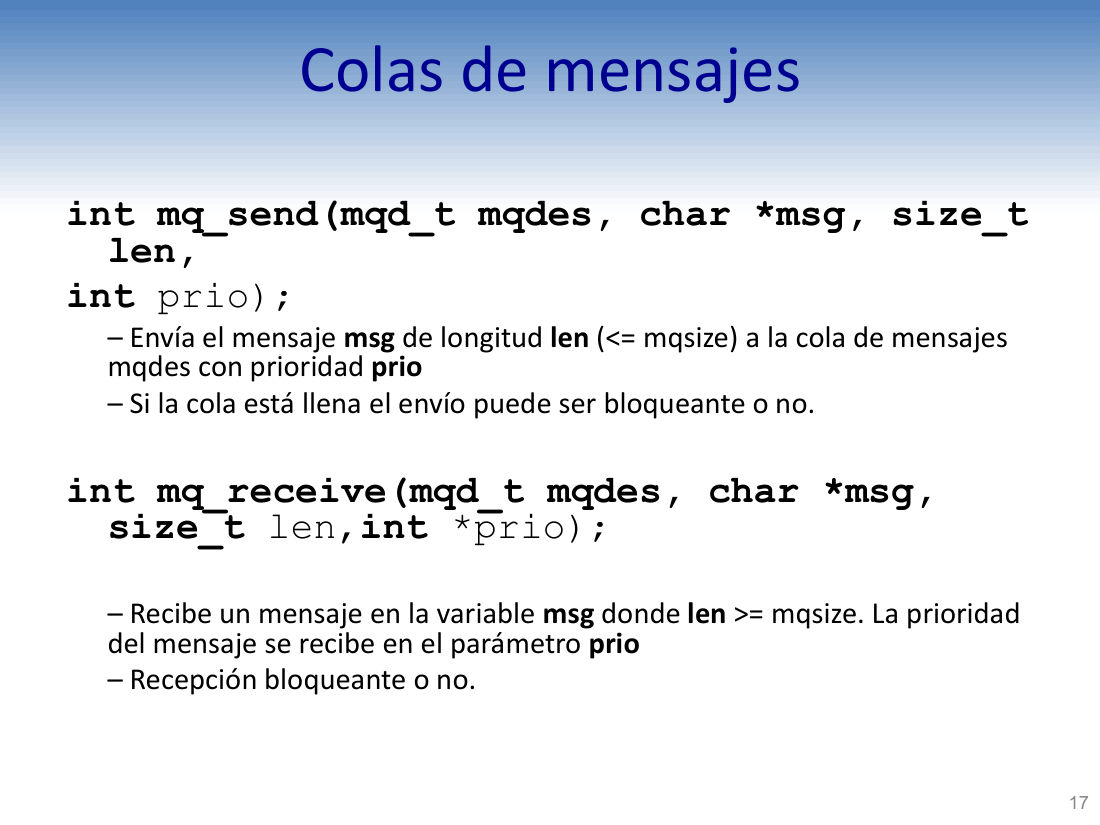
int mq_send(mqd_t mqdes, char *msg, size_t len, int prio);
int mq_send(mqd_t mqdes, char *msg, size_t len, int prio);——发送一条消息
– Envía el
– 把长度为 len(≤ mqsize)的消息 msg 发送到队列 mqdes,并带上
– Si la cola está
– 若队列已
int mq_receive(mqd_t mqdes, char *msg, size_t len, int *prio);
int mq_receive(mqd_t mqdes, char *msg, size_t len, int *prio);——接收一条消息
– Recibe un mensaje en la variable msg donde len >= mqsize. La prioridad del mensaje se recibe en el parámetro prio
– 把消息收到变量 msg 中,要求 len ≥ mqsize;该消息的优先级通过参数 prio 带回
–
–
| 原语 | 参数 | 方向 | 长度约束 | prio 的含义 |
|---|---|---|---|---|
| mq_send | mqdes, msg, len, prio | 进程 → 队列 | len <= mqsize | 传入消息的优先级 |
| mq_receive | mqdes, msg, len, &prio | 队列 → 进程 | len >= mqsize | 传出消息的优先级 |
Colas de mensajes · mq_unlink:先清场再开工
▸ 原页截图 p.18
页面横幅:
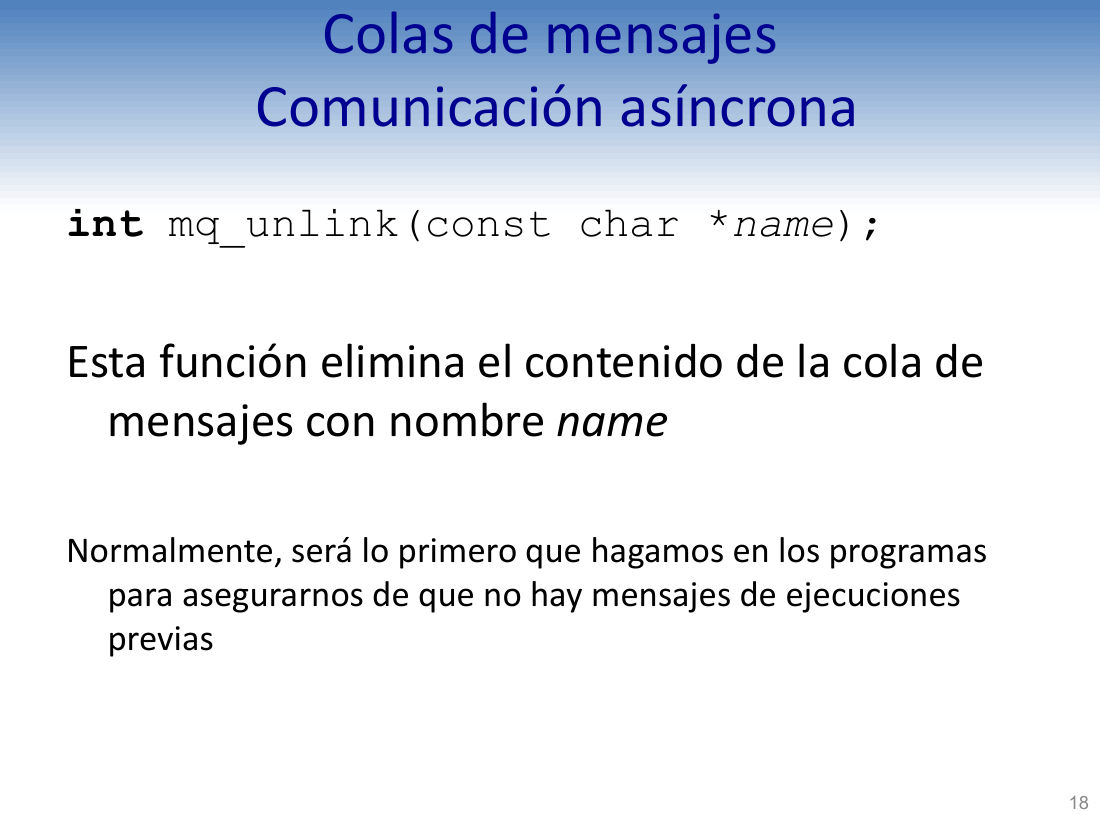
int mq_unlink(const char *name);
int mq_unlink(const char *name);——按名字删除队列
Esta función
该函数
Normalmente, será lo primero que hagamos en los programas para asegurarnos de que no hay mensajes de ejecuciones previas
通常它会是程序里最先做的事,以确保不残留上次运行留下的消息
/* 程序开头的标准三连(顺序不能颠倒) */
mq_unlink("/PC");                                  /* ① 先清掉上次残留 */
idcola = mq_open("/PC", O_RDWR|O_CREAT,             /* ② 再创建/打开 */
                 (S_IRUSR|S_IWUSR|S_IRGRP|S_IROTH), &attr);
/* ③ 最后才 pthread_create 起生产者和消费者 */
清场顺序 · Tema 4 · Paso de mensajes · p.18
五、完整实例:生产者 / 消费者与花园问题
p.19–p.23Productor/Consumidor · int main():建队列、起线程
▸ 原页截图 p.19
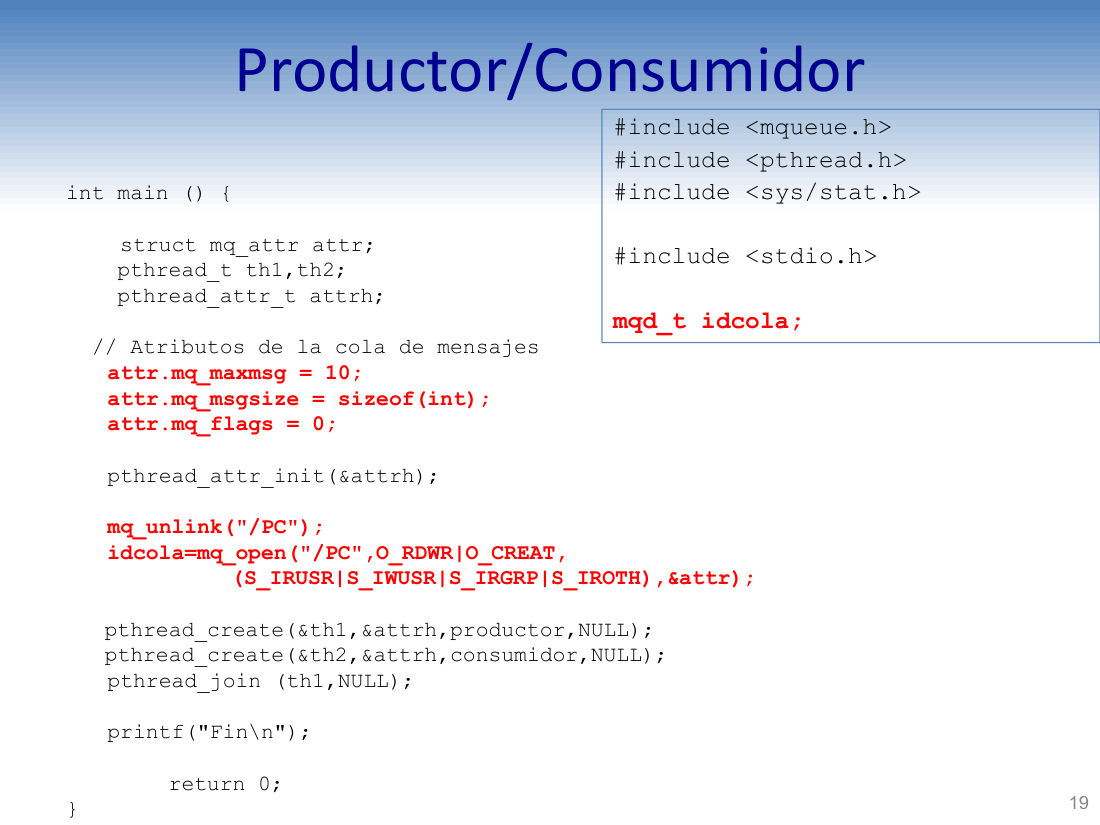
#include <mqueue.h>
#include <mqueue.h>——消息队列整套 API(mq_open/mq_send/mq_receive)
#include <pthread.h>
#include <pthread.h>——
#include <sys/stat.h>
#include <sys/stat.h>——提供权限宏 S_IRUSR 等
#include <stdio.h>
#include <stdio.h>——printf
mqd_t idcola;
mqd_t idcola;——全局队列描述符,两个线程共用同一个句柄
int main () {
int main () {——主线程只负责「搭场景」,干活交给两个 hebra
struct mq_attr attr;
struct mq_attr attr;——声明
pthread_t th1,th2;
pthread_t th1,th2;——两个线程标识:th1 生产者、th2 消费者
pthread_attr_t attrh;
pthread_attr_t attrh;——线程
// Atributos de la cola de mensajes
// 消息队列的属性——下面三行才是队列属性
attr.mq_maxmsg = 10;
attr.mq_maxmsg = 10;——队列最多容纳 10 条消息
attr.mq_msgsize = sizeof(int);
attr.mq_msgsize = sizeof(int);——每条消息恰好一个 int(通常 4 字节)
attr.mq_flags = 0;
attr.mq_flags = 0;——0 表示阻塞模式(不加 O_NONBLOCK)
pthread_attr_init(&attrh);
pthread_attr_init(&attrh);——线程属性先初始化再用,不能直接传未初始化的 attrh
mq_unlink("/PC");
mq_unlink("/PC");——先清掉上次运行残留的队列(名字 "/PC")
idcola=mq_open("/PC",O_RDWR|O_CREAT,(S_IRUSR|S_IWUSR|S_IRGRP|S_IROTH),&attr);
idcola=mq_open("/PC",O_RDWR|O_CREAT,(S_IRUSR|S_IWUSR|S_IRGRP|S_IROTH),&attr);——创建并打开队列,返回描述符存进 idcola
pthread_create(&th1,&attrh,productor,NULL);
pthread_create(&th1,&attrh,productor,NULL);——创建生产者线程,入口函数 productor
pthread_create(&th2,&attrh,consumidor,NULL);
pthread_create(&th2,&attrh,consumidor,NULL);——创建消费者线程,入口函数 consumidor
pthread_join (th1,NULL);
pthread_join (th1,NULL);——主线程在此等 th1(而 th1 是 while(1) 死循环,实际永远等不到)
printf("Fin\n");
printf("Fin\n");——只有 th1 结束才会打印「Fin」,因此这行在实践中几乎不会执行
return 0;
return 0;——主线程正常返回
}
}——main 结束;没有 mq_close/mq_unlink 收尾
/* 全局:两个线程共用同一个队列描述符 */
mqd_t idcola;

int main () {
  struct mq_attr attr;
  pthread_t th1,th2;
  pthread_attr_t attrh;

  /* ① 队列属性:装 10 条、每条一个 int、阻塞模式 */
  attr.mq_maxmsg  = 10;
  attr.mq_msgsize = sizeof(int);
  attr.mq_flags   = 0;

  pthread_attr_init(&attrh);

  mq_unlink("/PC");                        /* ② 清场 */
  idcola = mq_open("/PC", O_RDWR|O_CREAT,  /* ③ 建队列 */
        (S_IRUSR|S_IWUSR|S_IRGRP|S_IROTH), &attr);

  pthread_create(&th1, &attrh, productor,  NULL);  /* ④ 起线程 */
  pthread_create(&th2, &attrh, consumidor, NULL);

  pthread_join (th1, NULL);
  printf("Fin\n");
  return 0;
}
main.c · 生产者/消费者主程序 · Tema 4 · Paso de mensajes · p.19
| 步骤 | 语句 | 如果不写会怎样 |
|---|---|---|
| ① 填属性 | attr.mq_maxmsg / mq_msgsize / mq_flags | attr 是栈上未初始化值,mq_open 会拿到垃圾容量 |
| ② 清场 | mq_unlink("/PC") | 读到上次运行残留的消息,生产/消费对不上号 |
| ③ 建队列 | mq_open(..., &attr) | 后面所有 mq_send/receive 无句柄可用 |
| ④ 起线程 | pthread_create × 2 | 队列建好但没人读写,程序停在 pthread_join |
Productor/Consumidor · productor:mq_send 死循环
▸ 原页截图 p.20
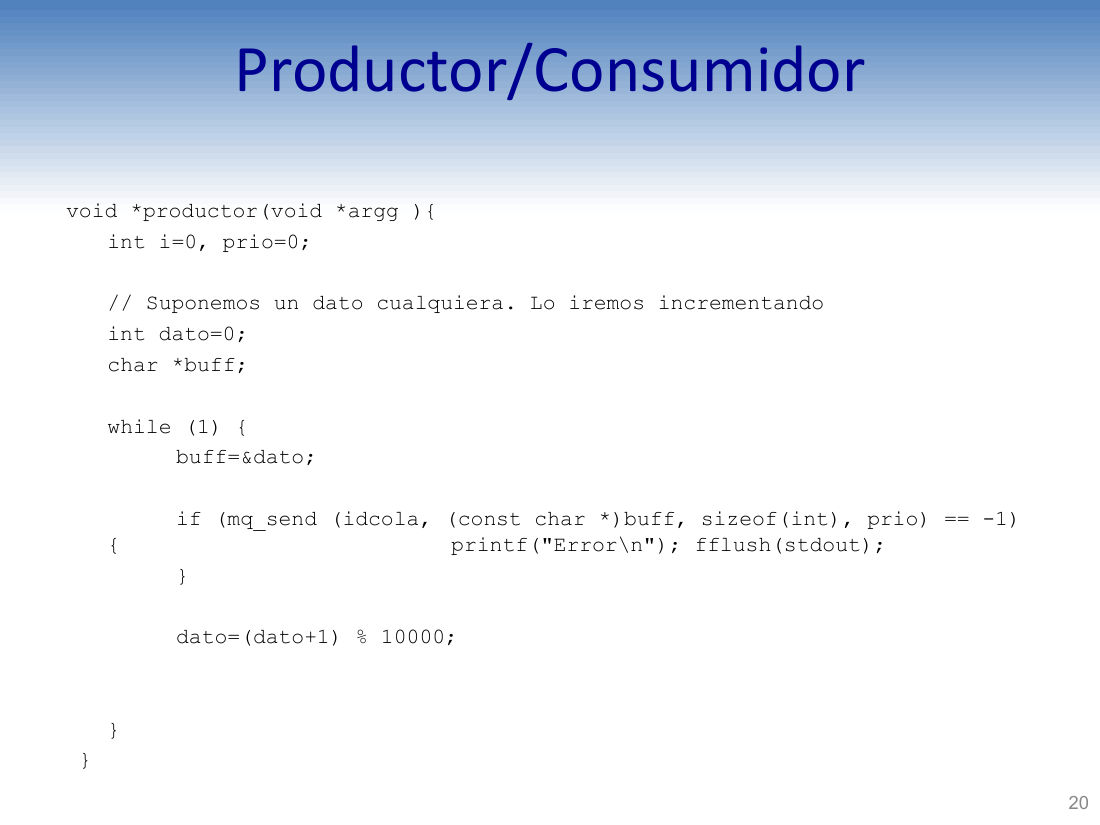
void *productor(void *argg ){
void *productor(void *argg ){——线程入口:返回 void*、接收 void*(本例 argg 未使用)
int i=0, prio=0;
int i=0, prio=0;——
// Suponemos un dato cualquiera. Lo iremos incrementando
// 假设有一个任意数据,我们会不断把它加一
int dato=0;
int dato=0;——真正被发送的变量,初值 0
char *buff;
char *buff;——指针,只作「字节视角」的临时别名,不分配缓冲
while (1) {
while (1) {——无限生产:队列满了就在 mq_send 里阻塞等待
buff=&dato;
buff=&dato;——让 buff 指向 dato 的首字节地址
if (mq_send (idcola, (const char *)buff, sizeof(int), prio) == -1)
if (mq_send (idcola, (const char *)buff, sizeof(int), prio) == -1)——向队列发送 sizeof(int) 个字节,返回 -1 即失败
{
{——失败分支开始
printf("Error\n"); fflush(stdout);
printf("Error\n"); fflush(stdout);——打印错误并强制刷新输出缓冲
}
}——失败分支结束(没有 break,出错也继续循环)
dato=(dato+1) % 10000;
dato=(dato+1) % 10000;——自增并在 10000 处回绕,保证数值始终有限
}
}——while 结束
}
}——函数结束(没有 return,因为永远进不来)
void *productor(void *argg ){
  int i=0, prio=0;
  // Suponemos un dato cualquiera. Lo iremos incrementando
  int dato=0;
  char *buff;

  while (1) {
    buff = &dato;                    /* 取 dato 的地址,按字节发送 */
    if (mq_send (idcola, (const char *)buff, sizeof(int), prio) == -1)
    {
      printf("Error\n"); fflush(stdout);
    }
    dato = (dato+1) % 10000;       /* 0..9999 循环 */
  }
}
productor.c · 生产者线程 · Tema 4 · Paso de mensajes · p.20
| 时刻 | dato | 被发送的 4 字节 | prio | 队列状态 |
|---|---|---|---|---|
| t1 | 0 | 0x00 0x00 0x00 0x00 | 0 | 1/10 |
| t2 | 1 | 0x01 0x00 0x00 0x00 | 0 | 2/10 |
| t3 | … | … | 0 | 满 10 条后 阻塞 |
| t4 | 9999 | 0x0F 0x27 0x00 0x00 | 0 | 下一次回到 0 |
Productor/Consumidor · consumidor:mq_receive 死循环
▸ 原页截图 p.21
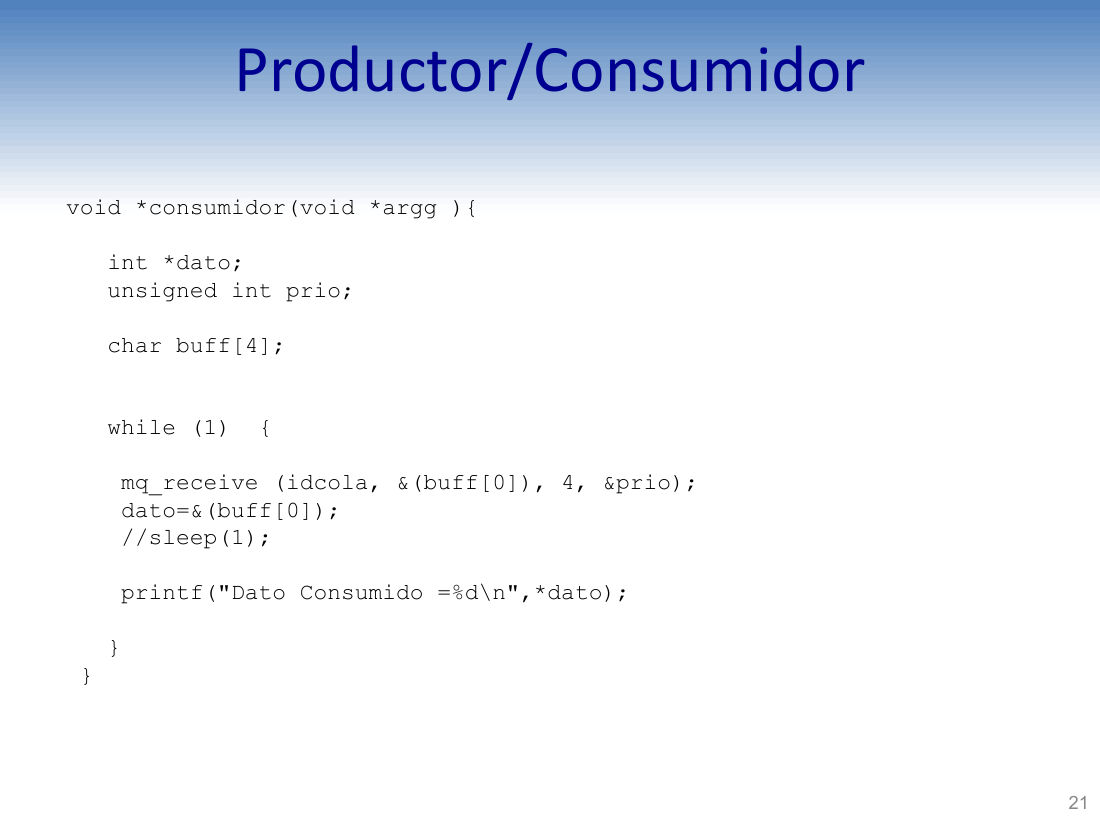
void *consumidor(void *argg ){
void *consumidor(void *argg ){——消费者线程入口,与生产者签名完全一致
int *dato;
int *dato;——准备一个 int*,用来解释收到的字节
unsigned int prio;
unsigned int prio;——接收端用来带回消息优先级的变量(此处收完不用)
char buff[4];
char buff[4];——真正的接收缓冲区,硬编码 4 字节
while (1) {
while (1) {——无限消费:队列空就在 mq_receive 里阻塞等
mq_receive (idcola, &(buff[0]), 4, &prio);
mq_receive (idcola, &(buff[0]), 4, &prio);——从队列取一条,装进 buff,优先级写入 prio
dato=&(buff[0]);
dato=&(buff[0]);——把 int* 指向缓冲区首字节,等价于 dato=buff
//sleep(1);
//sleep(1);——被注释掉的节流语句:想演示「慢消费」时取消注释即可
printf("Dato Consumido =%d\n",*dato);
printf("Dato Consumido =%d\n",*dato);——解引用打印收到的整数(原文 ",*dato" 中间无空格,照抄)
}
}——while 结束
}
}——函数结束
void *consumidor(void *argg ){
  int *dato;
  unsigned int prio;
  char buff[4];                  /* 缓冲区 = 一条消息的最大字节数 */

  while (1) {
    mq_receive (idcola, &(buff[0]), 4, &prio);  /* 阻塞直到有消息 */
    dato = &(buff[0]);           /* 按 int 解释这 4 个字节 */
    //sleep(1);                  /* 打开即可放慢消费速度 */
    printf("Dato Consumido =%d\n", *dato);
  }
}
consumidor.c · 消费者线程 · Tema 4 · Paso de mensajes · p.21
El problema de los jardines · 花园问题:为什么死等两次
▸ 原页截图 p.22
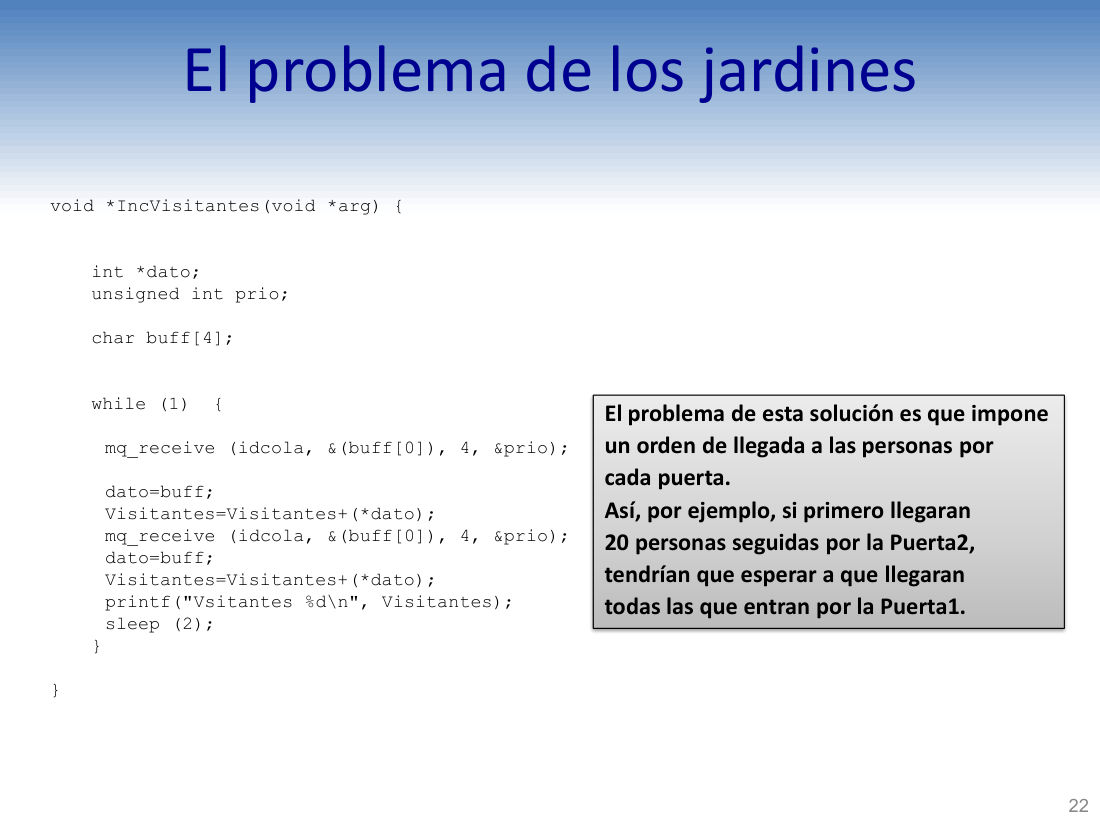
void *IncVisitantes(void *arg) {
void *IncVisitantes(void *arg) {——统计入园人数的线程:IncVisitantes = 增加访客数
int *dato;
int *dato;——解释缓冲区用的指针
unsigned int prio;
unsigned int prio;——接收优先级(同样未使用)
char buff[4];
char buff[4];——4 字节接收缓冲
while (1) {
while (1) {——每轮循环固定处理两条消息
mq_receive (idcola, &(buff[0]), 4, &prio);
第一次 mq_receive (idcola, &(buff[0]), 4, &prio);——收门 1 的到达人数
dato=buff;
dato=buff;——指向缓冲区(此处直接写 buff,比 p.21 的 &(buff[0]) 更简洁)
Visitantes=Visitantes+(*dato);
Visitantes=Visitantes+(*dato);——累加到全局计数 Visitantes
mq_receive (idcola, &(buff[0]), 4, &prio);
第二次 mq_receive (idcola, &(buff[0]), 4, &prio);——收门 2 的到达人数;问题就出在这一行
dato=buff;
dato=buff;——重新指向缓冲区(同一块内存被覆盖)
Visitantes=Visitantes+(*dato);
Visitantes=Visitantes+(*dato);——再累加一次
printf("Vsitantes %d\n", Visitantes);
printf("Vsitantes %d\n", Visitantes);——打印累计值(原文拼写为 Vsitantes,少一个 i,照抄)
sleep (2);
sleep (2);——暂停 2 秒,模拟「每 2 秒结算一次」
}
}——while 结束
}
}——函数结束
void *IncVisitantes(void *arg) {
  int *dato;
  unsigned int prio;
  char buff[4];

  while (1) {
    mq_receive (idcola, &(buff[0]), 4, &prio);  /* ① 等门 1 */
    dato=buff;
    Visitantes = Visitantes + (*dato);

    mq_receive (idcola, &(buff[0]), 4, &prio);  /* ② 死等门 2 */
    dato=buff;
    Visitantes = Visitantes + (*dato);

    printf("Vsitantes %d\n", Visitantes);  /* 原文笔误:应为 Visitantes */
    sleep (2);
  }
}
IncVisitantes.c · 花园问题 · Tema 4 · Paso de mensajes · p.22
El problema de esta solución es que impone un orden de llegada a las personas por cada puerta.
这个解法的问题在于:它给每道门的人都强加了一个到达顺序。
Así, por ejemplo, si primero llegaran 20 personas seguidas por la Puerta2,
举例来说,如果先有 20 个人连续从 2 号门进来,
tendrían que esperar a que llegaran todas las que entran por la Puerta1.
那他们就得等 1 号门的人全部到齐(因为循环里第二次 receive 死等门 1)
En resumen… · 本章小结
▸ 原页截图 p.23
• Hemos visto un modelo diferente sin compartición de memoria
• 我们看到了一个不共享内存的不同模型
• Diferentes modos: uno a uno, muchos a muchos
• 多种模式:
• Síncrono vs asíncrono
•
• Colas de mensajes como mecanismo POSIX
•
六、专有名词总表(A–Z)
全章 23 页专有名词速记表(A–Z)
按西语字母排序,点页码直接跳回对应页块。最后一列是「一句话记住 / 易错点」——考前只扫这一列也能救急。
| 西语术语 | 中文 | 页 | 一句话记住 / 易错点 |
|---|---|---|---|
| A | |||
| acoplamiento débil | 弱耦合 | p.3 | 不共享内存 → 只能靠消息通信,这是全章的逻辑起点 |
| asíncrona (comunicación) | 异步通信 | p.8 | 只有接收方阻塞,发送方发完就走 |
| atributos de la cola | 队列属性 | p.19 | maxmsg / msgsize / flags 三项,open 之前必须填好 |
| B | |||
| bidireccional | 双向 | p.5 | 同一对进程互相收发,两条方向各一条链路 |
| bloqueante | 阻塞的 | p.17 | 队列空/满时调用不返回,进程被挂起等待 |
| buzón | 信箱 | p.4 | 间接通信的中间结构;原文写作 buzon(无重音) |
| C | |||
| canal | 通道 | p.4 | 与 buzón 并列的间接结构,写法 send(ms,canal) |
| cita | 会合 / 约会 | p.10 | 同步通信:双方都阻塞,见面才交接 |
| cita extendida | 扩展会合 | p.12 | 会合后再等一句回复,全程两条消息 |
| cola de mensajes | 消息队列 | p.14 | POSIX 的高效异步机制,可跨进程也可跨 hebra |
| compartición de memoria | 内存共享 | p.23 | 本模型没有它——这是全章最核心的一句 |
| consumidor | 消费者 | p.21 | 只做 mq_receive,缓冲区要够大(≥ 消息长度) |
| D | |||
| Directa-Asimétrica | 直接·不对称 | p.4 | 接收方写 receive(ms):不点名,谁来都收 |
| Directa-Simétrica | 直接·对称 | p.4 | 双方都点名:send(ms,pidA) / receive(ms,pidB) |
| E | |||
| emisor | 发送方 | p.3 | 图里左侧那个箭头起点,对应 send |
| estructuras intermedias | 中间结构 | p.4 | buzón 与 canal 的统称,间接通信全靠它解耦 |
| H | |||
| hebra | 线程 | p.14 | 消息队列既能在 procesos 间、也能在 hebras 间通信 |
| I | |||
| Identificación de los procesos | 进程标识方式 | p.4 | 分类第 1 维:直接 / 间接 × 对称 / 不对称 |
| Indirecta-Simétrica | 间接·对称 | p.4 | 双方都写同一个 buzon/canal 名,靠中间结构会合 |
| M | |||
| mensaje | 消息 | p.3 | 通信的最小单位,走 canal 从 emisor 到 receptor |
| muchos a muchos | 多对多 | p.7 | 3 emisor + 3 receptor,拓扑里最一般的情形 |
| muchos a uno | 多对一 | p.6 | 多个 emisor 汇到一个 receptor,天然汇聚点 |
| mq_attr | 队列属性结构体 | p.16 | 四个字段:flags / maxmsg / msgsize / curmsgs |
| mq_close | 关闭队列句柄 | p.16 | 只关本进程句柄,队列还在 |
| mq_curmsgs | 当前消息条数 | p.16 | 四个字段里唯一只读的 |
| mq_flags | 队列标志位 | p.16 | 0 = 阻塞;O_NONBLOCK = 不阻塞 |
| mq_maxmsg | 最大消息条数 | p.19 | 本例 = 10,是容量不是字节数 |
| mq_msgsize | 单条消息最大字节 | p.19 | 本例 sizeof(int),决定收发缓冲大小 |
| mq_open | 创建/打开队列 | p.15 | 四参数:名字、flags、权限模式、属性 |
| mq_receive | 接收消息 | p.17 | 要求 len >= mqsize,prio 是出参 |
| mq_send | 发送消息 | p.17 | 要求 len <= mqsize,prio 是入参 |
| mq_unlink | 删除队列 | p.18 | 参数是名字不是句柄,程序第一步就调用 |
| mqd_t | 队列描述符类型 | p.15 | 相当于队列的「文件描述符」,全局共享一个 |
| O | |||
| O_NONBLOCK | 非阻塞标志 | p.16 | 置位后队列空/满时立刻返回,不死等 |
| orden de llegada | 到达顺序 | p.22 | 花园问题的病根:强加交替顺序 → 快门被慢门拖死 |
| P | |||
| paso de mensajes | 消息传递 | p.3 | 弱耦合系统里唯一可用的通信范式 |
| pipe | 管道 | p.14 | 消息队列最像它,但多了优先级/状态/控制/结构 |
| prioridad | 优先级 | p.15 | 消息队列相对 pipe 的关键增强,可指定取哪条 |
| productor | 生产者 | p.20 | 只做 mq_send,长度必须 ≤ mq_msgsize |
| Puerta1 / Puerta2 | 1 号门 / 2 号门 | p.22 | 花园问题的两个入口,对应两条消息来源 |
| Punto a punto | 点对点 | p.5 | 一对一,再分单向 / 双向两种画法 |
| R | |||
| receptor | 接收方 | p.3 | 对应 receive,异步时它是唯一阻塞的一方 |
| receive(ms, buzon) | 从信箱接收 | p.4 | 间接通信的接收原语,与 send 必须同名同结构 |
| S | |||
| semáforo | 信号量 | p.3 | 共享内存时代的同步工具,在本模型不适用 |
| send(ms, pidA) | 定向发送 | p.4 | 直接通信的发送原语,第二个参数是收件进程 |
| Sincronización | 同步方式 | p.8 | 分类第 2 维:异步 / 同步 / 同步扩展 |
| síncrona (comunicación) | 同步通信 | p.10 | 双方都阻塞,必须 cita 才会合 |
| U | |||
| unidireccional | 单向 | p.5 | 只有 emisor → receptor 一个箭头 |
| uno a muchos | 一对多 | p.6 | 一个 emisor 广播,多个 receptor 各收一份 |
| uno a uno | 一对一 | p.5 | 最基础拓扑,其余都是它的叠加 |
| V | |||
| Visitantes | 访客(计数) | p.22 | 原文 printf 误拼 Vsitantes,答题别跟着错 |
七、编号与规则速记卡
背诵版两条分类轴 + 四点差异 + 五个函数
原文只给编号不给总结,这三张表把「1. Identificación」「2. Sincronización」和 POSIX 接口全部压成可背的形式。
| 编号 | 名称 | 三个取值 | 一句话 |
|---|---|---|---|
| 1 | Identificación de los procesos | Directa-Simétrica / Directa-Asimétrica / Indirecta-Simétrica | 看「有没有中间结构」和「接收方点不点名」 |
| 2 | Sincronización | Asíncrona / Síncrona (cita) / Cita extendida | 看「谁在阻塞」:一方法、双方、双方加回程 |
| # | Colas de mensajes vs pipes(原文四点差异) | 中文 |
|---|---|---|
| 1 | estructura interna | 队列有内部结构,消息按边界成条,不是纯字节流 |
| 2 | prioridad | 可以给消息指定优先级,接收方可挑着取 |
| 3 | control del programador | 程序员对队列本身有控制权(建、删、设属性) |
| 4 | estado de la cola | 可以查询队列状态(mq_curmsgs) |
| # | 函数 | 作用 | 关键约束 |
|---|---|---|---|
| 1 | mq_open | 创建/打开命名队列 | 名字以 / 开头;flags 用 O_RDWR|O_CREAT |
| 2 | mq_send | 投递一条消息 | len <= mq_msgsize |
| 3 | mq_receive | 取走一条消息 | len >= mq_msgsize;prio 传地址 |
| 4 | mq_close | 关闭本进程句柄 | 队列与消息仍然存在 |
| 5 | mq_unlink | 按名字删除队列 | 程序第一步调用,清掉上次残留 |
八、易混概念对照卡
考前 3 分钟15 组最容易写反的概念
左格与右格只差一个关键词——考场上问「区别是什么」,答的就是那一句。
原语里写进程:send(ms,pidA)。
原语里写中间结构:send(ms,buzon) / (ms,canal)。
收发双方都点名,一一对应。
接收方不点名:receive(ms),谁来都收。
只有接收方阻塞等消息,发送方发完继续跑。
双方都阻塞,cita 会合才交接。
会合即结束,全程一条消息。
会合后还要回一句:send(ans,A),共两条。
一个箭头,只有 emisor → receptor。
两个箭头,双方互为收发。
一个 emisor,多个 receptor。
多个 emisor,一个 receptor。
信箱式中间结构,原文写作 buzon。
通道式中间结构,send(ms,canal)。
第三个参数 len ≤ mqsize(发货可以小)。
第三个参数 len ≥ mqsize(收货必须够大)。
值传递,你告诉队列这条消息多重要。
地址传递,队列把它读到的优先级写回给你。
关句柄,队列与消息仍存在,别人还能用。
按名字删队列,这才是真正移除。
队列能装几条(本例 10)。
每条多少字节(本例 sizeof(int))。
阻塞:空则等、满则等。
不阻塞:立刻返回错误码,自己重试。
只读,告诉你现在有几条。
创建时写,告诉你最多几条。
只看 mq_send,队列满时被阻塞。
只看 mq_receive,队列空时被阻塞。
按消息真实到达顺序处理,谁快谁先走。
强行「门 1、门 2」交替 → 快门被慢门锁死。