- 一页一块:页号胶囊是 PDF 物理页序(1–40);幻灯片上印的页码可能另有编号,以胶囊为准。
- 逐句对照:蓝色左框内是西语原句(逐字照抄,含原文笔误),下面带「中」字标的是中文翻译;项目符号统一用 • 表示。
- 提示框:绿色「考点」= 这页怎么考;红色「陷阱」= 易错点与原文勘误;紫色「记忆钩子」= 口诀;橙色「补充」= 前后页串联。
- 术语悬停:西语句里带浅蓝底的词,鼠标停上去出中文;中文句里带虚下划线的词,停上去出西语原词。
- 公式:一律用本地 MathJax 渲染(断网也能显示),每个公式下附「符号 / 西语读法 / 中文含义」三列小表——口语考试念的就是这一列。
一、引言:调制器、解调器与符号收发链
p.3–p.5Comunicaciones Digitales · Bloque 2 · Tema 2(课程封面)
▸ 原页截图 p.1
Comunicaciones Digitales
数字通信
Bloque 2: Transmisión en canales planos
第二模块:平坦信道上的传输
Tema 2: Transmisión y recepción de símbolos
主题 2:符号的发送与接收
Grado en Ingeniería de Telemática
远程通信工程学士
Departamento de Ingeniería de Comunicaciones
通信工程系
Universidad de Málaga
马拉加大学
Profesor: Laureano Moreno Pozas
授课教师:Laureano Moreno Pozas
Curso 2026/2027
学年 2026/2027
Contenido · 本讲目录(2.1–2.7 七节)
▸ 原页截图 p.2
Tema 2: Transmisión y recepción de símbolos
主题 2:符号的发送与接收
2.1 Introducción
2.1 引论
2.2 Codificación de símbolos
2.2 符号编码
2.3 Decodificación de símbolos
2.3 符号解码
2.4 Amplitudes
2.4 幅度
2.5 Etiquetas
2.5 标签(比特组)
2.6 PAM
2.6 PAM(脉冲幅度调制)
2.7 QAM
2.7 QAM(正交幅度调制)
2.1 Introducción · 调制器与解调器总框图
▸ 原页截图 p.3
2.1 Introducción
2.1 引论
Esquema del modulador y demodulador
调制器与解调器框图
Esquema de transmisión y recepción de símbolos
符号发送与接收框图
Tema 2: Transmisión y recepción de símbolos
主题 2:符号的发送与接收(本节 2.1 引论)
2.1 · 调制器/解调器的两项分工
▸ 原页截图 p.4
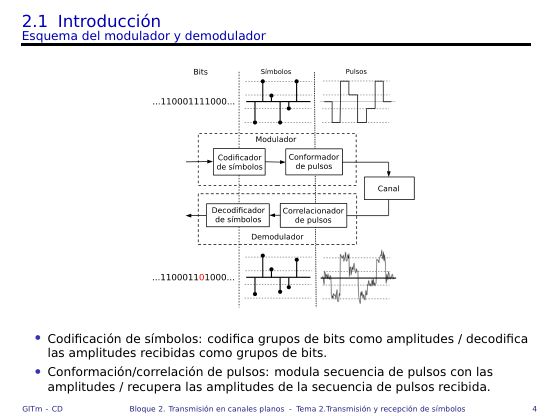
Codificación de símbolos: codifica grupos de bits como amplitudes / decodifica las amplitudes recibidas como grupos de bits.
符号编码:把若干比特组成一组编码成一个幅度/解码:把收到的幅度解码回一组比特。
Conformación/correlación de pulsos: modula secuencia de pulsos con las amplitudes / recupera las amplitudes de la secuencia de pulsos recibida.
脉冲成形/相关:用这些幅度去调制脉冲序列/从收到的脉冲序列中恢复出幅度。
GITm - CD
课程标识:远程通信工程 · 数字通信
2.1 Introducción
2.1 引论 · 调制器与解调器框图
2.1 · 符号发送/接收链路(编码器—离散等效信道—解码器)
▸ 原页截图 p.5
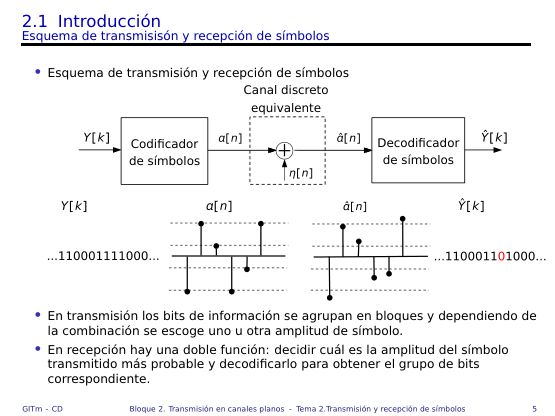
Esquema de transmisión y recepción de símbolos
符号发送与接收框图
Codificador de símbolos
符号编码器
Decodificador de símbolos
符号解码器
Canal discreto equivalente
离散等效信道
En transmisión los bits de información se agrupan en bloques y dependiendo de la combinación se escoge uno u otra amplitud de símbolo.
发送端把信息比特分成若干块,按块内比特的组合选取对应的符号幅度。
En recepción hay una doble función: decidir cuál es la amplitud del símbolo transmitido más probable y decodificarlo para obtener el grupo de bits correspondiente.
接收端有双重任务:先判决「最可能发送的是哪个符号幅度」,再把它解码成对应的比特组。
二、符号编码:标签 → 索引 → 幅度
p.6–p.92.2 Codificación de símbolos · 本节三条目
▸ 原页截图 p.6
2.2 Codificación de símbolos
2.2 符号编码
Descripción
描述
Energía y régimen binario
能量与比特速率
Diagrama de bloques
框图
2.2 · Descripción:B 比特标签 → S 个幅度
▸ 原页截图 p.7
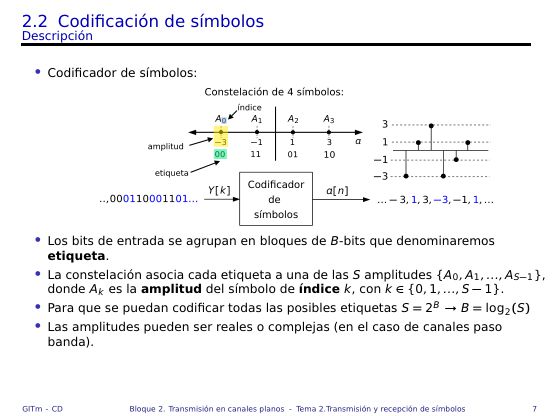
Los bits de entrada se agrupan en bloques de B-bits que denominaremos etiqueta.
输入比特被分成每 B 比特一块,我们把这一块叫作「标签」(etiqueta)。
La constelación asocia cada etiqueta a una de las S amplitudes {A0, A1, ..., AS−1}, donde Ak es la amplitud del símbolo de índice k, con k ∈ {0, 1, ..., S − 1}.
星座把每个标签关联到 S 个幅度 {A0, A1, …, AS−1} 中的一个;Ak 是索引 k 的符号幅度,k ∈ {0, 1, …, S−1}。
Para que se puedan codificar todas las posibles etiquetas S = 2B → B = log2(S)
为了能编码全部可能的标签:S = 2B → B = log2(S)。
Las amplitudes pueden ser reales o complejas (en el caso de canales paso banda).
幅度可以是实数或复数(后者用于通带信道)。
2.2 · 星座平均能量与比特速率
▸ 原页截图 p.8
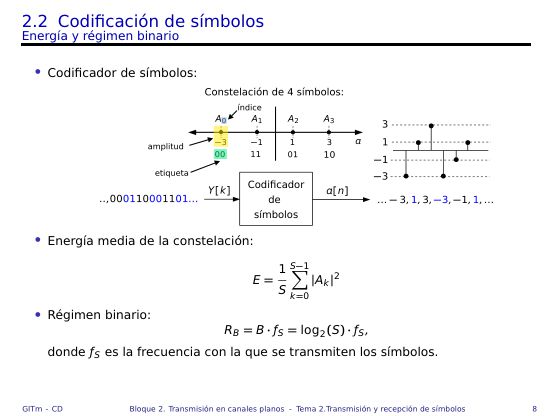
Energía media de la constelación:
星座平均能量:
Régimen binario:
比特速率(二进制速率):
donde ƒS es la frecuencia con la que se transmiten los símbolos.
其中 ƒS 是符号的发送频率(符号率)。
GITm - CD
课程标识;本页给出两条公式:平均能量 E 与比特速率 RB
2.2 · 框图:先编标签,再编幅度
▸ 原页截图 p.9
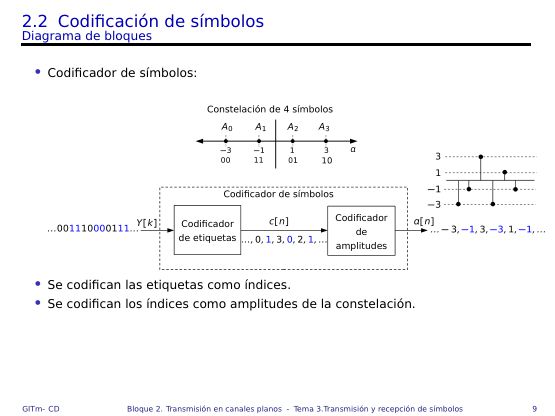
Diagrama de bloques
框图
Codificador de etiquetas
标签编码器
Codificador de amplitudes
幅度编码器
Se codifican las etiquetas como índices.
先把标签编码为索引。
Se codifican los índices como amplitudes de la constelación.
再把索引编码为星座中的幅度。
三、符号解码:幅度 → 索引 → 标签
p.10–p.122.3 Decodificación de símbolos · 本节两条目
▸ 原页截图 p.10
2.3 Decodificación de símbolos
2.3 符号解码
Descripción
描述
Diagrama de bloques
框图
2.3 Decodificación de símbolos
2.3 符号解码(本节两条目:描述、框图)
2.3 · Descripción:带误差的幅度 → 最可能索引
▸ 原页截图 p.11
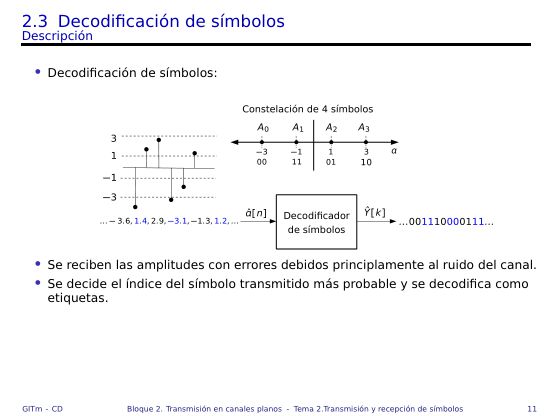
Se reciben las amplitudes con errores debidos principlamente al ruido del canal.
收到的幅度带有误差,主要来自信道噪声。
Se decide el índice del símbolo transmitido más probable y se decodifica como etiquetas.
判决出发送端最可能的符号索引,再解码为标签。
Decodificador de símbolos
符号解码器:输入带噪幅度,输出标签(比特组)
GITm - CD
课程标识
2.3 · 框图:先判幅度,再解标签
▸ 原页截图 p.12
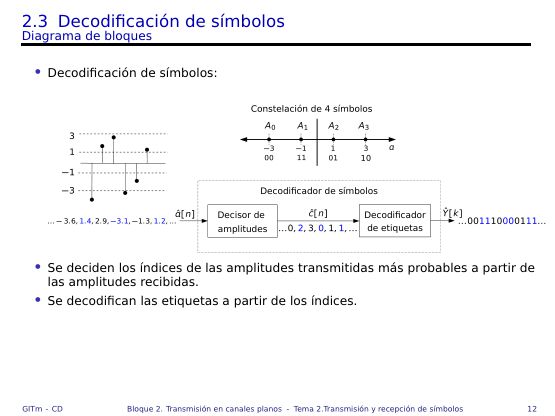
Decisor de amplitudes
幅度判决器
Decodificador de etiquetas
标签解码器
Se deciden los índices de las amplitudes transmitidas más probables a partir de las amplitudes recibidas.
根据收到的幅度,判决出最可能的发送幅度索引。
Se decodifican las etiquetas a partir de los índices.
再由索引解码出标签。
四、幅度:最小距离判决与判决区域
p.13–p.202.4 Amplitudes · 本节七条目
▸ 原页截图 p.13
2.4 Amplitudes
2.4 幅度
Codificación
编码
Decisión / Mínima distancia
判决/最小距离
Regiones de decisión
判决区域
Implementación
实现
Representación / Histogramas
表示/直方图
Representación / Nubes de puntos
表示/点云(散点图)
Python
Python 实现
2.4 · Codificación:用幅度表实现星座
▸ 原页截图 p.14
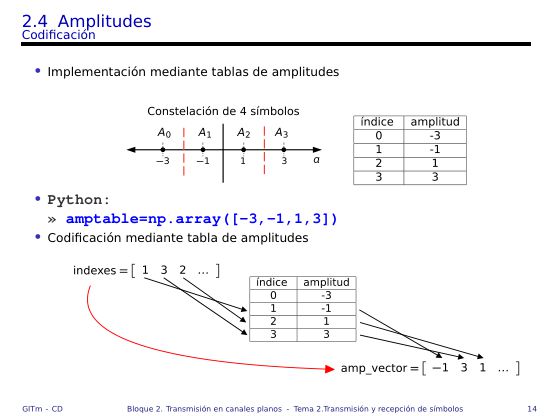
Implementación mediante tablas de amplitudes
通过幅度表实现
Codificación mediante tabla de amplitudes
利用幅度表进行编码
Tabla de amplitudes: [−3, −1, 1, 3]
幅度表:索引 0…3 分别对应 −3、−1、1、3
GITm - CD
课程标识
import numpy as np
amptable = np.array([-3, -1, 1, 3])      # 4-PAM 幅度表
index = np.array([0, 2, 3, 1])           # 索引向量
amplitudes = amptable[index]             # 编码:索引 → 幅度
2.4 · 判决:最小距离准则与判决区边界
▸ 原页截图 p.15
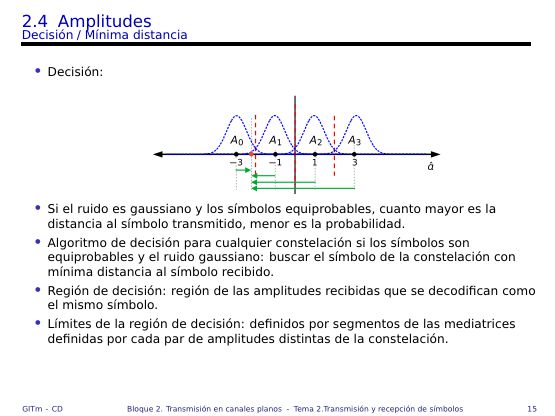
Decisión
判决
Si el ruido es gaussiano y los símbolos equiprobables, cuanto mayor es la distancia al símbolo transmitido, menor es la probabilidad.
若噪声为高斯且各符号等概,则「离发送符号越远,概率越小」。
Algoritmo de decisión para cualquier constelación si los símbolos son equiprobables y el ruido gaussiano: buscar el símbolo de la constelación con mínima distancia al símbolo recibido.
当符号等概、噪声高斯时,对任意星座的判决算法:找出与收到符号距离最小的星座点。
Región de decisión: región de las amplitudes recibidas que se decodifican como el mismo símbolo.
判决区域:会被解码成同一个符号的那些「收到幅度」构成的区域。
Límites de la región de decisión: definidos por segmentos de las mediatrices definidas por cada par de amplitudes distintas de la constelación.
判决区边界:由星座中每一对不同幅度所确定的中垂线(mediatrices)的线段所界定。
2.4 · 判决区域示例:16-QAM 的方形网格
▸ 原页截图 p.16
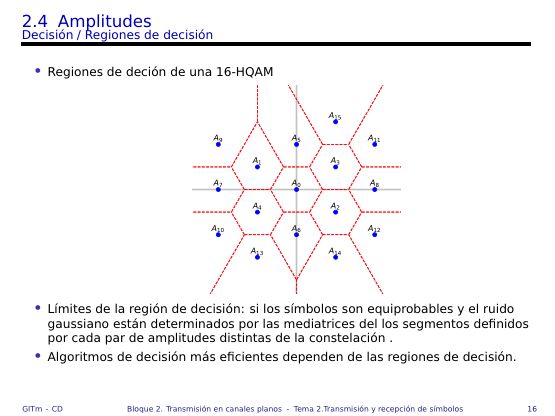
Regiones de decisión de una 16-HQAM
一个 16-QAM 的判决区域
Límites de la región de decisión: si los símbolos son equiprobables y el ruido gaussiano están determinados por las mediatrices de los segmentos definidos por cada par de amplitudes distintas de la constelación.
判决区边界:当符号等概且噪声高斯时,由星座中每一对不同幅度所定线段的中垂线确定。
Algoritmos de decisión más eficientes dependen de las regiones de decisión.
更高效的判决算法依赖于判决区域的形状。
A0, A1, …, A15
星座的 16 个幅度标记(原图逐点标注)
2.4 · 判决器的实现:算距离、取最小
▸ 原页截图 p.17
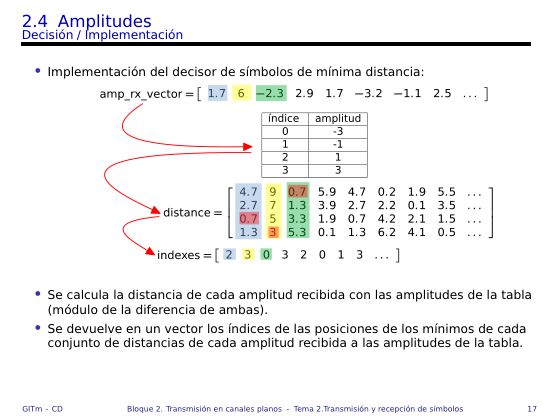
Implementación del decisor de símbolos de mínima distancia
最小距离符号判决器的实现
Se calcula la distancia de cada amplitud recibida con las amplitudes de la tabla (módulo de la diferencia de ambas).
计算每个收到幅度与幅度表中各元素的距离(两者之差的模)。
Se devuelve en un vector los índices de las posiciones de los mínimos de cada conjunto de distancias de cada amplitud recibida a las amplitudes de la tabla.
以向量返回:对每个收到幅度,取「它到各表项的距离」中最小值的位置索引。
módulo de la diferencia
差的模:|recibida − Ak|
# 示意实现(非原文代码,仅示意 p.17 描述的三步)
def decisor(recibidas, amptable):
    d = np.abs(recibidas[:, None] - amptable[None, :])   # 求差取模
    return np.argmin(d, axis=1)                          # 每行取最小位置的索引
2.4 · 可视化:实数星座用直方图
▸ 原页截图 p.18
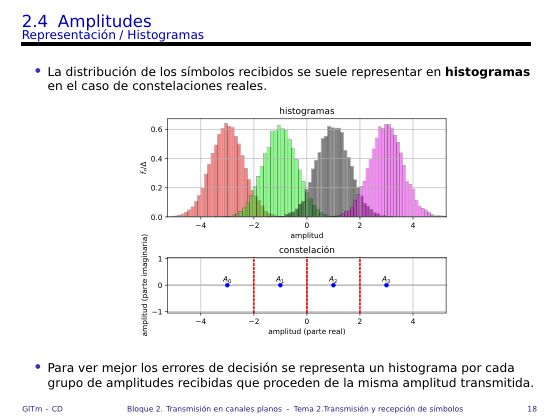
La distribución de los símbolos recibidos se suele representar en histogramas en el caso de constelaciones reales.
对于实数星座,收到的符号分布通常用直方图表示。
Para ver mejor los errores de decisión se representa un histograma por cada grupo de amplitudes recibidas que proceden de la misma amplitud transmitida.
为更清楚地看出判决错误,按「来自同一发送幅度」分组,每组画一个直方图。
constelación
星座(原图左侧:4 个幅度点)
histogramas
直方图(原图右侧:按发送幅度分组的四个驼峰)
2.4 · 可视化:复数星座用点云(scatter)
▸ 原页截图 p.19
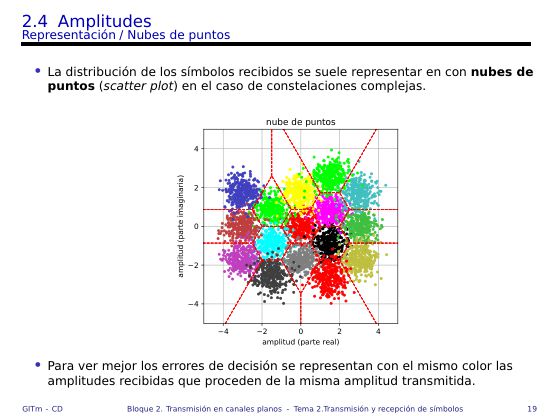
La distribución de los símbolos recibidos se suele representar con nubes de puntos (scatter plot) en el caso de constelaciones complejas.
对于复数星座,收到的符号分布通常用点云(散点图)表示。
Para ver mejor los errores de decisión se representan con el mismo color las amplitudes recibidas que proceden de la misma amplitud transmitida.
为更清楚地看出判决错误,把「来自同一发送幅度」的收到幅度画成同一种颜色。
nube de puntos
点云/散点图(scatter plot)
constelación
星座(原图左侧的 4 个幅度点)
2.4 · Python:symbols.Amplitudes
▸ 原页截图 p.20
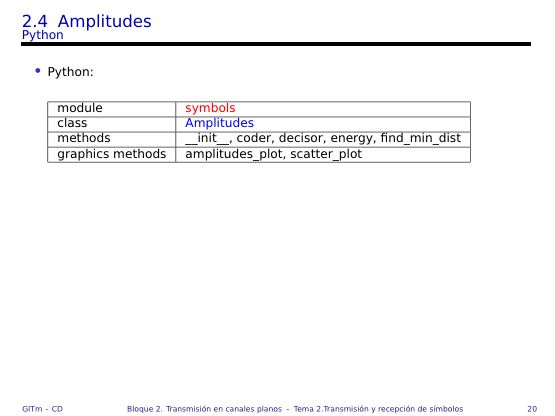
module symbols
模块 symbols
class Amplitudes
类 Amplitudes
methods: __init__, coder, decisor, energy, find_min_dist
方法:__init__、coder、decisor、energy、find_min_dist
graphics methods: amplitudes_plot, scatter_plot
绘图方法:amplitudes_plot、scatter_plot
五、标签表与索引表(含 Gray 映射)
p.21–p.252.5 Etiquetas · 本节四条目
▸ 原页截图 p.21
2.5 Etiquetas
2.5 标签
Tablas de etiquetas y tablas de índices
标签表与索引表
Codificación
编码
Decodificación
解码
Python
Python 实现
2.5 · 三张表:标签表、标签十进制表、索引表
▸ 原页截图 p.22
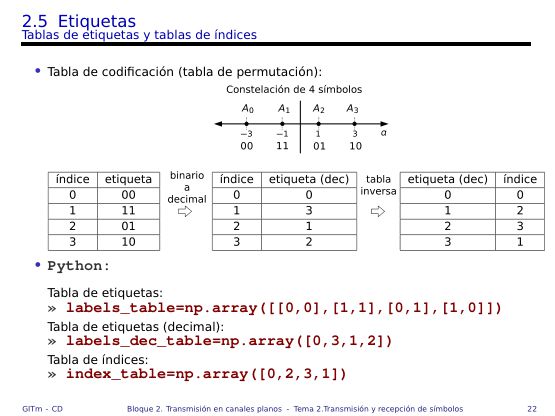
Tabla de codificación (tabla de permutación)
编码表(置换表)
Tabla de etiquetas
标签表
Tabla de etiquetas (decimal)
标签表(十进制形式)
Tabla de índices
索引表
labels_table     = np.array([[0,0],[1,1],[0,1],[1,0]])   # 4 个标签(2 bit)
labels_dec_table = np.array([0, 3, 1, 2])                # 标签的十进制值
index_table      = np.array([0, 2, 3, 1])                # 索引(星座编号)
2.5 · 编码:比特向量 → 索引向量(三步)
▸ 原页截图 p.23
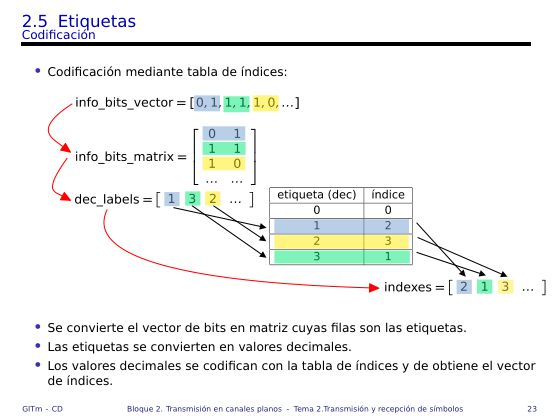
Codificación mediante tabla de índices
利用索引表编码
Se convierte el vector de bits en matriz cuyas filas son las etiquetas.
先把比特向量变成矩阵,每一行是一个标签。
Las etiquetas se convierten en valores decimales.
再把标签转成十进制值。
Los valores decimales se codifican con la tabla de índices y se obtiene el vector de índices.
最后用索引表把十进制值编码,得到索引向量。
2.5 · 解码:索引向量 → 比特向量(两步)
▸ 原页截图 p.24
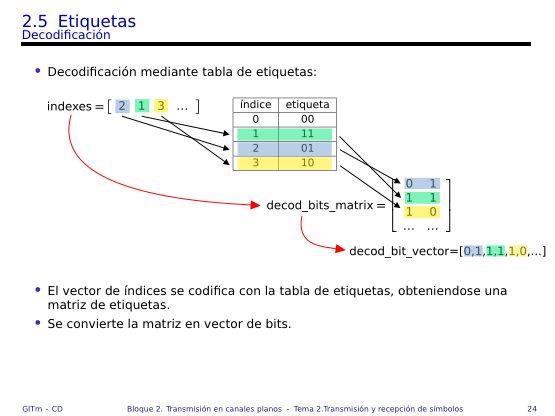
Decodificación mediante tabla de etiquetas
利用标签表解码
El vector de índices se codifica con la tabla de etiquetas, obteniéndose una matriz de etiquetas.
用标签表把索引向量编码,得到标签矩阵。
Se convierte la matriz en vector de bits.
再把矩阵拉平成一维比特向量。
matriz de etiquetas
标签矩阵:每一行是一个标签
2.5 · Python:symbols.Labels 与 symbols.Constellation
▸ 原页截图 p.25
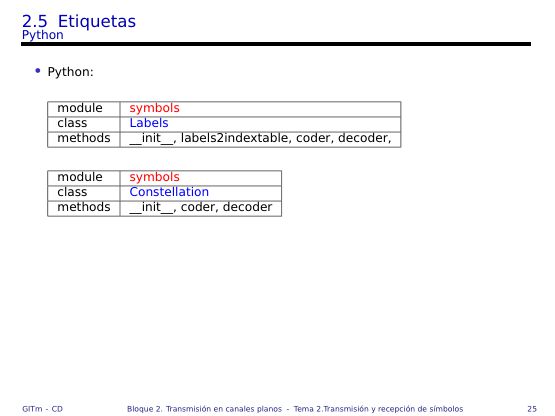
module symbols
模块 symbols
class Labels
类 Labels
methods: __init__, labels2indextable, coder, decoder
方法:__init__、labels2indextable、coder、decoder
class Constellation
类 Constellation
methods: __init__, coder, decoder
方法:__init__、coder、decoder
六、PAM:星座、SER 与 Gray 编码
p.26–p.342.6 PAM · 本节结构
▸ 原页截图 p.26
2.6 PAM
2.6 PAM
Descripción
描述
Errores de símbolos / Cálculo de probabilidad
符号错误/概率计算
Errores de símbolos / Resultados
符号错误/结果
Errores de bits / Diferencias con errores de símbolos
比特错误/与符号错误的区别
Errores de bits / Codificación Gray
比特错误/Gray 编码
Errores de bits / Resultados
比特错误/结果
Python
Python 实现
2.6 · PAM 星座:等间距、零均值、能量公式
▸ 原页截图 p.27
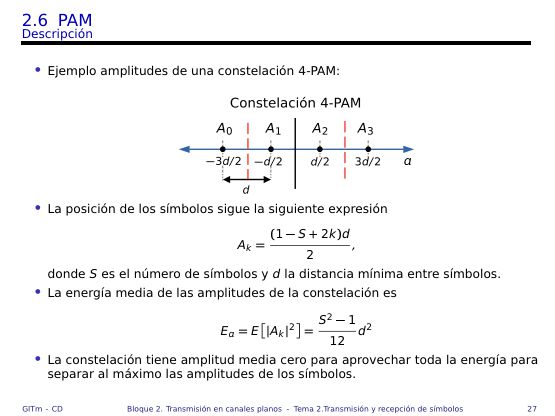
Ejemplo amplitudes de una constelación 4-PAM
4-PAM 星座的幅度示例
La posición de los símbolos sigue la siguiente expresión
符号位置满足下式
donde S es el número de símbolos y d la distancia mínima entre símbolos.
其中 S 是符号数,d 是符号间的最小距离。
La energía media de las amplitudes de la constelación es
星座幅度的平均能量为
La constelación tiene amplitud media cero para aprovechar toda la energía para separar al máximo las amplitudes de los símbolos.
该星座均值为零,以便把所有能量都用于尽可能拉开各符号幅度。
2.6 · SER 的概率计算:只有边缘符号「半边」
▸ 原页截图 p.28
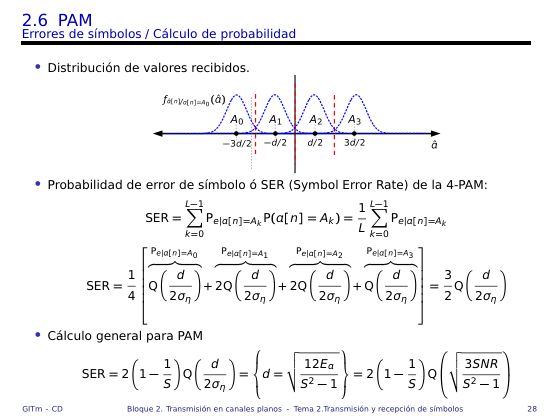
Distribución de valores recibidos.
收到值的分布。
Probabilidad de error de símbolo o SER (Symbol Error Rate) de la 4-PAM
4-PAM 的符号错误概率,即 SER(Symbol Error Rate)
Cálculo general para PAM
PAM 的一般计算
Q(·)
高斯尾函数 Q(x):标准正态分布的尾部概率
2.6 · SER 随 SNR 变化:L = 4 / 8 / 16 三条曲线
▸ 原页截图 p.29
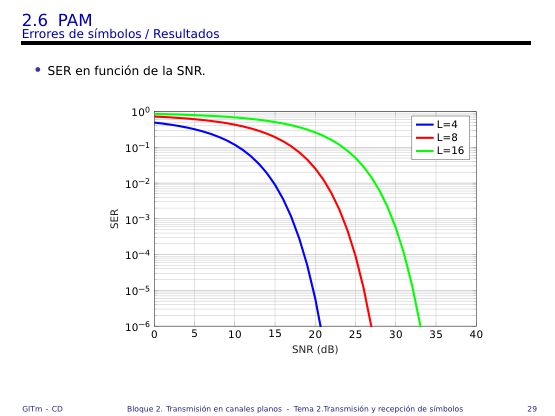
SER en función de la SNR.
SER 随 SNR 的变化。
L = 4
L = 4(即 4-PAM)
L = 8
L = 8
L = 16
L = 16
2.6 · 比特错误 ≠ 符号错误:同一个符号错,可能错 1 位也可能错 2 位
▸ 原页截图 p.30
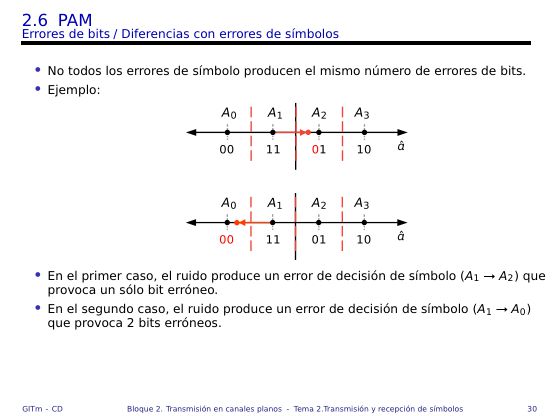
No todos los errores de símbolo producen el mismo número de errores de bits.
并非所有符号错误都产生相同数量的比特错误。
En el primer caso, el ruido produce un error de decisión de símbolo (A1 → A2) que provoca un sólo bit erróneo.
第一种情形:噪声造成符号判决错误(A1 → A2),只导致 1 个比特出错。
En el segundo caso, el ruido produce un error de decisión de símbolo (A1 → A0) que provoca 2 bits erróneos.
第二种情形:噪声造成符号判决错误(A1 → A0),导致 2 个比特出错。
A1 → A2: 1 bit erróneo / A1 → A0: 2 bits erróneos
两种判决错误的比特代价对比(1 位 vs 2 位)
2.6 · Gray 编码:相邻符号只差 1 位
▸ 原页截图 p.31
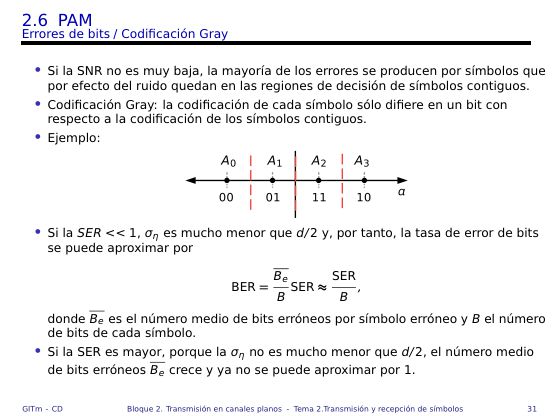
Si la SNR no es muy baja, la mayoría de los errores se producen por símbolos que por efecto del ruido quedan en las regiones de decisión de símbolos contiguos.
当 SNR 不是太低时,多数错误源于「因噪声落进了相邻符号判决区」。
Codificación Gray: la codificación de cada símbolo sólo difiere en un bit con respecto a la codificación de los símbolos contiguos.
Gray 编码:每个符号的编码与相邻符号的编码只相差 1 个比特。
Si la SER << 1, ση es mucho menor que d/2 y, por tanto, la tasa de error de bits se puede aproximar por
若 SER ≪ 1,则 ση 远小于 d/2,因此比特错误率可近似为
donde Be es el número medio de bits erróneos por símbolo erróneo y B el número de bits de cada símbolo.
其中 Be 是「每个错误符号平均错的比特数」,B 是每符号比特数。
Si la SER es mayor, porque la ση no es mucho menor que d/2, el número medio de bits erróneos Be crece y ya no se puede aproximar por 1.
若 SER 较大(ση 并不远小于 d/2),平均错误比特数 Be 会增大,不能再近似为 1。
2.6 · Gray 标签表的迭代构造
▸ 原页截图 p.32
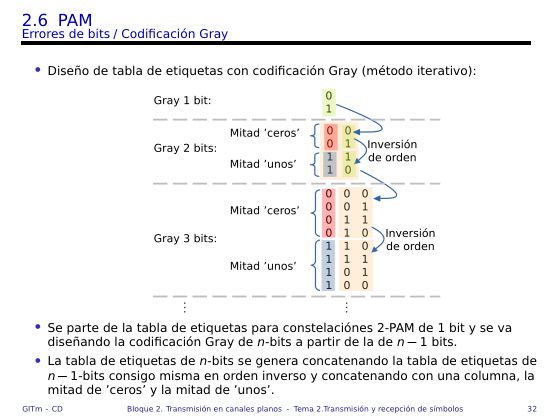
Diseño de tabla de etiquetas con codificación Gray (método iterativo)
Gray 编码标签表的设计(迭代法)
Se parte de la tabla de etiquetas para constelaciones 2-PAM de 1 bit y se va diseñando la codificación Gray de n-bits a partir de la de n − 1 bits.
从 1 比特的 2-PAM 标签表出发,由 n−1 比特的 Gray 码递推出 n 比特的 Gray 码。
La tabla de etiquetas de n-bits se genera concatenando la tabla de etiquetas de n −1-bits consigo misma en orden inverso y concatenando con una columna, la mitad de 'ceros' y la mitad de 'unos'.
n 比特表由「n−1 比特表 + 其逆序」上下拼接,再在最前面加一列(上半为 0、下半为 1)得到。
tabla de 2-PAM (1 bit)
起点:1 比特的 2-PAM 标签表 {0, 1}
n=1:  0 , 1
n=2:  00 01 | 11 10        # 后半是前半的逆序,最高位置 1
n=3:  000 001 011 010 | 110 111 101 100
2.6 · BER 结果:Gray / 非 Gray / 估计式对照
▸ 原页截图 p.33
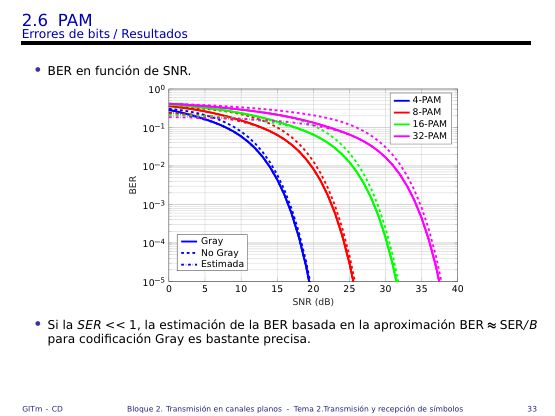
BER en función de SNR.
BER 随 SNR 的变化。
Gray
Gray 编码
No Gray
非 Gray 编码
Estimada
估计值(SER/B)
Si la SER << 1, la estimación de la BER basada en la aproximación BER ≈ SER/B para codificación Gray es bastante precisa.
当 SER ≪ 1 时,Gray 编码下基于 BER ≈ SER/B 的估计相当准确。
2.6 · Python:symbols.PAM
▸ 原页截图 p.34
class PAM(Constellation)
类 PAM(继承自 Constellation)
methods: __init__, amp_PAM_design, labels_Gray_design, SER
方法:__init__、amp_PAM_design、labels_Gray_design、SER
module symbols
模块 symbols
class PAM(Constellation)
类 PAM:2.6 节全部公式的实现
七、QAM:方形星座、SER 与 BER
p.35–p.402.7 QAM · 本节三条目
▸ 原页截图 p.35
2.7 QAM
2.7 QAM
SER
SER(符号错误率)
BER
BER(比特错误率)
Python
Python 实现
2.7 · 方形 S-QAM:两个 L-PAM 拼成
▸ 原页截图 p.36
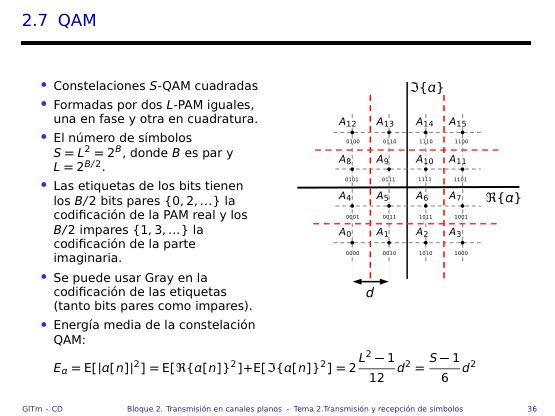
Constelaciones S-QAM cuadradas
方形 S-QAM 星座
Formadas por dos L-PAM iguales, una en fase y otra en cuadratura.
由两个相同的 L-PAM 构成:一个在同相(实)支路,一个在正交(虚)支路。
El número de símbolos S = L2 = 2B, donde B es par y L = 2B/2.
符号数 S = L2 = 2B,其中 B 为偶数,L = 2B/2。
Las etiquetas de los bits tienen los B/2 bits pares {0, 2, ...} la codificación de la PAM real y los B/2 impares {1, 3, ...} la codificación de la parte imaginaria.
标签比特中,偶数位 {0, 2, …} 共 B/2 位取实部 PAM 的编码,奇数位 {1, 3, …} 共 B/2 位取虚部 PAM 的编码。
Se puede usar Gray en la codificación de las etiquetas (tanto bits pares como impares).
标签编码可以使用 Gray 码(偶数位与奇数位都可以)。
Energía media de la constelación QAM
QAM 星座的平均能量
2.7 · QAM 的 SER:两维独立,再减去同时出错
▸ 原页截图 p.37
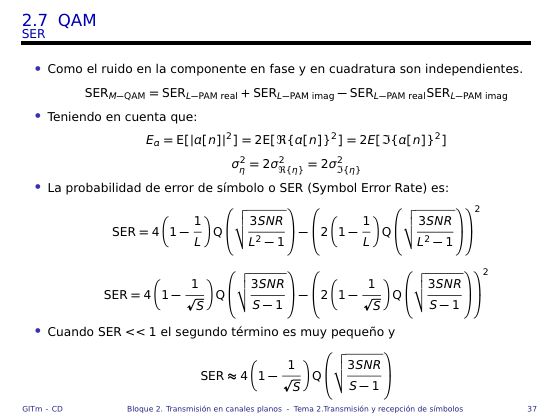
Como el ruido en la componente en fase y en cuadratura son independientes.
因为同相分量与正交分量的噪声相互独立。
La probabilidad de error de símbolo o SER (Symbol Error Rate) es
符号错误概率,即 SER(Symbol Error Rate)为
Cuando SER << 1 el segundo término es muy pequeño y
当 SER ≪ 1 时第二项很小,于是
SERL−PAM real , SERL−PAM imag
实部 L-PAM 与虚部 L-PAM 各自的符号错误率
2.7 · SER 结果:4/16/64-QAM 与近似式
▸ 原页截图 p.38
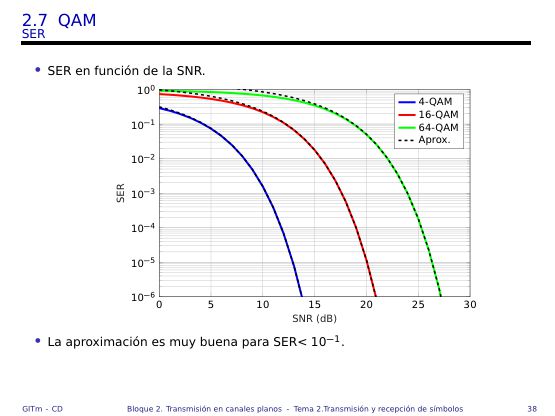
SER en función de la SNR.
SER 随 SNR 的变化。
4-QAM
4-QAM
16-QAM
16-QAM
64-QAM
64-QAM
Aprox.
近似式
La aproximación es muy buena para SER < 10−1.
当 SER < 10−1 时该近似非常好。
2.7 · BER 结果:Gray 与估计式
▸ 原页截图 p.39
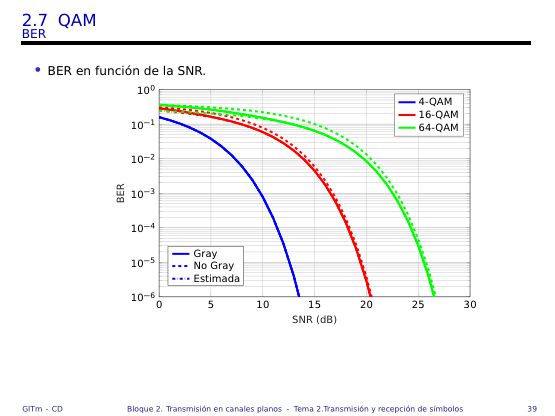
BER en función de la SNR.
BER 随 SNR 的变化。
Gray
Gray 编码
No Gray
非 Gray 编码
Estimada
估计值
2.7 · Python:symbols.QAMSquare
▸ 原页截图 p.40
class QAMSquare(Constellation)
类 QAMSquare(继承自 Constellation)
methods: __init__, amp_and_labels_PAM2QAM, SER
方法:__init__、amp_and_labels_PAM2QAM、SER
module symbols
模块 symbols
class QAMSquare(Constellation)
类 QAMSquare:方形 QAM 的实现
专有名词速记表(A–Z)
共 77 条,覆盖全 40 页的高频术语。第三列点页码直接跳回原页;最后一列只写「一句话 + 最容易被扣分的点」。
| 西语术语 | 中文 | 页码 | 一句话记住 · 易错点 |
|---|---|---|---|
| A | |||
| amplitud Ak | 幅度 | p.7 | 星座第 k 个点携带的值;基带是实数、通带是复数。 |
| Amplitudes (clase) | 幅度类 | p.20 | 建表、编码、判决、算能量、找最小距离——五个方法五件事。 |
| amplitud media cero | 零均值 | p.27 | PAM 星座位对称于原点,直流功率不浪费。 |
| aproximación (de SER) | SER 近似式 | p.37 | SER≪1 时丢掉「同时错」的交集项。 |
| Aprox. (curva) | 近似曲线 | p.38 | SER < 10−1 时和精确曲线几乎重合。 |
| B | |||
| BER | 比特错误率 | p.31 | Gray + 高 SNR 时 BER ≈ SER/B,两个条件缺一不可。 |
| Be | 每错误符号的平均错位数 | p.31 | Gray 下 Be ≈ 1;SER 大时会涨。 |
| bloque de B bits | B 比特块 | p.7 | 就是「标签」的定义;每块对应一个符号。 |
| B = log2(S) | 每符号比特数 | p.7 | 由 S = 2B 反解;QAM 里 B 必须为偶数。 |
| C | |||
| codificación de símbolos | 符号编码 | p.4 | 比特组 → 幅度;纯映射,不碰波形。 |
| codificador de símbolos | 符号编码器 | p.5 | 链路第一个方框;内部还分标签级与幅度级。 |
| codificador de etiquetas | 标签编码器 | p.9 | 比特组 → 索引(第一级查表)。 |
| codificador de amplitudes | 幅度编码器 | p.9 | 索引 → 幅度(第二级查表)。 |
| constelación | 星座 | p.7 | S 个幅度点的集合,就是「标签↔幅度」的字典。 |
| Constellation (clase) | 星座类 | p.25 | 只管索引 ↔ 幅度;标签的事归 Labels。 |
| codificación Gray | Gray 编码 | p.31 | 相邻符号只差 1 位 ⇒ 最可能的错只错 1 比特。 |
| codificación Gray (método iterativo) | Gray 迭代构造 | p.32 | 镜像复制 + 前缀列(上半 0、下半 1)。 |
| canal discreto equivalente | 离散等效信道 | p.5 | 把物理波形抽象掉,只剩「索引 + 噪声」。 |
| coder (método) | 编码方法 | p.20 | Labels 与 Constellation 各有一个 coder,别混。 |
| cuadratura | 正交支路 | p.36 | 虚部那一路;与同相支路各放一个 L-PAM。 |
| concatenar (tablas) | 拼接(表) | p.32 | n 比特表 = (n−1 比特表) + (其逆序) + 前缀列。 |
| D | |||
| decisión | 判决 | p.15 | 等概 + 高斯 ⇒ 挑「距离最近」的星座点。 |
| decisor de amplitudes | 幅度判决器 | p.12 | 解码链路第一块:幅度 → 索引。 |
| decisor (método) | 判决方法 | p.20 | 实现 = 求差 → 取模 → argmin。 |
| región de decisión | 判决区域 | p.15 | 会被判成同一符号的收到幅度集合(Voronoi 胞腔)。 |
| límites de la región de decisión | 判决区边界 | p.15 | 每对幅度的中垂线;不是圆,是多边形。 |
| distancia mínima (d) | 最小距离 | p.15 | SER 公式里的 d 就是它;PAM 中相邻点间距。 |
| distancia (cálculo de) | 距离计算 | p.17 | 用「差的模」|recibida − Ak|,不需要开方。 |
| decodificación de símbolos | 符号解码 | p.11 | 幅度 → 索引 → 标签,两步都不能省。 |
| decodificador de etiquetas | 标签解码器 | p.12 | 索引 → 标签(查逆表)。 |
| distribución de valores recibidos | 收到值分布 | p.18 | 直方图按「发送幅度」分组,尾部越过中垂线就出错。 |
| diagrama de bloques | 框图 | p.9 | 编码 p.9、解码 p.12,箭头方向相反。 |
| E | |||
| etiqueta | 标签 | p.7 | B 比特一组,是「比特的样子」;不等于索引。 |
| tabla de etiquetas | 标签表 | p.22 | labels_table:每行一个标签的比特。 |
| energía media de la constelación | 星座平均能量 | p.8 | E = (1/S)Σ|Ak|2;PAM 为 (S²−1)d²/12。 |
| equiprobables (símbolos) | 等概符号 | p.15 | 最小距离判决的前提之一,缺了要用 MAP。 |
| error de símbolo | 符号错误 | p.30 | 判到别的星座点;不一定只错 1 比特。 |
| errores de bits | 比特错误 | p.30 | A1→A2 错 1 位、A1→A0 错 2 位。 |
| Estimada (BER) | BER 估计值 | p.33 | 即 SER/B;只在高 SNR 准。 |
| G | |||
| gaussiano (ruido) | 高斯噪声 | p.15 | 「最可能 = 最近」的另一半前提。 |
| GITm - CD | 课程标识 | p.2 | 远程通信工程 · 数字通信。 |
| I | |||
| implementación (del decisor) | 判决器实现 | p.17 | 广播求差 → 取模 → argmin,复杂度 O(样本×S)。 |
| índice | 索引 | p.7 | 星座编号 0…S−1;与标签是两个层次。 |
| tabla de índices | 索引表 | p.22 | index_table:十进制值 → 索引的置换。 |
| L | |||
| L-PAM | L 元 PAM | p.36 | QAM 的构成块:S = L2,L = 2B/2。 |
| labels_table | 标签表数组 | p.22 | [[0,0],[1,1],[0,1],[1,0]]。 |
| labels_dec_table | 标签十进制表 | p.22 | [0,3,1,2]:标签转成十进制后的样子。 |
| Labels (clase) | 标签类 | p.25 | 只做比特 ↔ 标签 ↔ 索引。 |
| labels2indextable | 生成索引表 | p.25 | 由标签表自动反查,省掉手写索引表。 |
| M | |||
| mínima distancia (algoritmo) | 最小距离算法 | p.15 | 对任意星座通用;效率靠判决区形状提升。 |
| mediatriz | 中垂线 | p.15 | 两星座点的等距点集,正好是判决边界。 |
| matriz de etiquetas | 标签矩阵 | p.24 | 解码中间产物,每行一个标签,最后拉平成比特。 |
| module symbols | symbols 模块 | p.20 | Amplitudes / Labels / Constellation / PAM / QAMSquare 都在里面。 |
| N | |||
| nube de puntos | 点云/散点图 | p.19 | 复数星座的分布图;同源同色。 |
| número de símbolos (S) | 符号数 | p.7 | S = 2B;QAM 里 S = L2。 |
| P | |||
| PAM | 脉冲幅度调制 | p.27 | 一维等间距零均值星座;Ak = (1−S+2k)d/2。 |
| PAM(Constellation) | PAM 类 | p.34 | amp_PAM_design + labels_Gray_design + SER。 |
| probabilidad de error de símbolo | 符号错误概率 | p.28 | 系数 2(1−1/S);4-PAM 化简为 3/2。 |
| paso banda (canales) | 通带信道 | p.7 | 这里的幅度是复数,才有 I/Q 两路。 |
| permutación (tabla de) | 置换表 | p.22 | 编码表是双射,所以可逆、可解码。 |
| Q | |||
| QAM | 正交幅度调制 | p.35 | 二维星座:两个 L-PAM 正交叠加。 |
| QAM cuadrada | 方形 QAM | p.36 | S = L2、B 为偶数;判决可实虚分开做。 |
| QAMSquare(Constellation) | 方形 QAM 类 | p.40 | amp_and_labels_PAM2QAM:一维升二维。 |
| Q(·) | 高斯尾函数 | p.28 | 所有 SER 公式的外壳;参数是 d/(2ση)。 |
| R | |||
| régimen binario | 比特速率 | p.8 | RB = B·ƒS,是乘不是除。 |
| región de decisión (16-QAM) | 16-QAM 判决区 | p.16 | 16 块方砖铺满平面,砖缝是中垂线。 |
| ruido del canal | 信道噪声 | p.11 | 收到幅度带误差的主要来源。 |
| S | |||
| símbolo | 符号 | p.5 | 每 TS 发一个;由 B 比特决定。 |
| SER | 符号错误率 | p.28 | PAM:2(1−1/S)Q(d/2σ);QAM 见 p.37。 |
| S = 2B | 符号数等式 | p.7 | 点数必须是 2 的幂,没有 15-QAM。 |
| S = L2 | 方形 QAM 符号数 | p.36 | L 是每维的 PAM 点数,L = 2B/2。 |
| SNR | 信噪比 | p.28 | SER 只通过 SNR 依赖能量与噪声。 |
| scatter_plot | 散点图方法 | p.20 | Amplitudes 类的绘图方法之一。 |
| symbols (módulo) | symbols 模块 | p.20 | 本讲所有类的宿主模块。 |
| T | |||
| tabla de amplitudes | 幅度表 | p.14 | amptable = [−3,−1,1,3];编码就是下标取值。 |
| tabla de codificación | 编码表 | p.22 | 标签表 + 标签十进制表 + 索引表三件套。 |
| transmisión y recepción de símbolos | 符号的发送与接收 | p.5 | 编码器 → 离散等效信道 → 解码器。 |
| V | |||
| vector de bits | 比特向量 | p.23 | 编码入口;先 reshape 成「每行一个标签」。 |
| vector de índices | 索引向量 | p.23 | 编码出口;送到星座去取幅度。 |
数字与量级速记卡
口诀:「七节、一条闭环、三个 S 的公式、两条 Q 公式」。这页数字张口就能报,是 Tema 2 的送分点。
| 行 | 数字 | 原文关键词 | 中文 | 页 |
|---|---|---|---|---|
| 1 | 7 | 2.1 – 2.7 | 全讲七节:引论、编码、解码、幅度、标签、PAM、QAM | p.2 |
| 2 | 3 | codificador / canal / decodificador | 符号收发链三个方框 | p.5 |
| 3 | S = 2B | todas las etiquetas | 星座点数与每符号比特数的关系 | p.7 |
| 4 | RB = log2(S)·ƒS | régimen binario | 比特速率 | p.8 |
| 5 | 2 | etiquetas → amplitudes | 编码两级:先标签、后幅度 | p.9 |
| 6 | 4 | [−3, −1, 1, 3] | 4-PAM 幅度表元素个数 | p.14 |
| 7 | 中垂线 | mediatrices | 判决区边界的几何定义 | p.15 |
| 8 | 16 | 16-QAM | 16 个判决区(4×4 方砖) | p.16 |
| 9 | 3 步 | distancia → mínimo → índices | 判决器实现三步 | p.17 |
| 10 | 3 张表 | labels / labels_dec / index | 标签表、标签十进制表、索引表 | p.22 |
| 11 | E = (S²−1)d²/12 | energía media PAM | PAM 星座平均能量 | p.27 |
| 12 | 2(1−1/S)Q(d/2ση) | SER general PAM | PAM 的 SER 闭式 | p.28 |
| 13 | 3/2 | 4-PAM | 4-PAM 的 SER 系数 (1+2+2+1)/4 | p.28 |
| 14 | BER ≈ SER/B | Gray + SER ≪ 1 | 比特错误率的近似式 | p.31 |
| 15 | Be ≈ 1 | codificación Gray | Gray 下每个错误符号平均只错 1 位 | p.31 |
| 16 | E = (S−1)d²/6 | energía media QAM | QAM 星座平均能量 | p.36 |
| 17 | S = L², L = 2B/2 | QAM cuadrada | 方形 QAM 的符号数与每维点数 | p.36 |
| 18 | 4(1−1/√S)Q(√(3SNR/(S−1))) | SER QAM | QAM 的 SER(主项) | p.37 |
| 19 | SER < 10−1 | aproximación | 近似式好用的门槛 | p.38 |
最容易混的十二组概念
每组只抓一个分界点:谁在前谁在后、谁一维谁二维、谁决定谁。