- 一页一块:页号胶囊是 PDF 物理页序(1–39);幻灯片上印的页码可能另有编号,以胶囊为准。
- 逐句对照:蓝色左框内是西语原句(逐字照抄,含原文笔误),下面带「中」字标的是中文翻译;项目符号统一用 • 表示。
- 提示框:绿色「考点」= 这页怎么考;红色「陷阱」= 易错点与原文勘误;紫色「记忆钩子」= 口诀;橙色「补充」= 前后页串联。
- 术语悬停:西语句里带浅蓝底的词,鼠标停上去出中文;中文句里带虚下划线的词,停上去出西语原词。
- 公式:一律用本地 MathJax 渲染(断网也能显示),每个公式下附「符号 / 西语读法 / 中文含义」三列小表——口语考试念的就是这一列。
一、课程封面与总目录
p.1–p.3Comunicaciones Digitales · Bloque 4 · Tema 5(课程封面)
▸ 原页截图 p.1
Comunicaciones Digitales
数字通信
Bloque 4:
第 4 单元:信道编码
Tema 5:
主题 5:分组码(块编码)
Grado en Ingeniería de Telemática
远程通信工程学士
Departamento de Ingeniería de Comunicaciones
通信工程系
Universidad de Málaga
马拉加大学
Profesor: Laureano Moreno Pozas
授课教师:Laureano Moreno Pozas
Curso 2026/2027
学年 2026/2027
Tema 5: Codificación de bloque(目录页)
▸ 原页截图 p.2
Tema 5: Codificación de bloque
主题 5:分组码
5.1 Esquema de codificación de canal
5.1 信道编码方案
5.2
5.2 分组码
5.3 Implementación mediante tablas
5.3 用查表法实现
5.4
5.4 奇偶校验码
5.5 Códigos lineales
5.5 线性码
5.6 Prestaciones
5.6 性能
5.7
5.7 扰码器
Tema 5: Codificación de bloque(目录页 · 重复页)
▸ 原页截图 p.3
Tema 5: Codificación de bloque
主题 5:分组码
5.1 Esquema de codificación de canal
5.1 信道编码方案
5.2 Códigos de bloque
5.2 分组码
5.3 Implementación mediante tablas
5.3 用查表法实现
5.4 Códigos de paridad
5.4 奇偶校验码
5.5 Códigos lineales
5.5 线性码
5.6 Prestaciones
5.6 性能
5.7 Aleatorizador
5.7 扰码器
二、5.1 信道编码方案
p.45.1 Esquema de codificación de canal
▸ 原页截图 p.4
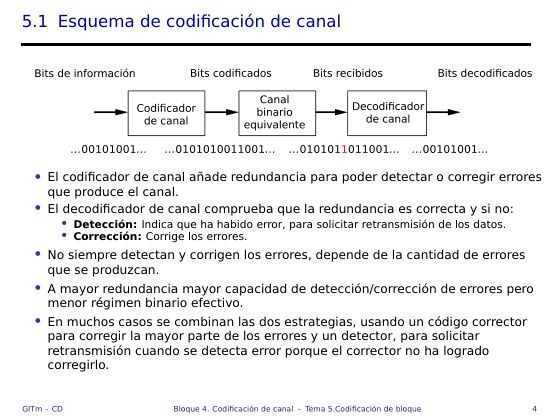
El
信道编码器加入冗余,以便能够检测或纠正信道产生的错误。
El
信道译码器检查冗余是否正确,如果不正确:
Detección: Indica que ha habido error, para solicitar
检错:指出已经发生错误,以便请求重传数据。
Corrección: Corrige los errores.
纠错:把错误直接改正过来。
No siempre detectan y corrigen los errores, depende de la cantidad de errores que se produzcan.
它们并非总能检测并纠正错误,这取决于实际发生的错误数量。
A mayor redundancia mayor
冗余越多,检错/纠错能力越强,但有效二进制速率越低。
En muchos casos se combinan las dos estrategias, usando un código corrector para corregir la mayor parte de los errores y un detector, para solicitar retransmisión cuando se detecta error porque el corrector no ha logrado corregirlo.
很多情况下会把两种策略组合使用:用纠错码纠正大部分错误,再用检错码在「纠错器没搞定」时请求重传。
三、5.2 分组码:定义、汉明距离与纠检错条件
p.5–p.10Tema 5: Codificación de bloque(目录 · 展开 5.2)
▸ 原页截图 p.5
5.1 Esquema de codificación de canal
5.1 信道编码方案
5.2 Códigos de bloque
5.2 分组码
Definición
定义
汉明距离
Requisitos de un código para detectar/corregir errores
码能检错/纠错的条件
5.3 Implementación mediante tablas
5.3 用查表法实现
5.4 Códigos de paridad
5.4 奇偶校验码
5.5 Códigos lineales
5.5 线性码
5.6 Prestaciones
5.6 性能
5.7 Aleatorizador
5.7 扰码器
5.2 Códigos de bloque · Definición
▸ 原页截图 p.6
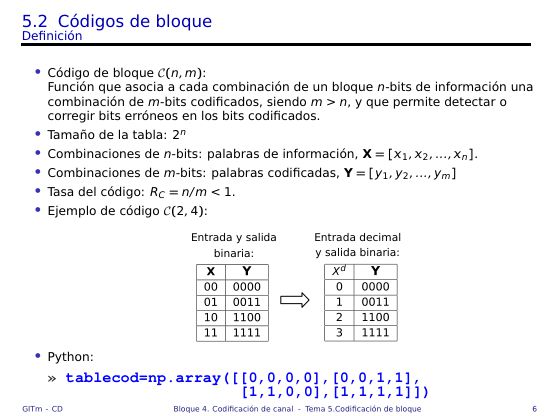
Código de bloque C(n, m):
分组码 C(n, m):
Función que asocia a cada combinación de un bloque n-
一种映射:把每个 n 比特的信息块组合,对应到一个 m 比特的编码组合,且 m > n,从而能够检测或纠正编码比特中的错误位。
Tamaño de la tabla: 2n
码表大小:2n 行(每个信息字一行)。
Combinaciones de n-bits:
n 比特组合:信息字,X = [x1, x2, …, xn]。
Combinaciones de m-bits:
m 比特组合:码字,Y = [y1, y2, …, ym]。
码率:RC = n/m < 1。
Ejemplo de código C(2, 4):
例:C(2, 4) 分组码。
Entrada y salida binaria:
二进制输入与输出(见原页表格):
Entrada decimal y salida binaria:
十进制输入与二进制输出(见原页表格):
Python: tablecod = np.array([[0,0,0,0],[0,0,1,1],[1,1,0,0],[1,1,1,1]])
Python 实现:把码表直接存成 4×4 的 NumPy 数组(行 = 信息字,列 = 码字比特)。
5.2 Códigos de bloque · Distancia de Hamming
▸ 原页截图 p.7
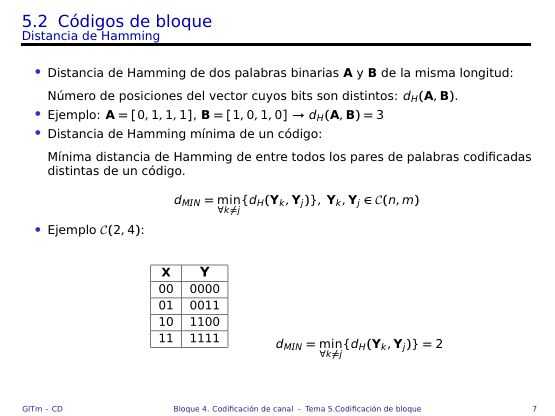
Distancia de Hamming de dos palabras binarias A y B de la misma longitud:
两个等长二进制字 A、B 的汉明距离:
Número de posiciones del vector cuyos bits son distintos: dH(A, B).
两向量中比特不同的位置个数,记作 dH(A, B)。
Ejemplo: A = [0, 1, 1, 1], B = [1, 0, 1, 0] → dH(A, B) = 3
例:A = [0, 1, 1, 1],B = [1, 0, 1, 0] → 第 1、2、4 位不同,故 dH(A, B) = 3。
码的最小汉明距离:
Mínima distancia de Hamming de entre todos los pares de palabras codificadas distintas de un código.
该码所有不同码字对之间汉明距离的最小值。
dMIN = min∀k≠j { dH(Yk, Yj) }, Yk, Yj ∈ C(n, m)
dMIN = 在所有不同码字对 {Yk, Yj} 上取 dH 的最小值。
Ejemplo C(2, 4): dMIN = min∀k≠j { dH(Yk, Yj) } = 2
例(接上页 C(2,4) 码表):逐对比较后最小值 dMIN = 2。
5.2 Códigos de bloque · Requisitos (I):检错码与纠错码
▸ 原页截图 p.8
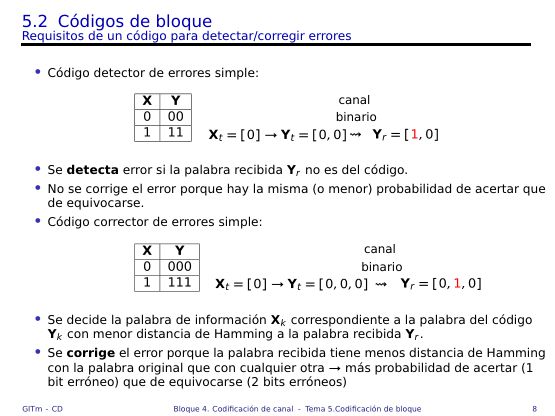
简单检错码:信息经二进制信道传输。
Se detecta error si la
若收到的字 Yr 不属于码表,就判定发生了错误。
No se corrige el error porque hay la misma (o menor) probabilidad de acertar que de equivocarse.
不纠错,因为「猜对」的概率与「猜错」相同甚至更低。
简单纠错码:同样经二进制信道传输。
Se decide la palabra de información Xk correspondiente a la palabra del código Yk con menor distancia de Hamming a la palabra recibida Yr.
选择与接收字 Yr 汉明距离最小的码字 Yk,输出它对应的信息字 Xk。
Se corrige el error porque la palabra recibida tiene menos distancia de Hamming con la palabra original que con cualquier otra → más probabilidad de acertar (1 bit erróneo) que de equivocarse (2
之所以能纠错,是因为接收字到原码字的距离小于到其他任何码字的距离 → 猜对(只错 1 位)的概率大于猜错(错 2 位)。
5.2 Códigos de bloque · Requisitos (II):检错条件 e < dMIN
▸ 原页截图 p.9
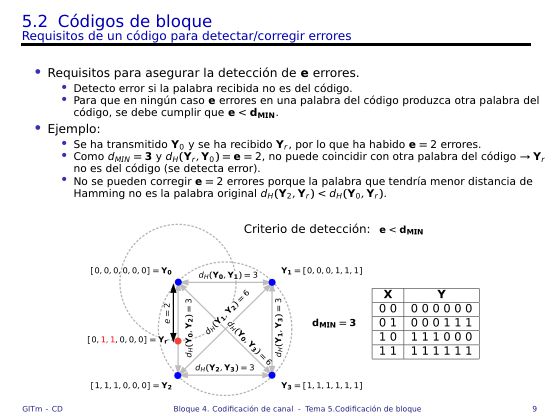
Requisitos para asegurar la detección de e errores.
保证能检测出 e 个错误的条件。
Detecto error si la palabra recibida no es del código.
只要接收字不属于码表,就检出错误。
Para que en ningún caso e errores en una palabra del código produzca otra palabra del código, se debe cumplir que e < dMIN.
要让「码字错 e 位后绝不变成另一个合法码字」,必须满足 e < dMIN。
Ejemplo:
例:
Se ha transmitido Y0 y se ha recibido Yr, por lo que ha habido e = 2 errores.
发送 Y0、收到 Yr,说明发生了 e = 2 个错误。
Como dMIN = 3 y dH(Yr, Y0) = e = 2, no puede coincidir con otra palabra del código → Yr no es del código (se detecta error).
因为 dMIN = 3 而 dH(Yr, Y0) = e = 2,它不可能与另一个码字重合 → Yr 不在码表中(检出错误)。
No se pueden corregir e = 2 errores porque la palabra que tendría menor distancia de Hamming no es la palabra original dH(Y2, Yr) < dH(Y0, Yr).
但这 2 个错误无法纠正:距离最近的字并不是原码字,因为 dH(Y2, Yr) < dH(Y0, Yr)。
5.2 Códigos de bloque · Requisitos (III):纠错条件 2e < dMIN
▸ 原页截图 p.10
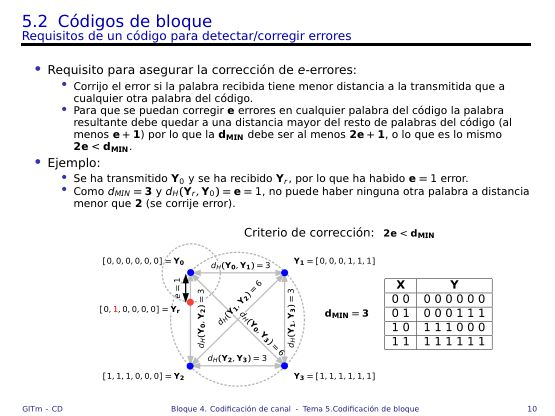
Requisito para asegurar la corrección de e-errores:
保证能纠正 e 个错误的条件:
Corrijo el error si la palabra recibida tiene menor distancia a la transmitida que a cualquier otra palabra del código.
当接收字到发送码字的距离小于到其他任何码字的距离时,就能改正错误。
Para que se puedan corregir e errores en cualquier palabra del código la palabra resultante debe quedar a una distancia mayor del resto de palabras del código (al menos e + 1) por lo que la dMIN debe ser al menos 2e + 1, o lo que es lo mismo 2e < dMIN.
要让任意码字错 e 位后仍离它最近,接收字到「其余码字」的距离至少要是 e + 1,因此 dMIN 至少为 2e + 1,等价于 2e < dMIN。
Ejemplo:
例:
Se ha transmitido Y0 y se ha recibido Yr, por lo que ha habido e = 1 error.
发送 Y0、收到 Yr,发生了 e = 1 个错误。
Como dMIN = 3 y dH(Yr, Y0) = e = 1, no puede haber ninguna otra palabra a distancia menor que 2 (se corrige el error).
因为 dMIN = 3 且 dH(Yr, Y0) = e = 1,不可能存在距离小于 2 的其它码字(错误被纠正)。
四、5.3 查表实现:编码表与译码表
p.11–p.15Tema 5: Codificación de bloque(目录 · 展开 5.3)
▸ 原页截图 p.11
5.1 Esquema de codificación de canal
5.1 信道编码方案
5.2 Códigos de bloque
5.2 分组码
5.3 Implementación mediante tablas
5.3 用查表法实现
Codificación
编码
译码
Decodificación por tabla
查表译码
5.4 Códigos de paridad
5.4 奇偶校验码
5.5 Códigos lineales
5.5 线性码
5.6 Prestaciones
5.6 性能
5.7 Aleatorizador
5.7 扰码器
5.3 Implementación mediante tablas · Codificación(流程图)
▸ 原页截图 p.12
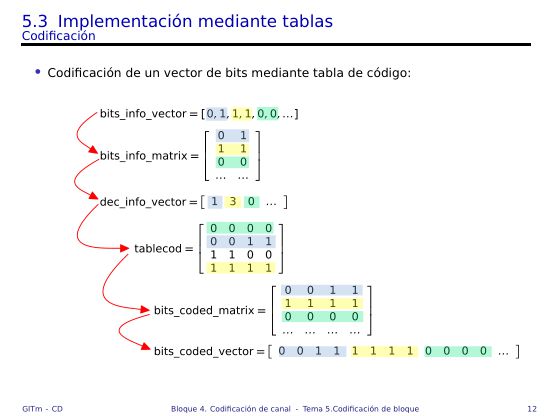
Codificación de un vector de bits mediante
用码表对一个比特向量做编码:
bits_info_vector = [0, 1, 1, 1, 1, 0, 0, ...] → se agrupa en filas de n bits.
信息比特流 bits_info_vector 先按每 n 位一行切成矩阵 bits_info_matrix。
bits_info_matrix = [[0, 1], [1, 1], [0, 0], [...]] → dec_info_vector = [1, 3, 0, ...]
每个 n 位行按二进制读成十进制,得到 dec_info_vector(这里 [0,1]→1、[1,1]→3、[0,0]→0)。
tablecod = np.array([[0,0,0,0], [0,0,1,1], [1,1,0,0], [1,1,1,1]]) — la fila k-ésima es la
码表 tablecod 的第 k 行就是十进制符号 k 对应的码字。
bits_coded_matrix = tablecod[dec_info_vector] → [[0,0,1,1], [1,1,1,1], [0,0,0,0], [...]]
用十进制下标整行取表,得到码字矩阵 bits_coded_matrix。
bits_coded_vector = [0, 0, 1, 1, 1, 1, 1, 1, 0, 0, 0, 0, ...] — se concatenan las filas.
把码字矩阵按行拼接成长比特流 bits_coded_vector,送入信道。
tablecod = np.array([[0,0,0,0],
                     [0,0,1,1],
                     [1,1,0,0],
                     [1,1,1,1]])

bits_info_vector = np.array([0,1,1,1,1,0,0])
bits_coded_vector = tablecod[dec_info_vector].flatten()
5.3 Implementación mediante tablas · Decodificación
▸ 原页截图 p.13
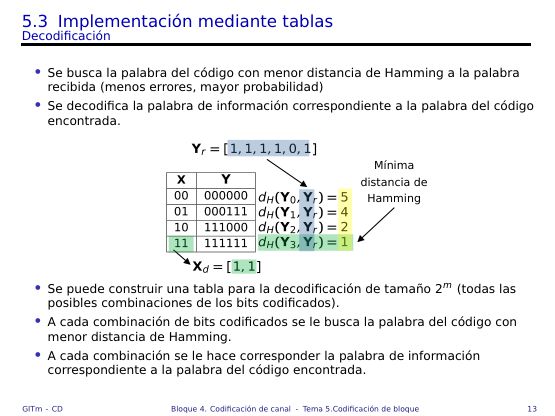
Se busca la palabra del código con menor distancia de Hamming a la palabra recibida (menos errores, mayor probabilidad)
在码表中寻找与接收字汉明距离最小的码字(错误最少 ⇒ 概率最大)。
Se decodifica la palabra de información correspondiente a la palabra del código encontrada.
再把找到的码字反查成它对应的信息字。
Se puede construir una tabla para la decodificación de tamaño 2m (todas las posibles combinaciones de los bits codificados).
可以预建一张大小为 2m 的译码表,覆盖码字比特的所有可能组合。
A cada combinación de bits codificados se le busca la palabra del código con menor distancia de Hamming.
对每一种接收组合,先找出汉明距离最小的合法码字。
A cada combinación se le hace corresponder la palabra de información correspondiente a la palabra del código encontrada.
再让该组合映射到这个码字所对应的信息字。
5.3 Implementación mediante tablas · Decodificación por tabla(流程图)
▸ 原页截图 p.14
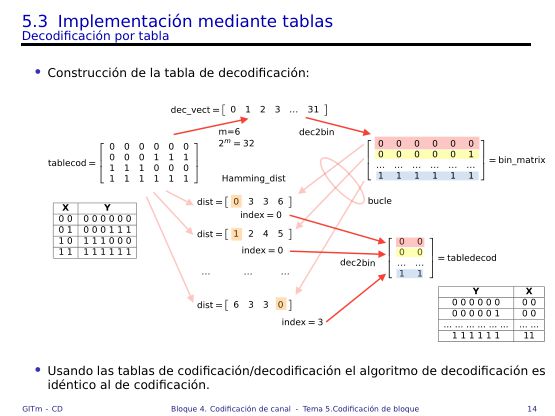
Construcción de la
译码表的构造(见原页流程图):
dec_vect = [0, 1, 2, ..., 31] con m = 6 → 2m = 32; dec2bin lo convierte en bin_matrix.
枚举全部 2m 个十进制下标(本例 m=6 → 32 个),用 dec2bin 转成 m 位二进制矩阵。
Hamming_dist calcula dist = [0, 3, 3, 6] frente a cada palabra del código e index = 0 es la posición del mínimo.
对每一行用 Hamming_dist 算出到各码字的距离向量(如 dist = [0, 3, 3, 6]),index 取最小值的下标。
El bucle recorre todas las filas: dist = [1, 2, 4, 5] → index = 1; ...; dist = [6, 3, 3, 0] → index = 3.
循环处理所有行:dist = [1, 2, 4, 5] → index = 1,……,dist = [6, 3, 3, 0] → index = 3。
tablecod[index] da la palabra codificada; la tabla inversa X/Y devuelve la palabra de información.
tablecod[index] 给出码字,再用逆表 X/Y 反查出信息字,写入 tabladecod。
Usando las tablas de codificación/decodificación el algoritmo de decodificación es idéntico al de codificación.
有了编码表与译码表,译码算法与编码算法完全同构:切块 → 转十进制 → 查表 → 平铺。
5.3 Implementación mediante tablas · Python: clase TableCode
▸ 原页截图 p.15
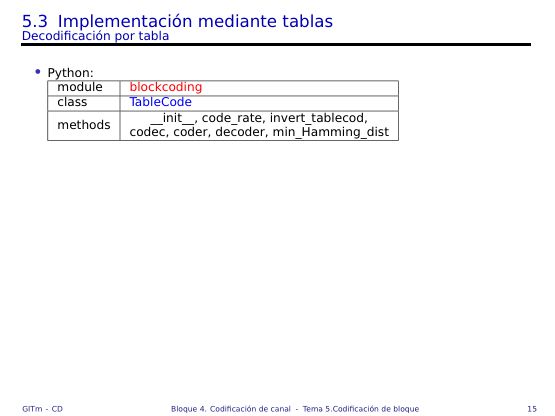
Python: module blockcoding, class TableCode
Python 实现:模块 blockcoding,类 TableCode。
methods: __init__, code_rate, invert_tablecod, codec, coder, decoder, min_Hamming_dist
方法:构造、算码率、求逆表、编解码一体、编码、译码、算最小汉明距离。
__init__ construye tablecod a partir del código; code_rate devuelve RC = n/m.
__init__ 由码定义生成 tablecod;code_rate 返回 RC = n/m。
invert_tablecod genera la tabla inversa (código → información); min_Hamming_dist obtiene dMIN.
invert_tablecod 生成逆表(码字 → 信息);min_Hamming_dist 算出 dMIN。
coder y decoder aplican las tablas vector a vector; codec encadena ambos.
coder、decoder 对逐个向量套表;codec 把两者串起来一步到位。
from blockcoding import TableCode

tc = TableCode(tablecod)      # 构造:建编码表/译码表
tc.code_rate()                # R_C = n/m
tc.min_Hamming_dist()         # d_MIN
bits_out = tc.coder(bits_in)  # 编码
bits_in  = tc.decoder(bits_rx)# 译码
五、5.4 奇偶校验码:简单校验与汉明码
p.16–p.20Tema 5: Codificación de bloque(目录 · 展开 5.4)
▸ 原页截图 p.16
5.1 Esquema de codificación de canal
5.1 信道编码方案
5.2 Códigos de bloque
5.2 分组码
5.3 Implementación mediante tablas
5.3 用查表法实现
5.4 Códigos de paridad
5.4 奇偶校验码
简单奇偶校验码
汉明码
5.5 Códigos lineales
5.5 线性码
5.6 Prestaciones
5.6 性能
5.7 Aleatorizador
5.7 扰码器
5.4 Códigos de paridad · Códigos de paridad simple
▸ 原页截图 p.17
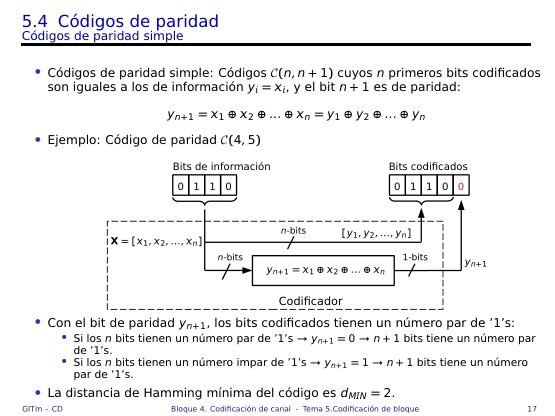
Códigos de paridad simple: códigos C(n, n + 1) cuyos n primeros bits codificados son iguales a los de información yi = xi, y el bit n + 1 es de paridad:
简单奇偶校验码:C(n, n + 1),前 n 个编码比特与信息比特相同(yi = xi),第 n + 1 位是校验位:
yn+1 = x1 ⊕ x2 ⊕ ... ⊕ xn = y1 ⊕ y2 ⊕ ... ⊕ yn
yn+1 = x1 ⊕ x2 ⊕ … ⊕ xn = y1 ⊕ y2 ⊕ … ⊕ yn(全部信息位异或)。
Ejemplo: código de paridad C(4, 5) con bits de información 0 1 1 0 y bits codificados 0 1 1 0 0.
例:C(4, 5) 奇偶校验码,信息位 0 1 1 0 → 编码后 0 1 1 0 0(两个 1,偶校验补 0)。
Con el
加上校验位后,整个码字中 1 的个数恒为偶数。
Si los n bits tienen un número par de '1's → yn+1 = 0 → n + 1 bits tiene un número par de '1's.
若 n 个信息位中 1 的个数为偶 → yn+1 = 0 → n + 1 位中 1 的个数仍为偶。
Si los n bits tienen un número impar de '1's → yn+1 = 1 → n + 1 bits tiene un número par de '1's.
若 n 个信息位中 1 的个数为奇 → yn+1 = 1 → 凑成偶数个 1。
La distancia de Hamming mínima del código es dMIN = 2.
该码的最小汉明距离 dMIN = 2。
5.4 Códigos de paridad · Síndrome o chequeo de paridad
▸ 原页截图 p.18
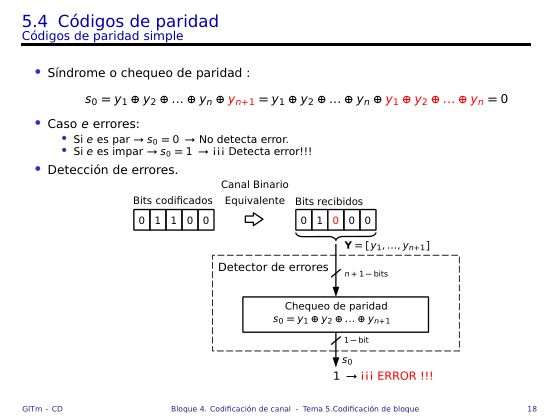
Síndrome o
校验子(syndrome,奇偶检查量):
s0 = y1 ⊕ y2 ⊕ ... ⊕ yn ⊕ yn+1 = y1 ⊕ y2 ⊕ ... ⊕ yn ⊕ y1 ⊕ y2 ⊕ ... ⊕ yn = 0
s0 = y1⊕…⊕yn⊕yn+1,把 yn+1 用前面的异或和代入,两项相同 ⇒ s0 = 0。
Caso e errores: si e es par → s0 = 0 → no detecta error.
错 e 位时:若 e 为偶 → s0 = 0 → 检不出错误。
Si e es impar → s0 = 1 → ¡¡¡Detecta error!!!
若 e 为奇 → s0 = 1 → 检出错误!
Detección de errores: los bits codificados 0 1 1 0 0 pasan por el
检错示意:码字 0 1 1 0 0 经二进制信道后收到 0 1 0 0 0(第 3 位翻转)。
El detector de errores recalcula s0 sobre los bits recibidos; si vale 1, declara error.
检错器对收到的比特重新算 s0;等于 1 就宣布出错。
5.4 Códigos de paridad · Códigos de Hamming
▸ 原页截图 p.19
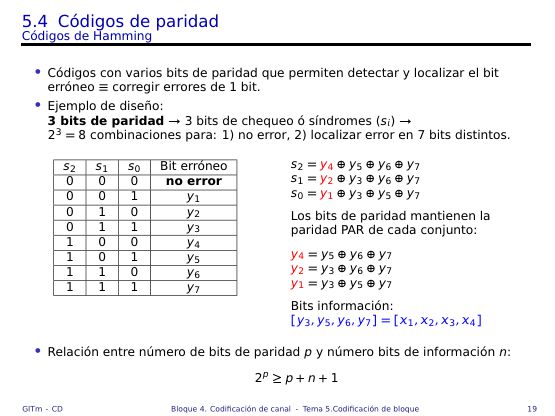
Códigos con varios
汉明码用多个校验位,既能检出、又能定位出错比特 ≡ 纠正 1 位错误。
Ejemplo de diseño: 3 bits de paridad → 3 bits de chequeo o síndromes (s2, s1, s0) → 23 = 8 combinaciones para: 1) no error, 2) localizar error en 7 bits distintos.
设计例:3 个校验位 → 3 个校验子 (s2, s1, s0) → 23 = 8 种组合,正好表示:1 种「无错」+ 7 种「哪一位错」。
Tabla de síndromes: 000 → no error; 001 → y1; 010 → y2; 011 → y3; 100 → y4; 101 → y5; 110 → y6; 111 → y7.
校验子表:000 无错;001→y1;010→y2;011→y3;100→y4;101→y5;110→y6;111→y7(二进制值就是错位号)。
s2 = y4 ⊕ y5 ⊕ y6 ⊕ y7; s1 = y2 ⊕ y3 ⊕ y6 ⊕ y7; s0 = y1 ⊕ y3 ⊕ y5 ⊕ y7
三个校验方程分别覆盖「末位为 1 的位」「中间位为 1 的位」「最低位为 1 的位」。
Los bits de paridad mantienen la paridad PAR de cada conjunto: y4 = y5 ⊕ y6 ⊕ y7; y2 = y3 ⊕ y6 ⊕ y7; y1 = y3 ⊕ y5 ⊕ y7
每个校验位负责让自己那一组保持偶校验,所以反解出校验位的取值公式。
Bits información: [y3, y5, y6, y7] = [x1, x2, x3, x4]
信息位放在非 2 的幂的位置:y3, y5, y6, y7 ↔ x1…x4。
Relación entre número de bits de paridad p y número bits de información n: 2p ≥ p + n + 1
校验位数 p 与信息位数 n 的关系:2p ≥ p + n + 1。
5.4 Códigos de paridad · Códigos de Hamming · Ejemplo de uso
▸ 原页截图 p.20
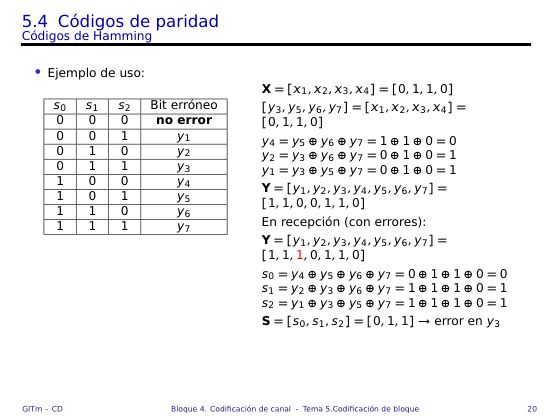
Códigos de Hamming · Ejemplo de uso:
汉明码用法示例:编码 → 传输 → 收端算 syndrome → 纠错。
Tabla de síndromes: 000 → no error; 001 → y1; 010 → y2; 011 → y3; 100 → y4; 101 → y5; 110 → y6; 111 → y7.
校验子表(同 p19):000 无错,其余三位的二进制值直接就是出错位号。
X = [x1, x2, x3, x4] = [0, 1, 1, 0]
待编码信息向量 X = [0, 1, 1, 0]。
[y3, y5, y6, y7] = [x1, x2, x3, x4] = [0, 1, 1, 0]
信息位填进非 2 的幂的位置:y3=0、y5=1、y6=1、y7=0。
y4 = y5 ⊕ y6 ⊕ y7 = 1 ⊕ 1 ⊕ 0 = 0
第 3 组(本位 y4):y4 = 1⊕1⊕0 = 0。
y2 = y3 ⊕ y6 ⊕ y7 = 0 ⊕ 1 ⊕ 0 = 1
第 2 组(本位 y2):y2 = 0⊕1⊕0 = 1。
y1 = y3 ⊕ y5 ⊕ y7 = 0 ⊕ 1 ⊕ 0 = 1
第 1 组(本位 y1):y1 = 0⊕1⊕0 = 1。
Y = [y1, y2, y3, y4, y5, y6, y7] = [1, 1, 0, 0, 1, 1, 0]
拼成码字 Y = [1, 1, 0, 0, 1, 1, 0]。
En recepción (con errores): Y = [y1, y2, y3, y4, y5, y6, y7] = [1, 1, 1, 0, 1, 1, 0]
接收端收到(有错):[1, 1, 1, 0, 1, 1, 0]——第 3 位被翻转。
s0 = y4⊕y5⊕y6⊕y7 = 0⊕1⊕1⊕0 = 0; s1 = y2⊕y3⊕y6⊕y7 = 1⊕1⊕1⊕0 = 1; s2 = y1⊕y3⊕y5⊕y7 = 1⊕1⊕1⊕0 = 1
拿收到的比特重算三个校验子:s0 = 0、s1 = 1、s2 = 1。
S = [s0, s1, s2] = [0, 1, 1] → error en y3
S = [0, 1, 1] → 出错在第 3 位 y3,翻转即完成纠错。
六、5.5 线性码:G / H、síndrome 与 coset-leaders
p.21–p.35Tema 5 · Índice (5.5 Códigos lineales desplegado)
▸ 原页截图 p.21
Tema 5: Codificación de bloque
主题 5:分组码(总目录页)。
5.1 Esquema de codificación de canal
5.1 信道编码方案。
5.2 Códigos de bloque
5.2 分组码。
5.3 Implementación mediante tablas
5.3 查表实现。
5.4 Códigos de paridad
5.4 奇偶校验码。
5.5 Códigos lineales
5.5 线性码(本页展开的一节)。
Definición y propiedades de la matrices generadoras y de chequeo
生成矩阵与校验矩阵的定义及性质。
Implementación de la codificación
编码的实现。
Implementación del cálculo de síndromes
校验子计算的实现。
Distancia de Hamming mínima
最小汉明距离。
陪集首领(coset-leaders)。
Diseño de la tabla de coset-leaders
陪集首领表的设计。
Corrección y separación de bits de información
纠错与信息位分离。
5.6 Prestaciones
5.6 性能(下一节入口)。
5.5 Códigos lineales · Matrices generadora y de chequeo (G)
▸ 原页截图 p.22
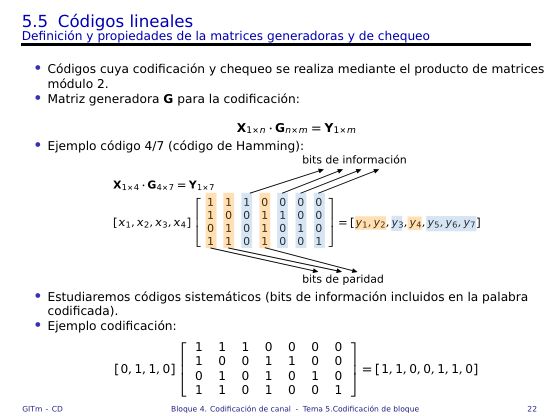
Definición y propiedades de la matrices generadoras y de chequeo
生成矩阵与校验矩阵的定义及性质。
Códigos cuya codificación y chequeo se realiza mediante el producto de matrices
线性码的编码与校验都靠模 2 矩阵乘法完成。
编码用生成矩阵 G:n 位信息 × Gn×m = m 位码字。
Ejemplo código 4/7 (código de Hamming): X1×4 · G4×7 = Y1×7
4/7 汉明码例:X1×4 · G4×7 = Y1×7(G 为 4 行 7 列,数值见原页矩阵)。
bits de información / bits de paridad
原页箭头标注:bits de información 指向信息位对应的列;bits de paridad 指向校验位对应的列。
Estudiaremos
本课只研究系统码:信息位原样保留在码字里,不被打乱。
Ejemplo codificación: [0, 1, 1, 0] · G4×7 = [1, 1, 0, 0, 1, 1, 0]
编码例:[0,1,1,0] × G = [1,1,0,0,1,1,0](与 p20 手工算出的码字完全一致)。
5.5 Códigos lineales · Matriz de chequeo H y cálculo de síndromes
▸ 原页截图 p.23
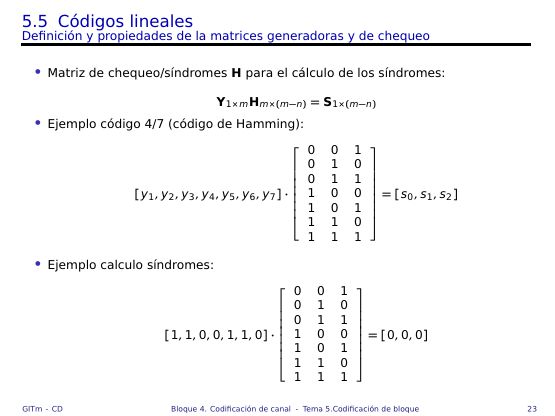
校验用校验矩阵 H:m 位码字 × Hm×(m−n) = m−n 位 syndrome。
Ejemplo código 4/7 (código de Hamming): [y1, y2, y3, y4, y5, y6, y7] · H7×3 = [s0, s1, s2]
4/7 汉明码:7 位码字 × H7×3 = 3 位 [s0, s1, s2]。
La matriz H tiene 7 filas (una por bit del código) y 3 columnas (una por síndrome); la fila i es el patrón binario de i.
H 共 7 行 × 3 列:第 i 行就是 i 的三位二进制(001、010、011 … 111),见原页矩阵。
Ejemplo cálculo de síndromes: [1, 1, 0, 0, 1, 1, 0] · H7×3 = [0, 0, 0]
例算:合法码字 [1,1,0,0,1,1,0] × H = [0,0,0](无错)。
5.5 Códigos lineales · G·H = 0 y síndrome con errores
▸ 原页截图 p.24
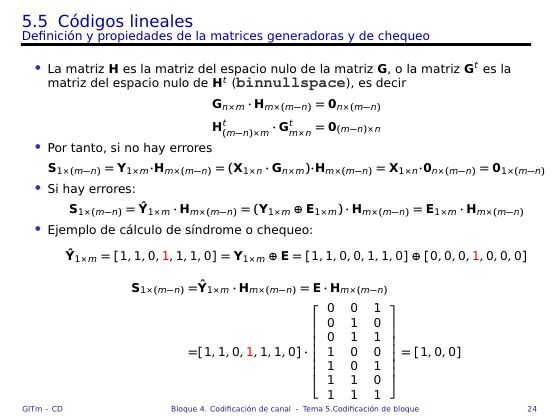
La matriz H es la matriz del
H 是 G 的零空间矩阵(反之 Gt 是 Ht 的零空间,binnullspace),即 G · H = 0(模 2)。
Ht(m−n)×m · Gtm×n = 0(m−n)×n
转置形式:Ht · Gt = 0,与上式等价。
Por tanto, si no hay errores: S1×(m−n) = Y·H = (X·G)·H = X·0 = 01×(m−n)
所以无错时:S = Y·H = (X·G)·H = X·0 = 0。
Si hay errores: S1×(m−n) = Ý·H = (Y ⊕ E)·H = E·H
有错时(Ý = Y ⊕ E):S = Ý·H = (Y⊕E)·H = E·H。
Ejemplo: Ý = [1, 1, 0, 1, 1, 1, 0] = Y ⊕ E = [1, 1, 0, 0, 1, 1, 0] ⊕ [0, 0, 0, 1, 0, 0, 0]
例:Ý = [1,1,0,1,1,1,0] = Y ⊕ E,错误图样 E 只在第 4 位为 1。
S = Ý·H = E·H = [1, 0, 0]
S = E·H = [1,0,0] → 错在 y4(H 第 4 行 = 100)。
5.5 Códigos lineales · Implementación de la codificación
▸ 原页截图 p.25
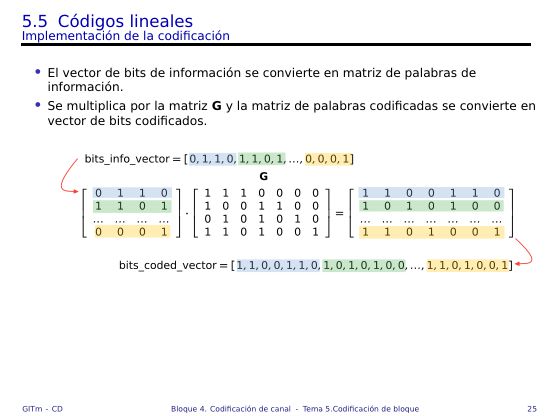
Implementación de la codificación
编码的工程实现。
El
① 把一维信息比特流按 n 位一段 reshape 成信息矩阵(每行一个信息字)。
Se multiplica por la matriz G y la matriz de palabras codificadas se convierte en vector de bits codificados.
② 矩阵 × Gn×m 得到码字矩阵,再 flatten 回一维编码比特流。
En la figura: bits_info_vector → matriz de información → × G → matriz de códigos → bits_coded_vector.
图示数据流:bits_info_vector →(按 4 位切行)→ 信息矩阵 → × G → 码字矩阵 → 拉平(flatten)→ bits_coded_vector。
El ejemplo parte de bits_info_vector = [0,1,1,0,1,1,0,1,1,0,…] (n = 4 bits por fila) y llega a bits_coded_vector = [1,1,0,0,1,1,0,1,0,1,0,1,…] (m = 7 bits por fila).
例:bits_info_vector = [0,1,1,0,1,1,0,1,1,0,…](每行 4 位)→ bits_coded_vector = [1,1,0,0,1,1,0,1,0,1,0,1,…](每行 7 位)。
Codificar en bloque permite usar álgebra lineal y operaciones vectorizadas, mucho más rápido que recorrer una tabla entrada a entrada.
分块编码可直接用线性代数 + 向量化运算,比逐条查表快得多。
bits_info_vector = [0,1,1,0, 1,1,0,1, 1,0,...]
        │  reshape  (n = 4 位一行)
        ▼
matriz de información   (filas × 4)
        │  × G(4×7)   módulo 2
        ▼
matriz de palabras codificadas   (filas × 7)
        │  flatten
        ▼
bits_coded_vector = [1,1,0,0,1,1,0, 1,0,1,0,1,...]
5.5 Códigos lineales · Implementación del cálculo de síndromes
▸ 原页截图 p.26
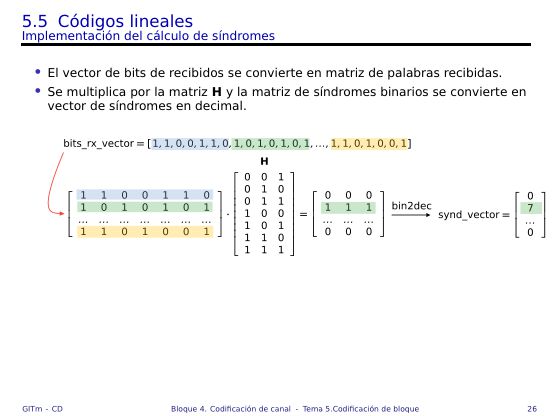
Implementación del cálculo de síndromes
校验子计算的工程实现。
El vector de bits de recibidos se convierte en matriz de palabras recibidas.
① 把接收比特流按 m 位一段 reshape 成接收矩阵(每行一个接收字)。
Se multiplica por la matriz H y la matriz de síndromes binarios se convierte en vector de síndromes en decimal.
② 矩阵 × Hm×(m−n) 得到二进制 syndrome 矩阵;再 bin2dec 转成十进制 syndrome 向量。
Cada fila de 3 bits (s2, s1, s0) se interpreta como número decimal: 000 → 0 (sin error), 111 → 7 (y7).
每行 3 位 (s2, s1, s0) 当二进制读:000→0(无错),111→7(y7)。
synd_vector = [0, 7, …] localiza directamente el bit erróneo de cada palabra recibida.
synd_vector = [0, 7, …] 直接给出每个接收字的出错位号(0 = 无错)。
bits_rx_vector   (码字流)
        │  reshape  (m = 7 位一行)
        ▼
matriz de palabras recibidas   (filas × 7)
        │  × H(7×3)   módulo 2
        ▼
matriz de síndromes binarios   (filas × 3)  →  [s2 s1 s0]
        │  bin2dec
        ▼
synd_vector = [0, 7, ...]   →  0 = 无错,其余 = 出错位号
5.5 Códigos lineales · Implementación en Python
▸ 原页截图 p.27
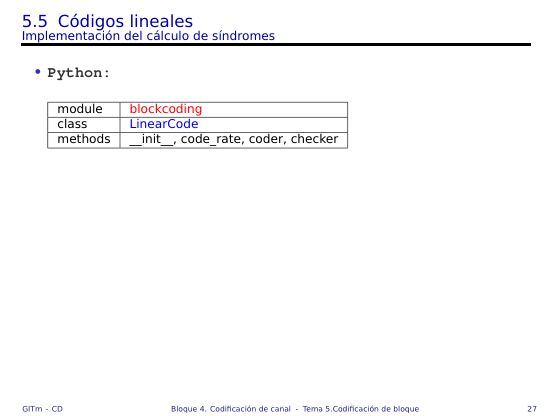
Implementación del cálculo de síndromes — Python: module blockcoding, class LinearCode, methods __init__, code_rate, coder, checker.
Python 实现:模块 blockcoding、类 LinearCode,方法 __init__ / code_rate / coder / checker。
__init__ construye el objeto del código lineal (guarda los parámetros y las matrices G y H).
__init__:构造线性码对象(保存参数与 G、H 矩阵)。
code_rate devuelve la tasa del código RC = n / m (4/7 en el ejemplo).
code_rate:返回码率 RC = n / m(本例 4/7)。
coder codifica: recibe el vector de información y aplica X · G = Y.
coder:编码,输入信息向量,执行 X · G = Y。
checker calcula los síndromes: recibe el vector recibido, aplica Ý · H y devuelve S en decimal.
checker:算校验子,输入接收向量,执行 Ý · H 并返回十进制 S。
module blockcoding
└── class LinearCode
    ├── __init__    # 建对象:参数 + G / H
    ├── code_rate   # R_C = n / m  →  4/7
    ├── coder       # X · G = Y
    └── checker     # Y · H = S  →  bin2dec
5.5 Códigos lineales · Distancia de Hamming mínima (desde H)
▸ 原页截图 p.28
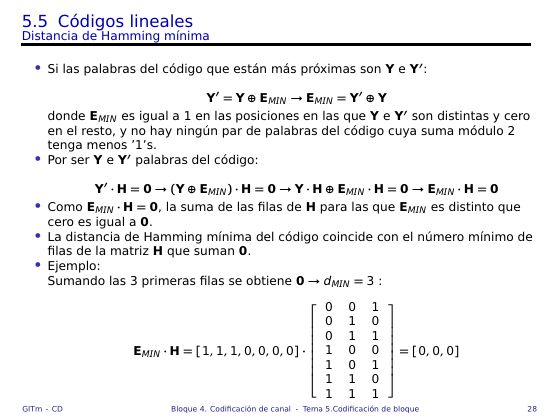
Si las palabras del código que están más próximas son Y e Y′: Y′ = Y ⊕ EMIN → EMIN = Y′ ⊕ Y
设码中最接近的两个码字为 Y 与 Y′:Y′ = Y ⊕ EMIN,反解 EMIN = Y′ ⊕ Y。
donde EMIN es igual a 1 en las posiciones en las que Y e Y′ son distintas y cero en el resto, y no hay ningún par de palabras del código cuya suma módulo 2 tenga menos ’1’s.
EMIN 在 Y 与 Y′ 不同的位置为 1、其余为 0;而且码中不存在任何一对码字,其模 2 之和的 1 比它更少。
Por ser Y e Y′ palabras del código: Y′·H = 0 → (Y ⊕ EMIN)·H = 0 → Y·H ⊕ EMIN·H = 0 → EMIN·H = 0
因为 Y、Y′ 都是合法码字:Y′·H = 0 → (Y ⊕ EMIN)·H = 0 → Y·H ⊕ EMIN·H = 0,而 Y·H = 0 ⇒ EMIN·H = 0。
Como EMIN·H = 0, la suma de las filas de H para las que EMIN es distinto que cero es igual a 0.
既然 EMIN·H = 0,那么「EMIN 中为 1 的那些位置所对应的 H 的行」之和必为 0(模 2)。
La distancia de Hamming mínima del código coincide con el número mínimo de filas de la matriz H que suman 0.
码的最小汉明距离 = 使 H 的行之和为 0 的最少行数(这就是 dMIN 的矩阵判定法)。
Ejemplo: sumando las 3 primeras filas se obtiene 0 → dMIN = 3
例:H 的前 3 行相加得 0(001⊕010⊕011 = 000)→ dMIN = 3。
EMIN·H = [1, 1, 1, 0, 0, 0, 0] · H7×3 = [0, 0, 0]
写成错误图样形式:[1,1,1,0,0,0,0] · H7×3 = [0,0,0]。
5.5 Códigos lineales · dMIN 例:简单校验码与重复码
▸ 原页截图 p.29
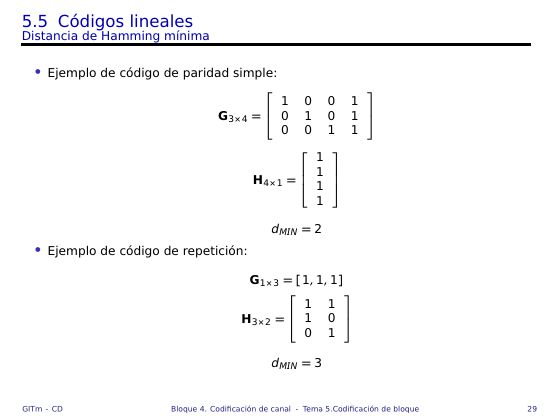
Ejemplo de
简单奇偶校验码例:G3×4(前 3 列是单位阵、末列全 1),H4×1(四个 1 组成的列向量),dMIN = 2。
En el código de paridad simple, n = 3 bits de información y m = 4 bits codificados → RC = 3/4.
简单校验码:n = 3 位信息、m = 4 位码字 → RC = 3/4。
dMIN = 2: hace falta sumar 2 filas de H para obtener 0 (dos 1s se cancelan módulo 2).
dMIN = 2:H 至少要 2 行才凑出 0(两个 1 模 2 抵消)。
Ejemplo de
重复码例:G1×3 = [1, 1, 1],H3×2,dMIN = 3。
En el código de repetición el único bit de información se repite tres veces; su H tiene 3 filas y hay que sumarlas todas para obtener 0.
重复码把 1 位信息重复 3 次;H 有 3 行,必须三行全加才得 0,故 dMIN = 3。
Paridad simple:  G(3×4) = [1 0 0 1]      H(4×1) = [1]
                          [0 1 0 1]               [1]
                          [0 0 1 1]               [1]
                                                  [1]
                  →  d_MIN = 2

Repetición:      G(1×3) = [1 1 1]        H(3×2) = [1 1]
                                                  [1 0]
                                                  [0 1]
                  →  d_MIN = 3
5.5 Códigos lineales · Coset-leaders
▸ 原页截图 p.30
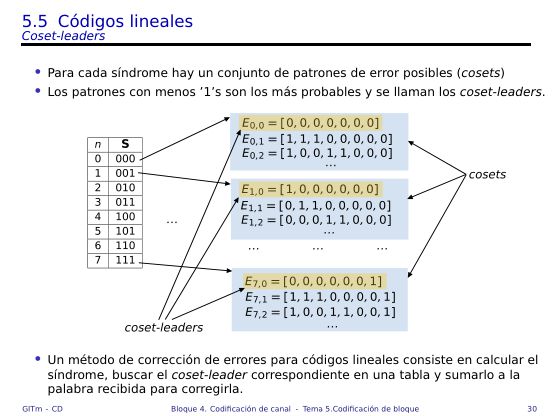
Para cada síndrome hay un conjunto de
每个 syndrome 对应一组可能的错误图样,这组图样叫一个 coset(陪集)。
Los patrones con menos ’1’s son los más probables y se llaman los coset-leaders.
其中 1 最少(重量最小)的图样=最可能发生的错误,称为 coset-leader(陪集首)。
Un método de corrección de errores para códigos lineales consiste en calcular el síndrome, buscar el coset-leader correspondiente en una tabla y sumarlo a la palabra recibida para corregirla.
线性码的纠错法:算 syndrome → 在表里查对应的 coset-leader → 与接收字模 2 相加即完成纠错。
Es decir: Ýcorregida = Ý ⊕ coset-leader(S).
即 纠正后 = Ý ⊕ coset-leader(S);因为 Ý = Y ⊕ E,加上同一个 E 就把错误抵消了。
5.5 Códigos lineales · Diseño de la tabla de coset-leaders (1–2)
▸ 原页截图 p.31
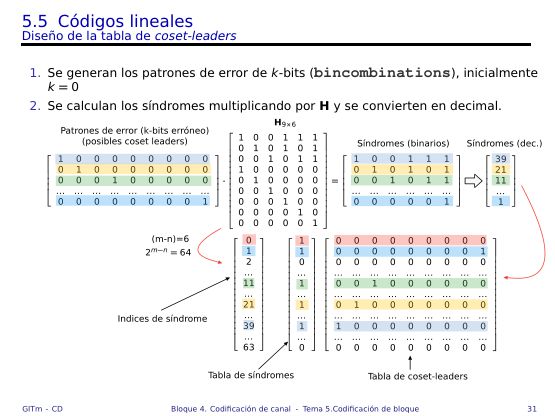
1. Se generan los patrones de error de k-bits (bincombinations), inicialmente k = 0
① 生成重量为 k 的错误图样(bincombinations 组合),从 k = 0 开始。
2. Se calculan los síndromes multiplicando por H y se convierten en decimal.
② 每个图样乘 H 算出 syndrome,并转成十进制作索引。
Con k = 0 el único patrón es el de todo ceros y su síndrome es 0: representa «no error».
k = 0 时只有一个全零图样,syndrome = 0,代表「无错」。
Los patrones se recorren en orden creciente de peso, porque los errores de pocos bits son los más probables.
按重量从小到大遍历,因为少数位出错才是最可能的情形。
5.5 Códigos lineales · Diseño de la tabla de coset-leaders (3–4)
▸ 原页截图 p.32
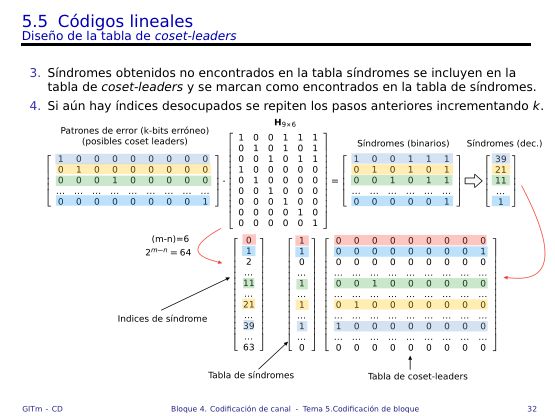
3. Síndromes obtenidos no encontrados en la tabla síndromes se incluyen en la tabla de coset-leaders y se marcan como encontrados en la tabla de síndromes.
③ 若算出的 syndrome 还没被占用,就把该图样写进 coset-leader 表,并在 syndrome 表里标记为已占用。
4. Si aún hay índices desocupados se repiten los pasos anteriores incrementando k.
④ 若还有未占用的索引,就 k 加 1,重复前面的步骤。
El proceso termina cuando todos los síndromes posibles (2m−n = 8 en el código 4/7) tienen asignado su coset-leader.
当所有可能的 syndrome(4/7 码共 23 = 8 个)都分到 coset-leader 时结束。
Para un código que corrige e bits, los coset-leaders son exactamente los patrones de peso ≤ e.
能纠 e 位的码,其 coset-leaders 恰好就是重量 ≤ e 的全部图样。
5.5 Códigos lineales · Corrección y separación (I):纠错
▸ 原页截图 p.33
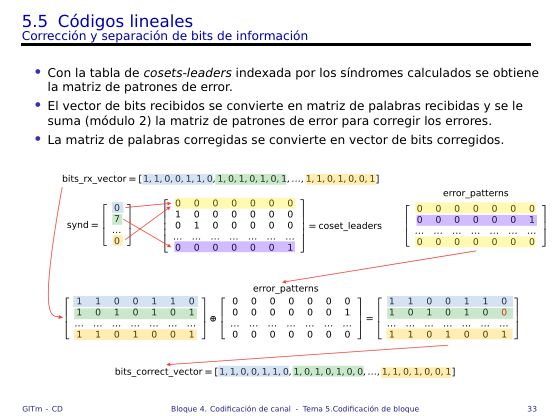
Con la tabla de cosets-leaders indexada por los síndromes calculados se obtiene la matriz de patrones de error.
用「syndrome → coset-leader」表,把每个 syndrome 翻译成错误图样矩阵。
El vector de bits recibidos se convierte en matriz de palabras recibidas y se le suma (módulo 2) la matriz de patrones de error para corregir los errores.
接收比特向量 reshape 成接收矩阵,再与错误图样矩阵模 2 相加,即完成纠错。
La matriz de palabras corregidas se convierte en vector de bits corregidos.
纠错后的矩阵再 flatten 成纠正比特向量。
En forma matricial: Ŷcorregida = Ŷ ⊕ E(S), con E(S) obtenido de la tabla.
矩阵形式:纠正矩阵 = 接收矩阵 ⊕ E(S),其中 E(S) 直接查表得到。
bits_rx_vector
   │ reshape(m)
   ▼
matriz recibida ──► ×H ──► S ──► bin2dec ──► 查 coset-leader 表
   │                                              │
   │            E(S) 矩阵  ◄──────────────────────┘
   ▼  ⊕ (módulo 2)
matriz corregida
   │ flatten
   ▼
bits_corrected_vector
5.5 Códigos lineales · Corrección y separación (II):分离信息位
▸ 原页截图 p.34
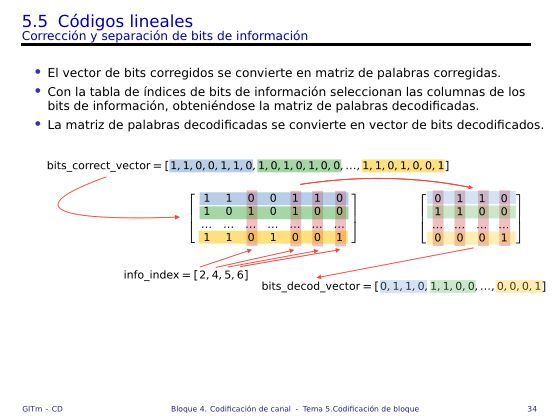
El vector de bits corregidos se convierte en matriz de palabras corregidas.
纠正后的比特向量 reshape 回纠正字矩阵。
Con la tabla de índices de bits de información seleccionan las columnas de los bits de información, obteniéndose la matriz de
按信息位索引表挑出信息位所在的列,得到译码字矩阵。
La matriz de palabras decodificadas se convierte en vector de
译码字矩阵再 flatten 成译码比特向量,即原始信息。
En el código 4/7, la tabla de índices de información es [3, 5, 6, 7]: se toman esas cuatro columnas de cada palabra corregida.
4/7 码中信息位索引表就是 [3, 5, 6, 7]:从每个纠正字里取这 4 列。
bits_corrected_vector
   │ reshape(m = 7)
   ▼
matriz corregida (filas × 7)
   │ 取列 [3, 5, 6, 7]   ← tabla de índices de información
   ▼
matriz decodificada (filas × 4)
   │ flatten
   ▼
bits_decoded_vector  =  X original
5.5 Códigos lineales · Implementación en Python (coset-leaders)
▸ 原页截图 p.35
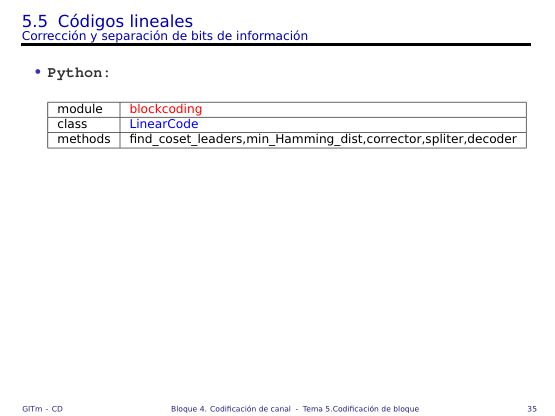
Implementación — Python: module blockcoding, class LinearCode, methods find_coset_leaders, min_Hamming_dist, corrector, spliter, decoder.
Python 实现:模块 blockcoding、类 LinearCode,方法 find_coset_leaders / min_Hamming_dist / corrector / spliter / decoder。
find_coset_leaders construye la tabla de coset-leaders (peso creciente + síndromes libres).
find_coset_leaders:建陪集首表(按重量递增、占用未用 syndrome)。
min_Hamming_dist calcula dMIN como el mínimo número de filas de H que suman 0.
min_Hamming_dist:按「H 最少几行相加为 0」算 dMIN。
corrector aplica la tabla a las palabras recibidas (Ŷ ⊕ E(S)); spliter separa los bits de información; decoder encadena corrección y separación.
corrector:用表纠错(Ŷ ⊕ E(S));spliter:分离信息位;decoder:把纠错 + 分离串起来。
decoder devuelve el vector de bits decodificados a partir del vector recibido.
decoder:输入接收向量,输出译码后的比特向量。
module blockcoding
└── class LinearCode
    ├── find_coset_leaders   # 建 coset-leader 表
    ├── min_Hamming_dist     # d_MIN = 最少几行 H 相加为 0
    ├── corrector            # Ý ⊕ E(S)
    ├── spliter              # 取列 [3,5,6,7]
    └── decoder              # corrector + spliter
七、5.6 性能与 5.7 扰码器
p.36–p.39Tema 5 · 目录(5.7 Aleatorizador 高亮)
▸ 原页截图 p.36
5.1 Esquema de codificación de canal
5.1 信道编码方案。
5.2 Códigos de bloque
5.2 分组码。
5.3 Implementación mediante tablas
5.3 查表实现。
5.4 Códigos de paridad
5.4 奇偶校验码。
5.5 Códigos lineales
5.5 线性码。
5.6 Prestaciones
5.6 性能。
5.7 Aleatorizador
5.7 扰码器(本页高亮,进入收尾一节)。
Tema 5: Codificación de bloque
主题 5:分组码(总目录)。
5.6 Prestaciones · BER y curvas de los códigos de Hamming
▸ 原页截图 p.37
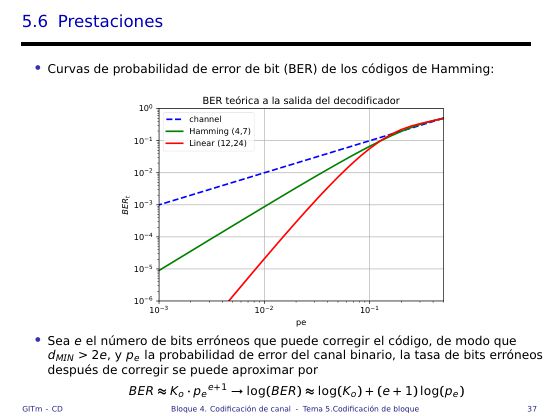
Curvas de
汉明码的误比特率(BER)曲线。
En la figura, el eje horizontal es BERt (BER teórica a la salida del decodificador) y se comparan «channel», «Hamming (4,7)» y «Linear (12,24)».
图中横轴是译码器输出的理论 BER,对比了「channel」(无编码)、「Hamming (4,7)」与「Linear (12,24)」三条曲线。
Sea e el número de bits erróneos que puede corregir el código, de modo que dMIN > 2e, y pe la
设 e 为码能纠正的比特数(满足 dMIN > 2e),pe 为二进制信道误码率,则纠错后的误比特率可近似为 BER ≈ Ko · pee+1。
log(BER) ≈ log(Ko) + (e + 1) log(pe)
取对数:log(BER) ≈ log(Ko) + (e + 1)·log(pe)。
En escala log-log la curva es una recta de pendiente (e + 1): a mayor
在双对数坐标下是一条斜率 (e+1) 的直线:e 越大,BER 随 pe 下降得越陡。
Tema 5 · 目录(5.7 Aleatorizador 高亮 · 重复页)
▸ 原页截图 p.38
Tema 5: Codificación de bloque
主题 5:分组码。
5.1 Esquema de codificación de canal
5.1 信道编码方案。
5.2 Códigos de bloque
5.2 分组码。
5.3 Implementación mediante tablas
5.3 查表实现。
5.4 Códigos de paridad
5.4 奇偶校验码。
5.5 Códigos lineales
5.5 线性码。
5.6 Prestaciones
5.6 性能。
5.7 Aleatorizador
5.7 扰码器(高亮项,下一页正式讲)。
5.7 Aleatorizador · 扰码与解扰
▸ 原页截图 p.39
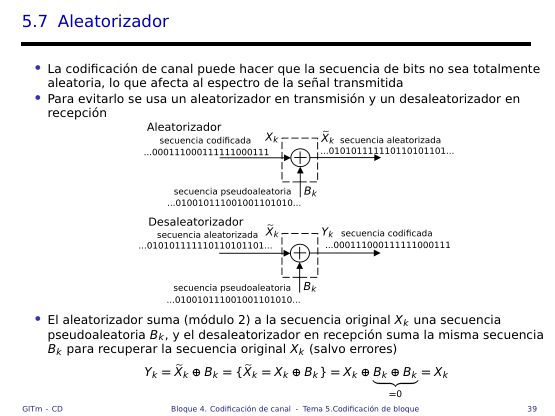
La codificación de canal puede hacer que la secuencia de bits no sea totalmente aleatoria, lo que afecta al espectro de la señal transmitida.
信道编码可能让比特序列不再完全随机,从而影响发送信号的频谱(出现离散谱线)。
Para evitarlo se usa un aleatorizador en transmisión y un
为避免这一点,发送端加扰码器(aleatorizador),接收端加解扰器(desaleatorizador)。
El aleatorizador suma (módulo 2) a la secuencia original Xk una
扰码器把原序列 Xk 与伪随机序列 Bk 模 2 相加;接收端解扰器再加同一个 Bk,即可还原 Xk(除错误外)。
Yk = Xk ⊕ Bk; en recepción: Yk ⊕ Bk = Xk ⊕ Bk ⊕ Bk = Xk
发送:Yk = Xk ⊕ Bk;接收:Yk ⊕ Bk = Xk ⊕ Bk ⊕ Bk = Xk。
Como Bk ⊕ Bk = 0, sumar dos veces la misma secuencia la cancela por completo.
因为 Bk ⊕ Bk = 0,同一序列加两次即彻底抵消。
专有名词速记表(A–Z)
共 46 条,覆盖全 39 页的高频术语。第三列点页码直接跳回原页;最后一列只写「一句话 + 最容易被扣分的点」。
| 西语术语 | 中文 | 页码 | 一句话记住 · 易错点 |
|---|---|---|---|
| A | |||
| Aleatorizador | 扰码器 | p.39 | 发端 ⊕Bk 打散长串 0/1、压窄谱线,收端再 ⊕Bk 还原。易错:以为它在加密——Bk 是公开可复现的伪随机序列。 |
| B | |||
| bit de paridad | 校验位 | p.17 | 简单奇偶码只在末尾加 1 位,让 1 的个数为偶。易错:dMIN=2 只能检 1 位错,不能纠。 |
| bits de información | 信息比特 | p.6 | 待编码的原始 n 位,记 X=[x1…xn]。易错:别把 m(码字长)当成信息位数。 |
| bits de paridad | 校验比特 | p.19 | 汉明码里 p 位校验位产生 2p 个 syndrome。易错:2p ≥ p+n+1 里的 n 是信息位数,不是码字长。 |
| bits decodificados | 译码比特 | p.34 | 纠错后按信息列下标(本课 [3,5,6,7])抽出的比特。易错:抽完还要 flatten 成一维,漏了就少一串。 |
| bits erróneos | 错误比特 | p.6 | 信道翻转的比特,个数记 e。易错:检错要 e < dMIN、纠错要 2e < dMIN,两个条件别混。 |
| C | |||
| canal binario | 二进制信道 | p.18 | 输入输出都是 0/1,以概率 pe 翻转。易错:pe 是单比特错误概率,不是整字错概率。 |
| capacidad de corrección | 纠错能力 | p.37 | 能纠 e 位 ⇔ dMIN > 2e。易错:把 > 写成 ≥ 直接丢分。 |
| capacidad de detección/corrección | 检错/纠错能力 | p.4 | 冗余越多能力越强、有效比特率越低,是此消彼长的一对。易错:以为加冗余只有好处。 |
| chequeo de paridad | 奇偶校验 | p.18 | s0=0 判无错(或偶数个错),s0=1 判有错。易错:偶数个错全漏检。 |
| Codificación de bloque | 分组码(块编码) | p.1 | 每 n 位一组映射成 m 位码字,组与组相互独立。易错:分组码无记忆,别套卷积码的网格图。 |
| Codificación de canal | 信道编码 | p.1 | 加冗余换可靠性,位置在调制之前。易错:它和信源编码方向相反,别写反。 |
| codificador de canal | 信道编码器 | p.4 | 按规则加冗余、输出码字 Y。易错:它只负责编码,纠错发生在收端译码器。 |
| Código corrector de errores | 纠错码 | p.8 | 收到 Yr 后取距离最近的合法码字。易错:前提是「最近的码字就是原码字」,错多了就不成立。 |
| código de paridad simple | 简单奇偶校验码 | p.29 | C(n,n+1):n 位原样 + 1 位校验,dMIN=2。易错:纠 0 位、检 1 位,别写成能纠错。 |
| código de repetición | 重复码 | p.29 | 1 位信息重复 3 次,dMIN=3,可纠 1 位。易错:H 的 3 行必须全部相加才为 0。 |
| Código detector de errores | 检错码 | p.8 | 收到不在码表里的字就报错、请求重传。易错:检错不纠,答题别写「纠正」。 |
| Códigos de bloque | 分组码(块码) | p.6 | C(n,m) 的另一种叫法:n 进 m 出。易错:RC=n/m<1,写成 m/n 是把码率倒了。 |
| Códigos de Hamming | 汉明码 | p.16 | 多个校验位的组合 syndrome 直接指出错位,(7,4) 是母版。易错:标准汉明码只纠 1 位,纠 2 位要加总体校验位。 |
| Códigos de paridad | 奇偶校验码 | p.16 | 5.4 节统称:简单奇偶 + 汉明。易错:汉明码本质是奇偶校验的多维版,不是另一类东西。 |
| Códigos de paridad simple | 简单奇偶校验码 | p.16 | 只加 1 位校验位的奇偶码。易错:与汉明的分界是校验位个数 p=1 vs p≥3。 |
| códigos sistemáticos | 系统码 | p.22 | 信息位原样出现在码字里,所以能按列下标直接抽回。易错:非系统码不能这样抽。 |
| Coset-leaders | 陪集首 | p.30 | 每个 syndrome 对应一组错误图样,取重量最小的那个。易错:不是任取一个,必须最轻(最可能)。 |
| D | |||
| Decodificación | 译码 | p.13 | 收到 Yr 后反推信息 X 的全过程。易错:它包含纠错,但两者不是同义词。 |
| decodificador de canal | 信道译码器 | p.4 | 先验证冗余,再检错或纠错。易错:译码器可以只检不纠,取决于码的设计。 |
| desaleatorizador | 解扰器 | p.39 | 收端 ⊕ 同一个 Bk,用 Bk⊕Bk=0 抵消。易错:序列必须完全相同且严格同步。 |
| Distancia de Hamming | 汉明距离 | p.7 | 两个等长码字不同位的个数。易错:不是欧氏距离,也不是逐位相减。 |
| Distancia de Hamming mínima | 最小汉明距离 | p.7 | 所有码字对里最小的 dH,记 dMIN。易错:dMIN=2 只能检出 1 位错,不能纠。 |
| E | |||
| espacio nulo | 零空间 | p.24 | G 的行空间与 H 的行空间互为零空间:G·H=0。易错:维度要写成 n×m · m×(m−n)。 |
| M | |||
| Matriz de chequeo | 校验矩阵 | p.23 | H 是 m×(m−n),S=Y·H;本课 H 第 i 行 = i 的三位二进制。易错:写成 (m−n)×m 就转置反了。 |
| Matriz generadora | 生成矩阵 | p.22 | G 是 n×m,Y=X·G;系统码里信息列构成单位阵。易错:G 是 n×m 不是 m×n。 |
| módulo 2 | 模 2 | p.22 | 加法即 XOR:1⊕1=0,永不进位。易错:按普通加法算会凭空多出一位。 |
| P | |||
| palabra codificada | 码字 | p.12 | 码表第 k 行就是「符号 k」的码字。易错:行号是十进制信息字,不是比特串本身。 |
| palabra recibida | 接收字 | p.8 | 过信道后可能带错的 Yr。易错:它不一定是合法码字,这正是检错的依据。 |
| palabras codificadas | 码字 | p.6 | 码表里的 m 位行向量。易错:一共 2n 个,不是 2m 个。 |
| palabras de información | 信息字 | p.6 | 2n 种 n 位输入组合。易错:码表行数 = 2n,和译码表的 2m 别混。 |
| palabras decodificadas | 译码后字 | p.34 | 按信息列下标抽出的 n 位结果。易错:抽的是列([3,5,6,7]),不是行。 |
| patrones de error | 错误图样 | p.30 | 与码字等长的 0/1 向量,1 的位置就是错位。易错:E 有 m 位,和信息字的 n 位不同长。 |
| probabilidad de error | 错误概率 | p.37 | 未编码时等于信道的 pe,编码后看 BER。易错:这两个 p 不是同一个量。 |
| probabilidad de error de bit | 误比特率 | p.37 | BER ≈ K0·pee+1,log-log 斜率是 e+1。易错:指数是 e+1,不是 e。 |
| R | |||
| retransmisión | 重传 | p.4 | 只检错时的补救:发现错就要求重发。易错:需要反向信道,单向链路做不到。 |
| S | |||
| secuencia pseudoaleatoria | 伪随机序列 | p.39 | 收发双方共享、可复现的 Bk。易错:伪随机 ≠ 真随机,必须能重现。 |
| T | |||
| tabla de código | 编码表 | p.12 | 2n 行查表:行号 → 码字。易错:n 一大表就爆,所以才有矩阵法。 |
| tabla de decodificación | 译码表 | p.14 | 2m 行,覆盖所有可能的接收串。易错:是 2m 不是 2n,m>n 所以更大。 |
| Tasa del código | 码率 | p.6 | RC=n/m<1。易错:4/7 码的码率是 4/7≈0.571,不是 7/4。 |
| V | |||
| vector de bits | 比特向量 | p.25 | 编码前按 n 位切行、编码后再 flatten。易错:reshape 的列数是 n,不是 m。 |
数字与量级速记卡
口诀:「一检二纠、三七汉明、四七系统、二八陪集」。这些数字考试张口就要报,全是送分点。
| 行 | 数字 | 原文关键词 | 中文 | 页 |
|---|---|---|---|---|
| 1 | 2 | dMIN = 2 | 简单奇偶码:只能检 1 位错,不能纠 | p.17 |
| 2 | 3 | dMIN = 3 | 汉明 (7,4) 与重复码:可纠 1 位错 | p.20 |
| 3 | 2 | e < dMIN | 保证检出 e 个错的条件(e=1 ⇒ dMIN≥2) | p.9 |
| 4 | 3 | 2e < dMIN | 保证纠正 e 个错的条件(e=1 ⇒ dMIN≥3) | p.10 |
| 5 | 2 | RC = n/m | 码率定义,4/7 码 ≈ 0.571 | p.6 |
| 6 | 4 | C(4, 7) | 汉明码:4 位信息进、7 位码字出 | p.22 |
| 7 | 3 | 2p ≥ p + n + 1 | 汉明码校验位数下界(n=4 ⇒ p=3) | p.19 |
| 8 | 8 | 2m−n = 23 | 4/7 码的 syndrome 总数 = coset-leader 条数 | p.32 |
| 9 | 32 | 2m = 26 | 译码表行数(p.14 的 m=6 例) | p.14 |
| 10 | 16 | 2n = 24 | 编码表行数(n=4 时) | p.12 |
| 11 | 1 | e = 1 | 汉明码纠错能力:只纠 1 位 | p.20 |
| 12 | 3 | S = [0, 1, 1] | p.20 例:syndrome 换算成十进制 3 ⇒ 错在 y3 | p.20 |
| 13 | 2 | GF(2) | 模 2 域:加法即 XOR,1⊕1=0,不进位 | p.22 |
| 14 | 3 | 001⊕010⊕011 = 000 | dMIN = H 中「最少几行相加为 0」⇒ 3 | p.28 |
| 15 | 1 | e + 1 | BER 曲线 log-log 斜率;纠错位越多越陡 | p.37 |
| 16 | 7 | [3, 5, 6, 7] | 4/7 系统码抽信息位的列下标 | p.34 |
最容易混的十二组概念
每组只抓一个分界点:谁喊错、谁改错、谁进谁出、谁最轻。