- 一页一块:页号胶囊是 PDF 物理页序(1–100);幻灯片上印的页码可能另有编号,以胶囊为准。
- 逐句对照:蓝色左框内是西语原句(逐字照抄,含原文笔误),下面带「中」字标的是中文翻译;项目符号统一用 • 表示。
- 提示框:绿色「考点」= 这页怎么考;红色「陷阱」= 易错点与原文勘误;紫色「记忆钩子」= 口诀;橙色「补充」= 前后页串联。
- 术语悬停:西语句里带浅蓝底的词,鼠标停上去出中文;中文句里带虚下划线的词,停上去出西语原词。
- 公式:一律用本地 MathJax 渲染(断网也能显示),每个公式下附「符号 / 西语读法 / 中文含义」三列小表——口语考试念的就是这一列。
一、课程导览:主题 2 讲什么、要考什么
p.1–p.3Tema 2. Representación del conocimiento · 主题 2:知识的表示
▸ 原页截图 p.1
Tema 2.
主题 2:
Eva Millán
Eva Millán(授课教师姓名,考试卷头与课件署名都是这个)。
Departamento de Lenguajes y Ciencias de la Computación
语言与计算机科学系(西班牙马拉加大学 UMA 的系名)。
Índice · 目录
▸ 原页截图 p.2
Índice
目录。
•
•
•
•
•
• Repaso de conceptos básicos de probabilidad
概率基础概念复习。
• Definición formal de red bayesiana
贝叶斯网络的形式定义。
•
• Modelado con redes bayesianas
用贝叶斯网络建模。
• Algoritmo de propagación de probabilidades en árboles
树上的概率传播算法。
2
幻灯片自带页码 2(与 PDF 物理页序一致,可用它核对页码)。
Resultados de aprendizaje · 学习成果
▸ 原页截图 p.3
Al finalizar el tema, el estudiante deberá ser capaz de:
完成本主题后,学生应能够:
• Describir el concepto de
描述
• Modelar una situación real con una
用一个
• Entender el significado e importancia de las condiciones de
理解
• Predecir la evolución de las probabilidades en la red conforme se adquiere nueva
预测随着获得新
• Aplicar algoritmos de
应用基本的
• Manejar herramientas de implementación de redes bayesianas (GENIE)
会使用贝叶斯网络的实现工具(GENIE)。
3
幻灯片页码 3。
二、基于知识的系统(SBC):定义、功能、架构
p.4–p.7SBC: Probemos uno · SBC:我们先试一个
▸ 原页截图 p.4
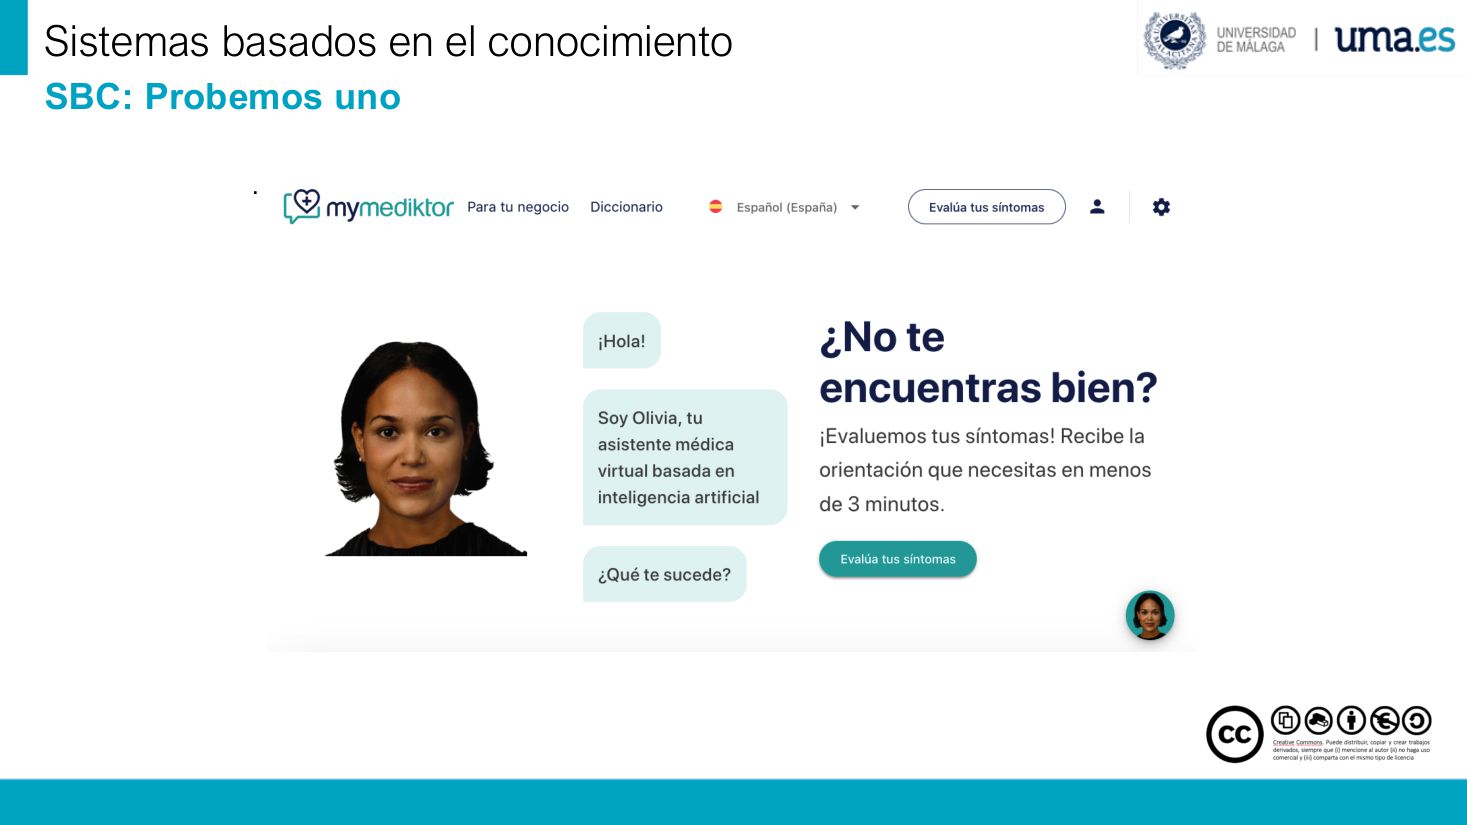
SBC: Probemos uno
SBC:我们先试一个(课堂互动页,老师当场让同学扮演一个“专家系统”)。
.
原文此处只有一个孤立句点,是原页留下给演示的空位。
SBC: Definición · SBC:定义
▸ 原页截图 p.5
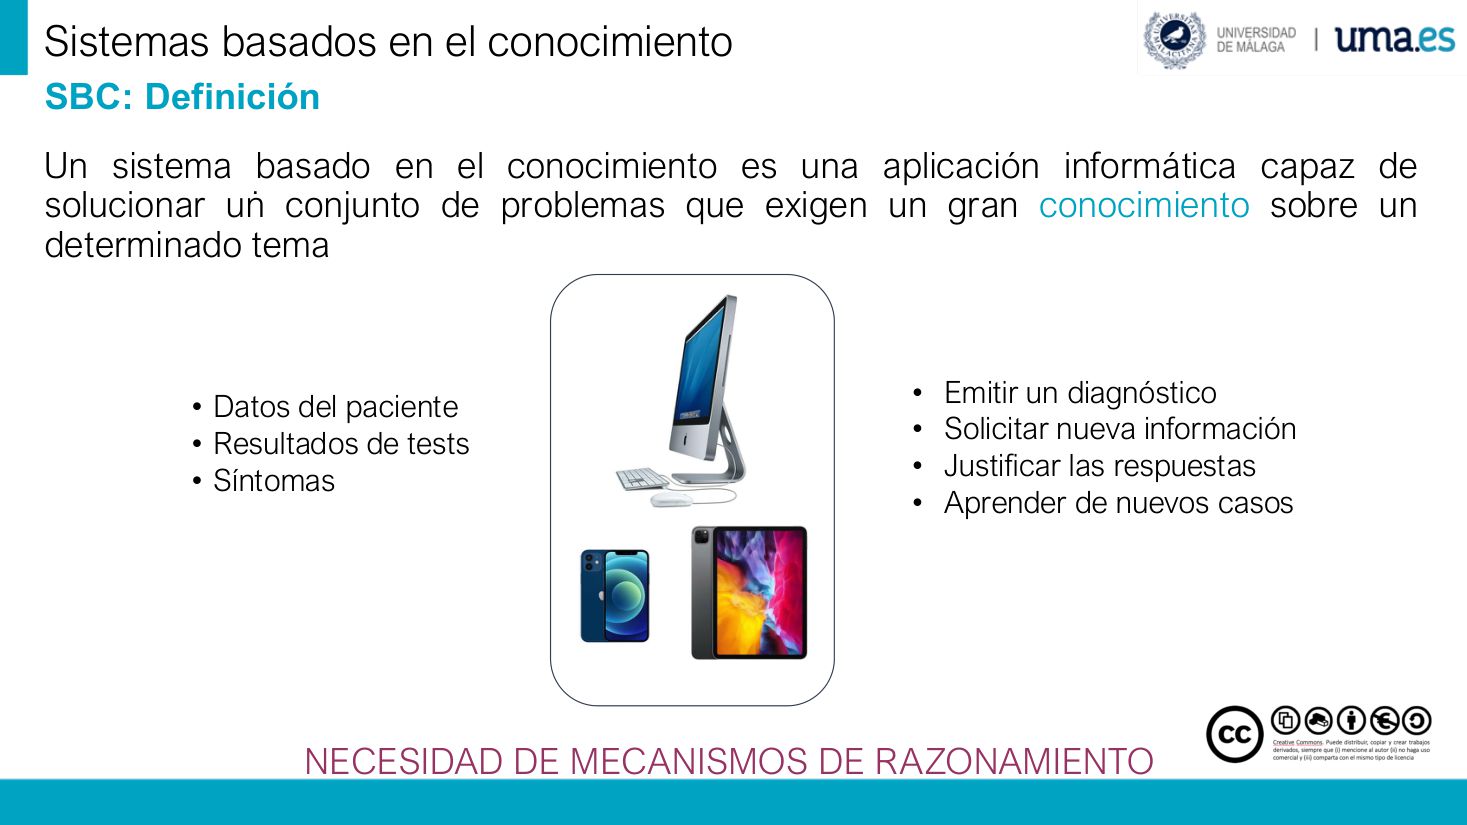
Sistemas basados en el conocimiento
基于知识的系统。
Un
一个
SBC: Definición
SBC:定义(本节标题)。
.
原文孤立的句点,排版残留。
• Datos del paciente
病人数据(系统的输入之一)。
• Resultados de tests
检验结果。
•
• Emitir un
给出
• Solicitar nueva información
索取新信息(系统主动问缺的数据)。
• Justificar las respuestas
为答案给出理由(可解释性)。
• Aprender de nuevos casos
从新案例中学习。
NECESIDAD DE
需要
SBC: Funcionalidad · SBC:功能
▸ 原页截图 p.6
Sistemas basados en el conocimiento
基于知识的系统。
Tareas que debe poder llevar a cabo un SBC:
一个 SBC 必须能够完成的任务:
• Aceptar las
接受用户就现实世界某一给定情境提出的
• Aceptar los datos proporcionados por el usuario acerca de esta situación, y solicitar otros datos que el sistema estime relevantes.
接受用户提供的关于该情境的数据,并索取系统认为相关的其他数据。
• Procesar esta información, en busca de una respuesta a la consulta planteada.
处理这些信息,以寻找对所提查询的答案。
• Emitir la respuesta hallada, que debe ser análoga en la mayor parte de los casos a la respuesta que daría un
给出找到的答案,它在大多数情况下应当与一位
• Justificar la respuesta finalmente emitida, siempre que el usuario así lo solicite.
只要用户要求,就要为最终给出的答案提供依据。
•
6
幻灯片页码 6。
SBC: Funcionalidad
SBC:功能(本节标题)。
SBC: Arquitectura · SBC:架构
▸ 原页截图 p.7
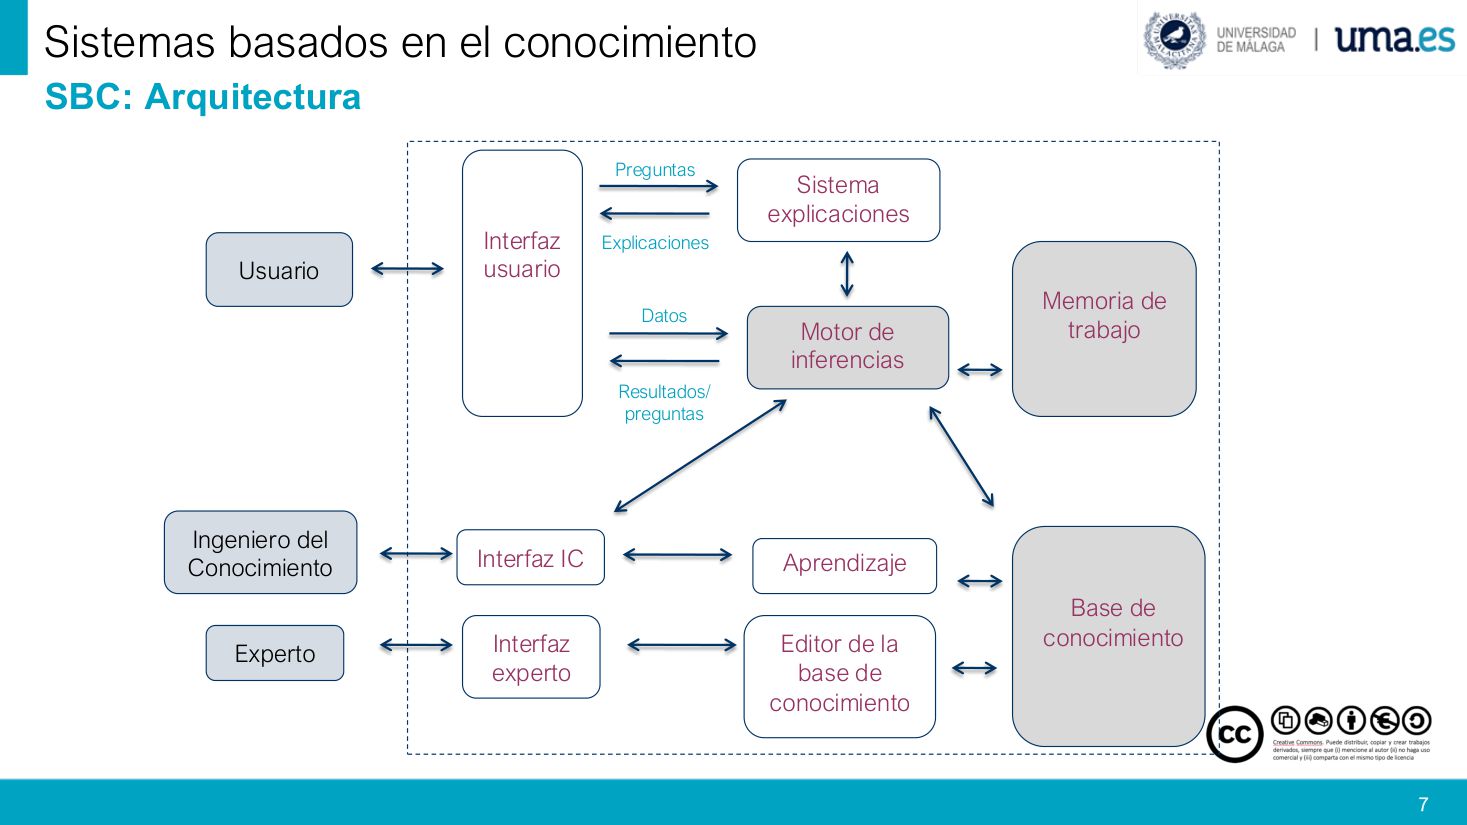
Sistemas basados en el conocimiento
基于知识的系统。
7
幻灯片页码 7。
SBC:
SBC:
Interfaz usuario
用户界面。
Interfaz IC
与知识工程师(IC =
Editor de la
Ingeniero del
Interfaz experto
专家界面。
Sistema explicaciones
解释系统(回答“为什么”)。
Preguntas
问题(用户向系统提问的箭头)。
Explicaciones
解释(系统回给用户的箭头)。
Datos
数据。
Resultados/ preguntas
结果/问题。
三、概率复习:联合分布、边缘分布与条件概率
p.8–p.13Método probabilístico clásico: ejemplo · 经典概率方法:例子
▸ 原页截图 p.8
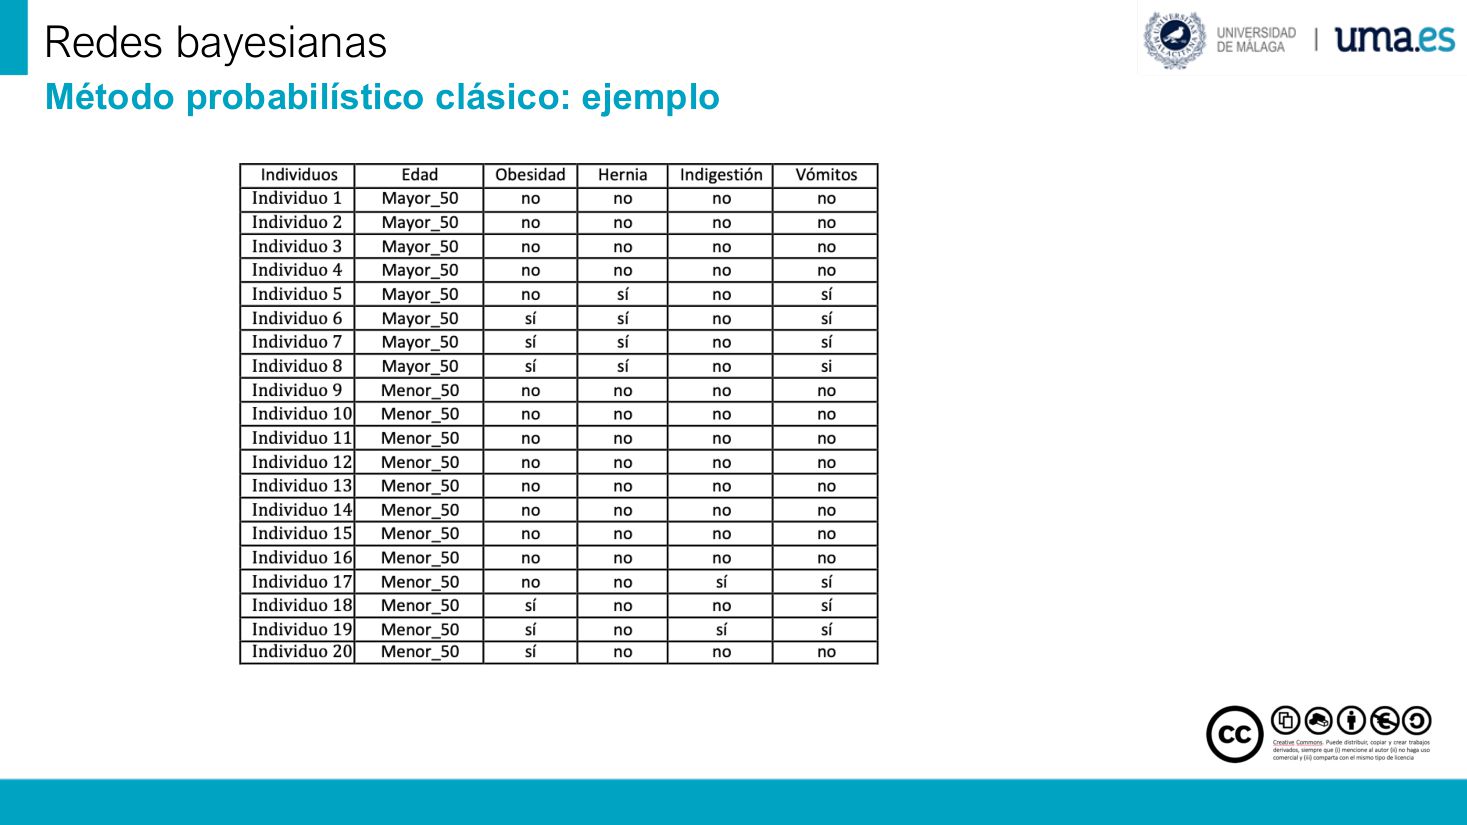
Redes bayesianas
贝叶斯网络(页眉所属章节名,全文每页都印)。
Método probabilístico clásico: ejemplo
经典概率方法:例子(本节标题页)。
Se pide · 题目要求
▸ 原页截图 p.9
Redes bayesianas
贝叶斯网络(页眉)。
Se pide:
要求完成:
a) Calcula un
a) 为这些变量计算一个
b) A partir del estimador de la distribución conjunta anterior, calcula:
b) 基于上一步得到的联合分布估计量,计算:
•
项目符号(原文单独一个圆点,排版残留)。
Las
P(Edad = Mayor_50) y P(Edad = Mayor_50, Hernia= sí)
P(Edad = Mayor_50) 与 P(Edad = Mayor_50, Hernia= sí)(年龄大于 50 的概率,以及「年龄大于 50 且患疝气」的联合概率)。
P(Hernia=si/Vómitos=sí) (
P(Hernia=si/Vómitos=sí)(已知呕吐时患疝气的概率,即
P(Vómitos=si/Obesidad=si, Hernia=sí) (
P(Vómitos=si/Obesidad=si, Hernia=sí)(已知肥胖且患疝气时发生呕吐的概率,即
Método probabilístico clásico: ejemplo
经典概率方法:例子(页脚标题)。
| 符号 | 西语读法 | 中文含义 |
|---|---|---|
| P(·) | «probabilidad de» | 概率;括号里是事件 |
| / | «dado» / «condicionado a» | 条件竖线,读作「在……条件下」 |
| , | «y» | 联合事件,两件事同时成立 |
| = Mayor_50 | «igual a mayor de cincuenta» | 变量取值为「大于 50 岁」 |
| = si | «igual a sí» | 变量取值为「是」(阳性 / 存在) |
A partir de los datos… · 从数据构造联合分布
▸ 原页截图 p.10
Redes bayesianas
贝叶斯网络(页眉)。
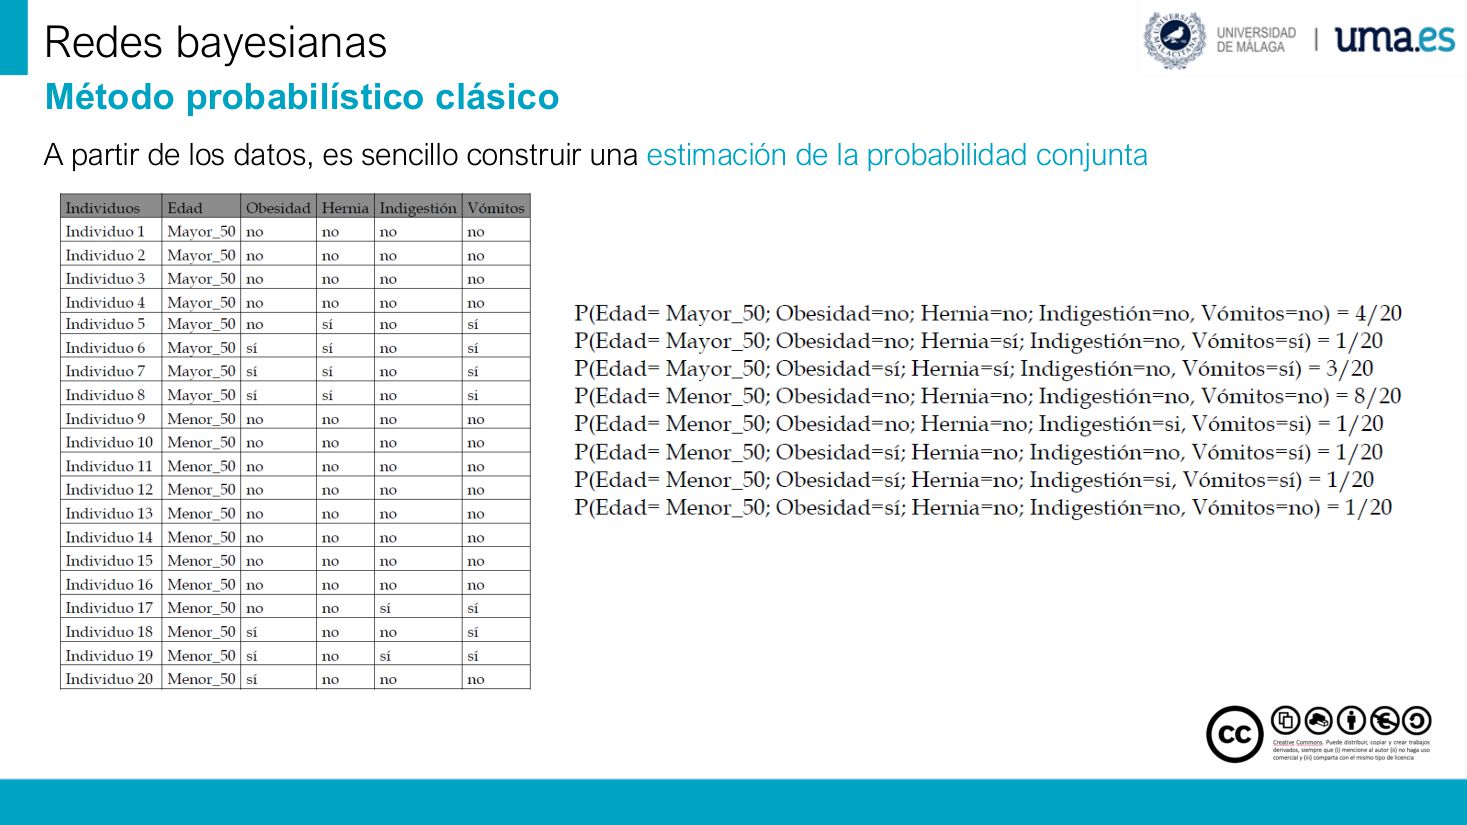
A partir de los datos, es sencillo construir una estimación de la
有了数据之后,构造
Método probabilístico clásico
经典概率方法(页脚标题)。
Marginales y condicionadas · 边缘分布与条件分布
▸ 原页截图 p.11
Redes bayesianas
贝叶斯网络(页眉)。
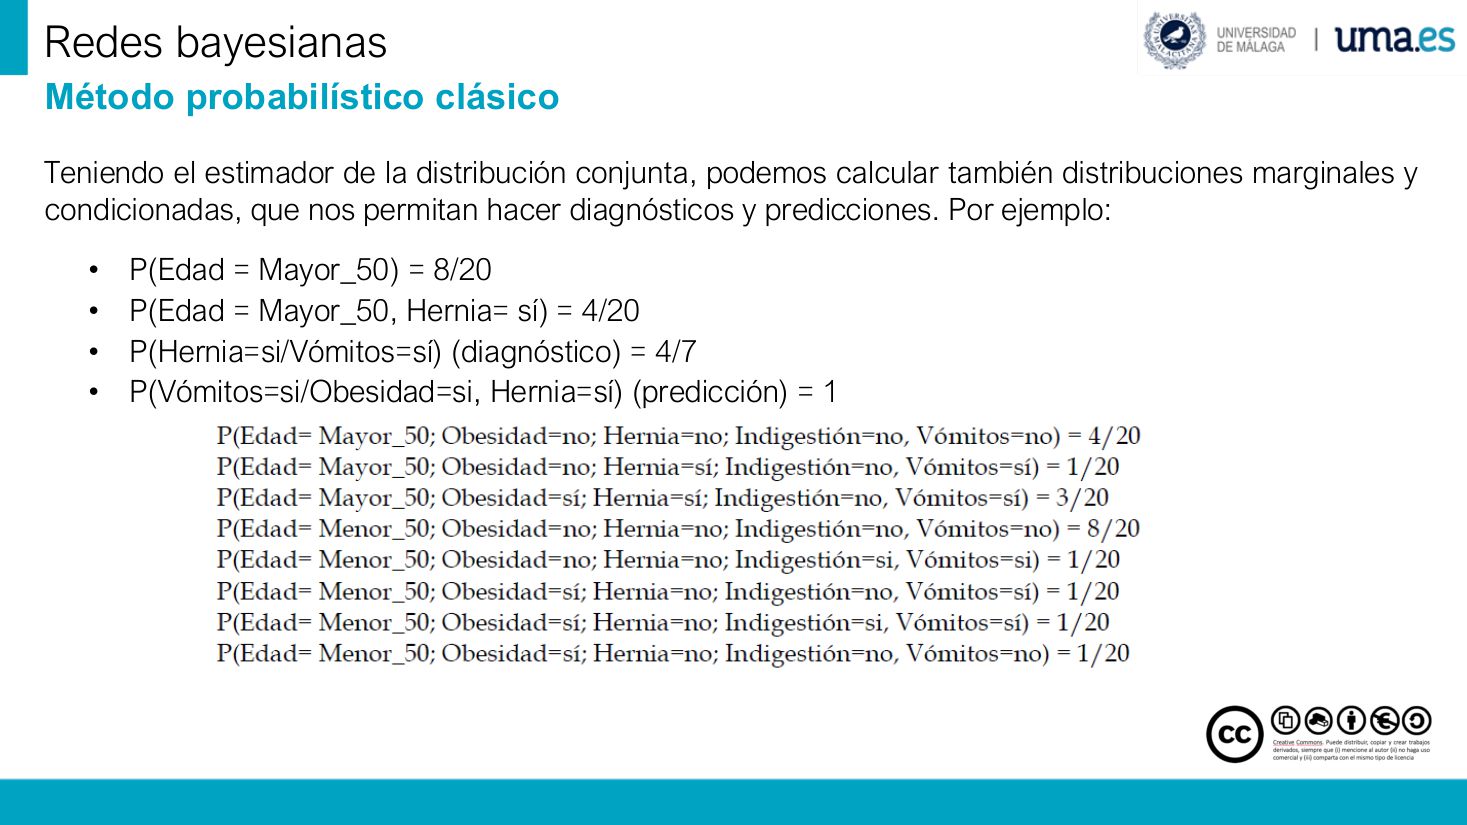
Teniendo el estimador de la distribución conjunta, podemos calcular también
有了联合分布的估计量,我们还可以计算
• P(Edad = Mayor_50) = 8/20
P(Edad = Mayor_50) = 8/20(20 个病例里 8 个年龄大于 50,即 0.4)。
• P(Edad = Mayor_50, Hernia= sí) = 4/20
P(Edad = Mayor_50, Hernia= sí) = 4/20(既年过 50 又患疝气的有 4 人,即 0.2)。
• P(Hernia=si/Vómitos=sí) (diagnóstico) = 4/7
P(Hernia=si/Vómitos=sí)(诊断)= 4/7(呕吐的 7 人中有 4 人患疝气,约 0.571)。
• P(Vómitos=si/Obesidad=si, Hernia=sí) (predicción) = 1
P(Vómitos=si/Obesidad=si, Hernia=sí)(预测)= 1(既肥胖又患疝气的人全部呕吐,概率为 1)。
Método probabilístico clásico
经典概率方法(页脚标题)。
| 符号 | 西语读法 | 中文含义 |
|---|---|---|
| P(A) = 8/20 | «probabilidad de A igual a ocho veinteavos» | 边缘概率 = 满足 A 的例数 ÷ 总例数 |
| P(A, B) | «probabilidad de A y B» | 联合概率,两个条件同时满足 |
| P(A/B) | «probabilidad de A dado B» | 条件概率,只在 B 成立的例子里算 |
| 4/7 | «cuatro séptimos» | 条件概率的分母是「条件事件的例数」,不是 20 |
Presentación intuitiva · 直观介绍
▸ 原页截图 p.12
Redes bayesianas
贝叶斯网络(页眉)。
En una
在一个
Notación:
记号:
• X, variable o nodo
X:变量或节点(大写表示整个变量)。
• x, valor (+x=sí, ¬x=no)
x:取值(+x=sí 表示「是」,¬x=no 表示「否」)。
Los
连接节点的
12
页码 12(原文页码印在正文下方)。
Presentación intuitiva
直观介绍(页脚标题)。
Información cualitativa y cuantitativa · 定性与定量信息
▸ 原页截图 p.13
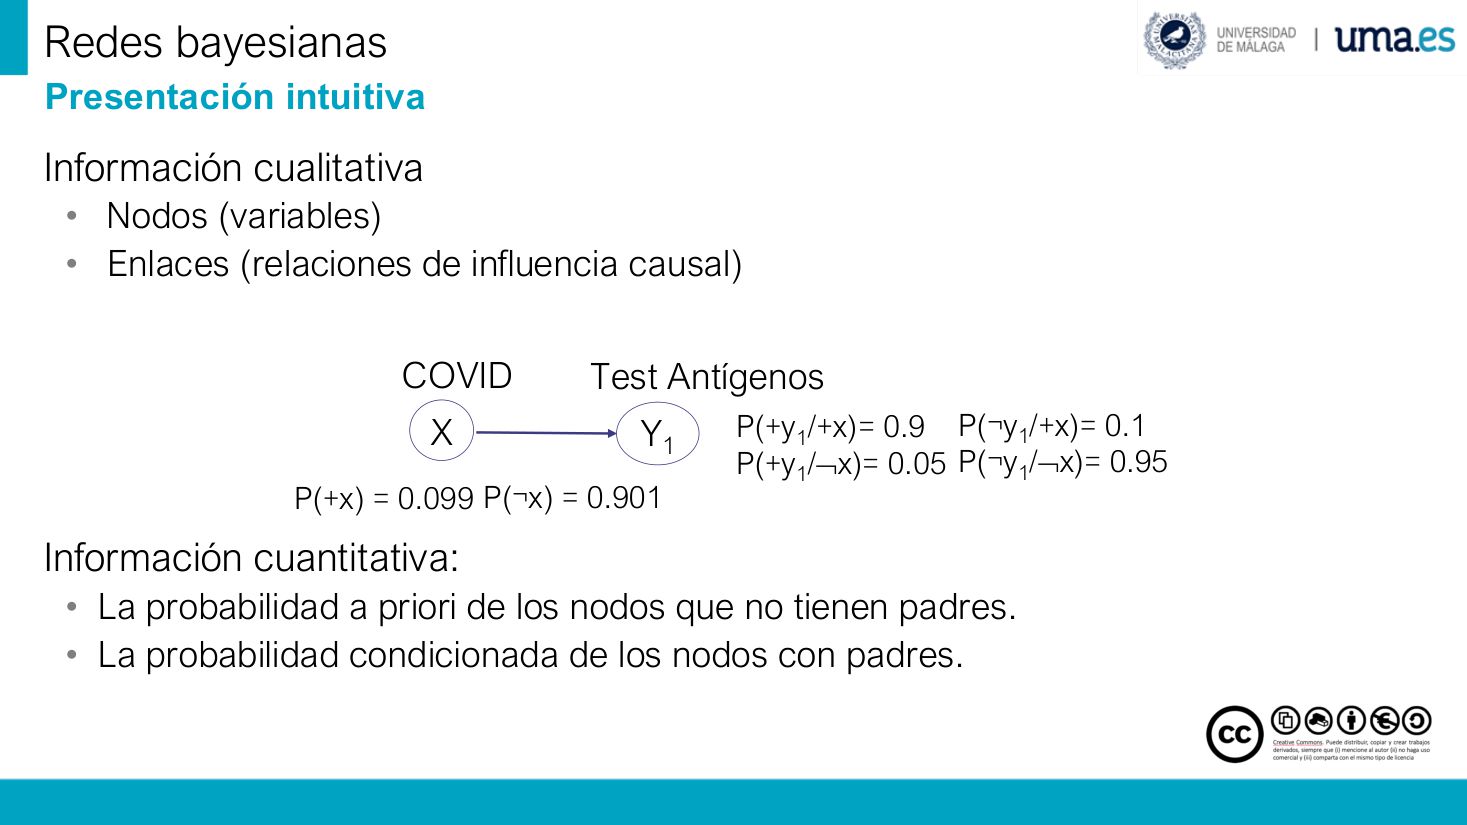
Redes bayesianas
贝叶斯网络(页眉)。
•
•
• La
没有父节点的那些节点的
• La
有父节点的那些节点的
Presentación intuitiva
直观介绍(页脚标题)。
P(¬y1/+x)= 0.1
P(¬y1/+x)= 0.1(X 为真时,Y1 为假的概率是 0.1)。
P(¬y1/x)= 0.95
P(¬y1/x)= 0.95(X 为假时,Y1 为假的概率是 0.95)。
Y1
Y1(图中下方的结果节点)。
X
X(图中上方的原因节点)。
P(+x) = 0.099
P(+x) = 0.099(X 为真的先验概率是 0.099)。
P(+y1/+x)= 0.9
P(+y1/+x)= 0.9(X 为真时,Y1 为真的概率是 0.9)。
P(+y1/x)= 0.05
P(+y1/x)= 0.05(X 为假时,Y1 为真的概率是 0.05)。
COVID
COVID(新冠,原因节点 X 的实例名)。
Test Antígenos
抗原检测(结果节点 Y1 的实例名)。
P(¬x) = 0.901
P(¬x) = 0.901(X 为假的先验概率是 0.901;注意 0.099 + 0.901 = 1)。
| 符号 | 西语读法 | 中文含义 |
|---|---|---|
| P(+x) | «probabilidad de más equis» | 节点取「是」的先验概率 |
| P(¬x) | «probabilidad de no equis» | 节点取「否」的先验概率,与 P(+x) 互补 |
| P(¬y1/+x) | «probabilidad de no ye uno dado más equis» | 父节点为「是」时子节点为「否」的条件概率 |
| / | «dado» | 条件竖线;下一页起也写作 «|» |
四、COVID 检测实例:先验、条件概率与后验推断
p.14–p.21Enfermedad / Test · 疾病与检测:五个关键名词
▸ 原页截图 p.14
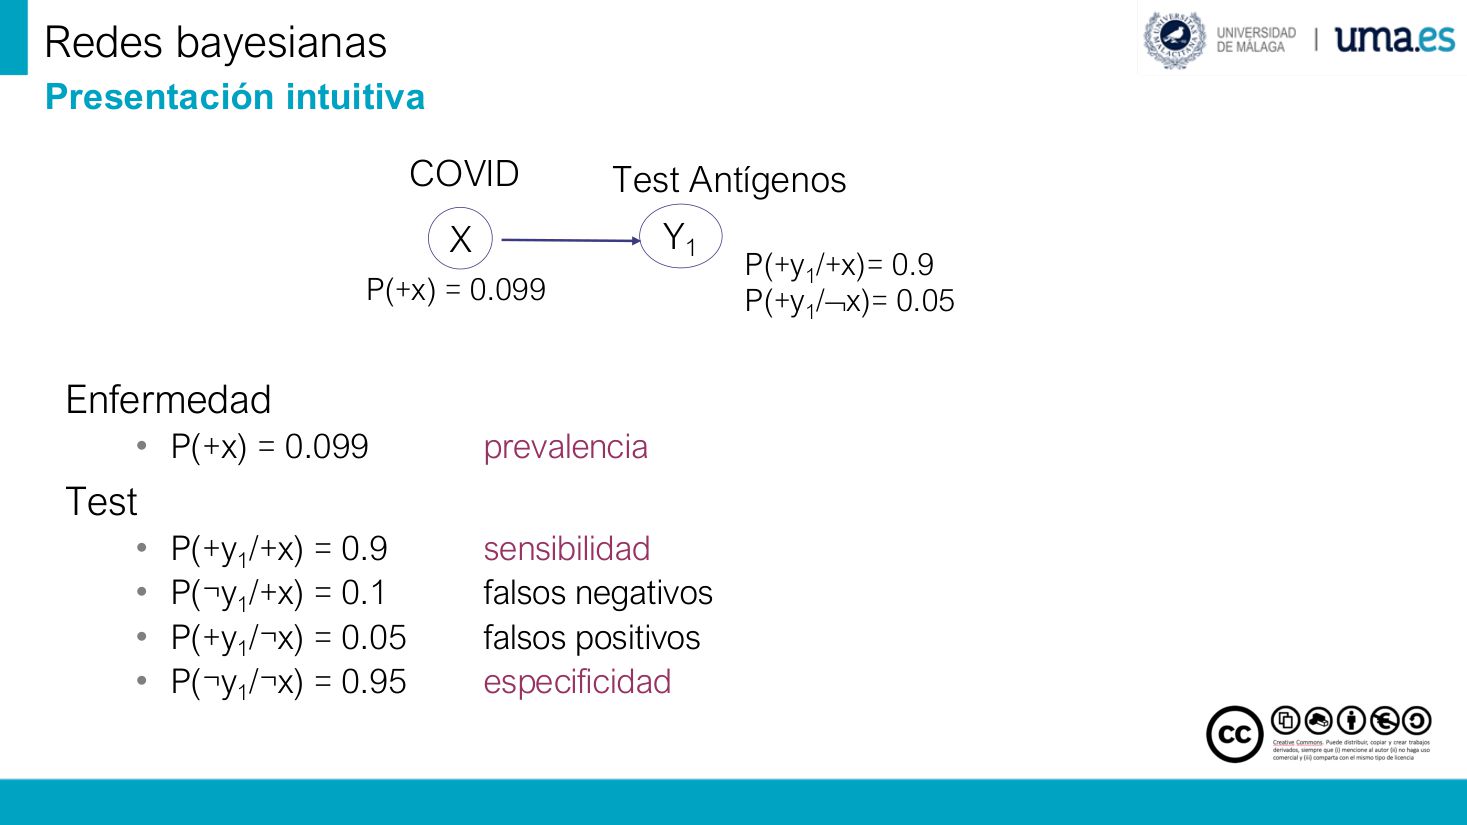
Redes bayesianas
贝叶斯网络(页眉)。
Enfermedad
疾病(原因节点 X 的通用名)。
• P(+x) = 0.099
P(+x) = 0.099(患病先验概率)。
Test
检测(结果节点 Y1 的通用名)。
• P(+y1/+x) = 0.9
P(+y1/+x) = 0.9(真患病时检测为阳性的概率)。
• P(¬y1/+x) = 0.1
P(¬y1/+x) = 0.1(真患病但检测为阴性的概率)。
• P(+y1/¬x) = 0.05
P(+y1/¬x) = 0.05(没病却检测为阳性的概率)。
• P(¬y1/¬x) = 0.95
P(¬y1/¬x) = 0.95(没病时检测为阴性的概率)。
Presentación intuitiva
直观介绍(页脚标题)。
Y1
Y1(结果节点)。
X
X(原因节点)。
P(+x) = 0.099
P(+x) = 0.099(图中标出的先验概率)。
P(+y1/+x)= 0.9
P(+y1/+x)= 0.9(图中标出的条件概率)。
P(+y1/x)= 0.05
P(+y1/x)= 0.05(图中标出的条件概率)。
COVID
新冠(X 的实例名)。
Test Antígenos
抗原检测(Y1 的实例名)。
| 符号 | 西语读法 | 中文含义 |
|---|---|---|
| prevalencia | «prevalencia» | 患病率 = P(+x),先验 |
| sensibilidad | «sensibilidad» | 灵敏度 = P(+y1/+x),真阳性率 |
| especificidad | «especificidad» | 特异度 = P(¬y1/¬x),真阴性率 |
| falsos negativos | «falsos negativos» | 假阴性率 = P(¬y1/+x) = 1 − sensibilidad |
| falsos positivos | «falsos positivos» | 假阳性率 = P(+y1/¬x) = 1 − especificidad |
Inferencias a partir de los datos · 从数据做推断:全概率公式
▸ 原页截图 p.15
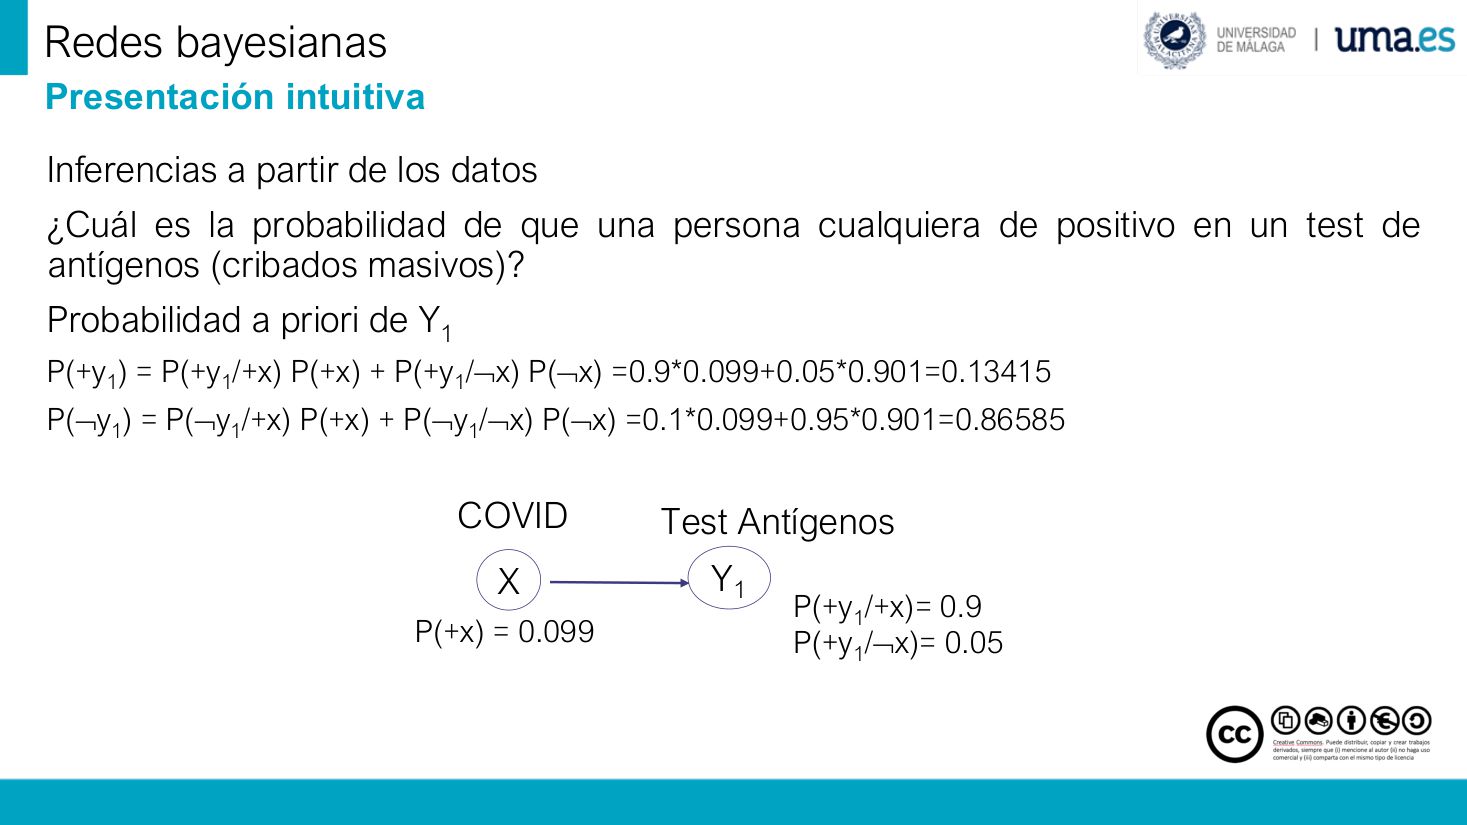
Redes bayesianas
贝叶斯网络(页眉)。
Inferencias a partir de los datos
从数据做推断(本节标题)。
¿Cuál es la probabilidad de que una persona cualquiera de positivo en un test de antígenos (
任意一个人抗原检测呈阳性的概率是多少(
P(+y1) = P(+y1/+x) P(+x) + P(+y1/x) P(x) =0.9*0.099+0.05*0.901=0.13415
P(+y1) = P(+y1/+x) P(+x) + P(+y1/¬x) P(¬x) = 0.9×0.099 + 0.05×0.901 = 0.13415(全概率公式:阳性 = 真阳性 + 假阳性)。
P(y1) = P(y1/+x) P(+x) + P(y1/x) P(x) =0.1*0.099+0.95*0.901=0.86585
P(¬y1) = P(¬y1/+x) P(+x) + P(¬y1/¬x) P(¬x) = 0.1×0.099 + 0.95×0.901 = 0.86585(阴性 = 假阴性 + 真阴性;两式相加为 1)。
Presentación intuitiva
直观介绍(页脚标题)。
Y1
Y1(检测结果节点)。
X
X(疾病节点)。
P(+x) = 0.099
P(+x) = 0.099(先验)。
P(+y1/+x)= 0.9
P(+y1/+x)= 0.9(灵敏度)。
P(+y1/x)= 0.05
P(+y1/x)= 0.05(图中标注;竖线后缺 ¬)。
COVID
新冠(X 的实例名)。
Test Antígenos
抗原检测(Y1 的实例名)。
| 符号 | 西语读法 | 中文含义 |
|---|---|---|
| P(+y1) | «probabilidad de más ye uno» | 检测阳性的先验(边缘)概率 |
| P(+y1/+x) | «dado más equis» | 患病时阳性的概率(灵敏度) |
| P(+x) | «probabilidad de más equis» | 患病率(prevalencia) |
| + | «más» | 求和;此处把 X 的两个取值两条路径相加 |
| * | «por» | 乘法(联合 = 条件 × 先验) |
Probabilidades a posteriori · 后验概率:贝叶斯公式
▸ 原页截图 p.16
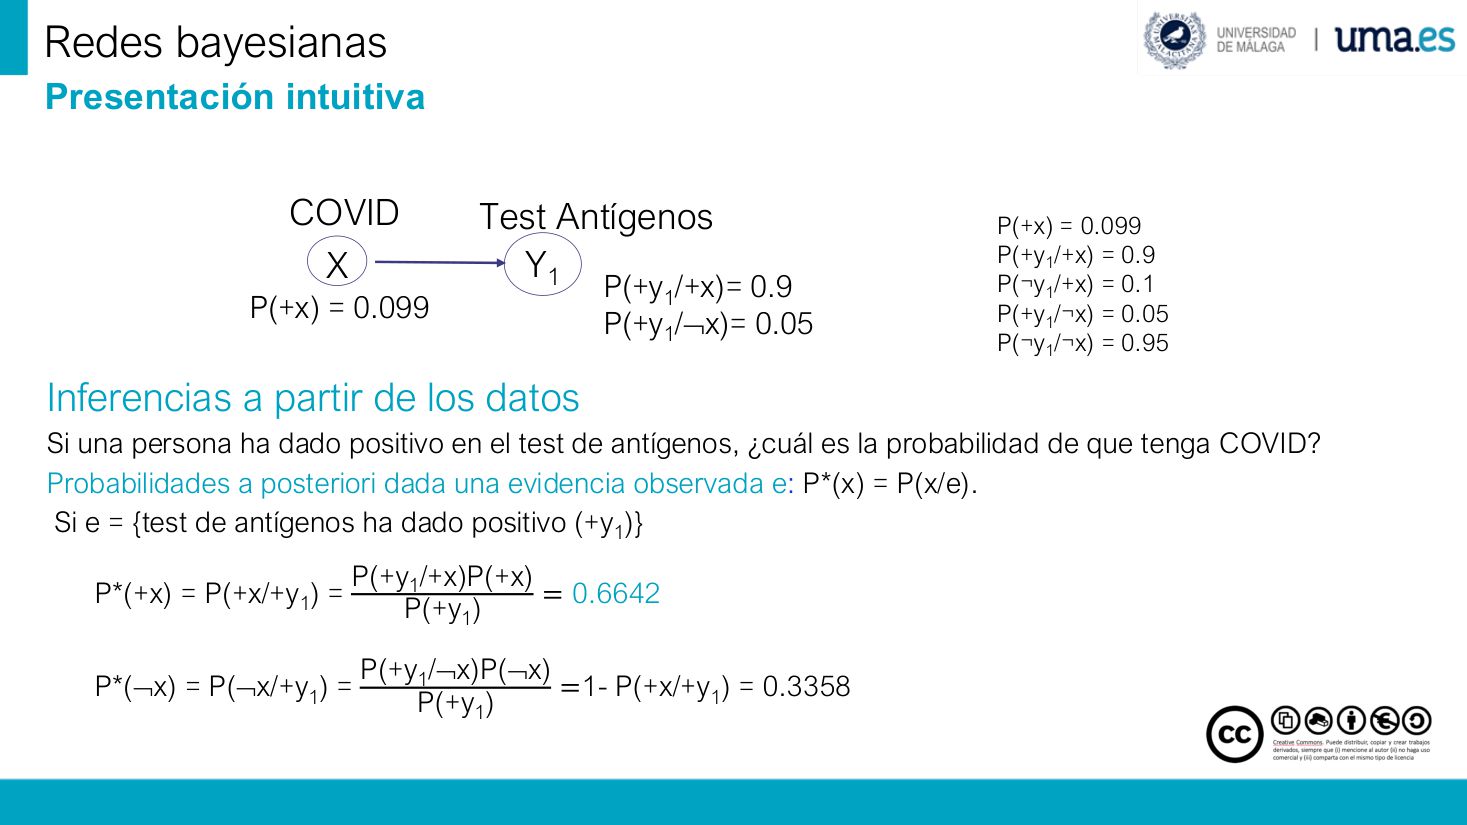
Redes bayesianas
贝叶斯网络(页眉)。
Inferencias a partir de los datos
从数据做推断(本节标题)。
Si una persona ha dado positivo en el test de antígenos, ¿cuál es la probabilidad de que tenga COVID?
如果一个人抗原检测呈阳性,他患新冠的概率是多少?
给定
Si e = {test de antígenos ha dado positivo (+y1)}
若 e = {抗原检测呈阳性 (+y1)}。
P*(+x) = P(+x/+y1) = P(+y1/+x)P(+x)
P*(+x) = P(+x/+y1) = P(+y1/+x)P(+x)(分子:似然 × 先验)。
P(+y1)
P(+y1)(分子下方是分母:证据的先验概率)。
= 0.6642
= 0.6642(即 0.9×0.099 / 0.13415 ≈ 0.6642)。
P*(x) = P(x/+y1) = P(+y1/x)P(x)
P*(¬x) = P(¬x/+y1) = P(+y1/¬x)P(¬x)(未患病那一路的分子)。
P(+y1)
P(+y1)(分母同上,阳性证据的总概率)。
=1- P(+x/+y1) = 0.3358
= 1 − P(+x/+y1) = 0.3358(用补事件算更快:1 − 0.6642)。
Presentación intuitiva
直观介绍(页脚标题)。
Y1
Y1(检测节点)。
X
X(疾病节点)。
P(+x) = 0.099
P(+x) = 0.099(先验)。
P(+y1/+x)= 0.9
P(+y1/+x)= 0.9(灵敏度)。
P(+y1/x)= 0.05
P(+y1/x)= 0.05(图中标注;应为 P(+y1/¬x))。
COVID
新冠(X 的实例名)。
Test Antígenos
抗原检测(Y1 的实例名)。
P(+x) = 0.099
P(+x) = 0.099(右侧参数表第一行)。
P(+y1/+x) = 0.9
P(+y1/+x) = 0.9(参数表)。
P(¬y1/+x) = 0.1
P(¬y1/+x) = 0.1(参数表;与 0.9 互补)。
P(+y1/¬x) = 0.05
P(+y1/¬x) = 0.05(参数表)。
P(¬y1/¬x) = 0.95
P(¬y1/¬x) = 0.95(参数表;与 0.05 互补)。
| 符号 | 西语读法 | 中文含义 |
|---|---|---|
| P*(x) | «pe asterisco de equis» | 后验概率(带星号 = 观测证据之后) |
| P(x/e) | «probabilidad de equis dado e» | 条件概率形式的同一件事 |
| e | «e» | evidencia:已观测到的证据集合 |
| P(+y1/+x)P(+x) | «likelihood por priori» | 分子 = 似然 × 先验 |
| P(+y1) | «probabilidad de más ye uno» | 分母 = 证据的先验概率(归一化常数) |
¿Sube o baja la probabilidad? · 新增证据后概率变大还是变小
▸ 原页截图 p.17
Redes bayesianas
贝叶斯网络(页眉)。
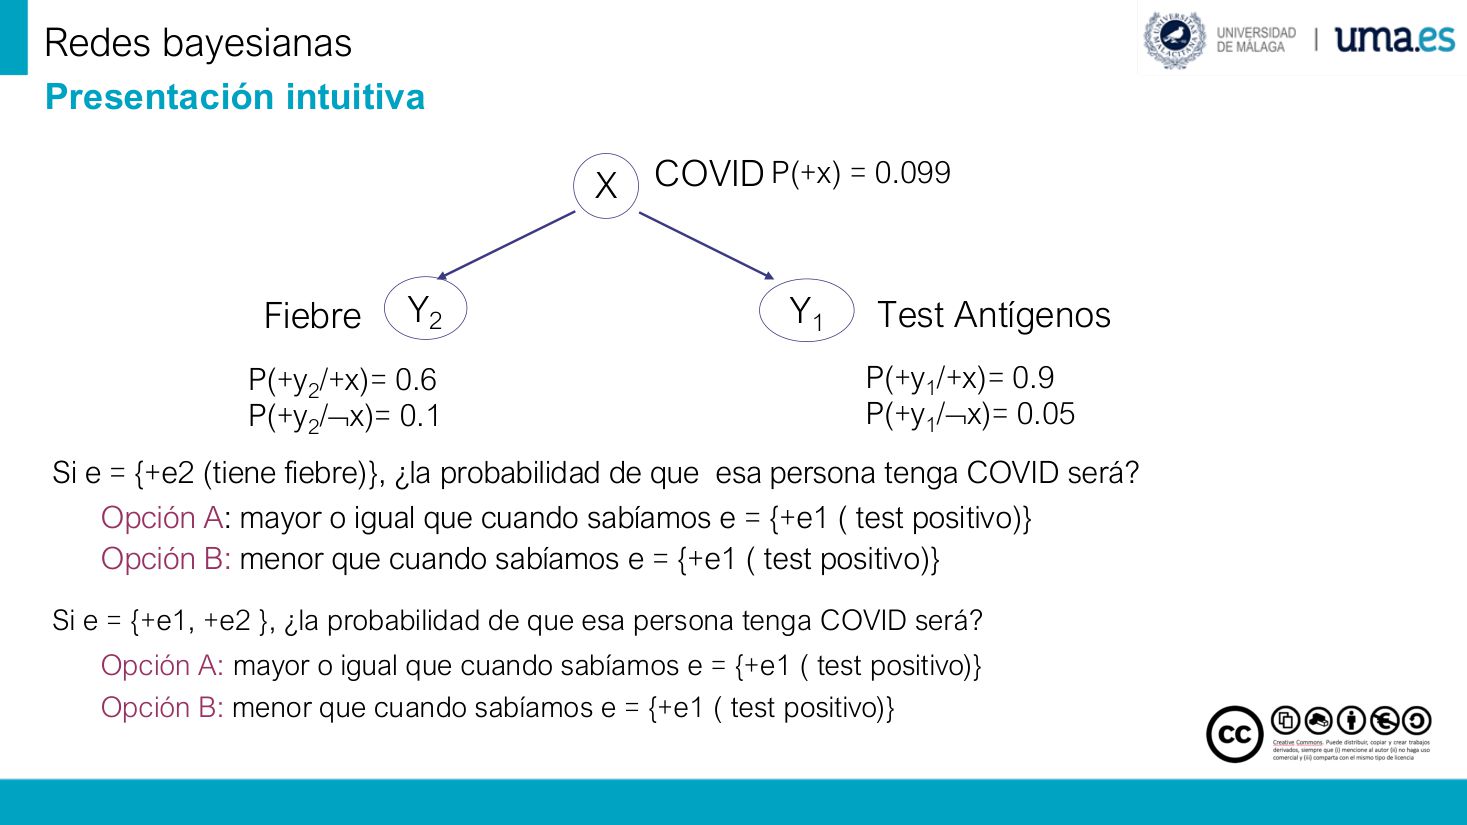
Si e = {+e2 (tiene fiebre)}, ¿la probabilidad de que esa persona tenga COVID será?
若 e = {+e2(发烧)},这个人患新冠的概率会怎样?
Opción A: mayor o igual que cuando sabíamos e = {+e1 ( test positivo)}
选项 A:大于或等于我们已知 e = {+e1(检测阳性)} 的时候。
Opción B: menor que cuando sabíamos e = {+e1 ( test positivo)}
选项 B:小于我们已知 e = {+e1(检测阳性)} 的时候。
Presentación intuitiva
直观介绍(页脚标题)。
Y1
Y1(抗原检测节点)。
X
X(新冠节点)。
P(+x) = 0.099
P(+x) = 0.099(先验)。
P(+y1/+x)= 0.9
P(+y1/+x)= 0.9(灵敏度)。
P(+y1/x)= 0.05
P(+y1/x)= 0.05(图中标注;应为 P(+y1/¬x))。
COVID
新冠(X 的实例名)。
Test Antígenos
抗原检测(Y1 的实例名)。
Y2
Y2(发烧节点,X 的第二个子节点)。
P(+y2/+x)= 0.6
P(+y2/+x)= 0.6(患病时发烧的概率)。
P(+y2/x)= 0.1
P(+y2/x)= 0.1(未患病时发烧的概率;应为 P(+y2/¬x))。
Fiebre
发烧(Y2 的实例名)。
Si e = {+e1, +e2 }, ¿la probabilidad de que esa persona tenga COVID será?
若 e = {+e1, +e2}(检测阳性且发烧),这个人患新冠的概率会怎样?
Opción A: mayor o igual que cuando sabíamos e = {+e1 ( test positivo)}
选项 A:大于或等于我们已知 e = {+e1(检测阳性)} 的时候。
Opción B: menor que cuando sabíamos e = {+e1 ( test positivo)}
选项 B:小于我们已知 e = {+e1(检测阳性)} 的时候。
| 符号 | 西语读法 | 中文含义 |
|---|---|---|
| e | «e» | 证据集合(evidence) |
| +e2 | «más e dos» | 证据 2 成立,即发烧 |
| P(+y2/+x) | «probabilidad de más ye dos dado más equis» | 患病时发烧的概率(似然) |
| P(+y2/¬x) | «dado no equis» | 未患病时发烧的概率(假警报) |
Inferencias: e = {+y2} · 只有发烧证据时的后验
▸ 原页截图 p.18
Redes bayesianas
贝叶斯网络(页眉)。
Inferencias
推断(本节标题)。
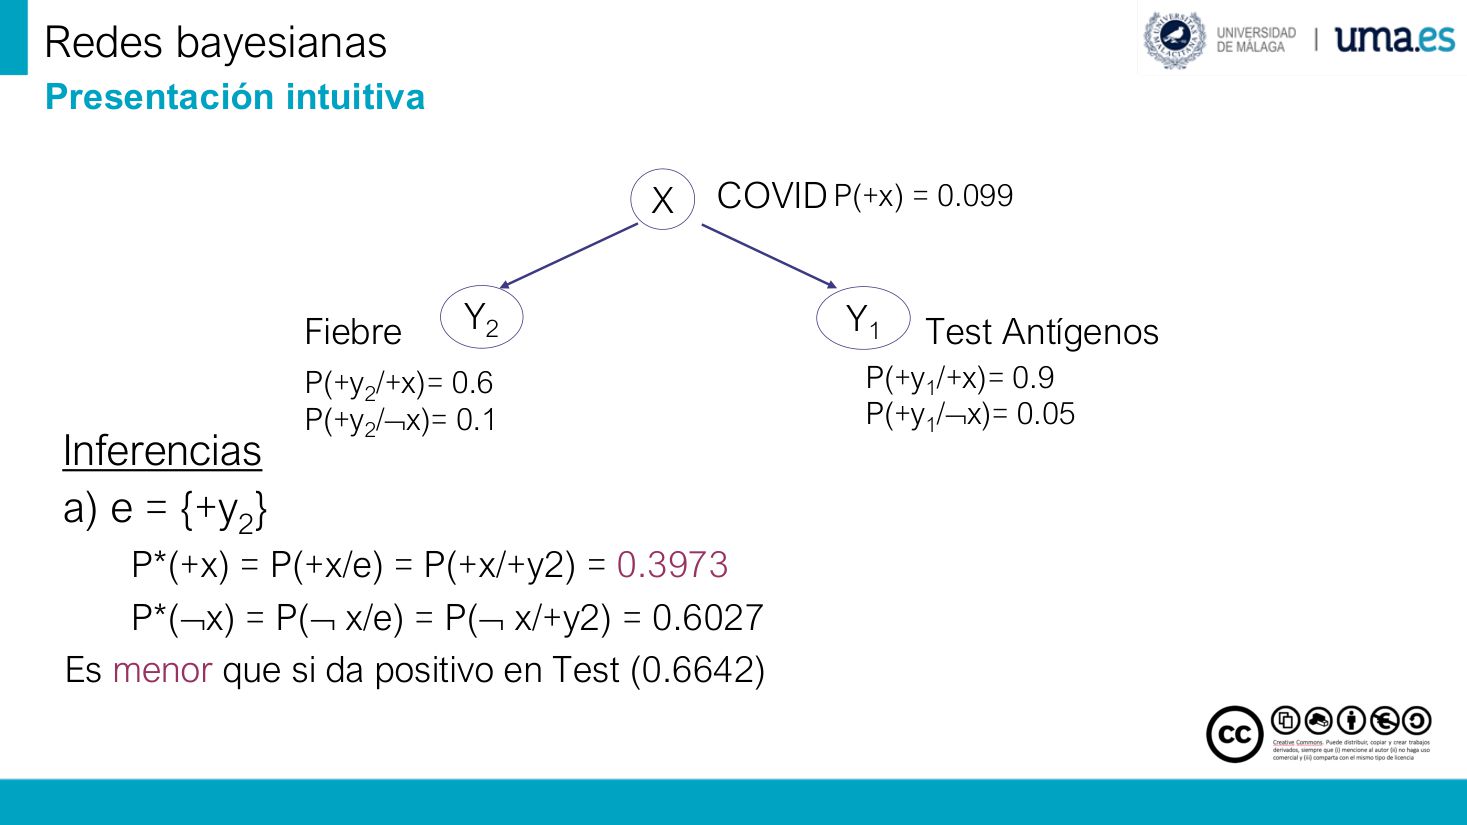
a) e = {+y2}
a) e = {+y2}(只观测到发烧)。
P*(+x) = P(+x/e) = P(+x/+y2) = 0.3973
P*(+x) = P(+x/e) = P(+x/+y2) = 0.3973(发烧后患病概率约 39.7%)。
P*(x) = P(x/e) = P(x/+y2) = 0.6027
P*(¬x) = P(¬x/e) = P(¬x/+y2) = 0.6027(未患病概率约 60.3%)。
Es menor que si da positivo en Test (0.6642)
它比检测呈阳性时(0.6642)更小。
Presentación intuitiva
直观介绍(页脚标题)。
X
X(新冠节点)。
Y1
Y1(抗原检测节点)。
P(+x) = 0.099
P(+x) = 0.099(先验)。
COVID
新冠(X 的实例名)。
Test Antígenos
抗原检测(Y1 的实例名)。
Y2
Y2(发烧节点)。
P(+y2/+x)= 0.6
P(+y2/+x)= 0.6(患病时发烧)。
P(+y2/x)= 0.1
P(+y2/x)= 0.1(未患病时发烧;应为 P(+y2/¬x))。
Fiebre
发烧(Y2 的实例名)。
P(+y1/+x)= 0.9
P(+y1/+x)= 0.9(灵敏度)。
P(+y1/x)= 0.05
P(+y1/x)= 0.05(图中标注;应为 P(+y1/¬x))。
| 符号 | 西语读法 | 中文含义 |
|---|---|---|
| P*(+x) | «pe asterisco de más equis» | 观测证据后的后验概率 |
| P(+x/+y2) | «dado más ye dos» | 「发烧」条件下的患病概率 |
| P(+y2) | «probabilidad de más ye dos» | 发烧的边缘概率(分母,归一化) |
| 0.3973 = 1 − 0.6027 | «cero coma tres nueve siete tres» | 患病与未患病互补,和为 1 |
Inferencias: e = {+y1, +y2} · 两条证据同时观测
▸ 原页截图 p.19
Redes bayesianas
贝叶斯网络(页眉)。
Inferencias
推断(本节标题)。
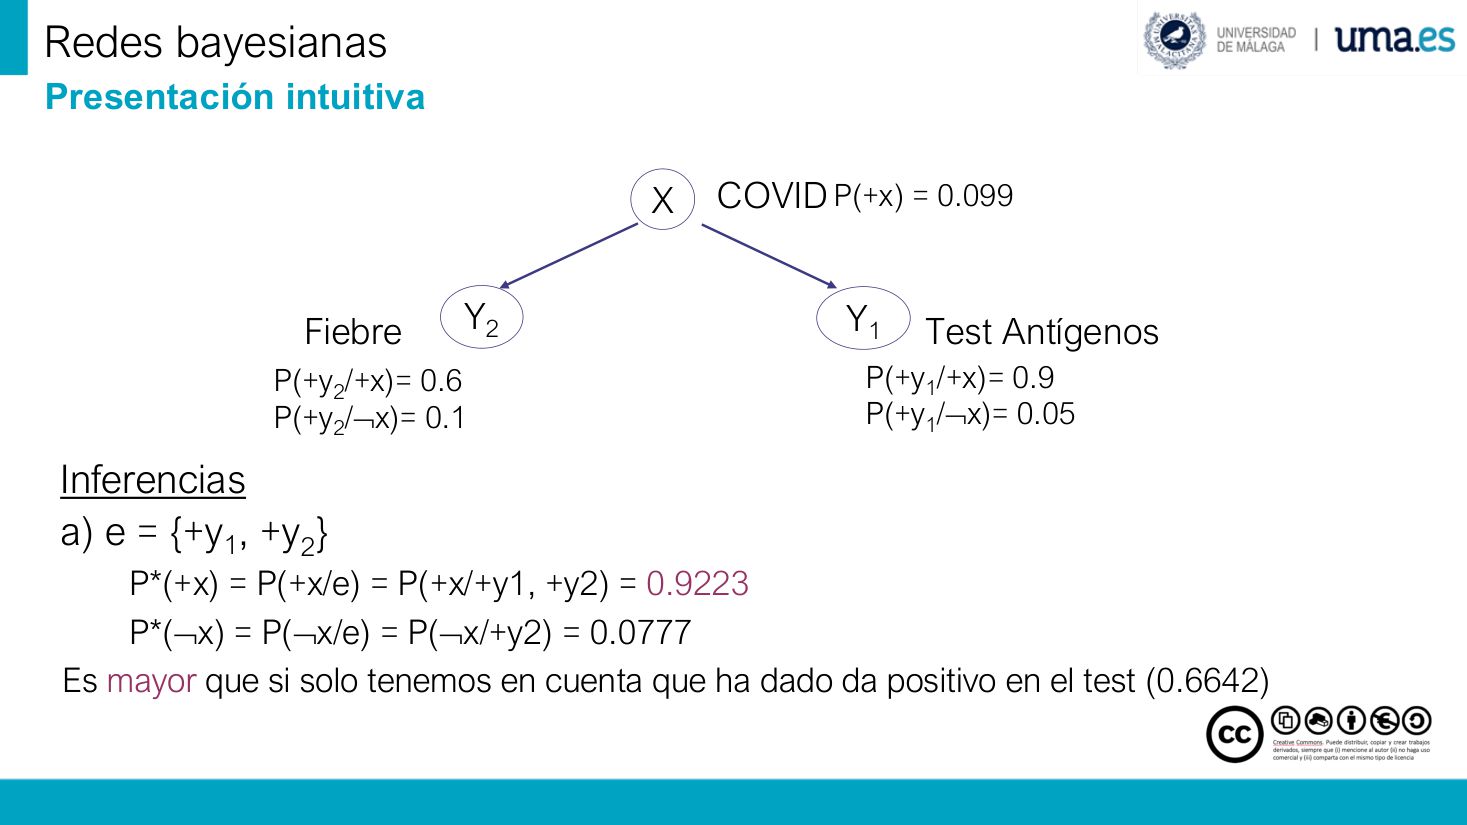
a) e = {+y1, +y2}
a) e = {+y1, +y2}(阳性且发烧,两条证据同时观测)。
P*(+x) = P(+x/e) = P(+x/+y1, +y2) = 0.9223
P*(+x) = P(+x/e) = P(+x/+y1, +y2) = 0.9223(两条证据后患病概率约 92.2%)。
P*(x) = P(x/e) = P(x/+y2) = 0.0777
P*(¬x) = P(¬x/e) = P(¬x/+y1, +y2) = 0.0777(未患病概率约 7.8%)。
Es mayor que si solo tenemos en cuenta que ha dado da positivo en el test (0.6642)
它比只考虑检测呈阳性(0.6642)时更大。
Presentación intuitiva
直观介绍(页脚标题)。
X
X(新冠节点)。
Y1
Y1(抗原检测节点)。
P(+x) = 0.099
P(+x) = 0.099(先验)。
COVID
新冠(X 的实例名)。
Test Antígenos
抗原检测(Y1 的实例名)。
Y2
Y2(发烧节点)。
P(+y2/+x)= 0.6
P(+y2/+x)= 0.6(患病时发烧)。
P(+y2/x)= 0.1
P(+y2/x)= 0.1(未患病时发烧;应为 P(+y2/¬x))。
Fiebre
发烧(Y2 的实例名)。
P(+y1/+x)= 0.9
P(+y1/+x)= 0.9(灵敏度)。
P(+y1/x)= 0.05
P(+y1/x)= 0.05(图中标注;应为 P(+y1/¬x))。
| 符号 | 西语读法 | 中文含义 |
|---|---|---|
| P(+x/+y1, +y2) | «dado más ye uno y más ye dos» | 两条证据同时成立时的后验 |
| P(+y1/+x)·P(+y2/+x) | «producto de las verosimilitudes» | 在给定 X 下两条证据条件独立,可直接相乘 |
| 0.9223 | «cero coma nueve dos dos tres» | 后验概率;与 0.0777 互补 |
| / | «dado» | 条件;逗号分隔同一条件里的多条证据 |
Inferencias: predecir el test desde la fiebre · 由发烧反推检测阳性
▸ 原页截图 p.20
Redes bayesianas
贝叶斯网络(页眉)。
Inferencias
推断(本节标题)。
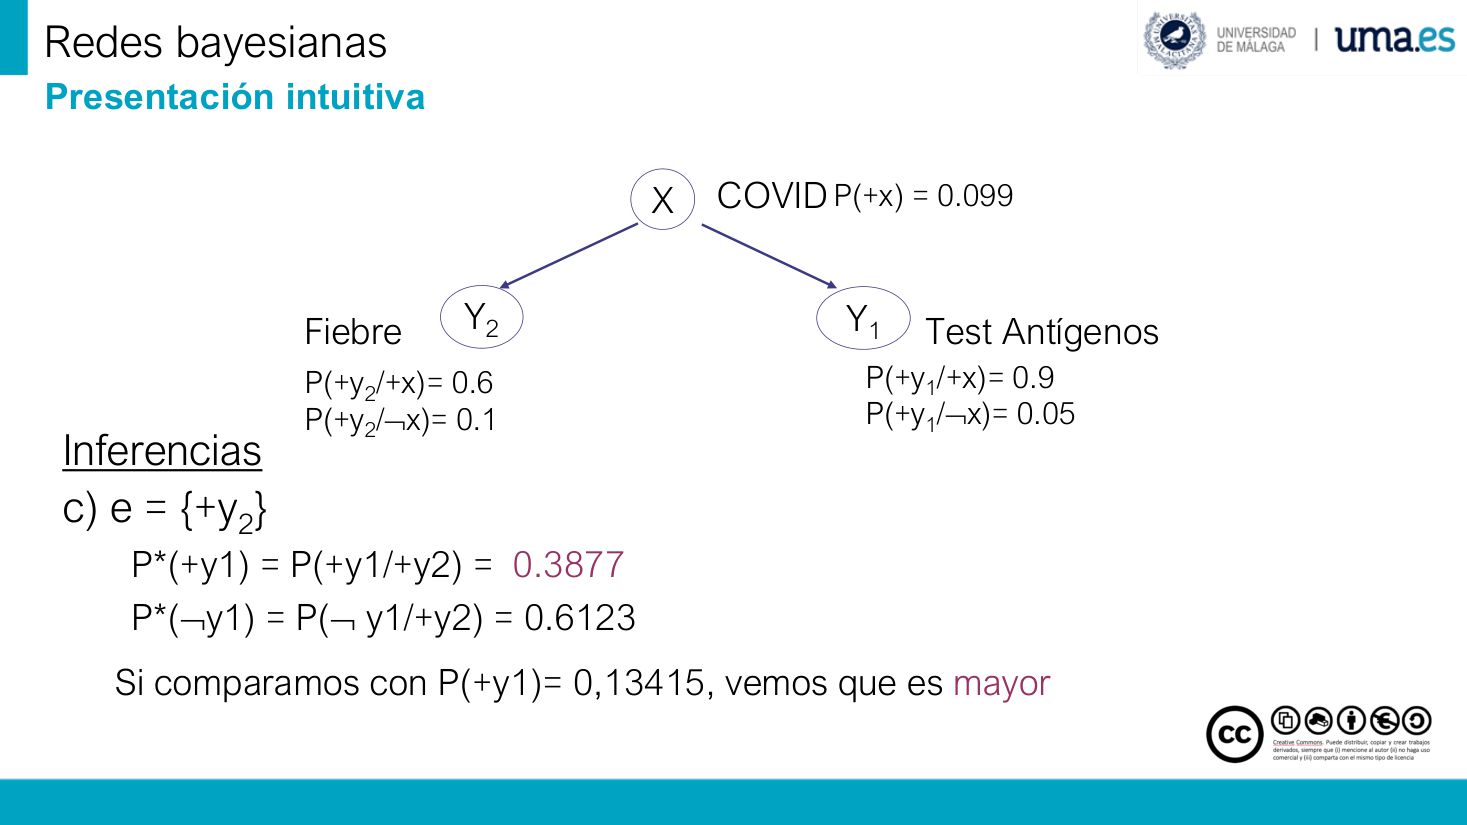
c) e = {+y2}
c) e = {+y2}(只观测到发烧,这次要预测检测结果)。
P*(+y1) = P(+y1/+y2) = 0.3877
P*(+y1) = P(+y1/+y2) = 0.3877(发烧时检测阳性的概率约 38.8%)。
P*(y1) = P(y1/+y2) = 0.6123
P*(¬y1) = P(¬y1/+y2) = 0.6123(发烧时检测阴性的概率约 61.2%)。
Presentación intuitiva
直观介绍(页脚标题)。
X
X(新冠节点)。
Y1
Y1(抗原检测节点)。
P(+x) = 0.099
P(+x) = 0.099(先验)。
COVID
新冠(X 的实例名)。
Test Antígenos
抗原检测(Y1 的实例名)。
Y2
Y2(发烧节点)。
P(+y2/+x)= 0.6
P(+y2/+x)= 0.6(患病时发烧)。
P(+y2/x)= 0.1
P(+y2/x)= 0.1(未患病时发烧;应为 P(+y2/¬x))。
Fiebre
发烧(Y2 的实例名)。
P(+y1/+x)= 0.9
P(+y1/+x)= 0.9(灵敏度)。
P(+y1/x)= 0.05
P(+y1/x)= 0.05(图中标注;应为 P(+y1/¬x))。
Si comparamos con P(+y1)= 0,13415, vemos que es mayor
与 P(+y1)= 0.13415 相比,可以看出它更大。
| 符号 | 西语读法 | 中文含义 |
|---|---|---|
| P*(+y1) | «pe asterisco de más ye uno» | 由证据推出来的、对 Y1 的新概率 |
| P(+y1/+y2) | «probabilidad de más ye uno dado más ye dos» | 发烧条件下检测阳性的概率 |
| P(+y1)= 0,13415 | «cero coma trece cuatro uno cinco» | 没有证据时的阳性先验(p.15 算过) |
| 0.3877 | «cero coma tres ocho siete siete» | 发烧把阳性率从 13.4% 抬到 38.8% |
Tipos de inferencia · 推断的两大类型
▸ 原页截图 p.21
Redes bayesianas
贝叶斯网络(页眉)。
Las redes bayesianas permiten hacer
贝叶斯网络允许做
•
项目符号(原文单独一个圆点,排版残留)。
•
项目符号(原文单独一个圆点,排版残留)。
Presentación intuitiva
直观介绍(页脚标题)。
五、形式定义:命题变量、无环有向图与条件独立
p.22–p.28Definición formal · 贝叶斯网络的形式定义
▸ 原页截图 p.22
Redes bayesianas
贝叶斯网络(页眉)。
Una red bayesiana es:
一个贝叶斯网络是:
• Un conjunto de
一个
• Un conjunto de
一个定义在 V 的变量之上的
• Una
一个定义在 V 的变量之上的
tales que:
使得:
• (V, E) forman un
(V, E) 构成一个
• (G, P) cumplen las
(G, P) 满足
Definición formal
形式定义(页脚标题)。
| 符号 | 西语读法 | 中文含义 |
|---|---|---|
| V | «uve» / «conjunto de variables» | 节点(命题变量)集合 |
| E | «e» / «conjunto de enlaces» | 边(二元关系 / 弧)集合 |
| P | «pe» | 联合概率分布 |
| G = (V, E) | «grafo uve e» | 由节点与边构成的有向图 |
| acíclico | «acíclico» | 无环:沿箭头走不回起点 |
| conexo | «conexo» | 连通:任意两节点间有路 |
Variables proposicionales · 命题变量与穷尽互斥
▸ 原页截图 p.23
Redes bayesianas
贝叶斯网络(页眉)。
Una
一个
¿Son los siguientes conjuntos exhaustivos y excluyentes?
下面这些集合是否既穷尽又互斥?
ColorFavorito={Rojo,Blanco,Verde}
ColorFavorito={Rojo,Blanco,Verde}(最喜欢的颜色 = {红、白、绿})。
EstadoImpresora={Encendida, Enchufada}
EstadoImpresora={Encendida, Enchufada}(打印机状态 = {开机、插电})。
EstadoImpresora={Encendida, Apagada}
EstadoImpresora={Encendida, Apagada}(打印机状态 = {开机、关机})。
¿Cuáles de las siguientes variables son variables proposicionales?
下面哪些变量是命题变量?
OPCIÓN A: Mascota = {Perro, Gato}
选项 A:Mascota = {Perro, Gato}(宠物 = {狗、猫})。
OPCIÓN B: Enfermedad = {Gripe, Hepatitis, Apendicitis}
选项 B:Enfermedad = {Gripe, Hepatitis, Apendicitis}(疾病 = {流感、肝炎、阑尾炎})。
OPCIÓN C: LenguajeProgramación = {Python, Java, C++}
选项 C:LenguajeProgramación = {Python, Java, C++}(编程语言 = {Python、Java、C++})。
OPCIÓN D: Ventilador = {Encendido, Apagado}
选项 D:Ventilador = {Encendido, Apagado}(风扇 = {开、关})。
OPCIÓN E: Calificación = {NoPresentado, Suspenso, Aprobado, Notable, Sobresaliente}
选项 E:Calificación = {NoPresentado, Suspenso, Aprobado, Notable, Sobresaliente}(成绩 = {缺考、不及格、及格、良好、优秀})。
¿Se te ocurren situaciones en las que las opciones A, B , C y E puedan corresponder a variables proposicionales?
你能想到哪些情境,使选项 A、B、C、E 也可以成为命题变量?
Definición formal: variables proposicionales
形式定义:命题变量(页脚标题)。
¿Qué grafos pueden ser una red bayesiana? · 哪些图能当贝叶斯网络
▸ 原页截图 p.24
Redes bayesianas
贝叶斯网络(页眉)。
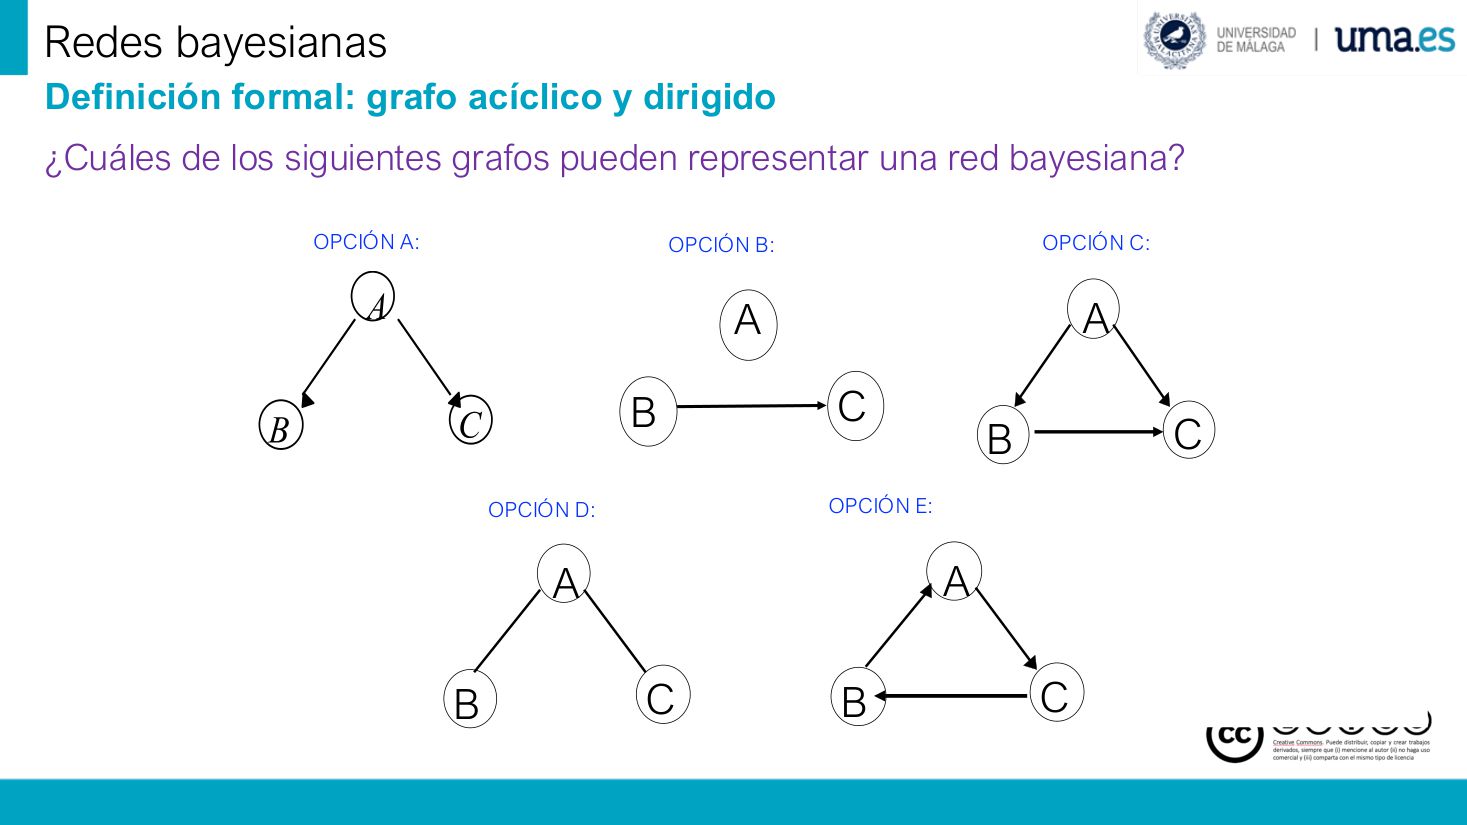
¿Cuáles de los siguientes grafos pueden representar una red bayesiana?
下面哪些图可以表示一个贝叶斯网络?
Definición formal: grafo acíclico y dirigido
形式定义:有向无环图(页脚标题)。
OPCIÓN A:
选项 A(图中 A 在上,箭头 A→B、A→C)。
A · B · C
三个节点 A、B、C(原文三行单字母标签,按图示合并)。
OPCIÓN B:
选项 B(图中 A 孤立,B→C)。
A · B · C
三个节点 A、B、C。
OPCIÓN C:
选项 C(A→B、A→C、B→C,形成三角形但无环)。
A · B · C
三个节点 A、B、C。
OPCIÓN D:
选项 D(A 与 B、C 之间是无箭头连线)。
A · B · C
三个节点 A、B、C。
OPCIÓN E:
选项 E(A、B、C 组成一个有向环)。
A · B · C
三个节点 A、B、C。
| 选项 | 西语读法 | 判定与理由 |
|---|---|---|
| A | «opción a» | 合格:有向、连通、无环(A→B, A→C) |
| B | «opción be» | 不合格:不连通(A 孤立) |
| C | «opción ce» | 合格:有向、连通、无环(A→B→C 且 A→C) |
| D | «opción de» | 不合格:边无方向,不是有向图 |
| E | «opción e» | 不合格:存在有向环(acyclic 被破坏) |
Independencia condicional / separación direccional · 条件独立与方向分离
▸ 原页截图 p.25
Redes bayesianas
贝叶斯网络(页眉)。
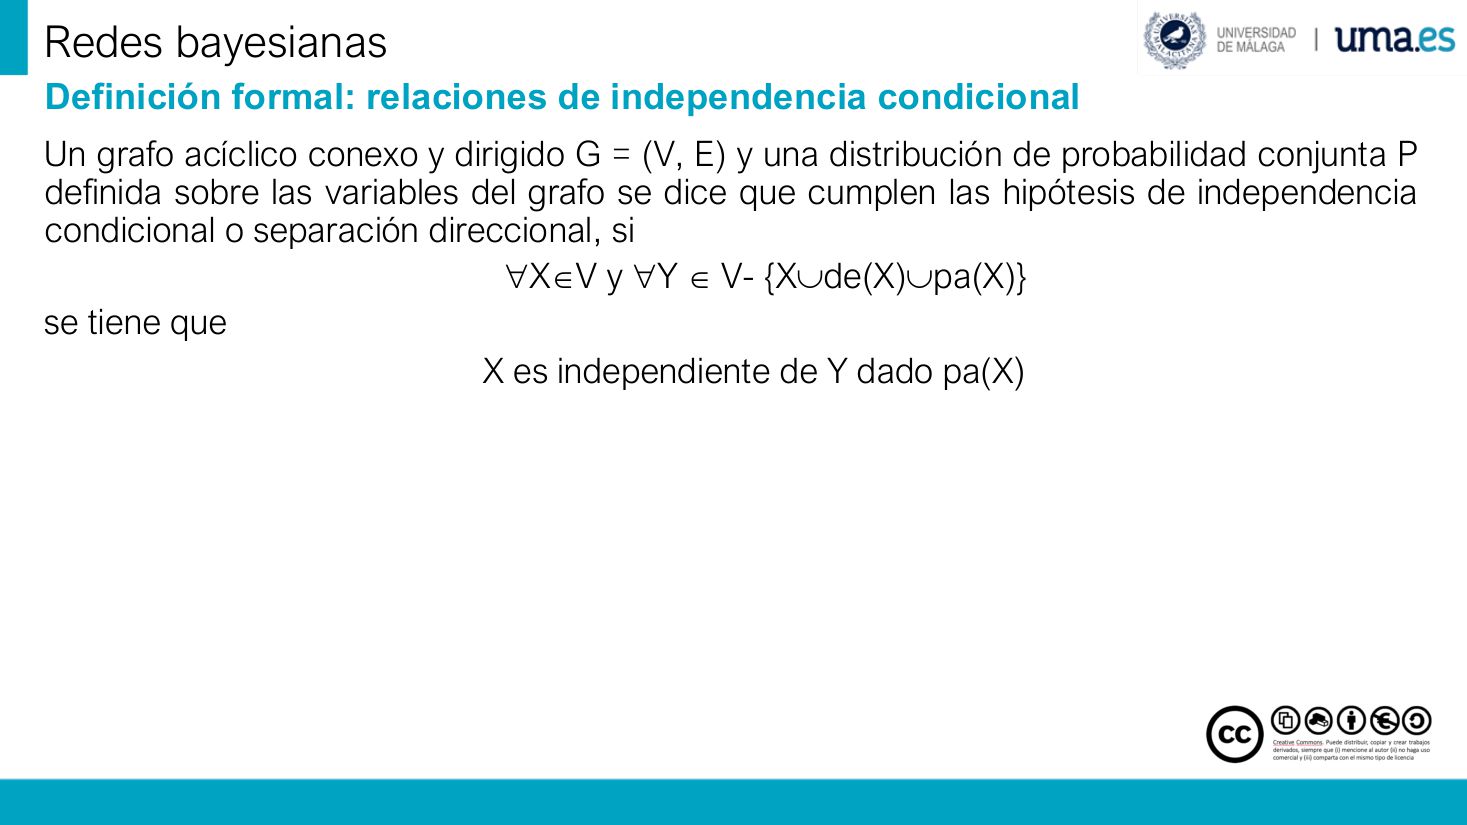
Un grafo acíclico conexo y dirigido G = (V, E) y una distribución de probabilidad conjunta P definida sobre las variables del grafo se dice que cumplen las
一个无环、连通、有向图 G = (V, E) 与定义在该图变量上的联合概率分布 P,若满足
X V y Y V- {Xde(X)pa(X)}
X∈V 且 Y∈V−({X}∪de(X)∪pa(X))(原文 PDF 抽取时丢失了 ∈、∪ 等符号,只剩字母;见下方勘误)。
se tiene que
都有:
X es independiente de Y dado pa(X)
X 在给定 pa(X) 的条件下独立于 Y(pa(X) = X 的父节点集合)。
Definición formal: relaciones de independencia condicional
形式定义:条件独立关系(页脚标题)。
| 符号 | 西语读法 | 中文含义 |
|---|---|---|
| V | «uve» | 全部变量的集合 |
| de(X) | «descendientes de equis» | X 的后代节点集合 |
| pa(X) | «padres de equis» | X 的父节点集合 |
| X ⊥ Y | pa(X) | «equis independiente de ye dado padres de equis» | 给定父节点后,X 与 Y 条件独立 |
| − | «menos» | 集合差:从 V 里去掉 X、后代、父节点 |
| ∪ | «unión» | 并集 |
Comprobar si la red es bayesiana · 检验这张网是否满足独立性
▸ 原页截图 p.26
Redes bayesianas
贝叶斯网络(页眉)。
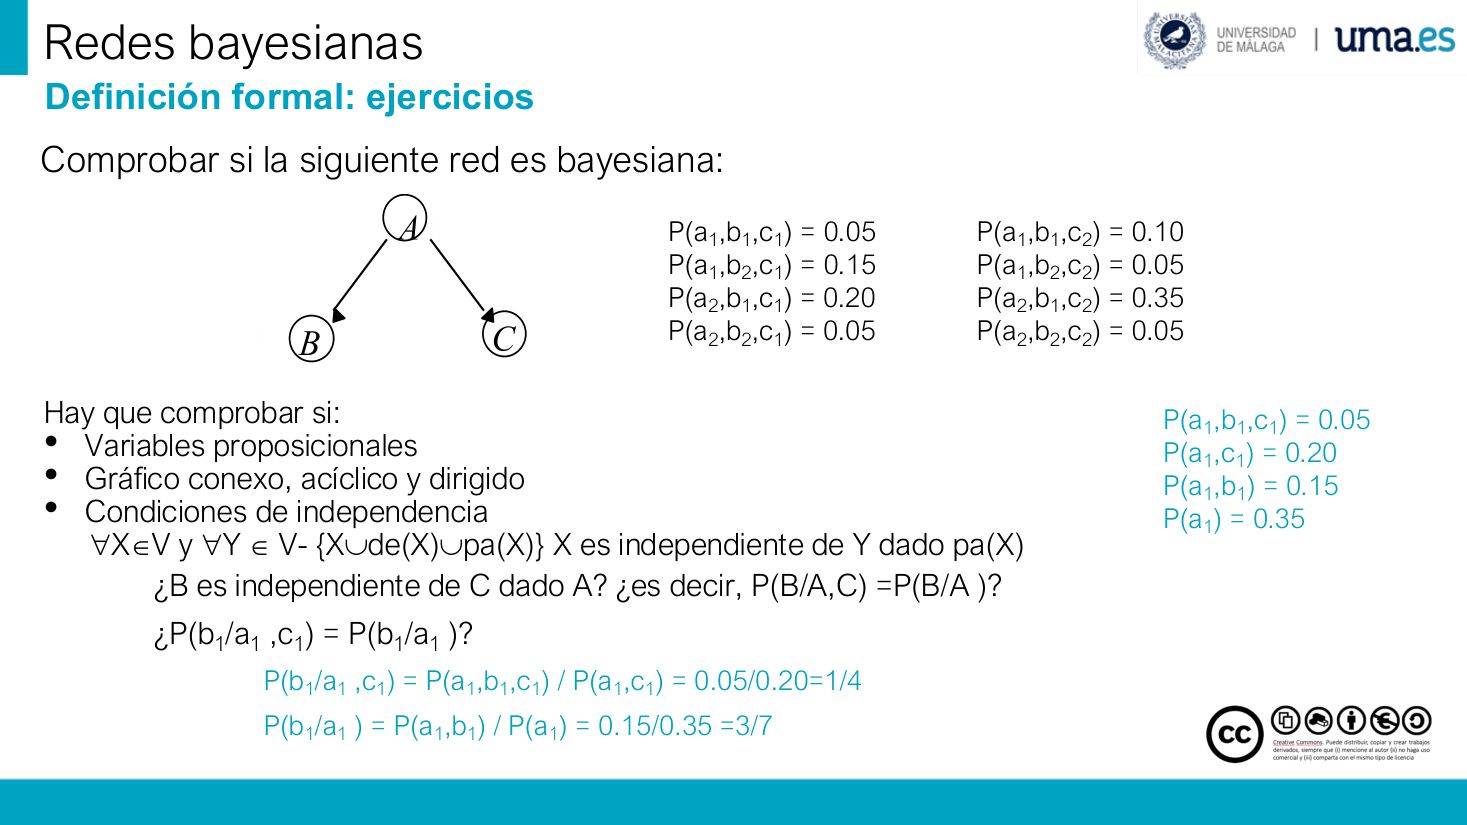
Hay que comprobar si:
需要检查:
• Variables proposicionales
命题变量(见 p.23)。
• Gráfico conexo, acíclico y dirigido
图是连通、无环、有向的。
• Condiciones de independencia
条件独立条件。
X V y Y V- {Xde(X)pa(X)} X es independiente de Y dado pa(X)
∀X∈V、∀Y∈V−({X}∪de(X)∪pa(X)):X 在给定 pa(X) 时独立于 Y(原文同样丢了符号,见 p.25 勘误)。
¿B es independiente de C dado A? ¿es decir, P(B/A,C) =P(B/A )?
B 在给定 A 时独立于 C 吗?也就是说,P(B/A,C) = P(B/A) 成立吗?
¿P(b1/a1 ,c1) = P(b1/a1 )?
具体检验:P(b1/a1,c1) = P(b1/a1) 吗?
P(b1/a1 ,c1) = P(a1,b1,c1) / P(a1,c1) = 0.05/0.20=1/4
P(b1/a1,c1) = P(a1,b1,c1) / P(a1,c1) = 0.05/0.20 = 1/4 = 0.25。
P(b1/a1 ) = P(a1,b1) / P(a1) = 0.15/0.35 =3/7
P(b1/a1) = P(a1,b1) / P(a1) = 0.15/0.35 = 3/7 ≈ 0.4286。
Definición formal: ejercicios
形式定义:练习(页脚标题)。
A · B · C
图上三个节点 A、B、C(结构:A→B,A→C)。
P(a1,b1,c1) = 0.05
P(a1,b1,c1) = 0.05(联合分布第一项)。
P(a1,b1,c2) = 0.10
P(a1,b1,c2) = 0.10。
P(a1,b2,c1) = 0.15
P(a1,b2,c1) = 0.15。
P(a1,b2,c2) = 0.05
P(a1,b2,c2) = 0.05。
P(a2,b1,c1) = 0.20
P(a2,b1,c1) = 0.20。
P(a2,b1,c2) = 0.35
P(a2,b1,c2) = 0.35。
P(a2,b2,c1) = 0.05
P(a2,b2,c1) = 0.05。
P(a2,b2,c2) = 0.05
P(a2,b2,c2) = 0.05。
P(a1,c1) = 0.20
P(a1,c1) = 0.20(由 0.05 + 0.15 边缘化 B 得到)。
P(a1,b1) = 0.15
P(a1,b1) = 0.15(由 0.05 + 0.10 边缘化 C 得到)。
P(a1) = 0.35
P(a1) = 0.35(a1 那一行四个格子之和)。
Comprobar si la siguiente red es bayesiana:
检验下面这个网络是否为贝叶斯网络:
| 计算 | 西语读法 | 结果 |
|---|---|---|
| P(b1/a1,c1) | «pe de be uno dado a uno y ce uno» | 0.05 / 0.20 = 0.25 = 1/4 |
| P(b1/a1) | «pe de be uno dado a uno» | 0.15 / 0.35 ≈ 0.4286 = 3/7 |
| 1/4 ≠ 3/7 | «no son iguales» | 不满足 P(B/A,C)=P(B/A) |
Ejercicio 1 · 练习 1:检验 A→B、A→C 的独立性
▸ 原页截图 p.27
Redes bayesianas
贝叶斯网络(页眉)。
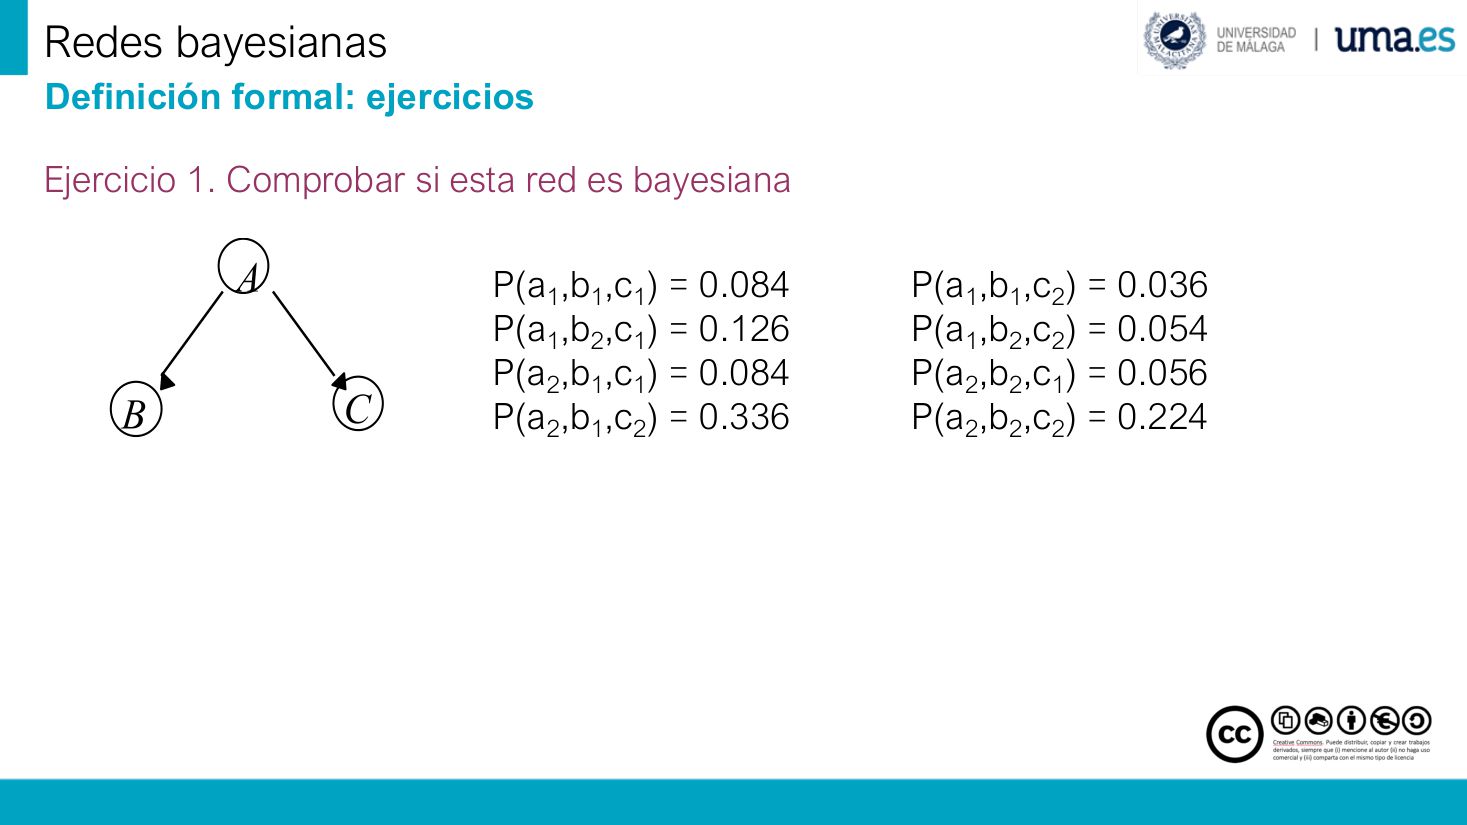
Ejercicio 1. Comprobar si esta red es bayesiana
练习 1:检验这个网络是不是贝叶斯网络。
Definición formal: ejercicios
形式定义:练习(页脚标题)。
A · B · C
图上三个节点 A、B、C(结构:A→B,A→C)。
P(a1,b1,c1) = 0.084
P(a1,b1,c1) = 0.084。
P(a1,b1,c2) = 0.036
P(a1,b1,c2) = 0.036。
P(a1,b2,c1) = 0.126
P(a1,b2,c1) = 0.126。
P(a1,b2,c2) = 0.054
P(a1,b2,c2) = 0.054。
P(a2,b1,c1) = 0.084
P(a2,b1,c1) = 0.084。
P(a2,b2,c1) = 0.056
P(a2,b2,c1) = 0.056。
P(a2,b1,c2) = 0.336
P(a2,b1,c2) = 0.336。
P(a2,b2,c2) = 0.224
P(a2,b2,c2) = 0.224。
| 边缘 / 条件 | 计算 | 结果 |
|---|---|---|
| P(a1) | 0.084+0.036+0.126+0.054 | 0.30 |
| P(a1,b1) | 0.084+0.036 | 0.12 → P(b1/a1)=0.4 |
| P(a1,c1) | 0.084+0.126 | 0.21 → P(b1/a1,c1)=0.084/0.21=0.4 |
| P(a1,c2) | 0.036+0.054 | 0.09 → 0.036/0.09=0.4 |
| P(a2) | 0.084+0.056+0.336+0.224 | 0.70 → P(b1/a2)=0.6 |
| P(a2,c1) | 0.084+0.056 | 0.14 → 0.084/0.14=0.6 |
| P(a2,c2) | 0.336+0.224 | 0.56 → 0.336/0.56=0.6 |
Ejercicio 2 · 练习 2:这张网隐含哪些独立性
▸ 原页截图 p.28
Redes bayesianas
贝叶斯网络(页眉)。
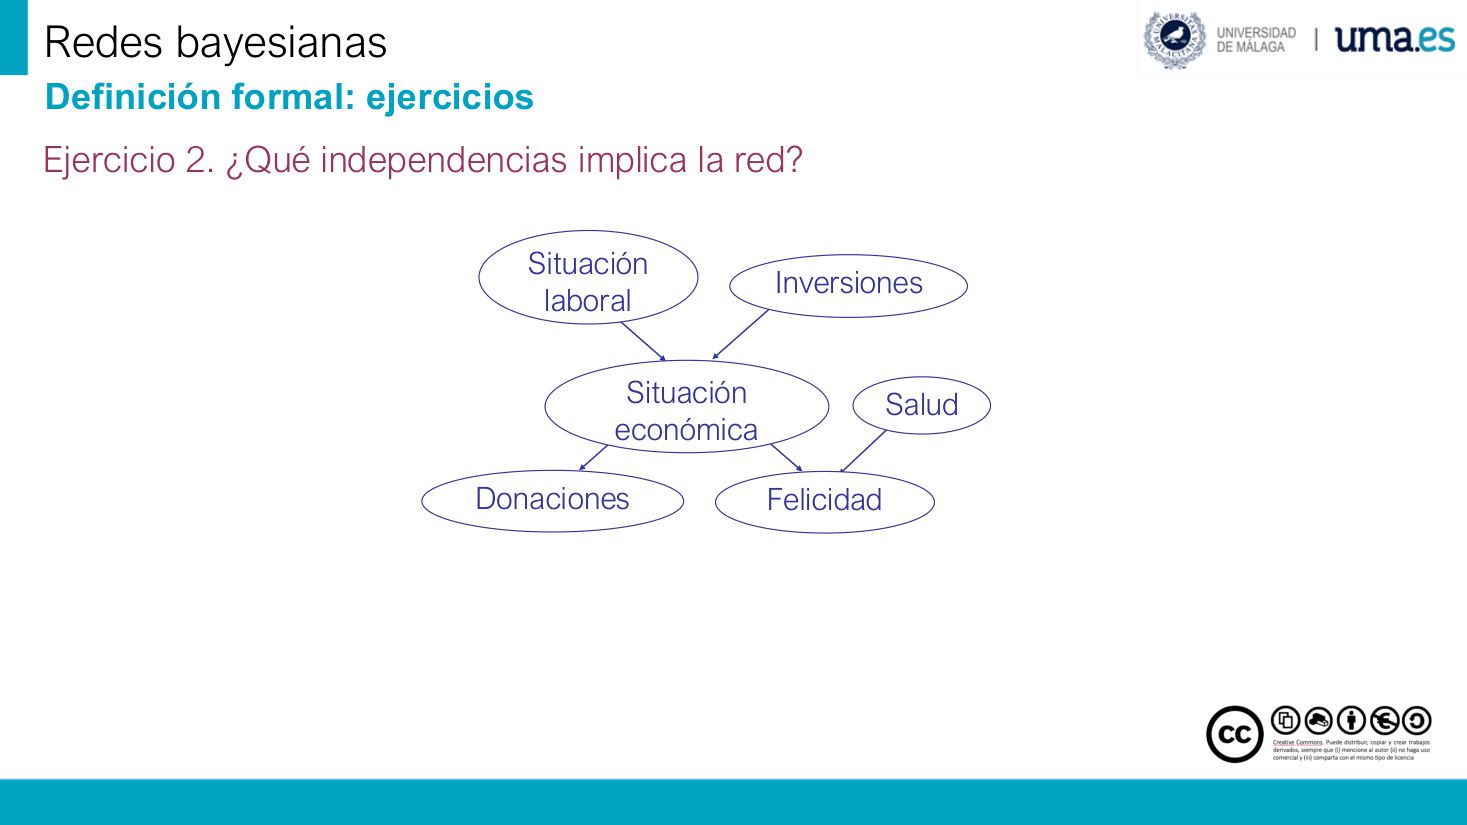
Ejercicio 2. ¿Qué independencias implica la red?
练习 2:这张网络隐含了哪些独立性?
Definición formal: ejercicios
形式定义:练习(页脚标题)。
Situación laboral
工作状况(根节点之一)。
Inversiones
投资(根节点之一)。
Situación económica
经济状况(工作状况与投资的共同子节点)。
Salud
健康(根节点)。
Felicidad
幸福感(经济状况与健康的共同子节点)。
Donaciones
捐款(经济状况的子节点)。
| 独立性 | 西语读法 | 理由 |
|---|---|---|
| Lab ⊥ Inv | «laboral independiente de inversiones» | 两个根节点之间无路径 |
| Salud ⊥ {Lab, Inv} | «salud independiente de laboral e inversiones» | 健康与它们无路径相连 |
| Don ⊥ Fel | Econ | «donaciones independiente de felicidad dado economía» | 共同父节点 Econ 被固定,fork 被阻断 |
| Lab ⊥ Fel | Econ | «laboral independiente de felicidad dado economía» | 路径 Lab→Econ→Fel 被 Econ 阻断 |
| Fel ⊥ {Inv, Lab, Don} | {Econ, Salud} | «felicidad independiente dado economía y salud» | 给定两个父节点后,Felicidad 与其非后代独立 |
六、独立性练习:Asia 网络、三节点结构与基本定理
p.29–p.33Ejercicio 3. ¿Qué independencias implica la red Asia? · 练习 3:Asia 网络隐含哪些独立性
▸ 原页截图 p.29
Redes bayesianas
贝叶斯网络(页眉)。
Definición formal: ejercicios
形式定义:练习(页脚标题)。
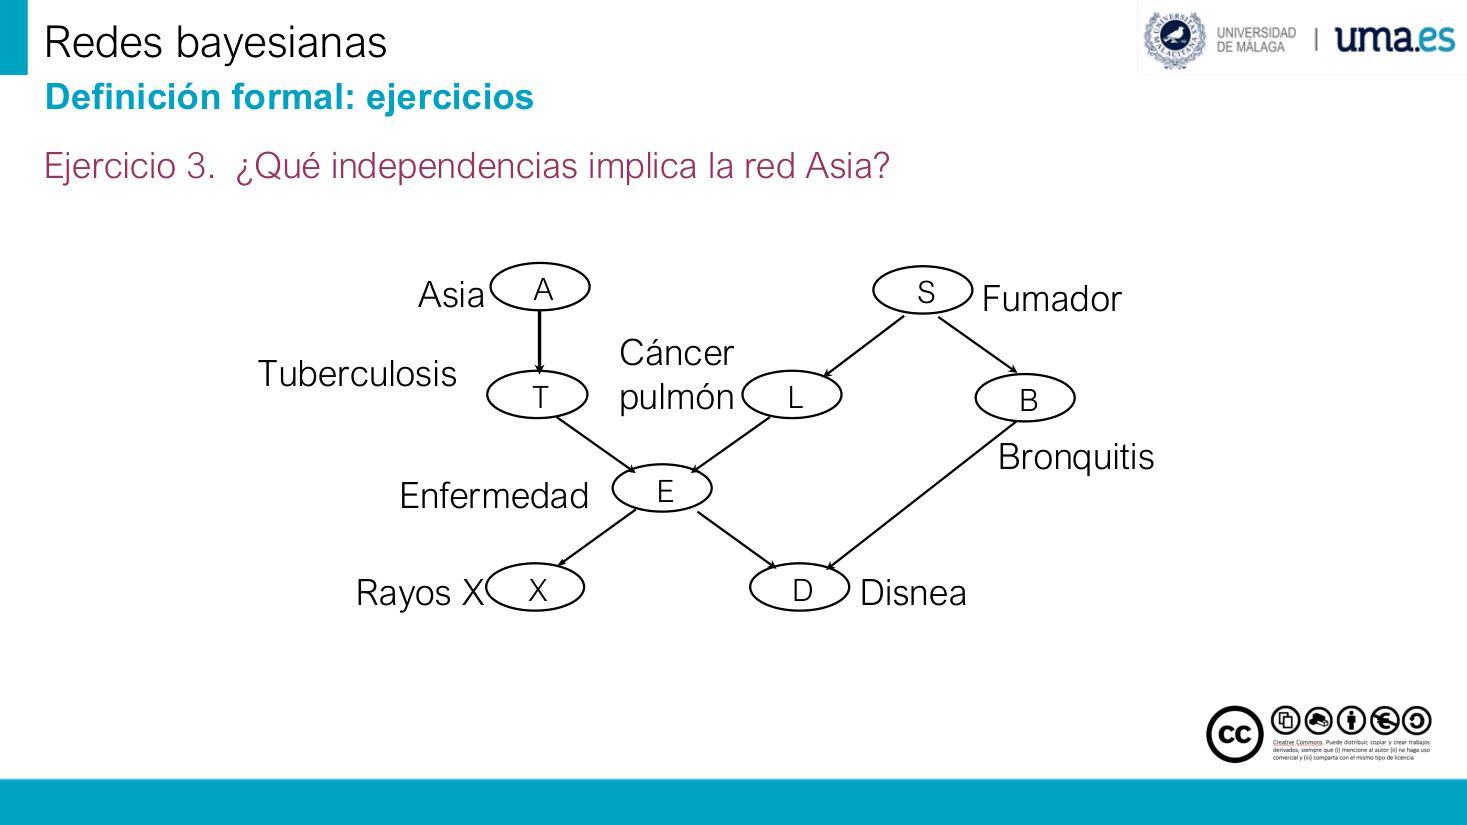
Ejercicio 3. ¿Qué independencias implica la red Asia?
练习 3:
Asia
亚洲(根节点 A:是否去过亚洲)。
Tuberculosis
结核病(T)。
Fumador
吸烟者(S)。
Cáncer pulmón
肺癌(L)。
Bronquitis
支气管炎(B)。
Enfermedad
(是否患)病(E)。
Rayos X
X 光片(X)。
Disnea
呼吸困难(D)。
| 独立性 | 西语读法 | 判定理由 |
|---|---|---|
| Asia ⊥ Fumador | «Asia independiente de fumador» | 两根节点之间没有任何路径 |
| Tuberculosis ⊥ Cáncer pulmón | «tuberculosis independiente de cáncer de pulmón» | T→E←L 是 |
| Rayos X ⊥ Disnea | «rayos equis independiente de disnea» | X←E→D 是 fork,E 未给定 → 阻断 |
| Rayos X ⊥ Disnea | Enfermedad | «rayos equis independiente de disnea dado enfermedad» | 同一条链在 E 处被固定 → 阻断 |
| Bronquitis ⊥ Tuberculosis | «bronquitis independiente de tuberculosis» | B←S→L→E←T,在 E 处撞上 collider |
| Asia ⊥ Disnea | Tuberculosis | «Asia independiente de disnea dada tuberculosis» | 给定 T 后,链 A→T→E→D 在 T 处断开 |
| Fumador ⊥ Tuberculosis | Enfermedad | «fumador independiente de tuberculosis dado enfermedad» | 不成立:E 是 collider,给定后反而把 S 与 T 联系起来( |
Ejercicio 4: estructuras de tres nodos · 练习 4:三节点网络的三种结构
▸ 原页截图 p.30
Redes bayesianas
贝叶斯网络(页眉)。
Definición formal: ejercicios
形式定义:练习(页脚标题)。
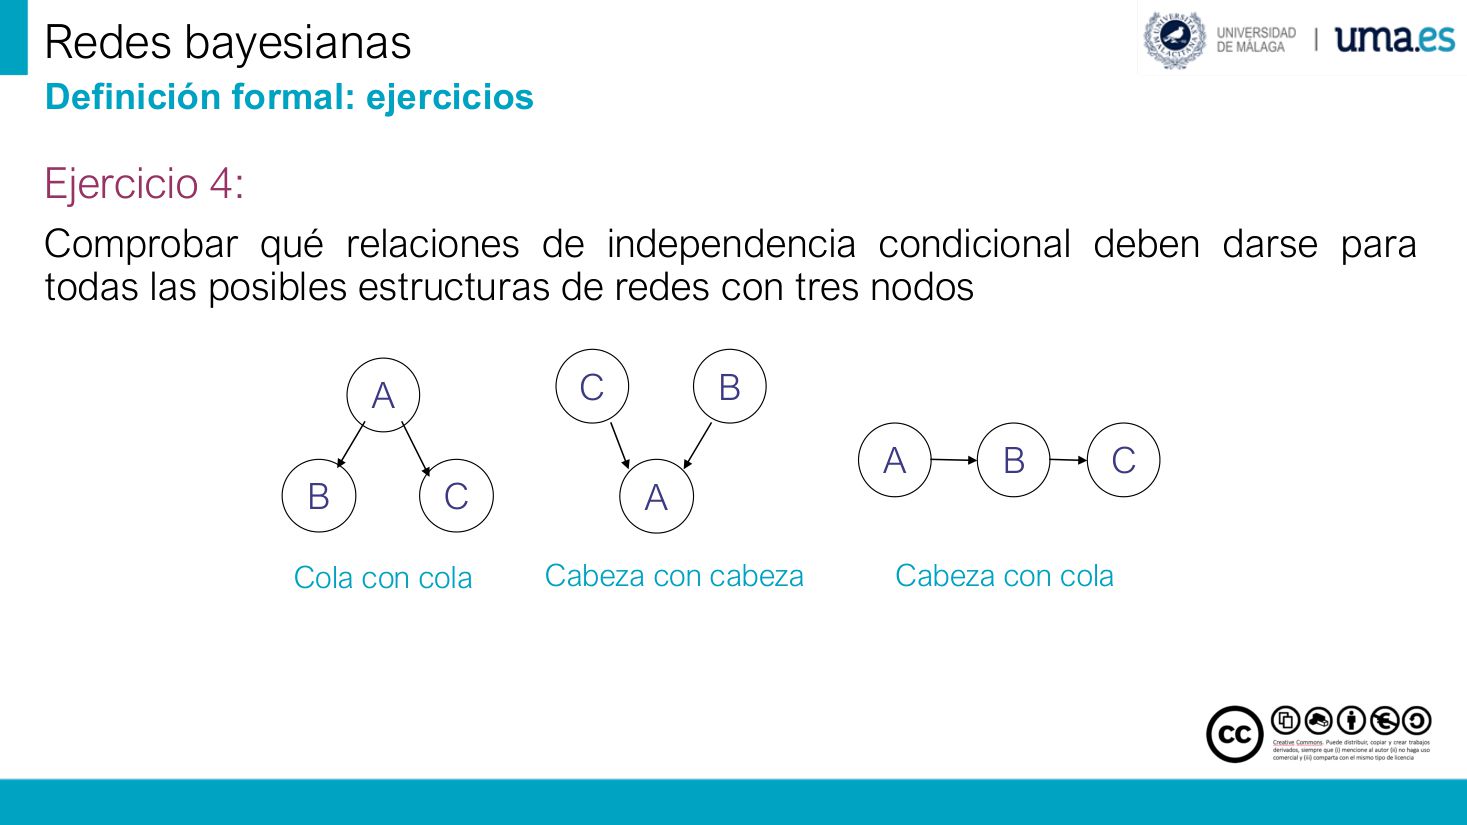
Ejercicio 4:
练习 4:
Comprobar qué relaciones de independencia condicional deben darse para todas las posibles estructuras de redes con tres nodos
检查对于三节点网络所有可能的结构,分别应该出现哪些
Cola con cola
尾对尾(fork:共同父节点 A 指向 B 和 C)。
Cabeza con cabeza
头对头(collider:B 和 C 共同指向 A)。
Cabeza con cola
头对尾(chain:A→B→C)。
A
节点 A(三张图中均出现)。
B
节点 B。
C
节点 C。
| 结构(图) | 西语读法 | 结论 |
|---|---|---|
| Cola con cola:A→B, A→C | «cola con cola» | B ⊥ C | A 成立:给定共同父节点 A,两个孩子独立 |
| Cola con cola:B ⊥ C | «be independiente de ce» | 不成立:不给 A 时,两个孩子通过 A 相关 |
| Cabeza con cabeza:B→A←C | «cabeza con cabeza» | B ⊥ C 成立:不给定共同子节点 A 时,两个父节点独立 |
| Cabeza con cabeza:B ⊥ C | A | «be independiente de ce dado a» | 不成立:给定 A 后 collider 被打开,两者反而相关 |
| Cabeza con cola:A→B→C | «cabeza con cola» | A ⊥ C | B 成立:给定中间节点 B,链两端独立 |
| Cabeza con cola:A ⊥ C | «a independiente de ce» | 不成立:不给 B 时,信息沿 A→B→C 流动 |
Ejemplos de significado de independencias en estructuras · 三种结构的实例化解释
▸ 原页截图 p.31
Redes bayesianas
贝叶斯网络(页眉)。
Definición formal: ejemplos de significado de independencias en estructuras
形式定义:结构上独立性含义的实例(页脚标题)。
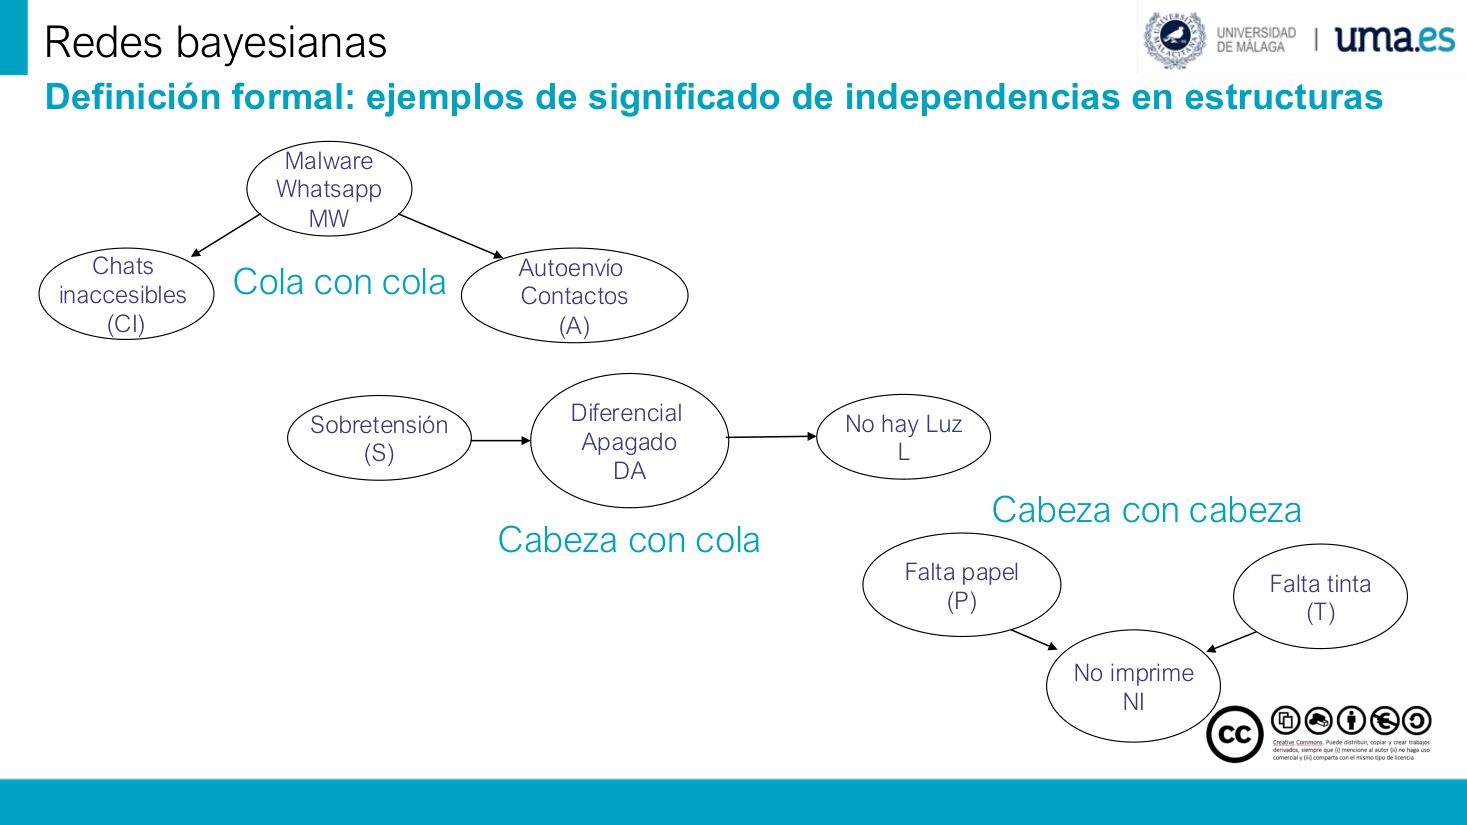
Cola con cola
尾对尾(fork):MW 是共同父节点。
Cabeza con cola
头对尾(chain):S→DA→L。
Cabeza con cabeza
头对头(collider):P→NI←T。
Malware Whatsapp
WhatsApp 木马/病毒(MW)。
MW
Malware Whatsapp 的缩写。
Chats inaccesibles
聊天记录无法访问(CI)。
(CI)
Chats inaccesibles 的缩写。
Autoenvío Contactos
自动向联系人转发/群发(A)。
(A)
Autoenvío Contactos 的缩写。
Sobretensión
电压过载/浪涌(S)。
(S)
Sobretensión 的缩写。
Diferencial Apagado
漏电保护器跳闸(DA)。
DA
Diferencial Apagado 的缩写。
No hay Luz
没电(L)。
L
No hay Luz 的缩写。
Falta papel
缺纸(P)。
(P)
Falta papel 的缩写。
Falta tinta
缺墨(T)。
(T)
Falta tinta 的缩写。
No imprime
打印不出来(NI)。
NI
No imprime 的缩写。
| 结构 | 西语读法 | 这条独立性在说什么 |
|---|---|---|
| CI ⊥ A | MW | «chats inaccesibles independiente de autoenvío dado malware whatsapp» | 一旦确认中了 WhatsApp 木马,聊天记录打不开和自动群发就是同一原因的两个后果,彼此不再提供额外信息 |
| S ⊥ L | DA | «sobretensión independiente de no hay luz dado diferencial apagado» | 知道是漏电保护器跳了闸,电压过载与「屋里没电」就无关了;链被中间节点截断 |
| P ⊥ T | «falta papel independiente de falta tinta» | 平时缺纸与缺墨互不影响(两个独立原因);collider 未给定 |
| P ⊥ T | NI | «falta papel independiente de falta tinta dado no imprime» | 不成立:看到「没打印出来」后,缺纸会 |
Teorema fundamental (Factorización de la probabilidad) · 基本定理:概率的因式分解
▸ 原页截图 p.32
Redes bayesianas
贝叶斯网络(页眉)。
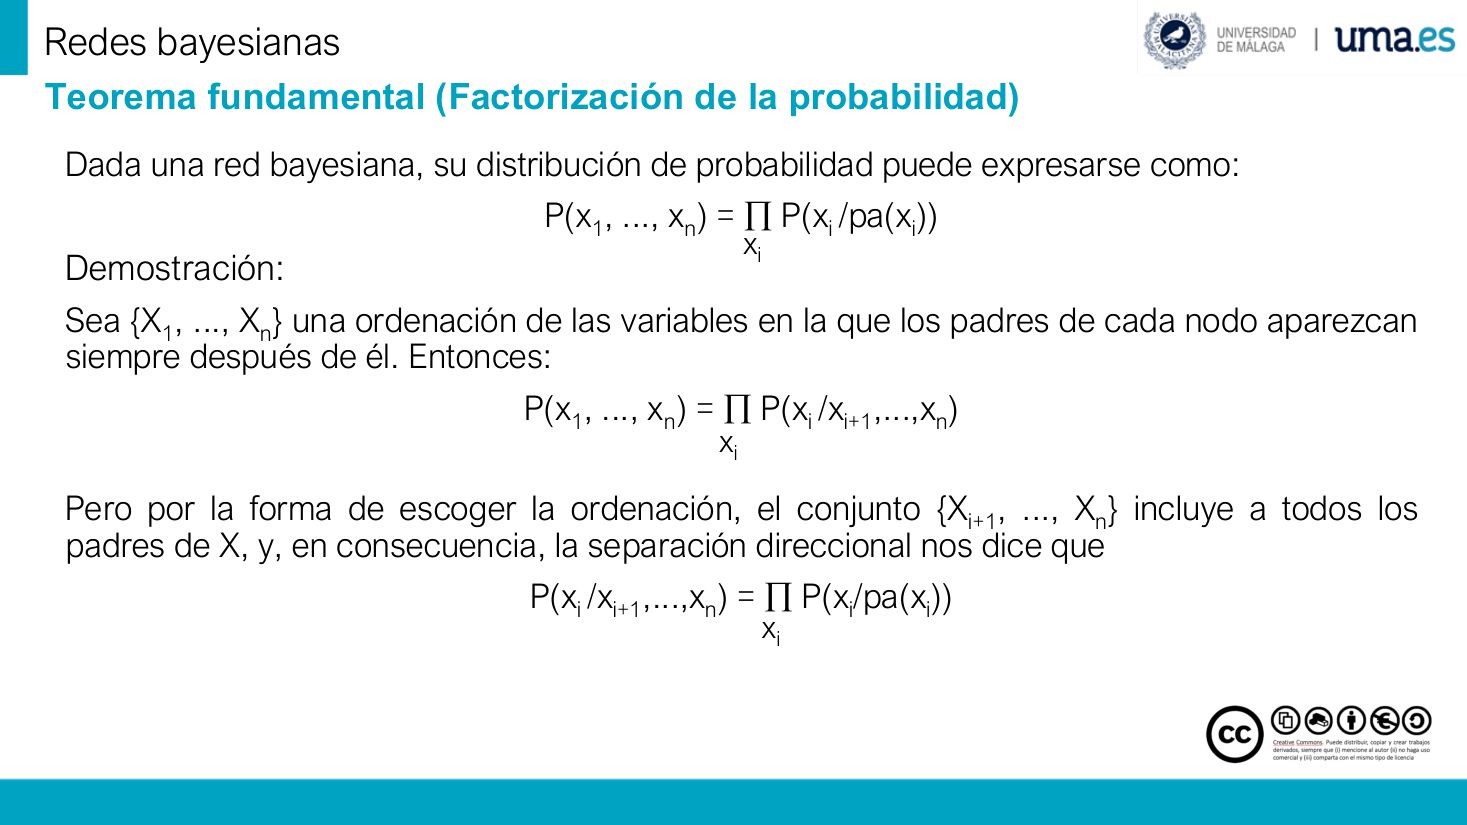
Teorema fundamental (Factorización de la probabilidad)
Dada una red bayesiana, su distribución de probabilidad puede expresarse como:
给定一个贝叶斯网络,其概率分布可以写成:
P(x1, ..., xn) = ∏P(xi /pa(xi))
P(x₁, …, xₙ) = ∏xᵢ P(xᵢ / pa(xᵢ)):联合分布等于每个节点「给定父节点的条件概率」之积。
Demostración:
证明:
Sea {X1, ..., Xn} una ordenación de las variables en la que los padres de cada nodo aparezcan siempre después de él. Entonces:
设 {X₁, …, Xₙ} 是变量的一种排序,使得每个节点的父节点在该排序中总排在它之后。于是:
P(x1, ..., xn) = ∏P(xi /xi+1,...,xn)
P(x₁, …, xₙ) = ∏ P(xᵢ / xi+1, …, xₙ):链式法则,每个变量以排在其后的所有变量为条件。
Pero por la forma de escoger la ordenación, el conjunto {Xi+1, ..., Xn} incluye a todos los padres de X, y, en consecuencia, la separación direccional nos dice que
但按这种排序方式,集合 {Xi+1, …, Xₙ} 已经包含了 X 的全部父节点,因此
P(xi /xi+1,...,xn) = ∏P(xi/pa(xi))
P(xᵢ / xi+1, …, xₙ) = P(xᵢ / pa(xᵢ)):条件里的一大串变量可以缩成父节点(见下方勘误)。
xi
xᵢ(∏ 下方的下标,表示对所有取值连乘)。
| 符号 | 西语读法 | 中文含义 |
|---|---|---|
| P(x₁, …, xₙ) | «probabilidad de equis uno hasta equis ene» | 全部变量的联合概率(一个完整赋值) |
| P(xᵢ / pa(xᵢ)) | «probabilidad de equis i dado padres de equis i» | 节点 i 在父节点取值下的条件概率(网络里存的表) |
| ∏xᵢ | «productorio sobre equis i» | 对每个节点连乘 |
| pa(xᵢ) | «padres de equis i» | 节点 i 的父节点取值组合 |
| {Xi+1, …, Xₙ} | «equis i más uno hasta equis ene» | 排序中排在 Xᵢ 之后的全部变量 |
| / | «dado» | 条件竖线(本讲义用斜杠写条件概率) |
Teorema fundamental: Importancia del teorema · 基本定理为什么重要
▸ 原页截图 p.33
Redes bayesianas
贝叶斯网络(页眉)。
Teorema fundamental: Importancia del teorema
基本定理:该定理的重要性。
Nos permite describir una red bayesiana a partir de las probabilidades condicionadas de cada nodo dados sus padres en lugar de a partir de la probabilidad conjunta, que:
它让我们用「每个节点给定其父节点的条件概率」来描述贝叶斯网络,而不必用联合概率来描述;而联合概率:
requiere un número de parámetros exponencial en el número de nodos.
所需参数个数随节点数呈
plantea el problema de verificar la independencia condicional
还带来「如何验证条件独立」这个问题。
| 描述方式 | 西语读法 | 参数规模(n 个二值节点) |
|---|---|---|
| P(x₁, …, xₙ) 联合分布 | «probabilidad conjunta» | 2ⁿ − 1 个自由参数:n = 10 就要 1023 个,n = 30 超过十亿 |
| ∏ P(xᵢ / pa(xᵢ)) 因式分解 | «producto de probabilidades condicionadas» | 每个节点 2 × 2|pa| 个(k 个父节点即 2k+1),随父节点数线性累加 |
| 只用联合表建模 | «solo con la tabla conjunta» | 不成立的做法:指数爆炸 + 还要额外检验条件独立是否满足 |
七、基本定理的应用与四道复习练习
p.34–p.40Teorema fundamental: ejemplo de aplicación · 基本定理的应用示例
▸ 原页截图 p.34
Redes bayesianas
贝叶斯网络(页眉)。
Teorema fundamental: ejemplo de aplicación
基本定理:应用示例。
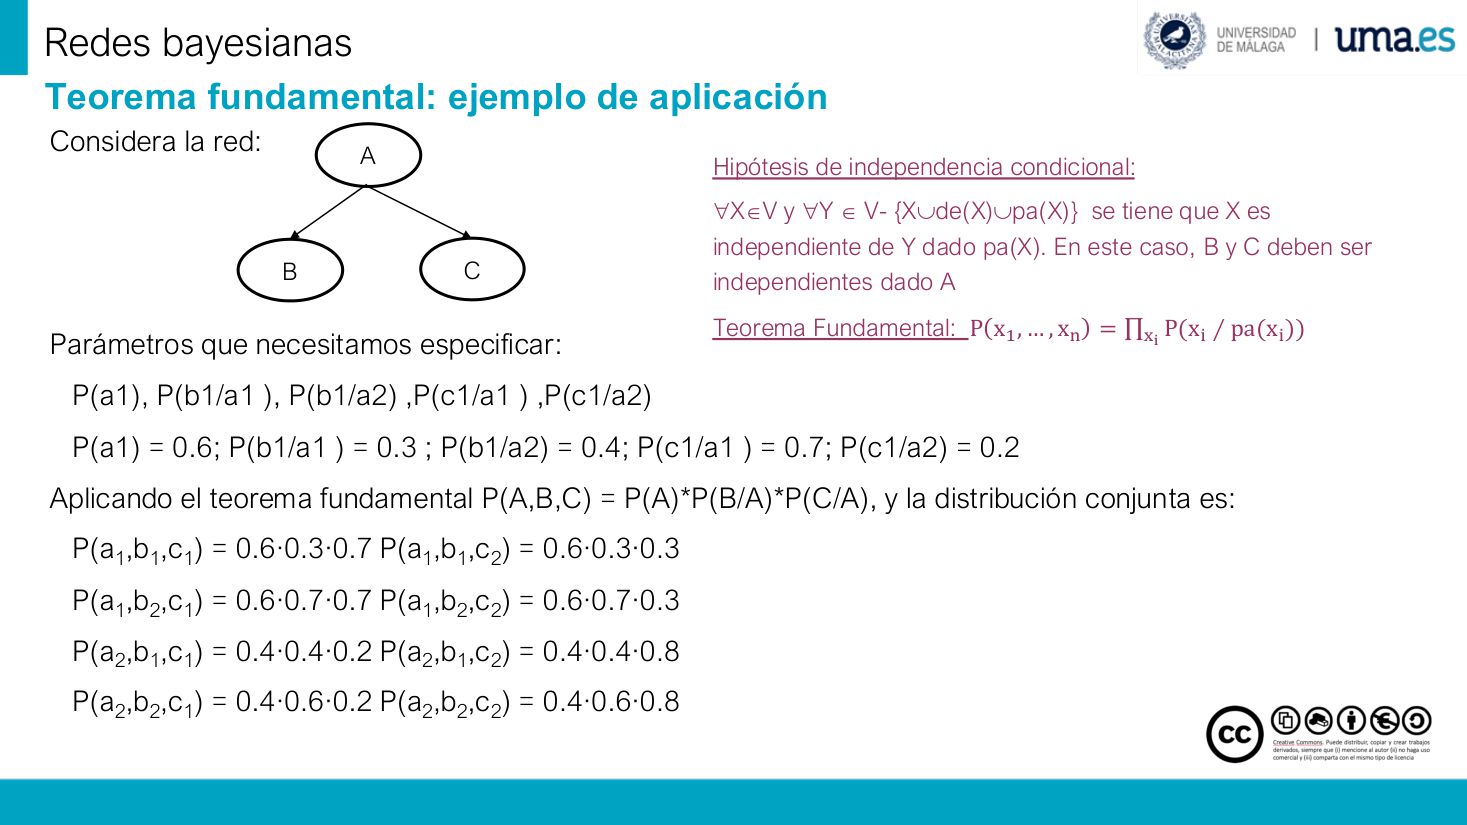
Considera la red:
考虑下面这个网络(A 在上,B、C 在下的 fork 结构):
Hipótesis de independencia condicional:
∀X∈V y ∀Y∈V- {X∪de(X)∪pa(X)} se tiene que X es independiente de Y dado pa(X). En este caso, B y C deben ser independientes dado A
对任意 X∈V、任意 Y∈V−({X}∪de(X)∪pa(X)),都有 X 在给定 pa(X) 时独立于 Y。在本例中,B 与 C 必须在给定 A 的条件下独立。
Teorema Fundamental: P(x1, …, xn) = ∏xi P(xi ∕pa(xi))
基本定理:P(x₁, …, xₙ) = ∏xᵢ P(xᵢ / pa(xᵢ))。
Parámetros que necesitamos especificar:
我们需要指定的参数:
P(a1), P(b1/a1 ), P(b1/a2) ,P(c1/a1 ) ,P(c1/a2)
P(a₁), P(b₁/a₁), P(b₁/a₂), P(c₁/a₁), P(c₁/a₂):一个先验加四个条件概率(二值变量时,每张表只差一个自由度)。
P(a1) = 0.6; P(b1/a1 ) = 0.3 ; P(b1/a2) = 0.4; P(c1/a1 ) = 0.7; P(c1/a2) = 0.2
P(a₁) = 0.6;P(b₁/a₁) = 0.3;P(b₁/a₂) = 0.4;P(c₁/a₁) = 0.7;P(c₁/a₂) = 0.2。
Aplicando el teorema fundamental P(A,B,C) = P(A)*P(B/A)*P(C/A), y la distribución conjunta es:
应用基本定理 P(A,B,C) = P(A)·P(B/A)·P(C/A),联合分布为:
P(a1,b1,c1) = 0.6·0.3·0.7 P(a1,b1,c2) = 0.6·0.3·0.3
P(a₁,b₁,c₁) = 0.6·0.3·0.7 = 0.126;P(a₁,b₁,c₂) = 0.6·0.3·0.3 = 0.054。
P(a1,b2,c1) = 0.6·0.7·0.7 P(a1,b2,c2) = 0.6·0.7·0.3
P(a₁,b₂,c₁) = 0.6·0.7·0.7 = 0.294;P(a₁,b₂,c₂) = 0.6·0.7·0.3 = 0.126。
P(a2,b1,c1) = 0.4·0.4·0.2 P(a2,b1,c2) = 0.4·0.4·0.8
P(a₂,b₁,c₁) = 0.4·0.4·0.2 = 0.032;P(a₂,b₁,c₂) = 0.4·0.4·0.8 = 0.128。
P(a2,b2,c1) = 0.4·0.6·0.2 P(a2,b2,c2) = 0.4·0.6·0.8
P(a₂,b₂,c₁) = 0.4·0.6·0.2 = 0.048;P(a₂,b₂,c₂) = 0.4·0.6·0.8 = 0.192。
| 符号 | 西语读法 | 中文含义 |
|---|---|---|
| P(a₁) | «probabilidad de a uno» | 根节点 A 的先验概率,0.6 |
| P(b₁/a₁) | «probabilidad de be uno dado a uno» | 父节点取 a₁ 时 B 取 b₁ 的条件概率 |
| P(c₁/a₂) | «probabilidad de ce uno dado a dos» | 父节点取 a₂ 时 C 取 c₁ 的条件概率,0.2 |
| P(A,B,C)=P(A)P(B/A)P(C/A) | «producto de la marginal por las dos condicionadas» | 本例的因式分解:B、C 只依赖 A |
| P(A,B,C)=P(A)P(B)P(C) | «producto de las tres marginales» | 不成立:B、C 只条件独立于 A,不是无条件独立 |
Ejercicio 1: caída del servidor · 练习 1:服务器宕机网络的因式分解
▸ 原页截图 p.35
Redes bayesianas
贝叶斯网络(页眉)。
Teorema fundamental: ejercicios
基本定理:练习(页脚标题)。
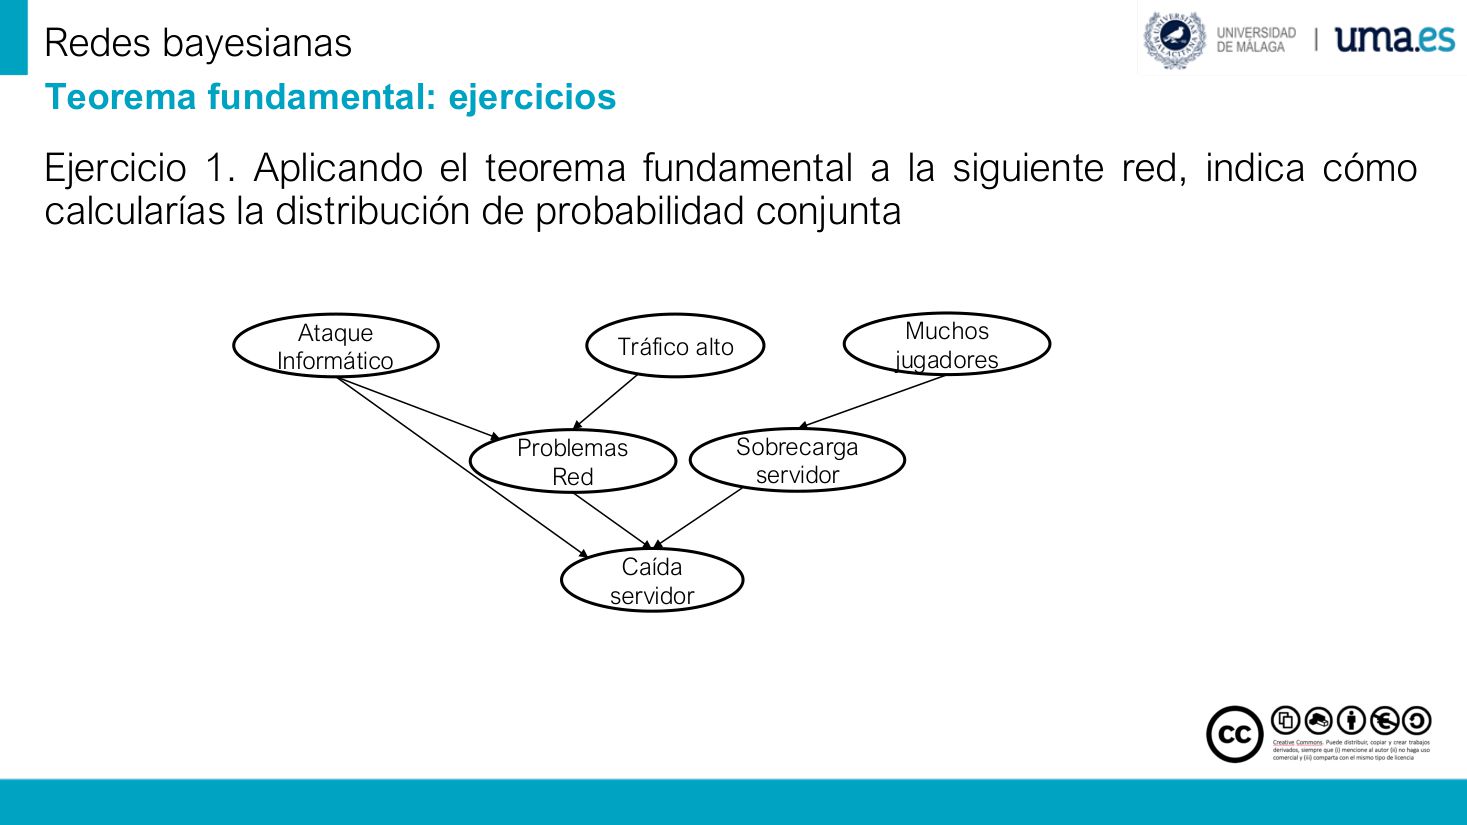
Ejercicio 1. Aplicando el teorema fundamental a la siguiente red, indica cómo calcularías la distribución de probabilidad conjunta
练习 1:对下图应用基本定理,说明你会如何计算
Ataque Informático
网络攻击(根节点)。
Tráfico alto
高流量(根节点)。
Muchos jugadores
玩家很多(根节点)。
Problemas Red
网络故障(攻击与高流量的共同子节点)。
Sobrecarga servidor
服务器过载(玩家很多的子节点)。
Caída servidor
服务器宕机(网络故障、过载、攻击三者共同指向)。
| 节点 | 西语读法 | 因子(父节点) |
|---|---|---|
| Ataque Informático | «ataque informático» | P(AI):根节点 |
| Tráfico alto | «tráfico alto» | P(TA):根节点 |
| Muchos jugadores | «muchos jugadores» | P(MJ):根节点 |
| Problemas Red | «problemas red» | P(PR / AI, TA):两个父节点 |
| Sobrecarga servidor | «sobrecarga servidor» | P(SS / MJ):一个父节点 |
| Caída servidor | «caída servidor» | P(CS / PR, SS, AI):三个父节点 |
Ejercicio 2: red de impresión · 练习 2:打印系统的因式分解
▸ 原页截图 p.36
Redes bayesianas
贝叶斯网络(页眉)。
Teorema fundamental: ejercicios
基本定理:练习(页脚标题)。
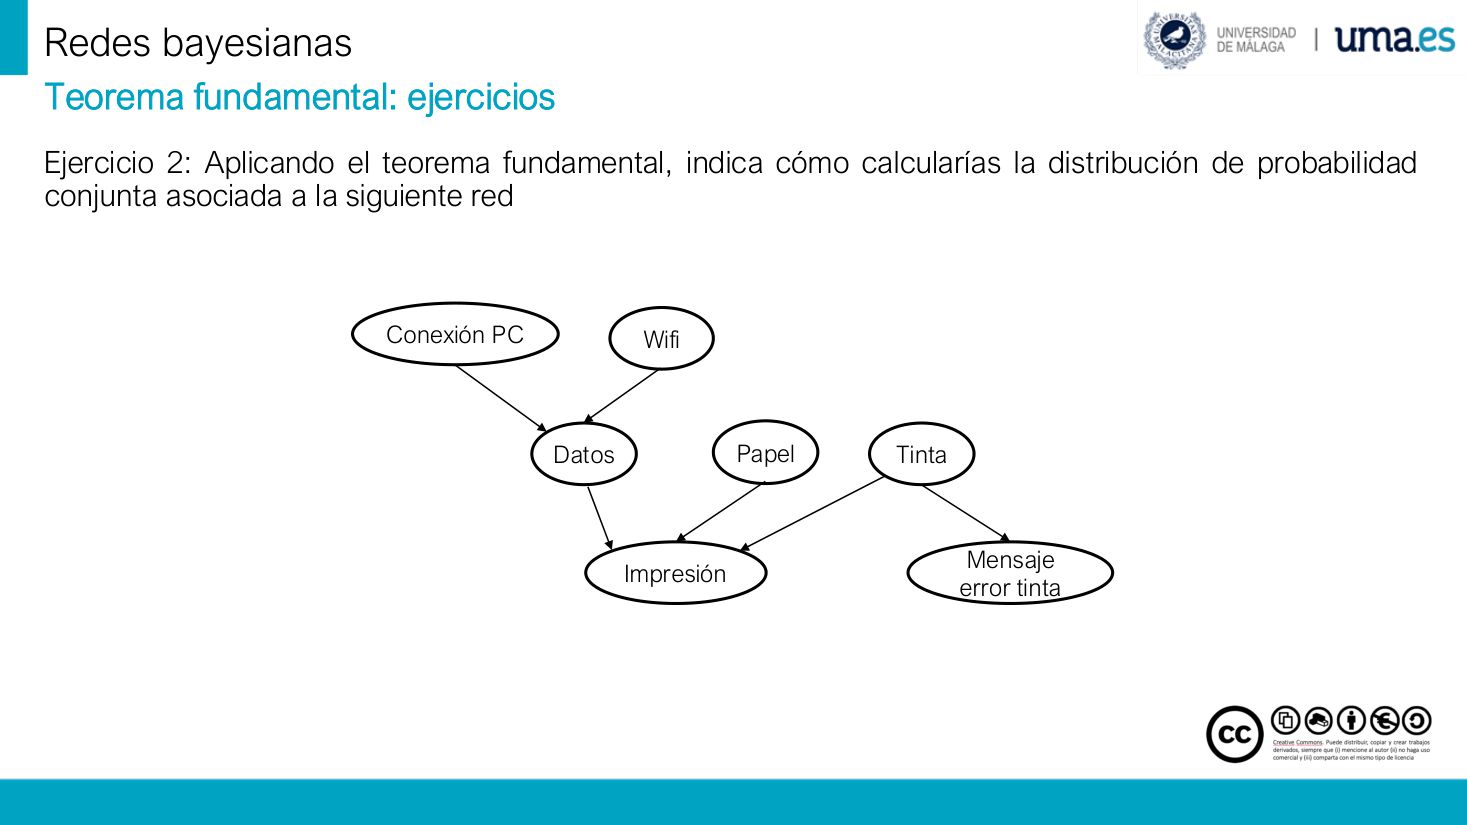
Ejercicio 2: Aplicando el teorema fundamental, indica cómo calcularías la distribución de probabilidad conjunta asociada a la siguiente red
练习 2:应用基本定理,说明你会如何计算下图对应的联合概率分布。
Conexión PC
PC 连接(根节点)。
Wifi
Wi-Fi(根节点)。
Datos
数据(PC 连接与 Wi-Fi 的共同子节点)。
Papel
纸张(根节点)。
Tinta
墨水(根节点)。
Impresión
打印(数据、纸张、墨水共同指向)。
Mensaje error tinta
缺墨错误提示(墨水的子节点)。
| 节点 | 西语读法 | 因子(父节点) |
|---|---|---|
| Conexión PC | «conexión pe ce» | P(CPC):根节点 |
| Wifi | «wifi» | P(W):根节点 |
| Papel | «papel» | P(Pa):根节点 |
| Tinta | «tinta» | P(T):根节点,有两条出边 |
| Datos | «datos» | P(D / CPC, W) |
| Impresión | «impresión» | P(I / D, Pa, T):三个父节点 |
| Mensaje error tinta | «mensaje error tinta» | P(ME / T):一个父节点 |
Ejercicio de repaso 1 · 复习练习 1:转移瘤网络(四问全解)
▸ 原页截图 p.37
Redes bayesianas
贝叶斯网络(页眉)。
Ejercicio de repaso 1
复习练习 1。
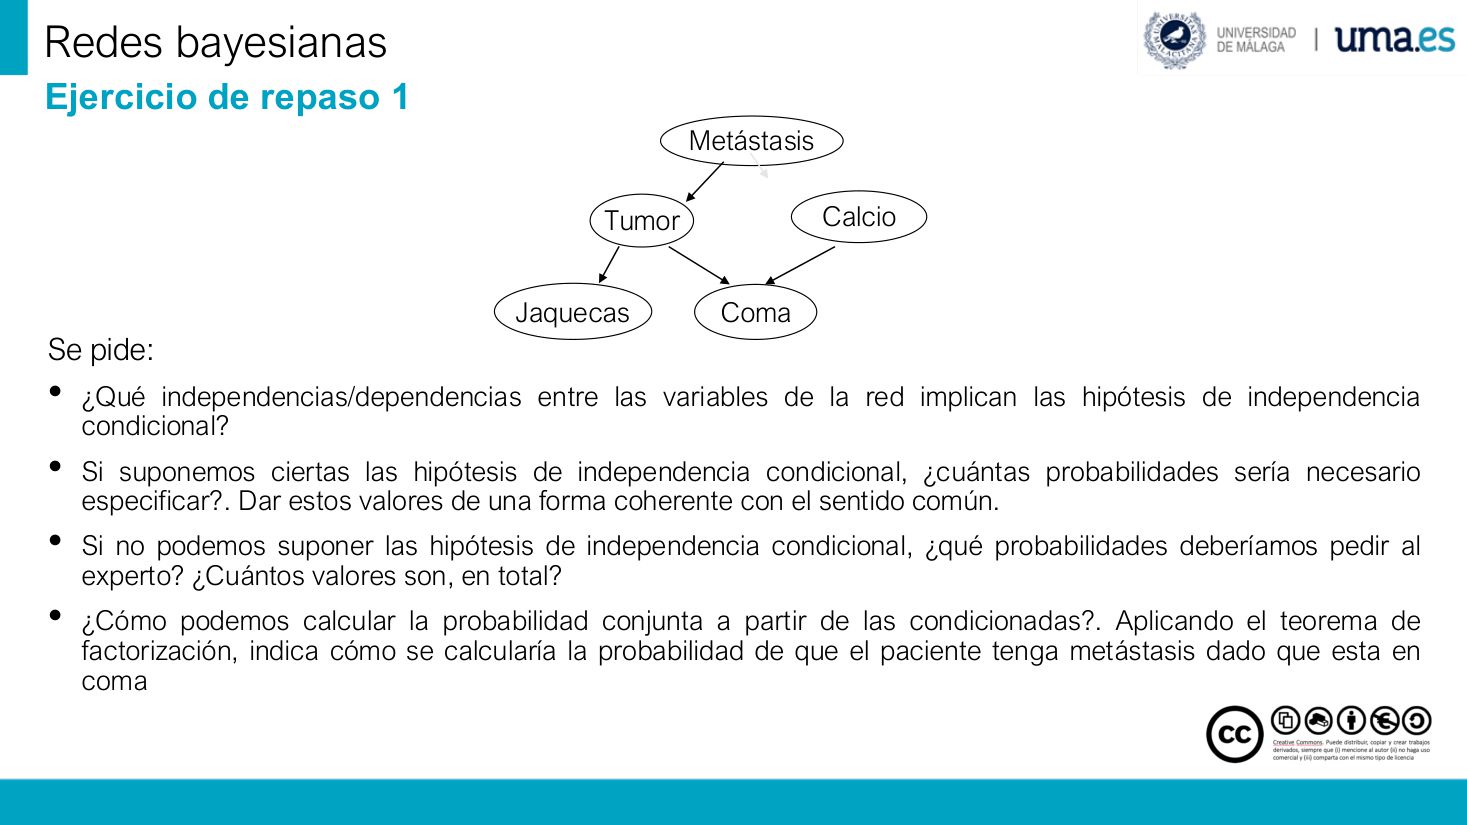
Metástasis
转移(瘤)(根节点)。
Tumor
肿瘤(转移的子节点,同时是头痛、昏迷的父节点)。
Calcio
血钙(根节点)。
Jaquecas
头痛(肿瘤的子节点)。
Coma
昏迷(肿瘤与血钙的共同子节点,collider)。
Se pide:
求:
¿Qué independencias/dependencias entre las variables de la red implican las hipótesis de independencia condicional?
网络的
Si suponemos ciertas las hipótesis de independencia condicional, ¿cuántas probabilidades sería necesario especificar?. Dar estos valores de una forma coherente con el sentido común.
若假定条件独立假设成立,需要指定多少个概率?请按常识给出一组自洽的数值。
Si no podemos suponer las hipótesis de independencia condicional, ¿qué probabilidades deberíamos pedir al experto? ¿Cuántos valores son, en total?
若不能假定条件独立,应该向专家索取哪些概率?总共有多少个数值?
¿Cómo podemos calcular la probabilidad conjunta a partir de las condicionadas?. Aplicando el teorema de factorización, indica cómo se calcularía la probabilidad de que el paciente tenga metástasis dado que esta en coma
如何由条件概率算出联合概率?应用因式分解定理,说明如何计算「已知病人处于昏迷,其有转移」的概率。
| 项目 | 西语读法 | 答案 |
|---|---|---|
| Metástasis ⊥ Calcio | «metástasis independiente de calcio» | 成立(两个根节点,无路径) |
| Jaquecas ⊥ Coma | Tumor | «jaquecas independiente de coma dado tumor» | 成立:C←T→J 的 fork 被 T 阻断 |
| Jaquecas ⊥ Calcio | «jaquecas independiente de calcio» | 成立:J←T→C←Ca,在 C 处是 collider,未给定则阻断 |
| Tumor ⊥ Calcio | Coma | «tumor independiente de calcio dado coma» | 不成立:给定 collider Coma,T 与 Ca 变得相关 |
| 参数个数(假设成立) | «¿cuántas probabilidades?» | P(Me)=1、P(Ca)=1、P(T/Me)=2、P(J/T)=2、P(C/T,Ca)=4 → 10 个 |
| 参数个数(不假设) | «sin las hipótesis» | 联合表 2⁵−1 = 31 个 |
| P(Me,Ca,T,J,C) | «factorización» | P(Me)·P(Ca)·P(T/Me)·P(J/T)·P(C/T,Ca) |
Ejercicio de repaso 2 · 复习练习 2:简化版 Asia 网络
▸ 原页截图 p.38
Redes bayesianas
贝叶斯网络(页眉)。
Ejercicio de repaso 2
复习练习 2。
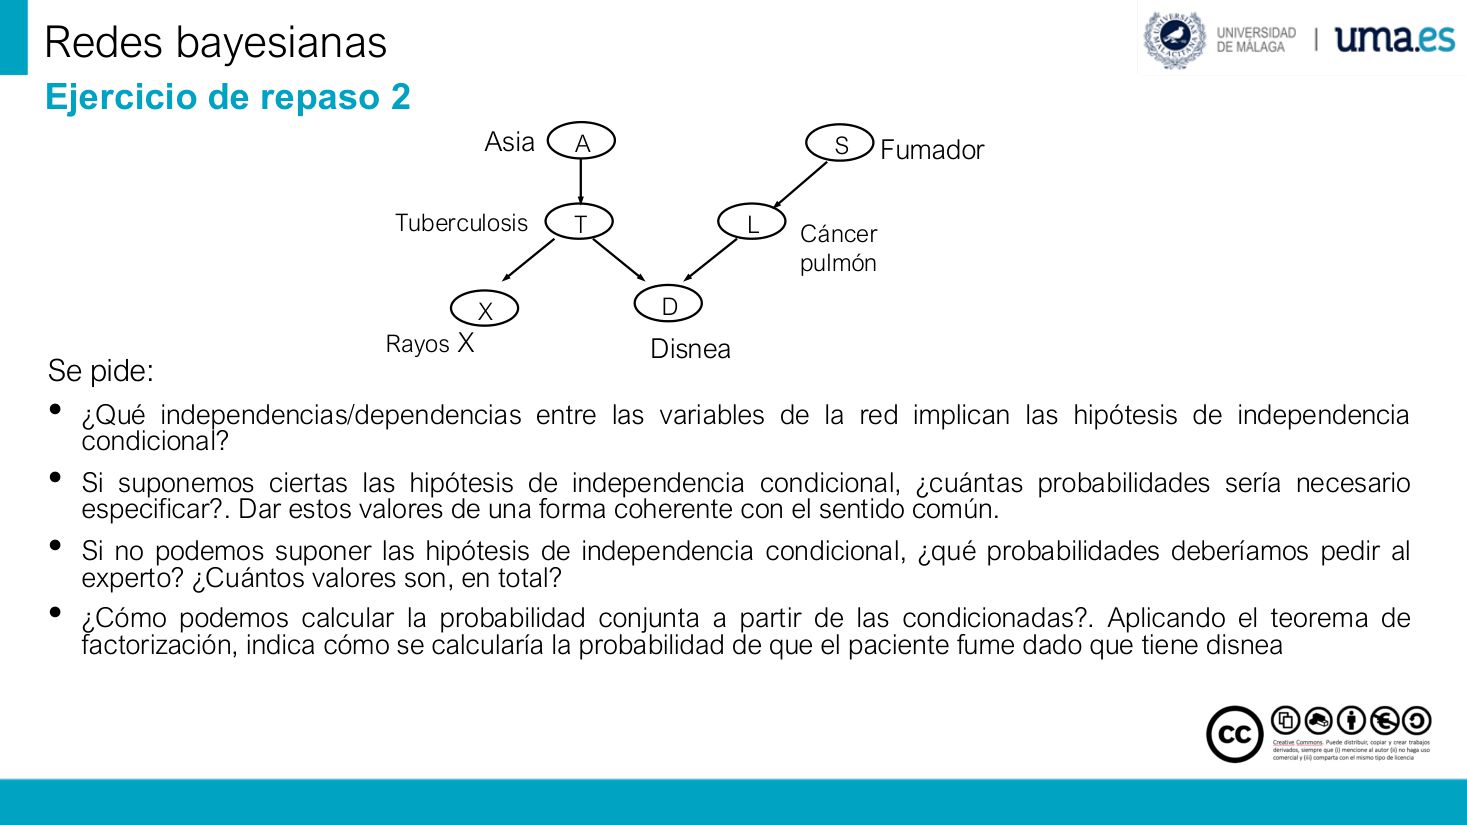
Asia
亚洲(根节点 A)。
Tuberculosis
结核病(T)。
Fumador
吸烟者(S)。
Cáncer pulmón
肺癌(L)。
Rayos X
X 光片(X)。
Disnea
呼吸困难(D)。
Se pide:
求:
¿Qué independencias/dependencias entre las variables de la red implican las hipótesis de independencia condicional?
条件独立假设隐含了哪些独立/依赖关系?
Si suponemos ciertas las hipótesis de independencia condicional, ¿cuántas probabilidades sería necesario especificar?. Dar estos valores de una forma coherente con el sentido común.
若假定条件独立假设成立,需要指定多少个概率?请按常识给出一组自洽的值。
Si no podemos suponer las hipótesis de independencia condicional, ¿qué probabilidades deberíamos pedir al experto? ¿Cuántos valores son, en total?
若不能假定条件独立,应向专家索取哪些概率?一共多少个数值?
¿Cómo podemos calcular la probabilidad conjunta a partir de las condicionadas?. Aplicando el teorema de factorización, indica cómo se calcularía la probabilidad de que el paciente fume dado que tiene disnea
如何由条件概率算联合概率?应用因式分解定理,说明如何计算「已知病人呼吸困难,他吸烟」的概率。
| 项目 | 西语读法 | 答案 |
|---|---|---|
| Asia ⊥ Fumador | «Asia independiente de fumador» | 成立:无路径 |
| Rayos X ⊥ Disnea | Tuberculosis | «rayos equis independiente de disnea dada tuberculosis» | 成立:X←T→D 的 fork 被 T 阻断 |
| Tuberculosis ⊥ Cáncer pulmón | Disnea | «tuberculosis independiente de cáncer dado disnea» | 不成立:D 是 T 与 L 的 collider,给定后两者相关 |
| 参数个数(假设成立) | «¿cuántas probabilidades?» | P(A)1 + P(S)1 + P(T/A)2 + P(L/S)2 + P(X/T)2 + P(D/T,L)4 = 12 |
| 参数个数(不假设) | «sin las hipótesis» | 联合表 2⁶−1 = 63 |
| P(A,S,T,L,X,D) | «factorización» | P(A)·P(S)·P(T/A)·P(L/S)·P(X/T)·P(D/T,L) |
Ejercicio de repaso 3 (propuesto) · 复习练习 3(课后自练):软件工程缺陷检测
▸ 原页截图 p.39
Redes bayesianas
贝叶斯网络(页眉)。
Ejercicio de repaso 3 (propuesto)
复习练习 3(
Dada la siguiente red sobre detección de defectos en ingeniería del software
给定下面这个关于软件工程缺陷检测的网络:
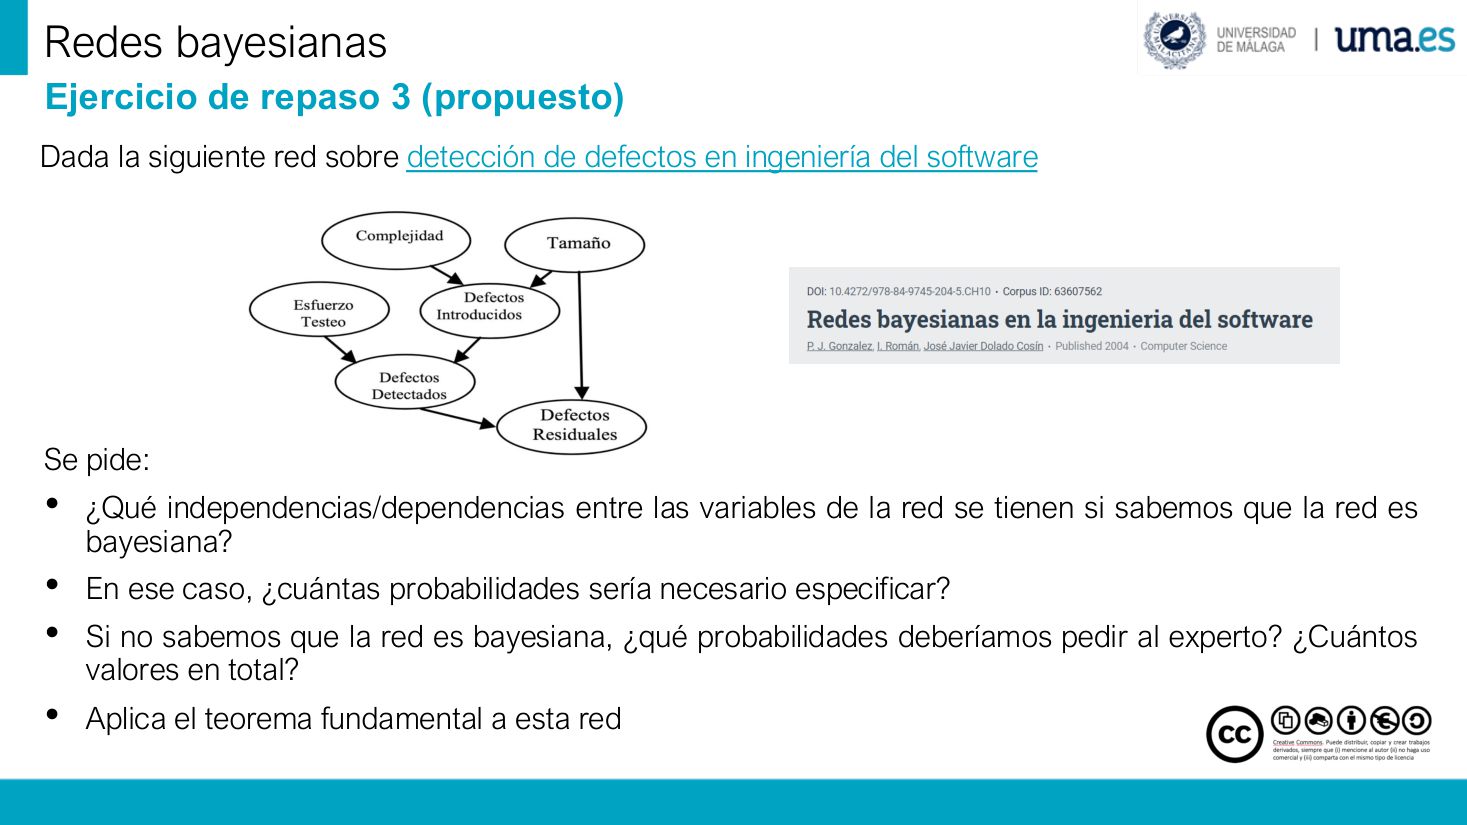
Complejidad
复杂度(根节点)。
Tamaño
规模(根节点,有两条出边)。
Esfuerzo Testeo
测试投入(根节点)。
Defectos Introducidos
引入的缺陷(复杂度与规模的子节点)。
Defectos Detectados
检测出的缺陷(引入缺陷与测试投入的子节点)。
Defectos Residuales
残余缺陷(引入缺陷、检测缺陷、规模共同指向)。
Se pide:
求:
¿Qué independencias/dependencias entre las variables de la red se tienen si sabemos que la red es bayesiana?
已知该网络是贝叶斯网络,变量之间存在哪些独立/依赖关系?
En ese caso, ¿cuántas probabilidades sería necesario especificar?
在这种情况下需要指定多少个概率?
Si no sabemos que la red es bayesiana, ¿qué probabilidades deberíamos pedir al experto? ¿Cuántos valores en total?
若不知道它是贝叶斯网络,应该向专家问哪些概率?一共多少个值?
Aplica el teorema fundamental a esta red
对该网络应用基本定理。
DOI: 10.4272/978-84-9745-204-5.CH10 · Corpus ID: 63607562
DOI 与 Corpus ID(原页引文卡片)。
Redes bayesianas en la ingeniería del software
《软件工程中的贝叶斯网络》(引文标题)。
P.J. González, I. Román, José Javier Dolado Cosín · Published 2004 · Computer Science
作者、发表年份 2004 与学科(计算机科学)。
| 节点 | 西语读法 | 因子(父节点) |
|---|---|---|
| Complejidad | «complejidad» | P(Cm):根节点 |
| Tamaño | «tamaño» | P(Ta):根节点 |
| Esfuerzo Testeo | «esfuerzo testeo» | P(Et):根节点 |
| Defectos Introducidos | «defectos introducidos» | P(DI / Cm, Ta) |
| Defectos Detectados | «defectos detectados» | P(DD / DI, Et) |
| Defectos Residuales | «defectos residuales» | P(DR / DI, DD, Ta):三个父节点 |
Ejercicio de repaso 4 (propuesto) · 复习练习 4(课后自练):计算机病毒防护网络
▸ 原页截图 p.40
Redes bayesianas
贝叶斯网络(页眉)。
Ejercicio de repaso 4 (propuesto)
复习练习 4(课后自练)。
Dada la siguiente red sobre infección por virus informáticos:
给定下面这个关于计算机病毒感染的网络:
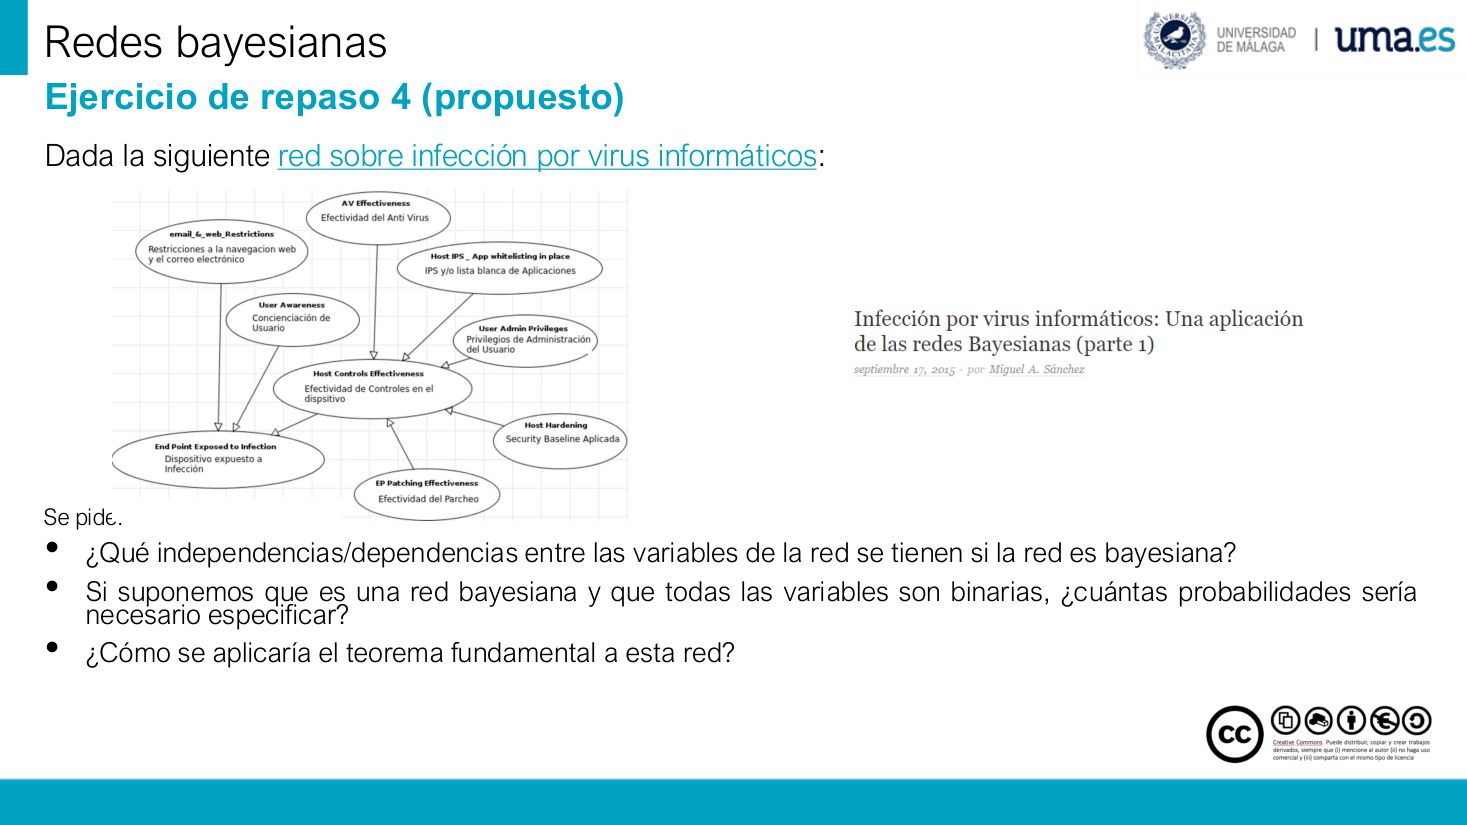
email_&_web_Restrictions
邮件与网页访问限制(英文节点名)。
Restricciones a la navegacion web y el correo electrónico
对网页浏览与电子邮件的限制(节点中文标签的原文;原文 «navegacion» 缺重音)。
AV Effectiveness
杀毒软件有效性(英文节点名)。
Efectividad del Anti Virus
杀毒软件的有效性。
Host IPS _ App whitelisting in place
主机入侵防御系统与应用程序白名单已启用(英文节点名)。
IPS y/o lista blanca de Aplicaciones
IPS 和/或应用程序白名单。
User Awareness
用户安全意识(英文节点名)。
Concienciación de Usuario
用户(安全)意识;«Concienciación» 即「提高意识」。
User Admin Privileges
用户管理员权限(英文节点名)。
Privilegios de Administración del Usuario
用户的管理权限。
Host Hardening
主机加固(英文节点名)。
Security Baseline Aplicada
已应用安全基线。
EP Patching Effectiveness
终端补丁有效性(英文节点名)。
Efectividad del Parcheo
打补丁的有效性。
Host Controls Effectiveness
主机控制措施有效性(英文节点名)。
Efectividad de Controles en el dispositivo
设备上控制措施的有效性。
End Point Exposed to Infection
终端暴露于感染(英文节点名)。
Dispositivo expuesto a Infección
暴露于感染风险的设备。
Infección por virus informáticos: Una aplicación de las redes Bayesianas (parte 1)
《计算机病毒感染:贝叶斯网络的一个应用(第 1 部分)》(原页引文标题)。
septiembre 17, 2015 · por Miguel A. Sánchez
2015 年 9 月 17 日,作者 Miguel A. Sánchez。
Se pide:
求:
¿Qué independencias/dependencias entre las variables de la red se tienen si la red es bayesiana?
若该网络是贝叶斯网络,变量之间有哪些独立/依赖关系?
Si suponemos que es una red bayesiana y que todas las variables son binarias, ¿cuántas probabilidades sería necesario especificar?
若假定它是贝叶斯网络且所有变量都是二值,需要指定多少个概率?
¿Cómo se aplicaría el teorema fundamental a esta red?
如何把基本定理应用到该网络?
| 节点 | 西语读法 | 因子(父节点) |
|---|---|---|
| email_&_web_Restrictions | «restricciones de correo y web» | P(EWR):根节点 |
| AV Effectiveness | «efectividad del antivirus» | P(AV):根节点 |
| Host IPS / App whitelisting | «ips y lista blanca» | P(HIPS):根节点 |
| User Awareness | «concienciación del usuario» | P(UA):根节点 |
| User Admin Privileges | «privilegios de administración» | P(UAP):根节点 |
| Host Hardening | «endurecimiento del host» | P(HH):根节点 |
| EP Patching Effectiveness | «efectividad del parcheo» | P(EPP):根节点 |
| Host Controls Effectiveness | «efectividad de controles del dispositivo» | P(HCE / AV, HIPS, UA, UAP, HH, EPP):六个父节点 → 2⁶ = 64 行 |
| End Point Exposed to Infection | «dispositivo expuesto a infección» | P(EPE / EWR, UA, HCE):三个父节点 → 8 行 |
八、建模:定性建模(节点与关系)与定量建模(参数)
p.41–p.46Modelado con redes bayesianas · 用贝叶斯网络建模:定性 + 定量两步
▸ 原页截图 p.41
Redes bayesianas
贝叶斯网络(页眉)。
Modelado con redes bayesianas
用贝叶斯网络进行
Un modelo es una representación selectiva de la realidad. El proceso de construir modelos se denomina modelado, y en el enfoque de redes bayesianas consta de:
模型是对现实的
Modelado cualitativo, en el que se han de definir;
Los nodos o variables (deben tomar un conjunto EXHAUSTIVO y EXCLUYENTE de valores).
节点(变量),其取值集合必须是
Las relaciones entre los nodos (deben representar influencia causal)
节点之间的关系(必须表示
Modelado cuantitativo, en el que se especifican los parámetros.
Por el teorema fundamental, los parámetros necesarios son las distribuciones de probabilidad condicionada de cada nodo dados sus padres (incluyendo la probabilidad a priori de los nodos sin padre)
由基本定理,所需参数就是每个节点在给定父节点下的
| 阶段 | 西语读法 | 要做的事 |
|---|---|---|
| Modelado cualitativo | «modelado cualitativo» | 选节点 + 定关系;节点取值要穷尽且互斥,箭头要有因果含义 |
| Modelado cuantitativo | «modelado cuantitativo» | 填条件概率表(CPT):有父节点的写 P(x/pa(x)),根节点写先验 |
| Solo modelado cuantitativo | «solo los parámetros» | 不成立:没有正确的定性结构,参数再多也无意义 |
Pregunta 1: enfermedades · 问题 1:疾病该用一个多值节点还是多个二值节点
▸ 原页截图 p.42
Redes bayesianas
贝叶斯网络(页眉)。
Modelado con redes bayesianas
用贝叶斯网络建模(副标题)。
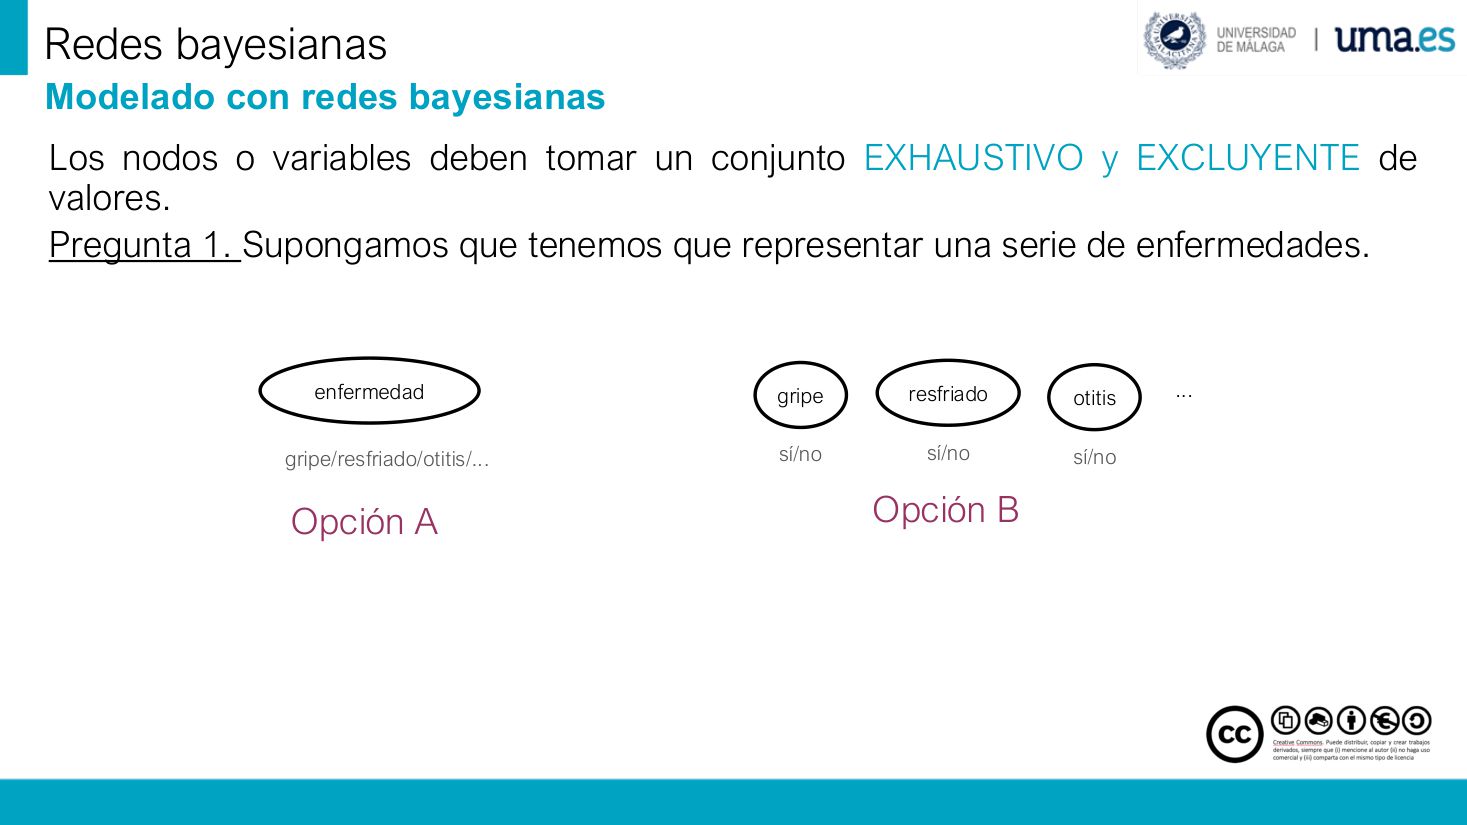
Los nodos o variables deben tomar un conjunto EXHAUSTIVO y EXCLUYENTE de valores.
节点(变量)必须取
Pregunta 1. Supongamos que tenemos que representar una serie de enfermedades.
问题 1:假设我们要表示一系列疾病。
Opción A
方案 A(单个多值节点)。
Opción B
方案 B(多个二值节点)。
enfermedad
疾病(一个节点)。
gripe/resfriado/otitis/...
流感 / 感冒 / 中耳炎 / …(该节点的取值表)。
gripe
流感(一个独立节点)。
sí/no
是/否(二值取值,原文每个节点下都标一次)。
resfriado
感冒(一个独立节点)。
otitis
中耳炎(一个独立节点)。
...
……(其余疾病继续照此添加)。
| 方案 | 西语读法 | 判定 |
|---|---|---|
| A:enfermedad = gripe/resfriado/otitis/… | «opción a, un nodo con varios valores» | 正确:一次就诊通常只有一种病,取值集合互斥且穷尽 |
| B:gripe sí/no, resfriado sí/no, otitis sí/no | «opción b, varios nodos binarios» | 错误:允许 gripe=sí 与 resfriado=sí 同时成立,破坏 EXCLUYENTE |
Pregunta 2: animales vertebrados · 问题 2:脊椎动物的节点怎么定义
▸ 原页截图 p.43
Redes bayesianas
贝叶斯网络(页眉)。
Modelado con redes bayesianas
用贝叶斯网络建模(副标题)。
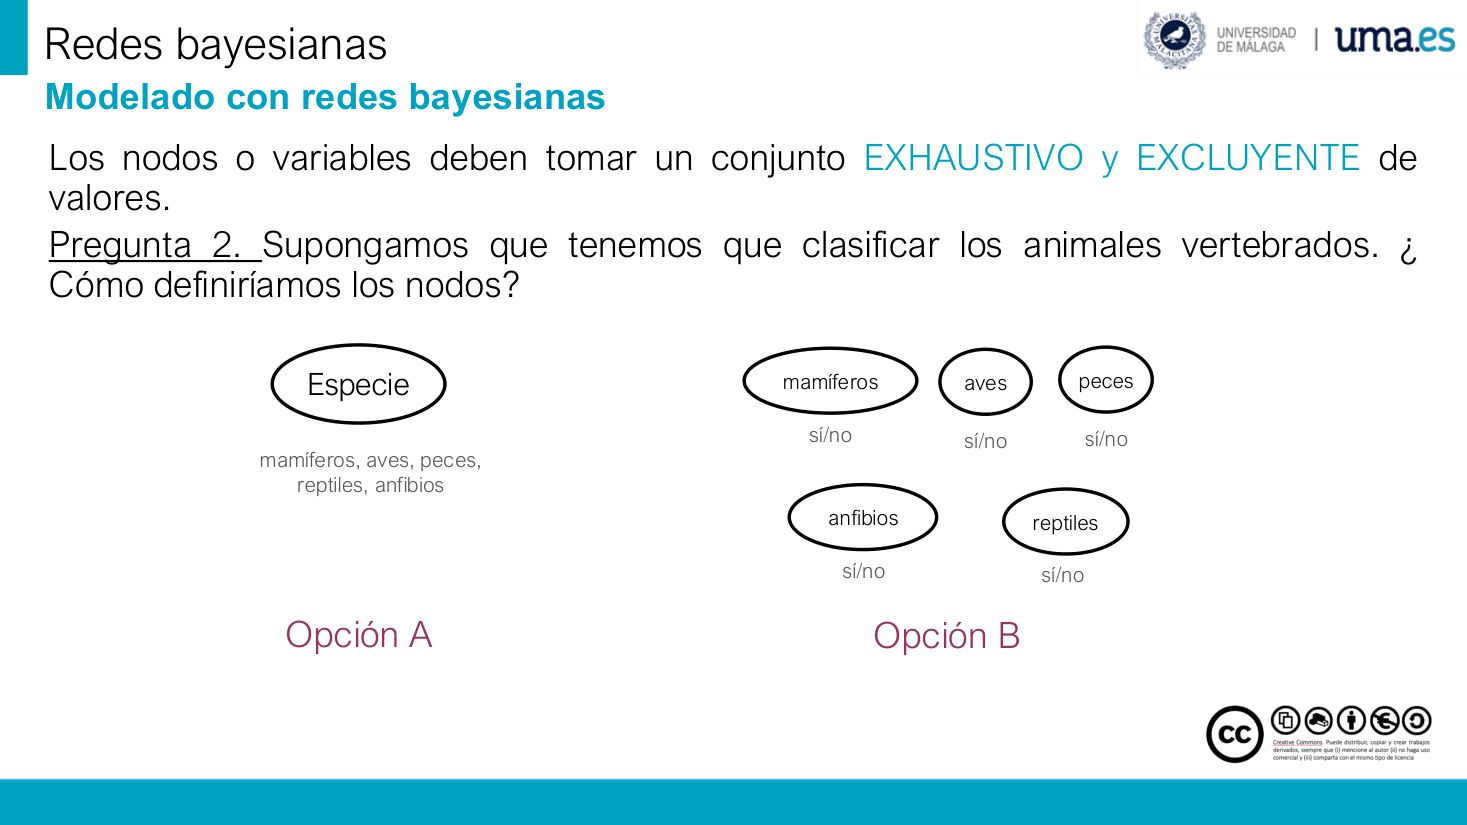
Los nodos o variables deben tomar un conjunto EXHAUSTIVO y EXCLUYENTE de valores.
节点(变量)必须取穷尽且互斥的取值集合。
Pregunta 2. Supongamos que tenemos que clasificar los animales vertebrados. ¿Cómo definiríamos los nodos?
问题 2:假设要给脊椎动物分类,节点该如何定义?
Opción A
方案 A(单个多值节点 Especie)。
Opción B
方案 B(每个类群一个二值节点)。
Especie
物种(一个节点)。
mamíferos, aves, peces, reptiles, anfibios
哺乳类、鸟类、鱼类、爬行类、两栖类(五个互斥取值)。
mamíferos
哺乳类(独立二值节点)。
aves
鸟类(独立二值节点)。
peces
鱼类(独立二值节点)。
reptiles
爬行类(独立二值节点)。
anfibios
两栖类(独立二值节点)。
sí/no
是/否(B 方案中每个节点的二值取值)。
| 方案 | 西语读法 | 判定 |
|---|---|---|
| A:Especie = mamíferos, aves, peces, reptiles, anfibios | «opción a, un nodo especie» | 正确:一只动物只属于一个类群,五个取值互斥且穷尽 |
| B:五个 sí/no 节点 | «opción b, cinco nodos binarios» | 错误:mamíferos=sí 且 aves=sí 会同时成立,不互斥;且要额外加约束才能保证穷尽 |
Pregunta 3: profesiones · 问题 3:按职业分类时的节点定义
▸ 原页截图 p.44
Redes bayesianas
贝叶斯网络(页眉)。
Modelado con redes bayesianas
用贝叶斯网络建模(副标题)。
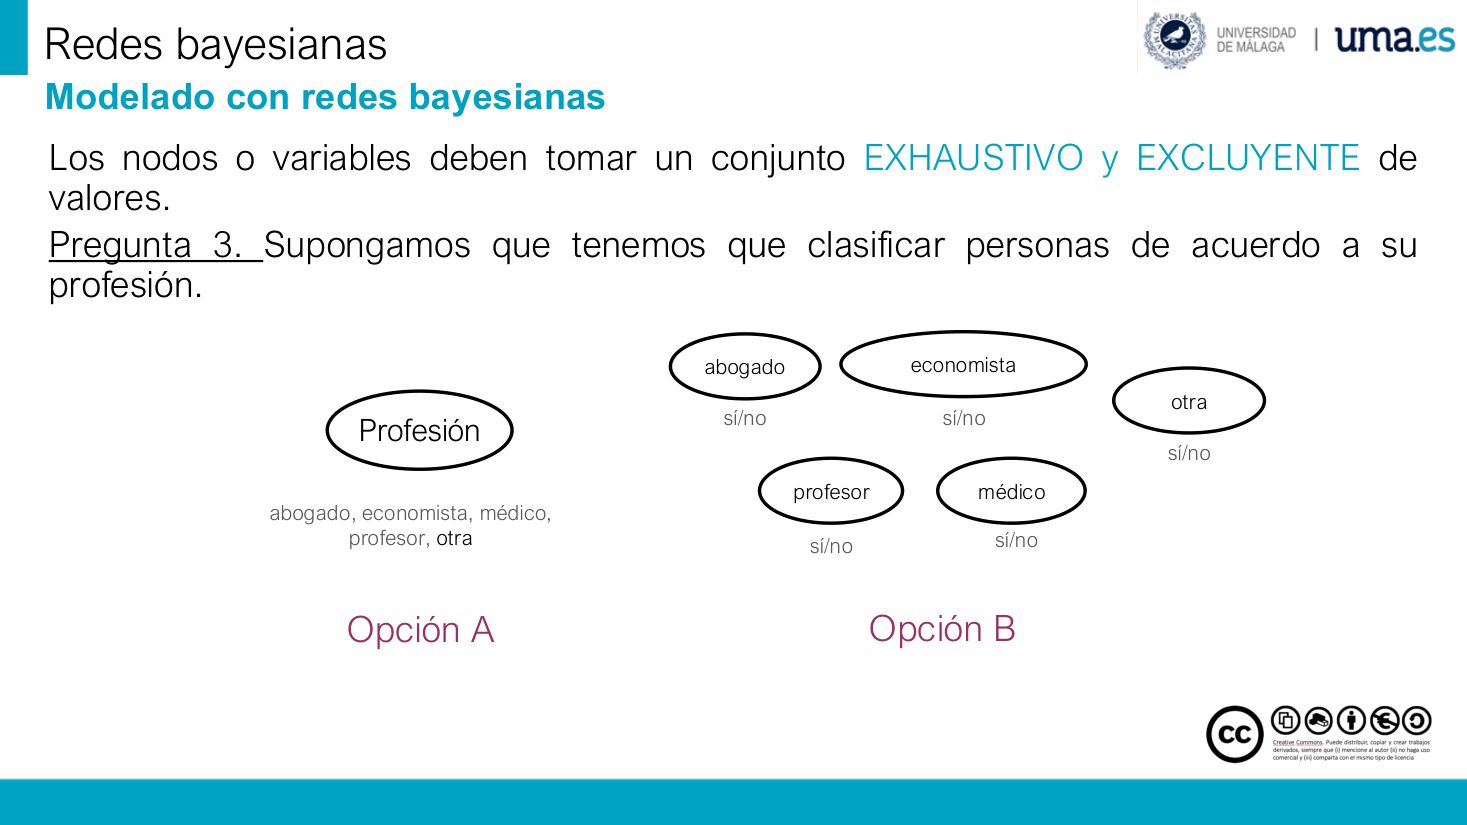
Los nodos o variables deben tomar un conjunto EXHAUSTIVO y EXCLUYENTE de valores.
节点(变量)必须取穷尽且互斥的取值集合。
Pregunta 3. Supongamos que tenemos que clasificar personas de acuerdo a su profesión.
问题 3:假设要按职业对人进行分类。
Opción A
方案 A(单个多值节点 Profesión)。
Opción B
方案 B(每个职业一个二值节点)。
Profesión
职业(一个节点)。
abogado, economista, médico, profesor, otra
律师、经济学家、医生、教师、其他(五个取值,最后一项保证穷尽)。
abogado
律师(独立二值节点)。
economista
经济学家(独立二值节点)。
médico
医生(独立二值节点)。
profesor
教师(独立二值节点)。
otra
其他(独立二值节点)。
sí/no
是/否(B 方案中每个节点的二值取值)。
| 方案 | 西语读法 | 判定 |
|---|---|---|
| A:Profesión = abogado, …, otra | «opción a, un nodo profesión» | 正确:一个人通常只有一个职业,取值互斥;«otra» 保证穷尽 |
| B:五个 sí/no 节点 | «opción b, cinco nodos binarios» | 错误:允许 abogado=sí 且 médico=sí 同时成立,不互斥 |
Pregunta 4: Gripe y Tos · 问题 4:因果箭头的方向(病 → 症状)
▸ 原页截图 p.45
Redes bayesianas
贝叶斯网络(页眉)。
Modelado con redes bayesianas
用贝叶斯网络建模(副标题)。
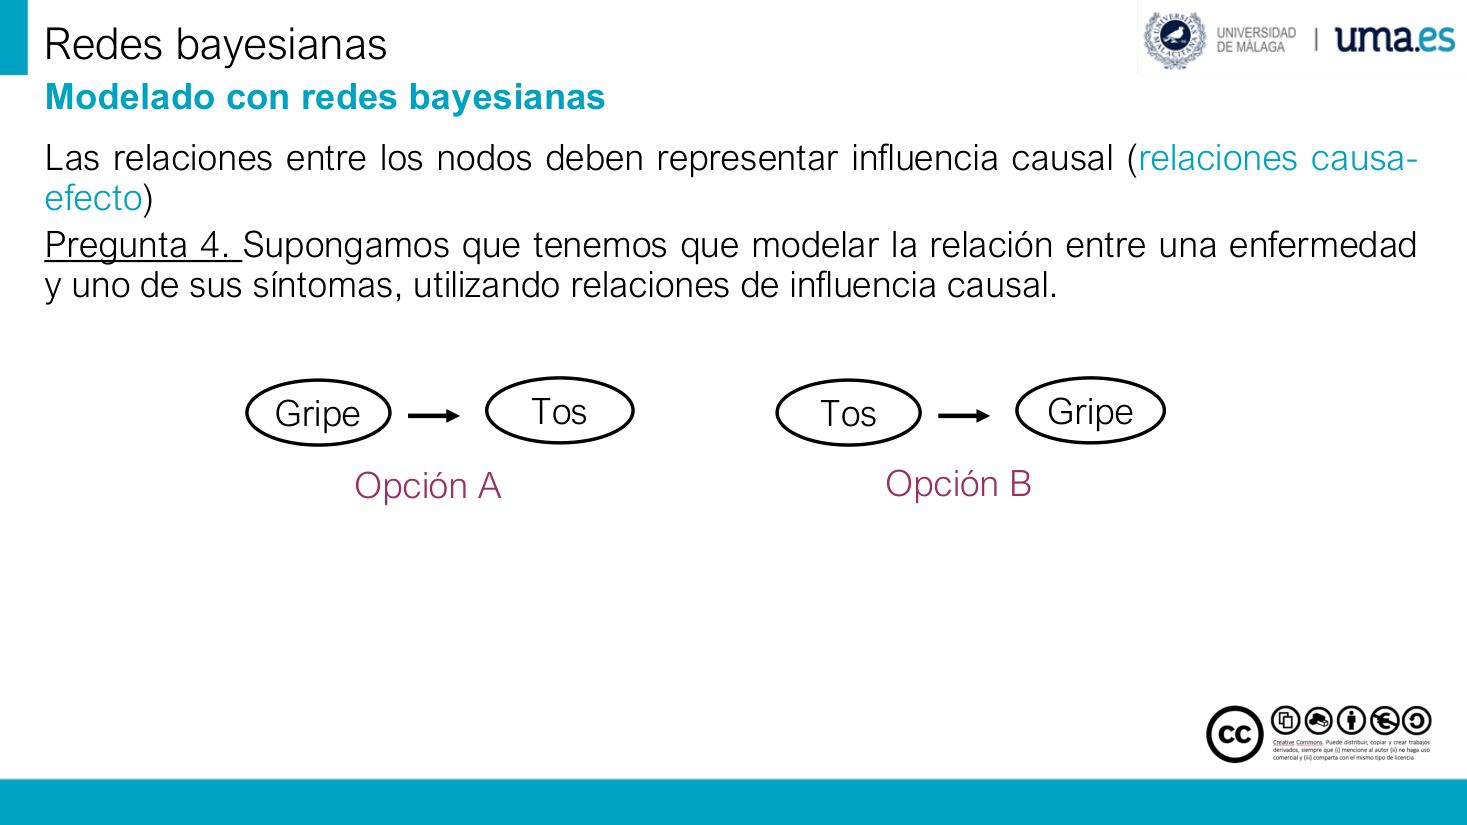
Las relaciones entre los nodos deben representar influencia causal (relaciones causa-efecto)
节点之间的关系必须表示
Pregunta 4. Supongamos que tenemos que modelar la relación entre una enfermedad y uno de sus síntomas, utilizando relaciones de influencia causal.
问题 4:假设要用因果影响关系来建模「一种疾病」与「它的一个症状」之间的关系。
Opción A
方案 A:Gripe → Tos。
Opción B
方案 B:Tos → Gripe。
Gripe
流感(原因)。
Tos
咳嗽(结果/症状)。
| 方案 | 西语读法 | 判定 |
|---|---|---|
| A:Gripe → Tos | «gripe causa tos» | 正确:疾病导致症状,箭头由原因指向结果,参数是 P(Tos/Gripe) |
| B:Tos → Gripe | «tos causa gripe» | 错误:症状不会引起疾病,因果方向反了 |
Pregunta 5: Pájaro y Vuela · 问题 5:动物类别与特征的箭头方向
▸ 原页截图 p.46
Redes bayesianas
贝叶斯网络(页眉)。
Modelado con redes bayesianas
用贝叶斯网络建模(副标题)。
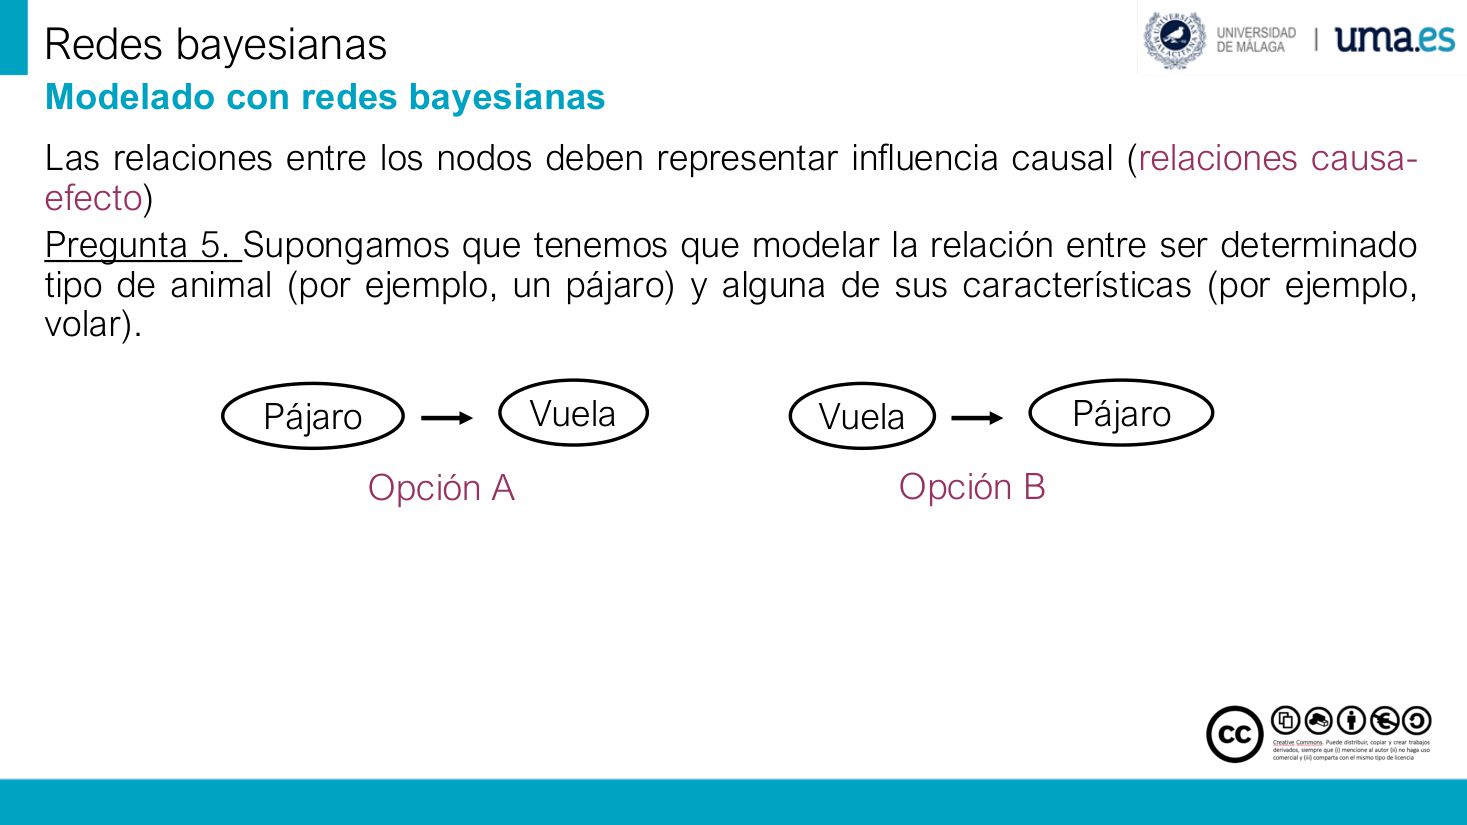
Las relaciones entre los nodos deben representar influencia causal (relaciones causa-efecto)
节点之间的关系必须表示因果影响(因果关系)。
Pregunta 5. Supongamos que tenemos que modelar la relación entre ser determinado tipo de animal (por ejemplo, un pájaro) y alguna de sus características (por ejemplo, volar).
问题 5:假设要建模「属于某种动物(例如鸟)」与「它的某个特征(例如会飞)」之间的关系。
Opción A
方案 A:Pájaro → Vuela。
Opción B
方案 B:Vuela → Pájaro。
Pájaro
鸟(原因:物种属性)。
Vuela
会飞(结果:可观察特征)。
| 方案 | 西语读法 | 判定 |
|---|---|---|
| A:Pájaro → Vuela | «pájaro causa volar» | 正确:物种决定能力,参数是 P(Vuela/Pájaro) |
| B:Vuela → Pájaro | «volar causa pájaro» | 错误:会飞不是成为鸟的原因(飞机、蝙蝠也会飞) |
九、定量建模:参数必须符合常识(Preguntas 6–7 与 OR / AND 关系)
p.47–p.50Modelado cuantitativo (parámetros) · 定量建模:Pregunta 6「流感—咳嗽」哪一行概率更大
▸ 原页截图 p.47
Redes bayesianas
贝叶斯网络(页眉)。
Modelado cuantitativo (parámetros)
Las
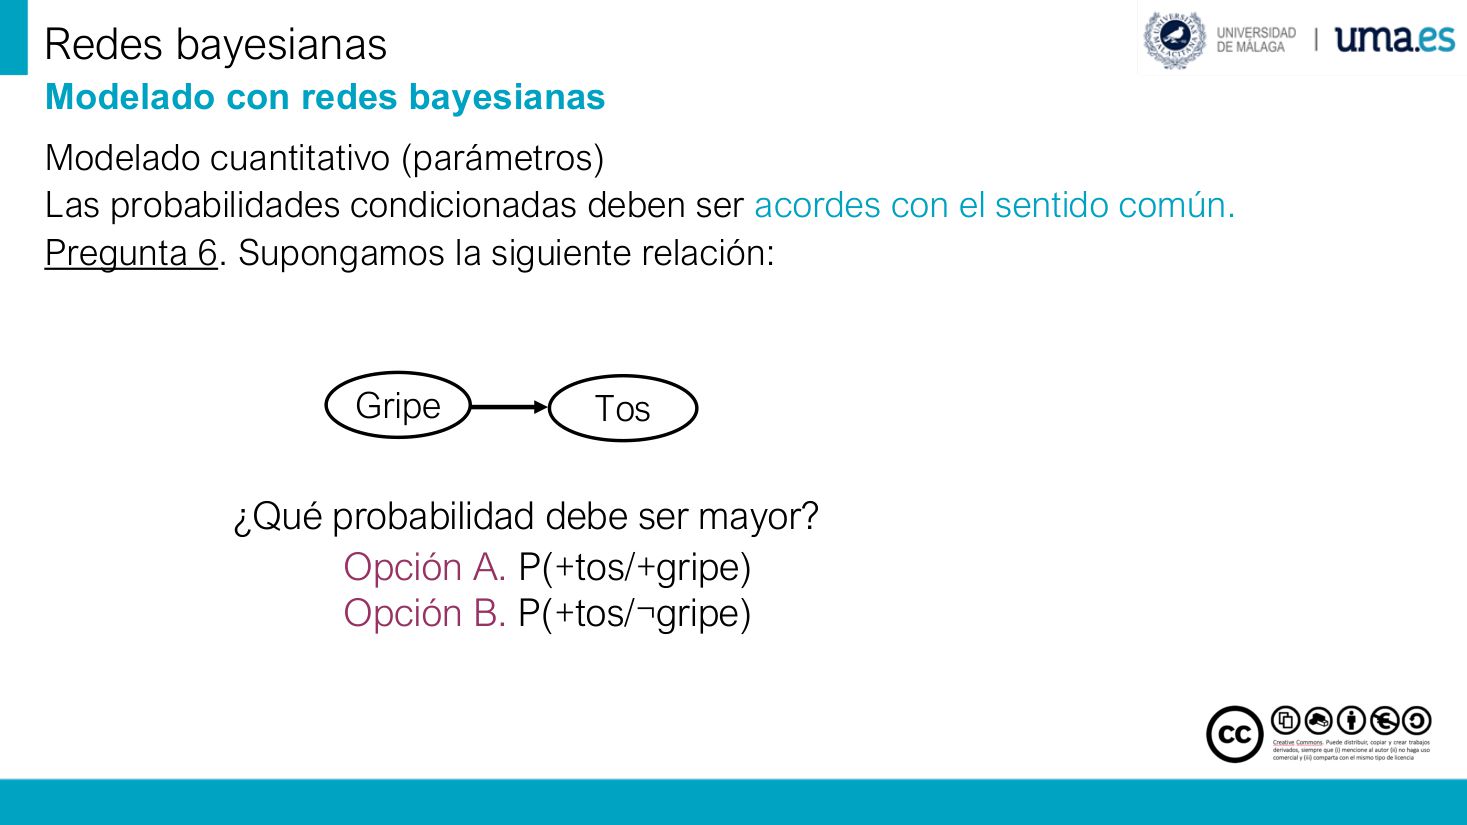
Pregunta 6. Supongamos la siguiente relación:
问题 6:假设存在下面这层关系:
Modelado con redes bayesianas
«用贝叶斯网络建模»——抽取层里残留的一行版式文本,本页截图中看不到这行字。
Gripe
流感(
Tos
咳嗽(子节点,箭头终点)。
¿Qué probabilidad debe ser mayor?
哪个概率应当更大?
Opción A. P(+tos/+gripe)
选项 A:P(+tos/+gripe),即「已知患流感时出现咳嗽」的概率。
Opción B. P(+tos/¬gripe)
选项 B:P(+tos/¬gripe),即「已知未患流感时出现咳嗽」的概率。
| 符号 | 西语读法 | 中文含义 |
|---|---|---|
| P(+tos/+gripe) | «probabilidad de tos dado gripe» | 患流感者的咳嗽概率(CPT 中 gripe=+ 那一行) |
| P(+tos/¬gripe) | «probabilidad de tos dado no gripe» | 未患流感者的咳嗽概率(CPT 中 gripe=¬ 那一行) |
| +tos | «tos presente» | 变量 Tos 取「有咳嗽」 |
| ¬gripe | «no gripe» | 变量 Gripe 取「无流感」(¬ 是否定) |
| / | «dado» | 条件符号:竖线前后的顺序是「结果 / 原因」 |
| 选项 | 西语读法 | 判定 |
|---|---|---|
| A:P(+tos/+gripe) | «probabilidad de tos dado gripe» | 更大 —— 正确:流感本身就会引起咳嗽 |
| B:P(+tos/¬gripe) | «probabilidad de tos dado no gripe» | 更小 —— 没有流感时,咳嗽只能由别的因素引起 |
Modelado cuantitativo (parámetros) · 定量建模:Pregunta 7「疫苗—流感」哪一行概率更大
▸ 原页截图 p.48
Redes bayesianas
贝叶斯网络(页眉)。
Las
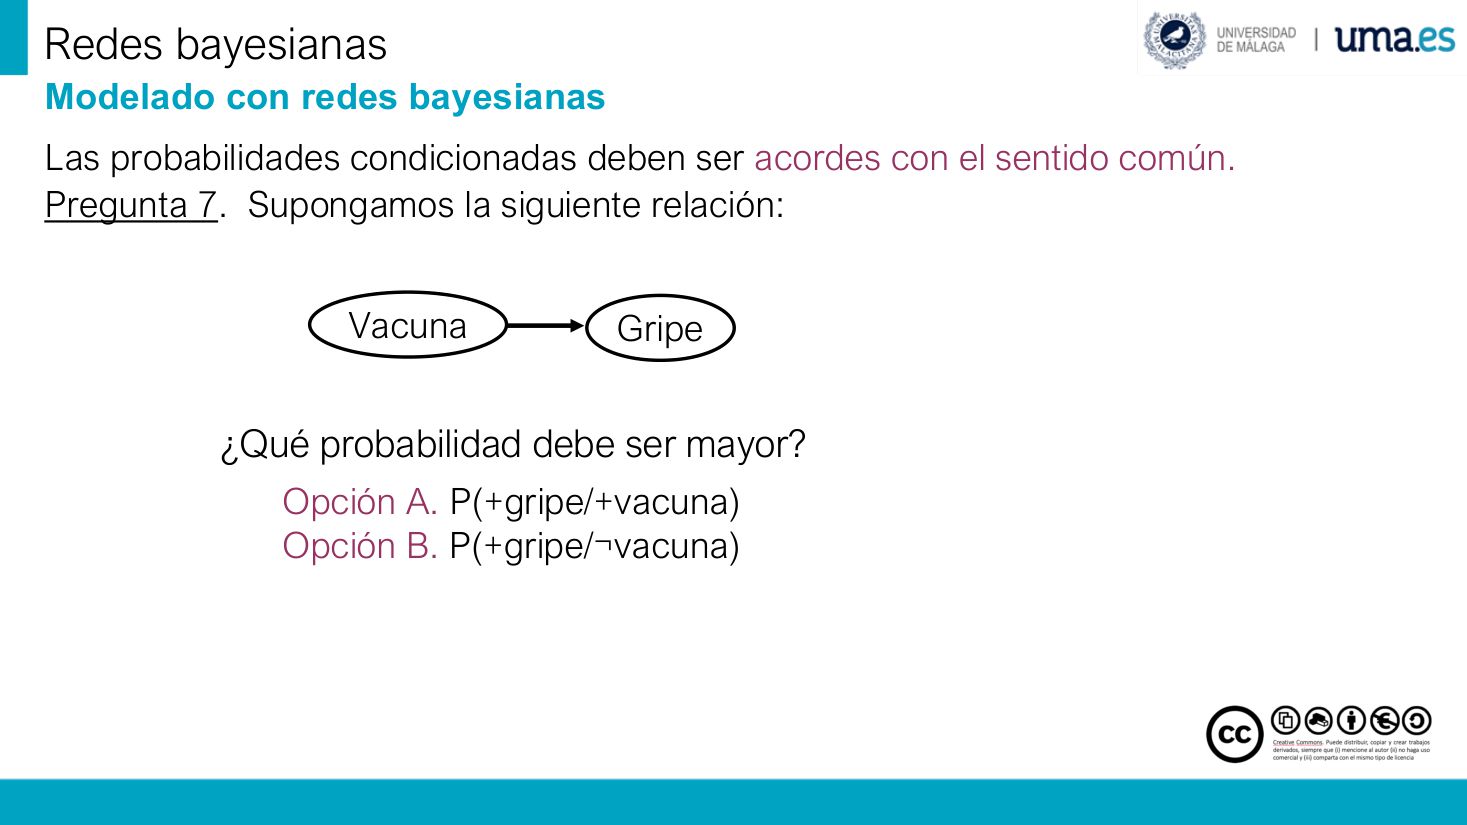
Pregunta 7. Supongamos la siguiente relación:
问题 7:假设存在下面这层关系:
Gripe
流感(子节点,箭头终点)。
¿Qué probabilidad debe ser mayor?
哪个概率应当更大?
Opción A. P(+gripe/+vacuna)
选项 A:P(+gripe/+vacuna),即「已知接种疫苗时仍患流感」的概率。
Opción B. P(+gripe/¬vacuna)
选项 B:P(+gripe/¬vacuna),即「已知未接种疫苗时患流感」的概率。
08497242
孤立数字串 08497242——抽取层残留,截图里没有这串数字。
| 符号 | 西语读法 | 中文含义 |
|---|---|---|
| P(+gripe/+vacuna) | «probabilidad de gripe dada vacuna» | 接种者的流感概率(CPT 中 vacuna=+ 那一行) |
| P(+gripe/¬vacuna) | «probabilidad de gripe dada no vacuna» | 未接种者的流感概率(CPT 中 vacuna=¬ 那一行) |
| +gripe | «gripe presente» | 变量 Gripe 取「患流感」 |
| +vacuna / ¬vacuna | «vacuna presente / no vacuna» | 是否接种(¬ 为否定) |
| Vacuna → Gripe | «vacuna causa (menos) gripe» | 箭头表示因果:接种影响患病 |
| 选项 | 西语读法 | 判定 |
|---|---|---|
| A:P(+gripe/+vacuna) | «probabilidad de gripe dada vacuna» | 更小 —— 疫苗的作用就是把这一行压下去 |
| B:P(+gripe/¬vacuna) | «probabilidad de gripe dada no vacuna» | 更大 —— 正确:不接种者更容易得流感 |
Modelado cuantitativo (parámetros) · 定量建模:OR 关系下四条条件概率的大小排序
▸ 原页截图 p.49
Redes bayesianas
贝叶斯网络(页眉)。
Modelado con redes bayesianas
用贝叶斯网络建模(副标题)。
Las
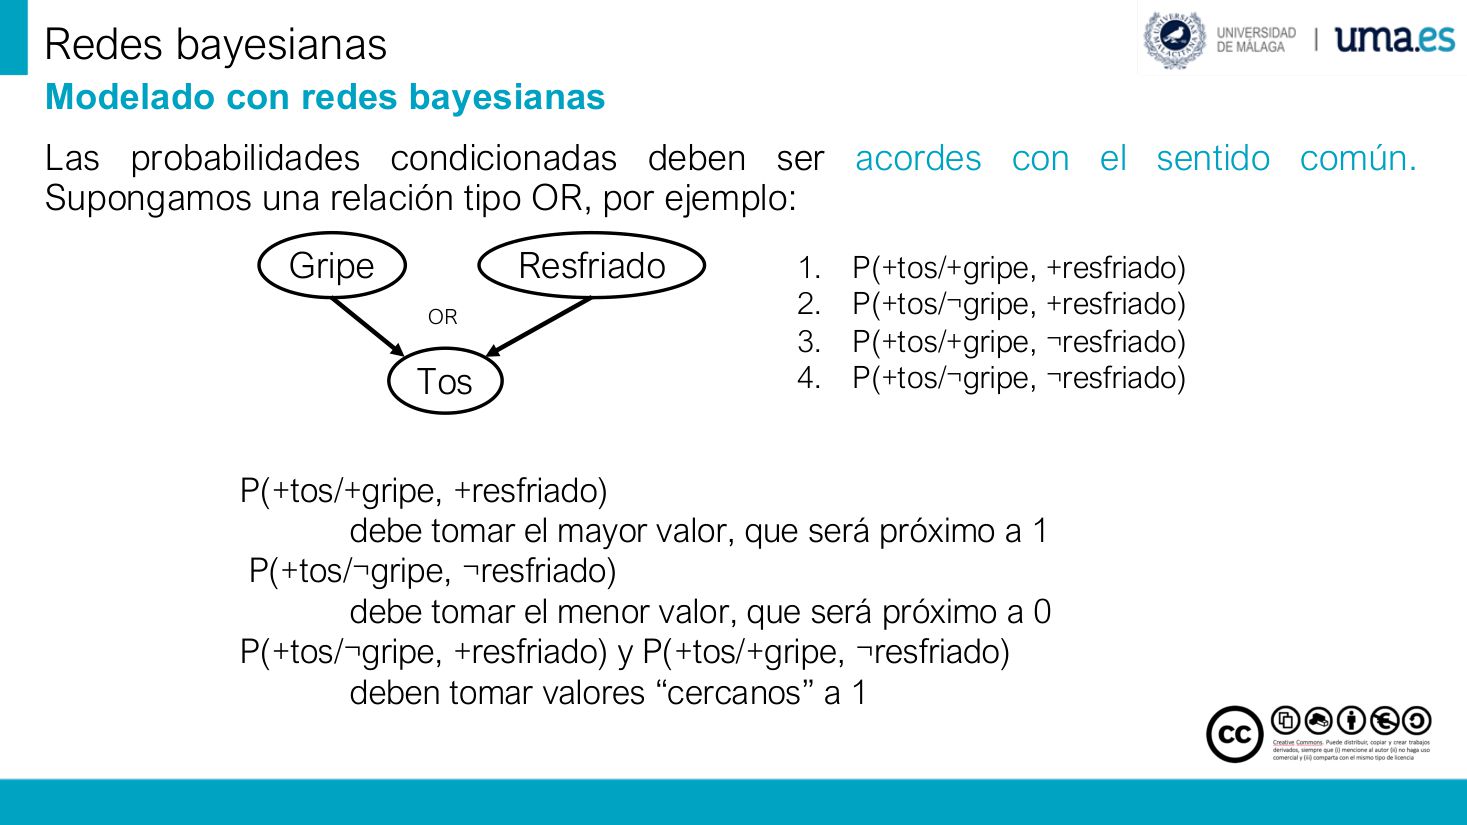
Supongamos una
假设存在一种
Gripe
流感(第一个父节点)。
Resfriado
感冒(第二个父节点)。
Tos
咳嗽(子节点,两个父节点共同指向)。
OR
图内标注 OR:两个原因「任意一个」都足以引起咳嗽。
1. P(+tos/+gripe, +resfriado)
① P(+tos/+gripe, +resfriado):两种病都有时咳嗽的概率。
2. P(+tos/¬gripe, +resfriado)
② P(+tos/¬gripe, +resfriado):无流感、有感冒时咳嗽的概率。
3. P(+tos/+gripe, ¬resfriado)
③ P(+tos/+gripe, ¬resfriado):有流感、无感冒时咳嗽的概率。
4. P(+tos/¬gripe, ¬resfriado)
④ P(+tos/¬gripe, ¬resfriado):两种病都没有时咳嗽的概率。
P(+tos/+gripe, +resfriado) debe tomar el mayor valor, que será próximo a 1
P(+tos/+gripe, +resfriado) 应取最大值,
P(+tos/¬gripe, ¬resfriado) debe tomar el menor valor, que será próximo a 0
P(+tos/¬gripe, ¬resfriado) 应取最小值,接近 0。
P(+tos/¬gripe, +resfriado) y P(+tos/+gripe, ¬resfriado) deben tomar valores “cercanos” a 1
P(+tos/¬gripe, +resfriado) 与 P(+tos/+gripe, ¬resfriado) 应取「
| 符号 | 西语读法 | 中文含义 |
|---|---|---|
| P(X/Y, Z) | «probabilidad de X dados Y y Z» | 两个父节点都给定时的条件概率(逗号=并且) |
| +tos | «tos presente» | 有咳嗽 |
| ¬gripe | «no gripe» | 无流感(¬ 为否定) |
| OR | «relación tipo o» | 或关系:任一父节点为 + 即触发结果 |
| próximo a 1 / a 0 | «cercano a uno / a cero» | 概率接近 1 / 接近 0 |
| 编号 | 条件(父节点取值) | 判定 | 概率 |
|---|---|---|---|
| 1 | +gripe, +resfriado | 两个原因同时在场 | 最大,≈1 |
| 2 | ¬gripe, +resfriado | 仅感冒在场(OR 已满足) | 接近 1 |
| 3 | +gripe, ¬resfriado | 仅流感在场(OR 已满足) | 接近 1 |
| 4 | ¬gripe, ¬resfriado | 两个原因都不在 | 最小,≈0 |
Modelado cuantitativo (parámetros) · 定量建模:AND 关系下四条条件概率的大小排序
▸ 原页截图 p.50
Redes bayesianas
贝叶斯网络(页眉)。
Modelado con redes bayesianas
用贝叶斯网络建模(副标题)。
Las
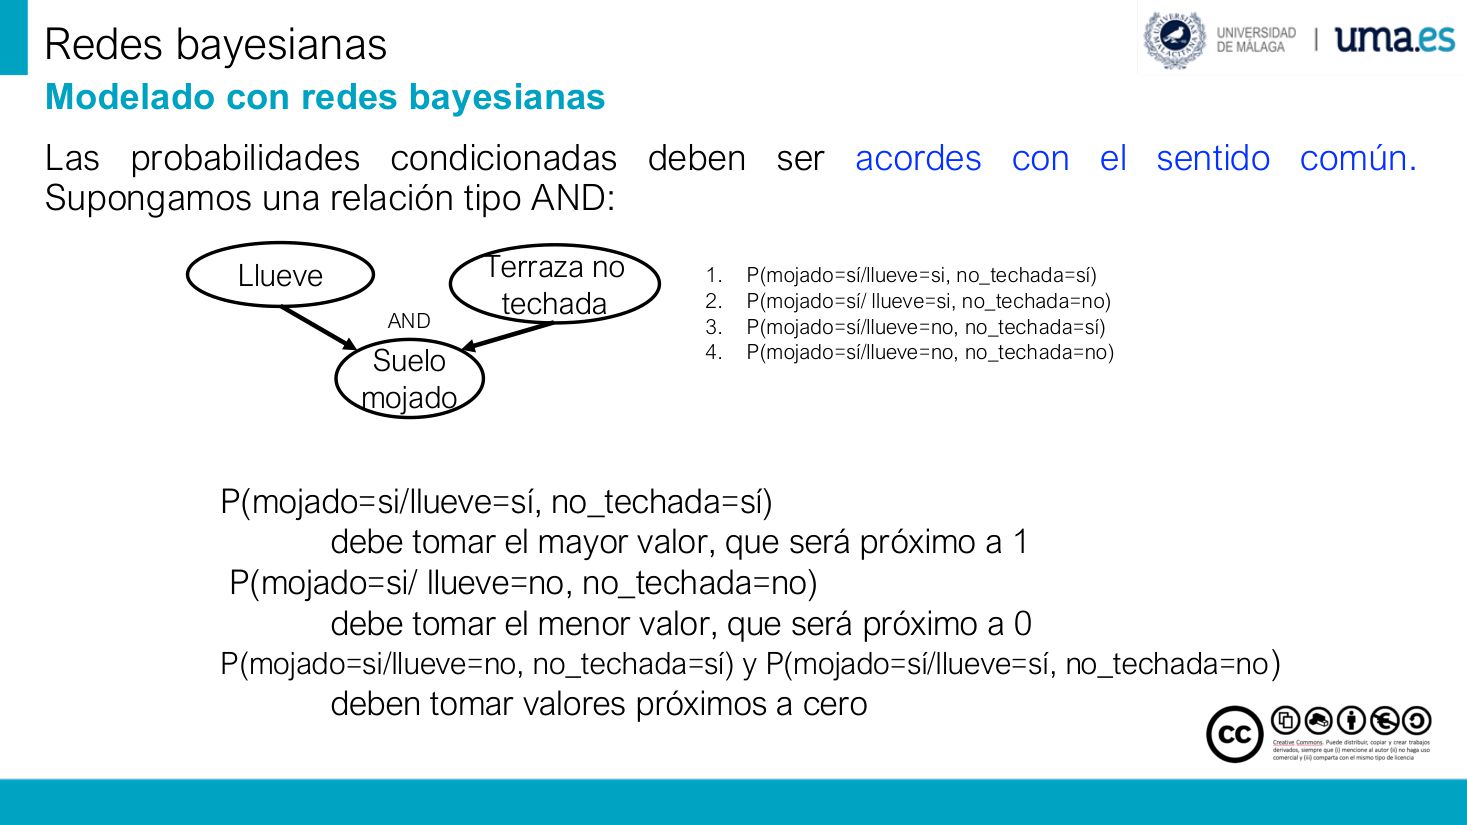
Supongamos una
假设存在一种
Llueve
下雨(第一个父节点)。
Terraza no techada
Suelo mojado
AND
图内标注 AND:两个原因「同时成立」才会出现结果。
1. P(mojado=sí/llueve=si, no_techada=sí)
① P(mojado=sí/llueve=si, no_techada=sí):下雨且露台无顶棚时地面湿的概率。
2. P(mojado=sí/ llueve=si, no_techada=no)
② P(mojado=sí/ llueve=si, no_techada=no):下雨但露台有顶棚时地面湿的概率。
3. P(mojado=sí/llueve=no, no_techada=sí)
③ P(mojado=sí/llueve=no, no_techada=sí):不下雨但露台无顶棚时地面湿的概率。
4. P(mojado=sí/llueve=no, no_techada=no)
④ P(mojado=sí/llueve=no, no_techada=no):不下雨且露台有顶棚时地面湿的概率。
P(mojado=si/llueve=sí, no_techada=sí) debe tomar el mayor valor, que será próximo a 1
P(mojado=si/llueve=sí, no_techada=sí) 应取最大值,接近 1。
P(mojado=si/ llueve=no, no_techada=no) debe tomar el menor valor, que será próximo a 0
P(mojado=si/ llueve=no, no_techada=no) 应取最小值,接近 0。
P(mojado=si/llueve=no, no_techada=sí) y P(mojado=sí/llueve=sí, no_techada=no) deben tomar valores próximos a cero
P(mojado=si/llueve=no, no_techada=sí) 与 P(mojado=sí/llueve=sí, no_techada=no) 应取接近 0 的值。
| 符号 | 西语读法 | 中文含义 |
|---|---|---|
| P(mojado=sí/llueve=sí, no_techada=sí) | «probabilidad de suelo mojado dado que llueve y la terraza no está techada» | 两因同时成立时的条件概率 |
| mojado=sí | «mojado igual a sí» | 变量取「湿」这一值(= 表示赋值,不是等号比较) |
| no_techada | «no techada» | 露台无顶棚(父节点名,取 sí / no) |
| AND | «relación tipo y» | 与关系:两个父节点都为 sí 才触发结果 |
| próximo a cero | «cercano a cero» | 概率接近 0 |
| 编号 | 条件(父节点取值) | 判定 | 概率 |
|---|---|---|---|
| 1 | llueve=sí, no_techada=sí | 两个原因同时在场 | 最大,≈1 |
| 2 | llueve=sí, no_techada=no | 有顶棚拦住雨水(AND 未满足) | 接近 0 |
| 3 | llueve=no, no_techada=sí | 没有雨(AND 未满足) | 接近 0 |
| 4 | llueve=no, no_techada=no | 两个原因都不在 | 最小,≈0 |
十、建模导航:四步法与五个经典例子
p.51–p.58Guía para el modelado con redes bayesianas · 贝叶斯网络建模的四步总纲
▸ 原页截图 p.51
Redes bayesianas
贝叶斯网络(页眉)。
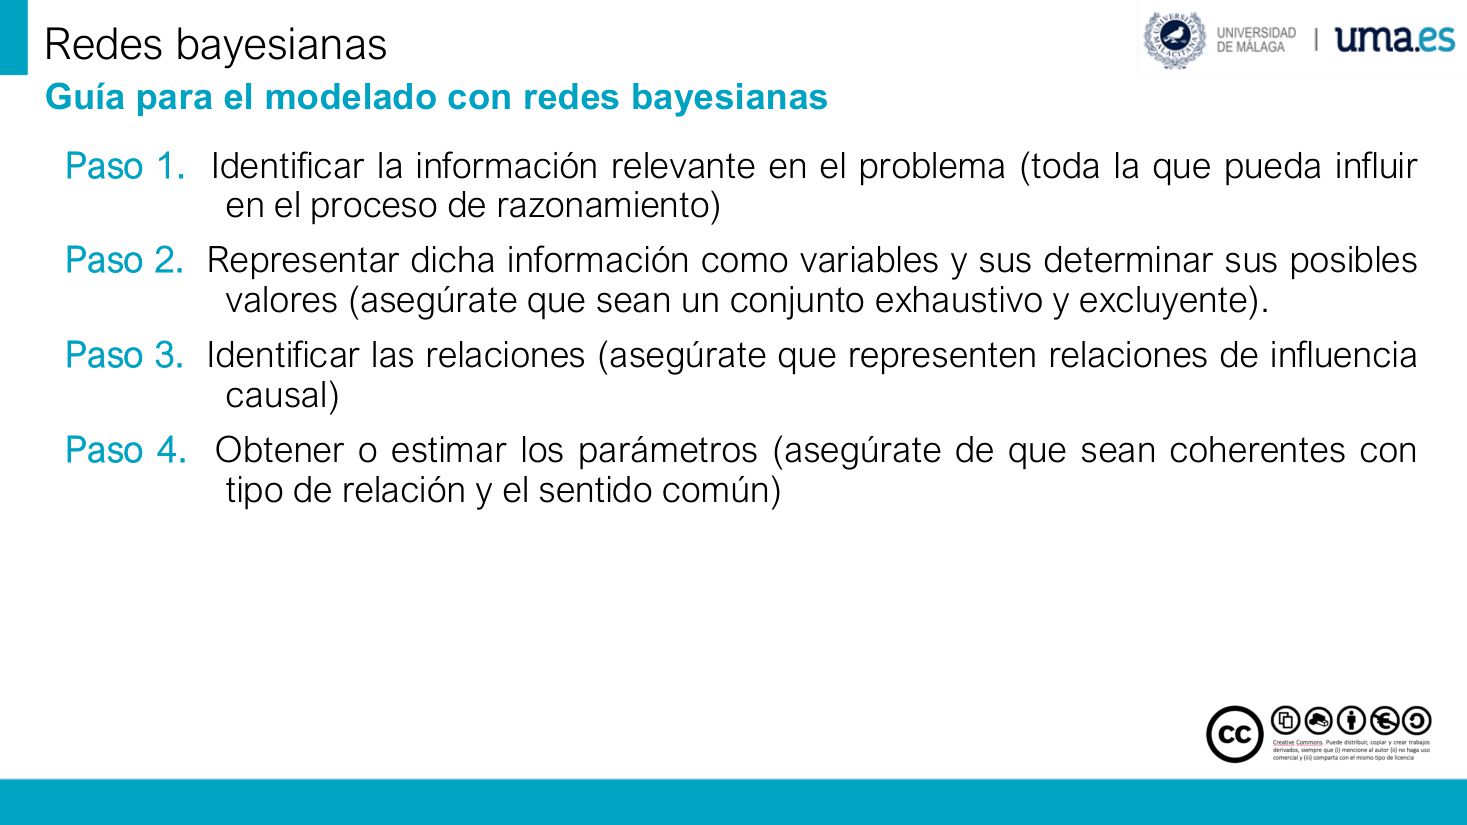
Paso 1.
第 1 步:
Paso 2.
第 2 步:把这些信息
Paso 3. Identificar las
第 3 步:识别
Paso 4. Obtener o
第 4 步:获得或
Guía para el modelado con redes bayesianas
用贝叶斯网络建模的指南(本页标题)。
| 步骤 | 原文关键词 | 中文动作 | 产出物 |
|---|---|---|---|
| Paso 1 | información relevante | 圈出所有会影响判断的信息 | 一张「素材清单」 |
| Paso 2 | variables / valores | 把素材改写成变量并列出取值 | 节点表 + 取值域(穷尽且互斥) |
| Paso 3 | influencia causal | 只连因果箭头,不连相关箭头 | 有向无环图(DAG) |
| Paso 4 | parámetros | 填条件概率表,检查是否符合常识 | CPT / 噪声参数 |
Ejemplo modelado 1: el ejemplo del estornudo · 建模实例 1:打喷嚏的故事
▸ 原页截图 p.52
Redes bayesianas
贝叶斯网络(页眉)。
Una tarde, Luis va a visitar a su compañero de oficina Antonio, y de repente comienza a
一天下午,Luis 去拜访他的办公室同事 Antonio,突然开始
Luis piensa que se ha
Luis 以为自己
Pero de repente observa que los muebles de Antonio están
但他忽然发现 Antonio 的家具上有
Ejemplo modelado 1: el ejemplo del estornudo
建模实例 1:打喷嚏的例子(本页标题)。
Paso 1. Identificación información relevante / Paso 2. Definición de variables · 实例 1:筛信息、定变量
▸ 原页截图 p.53
Redes bayesianas
贝叶斯网络(页眉)。
Paso 1. Identificación información relevante
第 1 步:识别相关信息。
Una tarde, Luis va a visitar a su compañero de oficina Antonio, y de repente comienza a estornudar.
一天下午,Luis 去拜访他的办公室同事 Antonio,突然开始打喷嚏。
Luis piensa que se ha resfriado.
Luis 以为自己感冒了。
Pero de repente observa que los muebles de Antonio están arañados, de forma que se le ocurre que quizás su amigo tenga un gato y sus estornudos se deban a una crisis producida por una rinitis alérgica.
但他忽然发现 Antonio 的家具被猫抓过,于是想到:也许朋友养了猫,而自己的喷嚏是过敏性鼻炎发作所致。
Paso 2. Definición de variables
第 2 步:定义变量。
•
•
•
•
•
•
•
•
•
•
•
•
Ejemplo modelado 1: ejemplo del estornudo
建模实例 1:打喷嚏的例子(页脚标题)。
| 变量 | 中文 | 取值域 | 为什么必须穷尽且互斥 |
|---|---|---|---|
| Estornudo | 喷嚏 | {sí, no} | 要么打要么不打,不能既打又不打 |
| Resfriado | 感冒 | {sí, no} | 二分状态,覆盖全部可能 |
| Arañazos | 抓痕 | {sí, no} | 它是可观察的「证据」节点 |
| Gato | 养猫 | {sí, no} | 解释抓痕的原因 |
| Rinitis | 鼻炎 | {sí, no} | 解释喷嚏,且由猫+过敏共同触发 |
| Alergia | 过敏 | {sí, no} | 与 Gato 一起构成 AND 关系的两个父节点 |
Paso 3. Identificar relaciones causales / Paso 4. Estimar probabilidades · 实例 1:连因果、估概率
▸ 原页截图 p.54
Redes bayesianas
贝叶斯网络(页眉)。
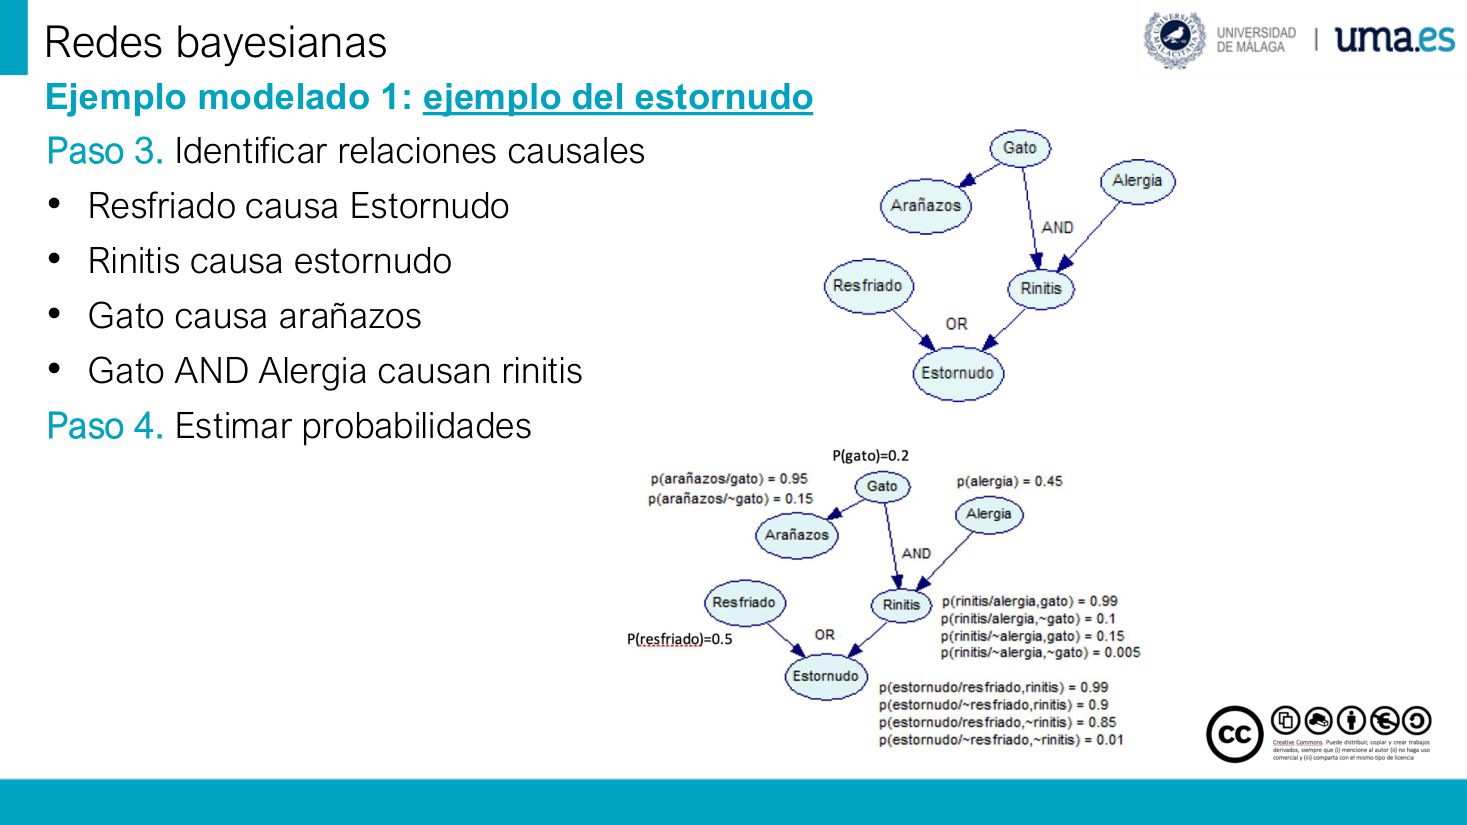
Paso 3. Identificar relaciones causales
第 3 步:识别因果关系。
•
•
•
•
•
•
• Gato AND Alergia causan rinitis
• 猫 AND 过敏共同导致鼻炎(注意这是 AND 关系,两个原因缺一不可)。
Paso 4. Estimar probabilidades
第 4 步:估计概率。
Ejemplo modelado 1: ejemplo del estornudo
建模实例 1:打喷嚏的例子(页脚标题)。
| 父 → 子 | 关系类型 | 中文 | 含义 |
|---|---|---|---|
| Resfriado → Estornudo | causal simple | 感冒 → 喷嚏 | 单父节点直线因果 |
| Rinitis → Estornudo | causal simple | 鼻炎 → 喷嚏 | 与上一条并列,两个原因都指向喷嚏 |
| Gato → Arañazos | causal simple | 猫 → 抓痕 | 这一支用于「从抓痕反推有没有猫」 |
| Gato, Alergia → Rinitis | AND | 猫 + 过敏 → 鼻炎 | 两个条件同时成立才产生鼻炎 |
Ejemplo modelado 2: red Asia · 建模实例 2:Asia 医疗网络
▸ 原页截图 p.55
Redes bayesianas
贝叶斯网络(页眉)。
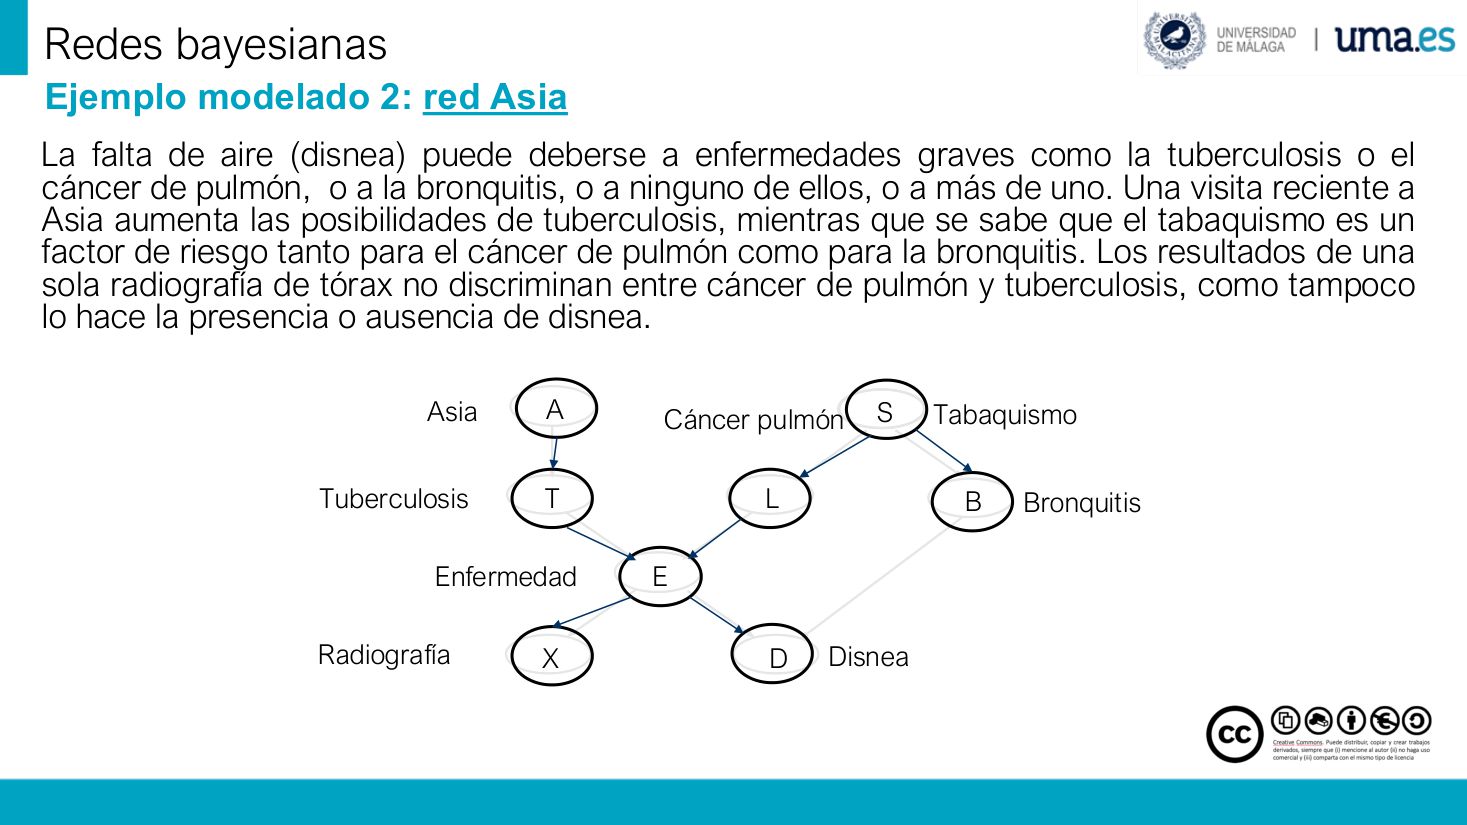
La falta de aire (
Una visita reciente a Asia aumenta las posibilidades de tuberculosis, mientras que se sabe que el
近期去过亚洲会增加患肺结核的可能性;而人们已知
Los resultados de una sola
单张
Ejemplo modelado 2: red Asia
建模实例 2:Asia 网络(本页标题)。
X
X = 节点 «Radiografía»(X 光片,X-ray 的首字母)。
D
D = 节点 «Disnea»(呼吸困难)。
T
T = 节点 «Tuberculosis»(肺结核)。
A
A = 节点 «Asia»(是否近期去过亚洲)。
L
L = 节点 «Cáncer de pulmón»(肺癌,Lung cancer)。
B
B = 节点 «Bronquitis»(支气管炎)。
S
S = 节点 «Tabaquismo»(吸烟,Smoking)。
E
E = 节点 «Enfermedad»(疾病,即 Tuberculosis 或 Cáncer 的统称节点)。
Asia
Asia:是否近期去过亚洲(根节点,无父节点)。
Tuberculosis
Tuberculosis:肺结核。
Cáncer pulmón
Cáncer pulmón:肺癌。
Tabaquismo
Tabaquismo:吸烟。
Bronquitis
Bronquitis:支气管炎。
Radiografía
Radiografía:X 光片(可观察证据)。
Disnea
Disnea:呼吸困难(可观察证据)。
Enfermedad
Enfermedad:疾病(Tuberculosis 或 Cáncer pulmón 的「或」节点)。
| 缩写 | 西语节点 | 中文 | 父节点 |
|---|---|---|---|
| A / X | Asia | 去过亚洲 | 无(根节点) |
| S | Tabaquismo | 吸烟 | 无(根节点) |
| T | Tuberculosis | 肺结核 | Asia |
| L | Cáncer pulmón | 肺癌 | Tabaquismo |
| B | Bronquitis | 支气管炎 | Tabaquismo |
| E | Enfermedad | 疾病(T 或 L) | Tuberculosis, Cáncer pulmón(OR) |
| R | Radiografía | X 光片 | Enfermedad |
| D | Disnea | 呼吸困难 | Enfermedad, Bronquitis(OR) |
Ejemplo modelado 3: un problema de diagnóstico · 建模实例 3:诊断问题(Luisito 呕吐)
▸ 原页截图 p.56
Redes bayesianas
贝叶斯网络(页眉)。
Considera la siguiente situación: Los padres de Luisito, que acaba de cumplir un año, deciden llevarlo al
设想这样一个情境:Luisito 刚满一岁,他父母因为他
Con el pediatra sostienen la siguiente conversación:
他们与医生进行了下面这段对话:
Pediatra -. Denme toda la información que consideren que puede ser relevante.
医生:把你们认为可能相关的所有信息都告诉我。
Mamá-. El otro día Luisito estaba
妈妈:前几天 Luisito
Vomitó el biberón de la noche, creo que por culpa de los
他把晚上的奶瓶吐了,我觉得是
Otras veces parece que vomita por una pequeña
另外几次看起来是因为轻微
Papá-. Además, creo que debe saber que mi hermano es
爸爸:另外我想您该知道,我哥哥是
Los vómitos son uno de sus
呕吐是它最
Se cree que tiene cierta
一般认为它带有一定的
Pediatra-. ¿Y la
医生:那 Luisito 的
Ambos-. Sí, desde hace unos meses.
父母:有,已经吃了好几个月了。
Plantea este problema de diagnóstico mediante una red bayesiana
请用贝叶斯网络来表述这个诊断问题。
Ejemplo modelado 3: un problema de diagnóstico
建模实例 3:一个诊断问题(页脚标题)。
| 对话线索 | 可建成的变量 | 中文 | 角色 |
|---|---|---|---|
| vomita con frecuencia | Vómito | 呕吐 | 目标 / 待解释现象 |
| estaba resfriado / mocos | Resfriado, Mocos | 感冒、鼻涕 | 暂时性原因 |
| pequeña indigestión | Indigestión | 消化不良 | 暂时性原因 |
| mi hermano es celíaco | Antecedente familiar | 家族史 | 遗传风险因素 |
| la dieta incluye gluten | Dieta con gluten | 含麸质饮食 | 触发 / 必要条件 |
| celiaquía | Celiaquía | 乳糜泻 | 隐藏病因(不可直接观察) |
Ejemplo modelado 4: un problema de clasificación · 建模实例 4:Zyx 星球动物分类
▸ 原页截图 p.57
Redes bayesianas
贝叶斯网络(页眉)。
En el planeta Zyx se pueden encontrar varias clases de animales, llamemos a estas clases
在 Zyx 星球上可以找到几类动物,我们把这些类别称作
Todos tienen un tamaño muy pequeño, y sus pieles son o bien
它们体型都很小,皮肤要么是
Además, una observación atenta ha permitido deducir lo siguiente:
此外,仔细观察使人们推断出以下事实:
• Todos los Wurros tienen 5 ó 6
• 所有 Wurros 都有 5 或 6 条
Su
它们的
• El número de patas de las Hobexas es un entero que varía
• Hobexas 的腿数是一个在 4 到 6 之间(含两端)
Su piel es escamosa.
它们的皮肤是鳞状的。
• En cuanto a las Wackas, tienen 4 ó 5 patas, y ofrecen a la vista una
• 至于 Wackas,它们有 4 或 5 条腿,看起来几乎总是蓝色
• Los animales que tienen un número
• 腿数为
Los animales que tienen un número
腿数为
Plantea el problema de la clasificación de animales de Zyx mediante una red bayesiana
请用贝叶斯网络表述 Zyx 动物的分类问题。
Ejemplo modelado 4: un problema de clasificación
建模实例 4:一个分类问题(页脚标题)。
| 变量 | 西语取值 | 中文 | 类型 |
|---|---|---|---|
| Clase | {Wurro, Hobexa, Wacka} | 动物类别 | 目标(待分类) |
| Patas | {4, 5, 6} | 腿数 | 可观察,受类别影响 |
| Piel | {escamosa, pelo} | 皮肤 | 可观察 |
| Color | {rojizo, azul} | 颜色 | 可观察(Wacka 20% 红) |
| Cojea | {sí, no} | 是否跛行 | 可观察,由腿数奇偶 + 异常决定 |
Ejemplo modelado 5: El problema de Monty Hall · 建模实例 5:Monty Hall 三门问题
▸ 原页截图 p.58
Redes bayesianas
贝叶斯网络(页眉)。
En el concurso televisivo Let´s Make a Deal, al concursante se le propone que elija una
在电视节目《Let's Make a Deal》中,主持人让参赛者从三扇
Su
他的
Una de ellas oculta un
其中一扇门后藏着一辆
Una vez que el concursante ha elegido una puerta, el
参赛者选定一扇门后,
En ese momento, el concursante tiene la opción de
此时,参赛者可以选择
¿Debe el concursante
参赛者应当
• Debe mantener su elección original
• 应当保持最初的选择。
• Debe cambiar
• 应当更换。
• En realidad, da igual lo que haga
• 其实怎么做都一样。
Ejemplo modelado 5: El problema de Monty Hall
建模实例 5:Monty Hall 问题(页脚标题)。
| 初始选择 | 车的位置 | 先验概率 | 换门后的胜率 |
|---|---|---|---|
| 1 号 | 1 号 | 1/3 | 0(换就输) |
| 1 号 | 2 号 | 1/3 | 1(换就赢) |
| 1 号 | 3 号 | 1/3 | 1(换就赢) |
十一、变量类型与关系方向:为什么模型里只能画因果
p.59–p.66Guía para el modelado con redes bayesianas · 建模指南(复习版:四步与三条括号提醒)
▸ 原页截图 p.59
Redes bayesianas
贝叶斯网络(页眉)。
Guía para el modelado con redes bayesianas
用贝叶斯网络建模的指南(本页标题)。
Paso 1. Identificar la información relevante en el problema
第 1 步:识别问题中相关的信息。
(toda la que pueda influir en el proceso de razonamiento)
(一切可能影响推理过程的信息。)
Paso 2. Representar dicha información como variables y sus determinar sus posibles valores
第 2 步:把这些信息表示成变量,并确定它们可能的取值。
(asegúrate que sean un conjunto exhaustivo y excluyente).
(务必使取值构成穷尽且互斥的集合。)
Paso 3. Identificar las relaciones
第 3 步:识别关系。
(asegúrate que representen relaciones de influencia causal)
(务必让它们表示因果关系。)
Paso 4. Obtener o estimar los parámetros
第 4 步:获得或估计参数。
(asegúrate de que sean coherentes con tipo de relación y el sentido común)
(务必使参数与关系类型及常识相符。)
Más sobre modelado
更多关于建模的内容(章节标题)。
Más sobre modelado: Identificación de las variables · 建模进阶:如何找变量(诊断类问题的四问)
▸ 原页截图 p.60
Redes bayesianas
贝叶斯网络(页眉)。
Por ejemplo, en problemas de
例如,在
• ¿Cuál es la
• 提出的
• ¿Qué posibles
• 有哪些可能的
• ¿Qué otros
• 还有哪些
• ¿De qué
• 有哪些
Más sobre modelado: Identificación de las variables
建模进阶:变量的识别(本页标题)。
| 提问 | 西语关键词 | 对应节点类型 | 例(Asia) |
|---|---|---|---|
| 问 1 | situación / problema | 目标节点(结果) | Disnea |
| 问 2 | causas | 病因节点 | Tuberculosis, Cáncer, Bronquitis |
| 问 3 | factores | 危险 / 保护因素 | Asia, Tabaquismo |
| 问 4 | evidencia | 可观察证据 | Radiografía |
Tipos de variables · 建模进阶:变量类型一览(目标 / 观察 / 因素 / 辅助)
▸ 原页截图 p.61
Redes bayesianas
贝叶斯网络(页眉)。
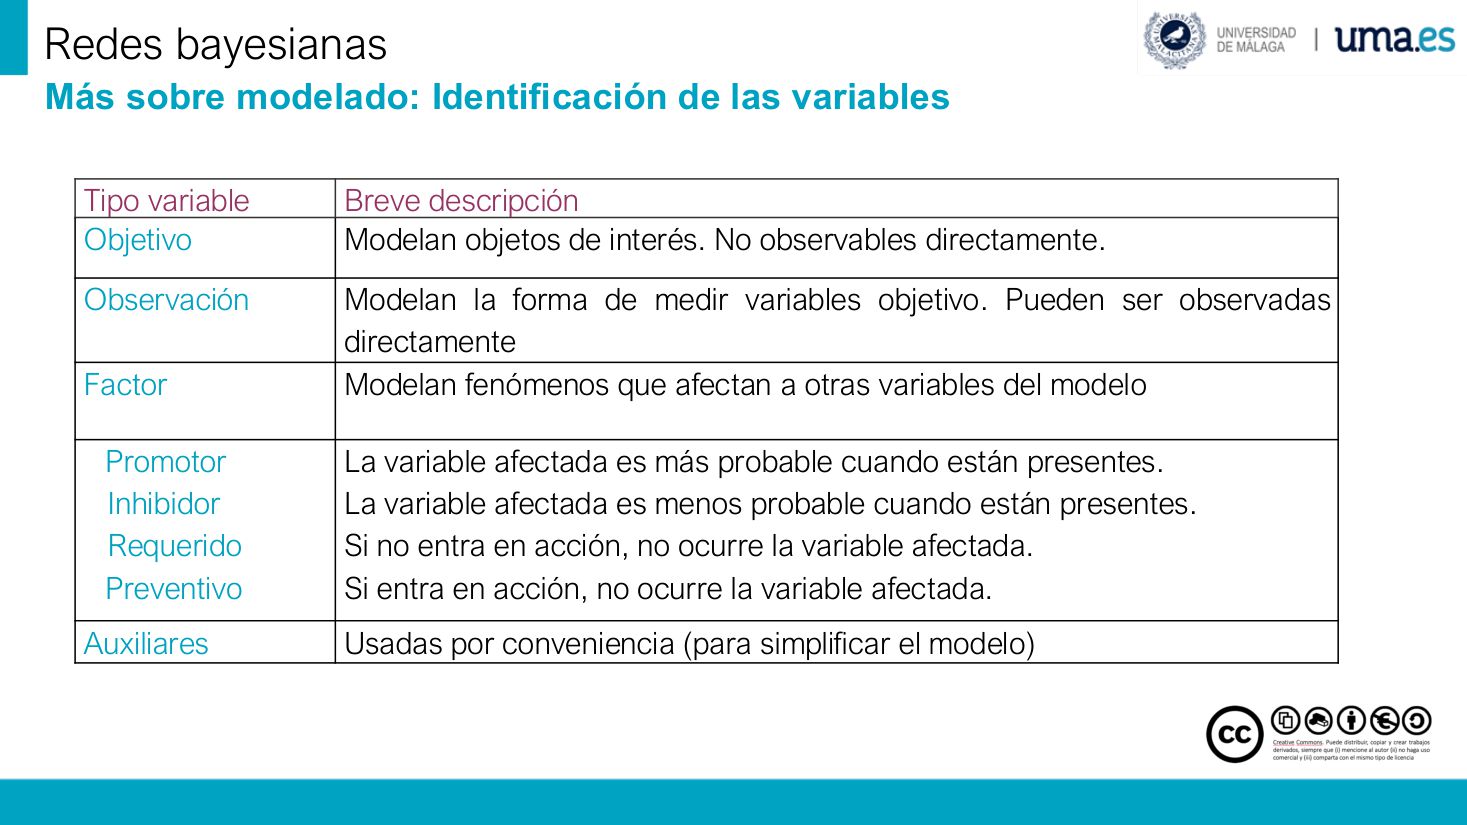
Tipo variable
变量类型(表头第一列;原文缺 «de»,见下方勘误)。
Breve descripción
简要说明(表头第二列)。
Modelan objetos de interés. No observables directamente.
对感兴趣的对象建模,不能直接观察。
Modelan la forma de medir variables objetivo. Pueden ser observadas directamente
对目标变量的测量方式建模,可以被直接观察。
Modelan fenómenos que afectan a otras variables del modelo
对会影响模型中其他变量的现象建模。
Promotor
La variable afectada es más probable cuando están presentes.
它们存在时,被影响的变量更可能发生。
Inhibidor
La variable afectada es menos probable cuando están presentes.
它们存在时,被影响的变量更不可能发生。
Requerido
Si no entra en acción, no ocurre la variable afectada.
若它不成立,被影响的变量就不会发生。
Preventivo
Si entra en acción, no ocurre la variable afectada.
若它成立,被影响的变量就不会发生。
Auxiliares
Usadas por conveniencia (para simplificar el modelo)
为方便而使用(用于简化模型)。
Más sobre modelado: Identificación de las variables
建模进阶:变量的识别(本页标题)。
| 类型 | 能否观察到 | 在模型里的位置 | 典型例子 |
|---|---|---|---|
| Objetivo | 否 | 我们真正想推断的对象 | Enfermedad |
| Observación | 是 | 目标变量的「测量口」 | Prueba, Radiografía |
| Factor | 视情况 | 指向其他变量的入边来源 | Gato, Tabaquismo |
| Auxiliar | — | 只为压缩参数而设 | 中间汇总节点 |
Más sobre modelado: relaciones · 建模进阶:两类关系(因果 vs 诊断)
▸ 原页截图 p.62
Redes bayesianas
贝叶斯网络(页眉)。
Más sobre modelado: relaciones
建模进阶:关系(本页标题)。
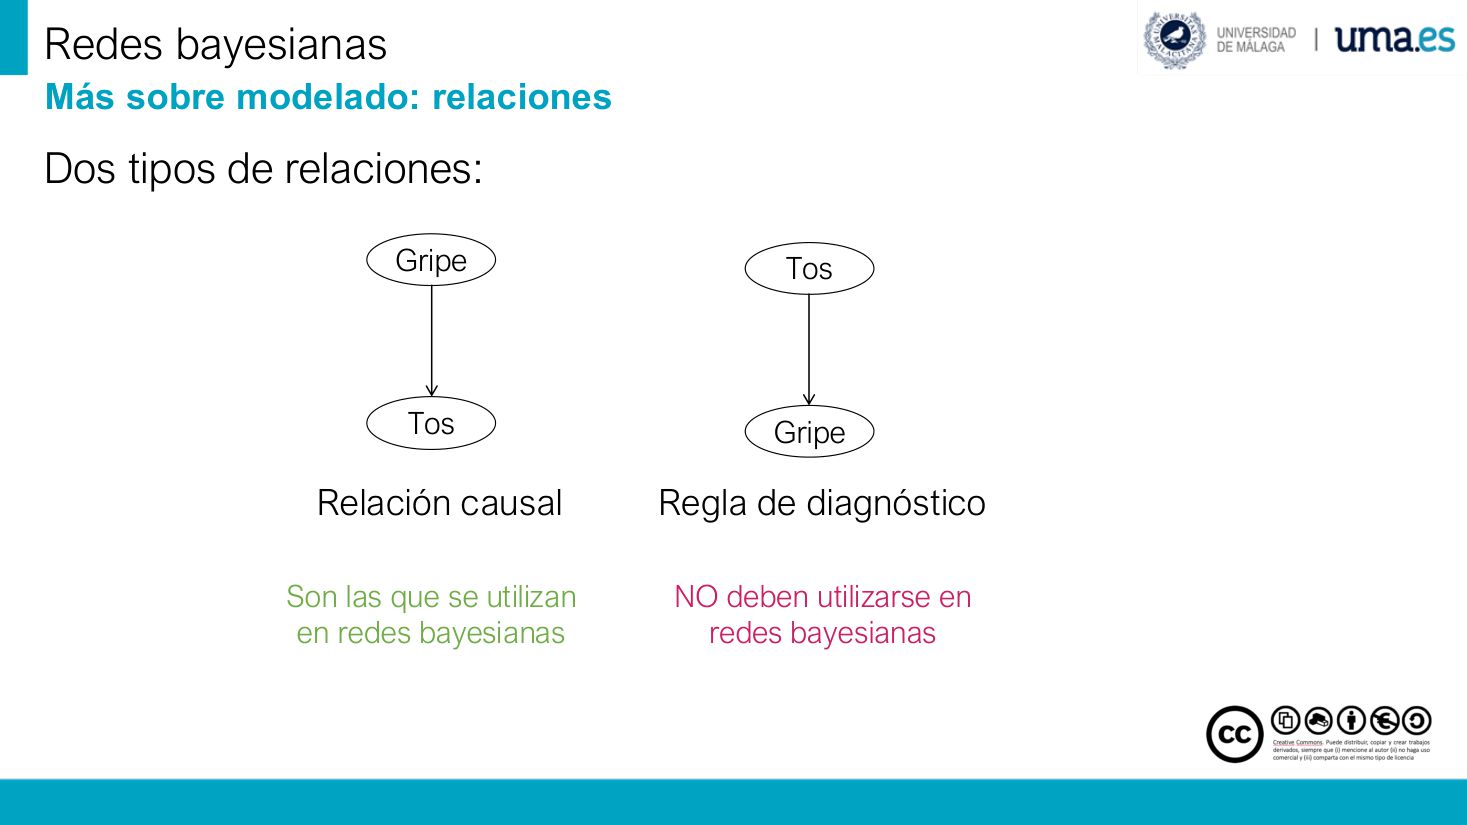
Dos tipos de relaciones:
两类关系:
Relación causal
Gripe → Tos
Gripe → Tos(感冒 → 咳嗽:由病因指向症状)。
Regla de diagnóstico
Tos → Gripe
Tos → Gripe(咳嗽 → 感冒:由症状反推病因)。
NO deben utilizarse en redes bayesianas
不应在贝叶斯网络中使用(指诊断规则方向)。
Son las que se utilizan en redes bayesianas
这些(因果关系)才是贝叶斯网络中使用的方向。
| 关系 | 箭头方向 | 读法 | 参数含义 | 推荐 |
|---|---|---|---|---|
| Causal | Gripe → Tos | 患感冒时咳嗽的概率 | P(Tos | Gripe) | 是 |
| Diagnóstico | Tos → Gripe | 咳嗽者患感冒的概率 | P(Gripe | Tos) | 否 |
Más sobre modelado: relaciones · 为什么因果方向让模型更简单
▸ 原页截图 p.63
Redes bayesianas
贝叶斯网络(页眉)。
Si definimos los enlaces de forma que modelen la relación causal,
如果我们把连接定义为对因果关系建模,
el modelo obtenido es más sencillo de entender y menos complejo en cuanto a parámetros y relaciones.
得到的模型就更容易理解,在参数和关系上也更不复杂。
Más sobre modelado: relaciones
建模进阶:关系(本页标题)。
| 建模方式 | 需要填的参数 | 可读性 | 维护成本 |
|---|---|---|---|
| 因果方向 | 每个节点只依赖其直接原因 | 高(符合人的直觉) | 低:加一个原因只改局部 |
| 诊断方向 | 每个症状要覆盖所有病因的组合 | 低(反直觉) | 高:病因一多参数爆炸 |
Ejemplo de uso de relaciones de influencia causal en el problema del estornudo · 打喷嚏问题:因果影响关系示例
▸ 原页截图 p.64
Redes bayesianas
贝叶斯网络(页眉)。
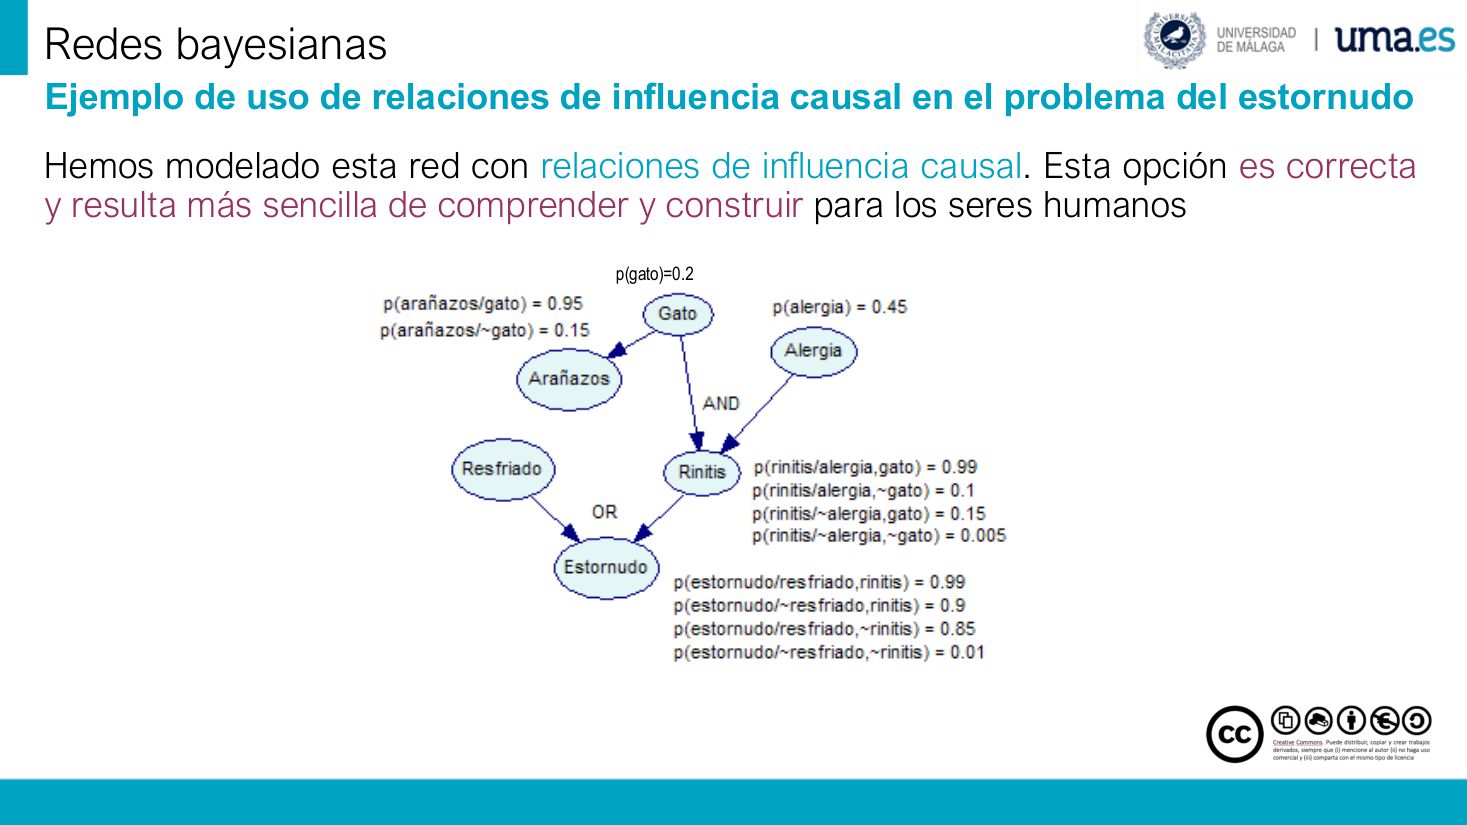
p(gato)=0.2
p(gato)=0.2(家里有猫的先验概率为 0.2)。
Hemos modelado esta red con relaciones de influencia causal.
我们用因果影响关系来构建这张网络。
Esta opción es correcta y resulta más sencilla de comprender y construir para los seres humanos
这一选择是正确的,而且对人类来说更易理解、更易构建。
Ejemplo de uso de relaciones de influencia causal en el problema del estornudo
打喷嚏问题中因果影响关系的使用示例(本页图题)。
| 节点 | 入边(直接原因) | 参数形式 | 本页给出的值 |
|---|---|---|---|
| Gato | 无(根节点) | 先验概率 | 0.2 |
| Resfriado | 无(根节点) | 先验概率 | 图外给定 |
| Alergia | 无(根节点) | 先验概率 | 图外给定 |
| Arañazos | Gato | 条件概率表 | 下一步讨论 |
| Rinitis | Gato, Alergia(AND) | 条件概率表 | 下一步讨论 |
| Estornudo | Resfriado, Rinitis(OR) | 条件概率表 | 下一步讨论 |
Ejemplo de uso de relaciones de diagnóstico en el problema del estornudo · 打喷嚏问题:诊断关系示例(正确但不推荐)
▸ 原页截图 p.65
Redes bayesianas
贝叶斯网络(页眉)。
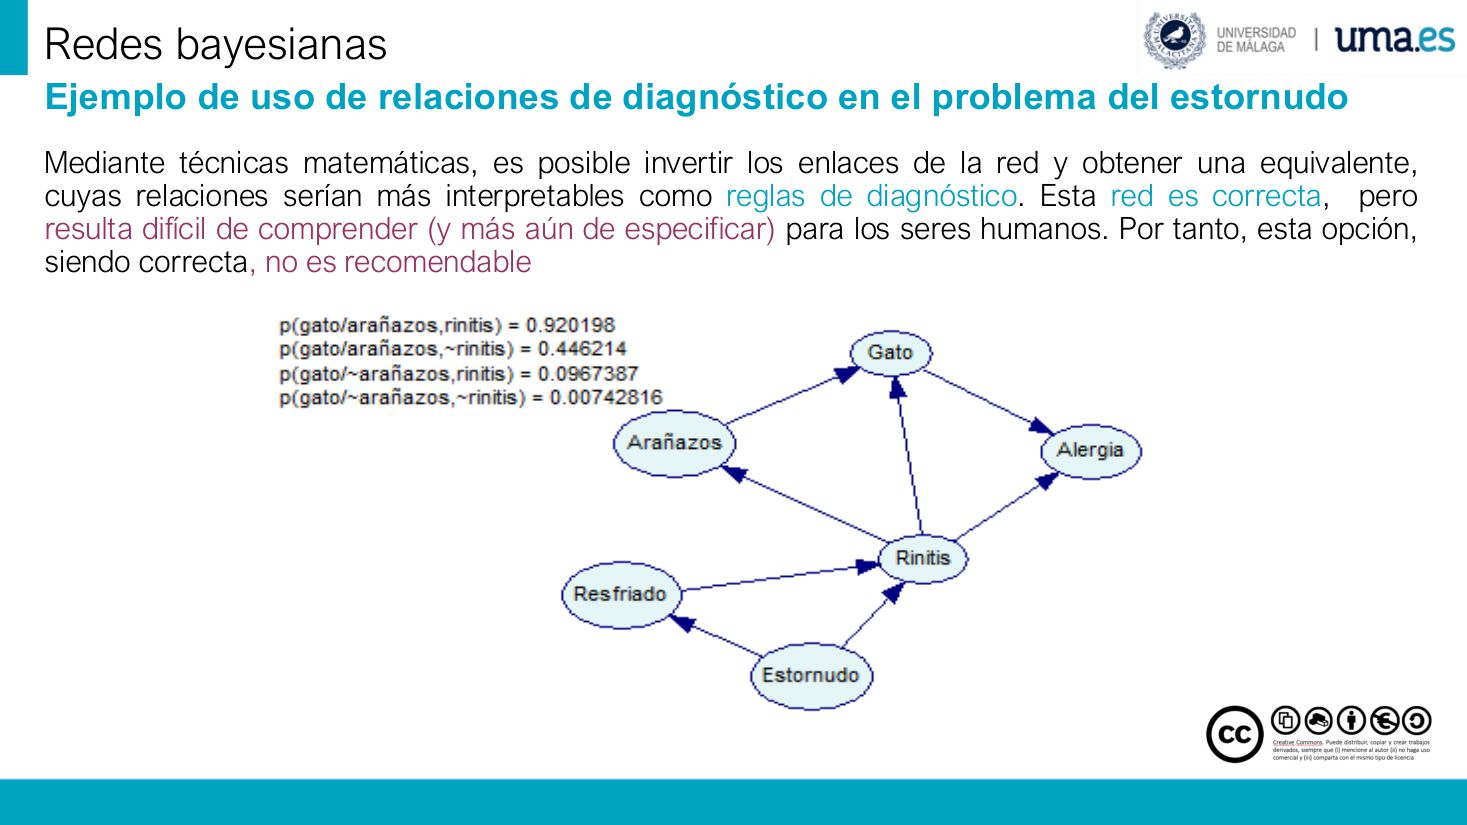
Mediante técnicas matemáticas, es posible invertir los enlaces de la red y obtener una equivalente, cuyas relaciones serían más interpretables como reglas de diagnóstico.
借助数学技巧,可以把网络中的连接反转,得到一个等价网络,其关系更容易被解释为
Esta red es correcta, pero resulta difícil de comprender (y más aún de especificar) para los seres humanos.
这张网络是正确的,但对人类来说难以理解(更难以具体写出来)。
Por tanto, esta opción, siendo correcta, no es recomendable
因此,这一方案虽然正确,但不值得推荐。
Ejemplo de uso de relaciones de diagnóstico en el problema del estornudo
打喷嚏问题中诊断关系的使用示例(本页图题)。
| 步骤 | 操作 | 得到什么 | 评价 |
|---|---|---|---|
| 1 | 建因果网络(p.64) | 原因 → 结果的图 | 直观、参数少 |
| 2 | 用数学技巧反转连接 | 诊断方向的等价网络 | 概率上等价,正确 |
| 3 | 按诊断规则读图 | 症状 → 病因 | 难理解、难写出参数 |
| 4 | 直接交付这种图给领域专家 | 「正确但不推荐」的方案 | 不采用 |
Más sobre modelado: controversia · 建模进阶:因果方向有争议时怎么办
▸ 原页截图 p.66
Redes bayesianas
贝叶斯网络(页眉)。
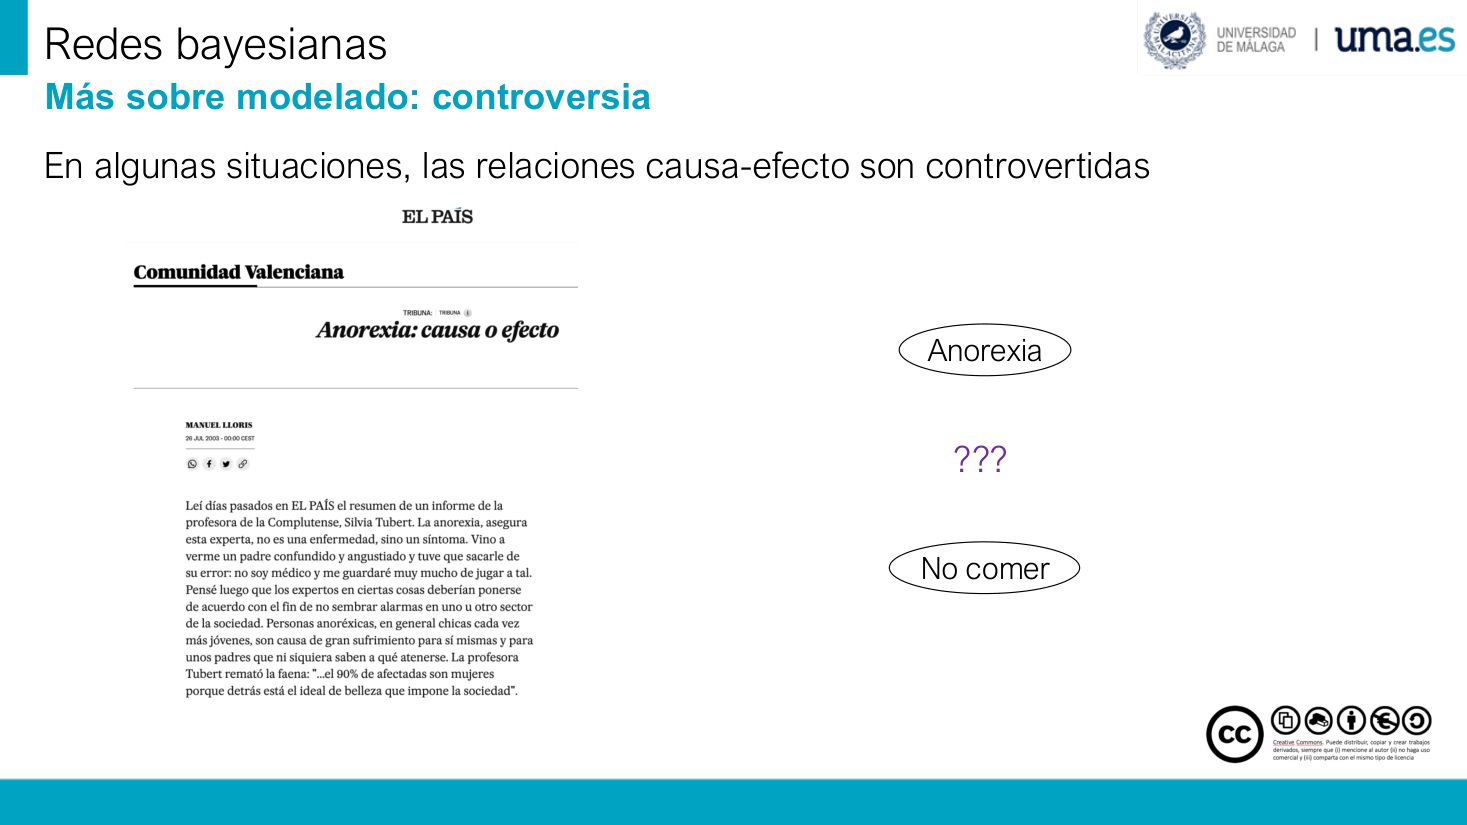
En algunas situaciones, las relaciones causa-efecto son controvertidas
在某些情形下,因果关系本身是有争议的。
Más sobre modelado: controversia
建模进阶:争议(本页标题)。
No comer
不吃东西(图中节点)。
???
???(图中表示方向待定的标记,原文如此,不是漏印)。
Anorexia → No comer
Anorexia → No comer(厌食导致不吃:把厌食当原因)。
No comer → Anorexia
No comer → Anorexia(长期不吃导致厌食:把不吃当原因)。
| 候选方向 | 机制解释 | 建模后果 | 问题 |
|---|---|---|---|
| Anorexia → No comer | 心理疾病导致进食行为改变 | 以厌食为父节点,需估计进食行为的条件概率 | 厌食本身难观察、难确诊 |
| No comer → Anorexia | 节食行为诱发厌食 | 以进食行为为父节点 | 方向与临床共识可能相反,且可能互为因果 |
十二、验证与简化:独立性、中间节点与参数来源
p.67–p.73Algunos trucos útiles para modelado: verificación · 建模技巧:用独立性检查模型(Modelo A / B)
▸ 原页截图 p.67
Redes bayesianas
贝叶斯网络(页眉)。
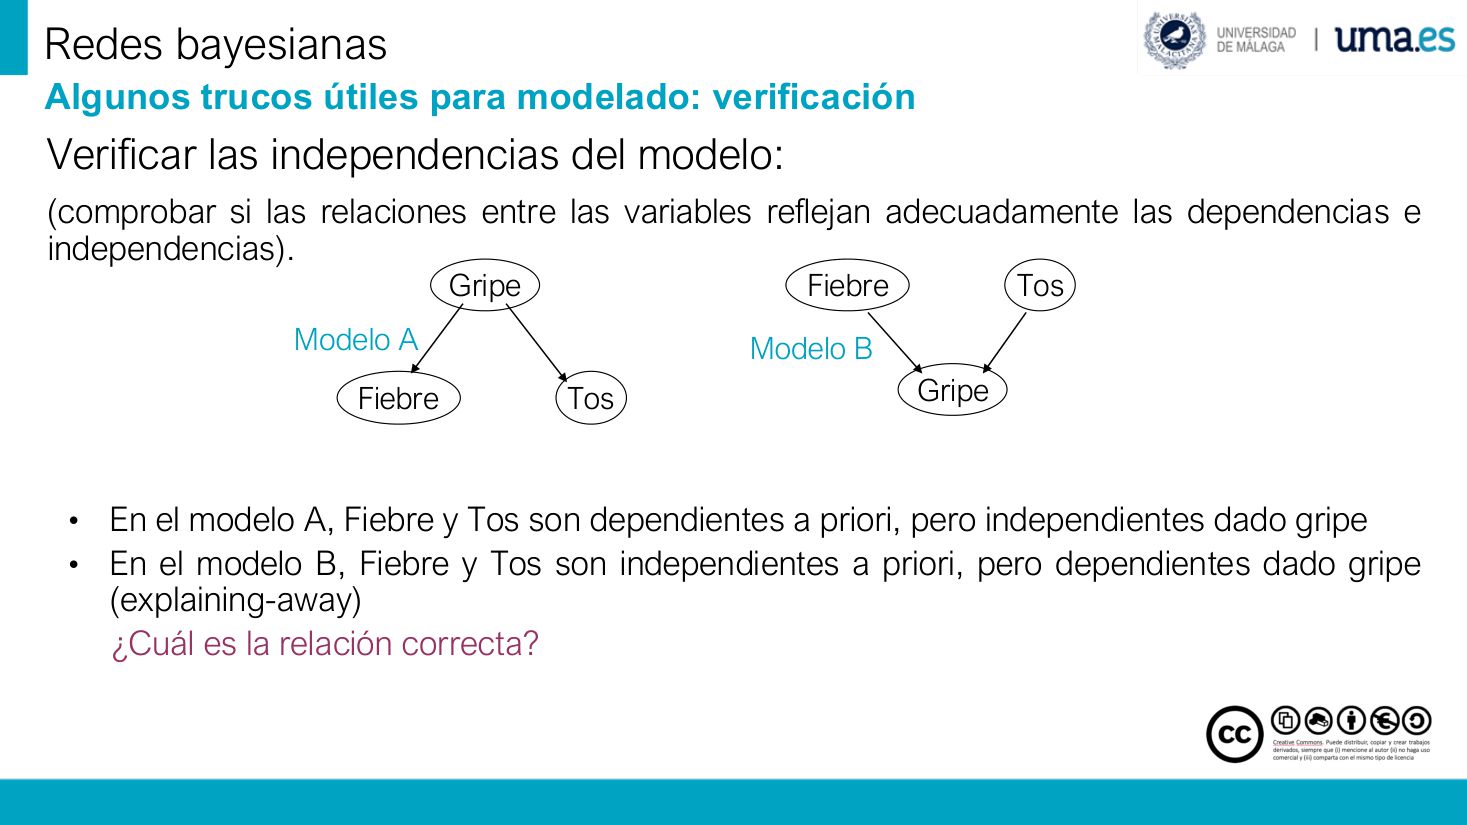
Verificar las independencias del modelo:
验证模型中的
(comprobar si las relaciones entre las variables reflejan adecuadamente las dependencias e independencias).
(检查变量之间的关系是否恰当反映了依赖与独立。)
• En el modelo A, Fiebre y Tos son dependientes a priori, pero independientes dado gripe
• 在模型 A 中,发烧与咳嗽先验相关,但在给定感冒的条件下独立。
• En el modelo B, Fiebre y Tos son independientes a priori, pero dependientes dado gripe
• 在模型 B 中,发烧与咳嗽先验独立,但在给定感冒的条件下相关。
(explaining-away)
(
¿Cuál es la relación correcta?
哪一种关系才是对的?
Modelo A
模型 A(左图)。
Modelo B
模型 B(右图)。
Algunos trucos útiles para modelado: verificación
建模的一些实用技巧:验证(本页标题)。
Tos · Gripe · Fiebre
咳嗽 · 感冒 · 发烧(两图共用的三个节点)。
| 模型 | 连接结构 | 先验关系 | 给定 Gripe 后 | 名称 |
|---|---|---|---|---|
| A | Fiebre ← Gripe → Tos(共同原因) | 相关 | 独立 | fork / 共同原因 |
| B | Fiebre → Gripe ← Tos(汇聚) | 独立 | 相关 | collider / explaining-away |
Algunos trucos útiles para modelado: verificación · 验证练习(打印机版:缺墨 / 缺纸 / 不打印)
▸ 原页截图 p.68
Redes bayesianas
贝叶斯网络(页眉)。
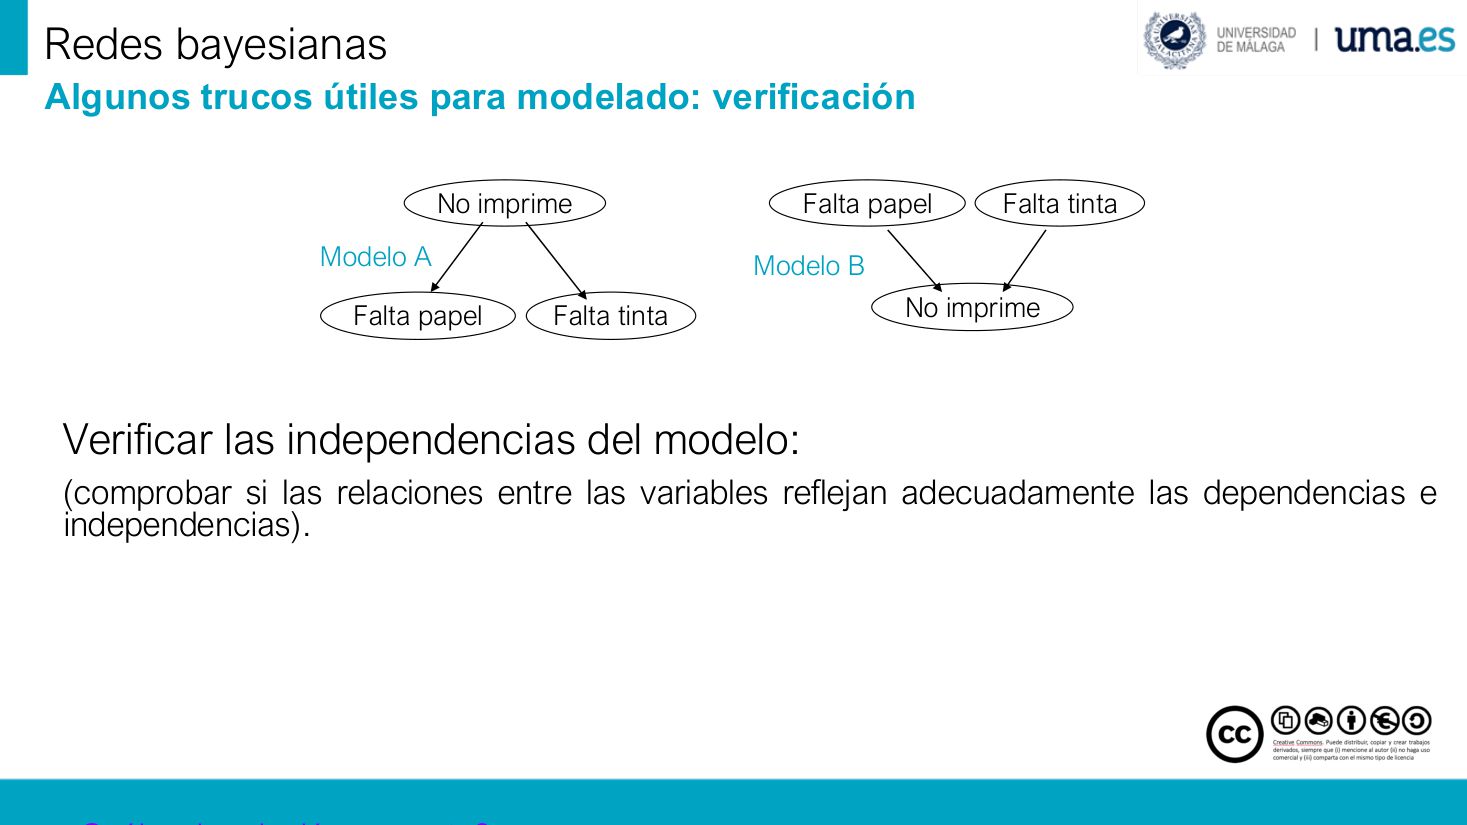
Verificar las independencias del modelo:
验证模型中的独立性:
(comprobar si las relaciones entre las variables reflejan adecuadamente las dependencias e independencias).
(检查变量之间的关系是否恰当反映了依赖与独立。)
C ál l l ió t ?
「C ál l l ió t ?」——原页此处的大字被拆成多行碎片,按上下文应为 «¿Cuál es la relación correcta?»(哪种关系才对?),字形残缺,照录原样。
Algunos trucos útiles para modelado: verificación
建模的一些实用技巧:验证(本页标题)。
Falta tinta
缺墨(节点,相当于「原因」)。
No imprime
不打印(节点,相当于「共同结果」)。
Falta papel
缺纸(节点,相当于另一个「原因」)。
Modelo A
模型 A(左图)。
Modelo B
模型 B(右图)。
| 已知信息 | 推理 | 两个原因之间的概率 |
|---|---|---|
| 什么都不知道 | 缺墨、缺纸各自独立 | 互不影响 |
| No imprime | 两个原因都能解释「不打印」 | 两者概率同时上升 |
| No imprime + Falta tinta | 「不打印」已被缺墨解释掉 | 缺纸概率下降(explaining-away) |
Algunos trucos útiles: estructura · 结构技巧:10 个二值变量要多少参数?
▸ 原页截图 p.69
Redes bayesianas
贝叶斯网络(页眉)。
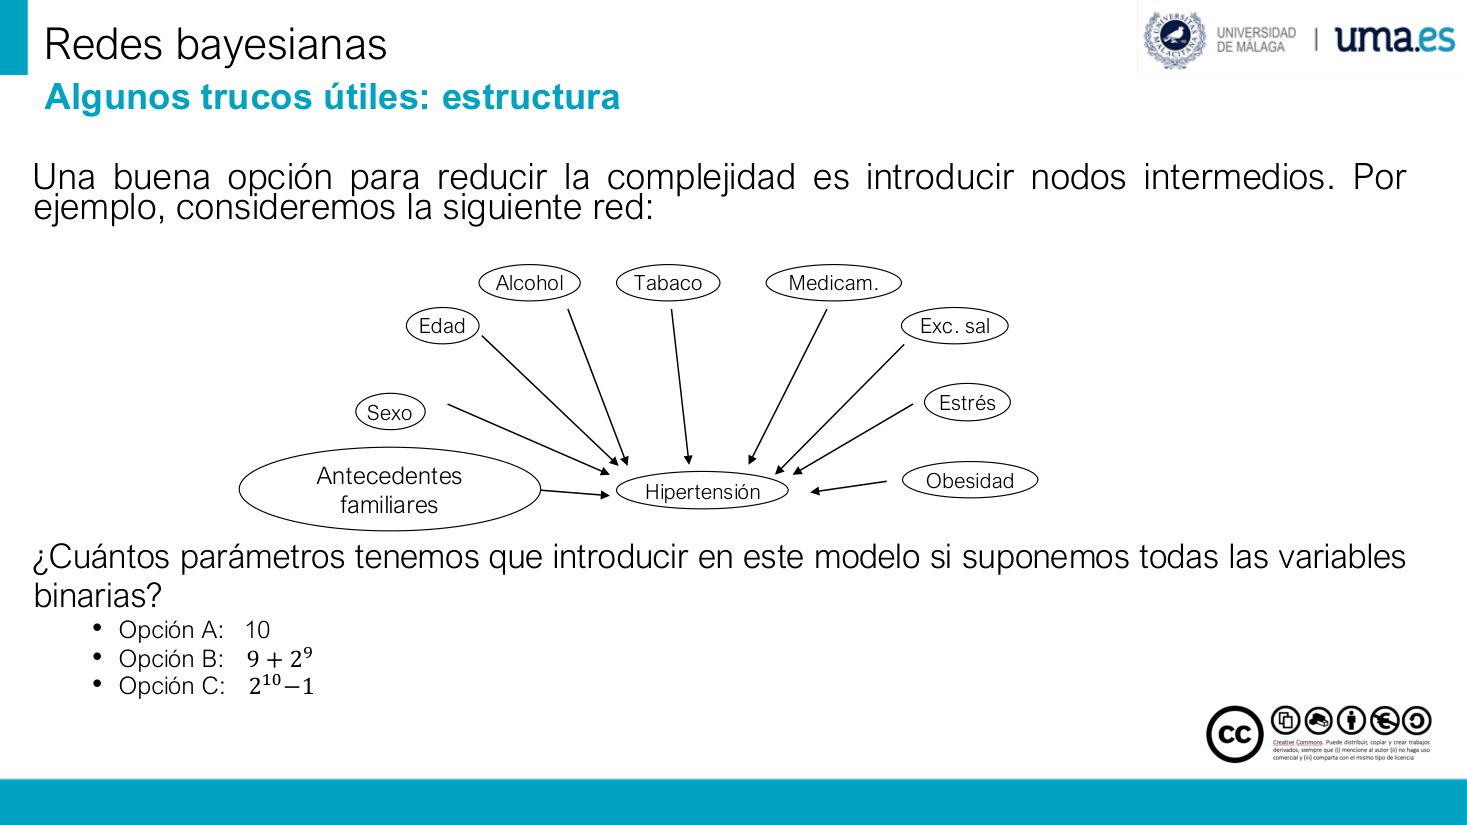
Una buena opción para reducir la complejidad es introducir nodos intermedios.
降低复杂度的一个好办法是引入
Por ejemplo, consideremos la siguiente red:
例如,考虑下面这张网络:
¿Cuántos parámetros tenemos que introducir en este modelo si suponemos todas las variables binarias?
若假设所有变量都是二值变量,这个模型需要引入多少个
• Opción A: 10
• 选项 A:10。
• Opción B: 9 + 29
• 选项 B:9 + 29(9 个根节点各 1 个,再加 9 个父节点组合)。
• Opción C: 210 − 1
• 选项 C:210 − 1(完全联合分布的自由度)。
Algunos trucos útiles: estructura
实用技巧:结构(本页标题)。
Sexo
性别(根节点)。
Edad
年龄(根节点)。
Tabaco
吸烟(根节点)。
Alcohol
饮酒(根节点)。
Antecedentes familiares
家族病史(根节点)。
Medicam.
用药(Medicamentos 的缩写,根节点)。
Exc. sal
盐摄入过量(Exceso de sal 的缩写,根节点)。
Estrés
压力(根节点)。
Hipertensión
高血压(汇聚节点,多条边指向它)。
Obesidad
肥胖(根节点)。
| 选项 | 隐含的结构假设 | 参数数 | 与图是否相符 |
|---|---|---|---|
| A | 10 个变量彼此独立 | 10 | 否:图中 Hipertensión 有入边 |
| B | 9 个根 + 1 个含 9 个父节点的节点 | 9 + 29 = 521 | 是:与图一致 |
| C | 完全联合分布(忽略图结构) | 210 − 1 = 1023 | 否:没用上条件独立 |
Algunos trucos útiles: estructura · 结构技巧:把节点分组后参数降到 41
▸ 原页截图 p.70
Redes bayesianas
贝叶斯网络(页眉)。
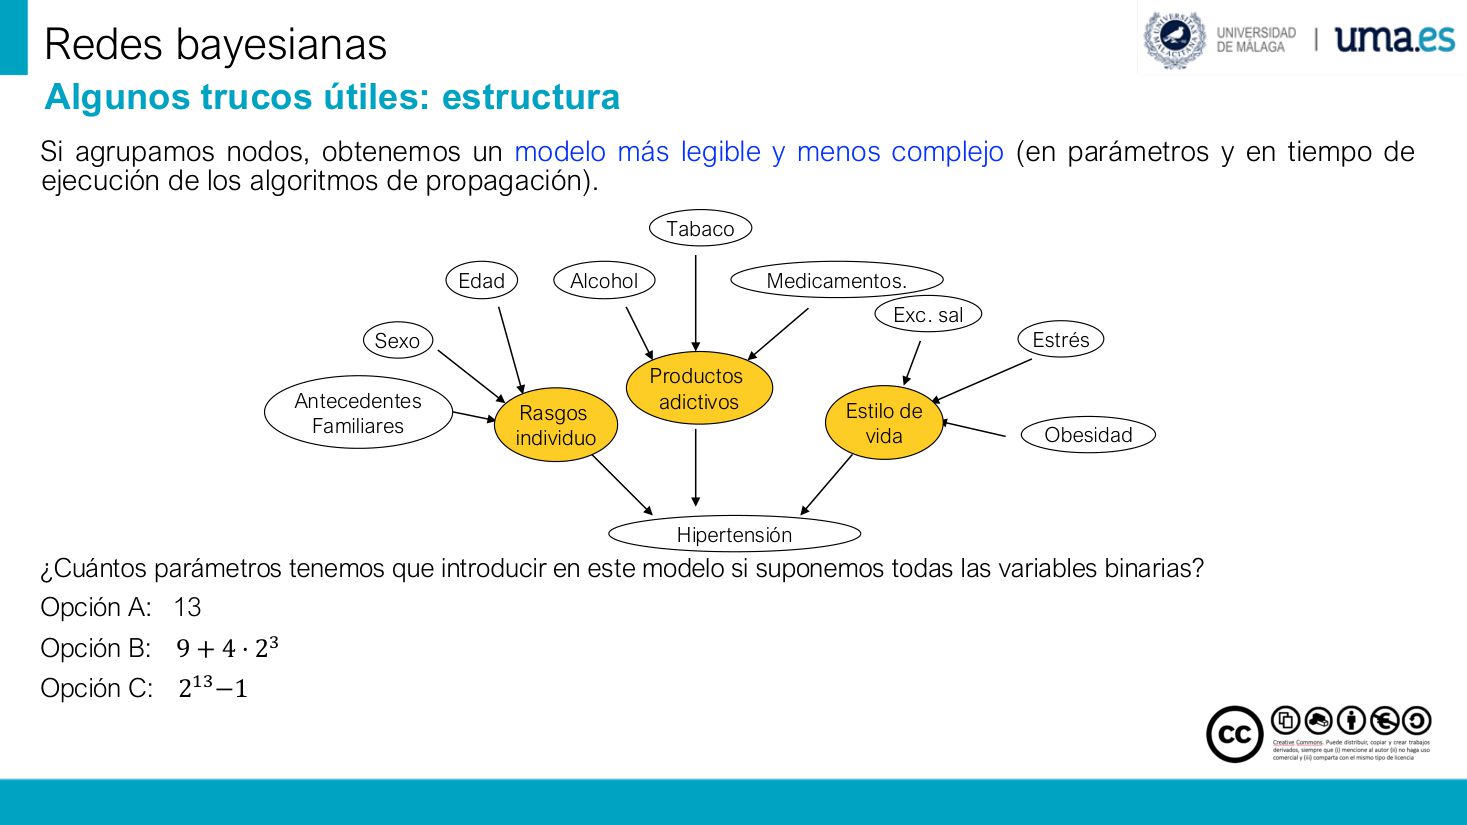
Si agrupamos nodos, obtenemos un modelo más legible y menos complejo (en parámetros y en tiempo de ejecución de los algoritmos de propagación).
如果把节点分组,我们得到的模型更易读、更不复杂(在参数数量与传播算法的执行时间两方面都是)。
¿Cuántos parámetros tenemos que introducir en este modelo si suponemos todas las variables binarias?
若假设所有变量都是二值变量,这个模型需要引入多少个参数?
Opción A: 13
选项 A:13。
Opción B: 9 + 4 · 23
选项 B:9 + 4 · 23(9 个根 + 4 个各有 3 个父节点的分组节点)。
Opción C: 213 − 1
选项 C:213 − 1(完全联合分布的自由度)。
Algunos trucos útiles: estructura
实用技巧:结构(本页标题)。
Sexo
性别。
Edad
年龄。
Tabaco
吸烟。
Alcohol
饮酒。
Antecedentes Familiares
家族病史(注意本页 F 大写,与 p.69 不一致)。
Medicamentos.
用药(原文标签自带句点)。
Exc. sal
盐摄入过量。
Obesidad
肥胖。
Estrés
压力。
Hipertensión
高血压(顶层结果节点)。
Rasgos individuo
个体特征(分组节点)。
Productos adictivos
成瘾性产品(分组节点)。
Estilo de vida
生活方式(分组节点)。
| 节点 | 父节点 | 参数个数 |
|---|---|---|
| 9 个根节点 | 无 | 9 × 1 = 9 |
| Rasgos individuo | Sexo, Edad, Antecedentes Familiares | 23 = 8 |
| Productos adictivos | Tabaco, Alcohol, Medicamentos | 23 = 8 |
| Estilo de vida | Exc. sal, Obesidad, Estrés | 23 = 8 |
| Hipertensión | Rasgos individuo, Productos adictivos, Estilo de vida | 23 = 8 |
| 合计(若用完全联合) | — | 213 − 1 = 8191 |
Más sobre modelado: parámetros · 参数从哪来:专家指定、缺省均分、学习与组合
▸ 原页截图 p.71
Redes bayesianas
贝叶斯网络(页眉)。
- Especificación directa de los parámetros (con ayuda de expertos, costoso)
- 直接指定参数(借助专家,成本高)。
• En ausencia de información, se suele suponer equiprobabilidad
• 缺乏信息时,通常假设
• En muchos casos, se podrán utilizar relaciones tipo AND u OR, con su correspondiente ruido
• 很多情况下可以使用 AND 或 OR 型关系,并配上相应的
- Aprendizaje (si existen bases de datos)
-
• Aprendizaje de parámetros (si se dispone de la estructura);
• 参数学习(若已拥有结构);
• Aprendizaje estructural (se aprende tanto la estructura como los parámetros)
• 结构学习(结构与参数一起学)。
- Combinaciones de los dos anteriores (iterativamente)
- 前两种方式的组合(迭代进行)。
Más sobre modelado: parámetros
建模进阶:参数(本页标题)。
| 途径 | 前提 | 成本 | 得到什么 |
|---|---|---|---|
| Especificación directa | 领域专家在场 | 高(costoso) | 全部条件概率 |
| Equiprobabilidad | 完全没有信息 | 最低 | 二值各 0.5 |
| AND / OR con ruido | 已知定性关系 | 中 | 少量参数代替整张表 |
| Aprendizaje de parámetros | 结构 + 数据 | 中 | 只学数值 |
| Aprendizaje estructural | 只有数据 | 高 | 结构 + 参数(搜索空间大) |
| Combinaciones | 部分数据 + 专家 | 中高 | 迭代改进 |
Más sobre modelado (parámetros) · 直接指定参数时的两条省力规则
▸ 原页截图 p.72
Redes bayesianas
贝叶斯网络(页眉)。
Si es necesario la especificación directa:
如果必须直接指定参数:
• En ausencia de información, se suele suponer equiprobabilidad
• 缺乏信息时,通常假设
• En muchos casos, se podrán utilizar relaciones tipo AND u OR, con su correspondiente ruido
• 很多情况下可以使用 AND 或 OR 型关系,并配上相应的
Más sobre modelado (parámetros)
建模进阶(参数)(本页标题)。
| 做法 | 参数规模 | 什么时候用 | 风险 |
|---|---|---|---|
| 等概率 | 每个取值 1/2 | 完全没有专家信息 | 可能与现实偏差很大 |
| 完整条件概率表 | 2k(k 个父节点) | 专家能逐项给出 | k 一大就不可行 |
| AND / OR + 噪声 | 每个父节点约 1 个(随 k 线性) | 存在「全真才发生 / 任一为真就发生」的定性知识 | 关系假设过强时会失真 |
Más sobre modelado: modelos canónicos · 规范模型:用 NOISY-OR / NOISY-AND 简化条件概率表
▸ 原页截图 p.73
Redes bayesianas
贝叶斯网络(页眉)。
Utilizar modelos canónicos
使用
• Son modelos que ayudan a simplificar la especificación de las tablas de probabilidades condicionadas, para ciertos tipos de relación causal entre variables.
• 它们用于简化
• Los más utilizados son los modelos NOISY-OR y NOISY-AND.
• 最常用的是
Más sobre modelado: modelos canónicos
建模进阶:规范模型(本页标题)。
| 做法 | 要为每个节点给出 | 参数规模 | 适用条件 |
|---|---|---|---|
| 完整条件概率表 | 父节点每种取值组合下的概率 | 2k | 任意,但 k 大时不可行 |
| NOISY-OR | 每个父节点「单独致效」的概率 + 一个噪声项 | 随 k 线性 | 任一原因即可致效、原因间无交互 |
| NOISY-AND | 每个父节点「缺席即阻断」的概率 + 一个噪声项 | 随 k 线性 | 所有原因同时成立才致效 |
十三、规范模型:OR / NOISY-OR / NOISY-AND 与参数压缩
p.74–p.82Más sobre modelado: modelos canónicos · OR 门的三个假设
▸ 原页截图 p.74
Redes bayesianas
贝叶斯网络(页眉)。
La puerta OR:
Hipótesis
假设
1. Cada una de las causas, por sí misma, puede producir el efecto y basta con que una de ellas esté presente para que el efecto ocurra;
1. 每个原因单独都能产生结果,只要其中一个出现,结果就会发生;
2. Cuando todas las causas están ausentes, el efecto está ausente;
2. 当所有原因都不存在时,结果也不存在;
3. No hay interacción entre las causas.
3. 原因之间没有相互作用。
Si se cumplen las hipótesis de la puerta OR, a partir de las probabilidades condicionadas por un solo padre podemos calcular las probabilidades condicionadas por todos los padres
若满足或门的假设,就可以由「只给定一个父节点」的条件概率,算出「给定全部父节点」的条件概率。
Más sobre modelado: modelos canónicos
建模进阶:规范模型(本页标题)。
| 假设 | 管什么 | 被违反时的现象 | 检查方法 |
|---|---|---|---|
| 1 | 单个原因的充分性 | 某原因单独无法致效 | 问专家「只此一个够不够」 |
| 2 | 原因缺席时结果也缺席 | 没有原因却仍发生(需要噪声项) | 查数据里有无「无原因病例」 |
| 3 | 原因之间互不增强/削弱 | 两个原因同时出现时效果超叠加 | 对比单独与联合的条件概率 |
Ejemplos puerta OR · 什么时候能用 OR 门:高血压的反例与发烧的正例
▸ 原页截图 p.75
Redes bayesianas
贝叶斯网络(页眉)。
Ejemplos puerta OR:
OR 门的例子:
Factores que tienen influencia causal en
对
No pueden modelarse con puerta OR
不能用 OR 门建模。
Factores que son causa directa de Fiebre:
作为发烧直接原因的因素:
Sí pueden modelarse con puerta OR
可以用 OR 门建模。
Más sobre modelado: modelos canónicos
建模进阶:规范模型(本页标题)。
| 例子 | 能否用 OR 门 | 原因 | 被违反的假设 |
|---|---|---|---|
| HTA(高血压) | 不能 | 肥胖、盐、压力、遗传往往要「叠加」才致病,且互相增强 | 假设 1 与 3:单一因素未必够,因素间有交互 |
| Fiebre(发烧) | 能 | 感染、炎症等任一个都可独立引起发烧 | 无(三条假设基本满足) |
Más sobre modelado: modelos canónicos · 用 OR 门计算 P(F/O,G):四种父节点组合
▸ 原页截图 p.76
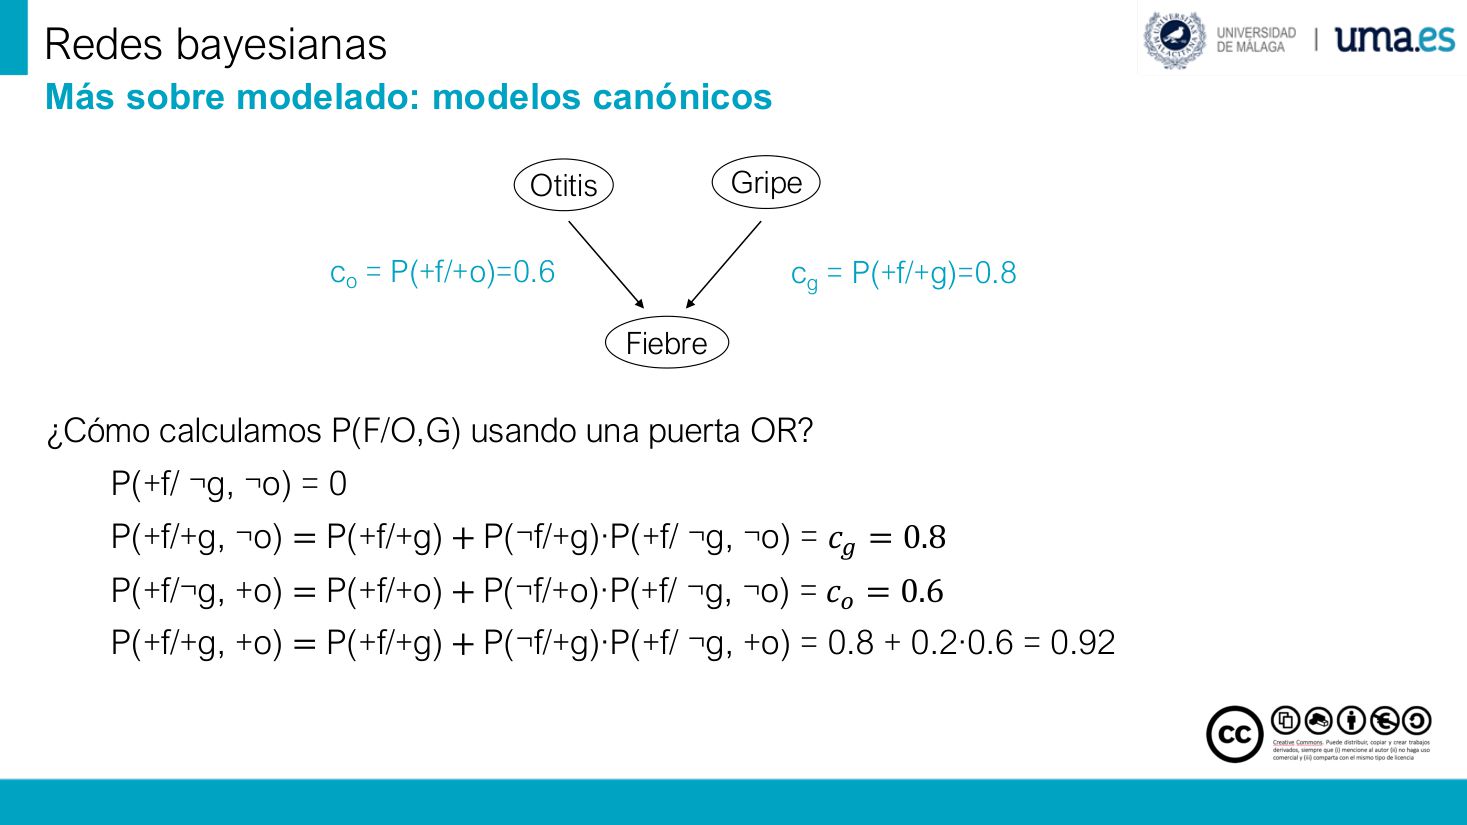
Redes bayesianas
贝叶斯网络(页眉)。
¿Cómo calculamos P(F/O,G) usando una puerta OR?
如何用 OR 门计算 P(F/O,G)?
P(+f/ ¬g, ¬o) = 0
P(+f/ ¬g, ¬o) = 0(感冒、中耳炎都不存在时,发烧概率为 0)。
P(+f/+g, ¬o) = P(+f/+g) + P(¬f/+g)·P(+f/ ¬g, ¬o) = cg= 0.8
P(+f/+g, ¬o) = P(+f/+g) + P(¬f/+g)·P(+f/ ¬g, ¬o) = cg= 0.8(只有感冒时,发烧概率 0.8)。
P(+f/¬g, +o) = P(+f/+o) + P(¬f/+o)·P(+f/ ¬g, ¬o) = co= 0.6
P(+f/¬g, +o) = P(+f/+o) + P(¬f/+o)·P(+f/ ¬g, ¬o) = co= 0.6(只有中耳炎时,发烧概率 0.6)。
P(+f/+g, +o) = P(+f/+g) + P(¬f/+g)·P(+f/ ¬g, +o) = 0.8 + 0.2·0.6 = 0.92
P(+f/+g, +o) = P(+f/+g) + P(¬f/+g)·P(+f/ ¬g, +o) = 0.8 + 0.2·0.6 = 0.92(两者都有时,发烧概率 0.92)。
Otitis · Gripe · Fiebre
中耳炎 · 感冒 · 发烧(图中的三个节点)。
co = P(+f/+o)=0.6
co = P(+f/+o)=0.6(图中标注:仅由中耳炎致发烧的概率)。
cg = P(+f/+g)=0.8
cg = P(+f/+g)=0.8(图中标注:仅由感冒致发烧的概率)。
Más sobre modelado: modelos canónicos
建模进阶:规范模型(本页标题)。
| Gripe | Otitis | 计算 | 结果 |
|---|---|---|---|
| ¬g | ¬o | 无原因,按 OR 假设 2 直接取 0 | 0 |
| +g | ¬o | 0.8 + 0.2 × 0 | 0.8 |
| ¬g | +o | 0.6 + 0.4 × 0 | 0.6 |
| +g | +o | 0.8 + 0.2 × 0.6 | 0.92 |
| 符号 | 西语读法 | 中文含义 |
|---|---|---|
| P(+f / ¬g, ¬o) | «pe de efe dado no ge y no o» | 给定「没感冒、没中耳炎」时发烧的条件概率 |
| +f | «más efe» | Fiebre 为真(发烧) |
| ¬g | «no ge» | Gripe 为假(没感冒) |
| ¬o | «no o» | Otitis 为假(没中耳炎) |
| cg | «ce sub ge» | 仅感冒致发烧的概率,0.8 |
| co | «ce sub o» | 仅中耳炎致发烧的概率,0.6 |
Algunos trucos útiles: modelos canónicos · NOISY-OR 门的四条假设
▸ 原页截图 p.77
Redes bayesianas
贝叶斯网络(页眉)。
La puerta NOISY-OR
Hipótesis
假设
1. Cada una de las causas, por sí misma, puede producir el efecto y basta con que una de ellas esté presente para que el efecto ocurra
1. 每个原因单独都能产生结果,只要其中一个出现,结果就会发生。
2. Hay causas desconocidas no incluidas en la red que puede producir el efecto cuando todas las causas especificadas en la red están ausentes (ruido)
2. 存在未纳入网络的未知原因,当网络中指定的原因全都不存在时,它们仍可能产生结果(即
3. El efecto solo se produce en presencia de alguna de las causas modeladas o de ruido
3. 结果只在某个已建模原因或噪声存在时才会发生。
4. No hay interacción entre las causas
4. 原因之间没有相互作用。
Si se cumplen las hipótesis de la puerta NOISY-OR, a partir de las probabilidades condicionadas por un solo padre y el factor de ruido podemos calcular las probabilidades condicionadas por todos los padres.
若满足 NOISY-OR 门的假设,就可以由「只给定一个父节点」的条件概率以及
Algunos trucos útiles: modelos canónicos
实用技巧:规范模型(本页标题)。
| 假设 | 作用 | 与普通 OR 门的区别 |
|---|---|---|
| 1 | 单因充分 | 相同 |
| 2 | 允许网络外原因(噪声) | 普通 OR 门要求「全无原因则结果必无」 |
| 3 | 结果只能由已建模原因或噪声引起 | 相同(封闭世界) |
| 4 | 原因互不交互 | 相同;违反则不能压缩参数 |
Más sobre modelado: modelos canónicos · NOISY-OR 的参数:每个原因一个 c 加一个噪声因子
▸ 原页截图 p.78
Redes bayesianas
贝叶斯网络(页眉)。
Puerta NOISY-OR
噪声或门。
Supongamos que en el modelo queremos incluir que es posible que otras causas no determinadas provoquen también fiebre.
假设我们想在模型里纳入:其他未确定的原因也可能引起发烧。
Entonces necesitamos los siguientes parámetros:
那么我们需要下列参数:
• Las probabilidades de que cada causa provoque el efecto por separado
• 每个原因单独引起结果的概率:
cg = P(+f/+g, ¬o, ¬r)=0.8
cg = P(+f/+g, ¬o, ¬r)=0.8(只有感冒、无中耳炎、无噪声时,发烧概率 0.8)。
co = P(+f/¬g, +o, ¬r)=0.6
co = P(+f/¬g, +o, ¬r)=0.6(只有中耳炎、无感冒、无噪声时,发烧概率 0.6)。
• Un factor de ruido
• 一个噪声因子:
cr = p(+f/¬g, ¬o)=0.01
cr = p(+f/¬g, ¬o)=0.01(两个原因都没有时,仍有 1% 的概率因未知原因发烧)。
Más sobre modelado: modelos canónicos
建模进阶:规范模型(本页标题)。
| 父节点组合 | 按 1 − ∏(1 − c) 计算 | 结果 |
|---|---|---|
| ¬g, ¬o | 只剩噪声 cr | 0.01 |
| +g, ¬o | 1 − (1−0.8)(1−0.01) | 0.802 |
| ¬g, +o | 1 − (1−0.6)(1−0.01) | 0.604 |
| +g, +o | 1 − 0.2 × 0.4 × 0.99 | 0.9208 |
| 符号 | 西语读法 | 中文含义 |
|---|---|---|
| cg | «ce sub ge» | 仅感冒致发烧的概率 |
| co | «ce sub o» | 仅中耳炎致发烧的概率 |
| cr | «ce sub erre» | 噪声因子(未知原因致效的概率) |
| +f | «más efe» | 发烧为真 |
| ¬r | «no erre» | 无噪声(噪声未触发) |
Más sobre modelado: modelos canónicos · 用 cg、co、cr 反推四种父节点组合
▸ 原页截图 p.79
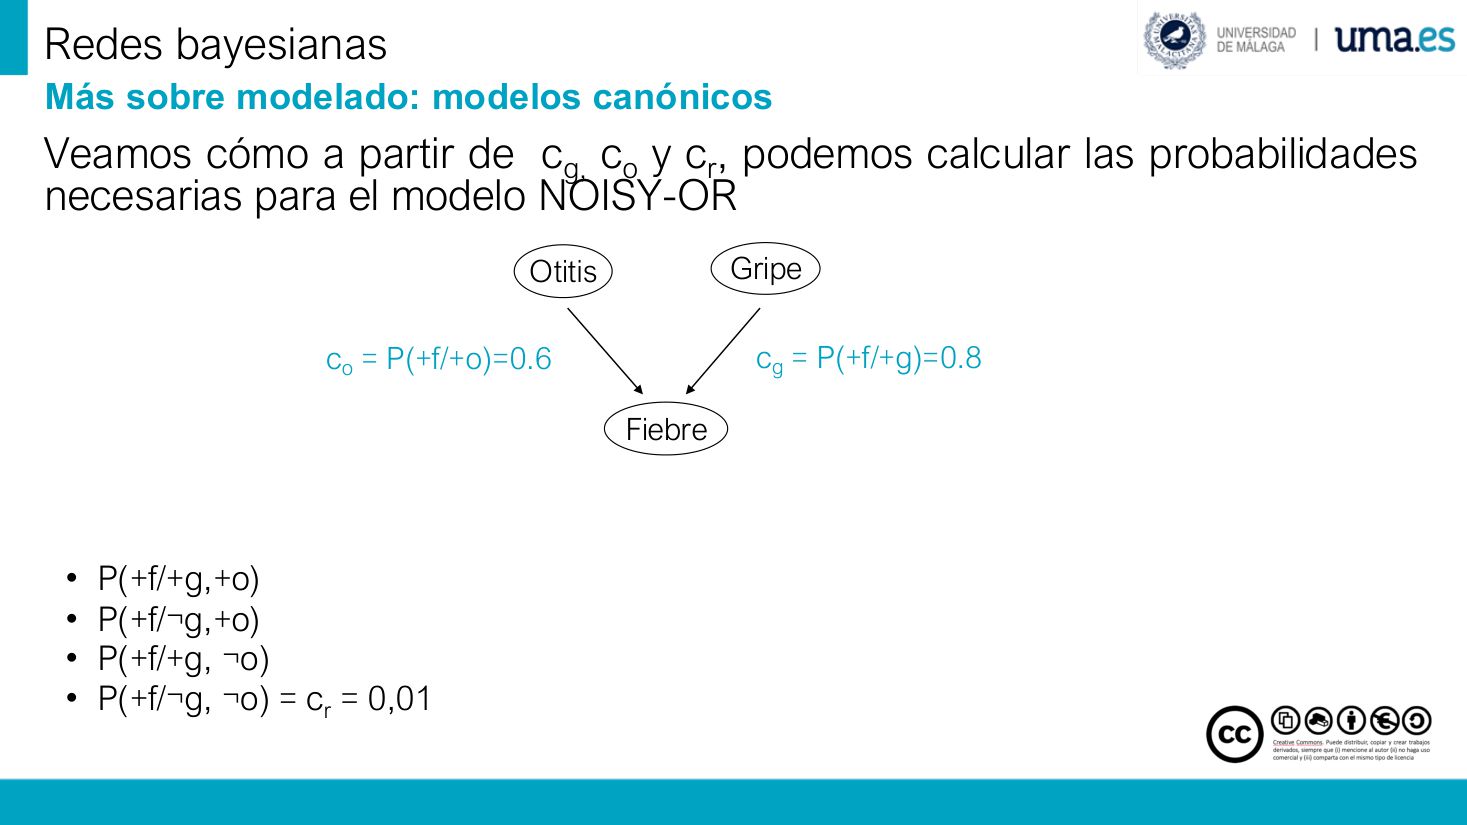
Redes bayesianas
贝叶斯网络(页眉)。
Veamos cómo a partir de cg, co y cr, podemos calcular las probabilidades necesarias para el modelo NOISY-OR
看看怎么用 cg、co、cr 这三个数,把
• P(+f/+g,+o)
• 感冒、中耳炎都为真时,发烧的概率。
• P(+f/¬g,+o)
• 只有中耳炎(无感冒)时,发烧的概率。
• P(+f/+g, ¬o)
• 只有感冒(无中耳炎)时,发烧的概率。
• P(+f/¬g, ¬o) = cr = 0,01
• 两个原因都没有、只剩
Más sobre modelado: modelos canónicos
建模进阶:规范模型(本页标题)。
| 父节点组合 | 已知的单个参数 | 状态 |
|---|---|---|
| ¬g, ¬o | cr = 0.01 | 本页直接给出 |
| +g, ¬o | cg = 0.8 | 本页直接给出(另一原因缺席) |
| ¬g, +o | co = 0.6 | 本页直接给出(另一原因缺席) |
| +g, +o | — | 本页没给,下一页用递推算(p.80 → 0.9208) |
| 符号 | 西语读法 | 中文含义 |
|---|---|---|
| +f / ¬g / +o | «más efe / no ge / más o» | 发烧 / 无感冒 / 有中耳炎 |
| cg | «ce sub ge» | 仅感冒致发烧的概率 0.8 |
| co | «ce sub o» | 仅中耳炎致发烧的概率 0.6 |
| cr | «ce sub erre» | 噪声因子,两个原因都没有时仍发烧的概率 0.01 |
Más sobre modelado: modelos canónicos · 递推:加一个原因时怎么算
▸ 原页截图 p.80
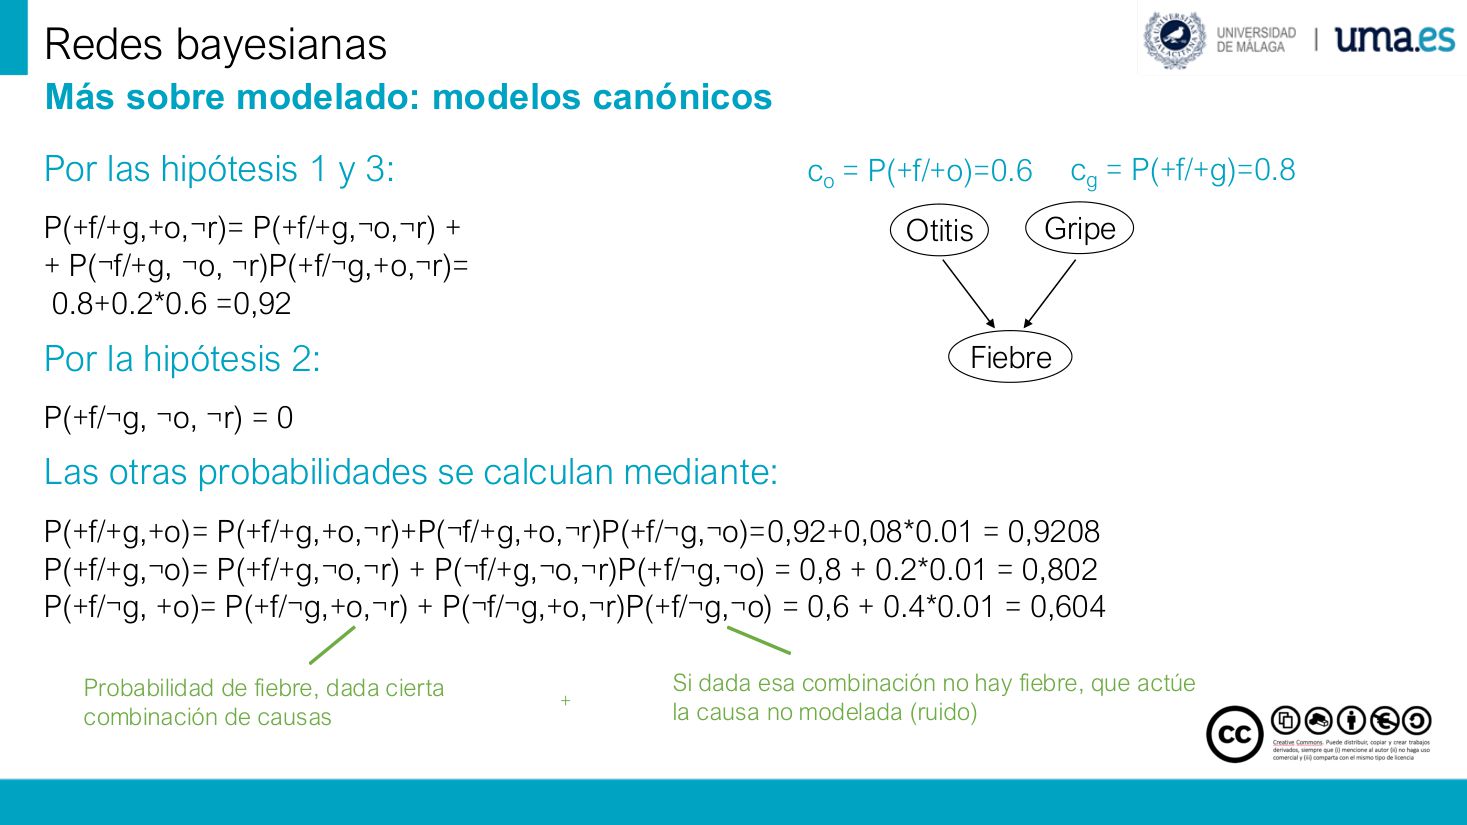
Redes bayesianas
贝叶斯网络(页眉)。
Por las hipótesis 1 y 3:
由第 1、3 条假设(单因充分;结果只能来自已建模原因或噪声):
P(+f/+g,+o,¬r) = P(+f/+g,¬o,¬r) + P(¬f/+g,¬o,¬r)·P(+f/¬g,+o,¬r) = 0.8 + 0.2×0.6 = 0,92
先算「有感冒、有中耳炎、噪声不生效」:感冒单独已经给出 0.8;剩下 0.2 的「没发烧」部分,交给中耳炎按 0.6 去捞,所以是 0.8 + 0.2×0.6 = 0,92。
Por la hipótesis 2:
由第 2 条假设(允许网络外的未知原因):
P(+f/¬g, ¬o, ¬r) = 0
两个原因都没有、噪声也不生效时,发烧概率为 0——这正是「封闭世界」的那一格。
Las otras probabilidades se calculan mediante:
其余三个概率用同一条递推算出:
Probabilidad de fiebre, dada cierta combinación de causas
给定某种原因组合时,发烧的概率(右侧图的旁注)。
Si dada esa combinación no hay fiebre, que actúe la causa no modelada (ruido)
如果在该组合下仍然没发烧,那就让未被建模的原因(噪声)来接盘。
| 要算的格子 | 拆成「较轻的组合」 | 再补上噪声 | 结果 |
|---|---|---|---|
| +g, ¬o | 0.8 | 0.2 × 0.01 | 0.802 |
| ¬g, +o | 0.6 | 0.4 × 0.01 | 0.604 |
| +g, +o(无噪声) | 0.8 + 0.2×0.6 | — | 0.92 |
| +g, +o(含噪声) | 0.92 | 0.08 × 0.01 | 0.9208 |
| 符号 | 西语读法 | 中文含义 |
|---|---|---|
| ¬r | «no erre» | 噪声不生效(不是「变量 R 为假」) |
| 0.2 = 1 − 0.8 | «cero coma dos» | 仅感冒时「没被捞起来」的剩余概率 |
| 0.08 = 1 − 0.92 | «cero coma cero ocho» | 两因齐上仍没发烧的剩余概率,交给噪声 |
Más sobre modelado: modelos canónicos · NOISY-OR 推广到 n 个原因
▸ 原页截图 p.81
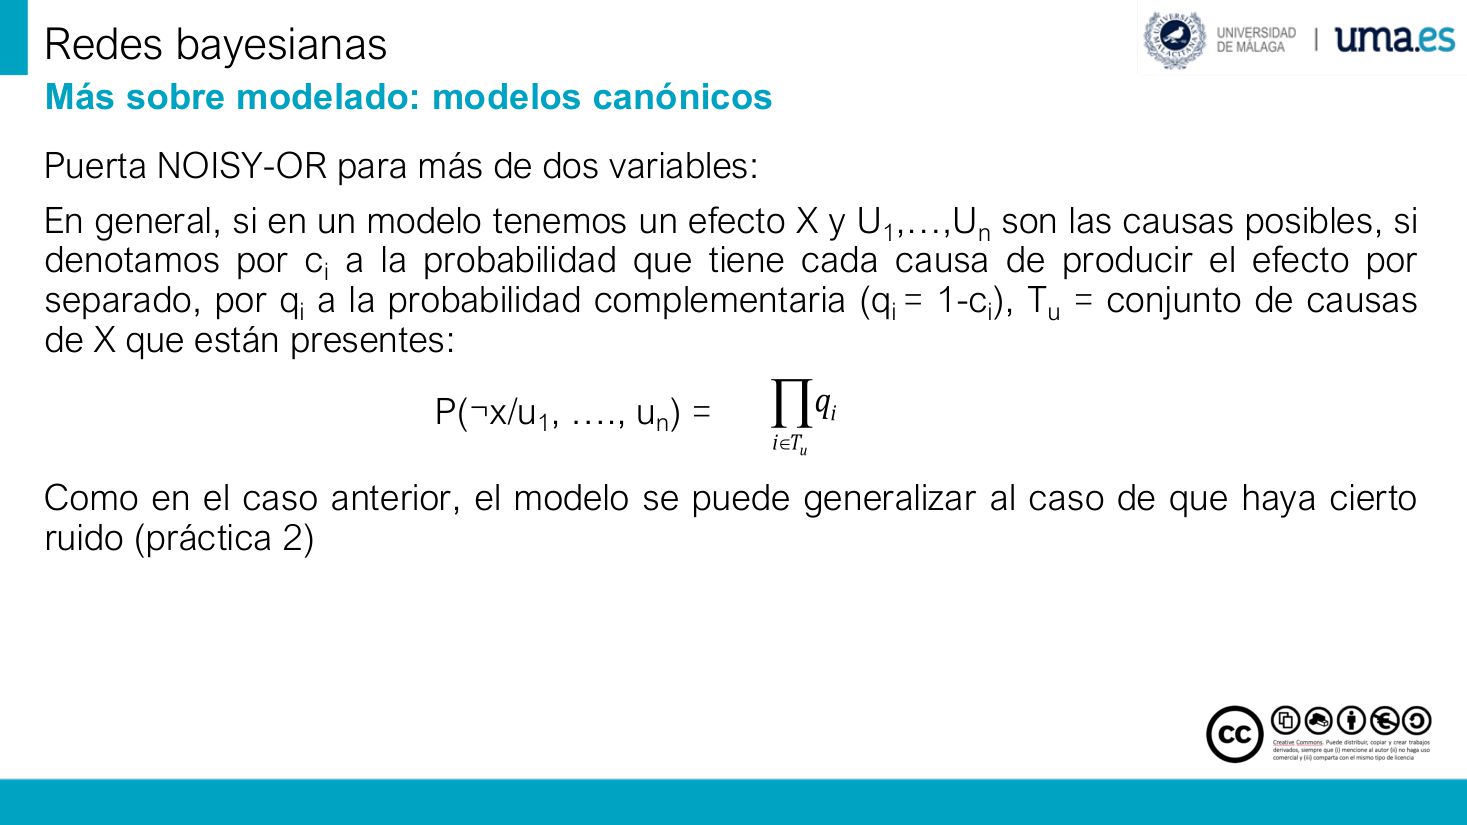
Redes bayesianas
贝叶斯网络(页眉)。
Puerta NOISY-OR para más de dos variables:
En general, si en un modelo tenemos un efecto X y U1,…,Un son las causas posibles, si denotamos por ci a la probabilidad que tiene cada causa de producir el efecto por separado, por qi a la probabilidad complementaria (qi = 1 − ci), Tu = conjunto de causas de X que están presentes:
一般情形:模型里有一个结果 X,U1,…,Un 是可能的
Como en el caso anterior, el modelo se puede generalizar al caso de que haya cierto ruido (práctica 2)
和前面一样,这个模型可以推广到「存在一定
Más sobre modelado: modelos canónicos
建模进阶:规范模型(本页标题)。
| 符号 | 西语读法 | 中文含义 |
|---|---|---|
| x / ¬x | «equis / no equis» | 结果发生 / 不发生 |
| ui | «u sub i» | 第 i 个原因(父节点)取真 |
| ci | «ce sub i» | 第 i 个原因单独致效的概率 |
| qi | «cu sub i» | 1 − ci,即「该原因没起作用」的概率 |
| Tu | «te sub u» | 当前为真的原因集合;不在集合里的原因不参与连乘 |
| ∏ | «productorio» | 连乘;空集时按 1 处理(p.98 会强调) |
Más sobre modelado: modelos canónicos · AND 门与 De Morgan:OR 的另一张脸
▸ 原页截图 p.82
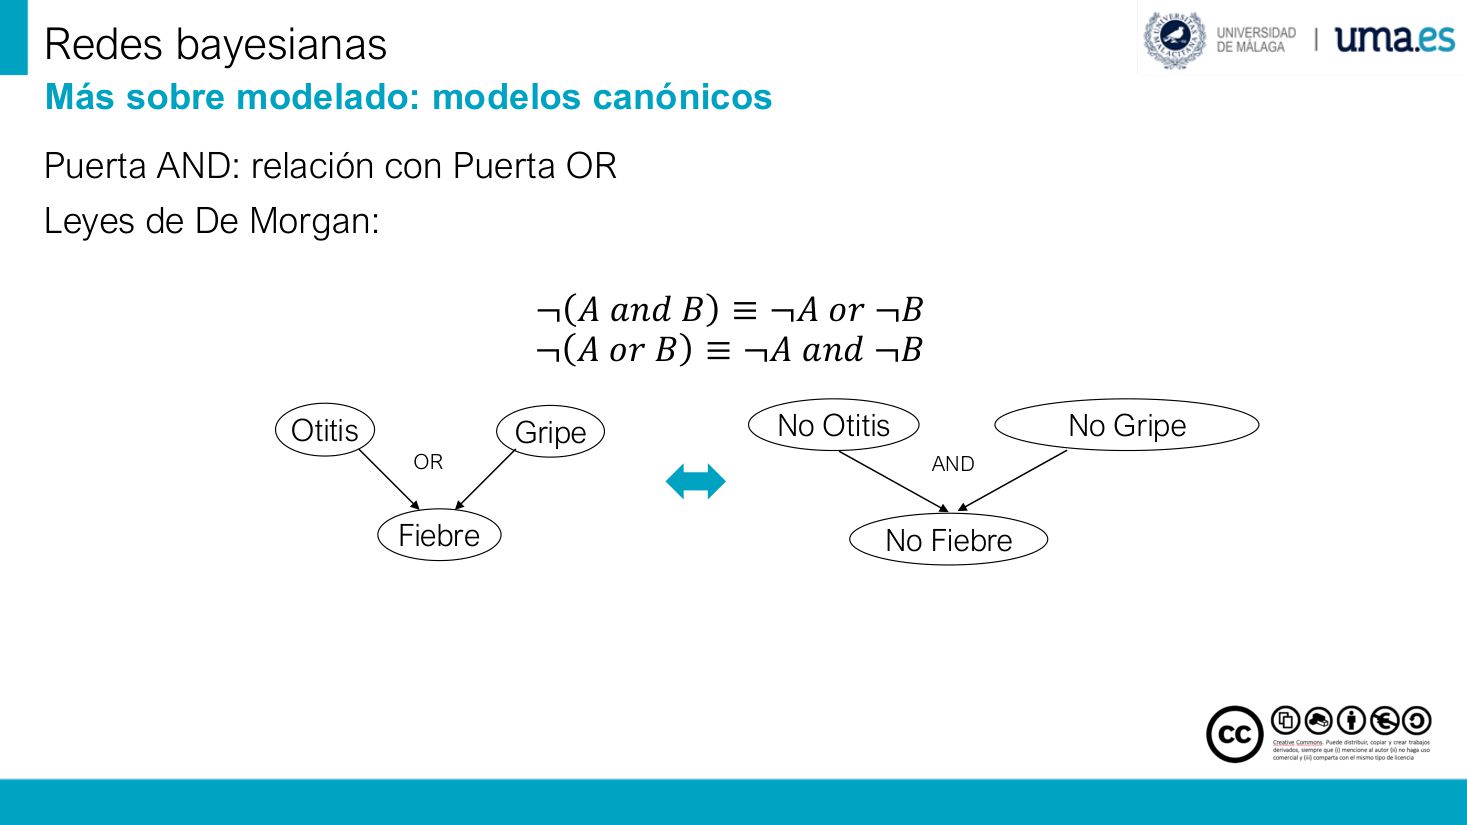
Redes bayesianas
贝叶斯网络(页眉)。
Puerta AND: relación con Puerta OR
Leyes de De Morgan:
德摩根定律:
¬(A and B) ≡ ¬A or ¬B
「并非(A 且 B)」等价于「非 A 或 非 B」。
¬(A or B) ≡ ¬A and ¬B
「并非(A 或 B)」等价于「非 A 且 非 B」。
Otitis · Gripe · Fiebre — OR
中耳炎 · 感冒 · 发烧 —— OR 门(任一原因成立,结果成立)。
No Otitis · No Gripe · No Fiebre — AND
无中耳炎 · 无感冒 · 无发烧 —— AND 门(所有「取反」的原因同时成立,结果才成立)。
Más sobre modelado: modelos canónicos
建模进阶:规范模型(本页标题)。
| 符号 | 西语读法 | 中文含义 |
|---|---|---|
| ∧ / and | «y» | 且(同时成立) |
| ∨ / or | «o» | 或(至少一个成立) |
| ¬ / no | «no» | 取反 |
| ≡ | «equivale a» | 逻辑等价(真值表完全一致) |
| 原网络 | 取反后的网络 | 门类型 |
|---|---|---|
| Otitis ∨ Gripe → Fiebre | ¬Otitis ∧ ¬Gripe → ¬Fiebre | OR ↔ AND |
| 任一原因成立即发烧 | 全部原因都不成立才「不发烧」 | 同一件事的两种写法 |
十四、传播算法:λ/π 消息、归一化与树形网络实例
p.83–p.100Actividad: crea y resuelve tu problema de modelado · 作业:自己建一个贝叶斯网络
▸ 原页截图 p.83
Redes bayesianas
贝叶斯网络(页眉)。
1. Identifica un dominio o problema de tu interés. Para ello, usa tu herramienta de IA generativa favorita para buscar información sobre algún tema concreto (por ejemplo, causas de la caída del cabello, de la lluvia con calima, de que te contraten para un puesto de trabajo, de que el Málaga gane o pierda, etc.).
第 1 步:选定一个你感兴趣的
2. Marca en el texto generado por la herramienta la información que consideres relevante para ese dominio: síntomas, indicios, pruebas, causas (potenciadoras, inhibidoras, favorecedoras, preventivas, etc.).
第 2 步:在 AI 生成的那段文字里,把对这个领域重要的信息标出来:
3. Simplifica el problema para eliminar posibles ambigüedades de las relaciones de influencia causal y tener un número de nodos razonable para un problema de clase (entre 8 y 12 nodos). Debes incluir al menos una relación de OR con tres nodos y una de AND con dos.
第 3 步:
4. Escribe el enunciado (debe ser simple y no prestarse a confusión).
第 4 步:写出
5. Dibuja el modelo correspondiente a tu red (no olvides etiquetar las relaciones AND/OR).
第 5 步:画出你那张网络的模型图(别忘了把 AND/OR 关系
6. Sube al foro del campus virtual.
第 6 步:上传到虚拟校园的论坛。
Tenéis un ejemplo para poder comprender mejor lo que se pide.
课程里给了一个范例,方便你更清楚作业要什么。
| 步骤 | 要做的事 | 交付物 / 检查点 |
|---|---|---|
| 1 | 选领域,用 AI 查资料 | dominio |
| 2 | 标出症状 / 迹象 / 证据 / 原因(促进·抑制·有利·预防) | síntomas, indicios… |
| 3 | 简化到 8–12 节点,含 1 个三节点 OR + 1 个两节点 AND | 8–12 nodos |
| 3 | 节点超过 12 个,或没写 OR/AND 关系 | 直接扣分项 |
| 4 | 写题干 | enunciado |
| 5 | 画图,标注 AND/OR | imagen GeNIe |
| 6 | 发论坛 | foro |
| 论坛帖子必填项 | 西语原文 | 说明 |
|---|---|---|
| 标题 | Título | 一句话说清你的领域 |
| 原始参考 | Referencia original | AI 资料来源的出处 |
| 原文 | Texto original | AI 生成的那段文字 |
| 题干 | Enunciado | 你写的简化版题目 |
| 网络图 | Imagen GeNIe | GeNIe 里画好的贝叶斯网络截图 |
Algoritmos de propagación · 传播算法:有新证据时,概率怎么跟着变
▸ 原页截图 p.84
Redes bayesianas
贝叶斯网络(页眉)。
Los algoritmos de propagación sirven para calcular las nuevas probabilidades de los nodos (P*) conforme se va teniendo evidencia del caso concreto (e).
P*(X) = P(X/e)
后验概率:给定证据 e 之后,变量 X 的概率。
Cuando un nodo toma un valor concreto, se dice que la variable se instancia. Como resultado, todos los nodos cambiarán su probabilidad.
某个节点取了一个确定值时,就说这个变量被
El problema es NP-duro, por eso existen muchos algoritmos, tanto exactos como aproximados.
这个问题是
Estudiaremos el algoritmo para el caso de que la red tenga forma de ÁRBOL (cada nodo tiene a lo sumo un padre).
本课只讲网络呈
| 符号 | 西语读法 | 中文含义 |
|---|---|---|
| P*(X) | «p asterisco de equis» | 加入证据后的新概率(后验) |
| e | «e» / «evidencia» | 已知的观测证据集合 |
| P(X/e) | «p de equis dado e» | 条件概率,竖线常被写成斜杠 |
| instanciar | «instanciar» | 给变量固定成一个值 |
| NP-duro | «ene-pe duro» | NP 难:一般图上的精确推断没有多项式算法 |
| árbol | «árbol» | 树:每个节点至多一个父节点 |
Ideas: P(X)=α·λ(X)·π(X) · 三因子分解:λ 值、π 值与归一化常数
▸ 原页截图 p.85
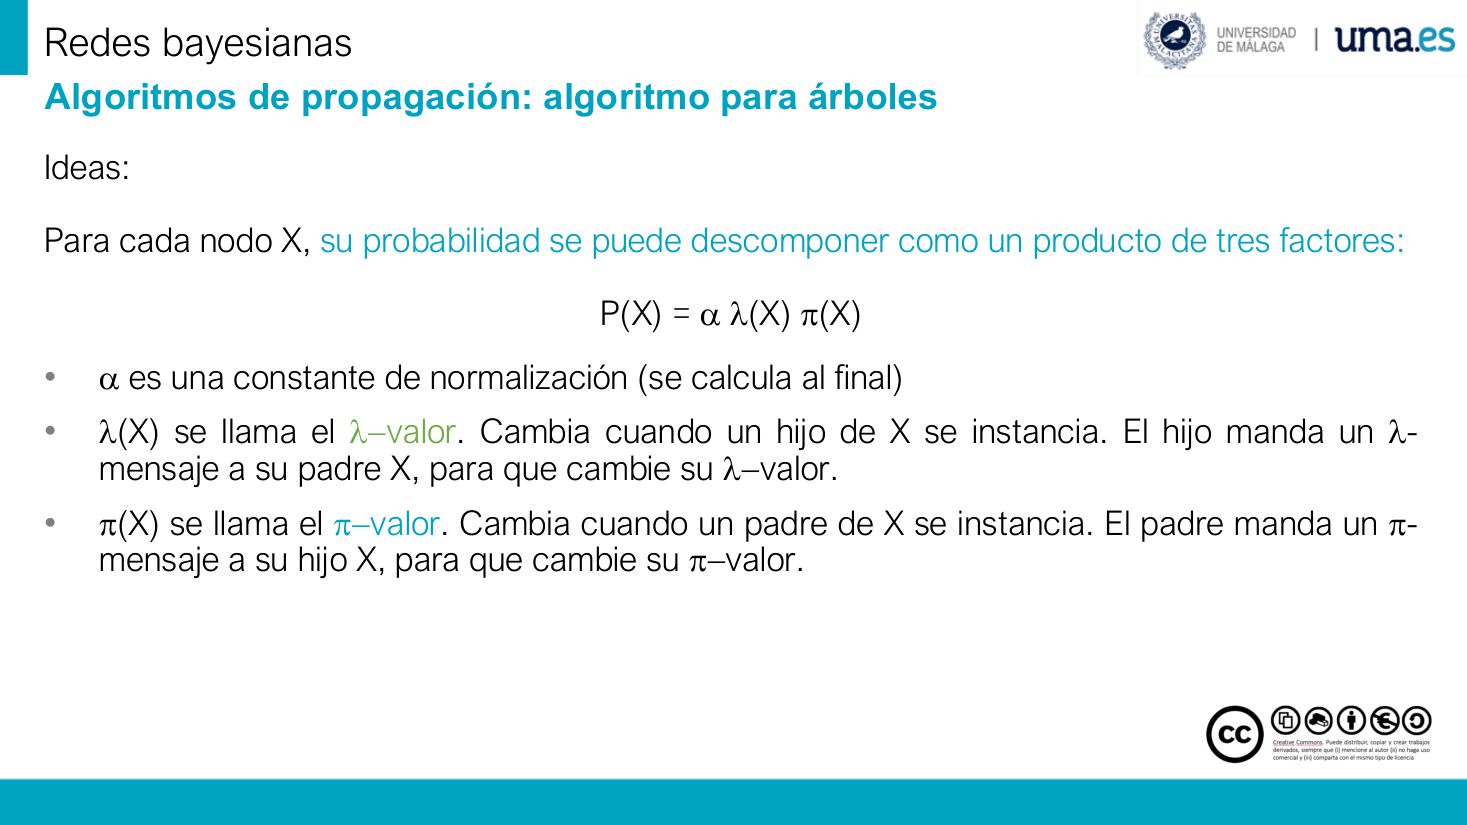
Redes bayesianas
贝叶斯网络(页眉)。
Ideas:
核心思路:
Para cada nodo X, su probabilidad se puede descomponer como un producto de tres factores:
对每个节点 X,它的概率都可以
P(X) = α λ(X) π(X)
P(X) 等于「归一化常数 × λ 值 × π 值」。
α es una constante de normalización (se calcula al final).
α 是
λ(X) se llama el λ-valor. Cambia cuando un hijo de X se instancia. El hijo manda un λ-mensaje a su padre X, para que cambie su λ-valor.
λ(X) 叫
π(X) se llama el π-valor. Cambia cuando un padre de X se instancia. El padre manda un π-mensaje a su hijo X, para que cambie su π-valor.
π(X) 叫
| 符号 | 西语读法 | 中文含义 |
|---|---|---|
| α | «alfa» | 归一化常数,最后算,保证各取值概率加起来为 1 |
| λ(X) | «lambda de equis» | 来自下方(子节点)的证据汇总 |
| π(X) | «pi de equis» | 来自上方(父节点 / 先验)的证据汇总 |
| λ-mensaje | «mensaje lambda» | 子 → 父,向上送 |
| π-mensaje | «mensaje pi» | 父 → 子,向下送 |
| 方向 | 谁变 | 发什么消息 | 影响谁 |
|---|---|---|---|
| ↑ 向上 | 子节点实例化 | λ-mensaje | 父节点的 λ 值 |
| ↓ 向下 | 父节点实例化 | π-mensaje | 子节点的 π 值 |
| ↑ 向上 | 父节点实例化 | 发 π 而不是 λ | 方向记反 = 全题崩 |
Ideas (cont.): cuándo se envían mensajes · 消息什么时候发、谁再转发
▸ 原页截图 p.86
Redes bayesianas
贝叶斯网络(页眉)。
Ideas:
核心思路(续):
Cada vez que un nodo se inicializa o cambia su probabilidad:
每当一个节点被
Manda un λ-mensaje a su nodo padre, para que cambie su λ-valor.
给它的
Manda un π-mensaje a todos sus nodos hijos, para que cambien su π-valores.
给它所有
Los nodos que reciben mensajes cambian sus probabilidades.
收到消息的节点会改变自己的概率。
Todos los nodos que cambian su probabilidad informan también a sus padres e hijos, enviándoles mensajes.
凡是概率变了的节点,都要再向自己的父节点和子节点发消息通报 —— 于是消息像波纹一样传遍全树。
| 触发条件 | 动作 | 发给谁 |
|---|---|---|
| 节点初始化 / 概率改变 | λ-mensaje | 它的父节点(1 条) |
| 节点初始化 / 概率改变 | π-mensaje | 它的全部子节点(每条 1 条) |
| 收到消息 | 重算自身概率 | — |
| 自身概率因此改变 | 继续转发 λ / π | 自己的父与子 |
| 只在收到消息时算一次 | 不转发 | 消息传不到整棵树 |
Normalización · 归一化:把 α 消掉,概率加起来等于 1
▸ 原页截图 p.87
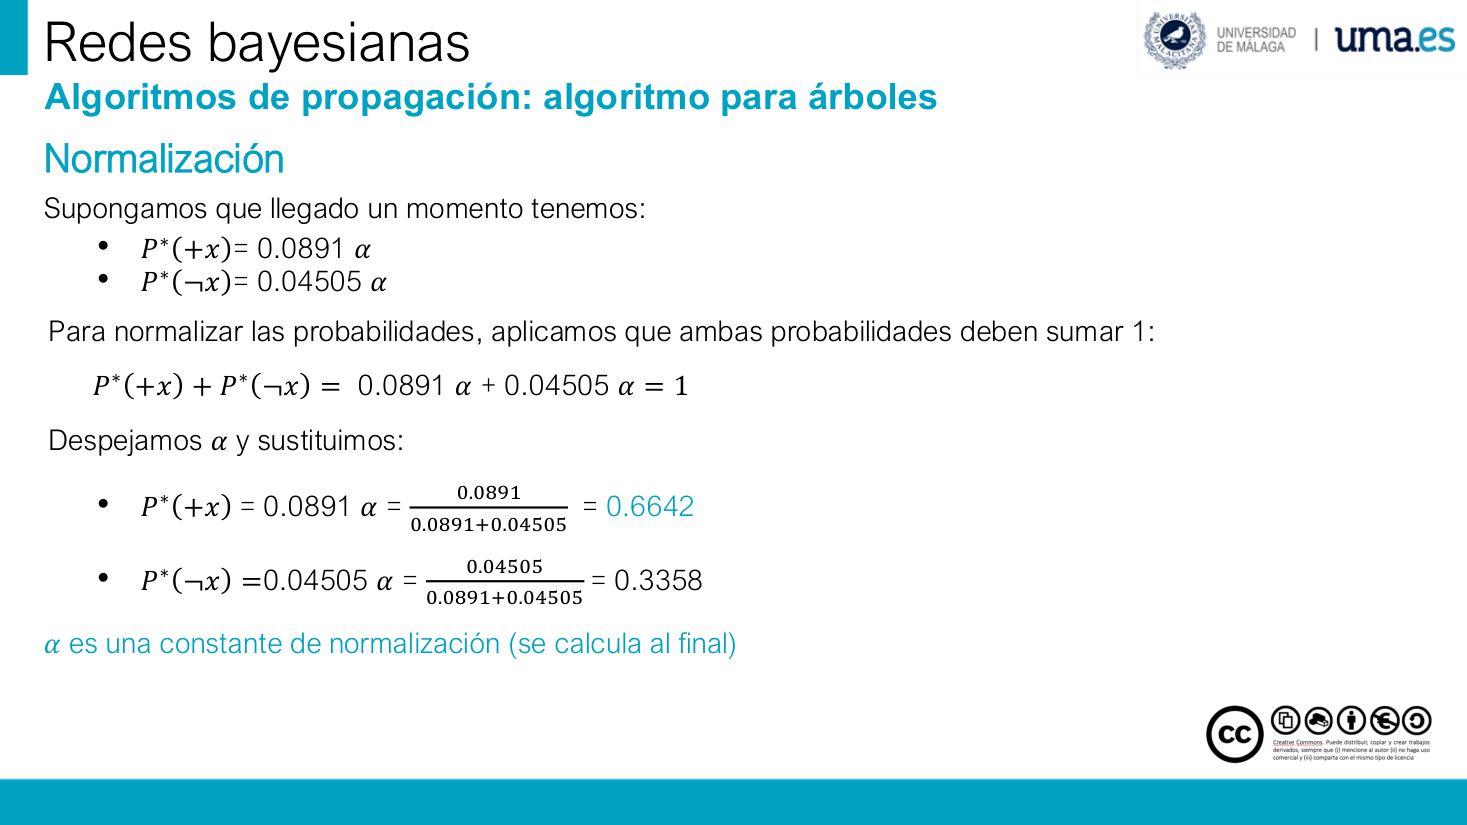
Redes bayesianas
贝叶斯网络(页眉)。
Normalización
Supongamos que llegado un momento tenemos:
假设算到某一步,我们手上是:
P*(+x) = 0.0891 α
X 取「真」的新概率 = 0.0891 乘 α。
P*(¬x) = 0.04505 α
X 取「假」的新概率 = 0.04505 乘 α。
Para normalizar las probabilidades, aplicamos que ambas probabilidades deben sumar 1:
归一化就是利用「两种取值的概率加起来必须等于 1」:
P*(+x) + P*(¬x) = 0.0891 α + 0.04505 α = 1
两个式子相加等于 1,由此解出 α。
Despejamos α y sustituimos:
把 α 解出来,再代回去:
P*(+x) = 0.0891 α = 0.0891 / (0.0891 + 0.04505) = 0.6642
「真」的概率 = 0.0891 除以两者之和 = 0.6642。
P*(¬x) = 0.04505 α = 0.04505 / (0.0891 + 0.04505) = 0.3358
「假」的概率 = 0.04505 除以两者之和 = 0.3358。
α es una constante de normalización (se calcula al final).
α 是归一化常数,留到最后由「和为 1」这个条件反解,不用中途单独求。
| 步骤 | 式子 | 说明 |
|---|---|---|
| 1 | 0{,}0891α + 0{,}04505α = 1 | 两取值概率之和为 1 |
| 2 | α = 1 / 0{,}13415 | 解出 α |
| 3 | P*(+x) = 0{,}0891 / 0{,}13415 | 代入,α 自动约掉 |
| 4 | = 0{,}6642 | 结果 |
| 5 | P*(¬x) = 1 − 0{,}6642 = 0{,}3358 | 用补数校验 |
| × | P*(+x) = 0{,}0891 | 忘记乘/除 α,概率不合 1 |
| 符号 | 西语读法 | 中文含义 |
|---|---|---|
| P*(+x) | «p asterisco de más equis» | X 为真的后验概率 |
| P*(¬x) | «p asterisco de no equis» | X 为假的后验概率 |
| despejar α | «despejar alfa» | 把 α 分离出来求解 |
| sustituir | «sustituir» | 代回原式 |
Ejemplos · 树形网络实例:感冒–黏膜–发烧–咳嗽–打喷嚏–疼痛
▸ 原页截图 p.88
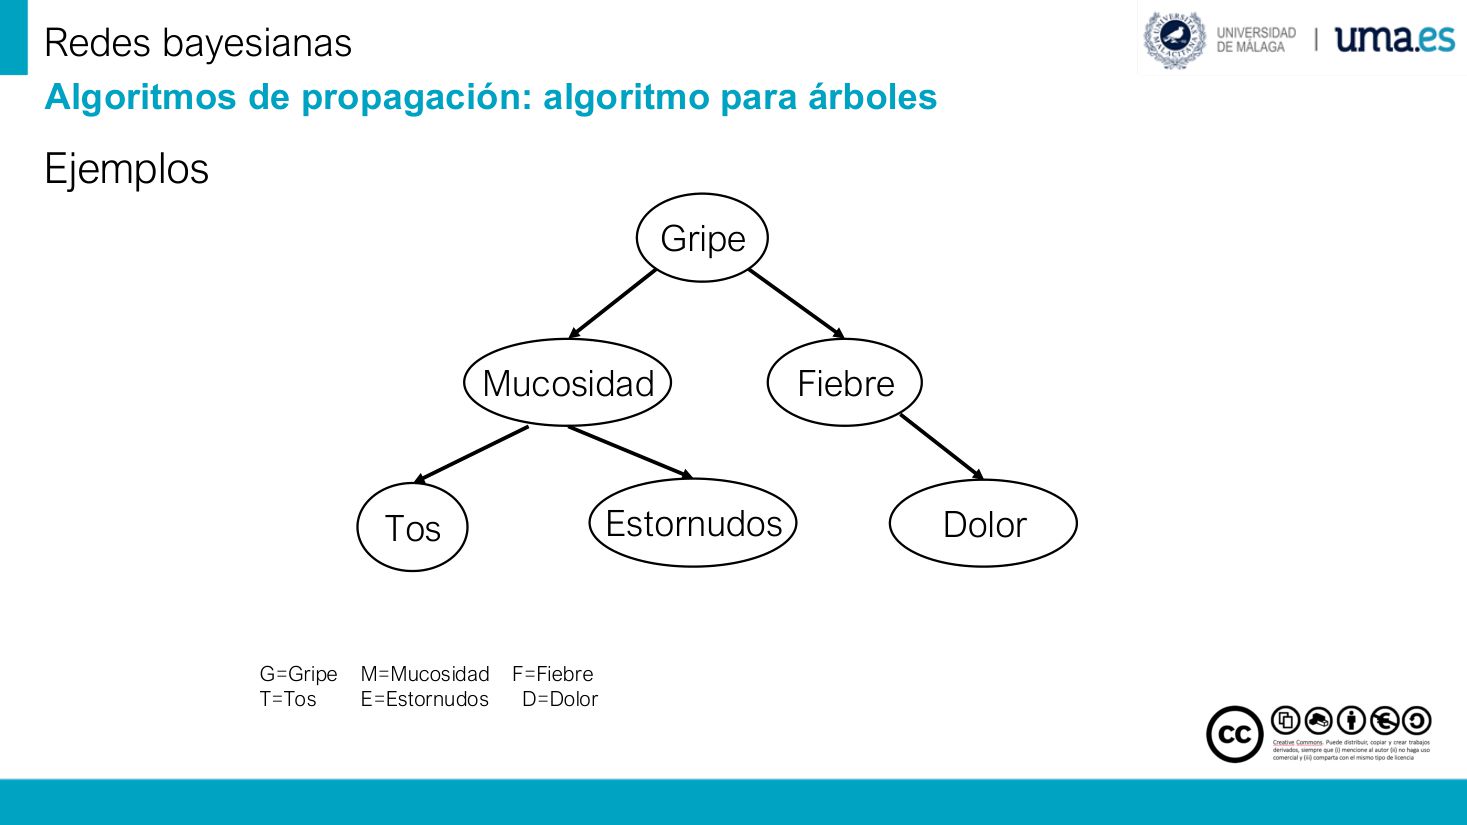
Redes bayesianas
贝叶斯网络(页眉)。
Ejemplos
Mucosidad · Gripe · Fiebre · Dolor · Estornudos · Tos
节点名依次是:
G = Gripe M = Mucosidad F = Fiebre
缩写:G 感冒、M 黏膜、F 发烧。
T = Tos E = Estornudos D = Dolor
缩写:T 咳嗽、E 打喷嚏、D 疼痛。
| 缩写 | 西语 | 中文 | 在树中的位置 |
|---|---|---|---|
| G | Gripe | 感冒 | 根节点(唯一无父) |
| M | Mucosidad | 黏膜 / 鼻涕 | G 的子节点 |
| F | Fiebre | 发烧 | G 的子节点 |
| T | Tos | 咳嗽 | M 的子节点 |
| E | Estornudos | 打喷嚏 | M 的子节点 |
| D | Dolor | 疼痛 | F 的子节点 |
Ejemplos: las seis ecuaciones de partida · 每个节点都写成 αλπ
▸ 原页截图 p.89
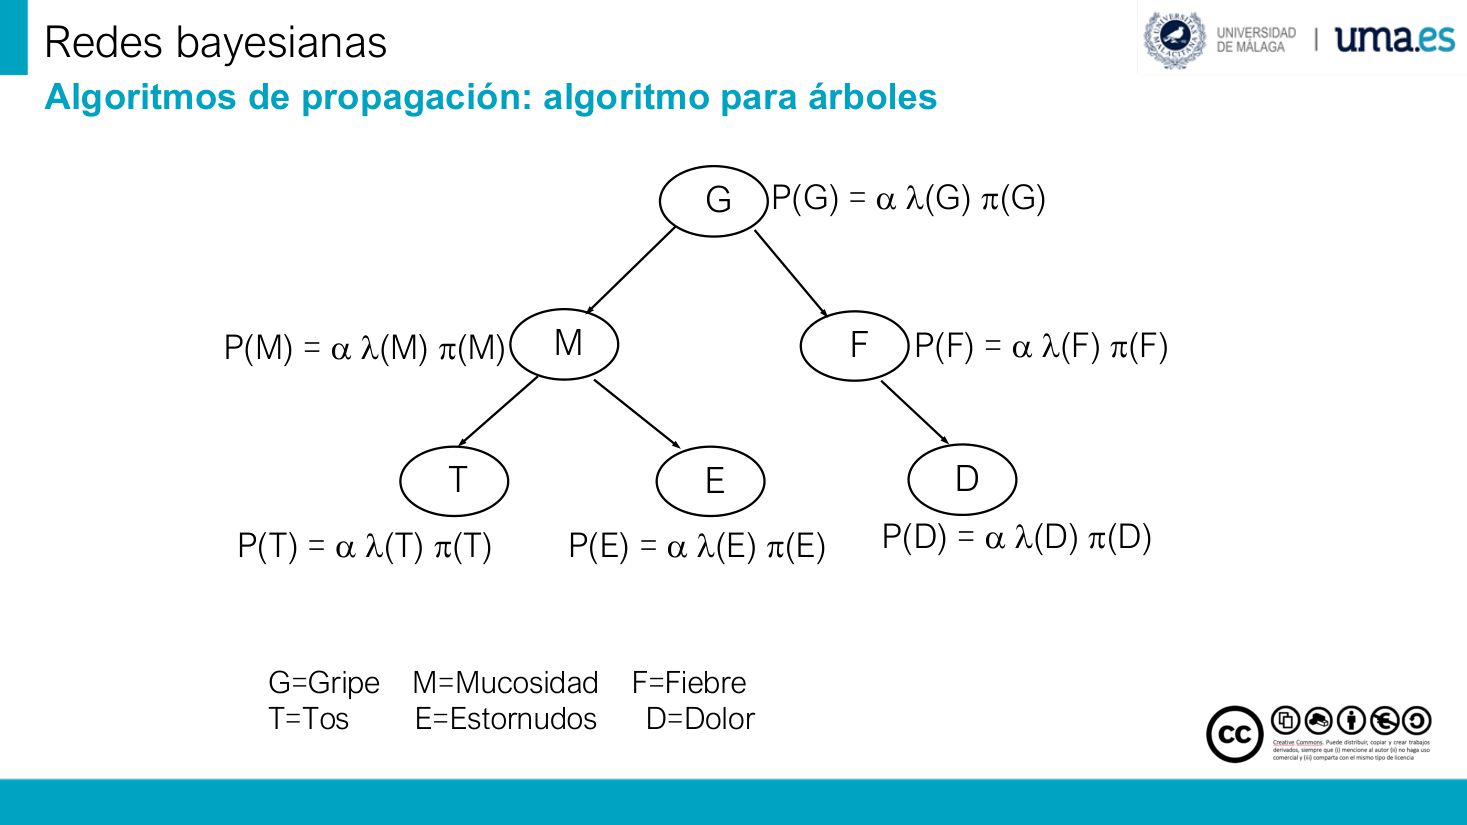
Redes bayesianas
贝叶斯网络(页眉)。
P(G) = α λ(G) π(G)
感冒:P(G)=α·λ(G)·π(G)。
P(F) = α λ(F) π(F)
发烧:P(F)=α·λ(F)·π(F)。
P(D) = α λ(D) π(D)
疼痛:P(D)=α·λ(D)·π(D)。
P(M) = α λ(M) π(M)
黏膜:P(M)=α·λ(M)·π(M)。
P(E) = α λ(E) π(E)
打喷嚏:P(E)=α·λ(E)·π(E)。
P(T) = α λ(T) π(T)
咳嗽:P(T)=α·λ(T)·π(T)。
G = Gripe M = Mucosidad F = Fiebre
缩写:G 感冒、M 黏膜、F 发烧。
T = Tos E = Estornudos D = Dolor
缩写:T 咳嗽、E 打喷嚏、D 疼痛。
| 节点 | 自己的 π 从哪来 | 自己的 λ 从哪来 |
|---|---|---|
| G(根) | 自身先验 P(G) | 子节点 M、F 的 λ 消息相乘 |
| M | 父 G 的 π 消息 | 子节点 T、E 的 λ 消息相乘 |
| F | 父 G 的 π 消息 | 子节点 D 的 λ 消息 |
| T | 父 M 的 π 消息 | 无子 → λ(T)=1 |
| E | 父 M 的 π 消息 | 无子 → λ(E)=1 |
| D | 父 F 的 π 消息 | 无子 → λ(D)=1 |
Supongamos M = sí · 设「有黏膜」:公式区与节点区整体错位一格
▸ 原页截图 p.90
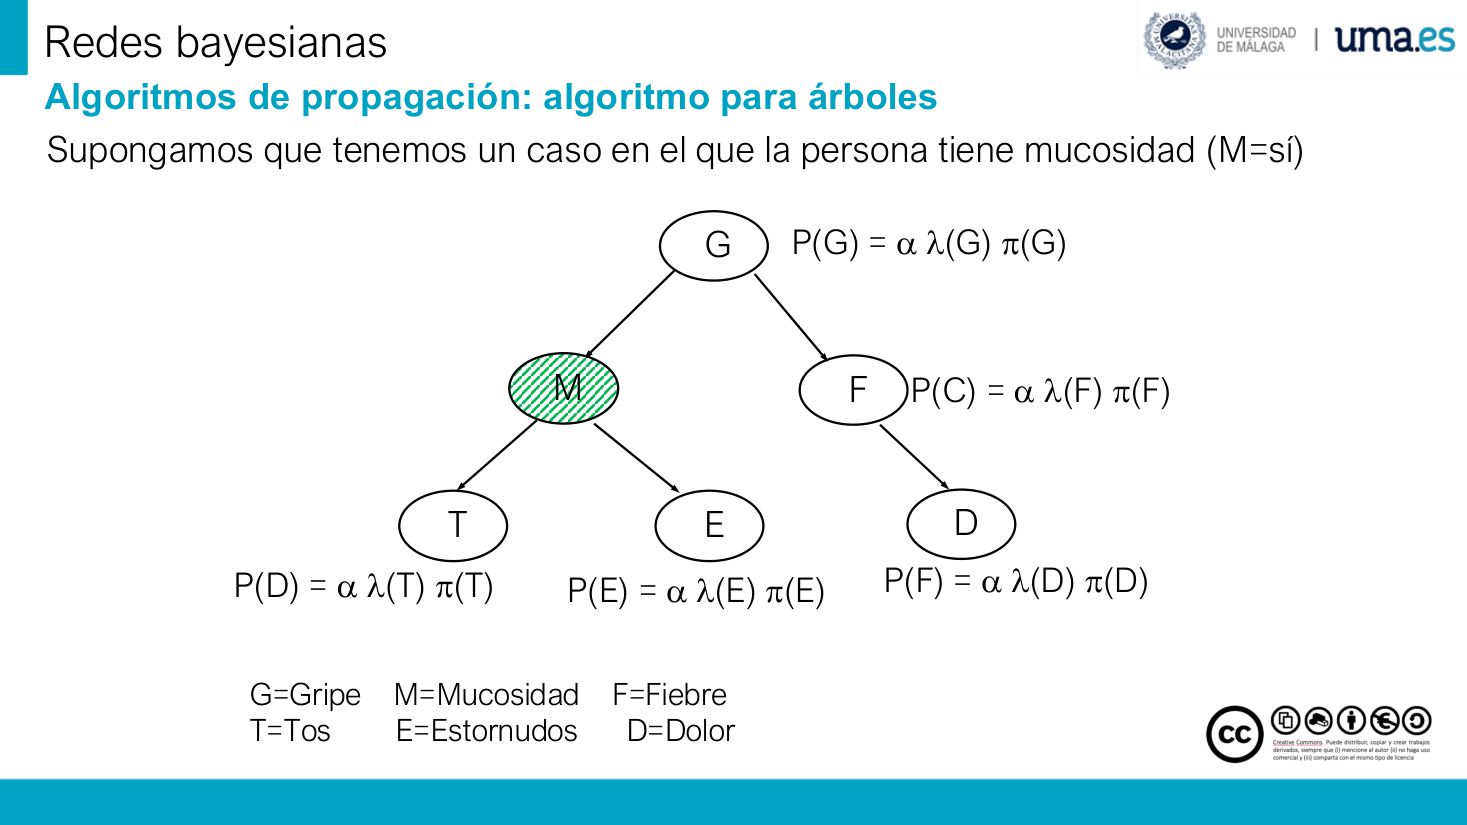
Redes bayesianas
贝叶斯网络(页眉)。
Supongamos que tenemos un caso en el que la persona tiene mucosidad (M = sí).
假设我们遇到的情况是:这个人有黏膜症状,即 M = sí(是)。
P(G) = α λ(G) π(G)
感冒(G)这条式子不变。
P(C) = α λ(F) π(F)
原文写 P(C),右侧用的是 F 的 λ、π —— 这一行是发烧 F 的式子,左侧字母被误打成 C。
P(F) = α λ(D) π(D)
原文写 P(F),右侧是 D 的 λ、π —— 实际指的是疼痛 D。
P(E) = α λ(E) π(E)
打喷嚏 E,这一行左右一致。
P(D) = α λ(T) π(T)
原文写 P(D),右侧是 T 的 λ、π —— 实际指的是咳嗽 T。
G = Gripe M = Mucosidad F = Fiebre
缩写:G 感冒、M 黏膜、F 发烧。
T = Tos E = Estornudos D = Dolor
缩写:T 咳嗽、E 打喷嚏、D 疼痛。
| 原文左侧 | 原文右侧 | 实际对应节点 | 判断依据 |
|---|---|---|---|
| P(G) | α λ(G) π(G) | G = Gripe | 左右一致 |
| P(C) | α λ(F) π(F) | F = Fiebre | 以右侧变量为准 |
| P(F) | α λ(D) π(D) | D = Dolor | 以右侧变量为准 |
| P(E) | α λ(E) π(E) | E = Estornudos | 左右一致 |
| P(D) | α λ(T) π(T) | T = Tos | 以右侧变量为准 |
Paso 1: M → G, mensaje λ · 第一步:黏膜给感冒送 λ 消息
▸ 原页截图 p.91
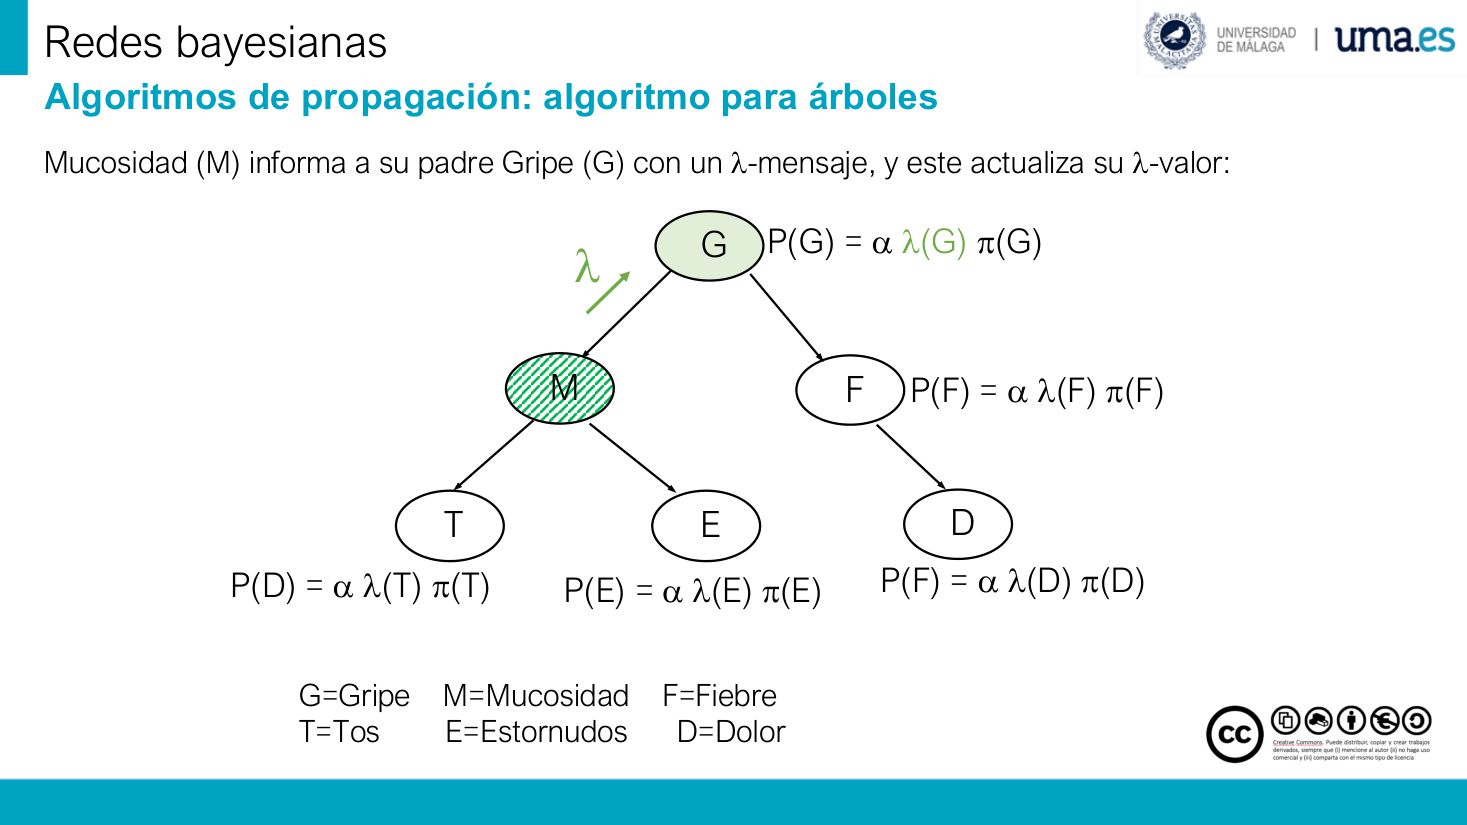
Redes bayesianas
贝叶斯网络(页眉)。
Mucosidad (M) informa a su padre Gripe (G) con un λ-mensaje, y este actualiza su λ-valor.
P(G) = α λ(G) π(G)
G 的概率公式里,λ(G) 这一项此刻被改写。
P(F) = α λ(F) π(F)
F(发烧)此时还没有收到任何 λ 消息,式子不变。
P(E) = α λ(E) π(E)
E(打喷嚏)式子不变。
G = Gripe M = Mucosidad F = Fiebre
缩写:G 感冒、M 黏膜、F 发烧。
| 步骤 | 谁 → 谁 | 发什么 | 接收者改什么 |
|---|---|---|---|
| 证据落地 | 外部 → M | M = sí | M 的 P* 变成 1(已实例化) |
| 第 1 条消息 | M → G | λ-mensaje | G 的 λ 值 |
| 第 1 次重算 | G 自己 | 用 αλ(G)π(G) | G 的概率 |
| 常见错误 | M → F | 给兄弟节点发消息 | F 不是 M 的父,方向乱 |
Paso 2: M → T, E, mensajes π · 第二步:黏膜给两个儿子送 π 消息
▸ 原页截图 p.92
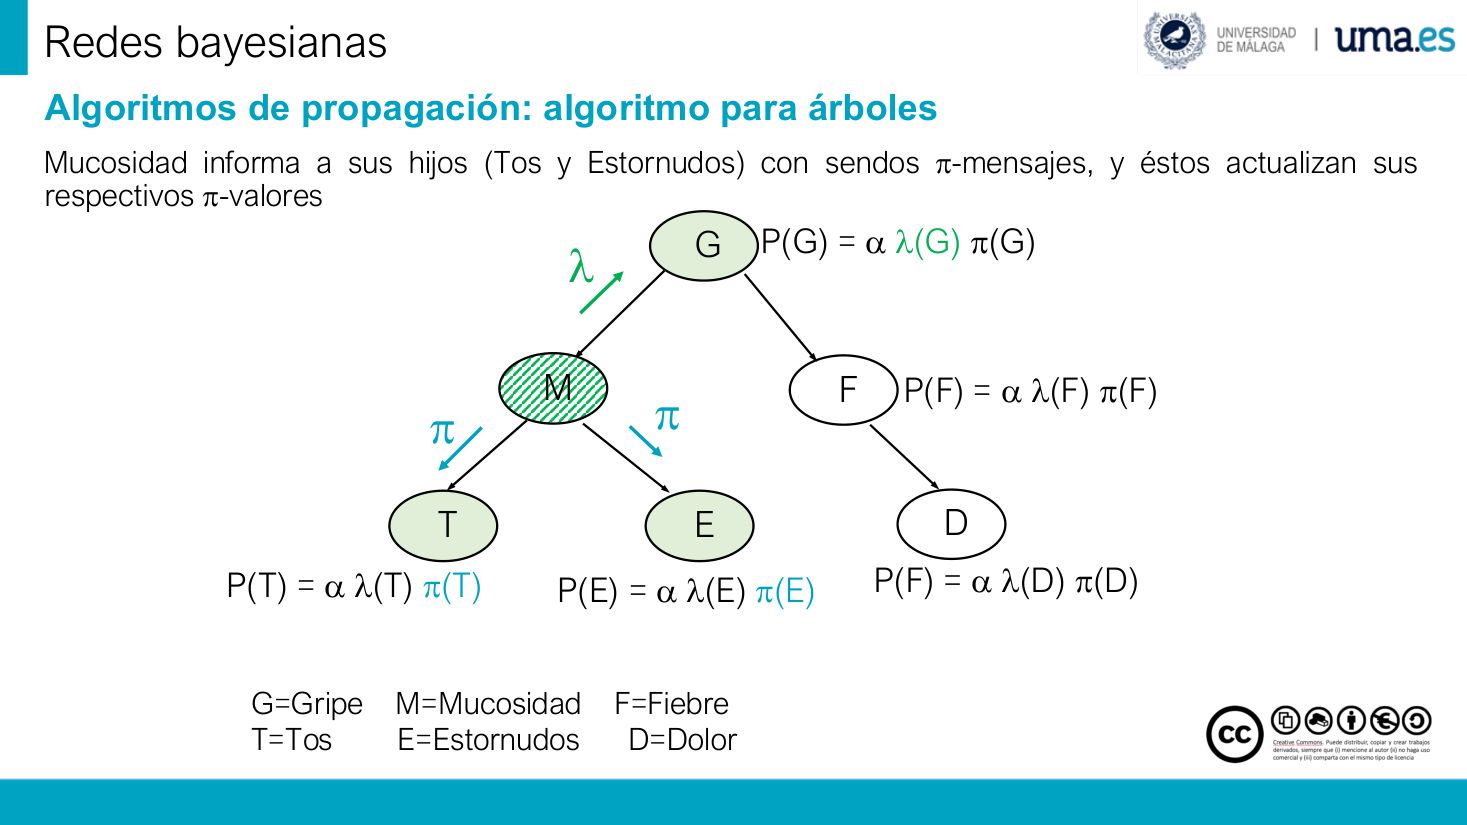
Redes bayesianas
贝叶斯网络(页眉)。
Mucosidad informa a sus hijos (Tos y Estornudos) con sendos π-mensajes, y éstos actualizan sus respectivos π-valores.
黏膜 M 给它的两个子节点 ——
P(T) = α λ(T) π(T)
T 的公式里,π(T) 被更新。
P(E) = α λ(E) π(E)
E 的公式里,π(E) 被更新。
P(G) = α λ(G) π(G)
G 保持上一步的 λ 值,公式不变。
| 发送者 | 接收者 | 消息 | 被更新的项 |
|---|---|---|---|
| M | T | π-mensaje | π(T) |
| M | E | π-mensaje | π(E) |
| M | G | λ-mensaje | λ(G)(上一步已完成) |
| M | D | 没有边 | D 不是 M 的儿子 |
Paso 3: G → F, mensaje π · 第三步:感冒的概率变了,给发烧送 π
▸ 原页截图 p.93
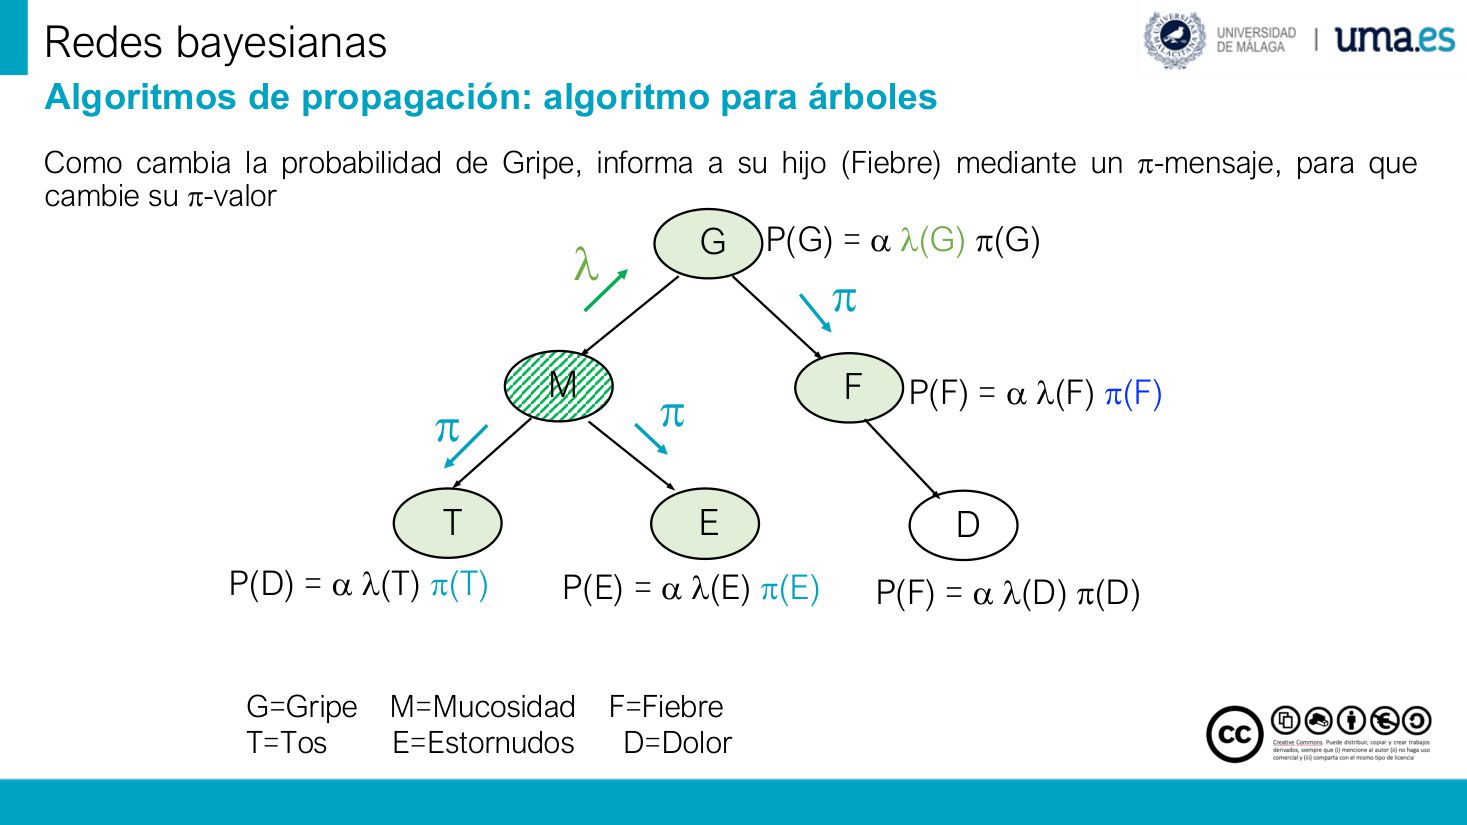
Redes bayesianas
贝叶斯网络(页眉)。
Como cambia la probabilidad de Gripe, informa a su hijo (Fiebre) mediante un π-mensaje, para que cambie su π-valor.
因为
P(F) = α λ(F) π(F)
F 的 π(F) 在这一步被改写。
P(G) = α λ(G) π(G)
G 已经重算过,本步不再变。
P(E) = α λ(E) π(E)
E 也保持不变。
| 因果链 | 消息方向 | 为什么发 |
|---|---|---|
| M = sí → G 变 | M → G(λ,向上) | 子节点证据改变父节点 |
| G 变 → F 该变 | G → F(π,向下) | 父节点概率改变子节点 |
| G → M 也变? | G → M(π) | 但 M 已实例化,P*(M) 固定,不再重算 |
| G 变 → 只通知 F 不通知 M | 漏发 | 规则要求给「所有子节点」发 |
Paso 4: F → D, mensaje π · 第四步:发烧变了,给疼痛送 π
▸ 原页截图 p.94
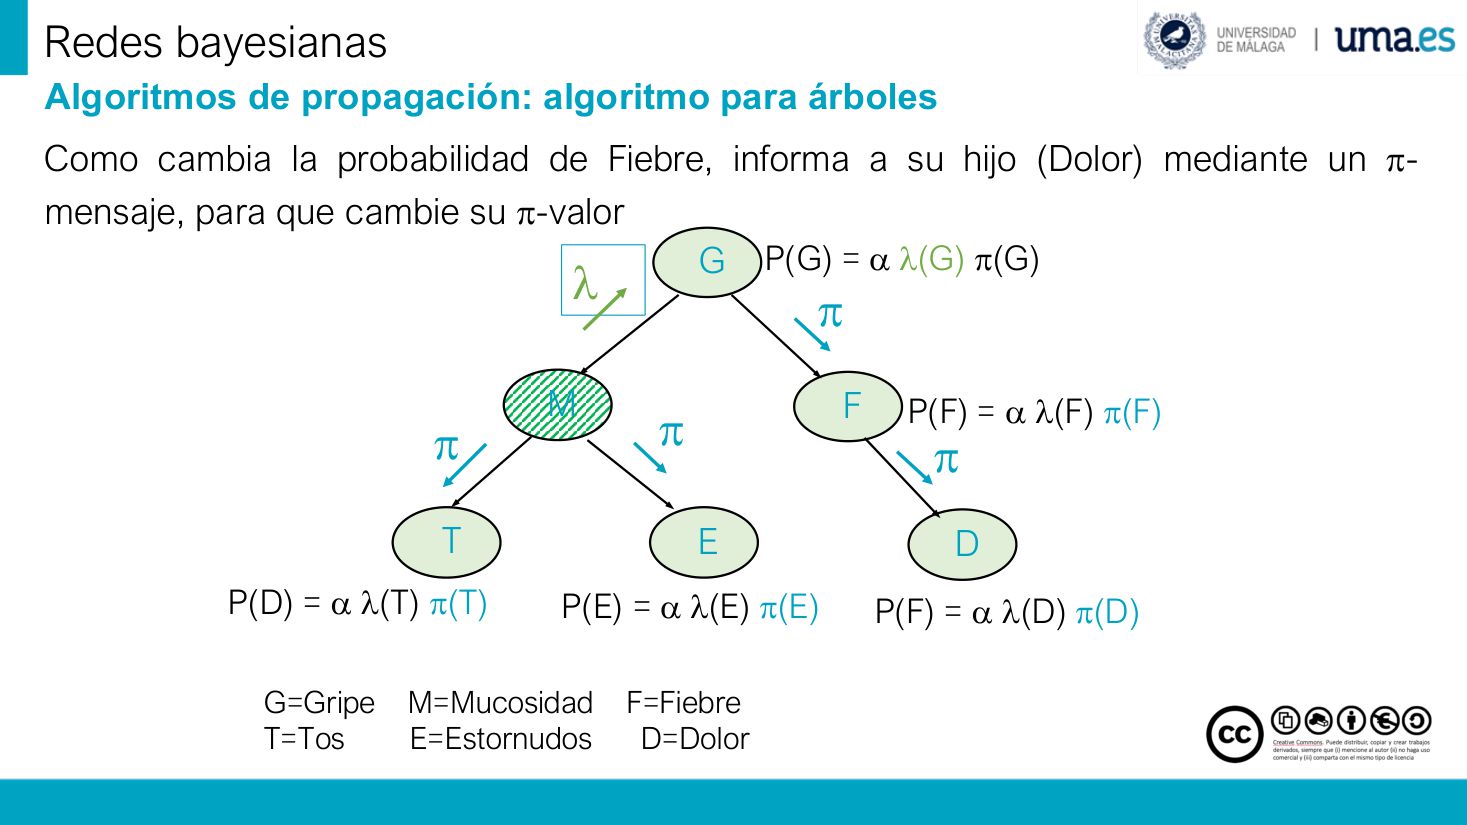
Redes bayesianas
贝叶斯网络(页眉)。
Como cambia la probabilidad de Fiebre, informa a su hijo (Dolor) mediante un π-mensaje, para que cambie su π-valor.
因为
P(F) = α λ(F) π(F)
F 自己的式子已完成更新,本步作为发送方。
P(D) = α λ(D) π(D)
D 的 π(D) 在这一步被改写。
P(G) = α λ(G) π(G)
G 不再参与本轮更新。
| 轮次 | 消息 | 被更新的节点 |
|---|---|---|
| 1 | M → G (λ) | G:λ 值更新、概率重算 |
| 2 | M → T, E (π) | T、E:π 值更新 |
| 3 | G → F (π) | F:π 值更新、概率重算 |
| 4 | F → D (π) | D:π 值更新、概率重算 |
| — | 没有 D → 任何节点 | D 是叶子,λ(D)=1,无子可发 |
Dos etapas: inicialización y actualización · 两阶段:先算先验 S0,再算后验 S1…
▸ 原页截图 p.95
Redes bayesianas
贝叶斯网络(页眉)。
Empezamos con una red bayesiana (nodos, enlaces y parámetros).
出发点是一张建好的贝叶斯网络:
Se divide en dos etapas:
整个算法分成两个
Inicialización. Calcular todas las probabilidades a priori P(X) de todos los nodos. En el ejemplo de los apuntes, el estado S0 (estado inicial).
Actualización. Cuando conocemos el valor de un nodo (evidencia e), actualizar todas las probabilidades, es decir, calcular las probabilidades a posteriori P*(X) = P(X/e) de todos los nodos de la red. En el ejemplo de los apuntes, estados S1 y sucesivos.
Todos los valores y mensajes (los λ y los π) son fórmulas.
所有值和消息(λ 与 π)本身都是公式,不是一个算好的数 —— 这一点初学者最容易忽略。
Tenéis una hoja resumen de las etapas y las fórmulas en el Campus virtual.
虚拟校园里有一张汇总表,列出各阶段与对应公式。
| 阶段 | 西语 | 算什么 | 状态标记 | 触发条件 |
|---|---|---|---|---|
| Ⅰ | Inicialización | 全部先验 P(X) | S0 | 网络建好、还没有证据 |
| Ⅱ | Actualización | 全部后验 P*(X)=P(X/e) | S1, S2, … | 每来一条证据 e |
| × | 只算一次 | 忽略后续证据 | — | 证据可以不断追加,状态会一直往后走 |
La inicialización como una actualización desde la raíz · 把「初始化」看成从根节点出发的一次更新
▸ 原页截图 p.96
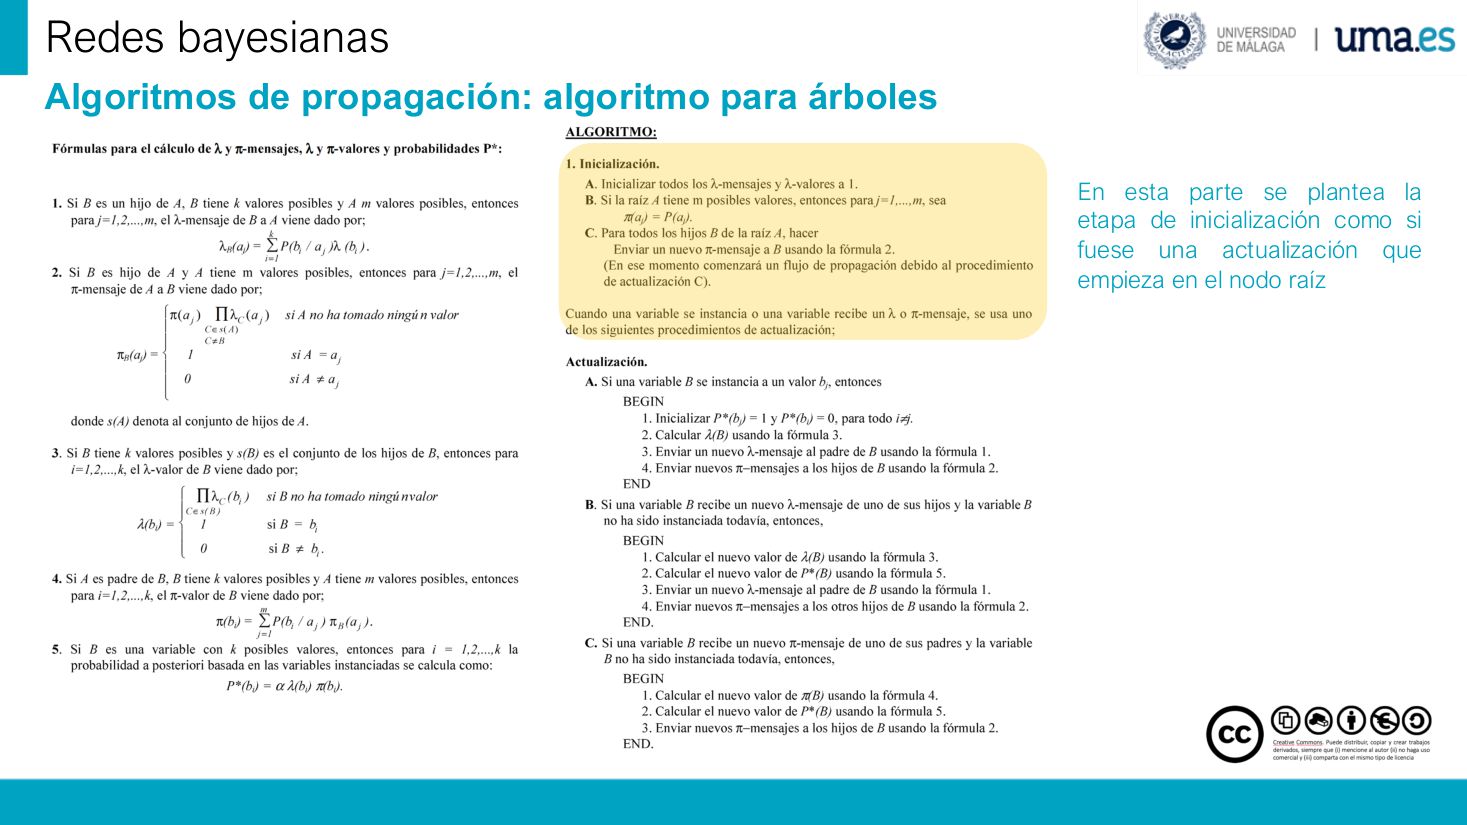
Redes bayesianas
贝叶斯网络(页眉)。
En esta parte se plantea la etapa de inicialización como si fuese una actualización que empieza en el nodo raíz.
这一部分把
Algoritmos de propagación: algoritmo para árboles
传播算法:树形网络版本(本节标题)。
La etapa de inicialización
所谓「初始化」这一步。
se plantea como una actualización que empieza en el nodo raíz
被处理成像一次从根节点开始的更新过程。
| 视角 | 初始化(S0) | 一次更新(S1) |
|---|---|---|
| 起点 | 根节点 A | 某个被实例化的节点 B |
| λ 状态 | 全部 λ = 1(还没有子女证据) | 被实例化节点向上送新 λ |
| π 状态 | 根自己的 π(a_j) = P(a_j) | 父节点向下送新 π |
| 方向 | 只往下(π 单程) | 先上(λ)再下(π) |
| 是否相同机制 | 是 —— 初始化就是「只有根、没有证据」的特例 | |
Flujo de información · 信息怎么流:箭头图 + 三种节点状态
▸ 原页截图 p.97
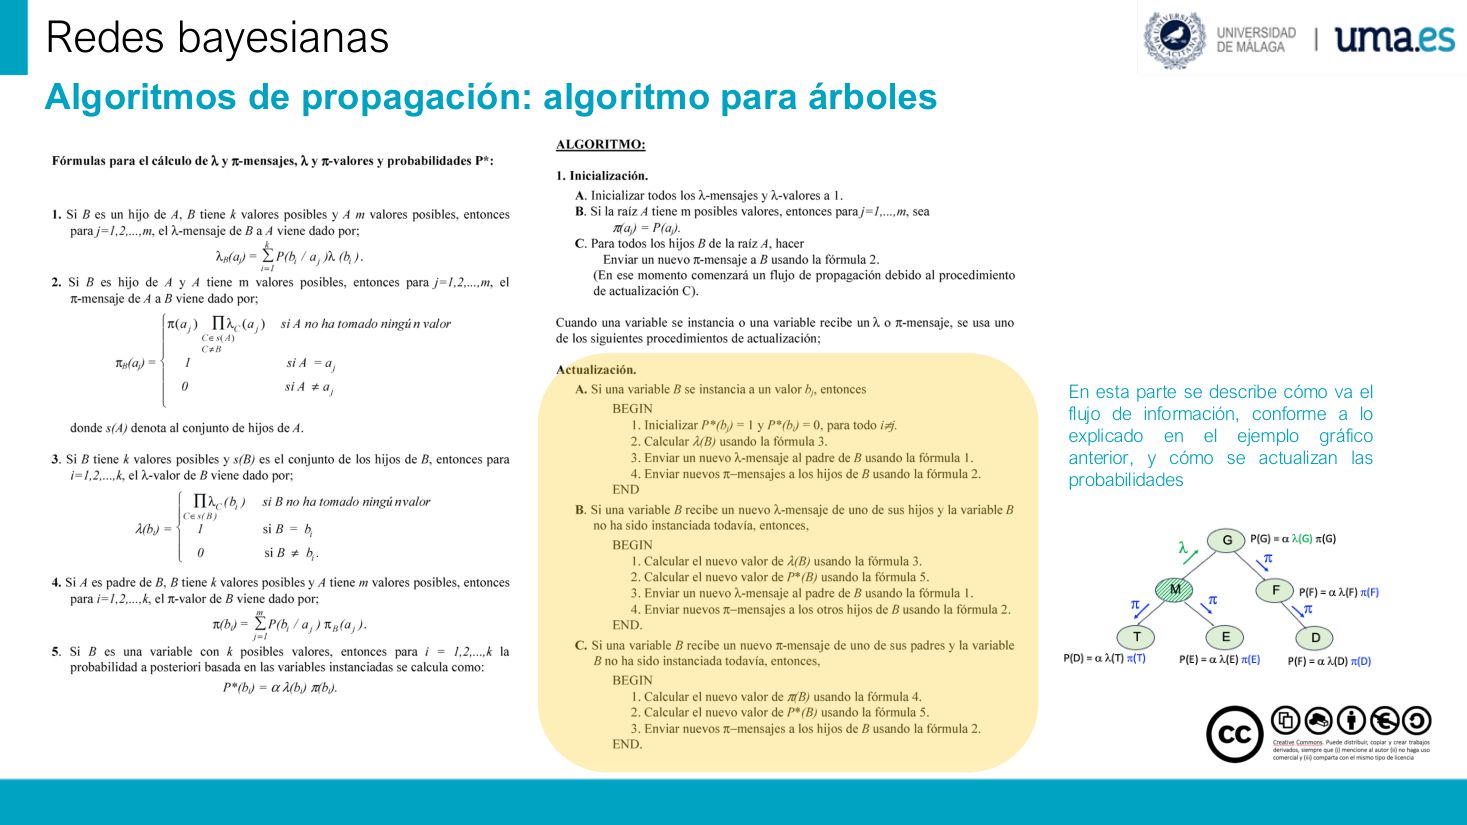
Redes bayesianas
贝叶斯网络(页眉)。
En esta parte se describe cómo va el flujo de información, conforme a lo explicado en el ejemplo gráfico anterior, y cómo se actualizan las probabilidades.
这一部分描述
Algoritmos de propagación: algoritmo para árboles
传播算法:树形网络版本(本节标题)。
cómo va el flujo de información
信息流「怎么走」。
cómo se actualizan las probabilidades
概率「怎么被更新」。
| 节点状态 | 它收到什么 | 它要做什么(伪码对应) |
|---|---|---|
| 刚被实例化 | 外部证据 | P*(固定值)=1,其余=0;算 λ(B);向父发 λ;向所有子发 π |
| 收到某子的 λ,且自己未实例化 | λ-mensaje | 算 λ(B);算 P*(B);向父发 λ;向其余子发 π |
| 收到某父的 π,且自己未实例化 | π-mensaje | 算 π(B);算 P*(B);向所有子发 π |
| 已实例化却继续改概率 | — | 实例化节点的 P* 被钉死为 1/0,不再重算 |
Fórmulas de λ/π y pseudocódigo del algoritmo · 五条公式 + 完整伪码(本章总纲)
▸ 原页截图 p.98
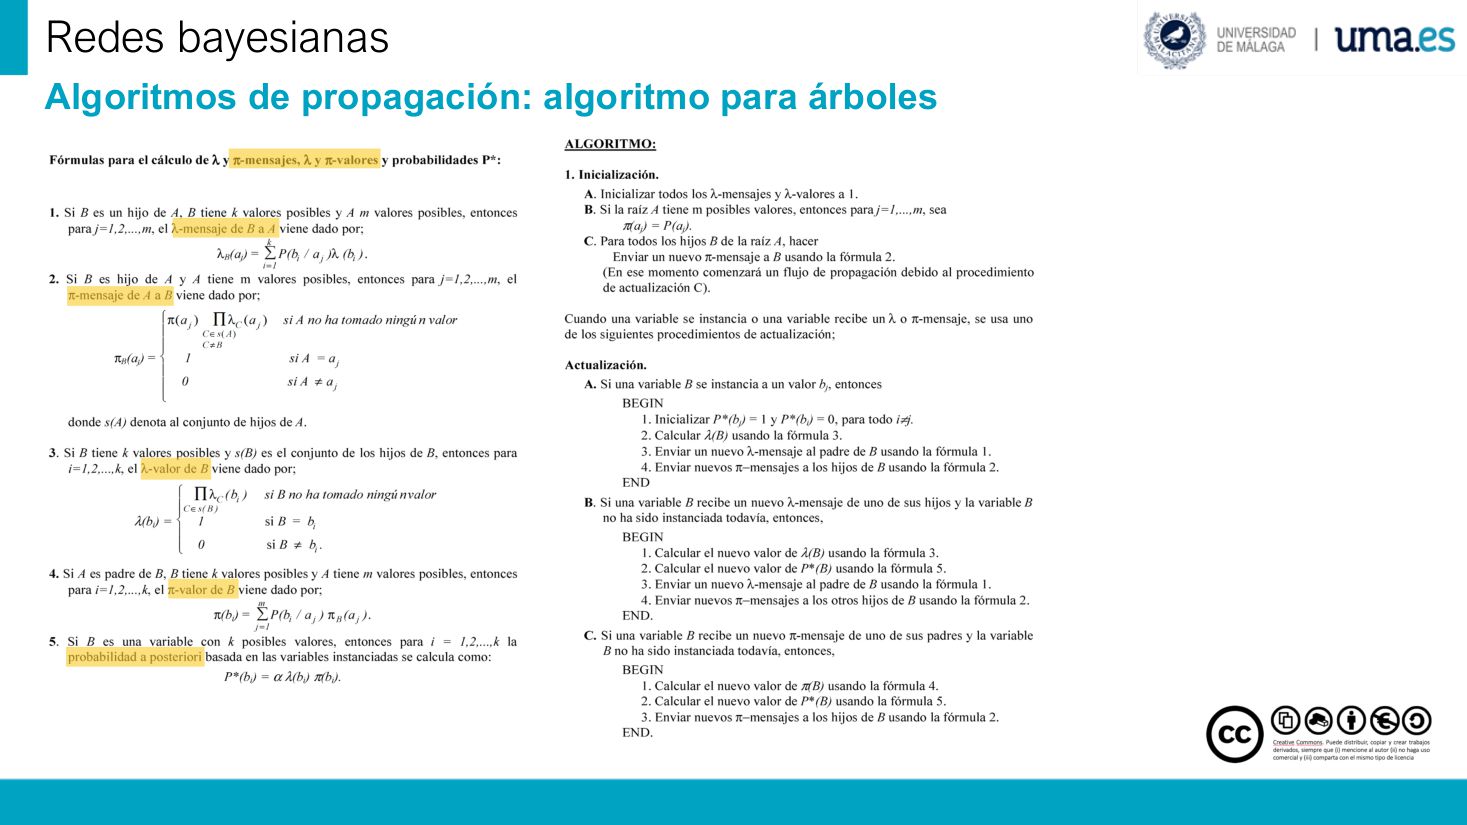
Algoritmos de propagación: algoritmo para árboles
传播算法:树形网络版本(本节标题)。
Fórmulas para el cálculo de λ y π-mensajes, λ y π-valores y probabilidades P*:
计算 λ 消息、π 消息、λ 值、π 值与后验概率 P* 的五条公式。
1. Si B es un hijo de A, B tiene k valores posibles y A m valores posibles, entonces para j = 1, 2, …, m, el λ-mensaje de B a A viene dado por:
公式 1:若 B 是 A 的子节点,B 有 k 个可能取值、A 有 m 个可能取值,则对 j=1,…,m,B 发给 A 的 λ 消息为:
2. Si B es hijo de A y A tiene m valores posibles, entonces para j = 1, 2, …, m, el π-mensaje de A a B viene dado por:
公式 2:若 B 是 A 的子节点、A 有 m 个可能取值,则对 j=1,…,m,A 发给 B 的 π 消息为:
donde s(A) denota al conjunto de hijos de A.
其中 s(A) 表示 A 的
3. Si B tiene k valores posibles y s(B) es el conjunto de los hijos de B, entonces para i = 1, 2, …, k, el λ-valor de B viene dado por:
公式 3:若 B 有 k 个可能取值、s(B) 是 B 的子节点集合,则对 i=1,…,k,B 的 λ 值为:
4. Si A es padre de B, B tiene k valores posibles y A tiene m valores posibles, entonces para i = 1, 2, …, k, el π-valor de B viene dado por:
公式 4:若 A 是 B 的父节点,B 有 k 个取值、A 有 m 个取值,则对 i=1,…,k,B 的 π 值为:
5. Si B es una variable con k posibles valores, entonces para i = 1, 2, …, k, la probabilidad a posteriori basada en las variables instanciadas se calcula como:
公式 5:若 B 是有 k 个可能取值的变量,则对 i=1,…,k,基于已实例化变量的后验概率为:
| 公式 | 算什么 | 方向 | 核心动作 |
|---|---|---|---|
| 1 | λ_B(a_j) | B → A(↑) | 对 B 的所有取值 i 求和 |
| 2 | π_B(a_j) | A → B(↓) | 父的 π 乘以「除 B 以外其他子女的 λ」 |
| 3 | λ(b_i) | 节点自身 | 把所有子女的 λ 消息连乘 |
| 4 | π(b_i) | 节点自身 | 对父的所有取值 j 求和 |
| 5 | P*(b_i) | 节点自身 | α × λ × π,最后归一化 |
| 2 / 3 | 已实例化分支 | — | 取值命中记 1,未命中记 0(硬开关) |
ALGORITMO:
I. Inicialización.
Ⅰ.
A. Inicializar todos los λ-mensajes y λ-valores a 1.
A. 把所有 λ 消息与 λ 值都置为 1。
B. Si la raíz A tiene m posibles valores, entonces para j = 1, …, m, sea π(a_j) = P(a_j).
B. 若根节点 A 有 m 个可能取值,则对 j=1,…,m,令 π(a_j)=P(a_j)(根的 π 值就是它的先验)。
C. Para todos los hijos B de la raíz A, hacer: Enviar un nuevo π-mensaje a B usando la fórmula 2. (En este momento comienza un flujo de propagación debido al procedimiento de actualización C).
C. 对根 A 的每一个子节点 B:用公式 2 给 B 发一条新的 π 消息。(此时会由「更新过程 C」引发一连串传播。)
| 更新过程 | 触发条件 | 要做的事 |
|---|---|---|
| A | 变量 B 被实例化为 b_j | ① P*(b_j)=1、其余 P*(b_i)=0 ② 用公式 3 算 λ(B) ③ 用公式 1 向父发 λ ④ 用公式 2 向所有子发 π |
| B | B 收到某个子的新 λ,且自身未实例化 | ① 用公式 3 算 λ(B) ② 用公式 5 算 P*(B) ③ 用公式 1 向父发 λ ④ 用公式 2 向其余子发 π |
| C | B 收到某个父的新 π,且自身未实例化 | ① 用公式 4 算 π(B) ② 用公式 5 算 P*(B) ③ 用公式 2 向所有子发 π |
| 三个分支都不改「已实例化」的 B 的 P* —— 一旦 P*(b_j)=1,它就钉死不动 | ||
Misma página, π_B compacto · 同一张总纲的紧凑写法 + 两条黄色注释
▸ 原页截图 p.99
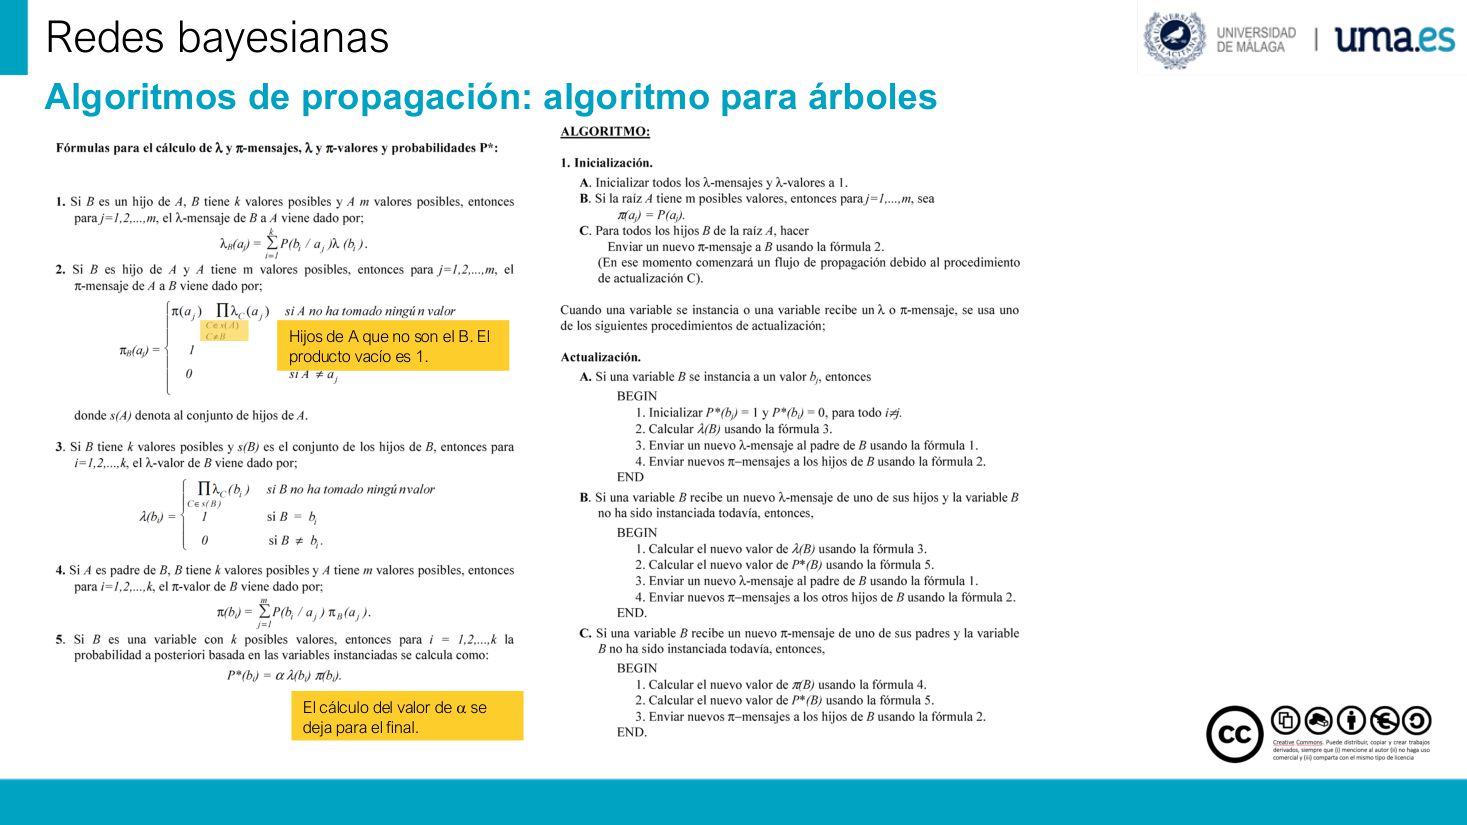
Algoritmos de propagación: algoritmo para árboles
传播算法:树形网络版本(本节标题)。
Fórmulas para el cálculo de λ y π-mensajes, λ y π-valores y probabilidades P*:
λ/π 消息、λ/π 值与 P* 的计算公式(与上一页同一组)。
2. Si B es hijo de A y A tiene m valores posibles, entonces para j = 1, 2, …, m, el π-mensaje de A a B viene dado por:
公式 2(紧凑版):A 发给 B 的 π 消息——
Hijos de A que no son el B. El producto vacío es 1.
「A 的子女中除 B 之外的那些」——这就是 C≠B 的含义;空乘积等于 1(若 A 只有 B 一个孩子,那个连乘就是空积,取 1)。
El cálculo del valor de α se deja para el final.
α 的取值留到最后再算(用「概率和为 1」反解)。
donde s(A) denota al conjunto de hijos de A.
其中 s(A) 表示 A 的子节点集合。
ALGORITMO:
算法伪码(与上一页完全相同)。
| 黄色注释 | 西语原文 | 考试含义 |
|---|---|---|
| 排除自己 | Hijos de A que no son el B | 公式 2 的连乘要跳过收消息的那个子节点 |
| 空积为 1 | El producto vacío es 1 | 没有子女时 λ=1(叶子默认值) |
| α 最后算 | El cálculo del valor de α se deja para el final | 先算 λ、π,最后统一归一化 |
| 误读为「A 的所有子女都参与连乘」 | — | 会把 B 自己的 λ 也算进去,结果必错 |
Tareas · 本章作业:把算法吃透的三件事
▸ 原页截图 p.100
Redes bayesianas
贝叶斯网络(页眉)。
Tareas:
Estudiar el algoritmo.
把算法学透(五条公式 + 三个更新过程,能默写)。
Hacer el ejemplo.
把课上的例子亲手做一遍(M=sí 的四步消息序列 + 归一化)。
Resolver ejercicios propuestos.
完成布置的习题。
Algoritmos de propagación: algoritmo para árboles
传播算法:树形网络版本(本节标题)。
| 作业 | 自检标准 | 对应页 |
|---|---|---|
| Estudiar el algoritmo | 不看笔记写出 5 条公式 + Inicialización 的 A/B/C | p.98–p.99 |
| Hacer el ejemplo | 写出 M→G(λ)、M→T,E(π)、G→F(π)、F→D(π) 并完成归一化 | p.90–p.94 |
| Resolver ejercicios | 换一张新树,独立跑完 S0→S1 | 习题册 |
| 只背公式不做例子 | 考试给图就卡壳 | 公式与图必须对上 |
专有名词速记表(A–Z)
共 119 条,覆盖全 100 页的高频术语。第三列点页码直接跳回原页;最后一列只写「一句话 + 最容易被扣分的点」。
| 西语术语 | 中文 | 页码 | 一句话记住 · 易错点 |
|---|---|---|---|
| A | |||
| abductivas | 溯因推理 | p.21 | 从结果反推原因,正是「诊断」的方向;与 predictivas 恰好相反。 |
| actualización | 更新 | p.95 | 有证据 e 后算后验 P*(X)=P(X/e),从状态 S1 起;不是「初始化」。 |
| algoritmo de propagación | 传播算法 | p.84 | 有新证据就重算全网 P*;一般图 NP-duro,课程只讲树。 |
| AND 门 | 与门 | p.82 | 父节点全部成立、子节点才成立;与 OR 门互为德摩根对偶。 |
| anorexia | 厌食症 | p.66 | 简化建模实例里的目标问题,用来说明「删中间节点」的技巧。 |
| aprendizaje | 学习 | p.7 | SBC 的「自动获取知识」环节,与 base de conocimiento 并列。 |
| árbol | 树 | p.84 | 每个节点至多一个父节点——本章所有公式成立的前提。 |
| arcos | 弧 | p.12 | 有向边:从原因指结果,表达因果影响。 |
| Asia (red Asia) | Asia 网络 | p.29 | 经典教学网络,用来说明 collider 与 explaining away。 |
| autoaprendizaje | 自主学习 | p.6 | 系统自己更新知识库,少让知识工程师手工录入。 |
| auxiliares | 辅助变量 | p.61 | 建模时补的中介变量,不属于目标/观察/因素三类。 |
| B | |||
| base de conocimiento | 知识库 | p.7 | 存事实与规则的「长期记忆」,与 memoria de trabajo 成对。 |
| C | |||
| causa | 原因 | p.81 | NOISY-OR 里每个原因独立地「可能」触发结果。 |
| causas | 原因(复数) | p.60 | 建模第一步:先把情境里的各种原因列出来。 |
| collider | 对撞结构 | p.29 | 两条箭头汇到同一节点,会引发 explaining away(解释消除)。 |
| condicionadas | 条件(分布) | p.11 | P(X | 父节点):网络的参数,别写成边缘分布。 |
| conjunto exhaustivo y excluyente | 穷尽且互斥的取值集合 | p.51 | 每个变量的取值要覆盖全部可能、且互不重叠。 |
| constante de normalización | 归一化常数 | p.85 | 就是 α,留到最后由「和为 1」反解。 |
| conocimiento | 知识 | p.7 | SBC 的核心资产,存放在知识库里。 |
| cribados masivos | 大规模筛查 | p.15 | 低患病率 + 大范围检测 → 假阳性数量爆炸。 |
| D | |||
| definición | 定义 | p.2 | 课程第二节:SBC 是什么、由哪几块组成。 |
| descomponer | 分解 | p.85 | 把 P(X) 拆成 α·λ(X)·π(X) 三因子乘积。 |
| diagnóstico | 诊断 | p.5 | 从症状反推病因,是贝叶斯网络的头号应用。 |
| disnea | 呼吸困难 | p.55 | 肺癌/结核/支气管炎网络里的症状节点。 |
| distribución conjunta | 联合分布 | p.9 | 所有变量一起的完整概率表,规模随变量数指数爆炸。 |
| distribuciones marginales | 边缘分布 | p.9 | 把联合分布里不关心的变量求和消掉。 |
| dolor | 疼痛 | p.88 | 六节点例子里 F 的子节点,叶子 λ=1。 |
| dominio | 领域 | p.83 | 建模作业第 1 步:先选定一个领域。 |
| E | |||
| enlace | 连线 | p.95 | 建网的三大件之一:节点、连线、参数。 |
| enlaces | 连边(复数) | p.13 | 定性部分 = 节点 + 连边(谁影响谁)。 |
| enunciado | 题干 | p.83 | 作业第 4 步:必须简单、不能有歧义。 |
| especificidad | 特异度 | p.14 | P(阴性 | 无病):没病的人被测成阴性的比例。 |
| estornudos | 打喷嚏 | p.88 | M 的子节点之一,与 tos 并列。 |
| etapa | 阶段 | p.95 | 初始化(S0)与更新(S1…)两阶段。 |
| evidencia | 证据 | p.3 | 观测到的确定值 e,是传播算法的输入。 |
| evidencia observada | 观测证据 | p.16 | 用来算后验 P*(X) 的已知信息。 |
| exhaustivo | 穷尽的 | p.23 | 取值集合覆盖所有可能,一项不能漏。 |
| excluyente | 互斥的 | p.23 | 取值之间不能同时成立。 |
| F | |||
| factor de ruido | 噪声因子 | p.77 | NOISY-OR 里的 q_i:父为真时子仍为假的概率;与 p_i 是互补关系。 |
| factorización | 因式分解 | p.32 | 用条件独立把联合分布拆成局部条件概率之积。 |
| falsos negativos | 假阴性 | p.14 | 有病却测成阴性,等于漏诊。 |
| falsos positivos | 假阳性 | p.14 | 无病却测成阳性,筛查规模一大就成灾。 |
| fiebre | 发烧 | p.88 | G 的子节点、D 的父节点,是消息的「中转站」。 |
| flujo de información | 信息流 | p.97 | λ 向上、π 向下的传播路径。 |
| funcionalidad | 功能 | p.2 | SBC 问答能力的总称,与 arquitectura 并列讲。 |
| G | |||
| gluten | 麸质 | p.56 | 乳糜泻例子里被小肠绒毛「识别」并引发反应的对象。 |
| grafo acíclico, conexo y dirigido | 无环、连通、有向图 | p.22 | 贝叶斯网络的图结构定义,三个形容词缺一不可。 |
| gripe | 感冒 | p.88 | 六节点例子的根节点,π 值就是它的先验。 |
| H | |||
| hallazgos | 发现 | p.21 | 溯因推理的输入:观察到的现象。 |
| hipótesis de independencia condicional | 条件独立假设 | p.22 | 网络能把指数级联合分布「压缩」下来的根本原因。 |
| HTA | 高血压 | p.75 | NOISY-OR 建模示例的目标节点。 |
| I | |||
| indicio | 迹象 | p.83 | 建模时要标出的弱证据,与 prueba / síntoma 并列。 |
| independencia condicional | 条件独立 | p.3 | 给定父节点后,节点与其非后代独立。 |
| inferencias | 推断 | p.21 | 网络能做的推理总称(溯因 + 预测)。 |
| información cualitativa | 定性信息 | p.13 | 节点 + 连边(谁影响谁)。 |
| información cuantitativa | 定量信息 | p.13 | 条件概率表(影响有多强)。 |
| inhibidor | 抑制因素 | p.61 | 降低结果发生可能性的因素,与 promotor 相反。 |
| inicialización | 初始化 | p.95 | 算全部先验 P(X),状态 S0,还没证据。 |
| inicializar | 初始化(赋确定值) | p.86 | 这里指「节点被赋一个值」,不是 p.95 的两阶段之一。 |
| instanciar | 实例化 | p.84 | 变量取定一个值,全网概率随之改变。 |
| L | |||
| λ-mensaje | λ 消息 | p.85 | 子 → 父,向上送;发消息的是子女。 |
| λ-valor | λ 值 | p.85 | 汇总「下方」子女证据的因子;叶子节点为 1。 |
| M | |||
| mecanismos de razonamiento | 推理机制 | p.5 | SBC 的推理方式,贝叶斯网络是其中一种。 |
| memoria de trabajo | 工作内存 | p.7 | 存当前事实的「短期记忆」。 |
| modelado cualitativo | 定性建模 | p.41 | 只定结构:节点 + 边。 |
| modelado cuantitativo | 定量建模 | p.41 | 在结构之上再加条件概率参数。 |
| modelos canónicos | 规范模型 | p.73 | AND / OR / NOISY-OR / NOISY-AND 这些标准模块。 |
| motor de inferencias | 推理机 | p.7 | 按规则从知识库推出结论的引擎。 |
| mucosidad | 黏膜(鼻涕) | p.88 | 六节点例子里的证据节点,M=sí 是整段推导的起点。 |
| N | |||
| nodo | 节点 | p.12 | 图里代表变量的点。 |
| nodo hijo | 子节点 | p.85 | 箭头指向的一端,λ 消息的发送者。 |
| nodo padre | 父节点 | p.85 | 箭头出发的一端,π 消息的发送者。 |
| nodo raíz | 根节点 | p.96 | 唯一没有父节点的节点,π 值取其先验 P(a_j)。 |
| nodos intermedios | 中间节点 | p.69 | 简化网络时可以删掉、把边直接接起来的传递节点。 |
| NOISY-AND | 噪声与 | p.73 | AND 的软化版:原因齐全时结果也可能不成立。 |
| NOISY-OR | 噪声或 | p.73 | OR 的软化版:某个原因成立时结果也可能不触发。 |
| normalización | 归一化 | p.87 | 两个数相加做分母、各自做分子,让概率和为 1。 |
| NP-duro | NP 难 | p.84 | 一般图上精确推断没有多项式算法,所以只讲树。 |
| O | |||
| observación | 观察变量 | p.61 | 建模里能被直接看到/测到的变量。 |
| objetivo | 目标变量 | p.61 | 建模里真正想求的那个变量。 |
| OR 关系 (relación tipo OR) | 或关系 | p.49 | 任一原因成立,结果即可成立;与 AND 门互为对偶。 |
| P | |||
| parámetro | 参数 | p.95 | 条件概率表里的具体数值,建网时就得填。 |
| predictivas | 预测推理 | p.21 | 从原因推结果,与 abductivas 方向相反。 |
| prevalencia | 患病率 | p.14 | 先验 P(病),是筛查例子里最关键的输入数。 |
| presentador | 主持人 | p.58 | 蒙提霍尔问题里知道答案、会开门的那一方。 |
| preventivo | 阻断条件 | p.61 | 直接让结果不可能发生的因素,比 inhibidor 更绝对。 |
| probabilidad a posteriori | 后验概率 | p.16 | P*(X)=P(X|e):加了证据之后的新概率。 |
| probabilidad a priori | 先验概率 | p.13 | 没有任何证据时的 P(X),S0 状态用的就是它。 |
| probabilidad condicionada | 条件概率 | p.13 | P(X | padres),是网络的定量参数。 |
| promotor | 促进因素 | p.61 | 提高结果发生概率的因素。 |
| propagación | 传播 | p.3 | 证据沿网络扩散、逐点更新概率的过程。 |
| prueba | 证据(检测) | p.83 | 建模时要标出的较强证据,比 indicio 更硬。 |
| puerta OR | 或门 | p.74 | OR 关系的图形化模块,GeNIe 里可直接标。 |
| π-mensaje | π 消息 | p.85 | 父 → 子,向下传;父节点变了就发给所有子节点。 |
| π-valor | π 值 | p.85 | 汇总「上方」父节点证据的因子;根节点取先验。 |
| R | |||
| red bayesiana | 贝叶斯网络 | p.3 | 有向无环图 + 每个节点的条件概率表。 |
| reglas de diagnóstico | 诊断规则 | p.65 | 从症状指向病因的条件概率写法。 |
| relación tipo AND | 与关系 | p.50 | 全部条件成立,结果才成立。 |
| representación del conocimiento | 知识表示 | p.1 | 本章主题:怎么把知识装进机器里。 |
| ruido | 噪声 | p.71 | 关系不是 100% 确定时那点「不确定性」的来源。 |
| S | |||
| sensibilidad | 灵敏度 | p.14 | P(阳性 | 有病);与特异度成对记。 |
| separación direccional | 方向分离 | p.22 | 用图结构判断条件独立的直观规则。 |
| simplificar | 简化 | p.83 | 建模作业第 3 步:把节点压到 8–12 个。 |
| síntoma | 症状 | p.83 | 建模里最强的一类观察证据。 |
| síntomas | 症状(复数) | p.5 | 诊断系统的输入。 |
| sistemas basados en el conocimiento | 基于知识的系统 | p.2 | SBC = 知识库 + 推理机 + 人机接口。 |
| T | |||
| tabaquismo | 吸烟 | p.55 | 肺癌网络里的原因节点。 |
| tablas de probabilidades condicionadas | 条件概率表 | p.73 | 每个节点自带一张,规模由父节点个数决定。 |
| tareas | 作业 | p.100 | 三件事:学算法、做例子、做习题。 |
| teorema fundamental | 基本定理 | p.2 | 用条件独立把联合分布因式分解,是整章的理论支点。 |
| tos | 咳嗽 | p.88 | M 的子节点之一,与 estornudos 并列。 |
| tuberculosis | 肺结核 | p.55 | 肺癌网络里的鉴别诊断之一。 |
| U | |||
| uniformemente | 均匀地 | p.57 | Wurros 例子里颜色取值的均匀分布。 |
| usuario | 用户 | p.7 | 向 SBC 提问的人,与 experto 相对。 |
| V | |||
| vacuna | 疫苗 | p.48 | 「参数要符合常识」的反例:有它时发病率该降。 |
| variable | 变量 | p.12 | 节点所代表的不确定量。 |
| variable aleatoria | 随机变量 | p.23 | 取值带概率的变量。 |
| variables proposicionales | 命题变量 | p.22 | 只取真/假的二值变量。 |
| vello intestinal | 小肠绒毛 | p.56 | 乳糜泻例子里被破坏的结构。 |
数字与流程速记卡
口诀:「3 因子、2 阶段、5 公式、3 更新」。张口就能报数,是这一章的送分点。
| 行 | 数字 | 原文关键词 | 中文 | 页 |
|---|---|---|---|---|
| 1 | 3 | P(X) = α λ(X) π(X) | 概率三因子分解:归一化常数 + λ 值 + π 值 | p.85 |
| 2 | 2 | Inicialización / Actualización | 两个阶段:S0 先验;S1 起后验 | p.95 |
| 3 | 5 | λ_B(a_j) · π_B(a_j) · λ(b_i) · π(b_i) · P*(b_i) | 五条公式:报父 / 排自己下传 / 全子女连乘 / 对父求和 / αλπ | p.98 |
| 4 | 3 | Actualización A / B / C | 三种更新过程:被实例化 / 收到子的 λ / 收到父的 π | p.98 |
| 5 | 1 | El producto vacío es 1 | 空乘积为 1,所以叶子节点 λ = 1 | p.99 |
| 6 | 4 | M→G(λ) · M→T,E(π) · G→F(π) · F→D(π) | M=sí 时的完整消息序列(四条) | p.94 |
| 7 | 6 | G, M, F, T, E, D | 例题网络的六个节点;一棵树,每点只有一个父 | p.88 |
| 8 | 8–12 | entre 8 y 12 nodos | 建模作业的节点数量区间 | p.83 |
| 9 | 2 | una relación de OR con tres nodos y una de AND con dos | 作业必须含:三节点 OR 一个 + 两节点 AND 一个 | p.83 |
| 10 | 5 | Título · Referencia original · Texto original · Enunciado · Imagen GeNIe | 论坛帖子五项必填内容 | p.83 |
| 11 | 0,6642 | 0,0891 / (0,0891 + 0,04505) | 归一化算例:P*(+x) 的结果 | p.87 |
| 12 | 0,3358 | 0,04505 / (0,0891 + 0,04505) | 归一化算例:P*(¬x) 的结果,两数相加为 1 | p.87 |
考场自检:说「λ 值是把所有子节点连乘」对,但要补一句「叶子节点因空乘积取 1」;说「α 一开始就要求出来」直接错——α 留到最后。
最容易混的十四组概念
每组只抓一个分界点:谁对谁、哪个方向、哪一步。