- 一页一块:页码 = PDF 物理页序,和老师发的 PDF 完全对齐;点顶部页码可直接跳转。
- 先看图再读句:每块顶部折叠着原页截图,图卡住了就展开对一眼,不用来回翻 PDF。
- 三色提示框:绿=考点(这页怎么考)、红=陷阱(易错 / 原文笔误)、紫=记忆钩子(一 句背下来)。
- 考前只扫两处:每页的绿框 + 文末「A–Z 术语速记表」最后一列。
- 术语悬停:正文中带虚下划线的西语词,鼠标停上去即显示中文。
- 逐句口径:正文、项目符号、表格标题与图注均逐句对照;每页重复的页眉标题与页脚数字不重复列句(已由页块标题承载),整张数据表以表格形式原样复刻,不拆成句子。
一、从传统编程到「学习」:¿Quién es quién?
p.1–p.5Tema 3: Introducción al aprendizaje computacional · 第 3 讲:计算学习导论(封面)
▸ 原页截图 p.1
Tema 3: Introducción al aprendizaje computacional
第 3 讲:计算学习导论
Eva Millán
Eva Millán(授课教师)
Departamento de Lenguajes y Ciencias de la Computación
语言与计算机科学系
El juego del ¿Quién es quién? · 「猜猜我是谁?」游戏
▸ 原页截图 p.2
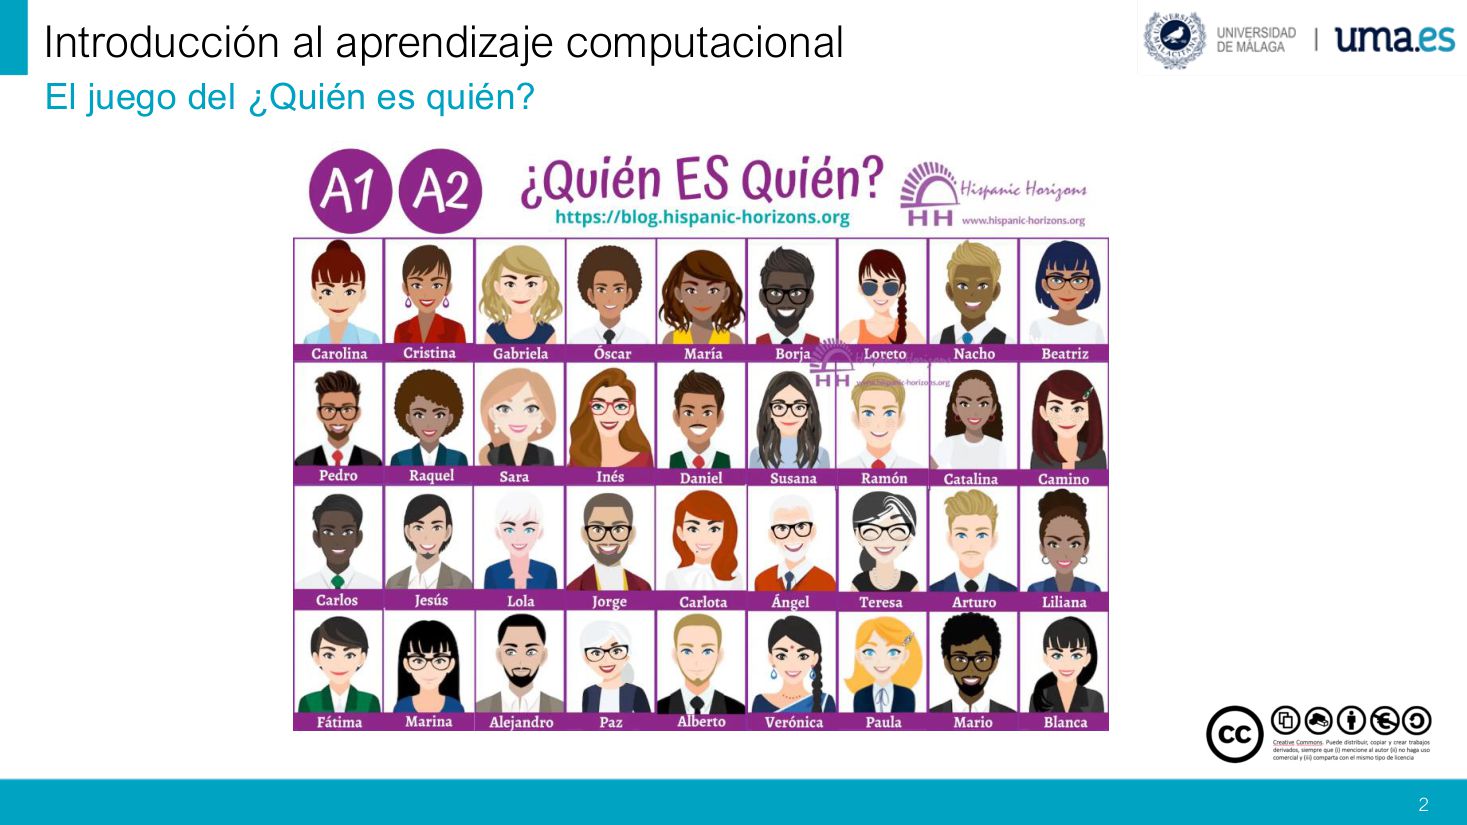
El juego del ¿Quién es quién?
「猜猜我是谁?」这个游戏
Programación tradicional · 传统编程
▸ 原页截图 p.3
Programación tradicional
传统编程
¿?
?(一个大大的问号)
Una parte de un posible algoritmo con programación tradicional · 传统编程写法的一小段算法
▸ 原页截图 p.4
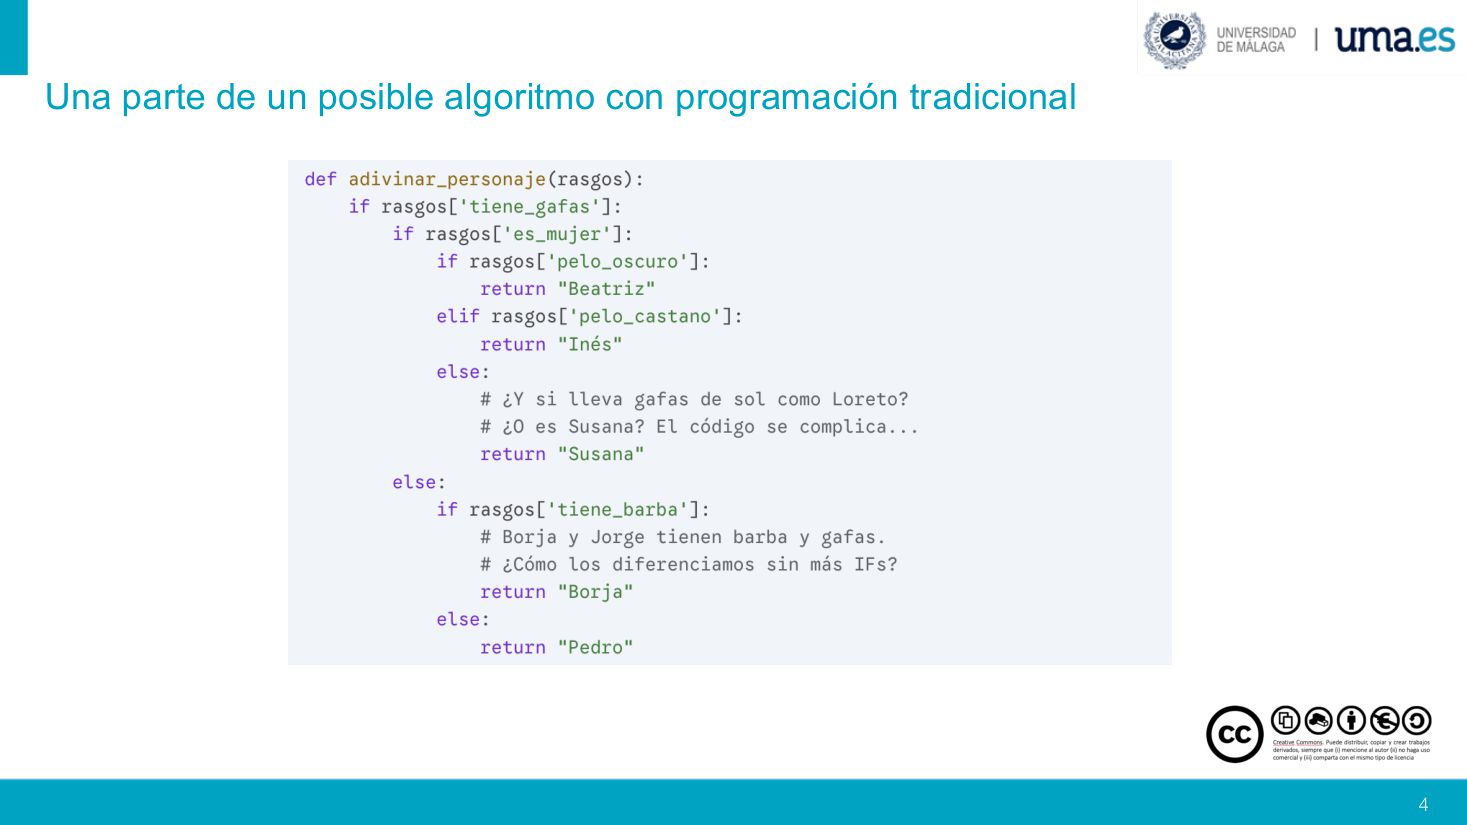
Una parte de un posible algoritmo con programación tradicional
用传统编程写出的、可能算法的一小部分
def adivinar_personaje(rasgos):
    if rasgos['tiene_gafas']:
        if rasgos['es_mujer']:
            if rasgos['pelo_oscuro']:
                return "Beatriz"
            elif rasgos['pelo_castano']:
                return "Inés"
            else:
                # ¿Y si lleva gafas de sol como Loreto?
                # ¿O es Susana? El código se complica...
                return "Susana"
        else:
            if rasgos['tiene_barba']:
                # Borja y Jorge tienen barba y gafas.
                # ¿Cómo los diferenciamos sin más IFs?
                return "Borja"
            else:
                return "Pedro"
Problemas del enfoque tradicional · 传统方法的三大问题
▸ 原页截图 p.5
• Ambigüedad de los Atributos
• 属性的歧义性
Si definimos la regla tiene_gafas, ¿incluimos las de sol de Loreto?
如果我们定义 tiene_gafas(戴眼镜)这条规则,Loreto 的太阳镜算不算?
• Orden de las Preguntas (Eficiencia)
• 提问的顺序(效率问题)
¿Cual es la mejor pregunta para empezar?
从哪个问题开始问最好?
• Rigidez ante los Datos
• 面对数据时的僵化
El programa tradicional es estático
传统程序是静态的(写死就不动)
• Si mañana incluyo a una nueva chica con gafas y pelo oscuro llamada 'Lucía', este código me seguirá diciendo que es Beatriz
• 如果我明天加进一个戴眼镜、深色头发、叫「Lucía」的新女孩,这段代码仍然会告诉我她是 Beatriz
• Si cambia el tablero ¿hay que empezar todo de nuevo?
• 如果棋盘(人物卡)换了,是不是得全部从头再来?
二、数据的问题与预处理:从「脏表」到「干净表」
p.6–p.11Datos generados por el becario 1. ¿Problemas? · 实习生 1 生成的数据:哪里有问题?
▸ 原页截图 p.6
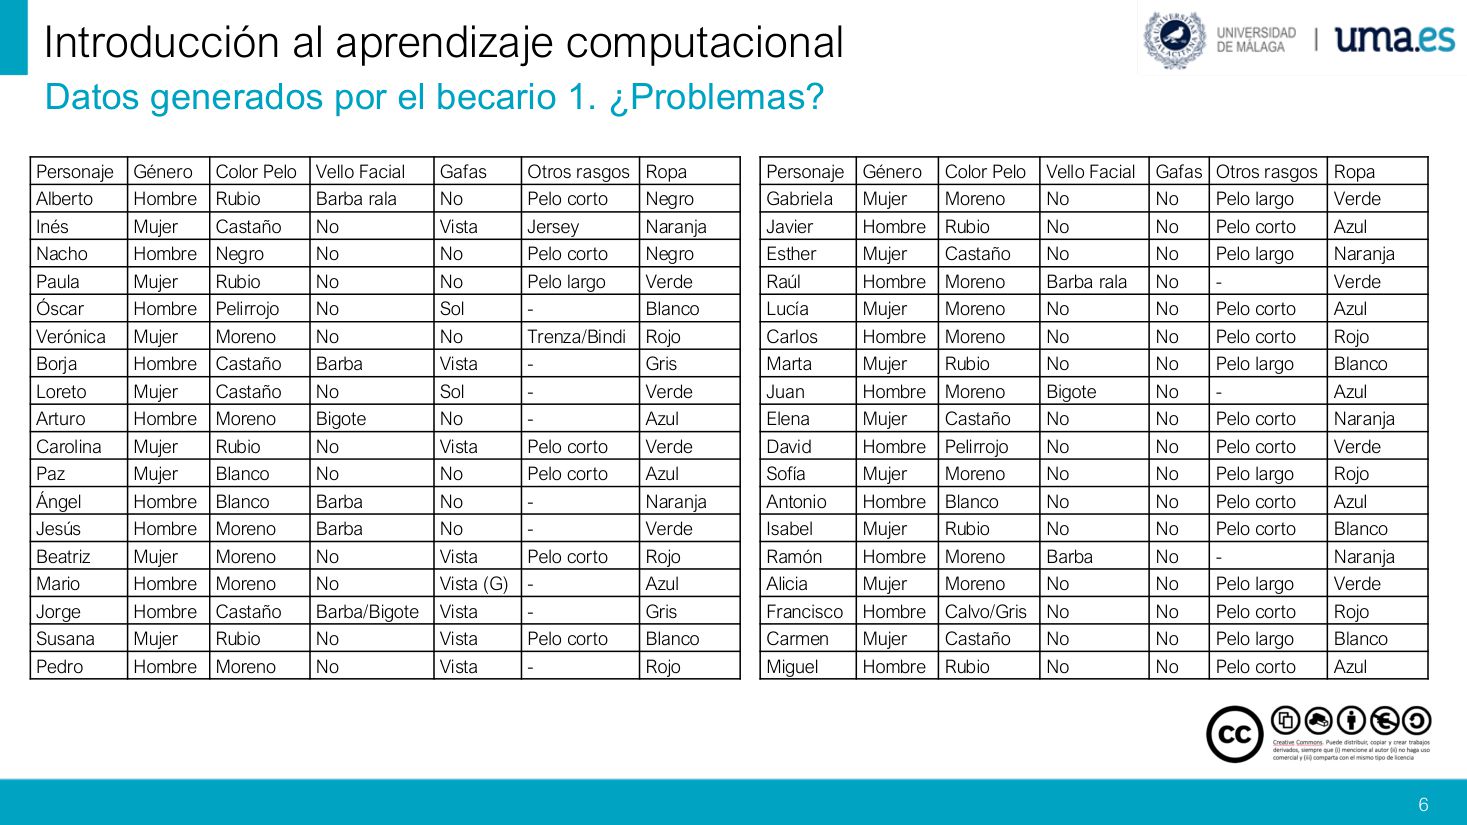
Datos generados por el becario 1. ¿Problemas?
实习生 1 生成的数据。有什么问题?
| Personaje | Género | Color Pelo | Vello Facial | Gafas | Otros rasgos | Ropa |
|---|---|---|---|---|---|---|
| Alberto | Hombre | Rubio | Barba rala | No | Pelo corto | Negro |
| Inés | Mujer | Castaño | No | Vista | Jersey | Naranja |
| Nacho | Hombre | Negro | No | No | Pelo corto | Negro |
| Paula | Mujer | Rubio | No | No | Pelo largo | Verde |
| Óscar | Hombre | Pelirrojo | No | Sol | - | Blanco |
| Verónica | Mujer | Moreno | No | No | Trenza/Bindi | Rojo |
| Borja | Hombre | Castaño | Barba | Vista | - | Gris |
| Loreto | Mujer | Castaño | No | Sol | - | Verde |
| Arturo | Hombre | Moreno | Bigote | No | - | Azul |
| Carolina | Mujer | Rubio | No | Vista | Pelo corto | Verde |
| Paz | Mujer | Blanco | No | No | Pelo corto | Azul |
| Ángel | Hombre | Blanco | Barba | No | - | Naranja |
| Jesús | Hombre | Moreno | Barba | No | - | Verde |
| Beatriz | Mujer | Moreno | No | Vista | Pelo corto | Rojo |
| Mario | Hombre | Moreno | No | Vista (G) | - | Azul |
| Jorge | Hombre | Castaño | Barba/Bigote | Vista | - | Gris |
| Susana | Mujer | Rubio | No | Vista | Pelo corto | Blanco |
| Pedro | Hombre | Moreno | No | Vista | - | Rojo |
| Personaje | Género | Color Pelo | Vello Facial | Gafas | Otros rasgos | Ropa |
|---|---|---|---|---|---|---|
| Gabriela | Mujer | Moreno | No | No | Pelo largo | Verde |
| Javier | Hombre | Rubio | No | No | Pelo corto | Azul |
| Esther | Mujer | Castaño | No | No | Pelo largo | Naranja |
| Raúl | Hombre | Moreno | Barba rala | No | - | Verde |
| Lucía | Mujer | Moreno | No | No | Pelo corto | Azul |
| Carlos | Hombre | Moreno | No | No | Pelo corto | Rojo |
| Marta | Mujer | Rubio | No | No | Pelo largo | Blanco |
| Juan | Hombre | Moreno | Bigote | No | - | Azul |
| Elena | Mujer | Castaño | No | No | Pelo corto | Naranja |
| David | Hombre | Pelirrojo | No | No | Pelo corto | Verde |
| Sofía | Mujer | Moreno | No | No | Pelo largo | Rojo |
| Antonio | Hombre | Blanco | No | No | Pelo corto | Azul |
| Isabel | Mujer | Rubio | No | No | Pelo corto | Blanco |
| Ramón | Hombre | Moreno | Barba | No | - | Naranja |
| Alicia | Mujer | Moreno | No | No | Pelo largo | Verde |
| Francisco | Hombre | Calvo/Gris | No | No | Pelo corto | Rojo |
| Carmen | Mujer | Castaño | No | No | Pelo largo | Blanco |
| Miguel | Hombre | Rubio | No | No | Pelo corto | Azul |
Problemas con los datos · 数据存在的问题
▸ 原页截图 p.7
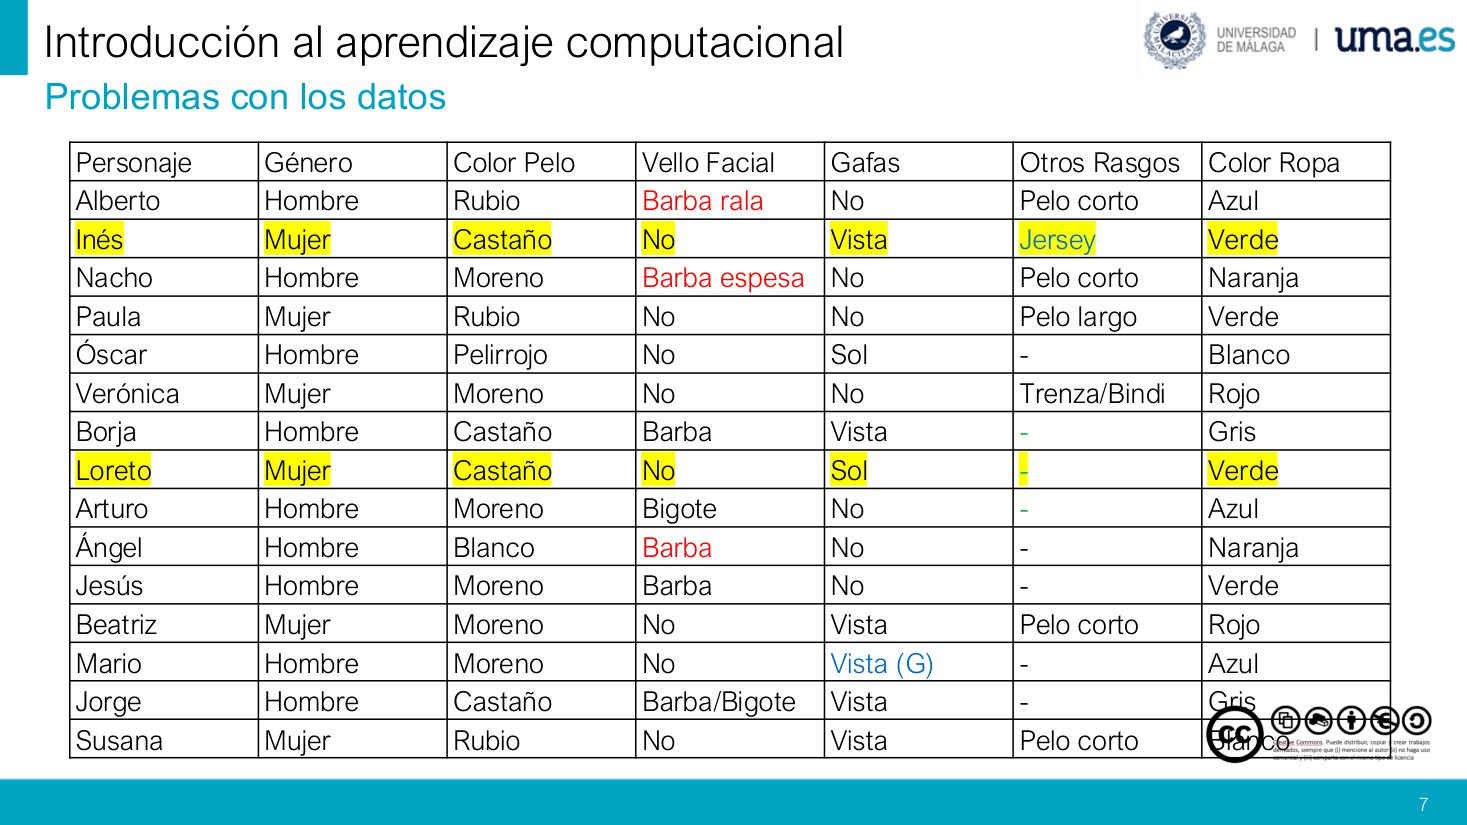
Problemas con los datos
数据存在的问题
| Personaje | Género | Color Pelo | Vello Facial | Gafas | Otros Rasgos | Color Ropa |
|---|---|---|---|---|---|---|
| Alberto | Hombre | Rubio | Barba rala | No | Pelo corto | Azul |
| Inés | Mujer | Castaño | No | Vista | Jersey | Verde |
| Nacho | Hombre | Moreno | Barba espesa | No | Pelo corto | Naranja |
| Paula | Mujer | Rubio | No | No | Pelo largo | Verde |
| Óscar | Hombre | Pelirrojo | No | Sol | - | Blanco |
| Verónica | Mujer | Moreno | No | No | Trenza/Bindi | Rojo |
| Borja | Hombre | Castaño | Barba | Vista | - | Gris |
| Loreto | Mujer | Castaño | No | Sol | - | Verde |
| Arturo | Hombre | Moreno | Bigote | No | - | Azul |
| Ángel | Hombre | Blanco | Barba | No | - | Naranja |
| Jesús | Hombre | Moreno | Barba | No | - | Verde |
| Beatriz | Mujer | Moreno | No | Vista | Pelo corto | Rojo |
| Mario | Hombre | Moreno | No | Vista (G) | - | Azul |
| Jorge | Hombre | Castaño | Barba/Bigote | Vista | - | Gris |
| Susana | Mujer | Rubio | No | Vista | Pelo corto | Blanco |
Preprocesamiento · 预处理
▸ 原页截图 p.8
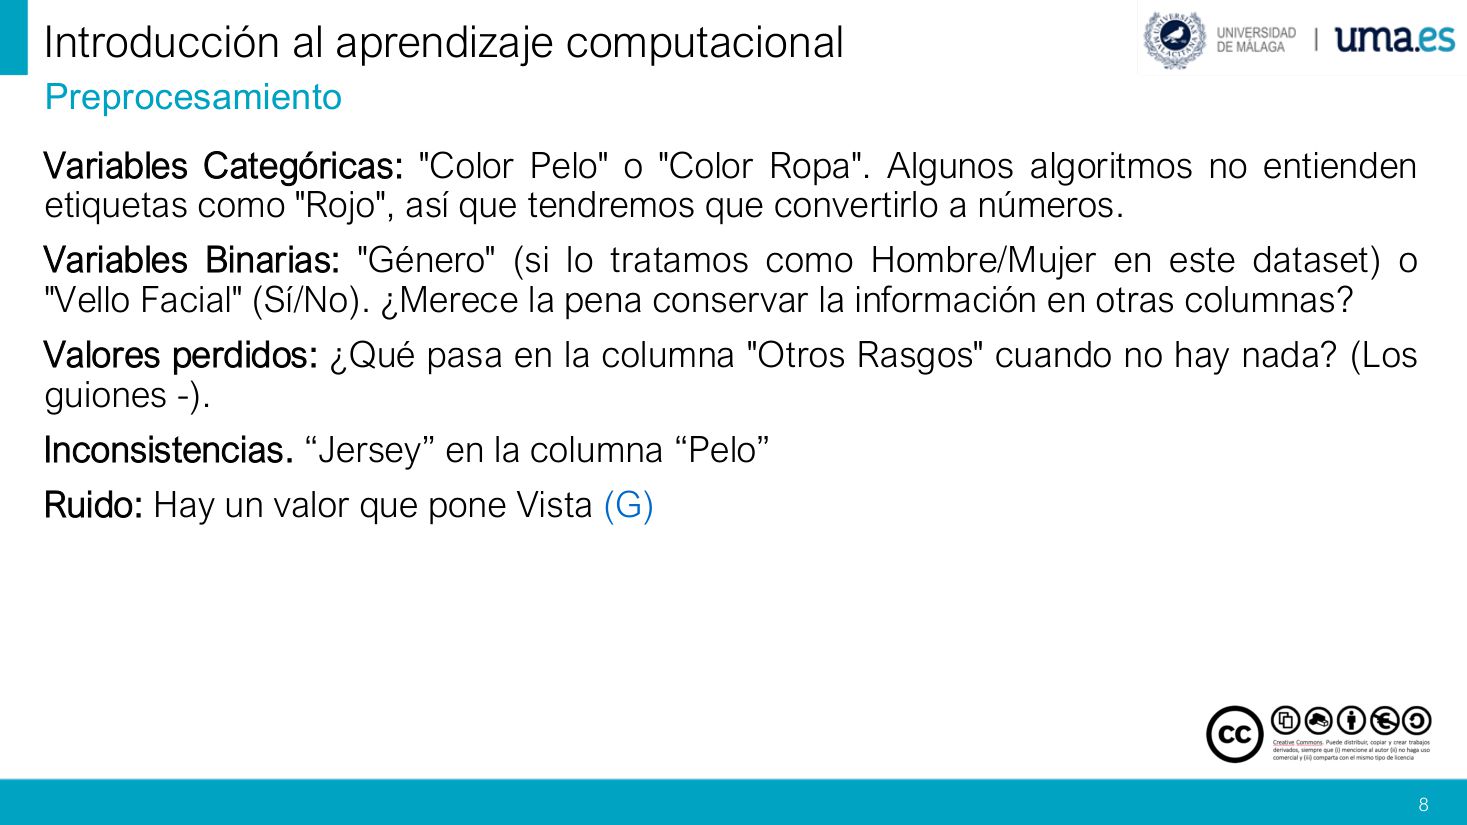
预处理
•
• 分类变量:「发色」或「衣服颜色」。
Algunos algoritmos no entienden etiquetas como "Rojo", así que tendremos que convertirlo a números.
有些算法看不懂「Rojo(红色)」这类标签,所以我们必须把它转成数字。
•
• 二元变量:「性别」(在这个数据集里按男 / 女处理)或「面部毛发」(是 / 否)。
¿Merece la pena conservar la información en otras columnas?
把信息保留在其他列里值得吗?(是否还有必要留别的列)
•
• 缺失值:「其他特征」这一列里什么都没有的时候,怎么办?
(Los guiones -).
(就是那些短横线 -。)
•
• 不一致:「Jersey(毛衣)」出现在了「头发」这一列里。
•
• 噪声:有一个值写的是「Vista (G)」。
Datos limpios (becario 2) · 干净数据(实习生 2 版)
▸ 原页截图 p.9
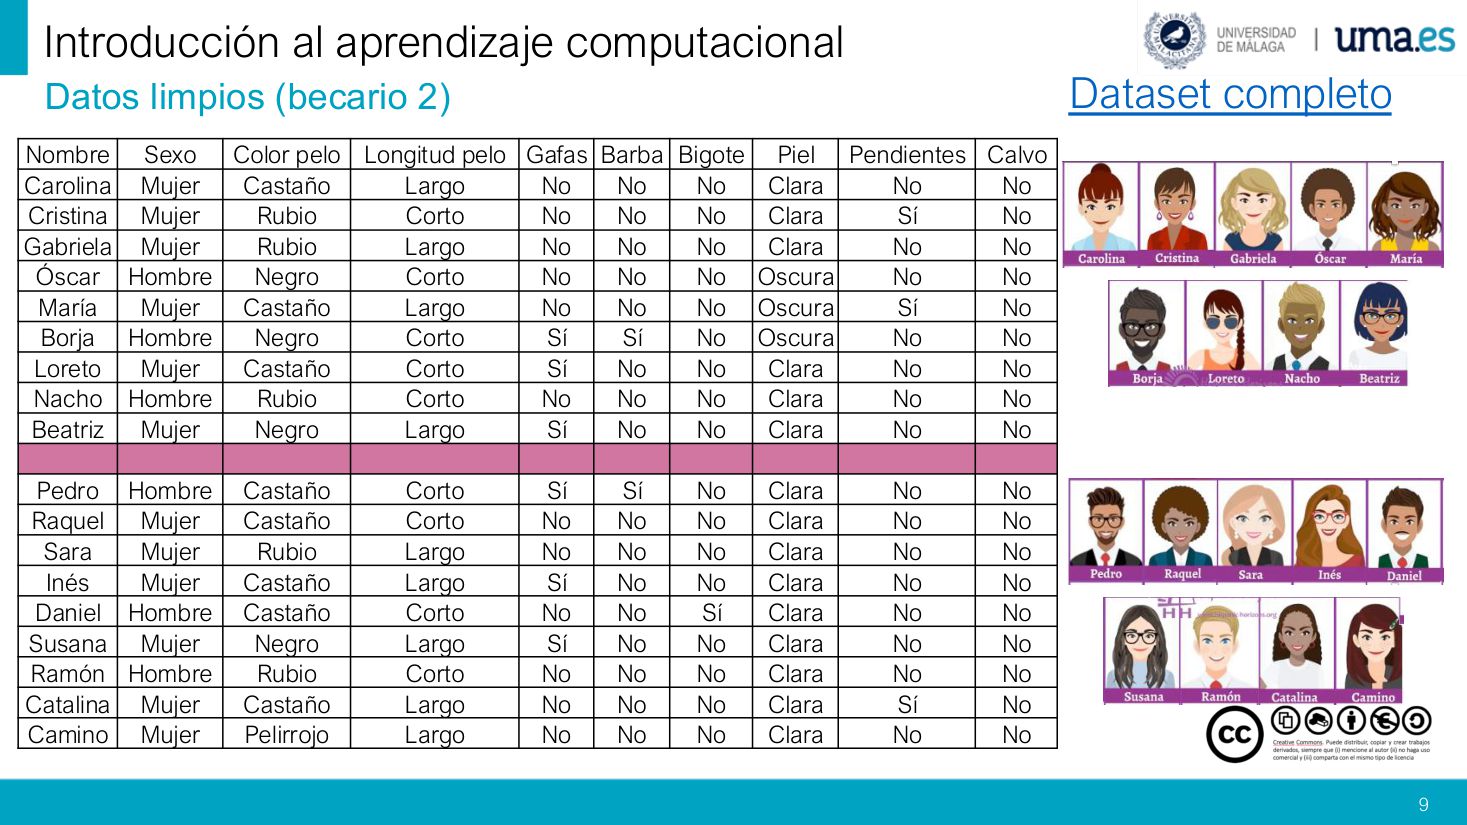
Datos limpios (becario 2)
干净数据(实习生 2 的版本)
| Nombre | Sexo | Color pelo | Longitud pelo | Gafas | Barba | Bigote | Piel | Pendientes | Calvo |
|---|---|---|---|---|---|---|---|---|---|
| Carolina | Mujer | Castaño | Largo | No | No | No | Clara | No | No |
| Cristina | Mujer | Rubio | Corto | No | No | No | Clara | Sí | No |
| Gabriela | Mujer | Rubio | Largo | No | No | No | Clara | No | No |
| Óscar | Hombre | Negro | Corto | No | No | No | Oscura | No | No |
| María | Mujer | Castaño | Largo | No | No | No | Oscura | Sí | No |
| Borja | Hombre | Negro | Corto | Sí | Sí | No | Oscura | No | No |
| Loreto | Mujer | Castaño | Corto | Sí | No | No | Clara | No | No |
| Nacho | Hombre | Rubio | Corto | No | No | No | Clara | No | No |
| Beatriz | Mujer | Negro | Largo | Sí | No | No | Clara | No | No |
| Pedro | Hombre | Castaño | Corto | Sí | Sí | No | Clara | No | No |
| Raquel | Mujer | Castaño | Corto | No | No | No | Clara | No | No |
| Sara | Mujer | Rubio | Largo | No | No | No | Clara | No | No |
| Inés | Mujer | Castaño | Largo | Sí | No | No | Clara | No | No |
| Daniel | Hombre | Castaño | Corto | No | No | Sí | Clara | No | No |
| Susana | Mujer | Negro | Largo | Sí | No | No | Clara | No | No |
| Ramón | Hombre | Rubio | Corto | No | No | No | Clara | No | No |
| Catalina | Mujer | Castaño | Largo | No | No | No | Clara | Sí | No |
| Camino | Mujer | Pelirrojo | Largo | No | No | No | Clara | No | No |
Dataset completo
完整数据集
Preguntas · 提问(课堂讨论)
▸ 原页截图 p.10
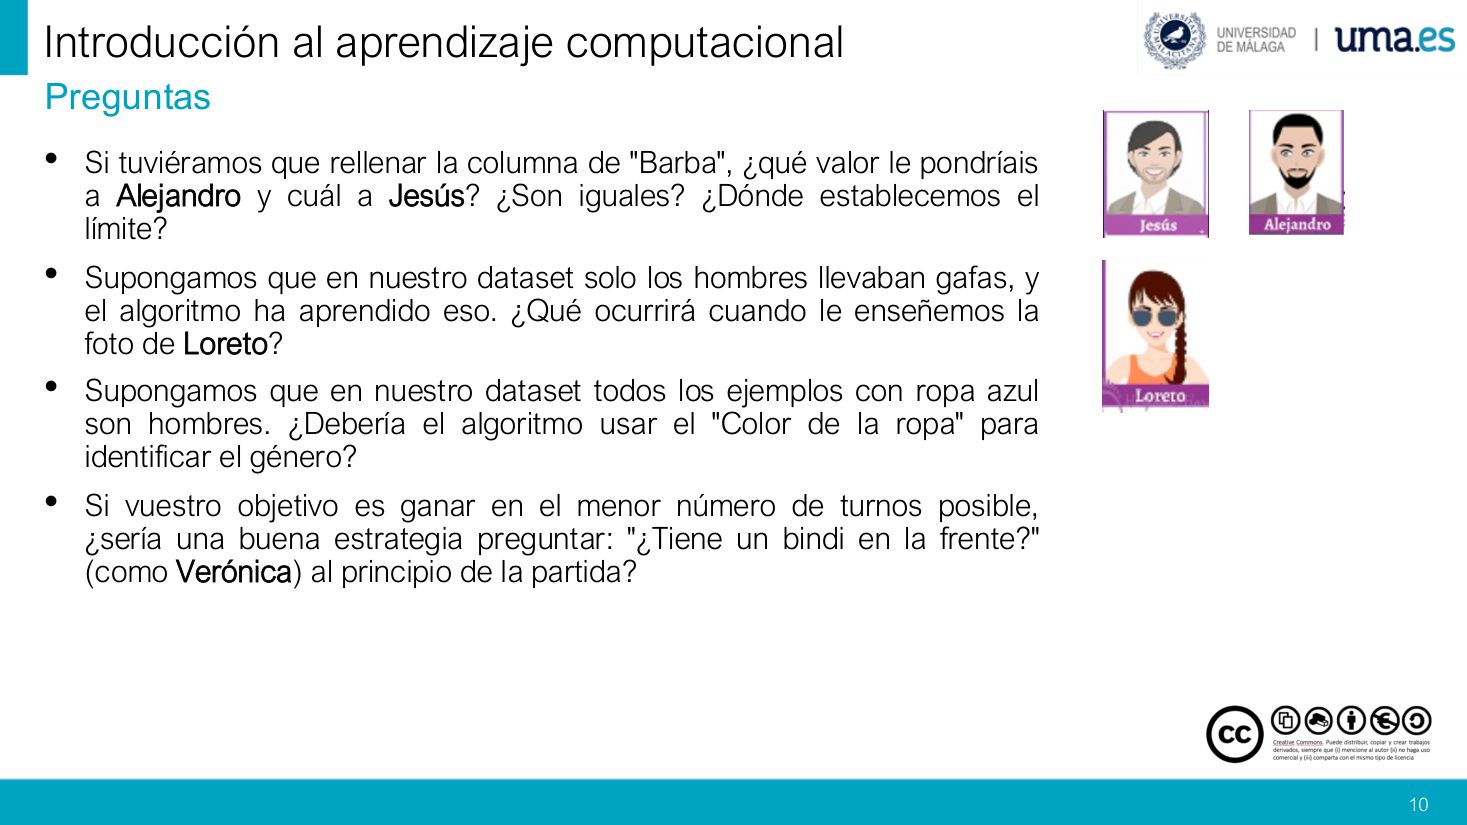
Preguntas
问题
• Si tuviéramos que rellenar la columna de "Barba", ¿qué valor le pondríais a Alejandro y cuál a Jesús?
• 如果我们要填「胡子」这一列,你会给 Alejandro 填什么值,给 Jesús 又填什么?
¿Son iguales? ¿Dónde establecemos el límite?
它们一样吗?我们把界限划在哪里?
• Supongamos que en nuestro dataset solo los hombres llevaban gafas, y el algoritmo ha aprendido eso.
• 假设在我们的数据集里只有男人戴眼镜,而算法已经学到了这一点。
¿Qué ocurrirá cuando le enseñemos la foto de Loreto?
那我们给它看 Loreto 的照片时,会发生什么?
• Supongamos que en nuestro dataset todos los ejemplos con ropa azul son hombres.
• 假设在我们的数据集里,所有穿蓝色衣服的样本都是男人。
¿Debería el algoritmo usar el "Color de la ropa" para identificar el género?
算法应该用「衣服颜色」来判断性别吗?
• Si vuestro objetivo es ganar en el menor número de turnos posible, ¿sería una buena estrategia preguntar: "¿Tiene un bindi en la frente?" (como Verónica) al principio de la partida?
• 如果你的目标是用最少的轮数取胜,那么一开局就问「(像 Verónica 那样)额头上有点红痣吗?」会是一个好策略吗?
Respuestas · 参考答案
▸ 原页截图 p.11
Respuestas
参考答案
• Respuesta 1: En AA, este problema se llama
• 答案 1:在机器学习(AA)里,这个问题叫「标注噪声」。
Si los datos son subjetivos (dependen de la opinión del humano que hizo la tabla), el modelo tendrá un "techo" de precisión..
如果数据是主观的(取决于做表那个人的看法),模型的准确率就会有一个「天花板」。
• Respuesta 2: Este es un caso de
• 答案 2:这是一个数据偏置的案例。
Si el dataset no es equilibrado, el modelo "memoriza" prejuicios en lugar de aprender conceptos.
如果数据集不均衡,模型「记住」的就是偏见,而不是学到概念。
• Respuesta 3:
• 答案 3:熵与信息增益。
Preguntar por el bindi tiene una probabilidad de éxito bajísima.
问「有没有 bindi」的成功概率低得可怜。
La "pregunta inteligente" es la que divide el dataset en dos grupos aproximadamente iguales
所谓「聪明的问题」,就是能把数据集切成两个人数大致相等的组的问题。
• Respuesta 4:
• 答案 4:过拟合(Overfitting)与特征选择(Feature Selection):删掉易变的属性(比如衣服),保留稳定的属性(身体特征),以保证模型对新照片也能用。
三、什么是机器学习:三个定义与 KDD 流程
p.12–p.16Definición · 定义(Samuel / Mitchell / Ng)
▸ 原页截图 p.12
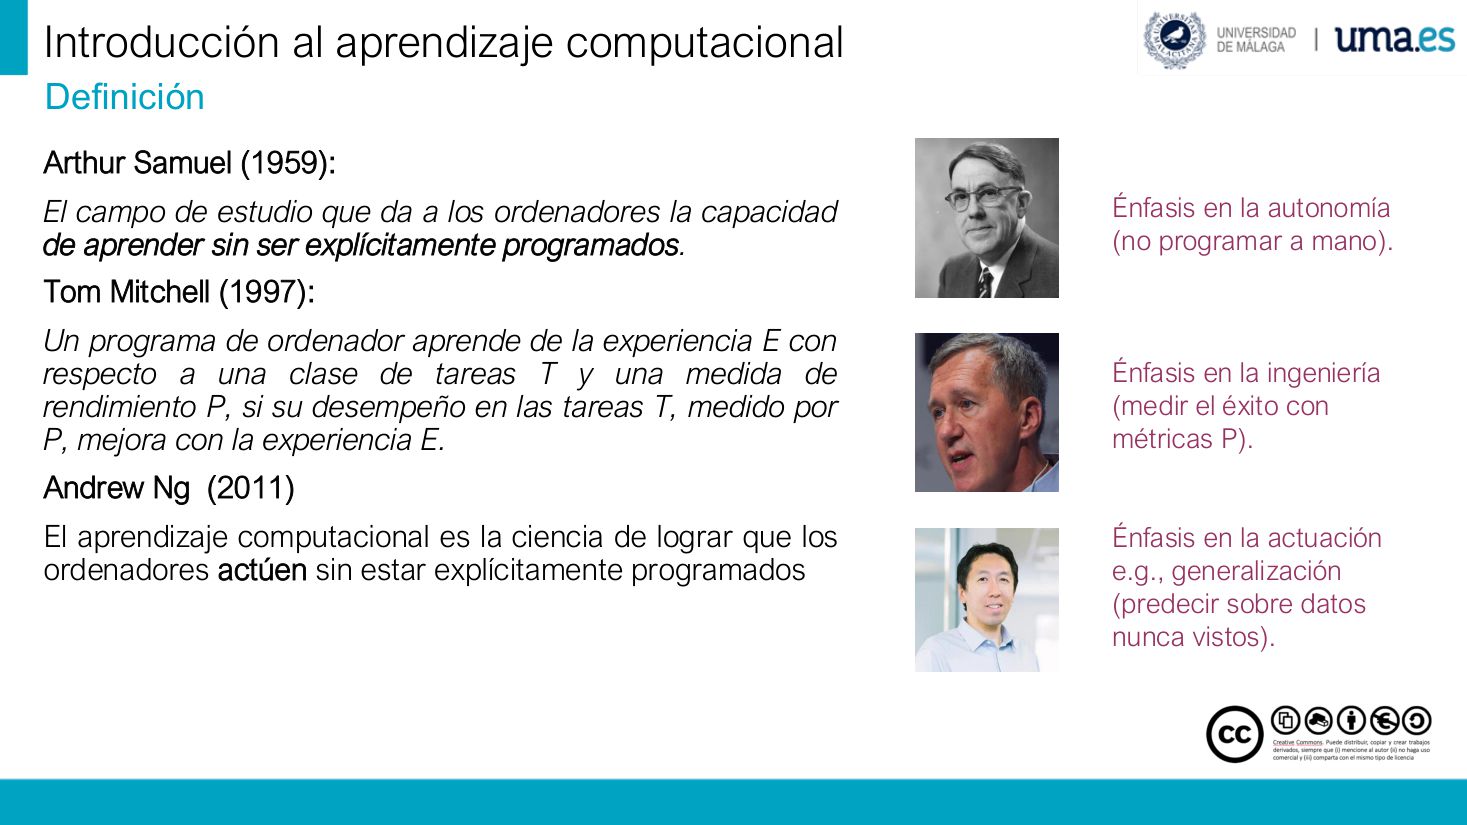
Definición
定义
Arthur Samuel (1959):
Arthur Samuel(1959):
El campo de estudio que da a los ordenadores la capacidad de aprender sin ser explícitamente programados.
这是一个研究领域:它赋予计算机「无需被显式编程就能学习」的能力。
Tom Mitchell (1997):
Tom Mitchell(1997):
Un programa de ordenador aprende de la experiencia E con respecto a una clase de tareas T y una medida de rendimiento P, si su desempeño en las tareas T, medido por P, mejora con la experiencia E.
若一个计算机程序在任务类 T 上的表现(由性能度量 P 衡量)随着经验 E 而提升,我们就说它关于 T、P 从 E 中学习。
Andrew Ng (2011)
Andrew Ng(2011)
El aprendizaje computacional es la ciencia de lograr que los ordenadores actúen sin estar explícitamente programados
计算学习是一门科学:让计算机在不被显式编程的情况下行动。
Énfasis en la autonomía (no programar a mano).
强调自主性(不手工编程)。
Énfasis en la ingeniería (medir el éxito con métricas P).
强调工程性(用度量 P 来衡量成功)。
Énfasis en la actuación e.g., generalización (predecir sobre datos nunca vistos).
强调表现,例如泛化(对从未见过的数据做预测)。
Definición Data Mining · 数据挖掘的定义
▸ 原页截图 p.13
Definición
数据挖掘的定义
Data mining is the process of discovering interesting knowledge, such as patterns, associations, changes, anomalies and significant structures, from large amounts of data stored in databases, data warehouses or other information repositories
数据挖掘是一个过程:从数据库、数据仓库或其他信息存储库中的海量数据里,发现有意义的(有趣的)知识,例如模式、关联、变化、异常和重要结构。
Enfoque: aplicación de técnicas (entre ellas ML) para extraer patrones y conocimiento de grandes conjuntos de datos.
着眼点:应用各种技术(其中包括机器学习)从大数据集中抽取模式与知识。
Referencia: J. Han & M. Kamber, Data Mining: Concepts and Techniques, Morgan Kaufmann, 2000.
参考文献:J. Han 与 M. Kamber,《Data Mining: Concepts and Techniques》,Morgan Kaufmann 出版社,2000 年。
Definición Knowledge Discovery · 知识发现(KDD)的定义
▸ 原页截图 p.14
Definición
知识发现的定义
Knowledge discovery in databases (KDD) is the nontrivial process of identifying valid, novel, potentially useful, and ultimately understandable patterns in data.
数据库中的知识发现(KDD)是一个非平凡的过程:从数据中识别出有效的、新颖的、可能有用的、并且最终可理解的模式。
Enfoque: proceso completo (selección, limpieza, transformación de datos, data mining, interpretación y uso del conocimiento).
着眼点:完整的过程(数据选择、清洗、变换、数据挖掘、解释以及知识的使用)。
Data mining sería una fase dentro de KDD.
数据挖掘只是 KDD 内部的一个阶段。
Referencia: U. M. Fayyad, G. Piatetsky-Shapiro, P. Smyth, “From Data Mining to Knowledge Discovery in Databases”, AI Magazine, 17(3), 1996.
参考文献:U. M. Fayyad、G. Piatetsky-Shapiro、P. Smyth,〈From Data Mining to Knowledge Discovery in Databases〉,《AI Magazine》17 卷 3 期,1996 年。
Fases del proceso de Knowledge Discovery · KDD 流程的各个阶段
▸ 原页截图 p.15
Fases del proceso de Knowledge Discovery:
知识发现过程的各个阶段:
https://www2.cs.uregina.ca/~dbd/cs831/notes/kdd/1_kdd.html
(课件给出的参考网址,原文照录)
El conocimiento extraído debe:
所提取出的知识必须:
• No ser trivial,
• 不是平凡的(不能是废话),
• Estar implícito en los datos,
• 隐含在数据之中,
• Ser previamente desconocido
• 是此前未知的
• Ser potencialmente útil
• 具有潜在的用处
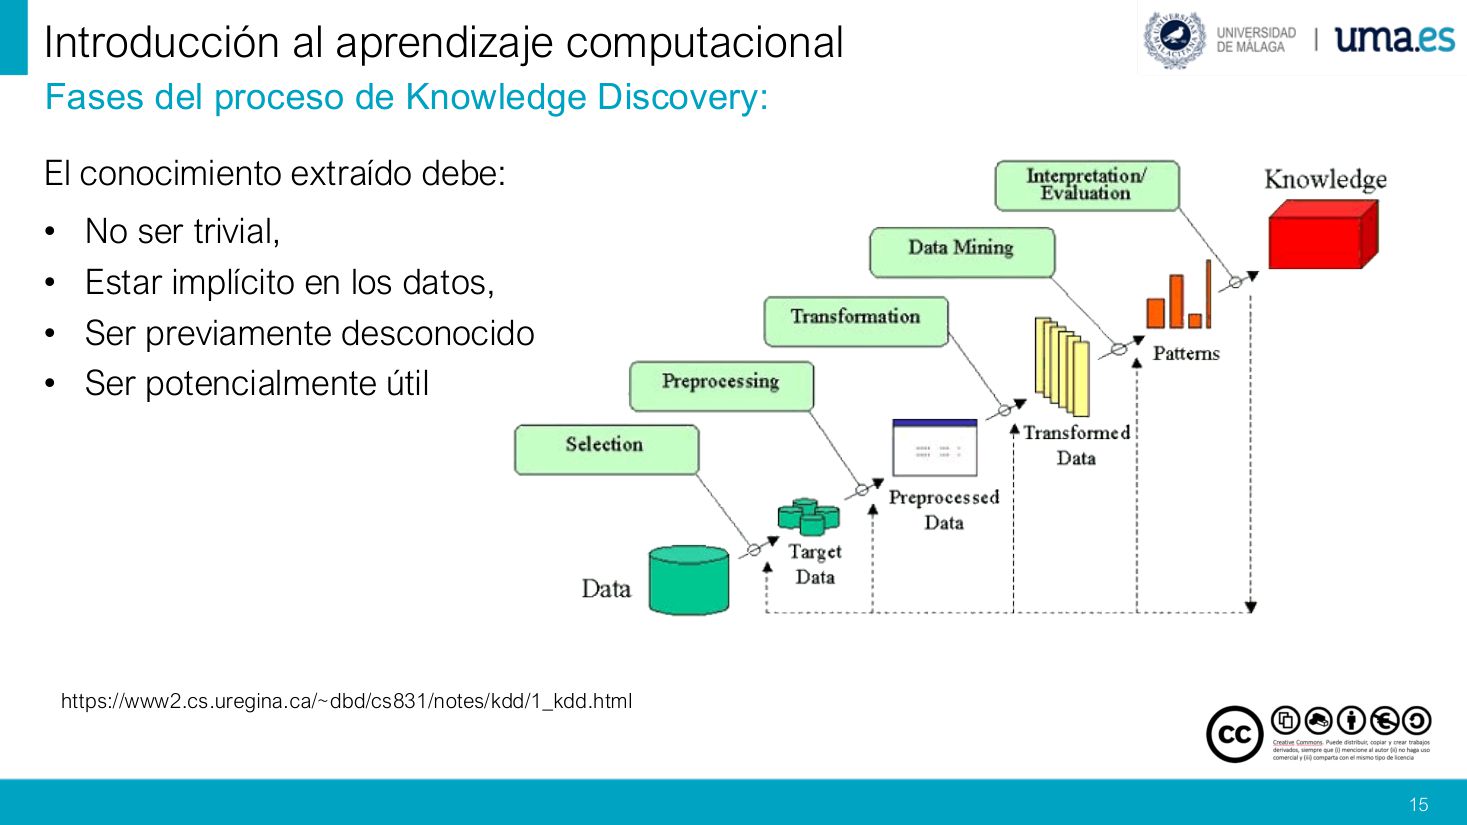
| 阶段(原图标签) | 中文 | 该阶段之后的产物(原图标签) |
|---|---|---|
| Selection | 选择 | Target Data |
| Preprocessing | 预处理 | Preprocessed Data |
| Transformation | 变换 | Transformed Data |
| Data Mining | 数据挖掘 | Patterns |
| Interpretation/Evaluation | 解释 / 评估 | Knowledge |
Un mito en minería de datos · 数据挖掘中的一个「神话」
▸ 原页截图 p.16
Un mito en minería de datos
数据挖掘中的一个「神话」
El mito:
这个神话是这样的:
En los años 90, una gran cadena de supermercados analizó millones de tickets de compra usando minería de datos (market basket analysis) y se descubrieron varias asociaciones:
上世纪 90 年代,一家大型连锁超市用数据挖掘(购物篮分析)分析了数百万张购物小票,发现了若干关联:
“Cereales, leche”, “ginebra, tónica, limones”, “pañales, cerveza”
「麦片、牛奶」「金酒、汤力水、柠檬」「尿布、啤酒」
Preguntas:
问题:
• ¿Qué descubrimiento cumple las condiciones del knowledge discovery?
• 哪一项发现满足知识发现的条件?
(no ser trivial, estar implícito en los datos, ser previamente desconocido y potencialmente útil)
(不平凡、隐含在数据中、此前未知、且潜在有用)
• ¿Qué interpretación podemos darle?
• 我们能对它作什么解释?
• ¿Qué acción tomaríamos?
• 我们会采取什么行动?
• ¿Qué resultados cabe esperar?
• 可以期待什么样的结果?
四、数据与属性:对象、属性、类型
p.17–p.20Definiciones · 基本术语:对象、属性、数据、取值、标注数据
▸ 原页截图 p.17
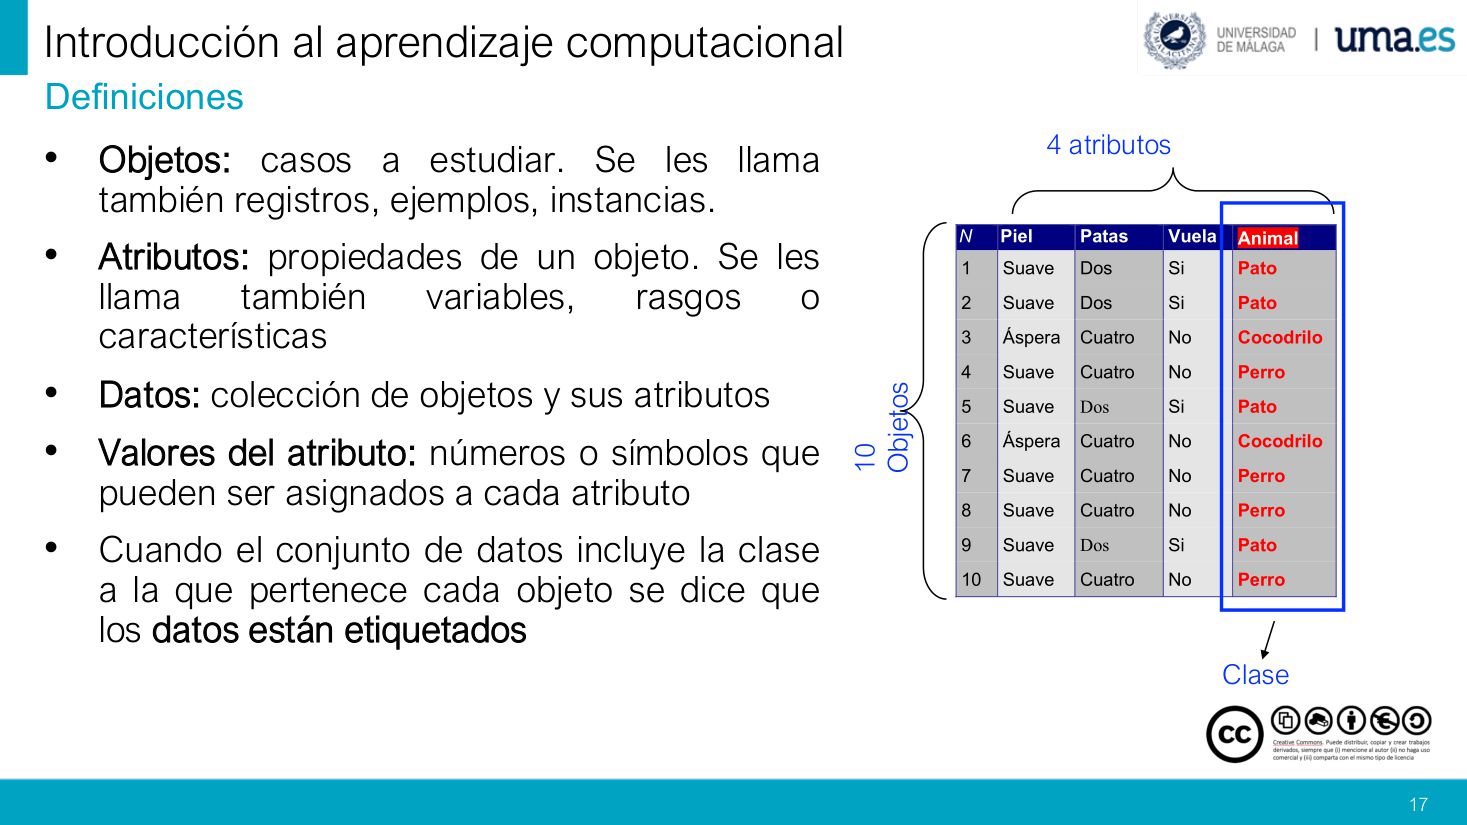
Definiciones
定义
•
• 对象:要研究的个案。
Se les llama también registros, ejemplos, instancias.
它们也被称作记录、样例、实例。
•
• 属性:一个对象的性质。
Se les llama también variables, rasgos o características
它们也被称作变量、特征或特性。
•
• 数据:对象及其属性的集合。
•
• 属性取值:可以赋给每个属性的数字或符号。
• Cuando el conjunto de datos incluye la clase a la que pertenece cada objeto se dice que los datos están
• 当数据集包含每个对象所属的类别时,我们就说这些数据是「已标注的」。
| N | Piel | Patas | Vuela | Animal |
|---|---|---|---|---|
| 1 | Suave | Dos | Si | Pato |
| 2 | Suave | Dos | Si | Pato |
| 3 | Áspera | Cuatro | No | Cocodrilo |
| 4 | Suave | Cuatro | No | Perro |
| 5 | Suave | Dos | Si | Pato |
| 6 | Áspera | Cuatro | No | Cocodrilo |
| 7 | Suave | Cuatro | No | Perro |
| 8 | Suave | Cuatro | No | Perro |
| 9 | Suave | Dos | Si | Pato |
| 10 | Suave | Cuatro | No | Perro |
Tipos de atributos · 属性类型:离散 / 连续,二值 / 名义 / 有序
▸ 原页截图 p.18
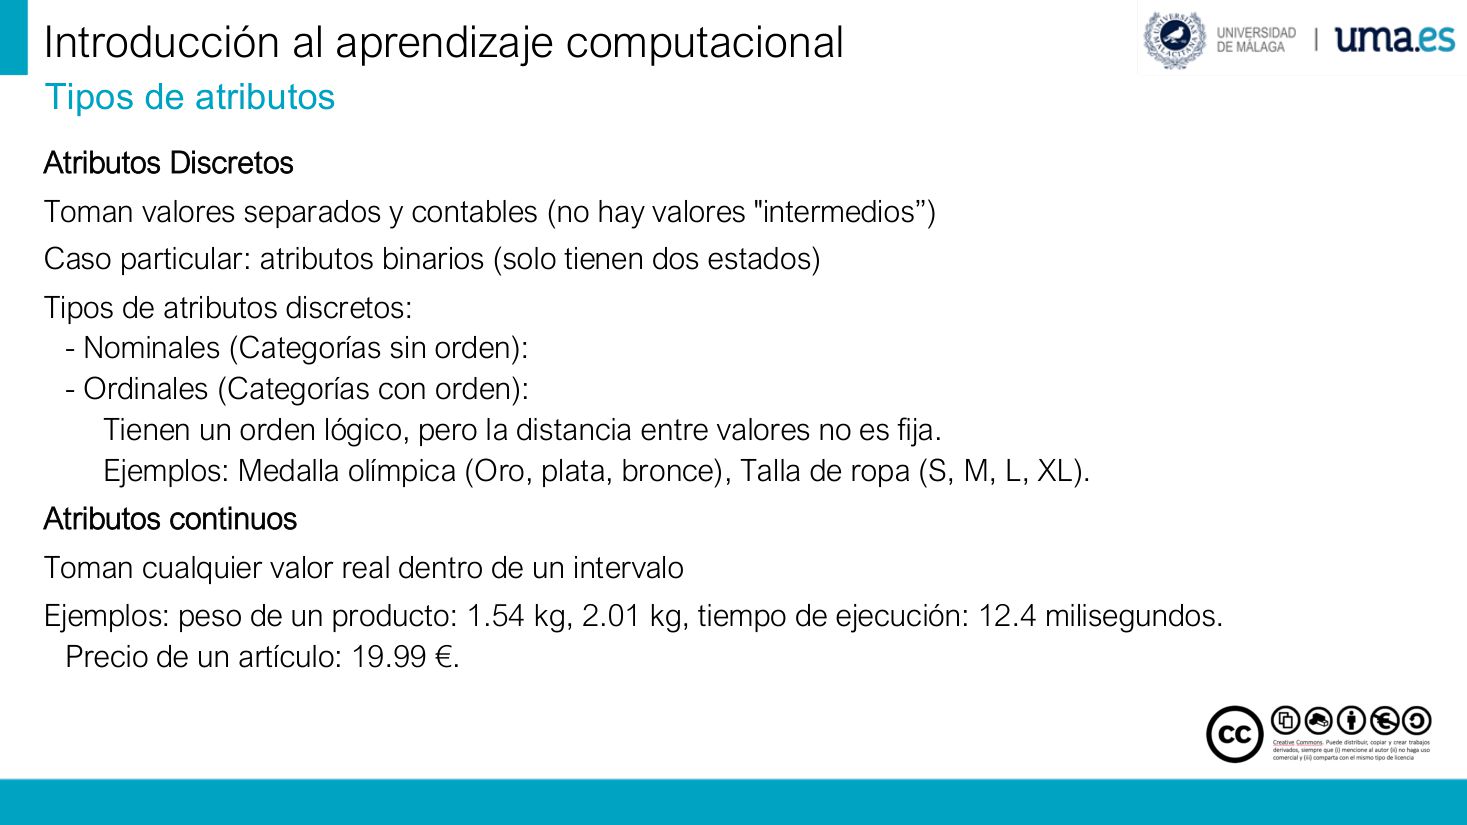
Tipos de atributos
属性类型
离散属性
Toman valores separados y contables (no hay valores "intermedios”)
取彼此分离、可以计数的值(不存在「中间值」)。
Caso particular:
特例:二值属性(只有两个状态)。
Tipos de atributos discretos:
离散属性的类型:
-
- 名义型(类别之间没有顺序):
-
- 有序型(类别之间有顺序):
Tienen un orden lógico, pero la distancia entre valores no es fija.
它们有逻辑上的顺序,但取值之间的距离并不固定。
Ejemplos: Medalla olímpica (Oro, plata, bronce), Talla de ropa (S, M, L, XL).
例子:奥运奖牌(金、银、铜)、衣服尺码(S、M、L、XL)。
连续属性
Toman cualquier valor real dentro de un intervalo
在一个区间内取任意实数值。
Ejemplos: peso de un producto: 1.54 kg, 2.01 kg, tiempo de ejecución: 12.4 milisegundos.
例子:商品重量 1.54 kg、2.01 kg;执行时间 12.4 毫秒。
Precio de un artículo: 19.99 €.
商品价格:19.99 €。
| 大类 | 子类 | 原文判据 | 原文例子 |
|---|---|---|---|
| Atributos Discretos | Binarios | solo tienen dos estados | — |
| Atributos Discretos | Nominales | Categorías sin orden | — |
| Atributos Discretos | Ordinales | Categorías con orden, distancia no fija | Medalla olímpica; Talla de ropa |
| Atributos continuos | — | cualquier valor real dentro de un intervalo | peso; tiempo de ejecución; precio |
Tipos de atributos: atributos discretos · 例:六列客户数据,逐列判类型
▸ 原页截图 p.19
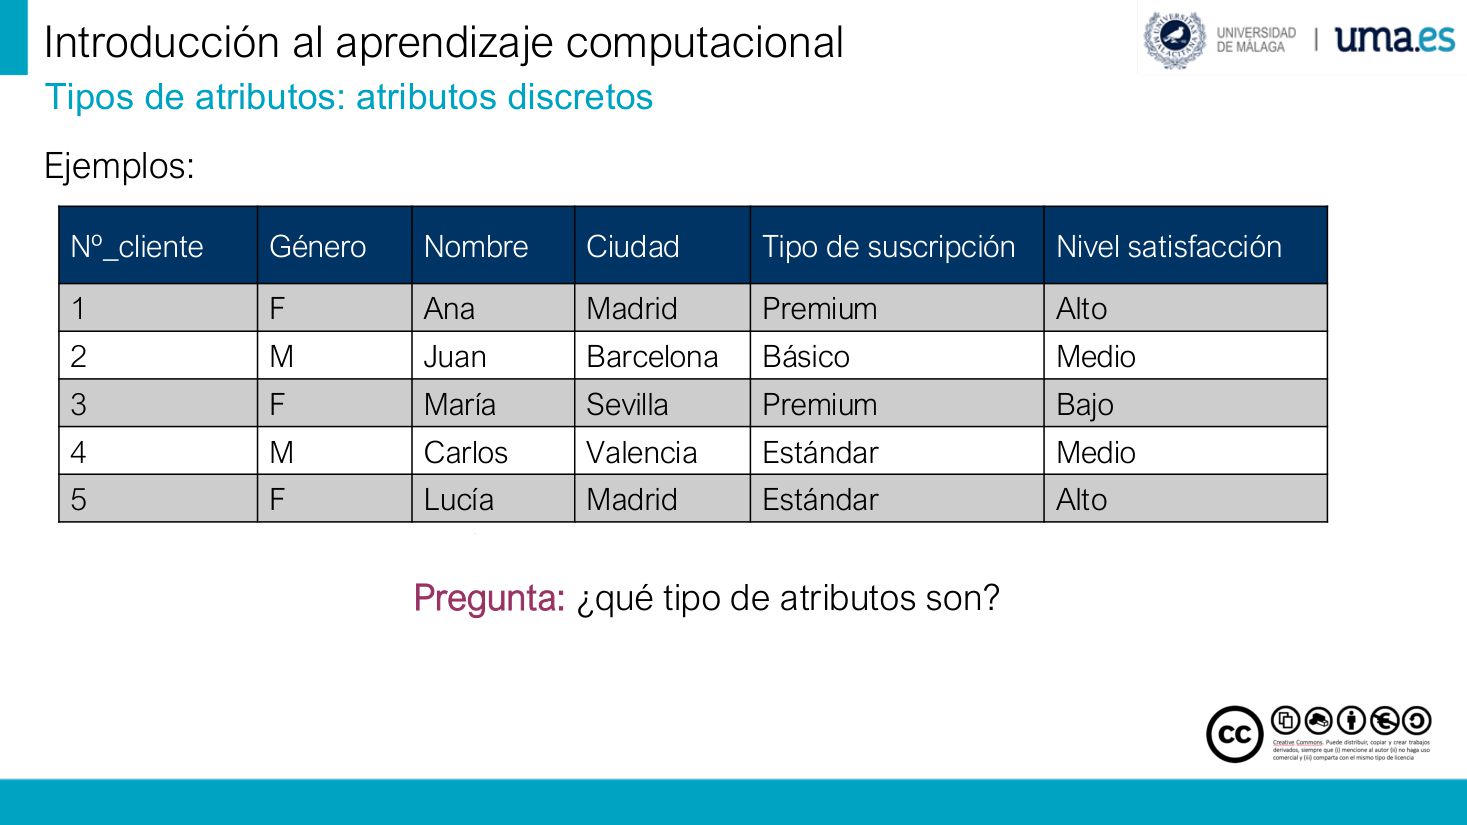
Ejemplos:
例子:
Tipos de atributos: atributos discretos
属性类型:离散属性
| Nº_cliente | Género | Nombre | Ciudad | Tipo de suscripción | Nivel satisfacción |
|---|---|---|---|---|---|
| 1 | F | Ana | Madrid | Premium | Alto |
| 2 | M | Juan | Barcelona | Básico | Medio |
| 3 | F | María | Sevilla | Premium | Bajo |
| 4 | M | Carlos | Valencia | Estándar | Medio |
| 5 | F | Lucía | Madrid | Estándar | Alto |
Pregunta: ¿qué tipo de atributos son?
问题:它们分别属于什么类型的属性?
| 属性 | 原文取值 | 推断类型 | 为什么 |
|---|---|---|---|
| Nº_cliente | 1, 2, 3, 4, 5 | 离散(数值型标识符) | 能一个个数,但只是编号,做加减没有意义 |
| Género | F / M | 二值(binario) | 只有两个状态 |
| Nombre | Ana, Juan, María… | 名义(nominal) | 类别,没有顺序 |
| Ciudad | Madrid, Barcelona… | 名义(nominal) | 地名之间不能排大小 |
| Tipo de suscripción | Básico / Estándar / Premium | 有序(ordinal) | 档次有高低,但档次间距不固定 |
| Nivel satisfacción | Bajo / Medio / Alto | 有序(ordinal) | Bajo < Medio < Alto,间距不等 |
Tipos de atributos: atributos numéricos · 例:病人数据 + 两道判断
▸ 原页截图 p.20
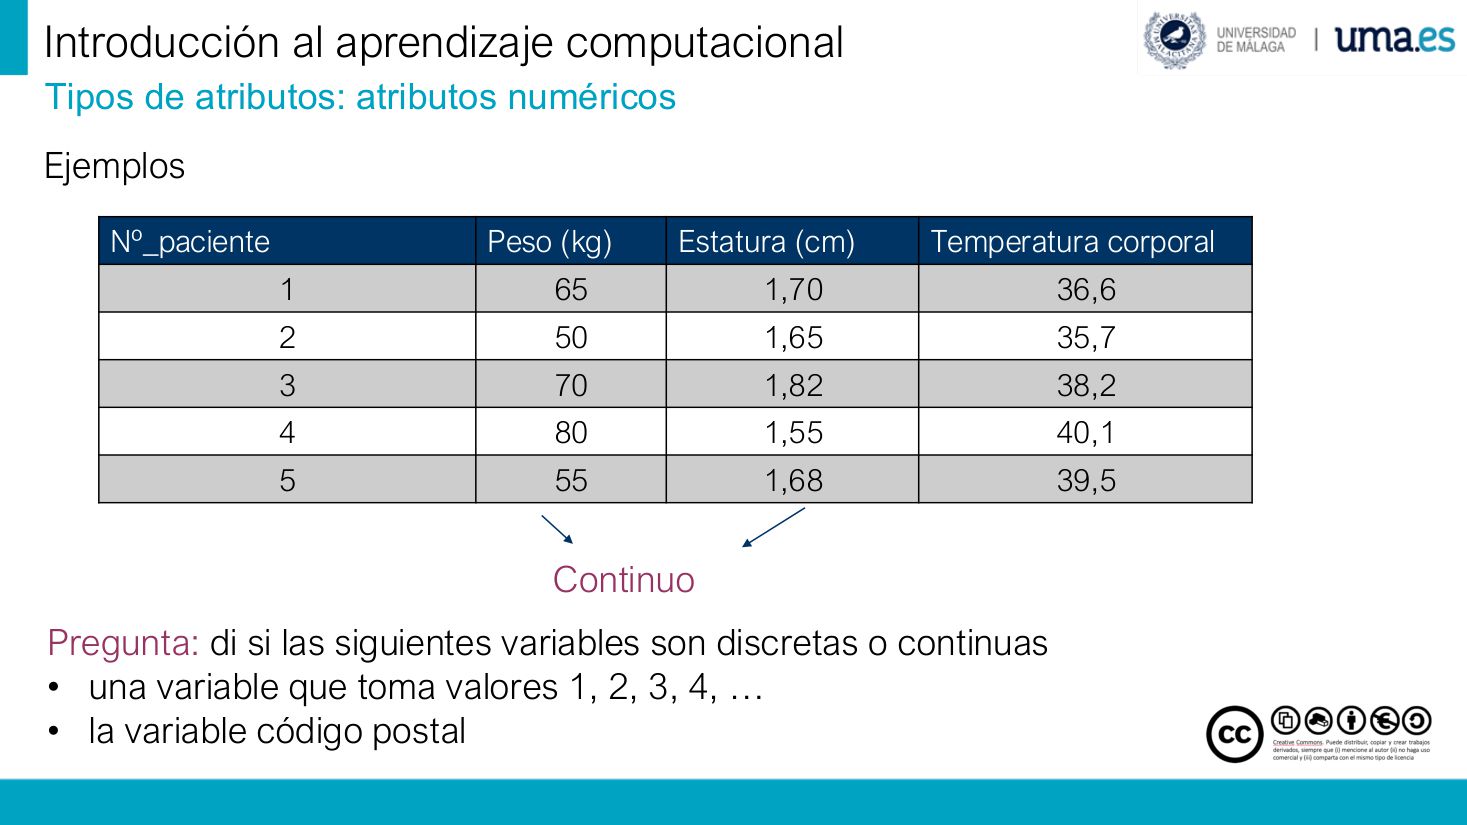
Ejemplos
例子
Tipos de atributos: atributos numéricos
属性类型:数值属性
| Nº_paciente | Peso (kg) | Estatura (cm) | Temperatura corporal |
|---|---|---|---|
| 1 | 65 | 1,70 | 36,6 |
| 2 | 50 | 1,65 | 35,7 |
| 3 | 70 | 1,82 | 38,2 |
| 4 | 80 | 1,55 | 40,1 |
| 5 | 55 | 1,68 | 39,5 |
Pregunta: di si las siguientes variables son discretas o continuas
问题:说出下列变量是离散的还是连续的。
• una variable que toma valores 1, 2, 3, 4, …
• 一个取值为 1、2、3、4、…… 的变量
• la variable código postal
• 「邮政编码」这个变量
五、模型分类:监督 / 无监督、预测 / 描述
p.21–p.27Tipos de modelos (según si hay variable clase o no) · 按「有没有类别变量」分:监督 vs 无监督
▸ 原页截图 p.21
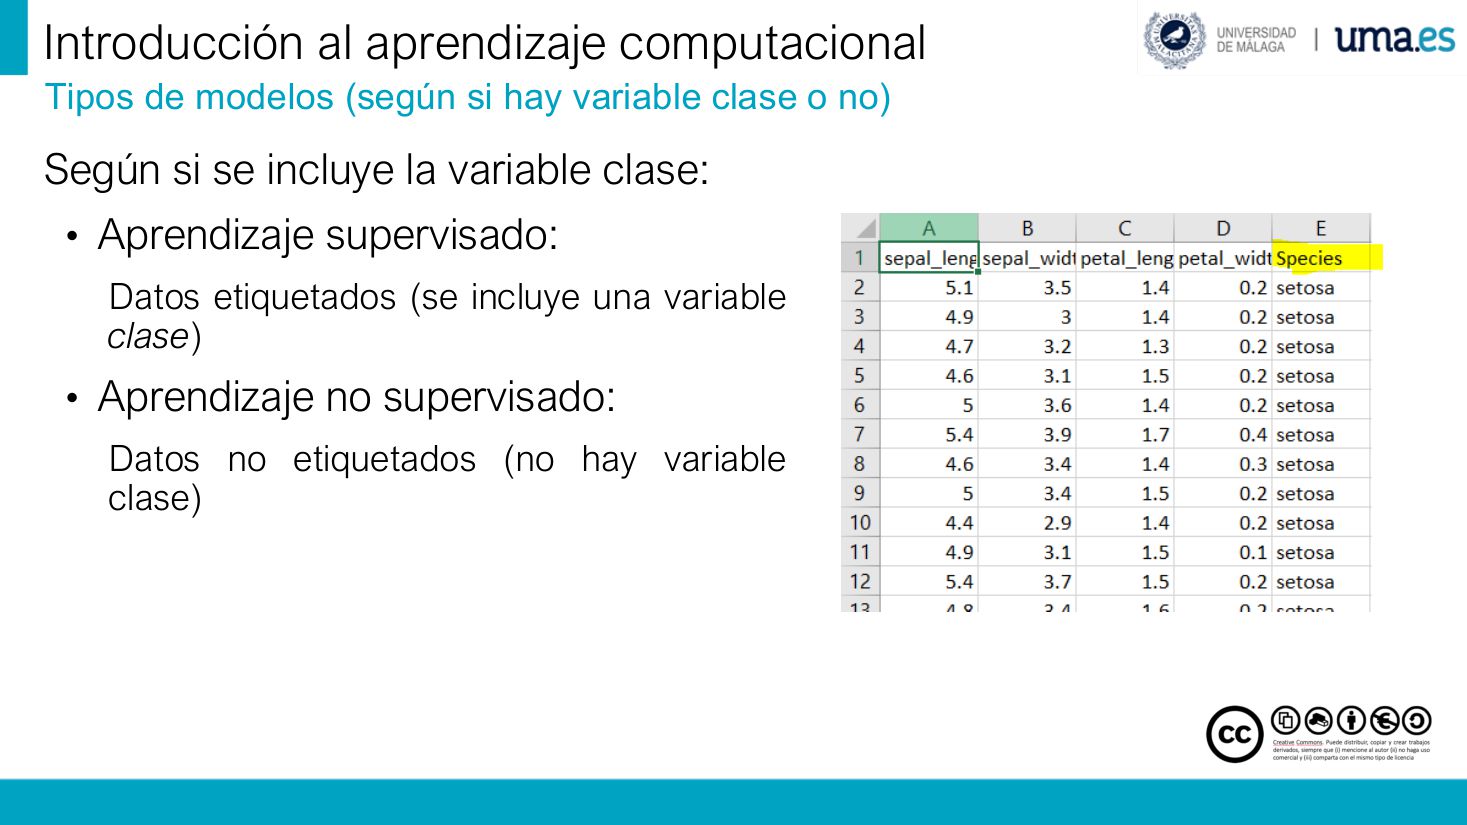
Tipos de modelos (según si hay variable clase o no)
模型类型(按是否存在类别变量划分)
Según si se incluye la variable clase:
依据是否包含类别变量:
•
• 监督学习:
已标注数据(包含一个类别变量)。
•
• 无监督学习:
Datos no etiquetados (no hay variable clase)
未标注数据(没有类别变量)。
Tipos de modelos (según su objetivo) · 按「目标」分:预测型 vs 描述型
▸ 原页截图 p.22
Tipos de modelos (según su objetivo)
模型类型(按其目标划分)
Según su objetivo:
依据其目标:
•
• 预测型模型
El objetivo es predecir los valores de la variable de interés (clase o
目标是根据其他变量的取值,预测「关注变量」(类别,或叫响应变量)的取值。
•
• 描述型模型
El objetivo es describir el comportamiento de los datos, encontrando
目标是描述数据的行为,找出模式、关联、共同特征等等。
Ejemplos: Quién es quién · 例:是谁?——同一张人物表的两连问
▸ 原页截图 p.23
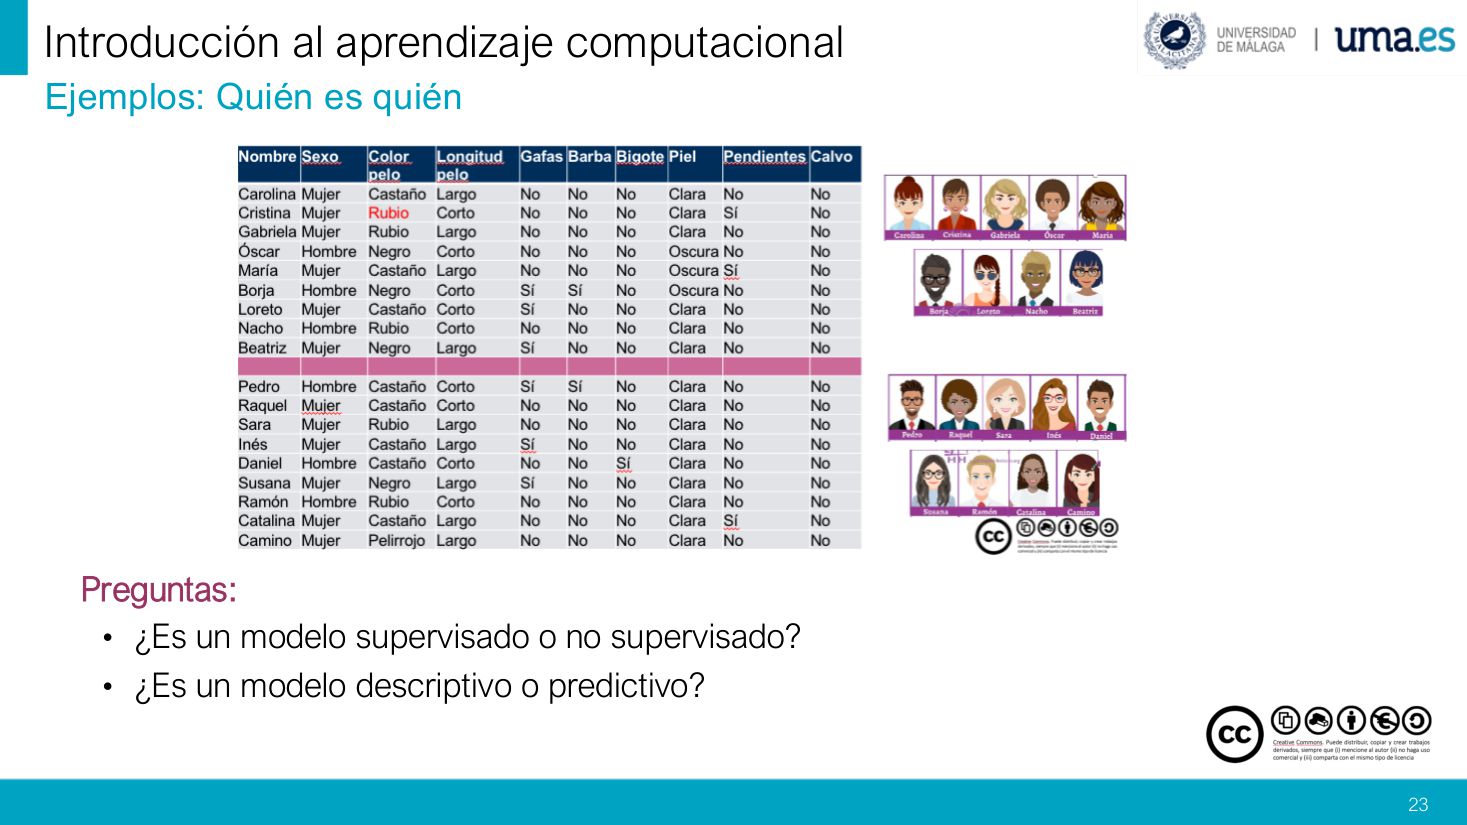
Ejemplos: Quién es quién
例子:是谁?(Who's Who 桌游)
| Nombre | Sexo | Color pelo | Longitud pelo | Gafas | Barba | Bigote | Piel | Pendientes | Calvo |
|---|---|---|---|---|---|---|---|---|---|
| Carolina | Mujer | Castaño | Largo | No | No | No | Clara | No | No |
| Cristina | Mujer | Rubio | Corto | No | No | No | Clara | Sí | No |
| Gabriela | Mujer | Rubio | Largo | No | No | No | Clara | No | No |
| Óscar | Hombre | Negro | Corto | No | No | No | Oscura | No | No |
| María | Mujer | Castaño | Largo | No | No | No | Oscura | Sí | No |
| Borja | Hombre | Negro | Corto | Sí | Sí | No | Oscura | No | No |
| Loreto | Mujer | Castaño | Corto | Sí | No | No | Clara | No | No |
| Nacho | Hombre | Rubio | Corto | No | No | No | Clara | No | No |
| Beatriz | Mujer | Negro | Largo | Sí | No | No | Clara | No | No |
| Pedro | Hombre | Castaño | Corto | Sí | Sí | No | Clara | No | No |
| Raquel | Mujer | Castaño | Corto | No | No | No | Clara | No | No |
| Sara | Mujer | Rubio | Largo | No | No | No | Clara | No | No |
| Inés | Mujer | Castaño | Largo | Sí | No | No | Clara | No | No |
| Daniel | Hombre | Castaño | Corto | No | No | Sí | Clara | No | No |
| Susana | Mujer | Negro | Largo | Sí | No | No | Clara | No | No |
| Ramón | Hombre | Rubio | Corto | No | No | No | Clara | No | No |
| Catalina | Mujer | Castaño | Largo | No | No | No | Clara | Sí | No |
| Camino | Mujer | Pelirrojo | Largo | No | No | No | Clara | No | No |
Preguntas:
问题:
• ¿Es un modelo supervisado o no supervisado?
• 这是一个监督模型还是无监督模型?
• ¿Es un modelo descriptivo o predictivo?
• 这是一个描述型模型还是预测型模型?
Ejemplos: detección de intrusiones · 例:入侵检测——把网络流量分成「正常 / 恶意」
▸ 原页截图 p.24
Ejemplos: detección de intrusiones
例子:入侵检测
Se busca entrenar un modelo que clasifique el tráfico de red en normal o malicioso, a partir de los datos capturados en los paquetes que circulan por la red.
目标是训练一个模型,依据网络中流动的数据包所捕获的数据,把网络流量分类为「正常」或「恶意」。
Tenemos una base de datos en la que para cada registro disponemos de la siguiente información:
我们有一个数据库,其中每条记录都包含下列信息:
• Dirección IP de origen y destino
• 源 IP 与目的 IP 地址
• Protocolo usado (TCP, UDP, ICMP, etc.)
• 使用的协议(TCP、UDP、ICMP 等)
• Número de bytes enviados y recibidos
• 发送与接收的字节数
• Duración de la conexión
• 连接持续时间
• Número de paquetes retransmitidos o fallidos
• 重传或失败的数据包数量
• Si el tráfico de red era normal o malicioso
• 该网络流量是正常还是恶意
Preguntas:
问题:
• ¿Es un modelo supervisado o no supervisado?
• 这是监督模型还是无监督模型?
• ¿Es un modelo descriptivo o predictivo?
• 这是描述型模型还是预测型模型?
Ejemplos: reglas de asociación · 例:关联规则——买了这个的人往往也买那个
▸ 原页截图 p.25
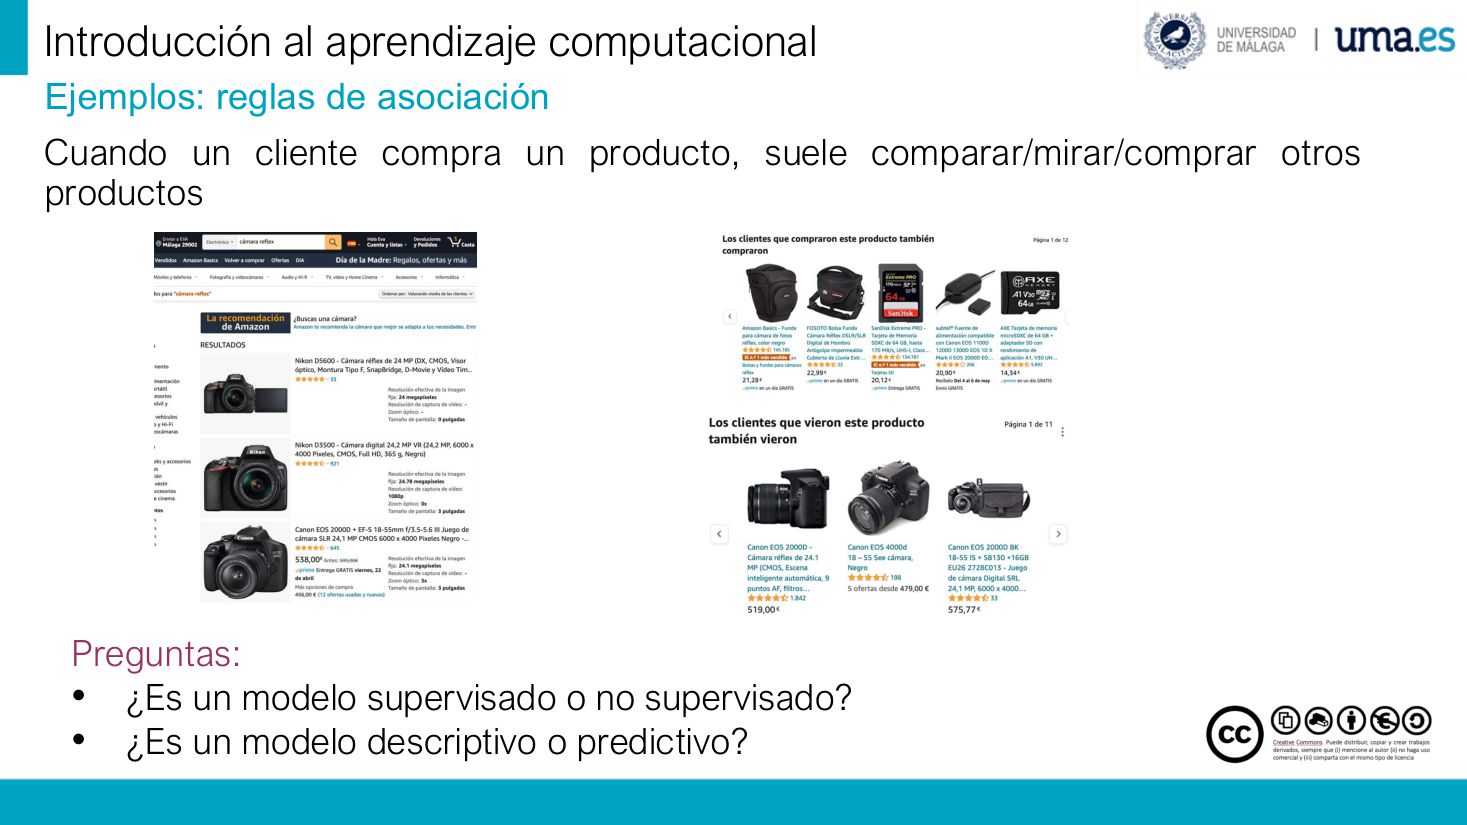
Ejemplos: reglas de asociación
例子:关联规则
Cuando un cliente compra un producto, suele comparar/mirar/comprar otros productos
当顾客购买一件商品时,往往会比较 / 浏览 / 购买其他商品。
Preguntas:
问题:
• ¿Es un modelo supervisado o no supervisado?
• 这是监督模型还是无监督模型?
• ¿Es un modelo descriptivo o predictivo?
• 这是描述型模型还是预测型模型?
Ejemplos: clustering · 例:聚类——按「用量」把手机用户分成三群
▸ 原页截图 p.26
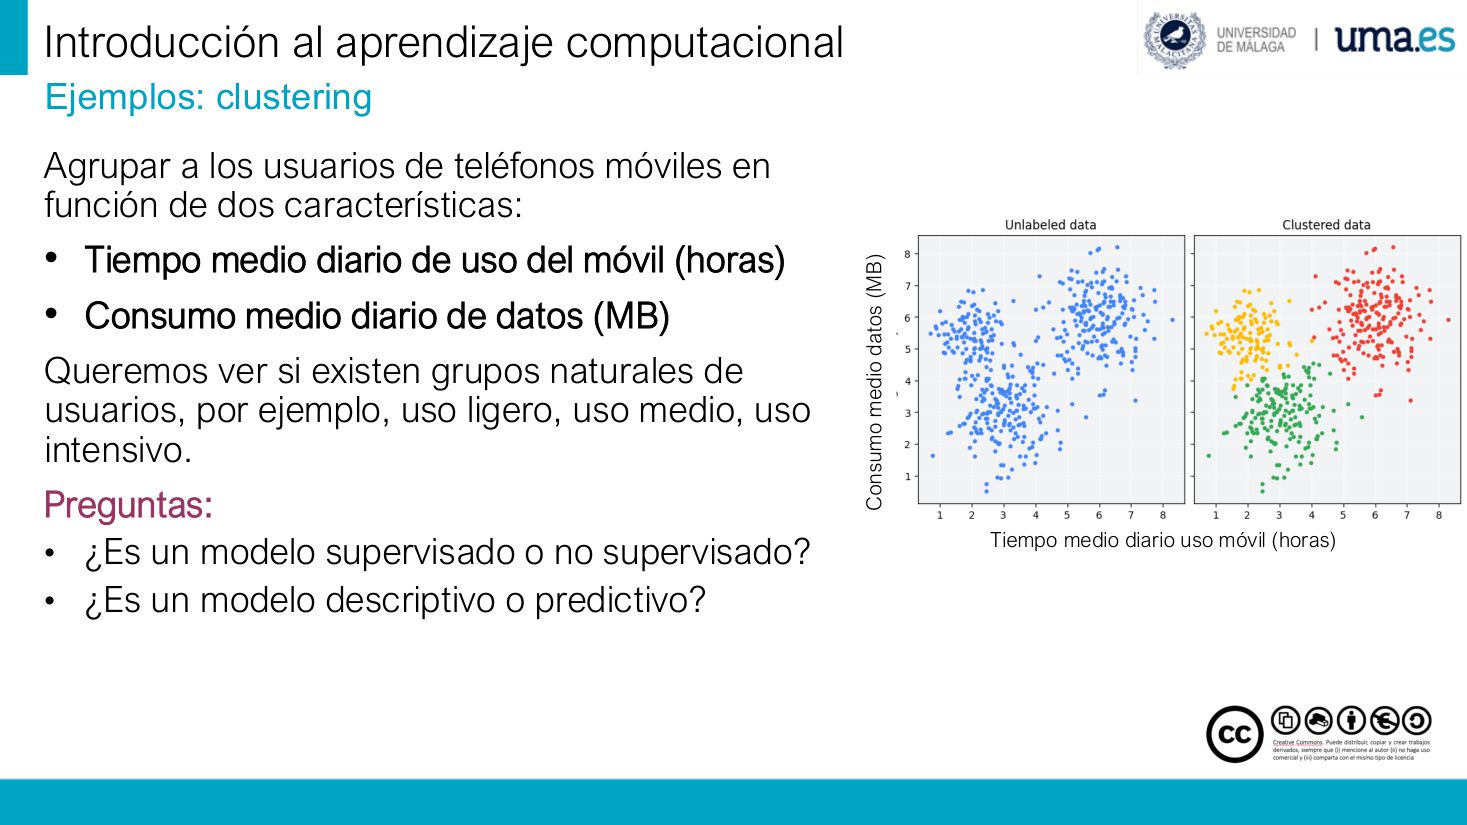
Ejemplos:
例子:聚类
Agrupar a los usuarios de teléfonos móviles en función de dos características:
依据两个特征把手机用户分组:
• Tiempo medio diario de uso del móvil (horas)
• 日均手机使用时长(小时)
• Consumo medio diario de datos (MB)
• 日均数据流量消耗(MB)
Queremos ver si existen grupos naturales de usuarios, por ejemplo, uso ligero, uso medio, uso intensivo.
我们想知道是否存在天然的用户群体,例如轻度使用、中度使用、重度使用。
Preguntas:
问题:
• ¿Es un modelo supervisado o no supervisado?
• 这是监督模型还是无监督模型?
• ¿Es un modelo descriptivo o predictivo?
• 这是描述型模型还是预测型模型?
Ejemplos: predicción de notas · 例:预测成绩——分类还是回归?标签数据还是无标签数据更靠谱?
▸ 原页截图 p.27
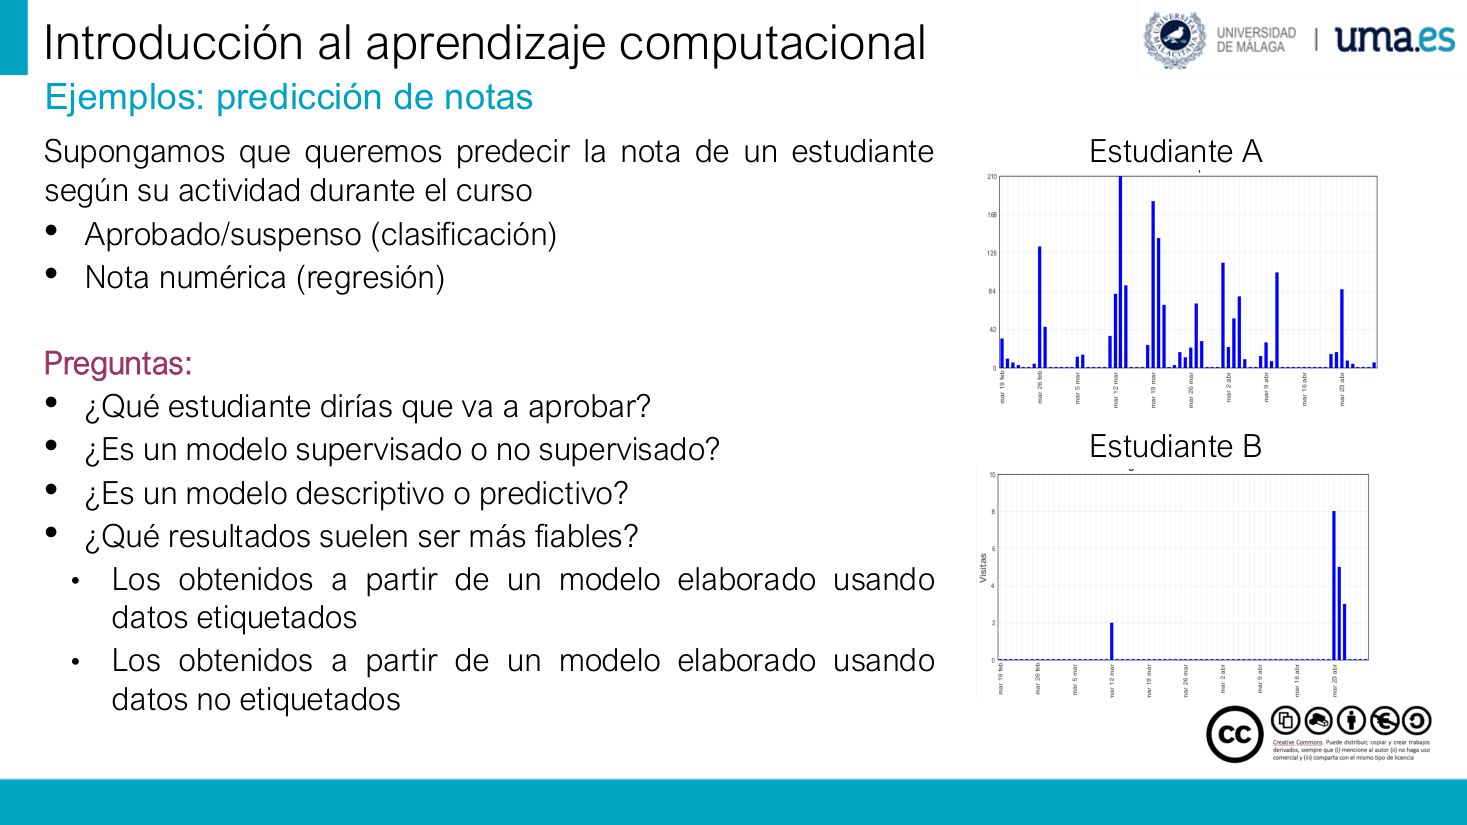
Ejemplos: predicción de notas
例子:成绩预测
Supongamos que queremos predecir la nota de un estudiante según su actividad durante el curso
假设我们想根据一名学生在课程期间的活动情况来预测他的成绩。
• Aprobado/suspenso (
• 及格 / 不及格(分类)
• Nota numérica (
• 数值分数(回归)
Preguntas:
问题:
• ¿Qué estudiante dirías que va a aprobar?
• 你觉得哪个学生将会及格?
• ¿Es un modelo supervisado o no supervisado?
• 这是监督模型还是无监督模型?
• ¿Es un modelo descriptivo o predictivo?
• 这是描述型模型还是预测型模型?
• ¿Qué resultados suelen ser más fiables?
• 哪一类结果通常更可靠?
• Los obtenidos a partir de un modelo elaborado usando datos etiquetados
• 用「已标注数据」构建的模型所得到的结果
• Los obtenidos a partir de un modelo elaborado usando datos no etiquetados
• 用「未标注数据」构建的模型所得到的结果
六、监督学习:分类与回归的算法清单
p.28–p.33Aprendizaje supervisado: tipos de problemas · 监督学习的两类问题:分类 vs 回归 + 算法清单
▸ 原页截图 p.28
Aprendizaje supervisado: tipos de problemas
监督学习:问题类型
Problemas de Clasificación: la variable clase es discreta (categorías).
分类问题:类别变量是离散的(类别型)。
• Reglas de clasificación. Infieren reglas para clasificar según los valores de los atributos
• 分类规则。根据属性取值推断出用于分类的规则。
•
• 朴素贝叶斯。根据在给定属性取值下每个类别的概率进行分类。
•
• 决策树。构建树,依据属性取值进行分类。
•
• K 近邻(k-NN):根据最近邻的「类别」进行分类。
Problemas de Regresión: la variable clase es continua (números).
回归问题:类别变量是连续的(数值型)。
• Regresión Lineal: Busca la relación lineal (una línea o plano) que mejor ajusta los datos.
• 线性回归:寻找最能拟合数据的线性关系(一条直线或一个平面)。
• Regresión Polinomial: Para relaciones más complejas que no siguen una línea recta.
• 多项式回归:用于不沿直线走的更复杂关系。
Pregunta: ¿Qué tipo de problema es….
问题:下列属于哪类问题……
… predecir si un banco le dará el crédito a un cliente?
…… 预测一家银行是否会给某客户放贷?
... predecir cuánto dinero exactamente le prestará?
…… 预测银行究竟会贷给他多少钱?
Aprendizaje supervisado: esquema general clasificación · 监督学习总流程(分类):训练 → 预测两个阶段
▸ 原页截图 p.29
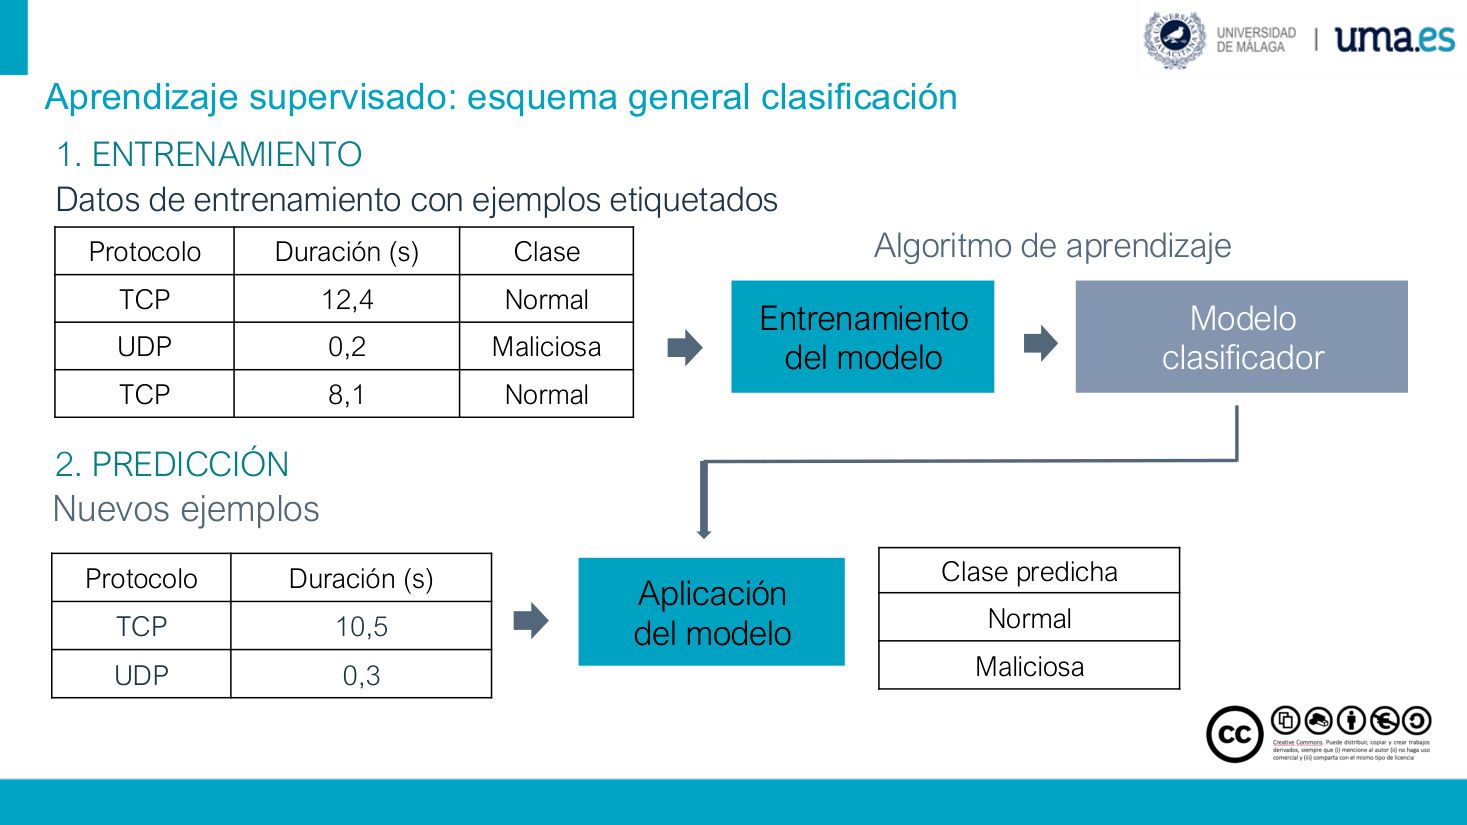
1. ENTRENAMIENTO
1. 训练阶段
带标签样例的训练数据
| Protocolo | Duración (s) | Clase |
|---|---|---|
| TCP | 12,4 | Normal |
| UDP | 0,2 | Maliciosa |
| TCP | 8,1 | Normal |
Entrenamiento del modelo
模型训练
Algoritmo de aprendizaje
学习算法
分类器模型
2. PREDICCIÓN
2. 预测阶段
Nuevos ejemplos
新的样例
| Protocolo | Duración (s) |
|---|---|
| TCP | 10,5 |
| UDP | 0,3 |
| Clase predicha |
|---|
| Normal |
| Maliciosa |
Aplicación del modelo
模型应用
Clase predicha
预测出的类别
Aprendizaje supervisado: ejemplo clasificación (árboles de decisión) · 决策树实例:14 条训练样例 → 一棵树 → 新样例判类
▸ 原页截图 p.30
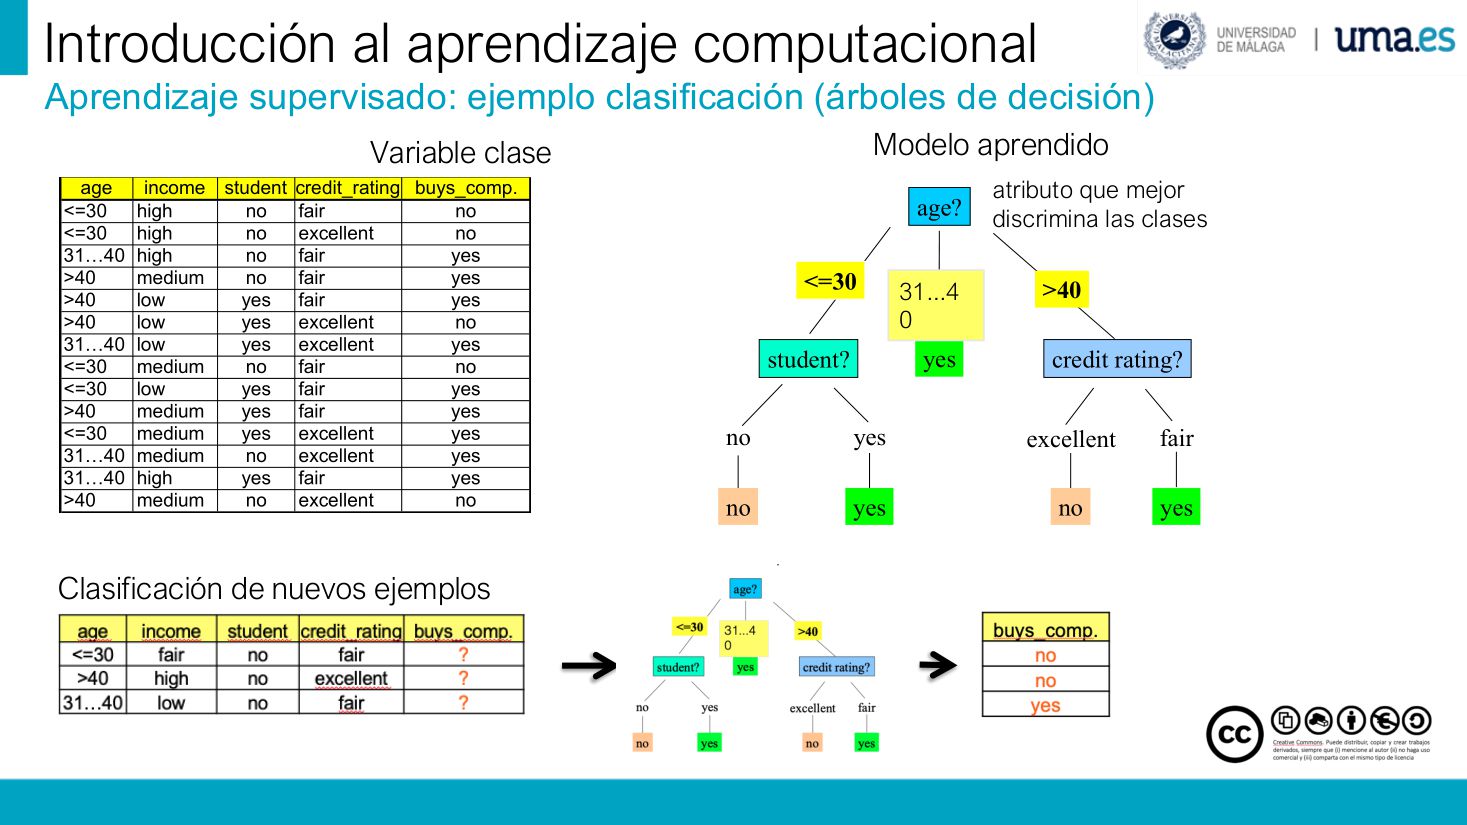
Introducción al aprendizaje computacional
计算学习导论(页眉标题)
Aprendizaje supervisado: ejemplo clasificación (árboles de decisión)
监督学习实例:分类(决策树)
Variable clase
类别变量
| age | income | student | credit_rating | buys_comp. |
|---|---|---|---|---|
| <=30 | high | no | fair | no |
| <=30 | high | no | excellent | no |
| 31…40 | high | no | fair | yes |
| >40 | medium | no | fair | yes |
| >40 | low | yes | fair | yes |
| >40 | low | yes | excellent | no |
| 31…40 | low | yes | excellent | yes |
| <=30 | medium | no | fair | no |
| <=30 | low | yes | fair | yes |
| >40 | medium | yes | fair | yes |
| <=30 | medium | yes | excellent | yes |
| 31…40 | medium | no | excellent | yes |
| 31…40 | high | yes | fair | yes |
| >40 | medium | no | excellent | no |
Modelo aprendido
学到的模型
atributo que mejor discrimina las clases
最能区分各个类别的属性
Clasificación de nuevos ejemplos
新样例的分类
| age | income | student | credit_rating | buys_comp. |
|---|---|---|---|---|
| <=30 | fair | no | fair | ? |
| >40 | high | no | excellent | ? |
| 31…40 | low | no | fair | ? |
| buys_comp. |
|---|
| no |
| no |
| yes |
Aprendizaje supervisado: esquema general regresión · 监督学习总流程(回归):面积 / 房间数 → 房价
▸ 原页截图 p.31
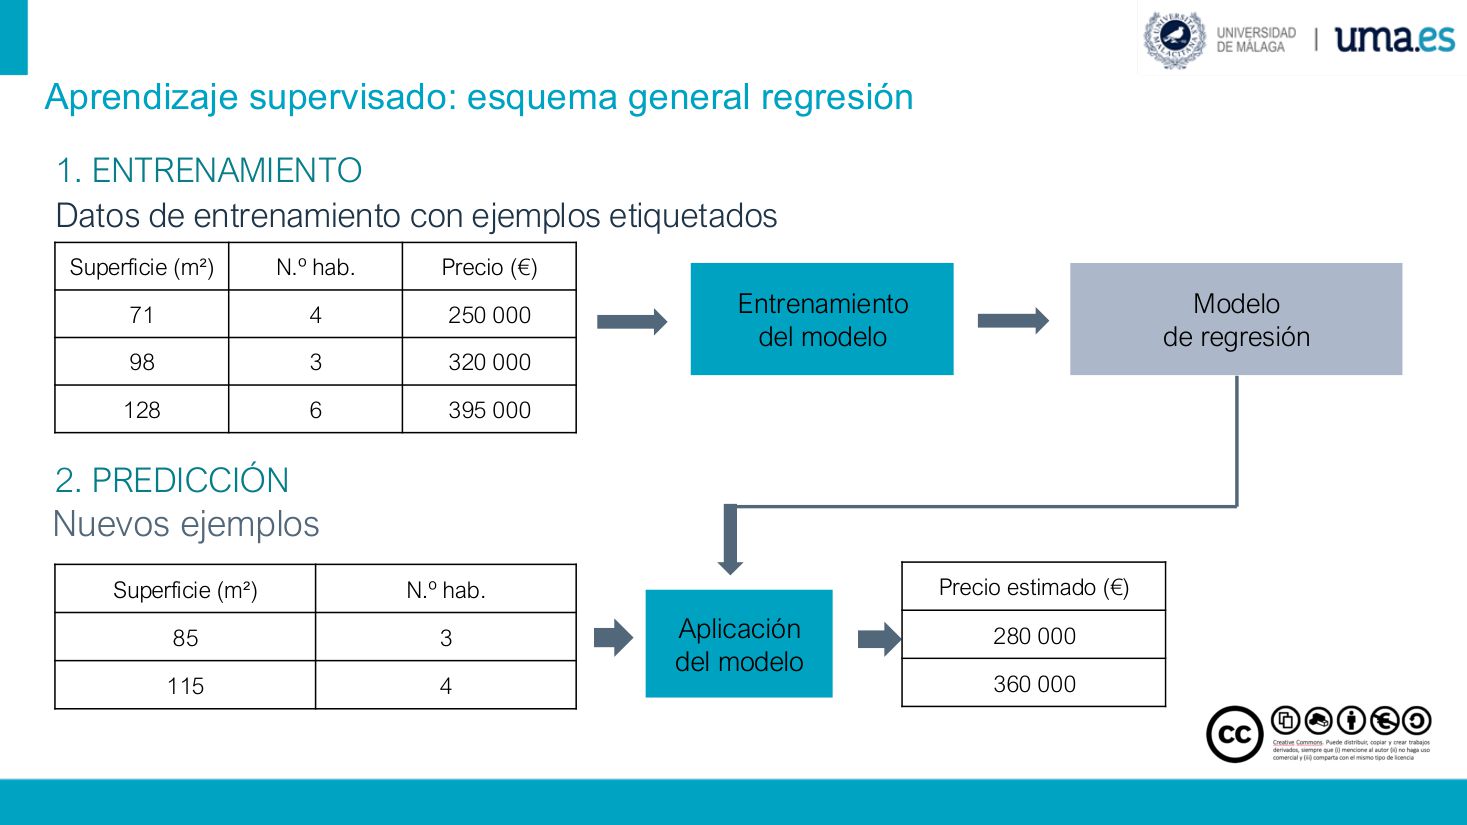
Aprendizaje supervisado: esquema general regresión
监督学习总流程:回归
1. ENTRENAMIENTO
1. 训练阶段
Datos de entrenamiento con ejemplos etiquetados
带标签样例的训练数据
| Superficie (m²) | N.º hab. | Precio (€) |
|---|---|---|
| 71 | 4 | 250 000 |
| 98 | 3 | 320 000 |
| 128 | 6 | 395 000 |
Entrenamiento del modelo
模型训练
Modelo de regresión
回归模型
2. PREDICCIÓN
2. 预测阶段
Nuevos ejemplos
新的样例
Aplicación del modelo
模型应用
| Superficie (m²) | N.º hab. |
|---|---|
| 85 | 3 |
| 115 | 4 |
| Precio estimado (€) |
|---|
| 280 000 |
| 360 000 |
Aprendizaje supervisado: ejemplo regresión (lineal) · 线性回归实例:梯度法拟合直线,预测 100 m² 的房子
▸ 原页截图 p.32
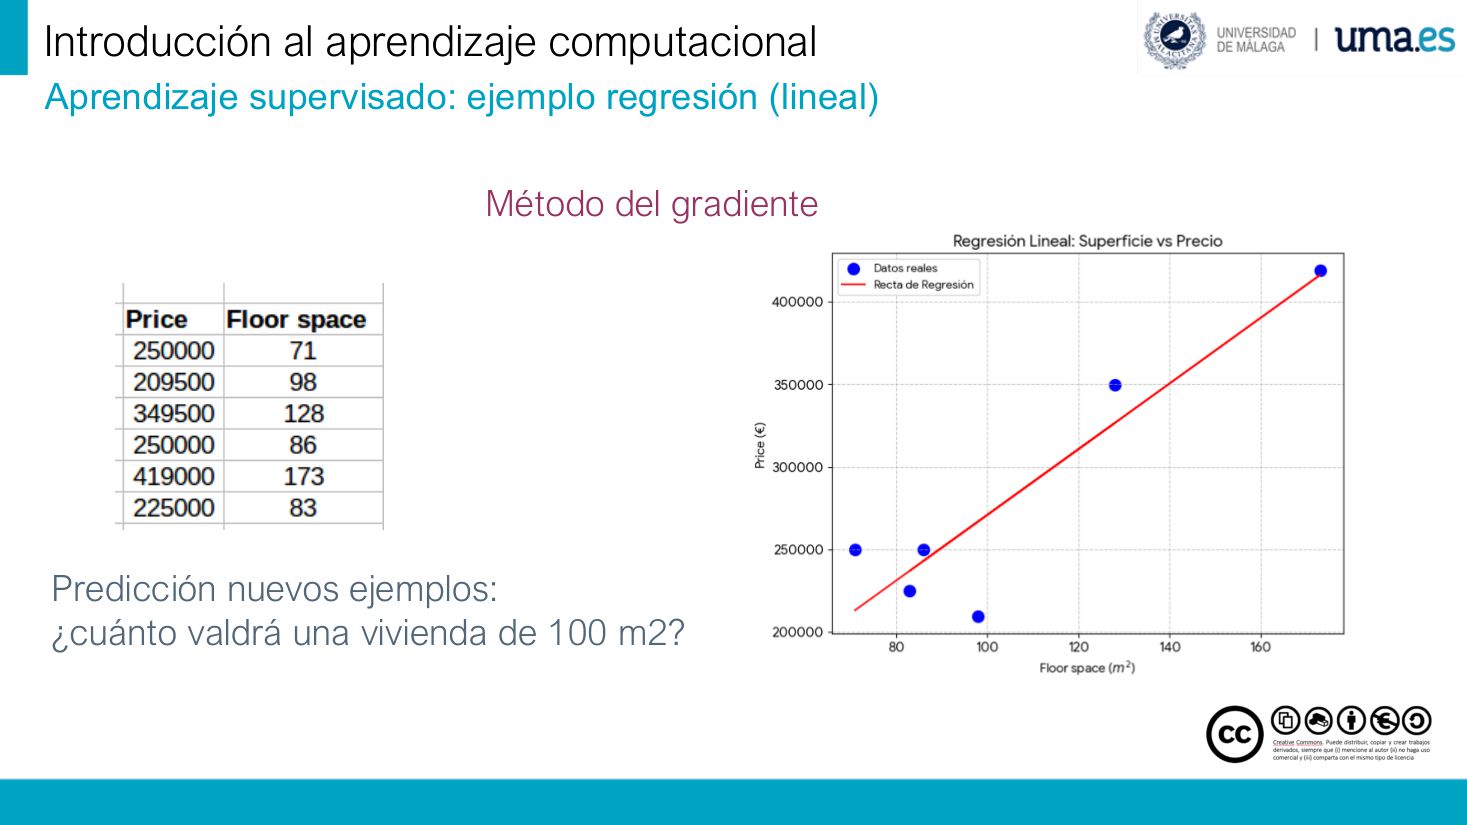
Aprendizaje supervisado: ejemplo regresión (lineal)
监督学习实例:回归(线性)
梯度法(梯度下降)
| Price | Flor space |
|---|---|
| 250000 | 71 |
| 209500 | 98 |
| 349500 | 128 |
| 250000 | 86 |
| 419000 | 173 |
| 225000 | 83 |
Predicción nuevos ejemplos:
预测新样例:
¿cuánto valdrá una vivienda de 100 m2?
一套 100 平方米的房子值多少钱?
Aprender NO ES memorizar · 学习 ≠ 记忆:过拟合 vs 泛化,以及 80 / 10 / 10 数据划分
▸ 原页截图 p.33
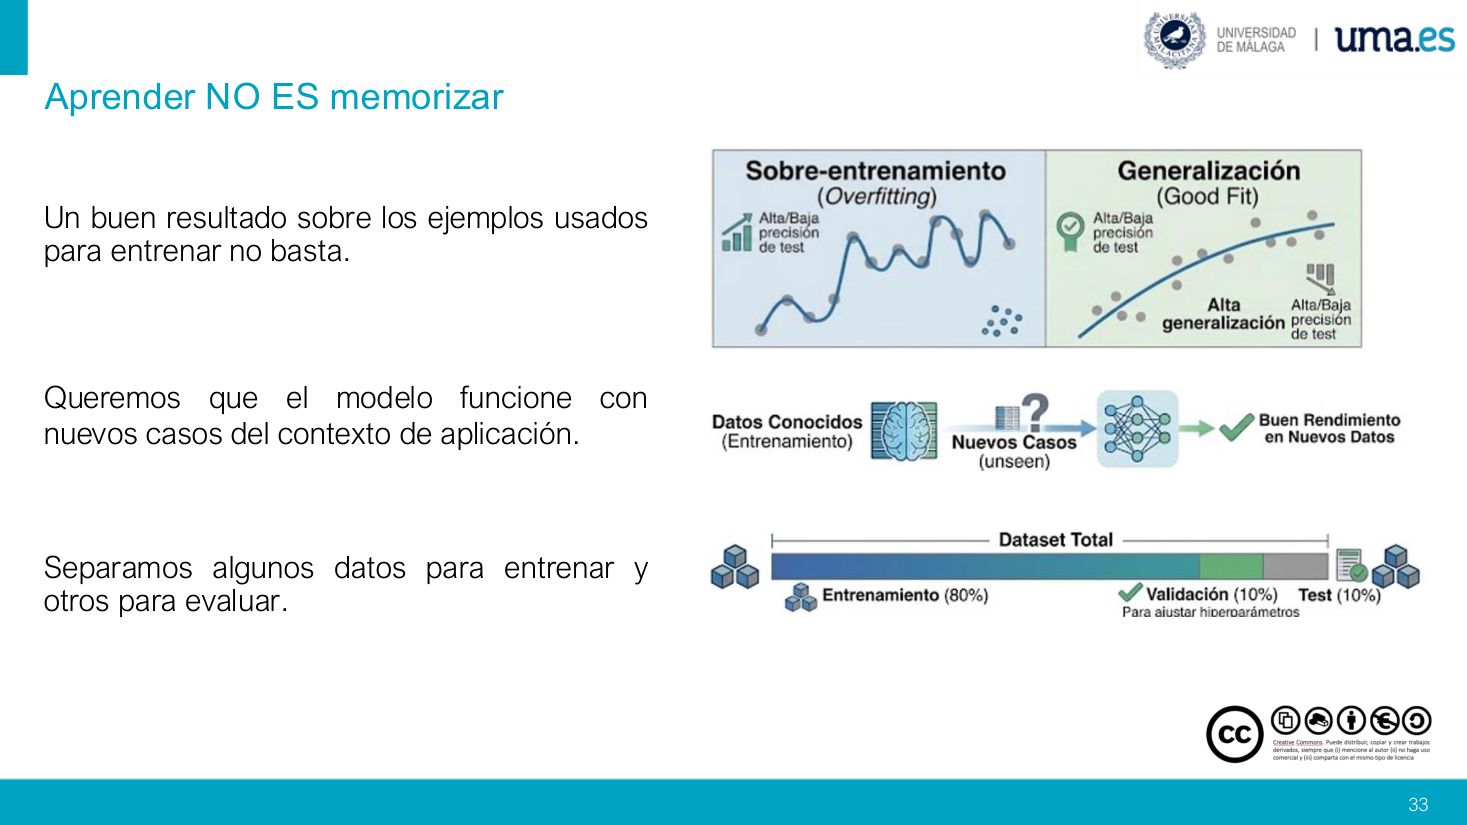
Aprender NO ES memorizar
学习不是记忆
Un buen resultado sobre los ejemplos usados para entrenar no basta.
仅仅在用于训练的样例上取得好结果,是不够的。
Queremos que el modelo funcione con nuevos casos del contexto de aplicación.
我们希望模型在应用场景的新案例上也能正常工作。
Separamos algunos datos para entrenar y otros para evaluar.
我们把一部分数据留出来训练,另一部分用于评估。
| 子集 | 比例 | 作用(原图标注) |
|---|---|---|
| Entrenamiento | 80% | 学参数(拟合模型) |
| Validación | 10% | Para ajustar hiperparámetros(调超参数) |
| Test | 10% | 最终评估(只考一次) |
七、无监督学习与课堂活动
p.34–p.38Aprendizaje no supervisado: algoritmos · 无监督学习的算法清单:聚类(K-Means / 层次)与关联规则(Apriori)
▸ 原页截图 p.34
Aprendizaje no supervisado: algoritmos
无监督学习:算法
Agrupamiento (Clustering)
聚类(Clustering)
El objetivo es dividir los datos en grupos (clusters) donde los miembros de un grupo sean muy parecidos entre sí y muy diferentes a los de otros grupos.
目标是把数据划分成若干组(簇):同一组内的成员彼此非常相似,而与其它组的成员差异很大。
• K-Means: Divide los datos en "K" grupos basándose en la distancia a un
• K-Means:依据到「质心」(中心点)的距离,把数据分成 "K" 个组。
• Agrupamiento Jerárquico: Crea una estructura de árbol (
• 层次聚类:构建一种树状结构(树状图),展示数据在不同细节层级上如何聚成组。
关联规则
Buscan reglas del tipo "si sucede A, entonces suele suceder B".
寻找形如「如果发生 A,那么通常会发生 B」的规则。
• Algoritmo
• Apriori 算法:在购物篮分析中用得非常多(例如「买尿布的人也会买啤酒」)。
Esquema general clustering · 聚类总流程:未标注数据 → 训练 → 生成簇(簇内近、簇间远)
▸ 原页截图 p.35
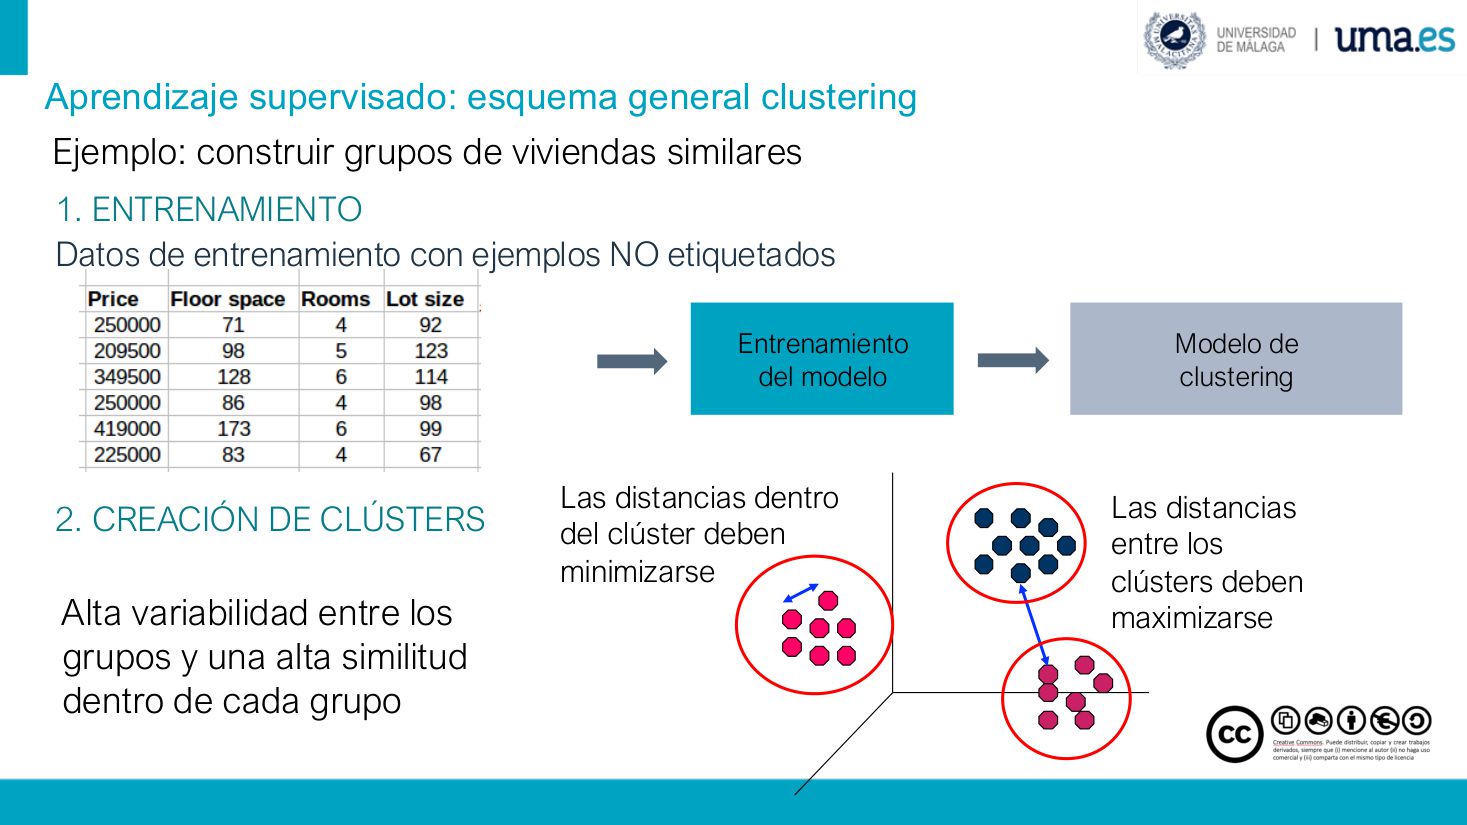
Ejemplo: construir grupos de viviendas similares
例子:把相似的住房聚成组
1. ENTRENAMIENTO
1. 训练阶段
Datos de entrenamiento con ejemplos NO etiquetados
用「未标注」样例构成的训练数据
| Price | Floor space | Rooms | Lot size |
|---|---|---|---|
| 250000 | 71 | 4 | 92 |
| 209500 | 98 | 5 | 123 |
| 349500 | 128 | 6 | 114 |
| 250000 | 86 | 4 | 98 |
| 419000 | 173 | 6 | 99 |
| 225000 | 83 | 4 | 67 |
Entrenamiento del modelo
模型训练
Modelo de clustering
聚类模型
2. CREACIÓN DE CLÚSTERS
2. 生成簇的阶段
Alta variabilidad entre los grupos y una alta similitud dentro de cada grupo
组与组之间差异大,而每个组内部高度相似。
Las distancias dentro del clúster deben minimizarse
簇内部的距离应当被最小化。
Las distancias entre los clústers deben maximizarse
簇与簇之间的距离应当被最大化。
Ejemplo clustering (segmentación clientes) · 聚类实例:用 k-medias 做客户分群(VIP / 偶发 / 高频)
▸ 原页截图 p.36
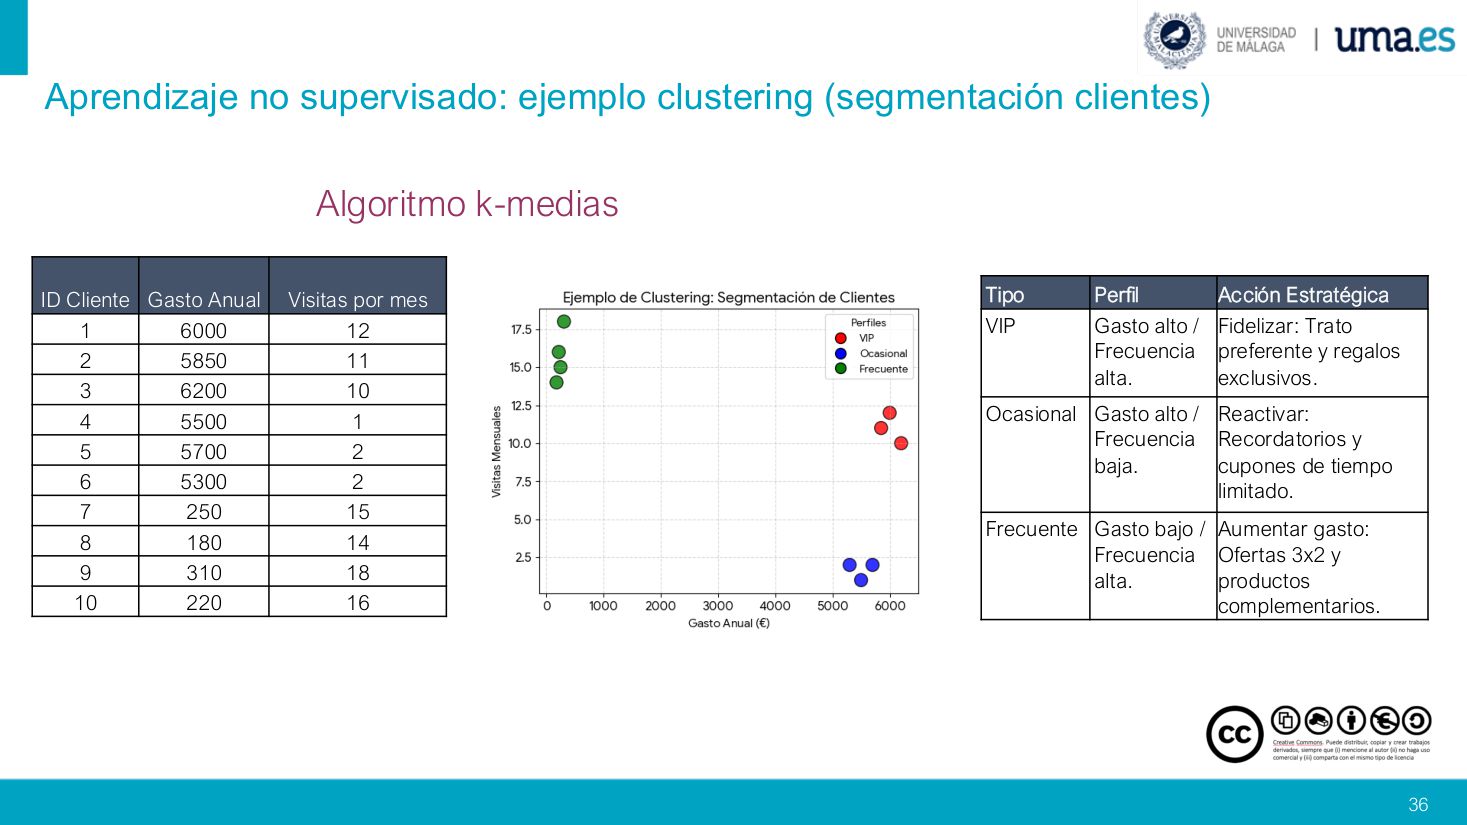
Aprendizaje no supervisado: ejemplo clustering (segmentación clientes)
无监督学习实例:聚类(客户分群)
Algoritmo k-medias
k-均值算法(即 K-Means)
| ID Cliente | Gasto Anual | Visitas por mes |
|---|---|---|
| 1 | 6000 | 12 |
| 2 | 5850 | 11 |
| 3 | 6200 | 10 |
| 4 | 5500 | 1 |
| 5 | 5700 | 2 |
| 6 | 5300 | 2 |
| 7 | 250 | 15 |
| 8 | 180 | 14 |
| 9 | 310 | 18 |
| 10 | 220 | 16 |
| Tipo | Perfil | Acción Estratégica |
|---|---|---|
| VIP | Gasto alto / Frecuencia alta. | Fidelizar: Trato preferente y regalos exclusivos. |
| Ocasional | Gasto alto / Frecuencia baja. | Reactivar: Recordatorios y cupones de tiempo limitado. |
| Frecuente | Gasto bajo / Frecuencia alta. | Aumentar gasto: Ofertas 3x2 y productos complementarios. |
Actividad · 课堂活动:任选一个日常服务/产品,写出 1 个名义属性、1 个连续属性、1 个监督问题、1 个无监督问题
▸ 原页截图 p.37
Introducción al aprendizaje computacional
计算学习导论(页眉标题)
Actividad
课堂活动
Elige un servicio o producto cotidiano y define los siguientes elementos:
选一个日常的服务或产品,并定义下列要素:
• Un atributo discreto nominal: una característica que sea una etiqueta o categoría sin orden intrínseco
• 一个离散名义属性:一种作为标签或类别的特征,本身没有内在顺序。
• Un atributo continuo: una propiedad que se mida numéricamente en un intervalo
• 一个连续属性:一种在某个区间内用数值来度量的性质。
• Problema supervisado: una pregunta cuya respuesta sea una etiqueta o clase o predicción
• 一个监督问题:其答案是标签、类别或预测值的问题。
• Problema no supervisado: una pregunta cuya respuesta sea un agrupamiento o conjunto de reglas de asociación
• 一个无监督问题:其答案是某种分组、或一组关联规则的问题。
Ejemplo solución actividad · 活动参考答案:Netflix 与 Smartwatch 两行示例 + 两行留给你填
▸ 原页截图 p.38
Introducción al aprendizaje computacional
计算学习导论(页眉标题)
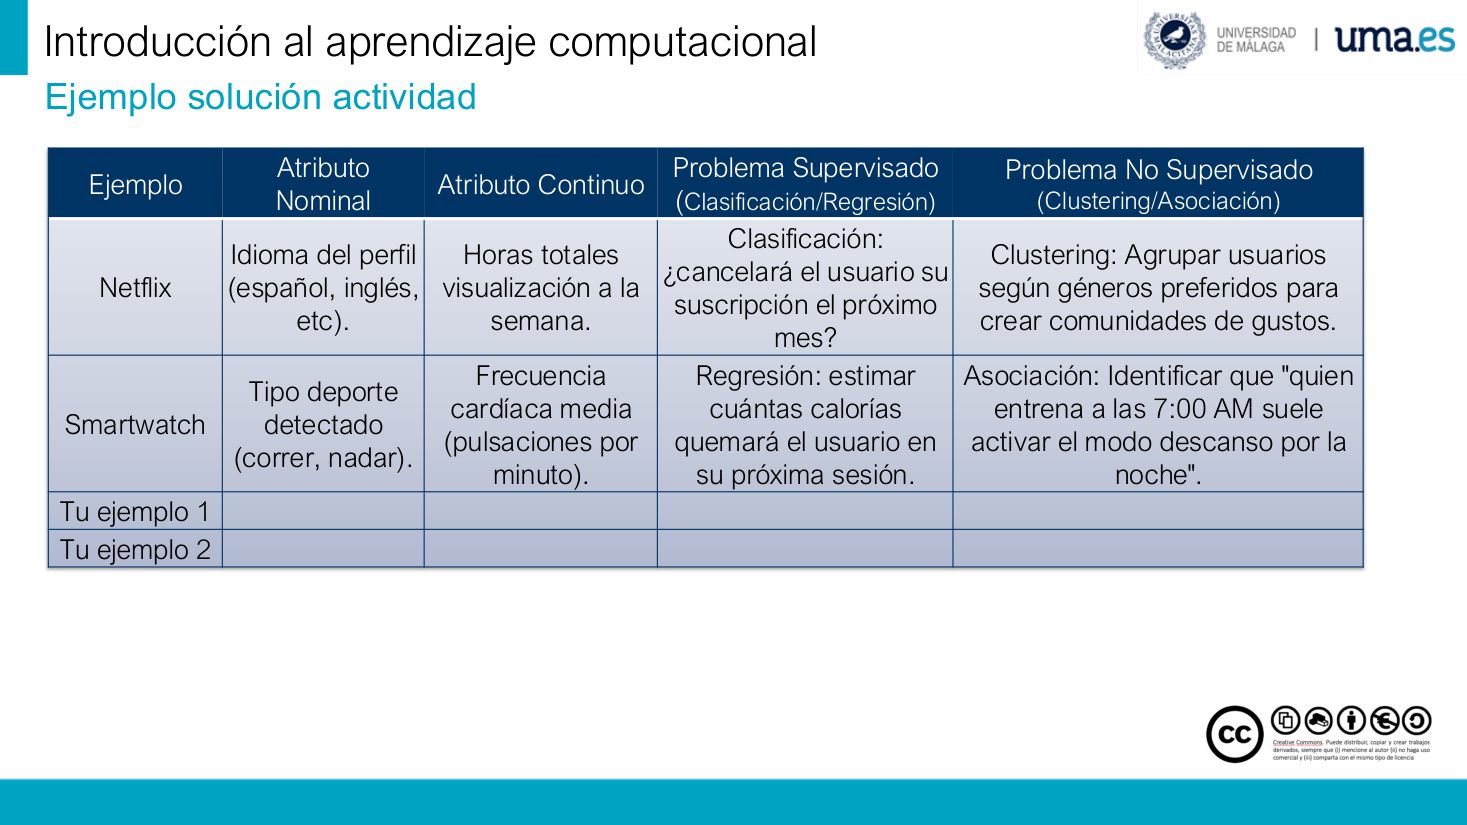
Ejemplo solución actividad
活动参考解答
| Ejemplo | Atributo Nominal | Atributo Continuo | Problema Supervisado (Clasificación/Regresión) | Problema No Supervisado (Clustering/Asociación) |
|---|---|---|---|---|
| Netflix | Idioma del perfil (español, inglés, etc). | Horas totales visualización a la semana. | Clasificación: ¿cancelará el usuario su suscripción el próximo mes? | Clustering: Agrupar usuarios según géneros preferidos para crear comunidades de gustos. |
| Smartwatch | Tipo deporte detectado (correr, nadar). | Frecuencia cardíaca media (pulsaciones por minuto). | Regresión: estimar cuántas calorías quemará el usuario en su próxima sesión. | Asociación: Identificar que "quien entrena a las 7:00 AM suele activar el modo descanso por la noche". |
| Tu ejemplo 1 | ||||
| Tu ejemplo 2 |
A–Z 术语速记表
共 50 条,覆盖全 38 页的高频术语。第三列点页码直接跳回原页;最后一列只写「一句话 + 最容易被扣分的点」,考前扫这一列就够。正文里带虚下划线的西语词,鼠标停上去也会显示中文。
| 西语术语 | 中文 | 页码 | 一句话记住 · 易错点 |
|---|---|---|---|
| A | |||
| algoritmo de aprendizaje | 学习算法 | p.29 | 吃「训练数据」,吐「模型」;不是人手写的 if-else 规则。 |
| aprendizaje computacional | 计算学习(机器学习) | p.1 | 不显式编程,让机器从数据里自己找规律。 |
| aprendizaje no supervisado | 无监督学习 | p.34 | 数据没有标签;目标是找结构:聚类 / 关联。 |
| aprendizaje supervisado | 监督学习 | p.28 | 有标签;学「属性 → 类别 / 数值」的映射。 |
| Apriori | Apriori 算法 | p.34 | 关联规则专用(啤酒 + 尿布);别拿它做分类。 |
| árbol de decisión | 决策树 | p.30 | 内部节点问属性,叶子给类别;要挑「最能区分」的属性来问。 |
| atributo | 属性 | p.17 | 对象的某一维性质 = 表格的一列。 |
| atributo continuo | 连续属性 | p.18 | 区间内任意实数:1.54 kg、12.4 ms、19.99 €。 |
| atributo discreto | 离散属性 | p.18 | 取值分开、可数,没有中间值;二值属性是它的特例。 |
| atributo nominal | 名义属性 | p.18 | 纯类别、无顺序:颜色、国籍;不能比大小。 |
| atributo ordinal | 有序属性 | p.18 | 有顺序但间距不固定:S / M / L / XL、金银铜。 |
| C | |||
| centroide | 质心 | p.34 | 簇的「重心」;K-Means 反复「分配点 + 移动质心」。 |
| clasificación | 分类 | p.28 | 类别变量离散:批不批贷款 → 是 / 否。 |
| clasificador | 分类器 | p.29 | 训练好的模型;输入新样本,输出 Normal / Maliciosa。 |
| clúster | 簇 | p.35 | 组内越像越好、组间越不像越好。 |
| clustering | 聚类 | p.26 | 无标签分组;组名要事后自己命名。 |
| conjunto de datos | 数据集 | p.17 | 对象(行)× 属性(列)组成的一张表。 |
| conjunto de test | 测试集 | p.33 | 只在最后打分用;拿去调参 = 自己给自己泄题。 |
| conjunto de validación | 验证集 | p.33 | 专门调超参数的那 10%;别和测试集混用。 |
| D | |||
| dato | 数据 | p.17 | 单个取值;很多对象 + 属性才构成数据集。 |
| dato etiquetado | 标注数据 | p.17 | 带「正确答案(clase)」的样本;监督学习的前提。 |
| datos de entrenamiento | 训练数据 | p.29 | 第一阶段用来「学」的那批样本。 |
| dendrograma | 树状图 | p.34 | 层次聚类的合并树;横切一刀 = 选定簇数。 |
| descriptivo | 描述型 | p.22 | 不预测新值,只总结现有数据的结构(聚类、关联)。 |
| E | |||
| ejemplo | 样本 / 示例 | p.17 | 和 objeto、instancia、registro 同义:表格一行。 |
| entrenamiento | 训练 | p.29 | 第一阶段:用训练数据拟合模型。 |
| etiqueta | 标签 | p.17 | 样本的正确答案;分类里就是 clase 那一列。 |
| G | |||
| generalización | 泛化 | p.12 | 在没见过的数据上表现好,才叫学会(p.33 再讲一遍)。 |
| gradiente (método del) | 梯度法 | p.32 | 沿误差下降最快的方向挪参数,一步步逼近最优。 |
| I | |||
| inconsistencia | 不一致 | p.8 | 「Pelo」列里冒出「Jersey」——同一信息自相矛盾。 |
| instancia | 实例 | p.17 | 对象的另一个叫法;一行数据。 |
| K | |||
| KDD | 知识发现流程 | p.14 | 五阶段整条流水线;Data Mining 只是其中一环。 |
| K-Means | K 均值聚类 | p.34 | 先定 K,再「分配点 + 移质心」循环;对初值敏感。 |
| M | |||
| minería de datos | 数据挖掘(data mining) | p.14 | KDD 的建模阶段,不是整个 KDD 的同义词。 |
| modelo | 模型 | p.29 | 训练出来的「规律」,用来预测新样本。 |
| modelo de clustering | 聚类模型 | p.35 | 只描述分组结构,不输出标签。 |
| N | |||
| nodo | 节点 | p.30 | 决策树的分叉点,内容是一个属性判断(age? / student?)。 |
| O | |||
| objeto | 对象 | p.17 | 被描述的一个个体 = 表格一行;也叫 registro / ejemplo / instancia。 |
| P | |||
| predicción | 预测 | p.21 | 第二阶段:拿模型给新样本出结果。 |
| predictivo | 预测型 | p.22 | 目标是估计未知值:类别(分类)或数值(回归)。 |
| preprocesamiento | 预处理 | p.8 | 建模前必修:类别转数字、补缺失、查不一致、去噪。 |
| problema de clasificación | 分类问题 | p.28 | 类别变量离散 → 规则 / Naive Bayes / 决策树 / k-NN。 |
| problema de regresión | 回归问题 | p.28 | 类别变量连续 → 线性 / 多项式回归。 |
| R | |||
| regresión | 回归 | p.28 | 输出连续数值:房价、贷款金额。 |
| regresión lineal | 线性回归 | p.32 | 用直线 / 平面拟合;本例只有 6 个点,别过度解读。 |
| S | |||
| segmentación de clientes | 客户分群 | p.36 | 聚类最经典的商业应用:VIP / 常客 / 偶尔。 |
| sobreajuste | 过拟合 | p.11 | 训练集满分、新数据崩盘;模型连噪声都背下来了。 |
| T | |||
| tipo de atributo | 属性类型 | p.18 | 离散(名义 / 有序 / 二值)vs 连续;类型决定能用什么算法。 |
| V | |||
| valor | 取值 | p.17 | 某个对象在某个属性上的具体内容(「Suave」「Dos」)。 |
| variable | 变量 | p.17 | 属性的统计叫法;同一样东西换个名字,别当成新概念。 |
阈值与流程速记卡
这门课没有公式推导,但有几个「数字 + 顺序」是送分点:划分比例、KDD 步数、每类算法个数。背下来,判断题和简答题都能秒答。
| 项目 | 数字 / 顺序 | 一句话口诀 |
|---|---|---|
| 训练 / 验证 / 测试 | 80% / 10% / 10% | 「八一一」;测试集最后才开箱,碰了就不算数(p.33)。 |
| KDD 阶段数 | 5 | 选择 → 清洗 → 变换 → 挖掘 → 解释与使用(p.14)。 |
| 分类算法个数 | 4 | 规则、Naive Bayes、决策树、k-NN(p.28)。 |
| 回归算法个数 | 2 | 线性、多项式;区别只在「直不直」(p.28)。 |
| 无监督两大任务 | 2 | 聚类(K-Means / 层次)+ 关联规则(Apriori)(p.34)。 |
| 属性类型 | 2 大类 / 3 小类 | 离散(名义 / 有序 / 二值特例)+ 连续(p.18)。 |
| 「好知识」四条件 | 4 | 不平凡、隐含在数据里、事先未知、潜在有用(p.15)。 |
| 聚类两条目标 | 2 | 簇内距离最小、簇间距离最大(p.35)。 |
易混对照卡
这 15 组是选择题最爱挖的坑:每组只差一个关键词,抓住那个词就不会翻车。
看有没有标签:有 clase 列 = 监督(p.28);只有属性、没有答案 = 无监督(p.34)。
预测型要「估一个未知值」;描述型只「总结现有结构」。聚类、关联都属描述型(p.22)。
只差类别变量:离散类别 = 分类;连续数值 = 回归。批不批贷款 vs 批多少(p.28)。
分类有标签、类别事先已知;聚类无标签、组名事后才起。中文都带「类」,西语完全不同(p.28 / p.34)。
名义无顺序(颜色),有序有等级(S/M/L)。有序能比大小,名义不能(p.18)。
离散可数、有「下一个值」;连续在区间内取任意实数,没有中间空档(p.18)。
属性 = 列(性质),对象 = 行(个体)。问「有几个属性」别数行(p.17)。
dato 是「对象 + 属性」的集合性说法;valor 是某一格的具体内容(p.17)。
KDD 是五阶段整条流水线;Data Mining 只是中间「挖掘」这一步(p.14)。
缺失 = 格子是空的(画了「-」);不一致 = 格子有值但放错列(Pelo 列写 Jersey)(p.8)。
ruido = 个别离谱值(Vista (G));sesgo = 数据整体不均衡,模型学到偏见(p.8 / p.11)。
过拟合 = 训练集完美、新数据崩;泛化 = 新数据也稳。二者是反义(p.11 / p.33)。
训练学参数、验证调超参数、测试只打分。顺序不能倒,测试集不能反复看(p.33)。
K-Means 要先给 K、靠质心迭代;层次聚类给一棵 dendrograma,切哪里由你定(p.34)。
关联规则说「买 A 常买 B」,不预测类别;分类规则才输出 clase(p.28 / p.34)。