- 一页一块:页码 = PDF 物理页序,和老师发的 PDF 完全对齐;点顶部页码可直接跳转。
- 先看图再读句:每块顶部折叠着原页截图,图卡住了就展开对一眼,不用来回翻 PDF。
- 三色提示框:绿=考点(这页怎么考)、红=陷阱(易错 / 原文笔误)、紫=记忆钩子(一句背下来)。
- 考前只扫两处:每页的绿框 + 文末「A–Z 术语速记表」最后一列。
- 术语悬停:正文中带虚下划线的西语词,鼠标停上去即显示中文。
- 逐句口径:每页正文、项目符号、表格标题与图注均逐句对照;每页重复的页眉标题与页脚数字不重复列句,已由页块标题承载。
一、EDA 是什么 · 数据质量审计
p.1–p.4Tema 4: Análisis exploratorio de datos · 第 4 讲:探索性数据分析(封面)
▸ 原页截图 p.1
Tema 4: Análisis exploratorio de datos
第 4 讲:探索性数据分析
Eva Millán
Eva Millán(授课教师)
Departamento de Lenguajes y Ciencias de la Computación
语言与计算机科学系
Índice · 目录
▸ 原页截图 p.2
Análisis exploratorio de datos
探索性数据分析
Introducción al
探索性数据分析导论
Análisis univariante de variables cuantitativas
定量变量的单变量分析
Análisis univariante de variables categóricas
分类变量的单变量分析
Análisis bivariante de variables cuantitativas
定量变量的双变量分析
Índice
目录
¿Qué es el análisis exploratorio de datos? · 什么是探索性数据分析
▸ 原页截图 p.3
El análisis exploratorio de datos (Exploratory Data Analysis, EDA) es un proceso que combina resúmenes numéricos, visualizaciones y comprobaciones de calidad para comprender un conjunto de datos, identificar patrones y detectar posibles problemas que orienten el análisis posterior..
探索性数据分析(Exploratory Data Analysis,EDA)是一个把数值摘要、可视化与质量检查结合起来的过程,用来理解一个数据集、识别模式,并发现可能存在的问题,从而为后续分析指明方向。。
Filosofía EDA: Explorar los datos, sin dar por supuesta una estructura o distribución determinada, antes de transformarlos y analizarlos.
EDA 的理念:在转换和分析数据之前先探索数据,不预设某种结构或分布。
Objetivos principales:
主要目标:
Describir las distribuciones de las variables y explorar sus relaciones.
描述各变量的分布,并探索它们之间的关系。
Detectar posibles problemas de calidad, como
发现可能的质量问题,例如缺失值、不一致性和异常值(outliers)。
Valorar el cumplimiento de supuestos relevantes para los métodos que se utilizarán.
评估将要使用的方法所依赖的相关假设是否成立。
Orientar las decisiones posteriores de preprocesamiento y análisis.
为后续的预处理与分析决策提供依据。
Auditoría de la calidad de los datos · 数据质量审计
▸ 原页截图 p.4
Estructura y significado de los datos
数据的结构与含义
Variables o atributos: significado, unidades de medida cuando corresponda, tipos (discreta, continua, nominal, ordinal) y tipo de almacenamiento (entero, decimal, texto, fecha, etc.)
变量或属性:含义、在适用情况下的计量单位、类型(离散型、连续型、名义型、有序型)以及存储类型(整数、小数、文本、日期等)。
Dimensión (número de registros y variables)
维度(记录数与变量数)
Identificadores: campos que permiten identificar cada observación.
标识符:能够唯一识别每条观测的字段。
Comprobaciones de calidad
质量检查
Valores ausentes: cantidad y porcentaje por variable y por observación.
缺失值:按变量和按观测统计的数量与百分比。
Duplicados: registros repetidos según la unidad de observación.
重复值:按观测单位判断的重复记录。
Cardinalidad: número de valores distintos por variable.
基数:每个变量不同取值的个数。
Valores inválidos: datos fuera de los rangos o categorías permitidos.
无效值:超出允许范围或允许类别的数据。
Inconsistencias: formatos, unidades o etiquetas diferentes para un mismo significado.
不一致性:同一含义却使用不同格式、单位或标签。
Coherencia entre variables: cumplimiento de relaciones lógicas (ej fecha de finalización posterior a la de inicio).
变量间一致性:是否满足逻辑关系(例如结束日期应晚于开始日期)。
二、单变量定量:数值计算与异常值
p.5–p.10Análisis univariante variables cuantitativas · 定量变量的单变量分析(总览)
▸ 原页截图 p.5
Examina una variable cuantitativa para describir su distribución e identificar posibles valores atípicos.
考察单个定量变量,以描述其分布并识别可能的异常值。
Medidas numéricas
数值度量
Tendencia central: media y
集中趋势:均值与中位数。
Dispersión:
离散程度:标准差与四分位距。
Forma: coeficiente de
形状:偏度系数。
Herramientas gráficas
图形工具
Histograma: permite observar la forma de la distribución, su concentración y la presencia de varios picos.
直方图:可以观察分布的形状、集中程度以及是否存在多个峰。
Diagrama de cajas y bigotes: resume la mediana y los cuartiles y señala posibles valores atípicos.
箱线图:概括中位数和四分位数,并标出可能的异常值。
Medidas numéricas análisis univariante variables cuantitativas · 定量单变量的数值度量
▸ 原页截图 p.6(公式页,默认展开)
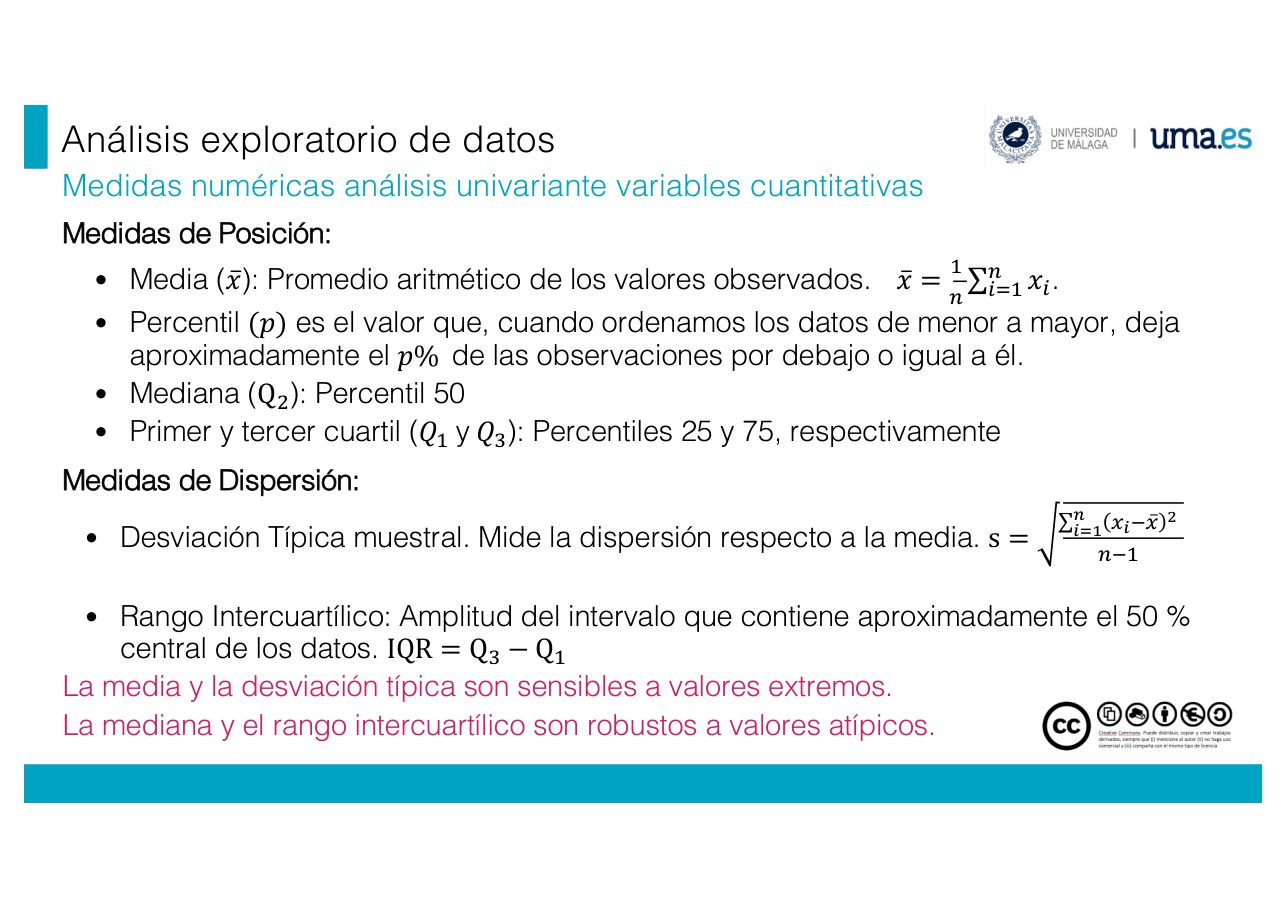
Medidas de Posición:
位置度量:
Media (\(\bar{x}\)): Promedio aritmético de los valores observados. \(\bar{x} = \frac{1}{n}\sum_{i=1}^{n} x_i\).
均值(\(\bar{x}\)):所有观测值的算术平均。\(\bar{x} = \frac{1}{n}\sum_{i=1}^{n} x_i\)。
Percentil (\(p\)) es el valor que, cuando ordenamos los datos de menor a mayor, deja aproximadamente el \(p\%\) de las observaciones por debajo o igual a él.
百分位数(\(p\)):把数据从小到大排序后,约有 \(p\%\) 的观测值小于或等于该值。
Mediana (\(Q_2\)): Percentil 50
中位数(\(Q_2\)):第 50 百分位数。
Primer y tercer
第一与第三四分位数(\(Q_1\) 与 \(Q_3\)):分别为第 25 和第 75 百分位数。
Medidas de Dispersión:
离散度量:
Desviación Típica muestral. Mide la dispersión respecto a la media. \(s = \sqrt{\frac{\sum_{i=1}^{n}(x_i-\bar{x})^2}{n-1}}\)
样本标准差:衡量数据相对于均值的离散程度。\(s = \sqrt{\frac{\sum_{i=1}^{n}(x_i-\bar{x})^2}{n-1}}\)
Rango Intercuartílico: Amplitud del intervalo que contiene aproximadamente el 50 % central de los datos. \(IQR = Q_3 - Q_1\)
四分位距:包含约 50% 中间数据的区间宽度。\(IQR = Q_3 - Q_1\)
La media y la desviación típica son sensibles a valores extremos.
均值与标准差对极端值敏感。
La mediana y el rango intercuartílico son robustos a valores atípicos.
中位数与四分位距对异常值具有稳健性。
| 符号 | 西语读法 | 中文含义 |
|---|---|---|
| \(\bar{x}\) | media muestral | 样本均值 |
| \(n\) | 样本量 | |
| \(Q_1, Q_2, Q_3\) | primer / segundo / tercer cuartil | 第一 / 第二 / 第三四分位数 |
| \(s\) | desviación típica muestral | 样本标准差(分母 \(n-1\)) |
| \(IQR\) | rango intercuartílico | 四分位距 \(Q_3-Q_1\) |
Ejemplo: medidas numéricas · 例题:数值度量(RTT)
▸ 原页截图 p.7
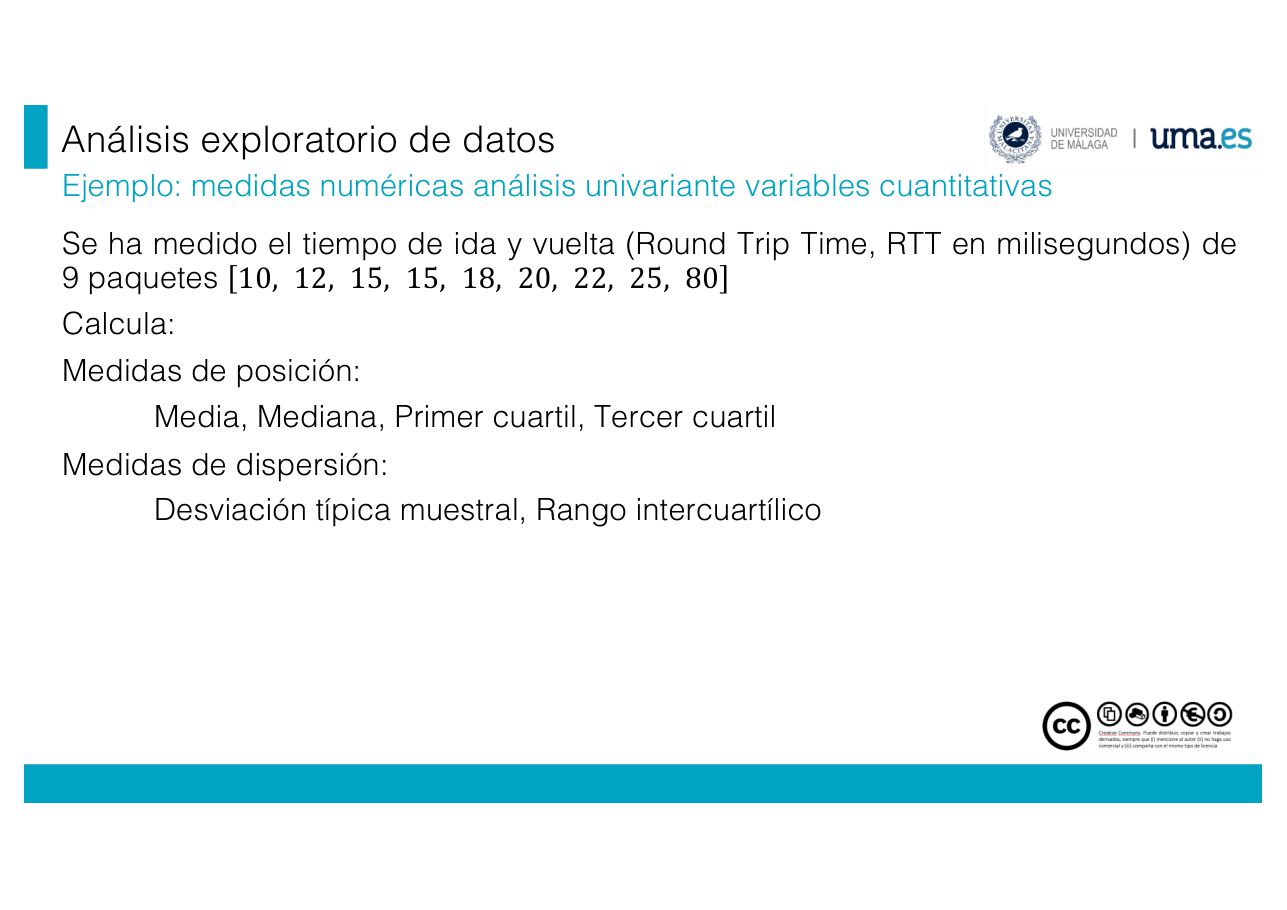
Se ha medido el tiempo de ida y vuelta (Round Trip Time, RTT en milisegundos) de 9 paquetes 10, 12, 15, 15, 18, 20, 22, 25, 80
已测量 9 个数据包的往返时延(Round Trip Time,RTT,单位毫秒):10、12、15、15、18、20、22、25、80。
Calcula:
计算:
Medidas de posición:
位置度量:
Media, Mediana, Primer cuartil, Tercer cuartil
均值、中位数、第一四分位数、第三四分位数。
Medidas de dispersión:
离散度量:
Desviación típica muestral, Rango intercuartílico
样本标准差、四分位距。
| 统计量 | 计算过程 | 结果 |
|---|---|---|
| 均值 \(\bar{x}\) | 217 / 9 | 24,11 ms |
| 中位数 \(Q_2\) | 排序后第 5 个 = 18 | 18 ms |
| \(Q_1\) | (12 + 15) / 2 | 13,5 ms |
| \(Q_3\) | (22 + 25) / 2 | 23,5 ms |
| \(IQR\) | 23,5 − 13,5 | 10 ms |
| 标准差 \(s\) | \(\sqrt{3694{,}89/8}\) | 21,49 ms |
Medidas de Forma y detección de valores atípicos · 形状度量与异常值检测(Fisher 偏度)
▸ 原页截图 p.8(公式页,默认展开)
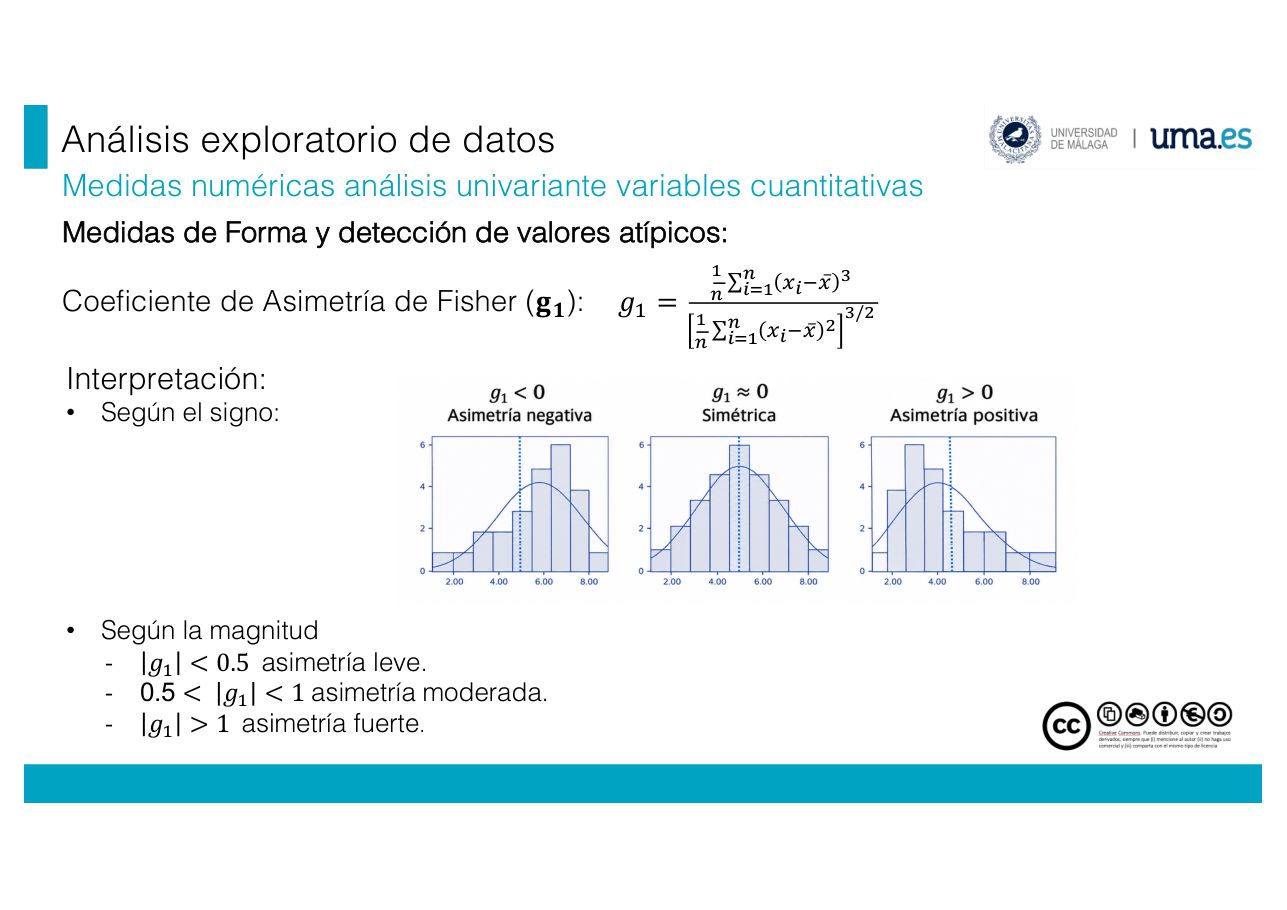
Coeficiente de Asimetría de Fisher (\(\mathbf{g_1}\)):
Fisher 偏度系数(\(\mathbf{g_1}\)):
\[ g_1 = \frac{\frac{1}{n}\sum_{i=1}^{n}(x_i-\bar{x})^3}{\left[\frac{1}{n}\sum_{i=1}^{n}(x_i-\bar{x})^2\right]^{3/2}} \]
\[ g_1 = \frac{\frac{1}{n}\sum_{i=1}^{n}(x_i-\bar{x})^3}{\left[\frac{1}{n}\sum_{i=1}^{n}(x_i-\bar{x})^2\right]^{3/2}} \](三阶中心矩除以二阶中心矩的 3/2 次方)
Interpretación:
解释:
Según el signo:
按符号判断:
\(g_1 < 0\) Asimetría negativa
\(g_1 < 0\):负偏(左偏),长尾在左。
\(g_1 \approx 0\) Simétrica
\(g_1 \approx 0\):对称分布。
\(g_1 > 0\) Asimetría positiva
\(g_1 > 0\):正偏(右偏),长尾在右。
Según la magnitud
按绝对值大小判断:
\(|g_1| < 0.5\) asimetría leve.
\(|g_1| < 0.5\):轻度偏斜。
\(0.5 < |g_1| < 1\) asimetría moderada.
\(0.5 < |g_1| < 1\):中度偏斜。
\(|g_1| > 1\) asimetría fuerte.
\(|g_1| > 1\):强烈偏斜。
| 符号 | 西语读法 | 中文含义 |
|---|---|---|
| \(g_1\) | Fisher 偏度系数 | |
| \(x_i-\bar{x}\) | desviación respecto a la media | 相对均值的离差 |
| \(n\) | tamaño de la muestra | 样本量(此公式按 \(1/n\) 计) |
Criterio del Rango Intercuartílico (Regla de Tukey) · 四分位距准则(Tukey 法则)
▸ 原页截图 p.9(公式页,默认展开)
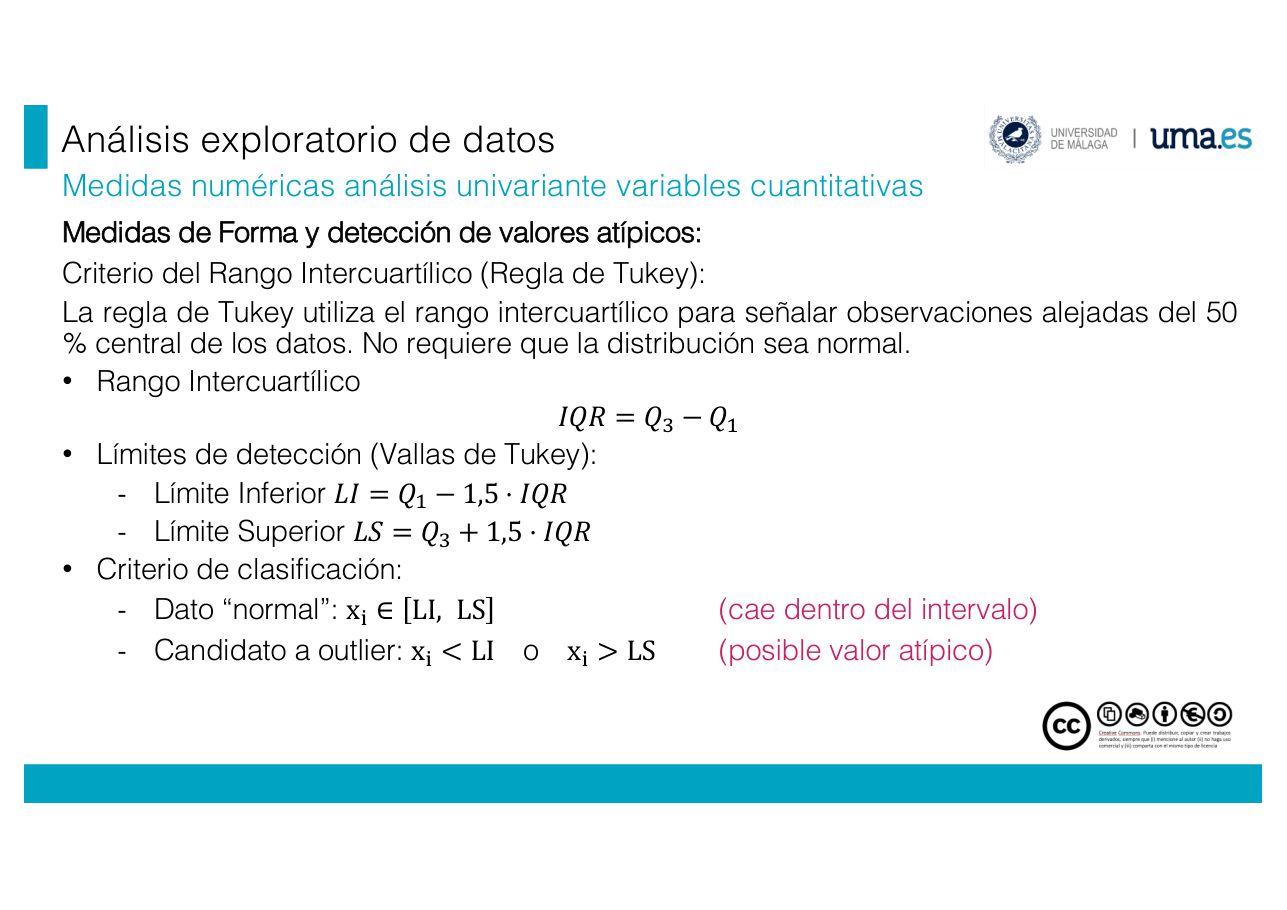
La
Tukey 法则利用四分位距来标记远离数据中间 50% 的观测。它不要求分布服从正态。
Rango Intercuartílico \(IQR = Q_3 - Q_1\)
四分位距 \(IQR = Q_3 - Q_1\)。
Límites de detección (Vallas de Tukey):
检测界限(Tukey 围栏):
Límite Inferior \(LI = Q_1 - 1{,}5 \cdot IQR\)
下界 \(LI = Q_1 - 1{,}5 \cdot IQR\)。
Límite Superior \(LS = Q_3 + 1{,}5 \cdot IQR\)
上界 \(LS = Q_3 + 1{,}5 \cdot IQR\)。
Criterio de clasificación:
分类判据:
Dato “normal”: \(x_i \in [LI, LS]\) (cae dentro del intervalo)
“正常”数据:\(x_i \in [LI, LS]\)(落在区间内)。
Candidato a outlier: \(x_i < LI\) o \(x_i > LS\) (posible
异常值候选:\(x_i < LI\) 或 \(x_i > LS\)(可能的异常值)。
| 符号 | 西语读法 | 中文含义 |
|---|---|---|
| \(IQR\) | rango intercuartílico | 四分位距 \(Q_3-Q_1\) |
| \(LI\) | límite inferior | 下界(valla inferior) |
| \(LS\) | límite superior | 上界(valla superior) |
| \(1{,}5\) | uno coma cinco | Tukey 的 1.5 倍系数 |
Ejemplo: medidas numéricas · 例题:偏度与异常值检测(RTT)
▸ 原页截图 p.10
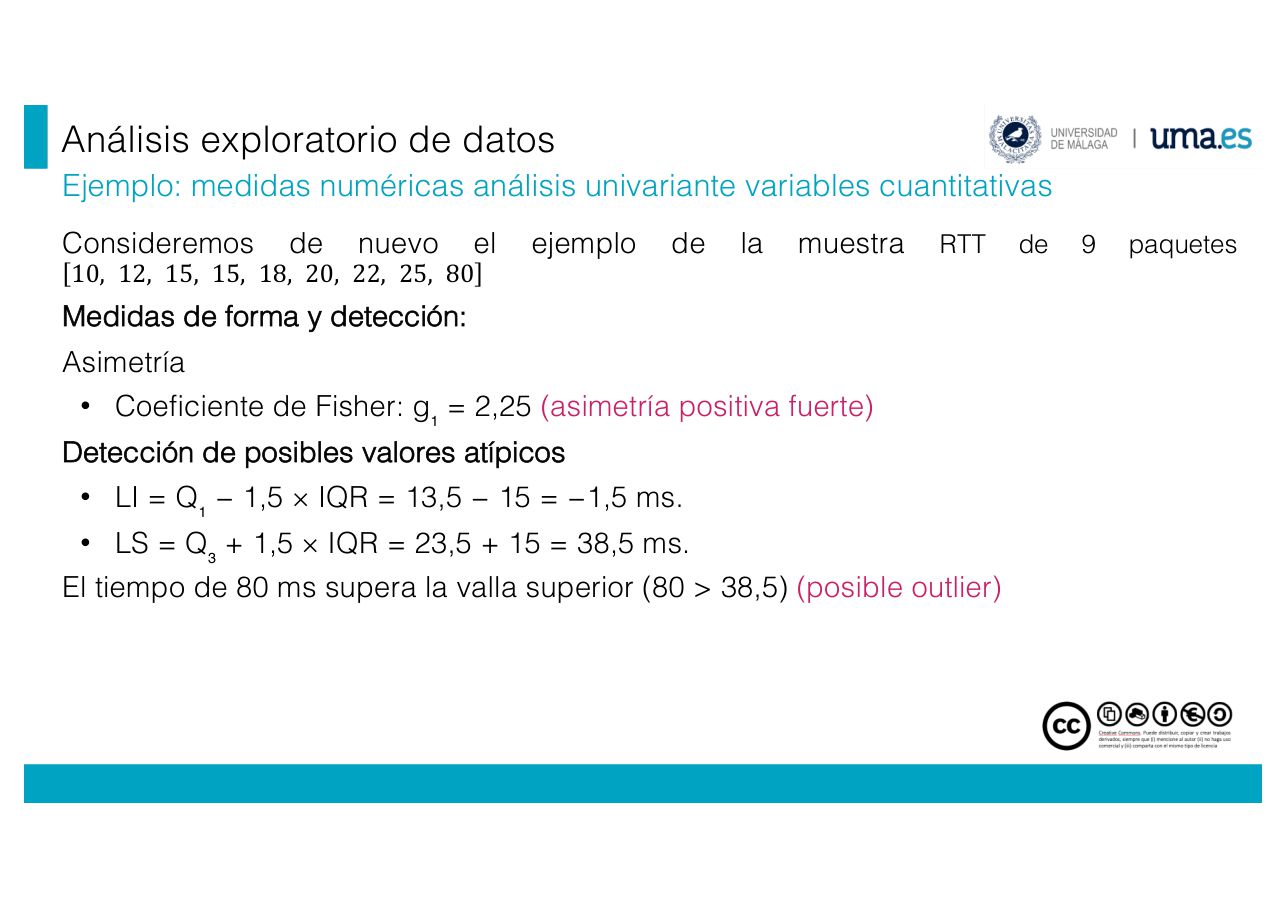
Consideremos de nuevo el ejemplo de la muestra RTT de 9 paquetes 10, 12, 15, 15, 18, 20, 22, 25, 80
再次考虑 9 个数据包 RTT 样本的例子:10、12、15、15、18、20、22、25、80。
Medidas de forma y detección:
形状度量与检测:
Asimetría
偏度
Coeficiente de Fisher: \(g_1 = 2{,}25\) (asimetría positiva fuerte)
Fisher 系数:\(g_1 = 2{,}25\)(强正偏)。
Detección de posibles valores atípicos
可能异常值的检测
\(LI = Q_1 - 1{,}5 \times IQR = 13{,}5 - 15 = -1{,}5\) ms.
\(LI = Q_1 - 1{,}5 \times IQR = 13{,}5 - 15 = -1{,}5\) ms。
\(LS = Q_3 + 1{,}5 \times IQR = 23{,}5 + 15 = 38{,}5\) ms.
\(LS = Q_3 + 1{,}5 \times IQR = 23{,}5 + 15 = 38{,}5\) ms。
El tiempo de 80 ms supera la valla superior (80 > 38,5) (posible outlier)
80 ms 这一取值超过上界(80 > 38,5),是可能的异常值。
| 步骤 | 计算 | 结果 |
|---|---|---|
| \(Q_1\) | (12+15)/2 | 13,5 |
| \(Q_3\) | (22+25)/2 | 23,5 |
| \(IQR\) | 23,5 − 13,5 | 10 |
| \(LI\) | 13,5 − 1,5 × 10 | −1,5 |
| \(LS\) | 23,5 + 1,5 × 10 | 38,5 |
| 判定 80 | 80 > 38,5 | outlier ✓ |
三、单变量定量:图形工具
p.11–p.13Herramientas gráficas · 图形工具(直方图与箱线图)
▸ 原页截图 p.11
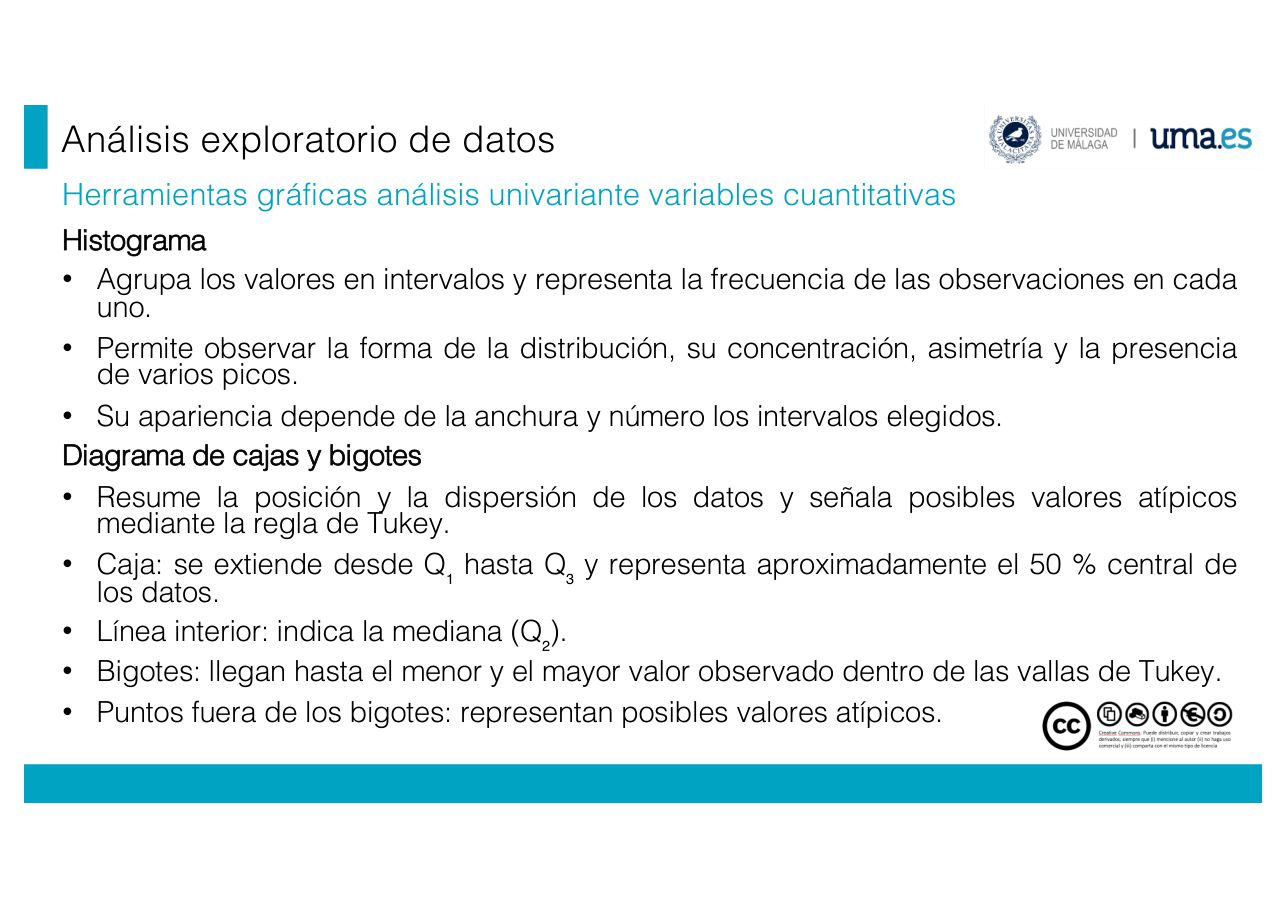
Histograma
直方图
Agrupa los valores en intervalos y representa la frecuencia de las observaciones en cada uno.
把取值按区间分组,表示每个区间内观测的频数。
Permite observar la forma de la distribución, su concentración, asimetría y la presencia de varios picos.
可以观察分布的形状、集中程度、偏斜情况以及是否存在多个峰。
Su apariencia depende de la anchura y número los intervalos elegidos.
它的外观取决于所选区间的宽度和数量。
Diagrama de cajas y bigotes
箱线图(箱须图)
Resume la posición y la dispersión de los datos y señala posibles valores atípicos mediante la regla de Tukey.
概括数据的位置与离散程度,并用 Tukey 法则标出可能的异常值。
Caja: se extiende desde \(Q_1\) hasta \(Q_3\) y representa aproximadamente el 50 % central de los datos.
箱体:从 \(Q_1\) 延伸到 \(Q_3\),代表约 50% 的中间数据。
Línea interior: indica la mediana (\(Q_2\)).
箱内线:表示中位数(\(Q_2\))。
Bigotes: llegan hasta el menor y el mayor valor observado dentro de las
须:延伸到 Tukey 围栏内最小和最大的观测值。
Puntos fuera de los bigotes: representan posibles valores atípicos.
须外的点:代表可能的异常值。
Ejemplo: herramientas gráficas · 例题:直方图(RTT)
▸ 原页截图 p.12(图示页,默认展开)
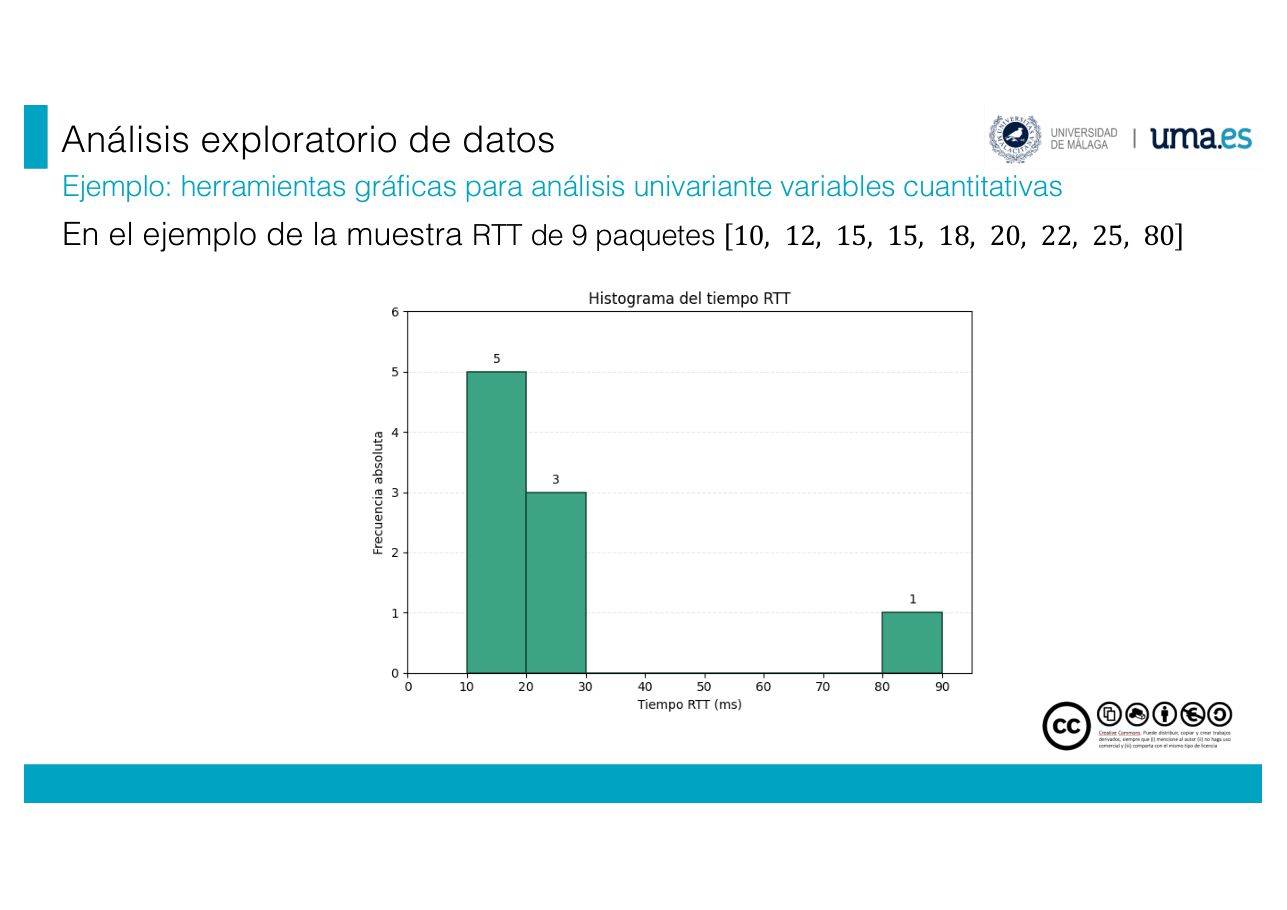
En el ejemplo de la muestra RTT de 9 paquetes 10, 12, 15, 15, 18, 20, 22, 25, 80
在 9 个数据包 RTT 样本的例子中:10、12、15、15、18、20、22、25、80。
Ejemplo: herramientas gráficas para análisis univariante · 例题:RTT 样本的箱线图与统计量表
▸ 原页截图 p.13(图示页,默认展开)
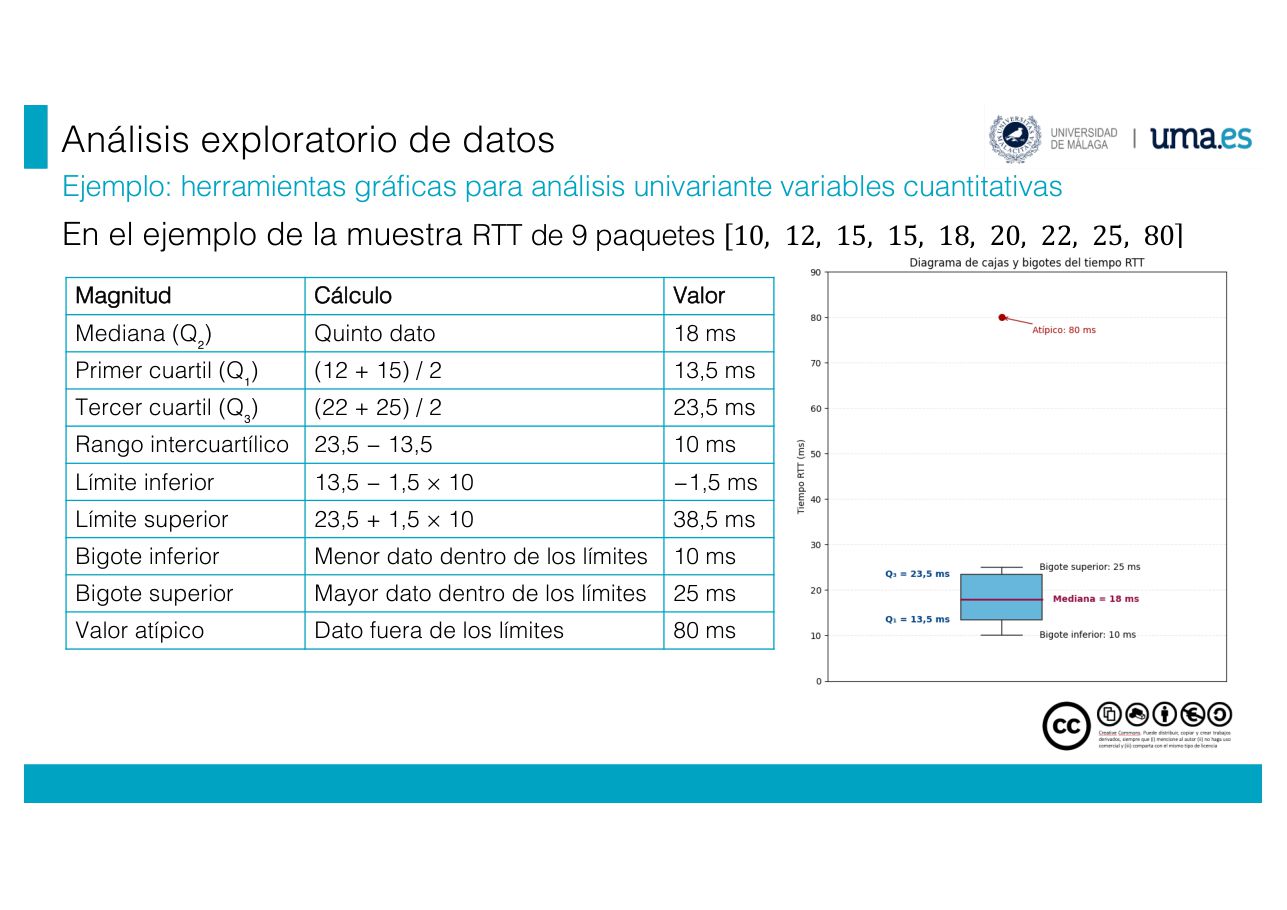
En el ejemplo de la muestra RTT de 9 paquetes 10, 12, 15, 15, 18, 20, 22, 25, 80
以 9 个数据包的 RTT 样本为例:10、12、15、15、18、20、22、25、80。
| 量(Magnitud) | 计算(Cálculo) | 值(Valor) |
|---|---|---|
| Mediana (Q₂)(中位数) | Quinto dato(第 5 个数据) | 18 ms |
| Primer cuartil (Q₁)(第一四分位) | (12 + 15) / 2 | 13,5 ms |
| Tercer cuartil (Q₃)(第三四分位) | (22 + 25) / 2 | 23,5 ms |
| Rango intercuartílico(四分位距) | 23,5 − 13,5 | 10 ms |
| Límite inferior(下限) | 13,5 − 1,5 × 10 | −1,5 ms |
| Límite superior(上限) | 23,5 + 1,5 × 10 | 38,5 ms |
| Bigote inferior(下须) | Menor dato dentro de los límites(围栏内最小值) | 10 ms |
| Bigote superior(上须) | Mayor dato dentro de los límites(围栏内最大值) | 25 ms |
| Valor atípico(异常值) | Dato fuera de los límites(围栏外的数据) | 80 ms |
四、单变量分类:频率、失衡与条形图
p.14–p.19Métricas para el análisis univariante variables categóricas · 分类变量的单变量分析:频率度量
▸ 原页截图 p.14(公式页,默认展开)
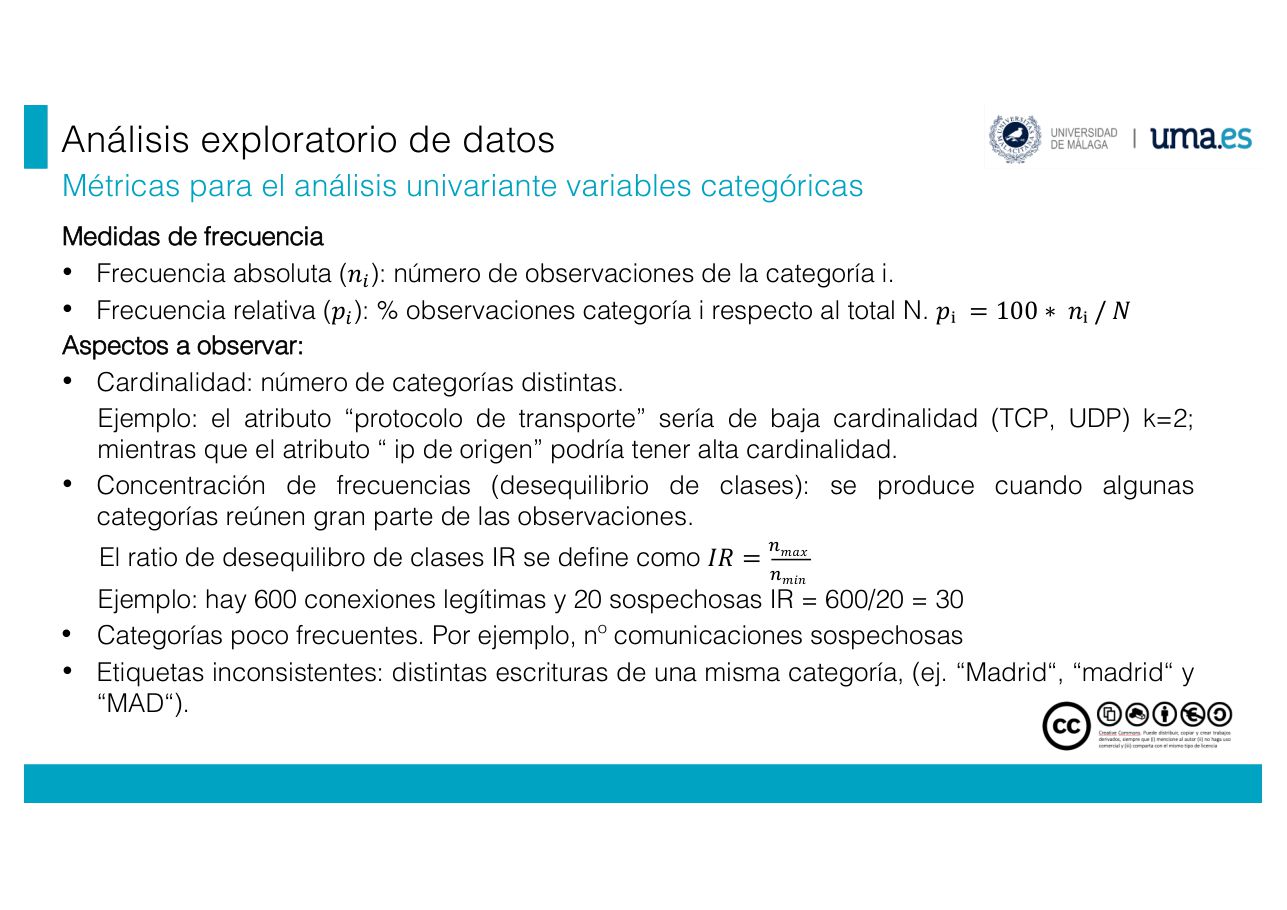
Medidas de frecuencia
频率度量
Frecuencia absoluta (\(n_i\)): número de observaciones de la categoría i.
绝对频数(\(n_i\)):类别 i 的观测个数。
Frecuencia relativa (\(p_i\)): % observaciones categoría i respecto al total N. \(p_i = 100 * n_i / N\)
相对频率(\(p_i\)):类别 i 的观测占总数 N 的百分比,\(p_i = 100 \times n_i / N\)。
| 符号 | 西语读法 | 中文 |
|---|---|---|
| \(n_i\) | 类别 i 的绝对频数(个数) | |
| \(p_i\) | 类别 i 的相对频率(%) | |
| \(N\) | total de observaciones | 观测总数 |
| \(IR\) | ratio de | 类别失衡比 |
| \(n_{\max},\,n_{\min}\) | frecuencia máxima / mínima | 最大 / 最小类别频数 |
Aspectos a observar:
需要观察的方面:
Cardinalidad: número de categorías distintas.
基数:不同类别的个数。
Ejemplo: el
例如:属性「传输协议」属于低基数(TCP、UDP),k=2;而属性「源 IP」可能是高基数。
Concentración de frecuencias (desequilibrio de clases): se produce cuando algunas categorías reúnen gran parte de las observaciones.
频率集中(类别失衡):某些类别汇集了大部分观测时出现。
El ratio de desequilibrio de clases IR se define como \(IR = n_{\max} / n_{\min}\)
类别失衡比 IR 定义为 \(IR = n_{\max} / n_{\min}\)。
Ejemplo: hay 600 conexiones legítimas y 20 sospechosas IR = 600/20 = 30
例如:有 600 个合法连接和 20 个可疑连接,IR = 600/20 = 30。
Categorías poco frecuentes. Por ejemplo, nº comunicaciones sospechosas
低频类别。例如:可疑通信的数量。
Etiquetas inconsistentes: distintas escrituras de una misma categoría, (ej. “Madrid”, “madrid” y “MAD”).
标签不一致:同一类别的不同写法(例如 “Madrid”、“madrid” 和 “MAD”)。
Análisis univariante de variables categóricas: ejemplo · 例题:500 个银行联系渠道的原始频数表
▸ 原页截图 p.15(表格页,默认展开)
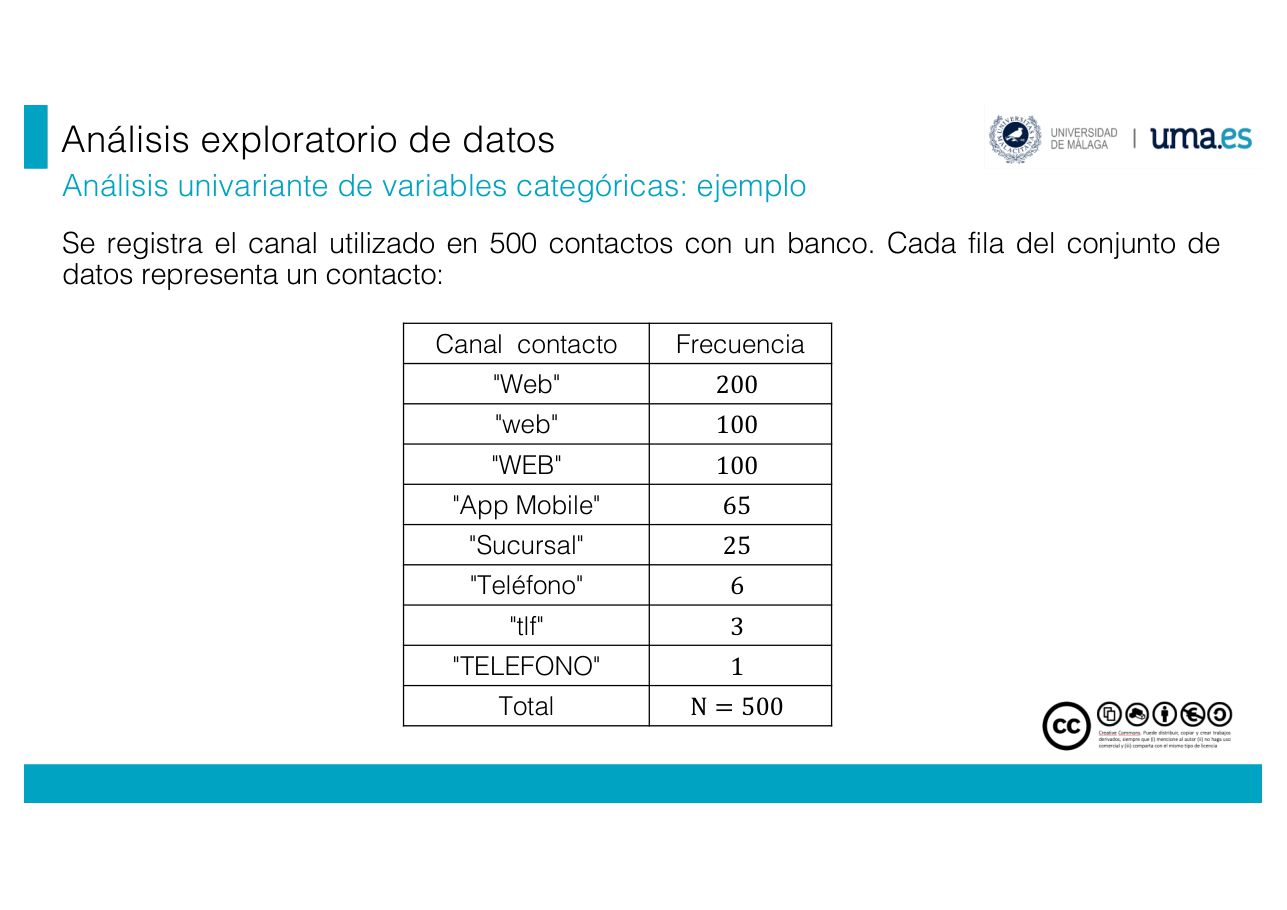
Se registra el canal utilizado en 500 contactos con un banco. Cada fila del conjunto de datos representa un contacto:
记录了与银行 500 次联系所使用的渠道。数据集的每一行代表一次联系:
| Canal(渠道) | Frecuencia(频数) |
|---|---|
| "Web" | 200 |
| "web" | 100 |
| "WEB" | 100 |
| "App Mobile" | 65 |
| "Sucursal" | 25 |
| "Teléfono" | 6 |
| "tlf" | 3 |
| "TELEFONO" | 1 |
| Total | N = 500 |
Métricas de frecuencia · 频率度量:标签统一后的频数表
▸ 原页截图 p.16(表格页,默认展开)
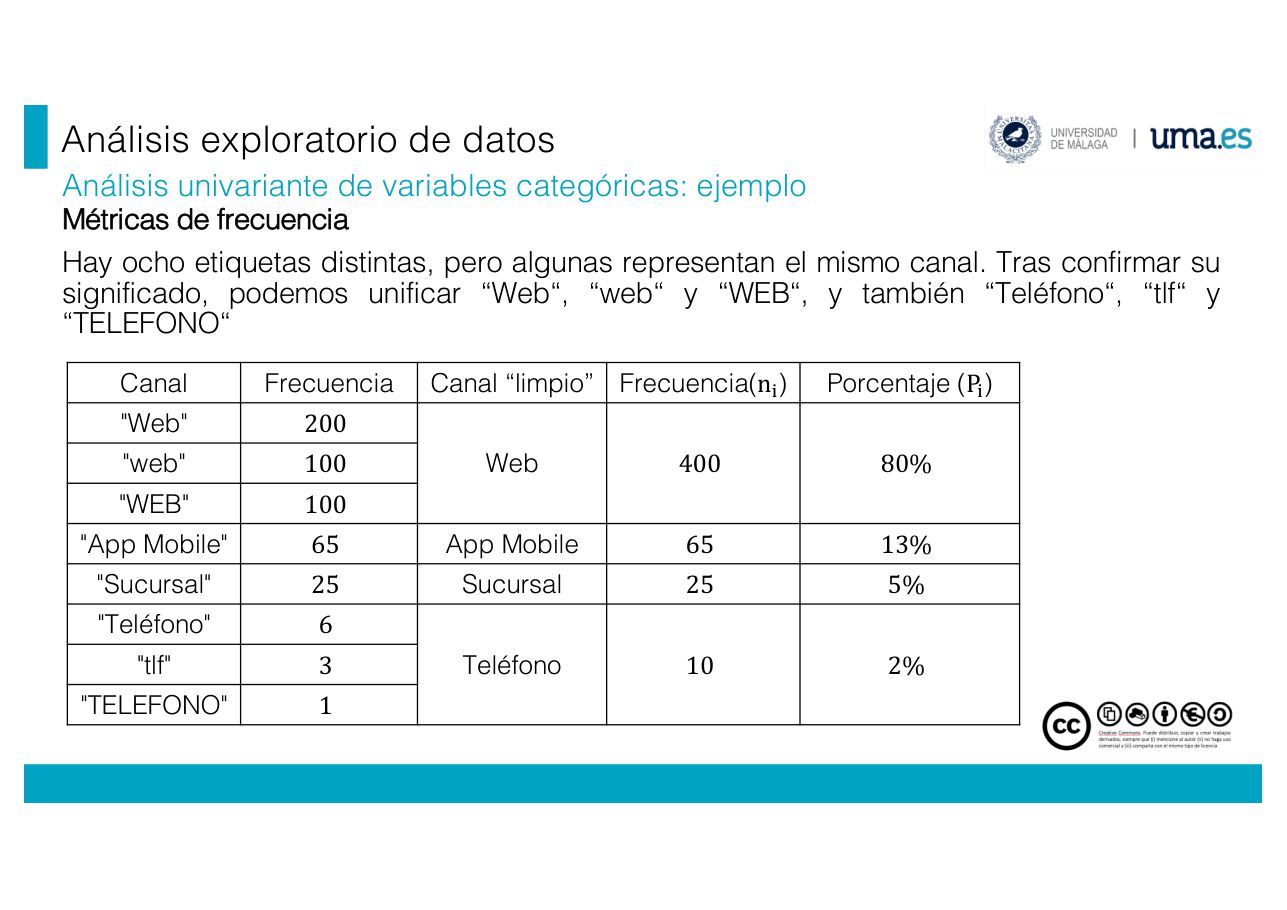
Hay ocho etiquetas distintas, pero algunas representan el mismo canal. Tras confirmar su significado, podemos unificar “Web”, “web” y “WEB”, y también “Teléfono”, “tlf” y “TELEFONO”
共有八个不同标签,但其中一些代表同一渠道。确认含义之后,可以把 “Web”、“web”、“WEB” 合并,也可以把 “Teléfono”、“tlf”、“TELEFONO” 合并。
| Canal(原标签) | Frecuencia(频数) | Canal “limpio”(清洗后) | Frecuencia (\(n_i\)) | Porcentaje (\(p_i\)) |
|---|---|---|---|---|
| "Web" | 200 | Web | 400 | 80% |
| "web" | 100 | |||
| "WEB" | 100 | |||
| "App Mobile" | 65 | App Mobile | 65 | 13% |
| "Sucursal" | 25 | Sucursal | 25 | 5% |
| "Teléfono" | 6 | Teléfono | 10 | 2% |
| "tlf" | 3 | |||
| "TELEFONO" | 1 |
Aspectos a observar · 需要观察的方面:集中度、IR 与稀有类别
▸ 原页截图 p.17
Aspectos a observar:
需要观察的方面:
Cardinalidad baja
低基数
Cuatro categorías: Web, Aplicación móvil, Sucursal y Teléfono.
四个类别:Web、移动应用、网点、电话。
Concentración de frecuencias
频率集中
Web reúne el 80 % de los contactos, mientras que Teléfono representa el 2 %.
Web 汇集了 80% 的联系,而电话只占 2%。
IR = nmax / nmin = 400 / 10 = 40 (Hay 40 contactos por Web por cada contacto telefónico).
IR = \(n_{\max}/n_{\min}\) = 400/10 = 40(每 1 次电话联系,对应 40 次 Web 联系)。
Categorías poco frecuentes
低频类别
Teléfono cuenta con solo 10 observaciones.
电话只有 10 条观测。
Posible agrupación: Sucursal y Teléfono podrían agruparse como «Atención directa» si el objetivo del análisis justifica esa categoría:
可能的合并:如果分析目标能支持这一类别,可以把网点和电话合并为「直接服务」:
n = 25 + 10 = 35 contactos → 7 %
n = 25 + 10 = 35 次联系 → 7%。
La agrupación pierde la distinción entre ambos canales y no debe decidirse únicamente por sus frecuencias.
这种合并会丢失两个渠道之间的区分,不能只凭频数就决定合并。
Herramientas gráficas para variables categóricas: diagrama de barras · 分类变量的图形工具:条形图
▸ 原页截图 p.18
Representa cada categoría mediante una barra cuya altura indica su frecuencia absoluta, relativa o porcentual.
用一根柱子表示每个类别,柱高表示其绝对频数、相对频数或百分比。
Permite comparar las frecuencias e identificar categorías predominantes o poco frecuentes.
可以比较频数,并识别占主导或低频的类别。
Distinción visual respecto al Histograma: Las barras deben mostrarse separadas por espacios, subrayando que representan niveles cualitativos discontinuos y no un continuo numérico.
与直方图的视觉区别:柱子之间必须留有空隙,强调它们代表的是离散的定性水平,而不是数值连续体。
Criterio de Ordenación:
排序准则:
Variables Nominales: Se deben ordenar las barras de mayor a menor frecuencia para facilitar la lectura del peso relativo de cada nivel.
名义变量:柱子应按频数从大到小排序,便于读出各水平的相对权重。
Variables Ordinales: Debe respetarse siempre el orden jerárquico natural de las categorías (ej. Bajo → Medio → Alto), ignorando el orden de frecuencias.
有序变量:必须始终遵循类别的自然等级顺序(例如 低 → 中 → 高),忽略频数顺序。
| 对比项 | Diagrama de barras(条形图) | Histograma(直方图) |
|---|---|---|
| 变量类型 | 分类(cualitativa) | 定量(cuantitativa) |
| 柱子间距 | 分开(separadas) | 紧贴(juntas) |
| 排序规则 | 名义:频数降序;有序:自然序 | 按区间数值顺序 |
| 每根柱代表 | 一个类别 | 一个数值区间 |
Ejemplo: canal de contacto con un banco · 例题:银行联系渠道的条形图
▸ 原页截图 p.19(图示页,默认展开)
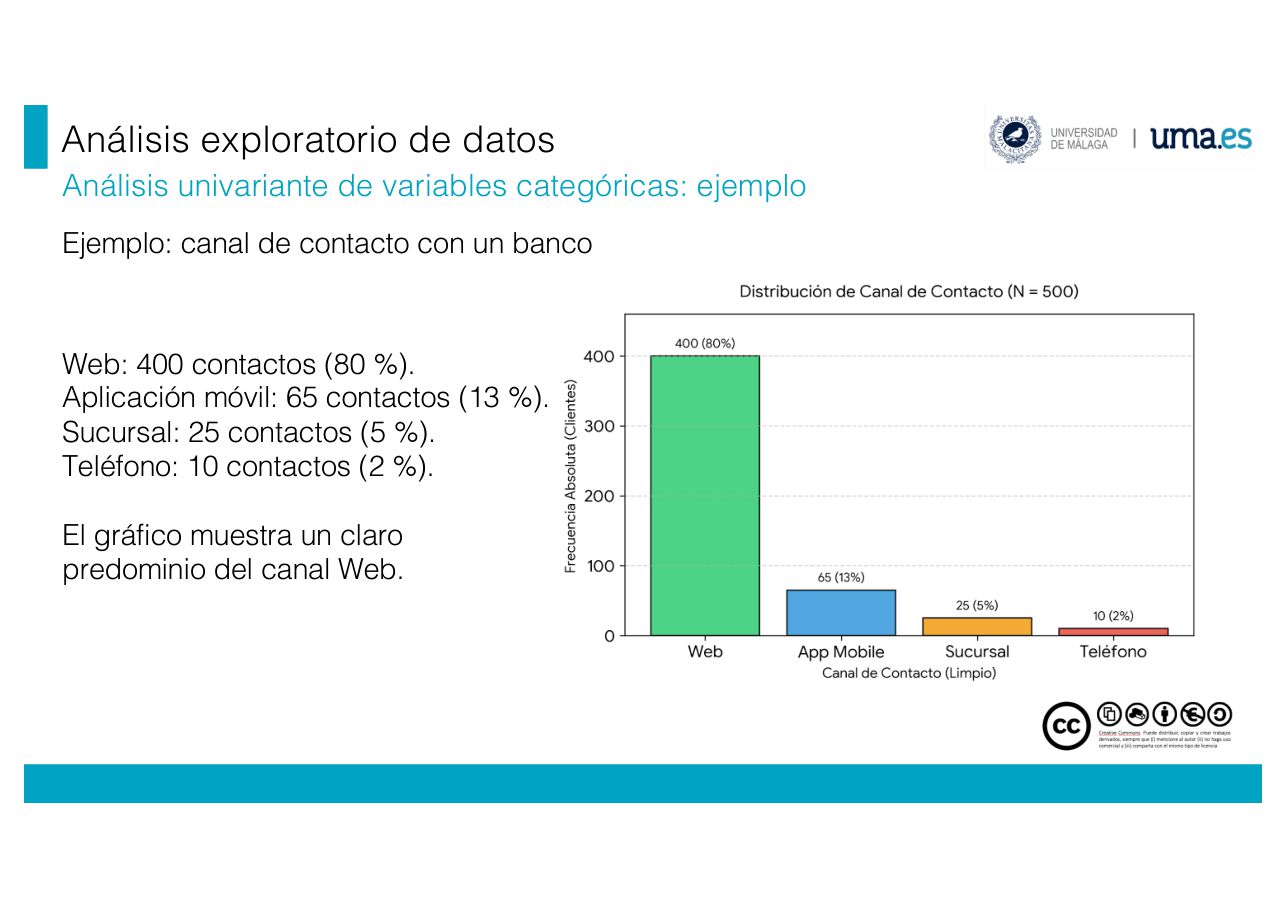
Ejemplo: canal de contacto con un banco
例题:与银行的联系渠道
Web: 400 contactos (80 %).
Web:400 次联系(80%)。
Aplicación móvil: 65 contactos (13 %).
移动应用:65 次联系(13%)。
Sucursal: 25 contactos (5 %).
网点:25 次联系(5%)。
Teléfono: 10 contactos (2 %).
电话:10 次联系(2%)。
El gráfico muestra un claro predominio del canal Web.
该图显示 Web 渠道明显占主导。
五、双变量定量:相关系数与诊断
p.20–p.23Análisis bivariante variables cuantitativas · 定量变量的双变量分析:总览
▸ 原页截图 p.20
Examina conjuntamente dos variables cuantitativas, X e Y, para explorar si existe una
联合考察两个定量变量 X 和 Y,探索它们之间是否存在关联,并描述其方向、形态与强度。
Para ello disponemos de medidas numéricas y herramientas gráficas:
为此我们有数值度量和图形工具:
Medidas numéricas:
数值度量:
Correlación de Pearson: cuantifica la asociación lineal.
Pearson 相关:量化线性关联。
Correlación de Spearman: cuantifica la asociación monotónica, es decir, la tendencia a que una variable aumente o disminuya cuando aumenta la otra.
Spearman 相关:量化单调关联,即一个变量增大时另一个变量趋于增大或减小的倾向。
Herramientas gráficas:
图形工具:
Diagrama de dispersión: representa los pares de valores y permite observar tendencias, agrupaciones y posibles valores atípicos.
散点图:表示成对的取值,可观察趋势、聚集和可能的异常值。
Mapa de correlaciones: representa mediante colores los coeficientes de correlación calculados para distintos pares de variables.
相关图(热图):用颜色表示不同变量对之间计算出的相关系数。
¡Ojo!. las asociaciones entre dos variables no implican relaciones causales
注意!两个变量之间的关联并不意味着因果关系。
Medidas numéricas: Pearson y Spearman · 数值度量:Pearson 与 Spearman 系数
▸ 原页截图 p.21(公式页,默认展开)
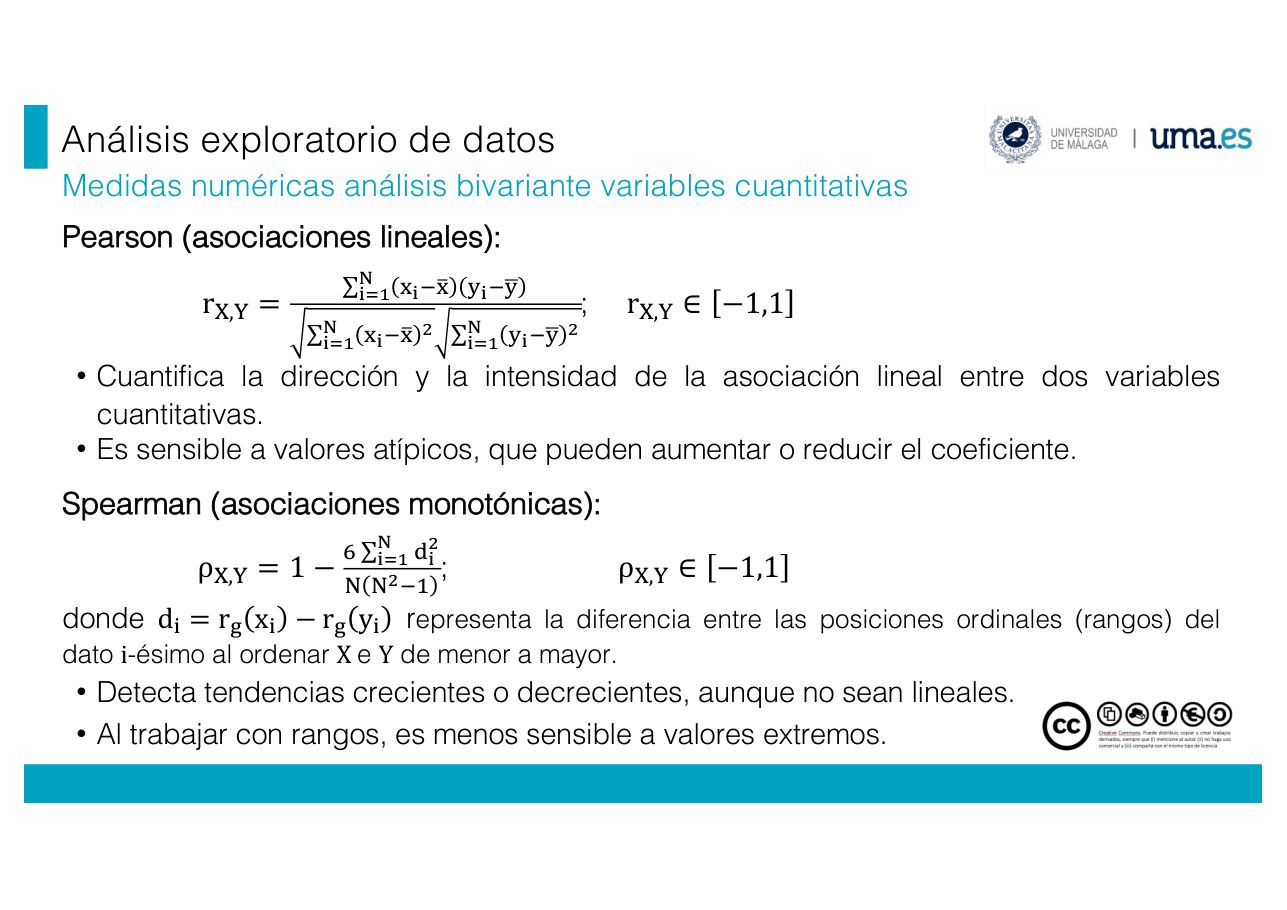
Pearson (asociaciones lineales):
Pearson(线性关联):
Cuantifica la dirección y la intensidad de la asociación lineal entre dos variables cuantitativas.
量化两个定量变量之间线性关联的方向与强度。
Es sensible a valores atípicos, que pueden aumentar o reducir el coeficiente.
它对异常值敏感,异常值可能抬高或拉低该系数。
Spearman (asociaciones monotónicas):
Spearman(单调关联):
donde \(d_i = rango(x_i) - rango(y_i)\) representa la diferencia entre las posiciones ordinales (rangos) del dato i-ésimo al ordenar X e Y de menor a mayor.
其中 \(d_i = \mathrm{rango}(x_i) - \mathrm{rango}(y_i)\),表示把 X 与 Y 分别由小到大排序后,第 i 个数据的秩次之差。
Detecta tendencias crecientes o decrecientes, aunque no sean lineales.
能识别递增或递减趋势,即使它们并非线性。
Al trabajar con rangos, es menos sensible a valores extremos.
由于使用秩次,它对极端值不那么敏感。
| 符号 | 西语读法 | 中文 |
|---|---|---|
| \(r_{x,y}\) | coeficiente de | Pearson 相关系数 |
| \(\rho_{x,y}\) | coeficiente de | Spearman 相关系数(读 rho) |
| \(\bar{x},\ \bar{y}\) | media de X / media de Y | X 的均值 / Y 的均值 |
| \(d_i\) | diferencia de rangos del dato i | 第 i 个数据的秩次差 |
| \(n\) | número de pares de observaciones | 观测对的数量 |
Interpretación y diagnóstico bivariante (r y ρ) · 双变量解释与诊断:强度阈值与警报
▸ 原页截图 p.22(阈值页,默认展开)
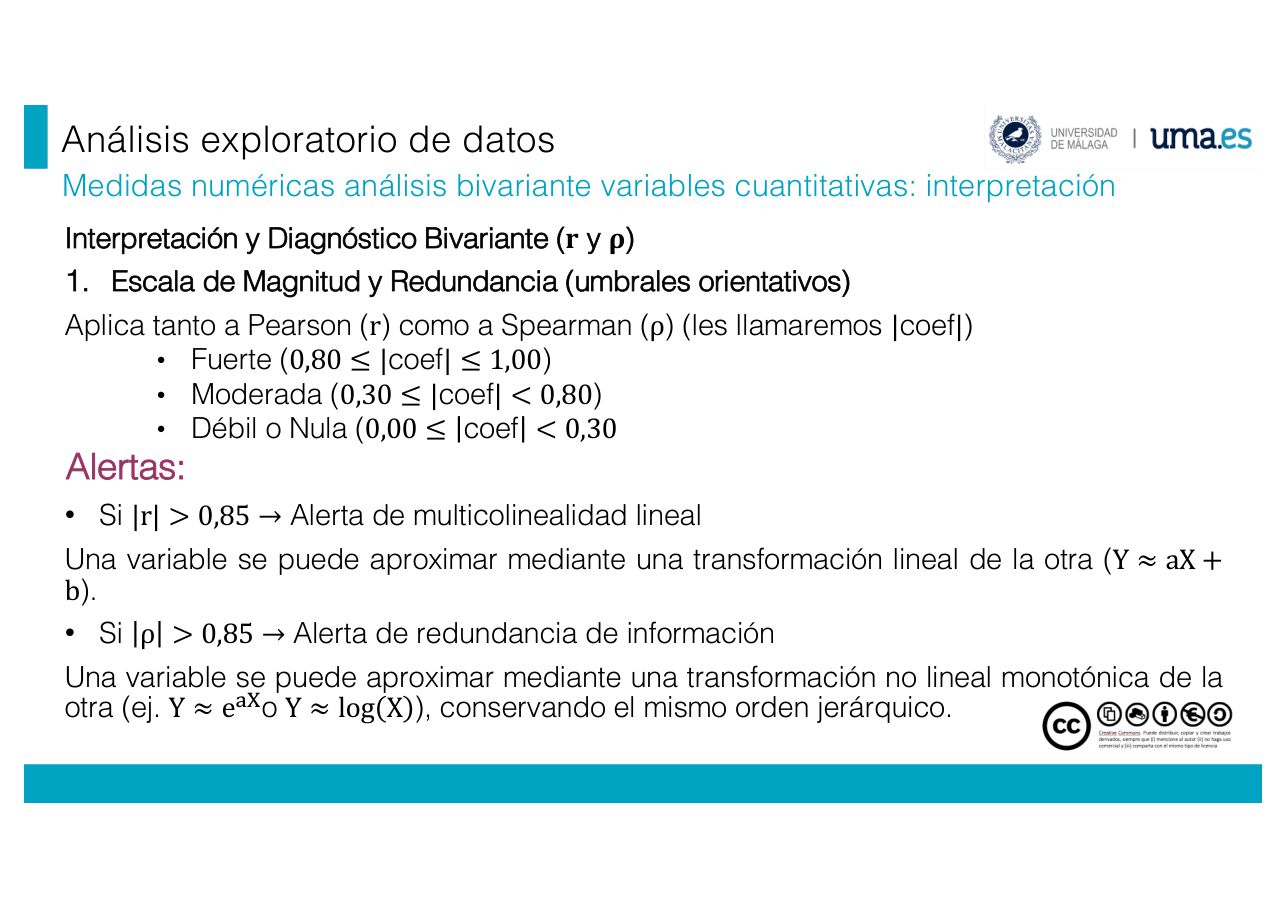
1. Escala de Magnitud y Redundancia (umbrales orientativos)
1. 强度与冗余量表(参考阈值)
Aplica tanto a Pearson (r) como a Spearman (ρ) (les llamaremos |coef|)
同时适用于 Pearson(r)和 Spearman(ρ)(我们统称为 |coef|)。
Fuerte (0,80 ≤|coef| ≤1,00)
强(0,80 ≤ |coef| ≤ 1,00)
Moderada (0,30 ≤|coef| < 0,80)
中等(0,30 ≤ |coef| < 0,80)
Débil o Nula (0,00 ≤coef < 0,30
弱或无(0,00 ≤ |coef| < 0,30)
Alertas:
警报:
Si |r| > 0,85 → Alerta de
若 |r| > 0,85 → 线性多重共线性警报。
Una variable se puede aproximar mediante una transformación lineal de la otra (Y ≈ aX + b).
一个变量可以用另一个变量的线性变换来近似(Y ≈ aX + b)。
Si ρ > 0,85 → Alerta de
若 ρ > 0,85 → 信息冗余警报。
Una variable se puede aproximar mediante una transformación no lineal monotónica de la otra (ej. Y ≈ e^x o Y ≈ log X), conservando el mismo orden jerárquico.
一个变量可以用另一个变量的单调非线性变换来近似(例如 Y ≈ e^x 或 Y ≈ log X),并保持相同的排序。
| |coef| 区间 | 强度 | 西语标签 |
|---|---|---|
| 0,80 – 1,00 | 强 | Fuerte |
| 0,30 – <0,80 | 中等 | Moderada |
| 0,00 – <0,30 | 弱或无 | Débil o Nula |
| > 0,85 | 警报线 | Multicolinealidad (r) / Redundancia (ρ) |
2. Matriz diagnóstica · 诊断矩阵:r 与 ρ 的组合判读
▸ 原页截图 p.23(表格页,默认展开)
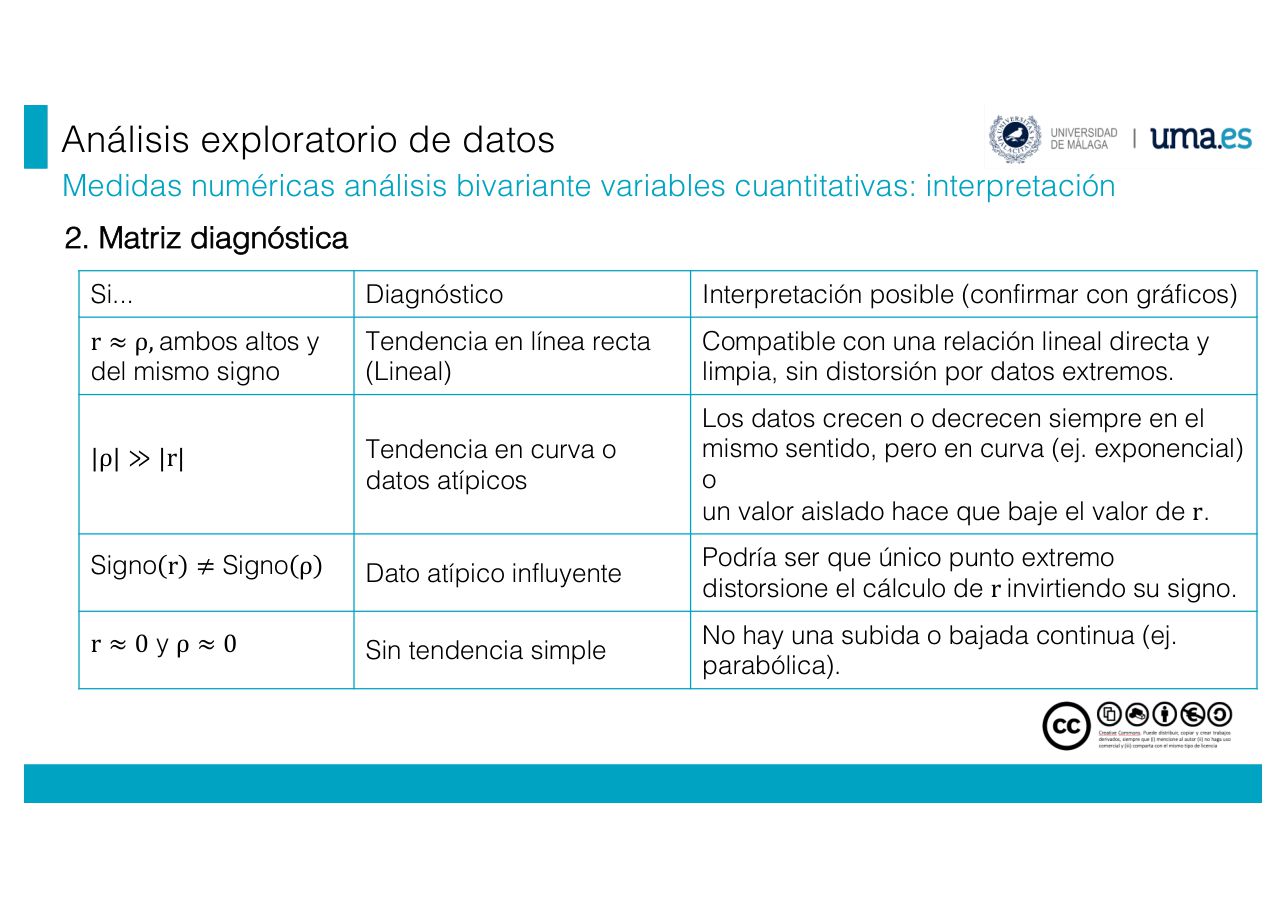
2. Matriz diagnóstica
2. 诊断矩阵
| Si...(若……) | Diagnóstico(诊断) | Interpretación posible (confirmar con gráficos)(可能解释,需用图形确认) |
|---|---|---|
| r ≈ ρ, ambos altos y del mismo signo | Tendencia en línea recta (Lineal) | Compatible con una relación lineal directa y limpia, sin distorsión por datos extremos. |
| |ρ| ≫ |r| | Tendencia en curva o datos atípicos | Los datos crecen o decrecen siempre en el mismo sentido, pero en curva (ej. exponencial) o un valor aislado hace que baje el valor de r. |
| Signo r ≠ Signo ρ | Dato atípico influyente | Podría ser que único punto extremo distorsione el cálculo de r invirtiendo su signo. |
| r ≈ 0 y ρ ≈ 0 | Sin tendencia simple | No hay una subida o bajada continua (ej. parabólica). |
六、双变量图形:热图与散点图
p.24–p.281. Mapa de Calor de Correlaciones (Heatmap) · 相关系数热图
▸ 原页截图 p.24(图示页,默认展开)
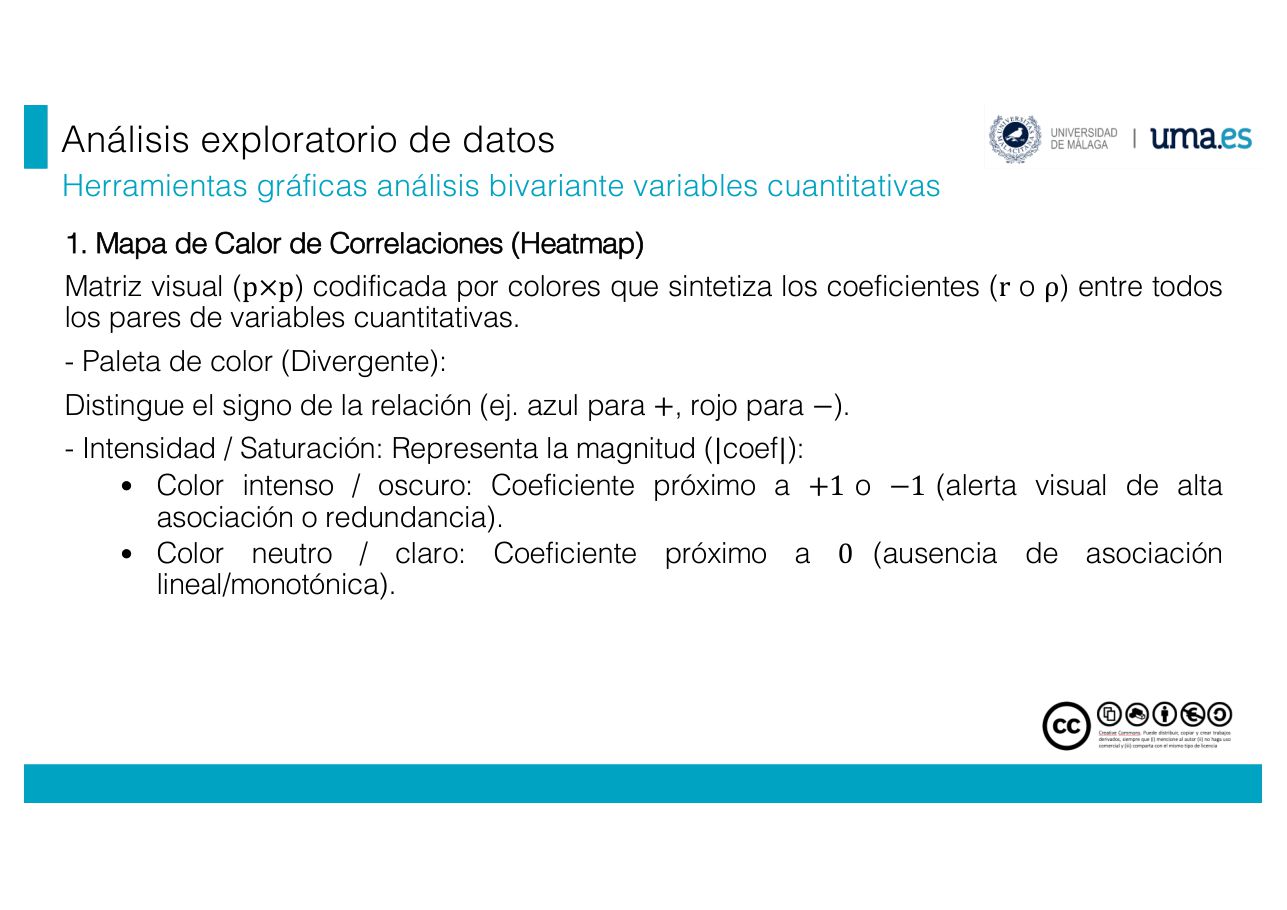
Matriz visual (p×p) codificada por colores que sintetiza los coeficientes (r o ρ) entre todos los pares de variables cuantitativas.
用颜色编码的 (p×p) 可视化矩阵,汇总所有定量变量两两之间的系数(r 或 ρ)。
Paleta de color (Divergente):
配色方案(发散型):
Distingue el signo de la relación (ej. azul para +, rojo para −).
区分关联的符号(例如蓝色表示 +,红色表示 −)。
Intensidad / Saturación: Representa la magnitud (|coef|):
强度 / 饱和度:表示大小(|coef|):
Color intenso / oscuro: Coeficiente próximo a +1 o −1 (alerta visual de alta asociación o redundancia).
深色 / 浓色:系数接近 +1 或 −1(高关联或冗余的视觉警报)。
Color neutro / claro: Coeficiente próximo a 0 (ausencia de asociación lineal/monotónica).
中性色 / 浅色:系数接近 0(不存在线性 / 单调关联)。
Ejemplo análisis bivariante · 例题:员工数据表(10 名员工,4 个变量)
▸ 原页截图 p.25(表格页,默认展开)
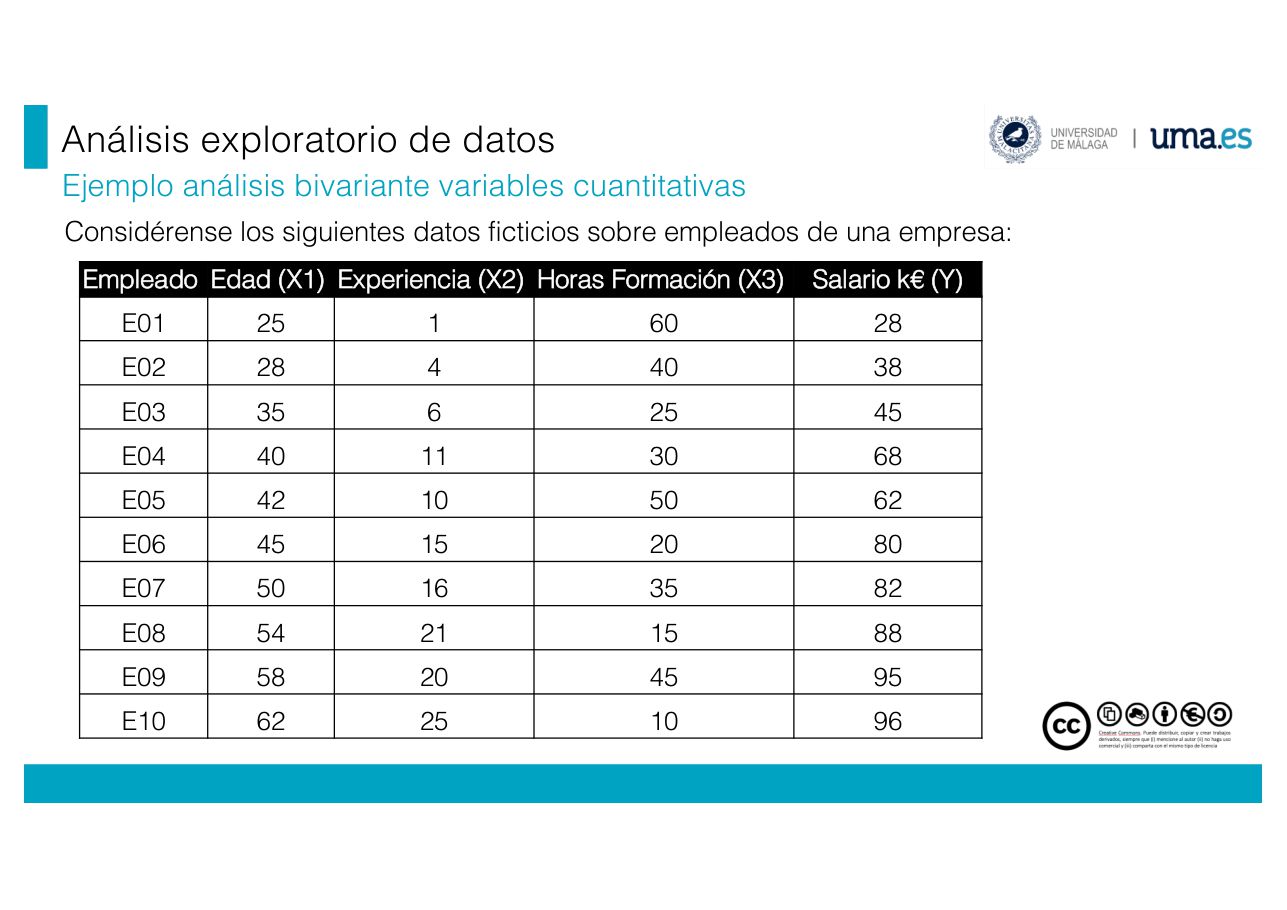
Considérense los siguientes datos ficticios sobre empleados de una empresa:
考虑以下关于某公司员工的虚构数据:
| Empleado | Edad (X1) | Experiencia (X2) | Horas Formación (X3) | Salario k€ (Y) |
|---|---|---|---|---|
| E01 | 25 | 1 | 60 | 28 |
| E02 | 28 | 4 | 40 | 38 |
| E03 | 35 | 6 | 25 | 45 |
| E04 | 40 | 11 | 30 | 68 |
| E05 | 42 | 10 | 50 | 62 |
| E06 | 45 | 15 | 20 | 80 |
| E07 | 50 | 16 | 35 | 82 |
| E08 | 54 | 21 | 15 | 88 |
| E09 | 58 | 20 | 45 | 95 |
| E10 | 62 | 25 | 10 | 96 |
Ejemplo: mapas de calor · 例题:员工数据的热图解读
▸ 原页截图 p.26(图示页,默认展开)
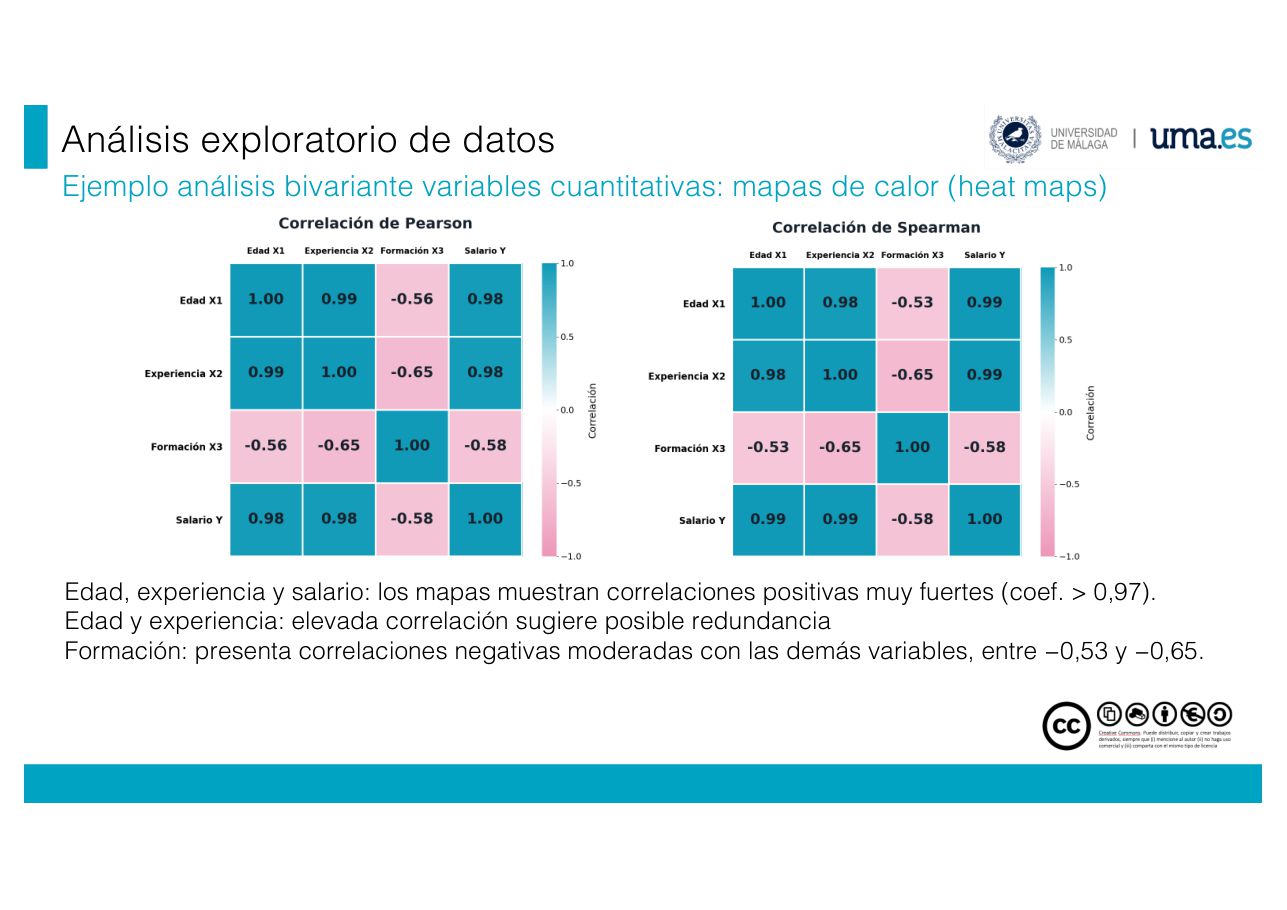
Edad, experiencia y salario: los mapas muestran correlaciones positivas muy fuertes (coef. > 0,97).
年龄、经验与薪资:热图显示非常强的正相关(系数 > 0,97)。
Edad y experiencia: elevada correlación sugiere posible redundancia
年龄与经验:高相关提示可能存在冗余。
Formación: presenta correlaciones negativas moderadas con las demás variables, entre −0,53 y −0,65.
培训:与其他变量呈中等负相关,介于 −0,53 与 −0,65 之间。
| Pearson | Edad X1 | Experiencia X2 | Formación X3 | Salario Y |
|---|---|---|---|---|
| Edad X1 | 1,00 | 0,99 | −0,56 | 0,98 |
| Experiencia X2 | 0,99 | 1,00 | −0,65 | 0,98 |
| Formación X3 | −0,56 | −0,65 | 1,00 | −0,58 |
| Salario Y | 0,98 | 0,98 | −0,58 | 1,00 |
(右图为 Spearman 矩阵:Edad–Experiencia 0,98;Edad–Salario 0,99;Formación 与其他变量 −0,53 ~ −0,65。)
(右图为 Spearman 矩阵:年龄–经验 0,98;年龄–薪资 0,99;培训与其他变量 −0,53 ~ −0,65。)
2. Diagrama de Dispersión (Scatter Plot) · 散点图
▸ 原页截图 p.27
Representa cada observación como un punto (xᵢ, yᵢ) en un plano cartesiano. Permite diagnosticar visualmente:
把每个观测表示为笛卡尔平面上的一个点 \((x_i, y_i)\)。可用来直观诊断:
Forma de la relación:
关系的形态:
Lineal: Puntos distribuidos a lo largo de una recta.
线性:点沿一条直线分布。
Curva Monotónica: Tendencia creciente/decreciente en curva (ej. saturación de enlace o retardo exponencial).
单调曲线:呈曲线状递增 / 递减趋势(例如链路饱和或指数时延)。
No Monotónica: Patrones complejos (ej. parabólicos o en "U") donde r ≈ 0 y ρ ≈ 0.
非单调:复杂模式(例如抛物线或「U」形),此时 r ≈ 0 且 ρ ≈ 0。
Agrupaciones y Atípicos:
聚集与异常值:
Cúmulos (Clusters): Subpoblaciones de datos dentro del dataset.
簇(聚类):数据集内部的子群体。
Puntos atípicos/influyentes: Observaciones alejadas de la tendencia global.
异常 / 影响点:远离整体趋势的观测。
Ejemplo: diagramas de dispersión · 例题:员工数据的散点图矩阵
▸ 原页截图 p.28(图示页,默认展开)
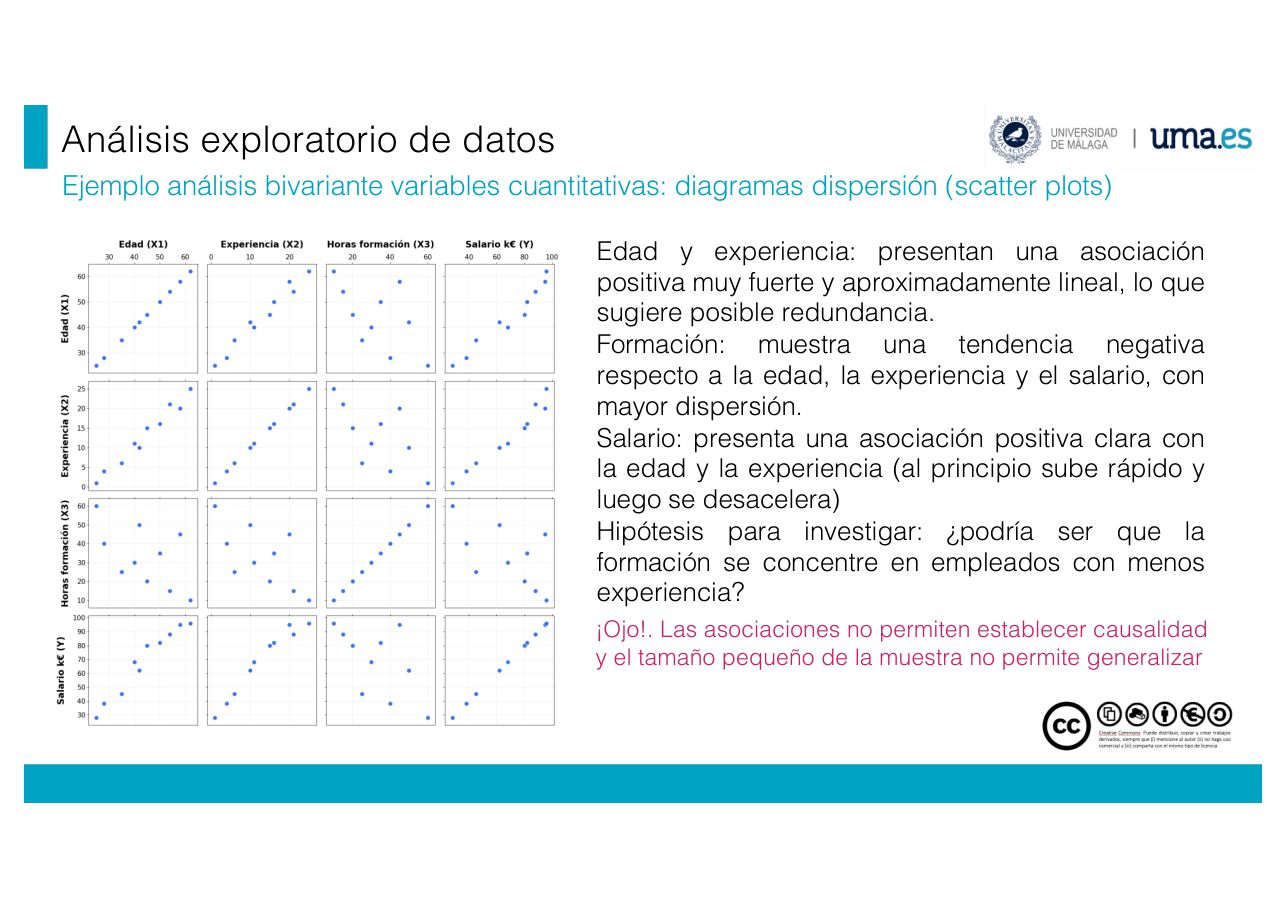
Edad y experiencia: presentan una asociación positiva muy fuerte y aproximadamente lineal, lo que sugiere posible redundancia.
年龄与经验:呈现非常强且近似线性的正关联,提示可能存在冗余。
Formación: muestra una tendencia negativa respecto a la edad, la experiencia y el salario, con mayor dispersión.
培训:相对年龄、经验和薪资呈负向趋势,且离散程度更大。
Salario: presenta una asociación positiva clara con la edad y la experiencia (al principio sube rápido y luego se desacelera)
薪资:与年龄和经验呈明显的正关联(起初上升很快,随后放缓)。
Hipótesis para investigar: ¿podría ser que la formación se concentre en empleados con menos experiencia?
待研究的假设:培训是否可能集中在经验较少的员工身上?
¡Ojo!. Las asociaciones no permiten establecer causalidad y el tamaño pequeño de la muestra no permite generalizar
注意!关联不能确立因果关系,且样本量小,不能推广。
七、专有名词总表
A–Z · 全章 28 页A–Z 术语速记表
按西语字母排序;「页」可点击跳回原页上下文。最后一列是考试时真正救命的「一句话 + 易错点」。
| 西语术语 | 中文 | 页 | 一句话记住 · 易错点 |
|---|---|---|---|
| A | |||
| análisis exploratorio de datos | 探索性数据分析 | p.3 | 先摸清数据再建模;不是「画图课」。 |
| análisis univariante | 单变量分析 | p.5 | 一次只看一个变量:定量看分布,分类看频数。 |
| análisis bivariante | 双变量分析 | p.20 | 只研究两个定量变量的关联,不等于回归建模。 |
| asociación | 关联 | p.20 | 关联 ≠ 因果,任何相关题都要补这句。 |
| asimetría | 偏度 | p.8 | g₁>0 右尾长(正偏),g₁<0 左尾长(负偏)。 |
| atributo | 属性 / 字段 | p.4 | 等同 variable;审计先看类型与单位。 |
| B | |||
| bigote | 须 | p.11 | 须只画到围栏内真实数据,不画到 LI / LS。 |
| diagrama de barras | 条形图 | p.18 | 柱分开;名义降序,有序保自然序。 |
| C | |||
| cardinalidad | 基数 | p.14 | 不同取值个数;8 个原始标签 ≠ 4 个真实类别。 |
| caja | 箱体 | p.11 | 从 Q₁ 到 Q₃,装中间 50% 的数据。 |
| cuartil | 四分位 | p.6 | Q₁=P25、Q₂=P50、Q₃=P75。 |
| correlación de Pearson | Pearson 相关 | p.21 | 只测线性;对异常值敏感。 |
| correlación de Spearman | Spearman 相关 | p.21 | 测单调;用秩次,抗极端值。 |
| clúster / cúmulo | 簇 | p.27 | 散点图里的子群体,不是异常点。 |
| concentración de frecuencias | 频率集中 | p.14 | 少数类别占大多数 → 类别失衡。 |
| coherencia entre variables | 变量间一致性 | p.4 | 逻辑校验,如结束日期 ≥ 开始日期。 |
| D | |||
| desviación típica | 标准差 | p.6 | 样本公式分母 n−1;和均值一样怕极端值。 |
| diagrama de dispersión | 散点图 | p.27 | 看形态、聚集、异常点最直观。 |
| diagrama de cajas y bigotes | 箱线图 | p.11 | 五要素:箱、中线、两须、须外点。 |
| desequilibrio de clases | 类别失衡 | p.14 | 用 IR 量化,IR = n_max / n_min ≥ 1。 |
| E | |||
| etiquetas inconsistentes | 标签不一致 | p.14 | Madrid / madrid / MAD 先合并再统计。 |
| escala de magnitud | 强度量表 | p.22 | 0,80 分强弱、0,30 分有无、0,85 报警报。 |
| estructura de los datos | 数据结构 | p.4 | 变量、维度、标识符,三件事开场。 |
| F | |||
| frecuencia absoluta | 绝对频数 | p.14 | n_i 是个数,不是百分比。 |
| frecuencia relativa | 相对频率 | p.14 | p_i = 100 · n_i / N,合计 100%。 |
| coeficiente de asimetría de Fisher | Fisher 偏度系数 | p.8 | 课上公式除以 n,不是 n−1。 |
| forma (medidas de forma) | 形态(度量) | p.5 | 偏度描述形状,不是离散程度。 |
| H | |||
| histograma | 直方图 | p.11 | 柱紧贴;组距一改,外观就变。 |
| heatmap / mapa de calor | 热图 | p.24 | p×p 对称;颜色分正负,深浅看强度。 |
| I | |||
| identificadores | 标识符 | p.4 | 唯一标识观测,不参与相关性分析。 |
| inconsistencias | 不一致 | p.4 | 格式 / 单位 / 标签不统一,属质量问题。 |
| IQR (rango intercuartílico) | 四分位距 | p.6 | IQR = Q₃ − Q₁,含中间 50%。 |
| IR (ratio de desequilibrio) | 类别失衡比 | p.14 | 600/20=30,读作「30 倍」不是「多 30」。 |
| L | |||
| límite inferior / límite superior | 下限 / 上限 | p.9 | LI = Q₁ − 1,5·IQR;LS = Q₃ + 1,5·IQR。 |
| lineal (asociación) | 线性(关联) | p.20 | 点沿直线分布,Pearson 的主场。 |
| M | |||
| media | 均值 | p.6 | 对极端值敏感,总和除以 n。 |
| mediana | 中位数 | p.6 | 稳健;就是 Q₂ = P50。 |
| multicolinealidad | 多重共线性 | p.22 | |r| > 0,85 的线性冗余警报。 |
| matriz diagnóstica | 诊断矩阵 | p.23 | 用 r 与 ρ 的大小、符号组合下结论。 |
| mapa de correlaciones | 相关图 | p.20 | 热图的另一种叫法,用颜色表系数。 |
| N | |||
| variable nominal | 名义变量 | p.18 | 类别无序;条形图按频数降序。 |
| dato normal | 正常数据 | p.9 | 落在 [LI, LS] 内,不是「正态分布」。 |
| O | |||
| variable ordinal | 有序变量 | p.18 | 有等级;条形图保自然序,别按频数排。 |
| outlier | 异常值 | p.9 | 候选异常 ≠ 一定要剔除,要结合业务。 |
| P | |||
| percentil | 百分位 | p.6 | P50 就是中位数;P25/P75 是四分位。 |
| punto atípico / influyente | 异常 / 影响点 | p.27 | 远离整体趋势,可能翻转 r 的符号。 |
| R | |||
| rango intercuartílico | 四分位距 | p.6 | 同 IQR,是稳健的离散度量。 |
| redundancia | 冗余 | p.22 | |ρ| > 0,85;单调非线性也算。 |
| rango (Spearman) | 秩次 | p.21 | d_i = rango(x_i) − rango(y_i)。 |
| S | |||
| saturación (de color) | 饱和度 | p.24 | 颜色越深,|coef| 越大。 |
| signo (de la relación) | 关联符号 | p.20 | 正=同向,负=反向;热图蓝正红负。 |
| T | |||
| regla de Tukey | Tukey 法则 | p.9 | 1,5×IQR 画围栏,不要求分布正态。 |
| tendencia central | 集中趋势 | p.5 | 均值 + 中位数,两件套。 |
| tamaño de la muestra | 样本量 | p.28 | 小样本不能推广,结论题必写。 |
| V | |||
| valor atípico | 异常值 | p.9 | 80 ms > LS=38,5 → 候选异常。 |
| valores ausentes | 缺失值 | p.4 | 按变量和按观测都要统计。 |
| valores inválidos | 无效值 | p.4 | 超出允许范围 / 类别,和缺失不是一回事。 |
| vallas de Tukey | Tukey 围栏 | p.9 | [LI, LS] 之外即候选异常。 |
阈值与公式速记卡
这一章真正要背死的数字都在这里;考试前扫一眼就够。
| 项目 | 阈值 / 公式 | 一句话口诀 |
|---|---|---|
| Fisher 偏度 \(g_1\) | 0–0,5 leve · 0,5–1 moderada · >1 fuerte | 「半点轻微,一点强;符号看尾巴」 |
| Tukey 围栏 | LI = Q₁ − 1,5·IQR LS = Q₃ + 1,5·IQR | 「一五倍 IQR,两边各画一道栏」 |
| 百分位与四分位 | Q₁=P25 · Q₂=P50 · Q₃=P75 | 「二五五零七五,三刀切四段」 |
| 类别失衡比 IR | IR = n_max / n_min | 「最大除最小,永远 ≥ 1」 |
| 相关强度 | 0,80–1,00 fuerte 0,30–<0,80 moderada 0–<0,30 débil o nula | 「八零算强,三零算有」 |
| 警报线 | |r| > 0,85 multicolinealidad |ρ| > 0,85 redundancia | 「八五拉警报,r 共线、ρ 冗余」 |
| 相对频率 | p_i = 100 · n_i / N | 「人头除以总数,再乘一百」 |
| 样本标准差 | s = √( Σ(x_i−x̄)² / (n−1) ) | 「分母 n−1,别写成 n」 |
易混对照卡
下面每一对都是「看着像、考起来要命」的组合,左右各一句判据。
直方图:定量、柱紧贴、按区间。条形图:分类、柱分开、按类别。
Pearson 测线性、用原始值、怕异常值;Spearman 测单调、用秩次、抗异常值。
均值对极端值敏感;中位数稳健,等于 P50。
标准差配均值、怕极端值;IQR 配中位数、稳健。
异常值是「罕见但可能真实」;无效值是「超出允许范围,不可能真实」。
缺失是「没有」;不一致是「有,但写法/单位/格式对不上」。
基数是不同取值个数;原始标签 8 个,清洗后真实类别只有 4 个。
名义条形图按频数降序;有序必须保持自然等级序。
|r|>0,85 是线性共线;|ρ|>0,85 是单调冗余。名字不能互换。
相关只说明同向/反向变动,不能推出「谁导致谁」。
箱体 Q₁–Q₃ 装中间 50%;须只到围栏内最远的真实数据。
热图给「系数矩阵」;散点图给「逐点形态、聚集、异常点」。
线性一定单调;单调不一定线性(如指数、对数曲线)。
Tukey 只负责「标记候选」,删不删要看业务与数据质量。