- 一页一块:页号胶囊是 PDF 物理页序(1–95)。幻灯片右下角印的页码另有编号:p.1–p.13 两者一致,p.14–p.71 印刷页 = 物理页 + 2,p.72 起印刷页 = 物理页 + 3(p.72 处跳过了 74)。老师上课说「第 38 页」指的是印刷页码,别找错。
- 逐句对照:蓝色左框内是西语原句(逐字照抄,含原文笔误),下面带「中」字标的是中文翻译;项目符号统一用 • 表示。
- 提示框:绿色「考点」= 这页怎么考;红色「陷阱」= 易错点与原文勘误;紫色「记忆钩子」= 口诀;橙色「补充」= 前后页串联。
- 术语悬停:西语句里带浅蓝底的词,鼠标停上去出中文;中文句里带虚下划线的词,停上去出西语原词。
- 公式:一律用本地 MathJax 渲染(断网也能显示),每个公式下附「符号 / 西语读法 / 中文含义」三列小表——口语考试念的就是这一列。
一、为什么必须预处理:GIGO 与三次真实事故
p.1–p.5Tema 5: Preprocesamiento de datos · 主题 5:数据预处理(封面)
▸ 原页截图 p.1
Tema 5:
Eva Millán
Eva Millán(主讲教师)
Departamento de Lenguajes y Ciencias de la Computación
语言与计算机科学系(马拉加大学)
Motivación · 动机:理想中的数据 vs 现实中的数据
▸ 原页截图 p.2
Lo ideal para el
对
En la práctica, esto no es así, y nos encontramos con los siguientes problemas:
但在实践中根本不是这样,我们总会遇到下面这些
• Presencia de
• 存在
•
•
• Datos
•
• Datos
•
• Grandes cantidades de datos en ambas dimensiones: ejemplos (filas) y características (columnas)
• 两个维度上的数据量都巨大:
Introducción · 问题 → 例子 → 可能解法 总表
▸ 原页截图 p.3
Preprocesamiento · Introducción
预处理 · 引言(本页是全章的「症状—药方」对照表)
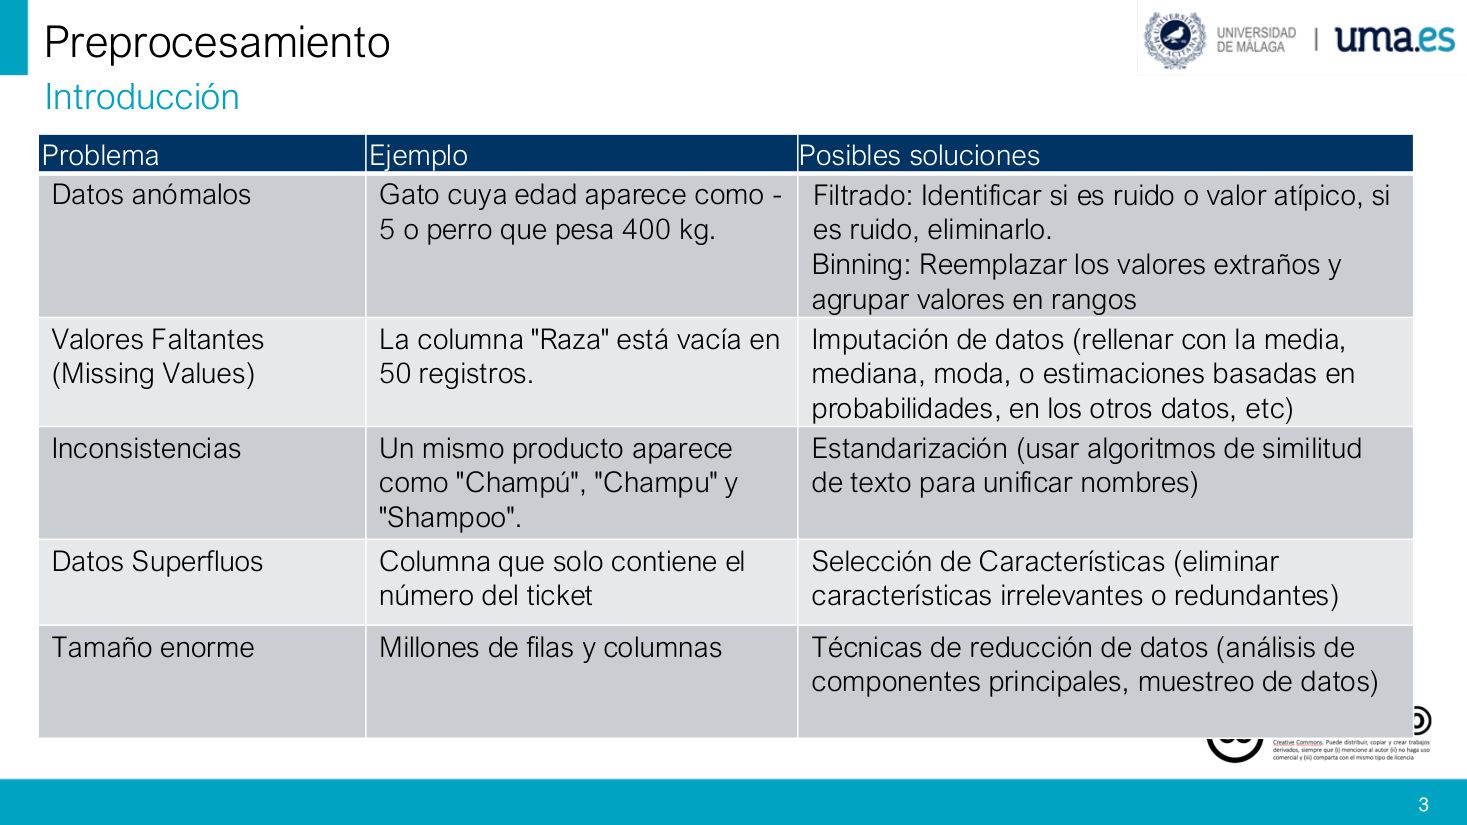
| Problema 问题 | Ejemplo 例子 | Posibles soluciones 可能的解法 |
|---|---|---|
| Datos anómalos 异常数据 | Gato cuya edad aparece como -5 o perro que pesa 400 kg. 猫的年龄显示为 -5,或狗重 400 kg | Filtrado: identificar si es ruido o valor atípico; si es ruido, eliminarlo. Binning: reemplazar los valores extraños y agrupar valores en rangos 过滤:先判断是噪声还是真实离群值,是噪声就删;分箱:把怪异值替换掉并按区间归组 |
| Valores Faltantes (Missing Values) 缺失值 | La columna "Raza" está vacía en 50 registros. 「品种」这一列有 50 条记录是空的 | Imputación de datos (rellenar con la media, mediana, moda, o estimaciones basadas en probabilidades, en los otros datos, etc.) 插补:用均值、中位数、众数,或基于其他数据 / 概率的估计来填 |
| Inconsistencias 不一致 | Un mismo producto aparece como "Champú", "Champu" y "Shampoo". 同一个产品写成三种拼法 | Estandarización (usar algoritmos de similitud de texto para unificar nombres) 标准化:用文本相似度算法把名称统一 |
| Datos Superfluos 多余数据 | Columna que solo contiene el número del ticket 只有「小票编号」的列 | Selección de Características (eliminar características irrelevantes o redundantes) 特征选择:删掉无关或冗余的特征 |
| Tamaño enorme 体量巨大 | Millones de filas y columnas 上百万行、上百万列 | Técnicas de reducción de datos (análisis de componentes principales, muestreo de datos) 数据归约:主成分分析、抽样 |
Introducción: GIGO · GIGO:垃圾进,垃圾出
▸ 原页截图 p.4
Garbage in, garbage out
垃圾进,垃圾出(缩写 GIGO)
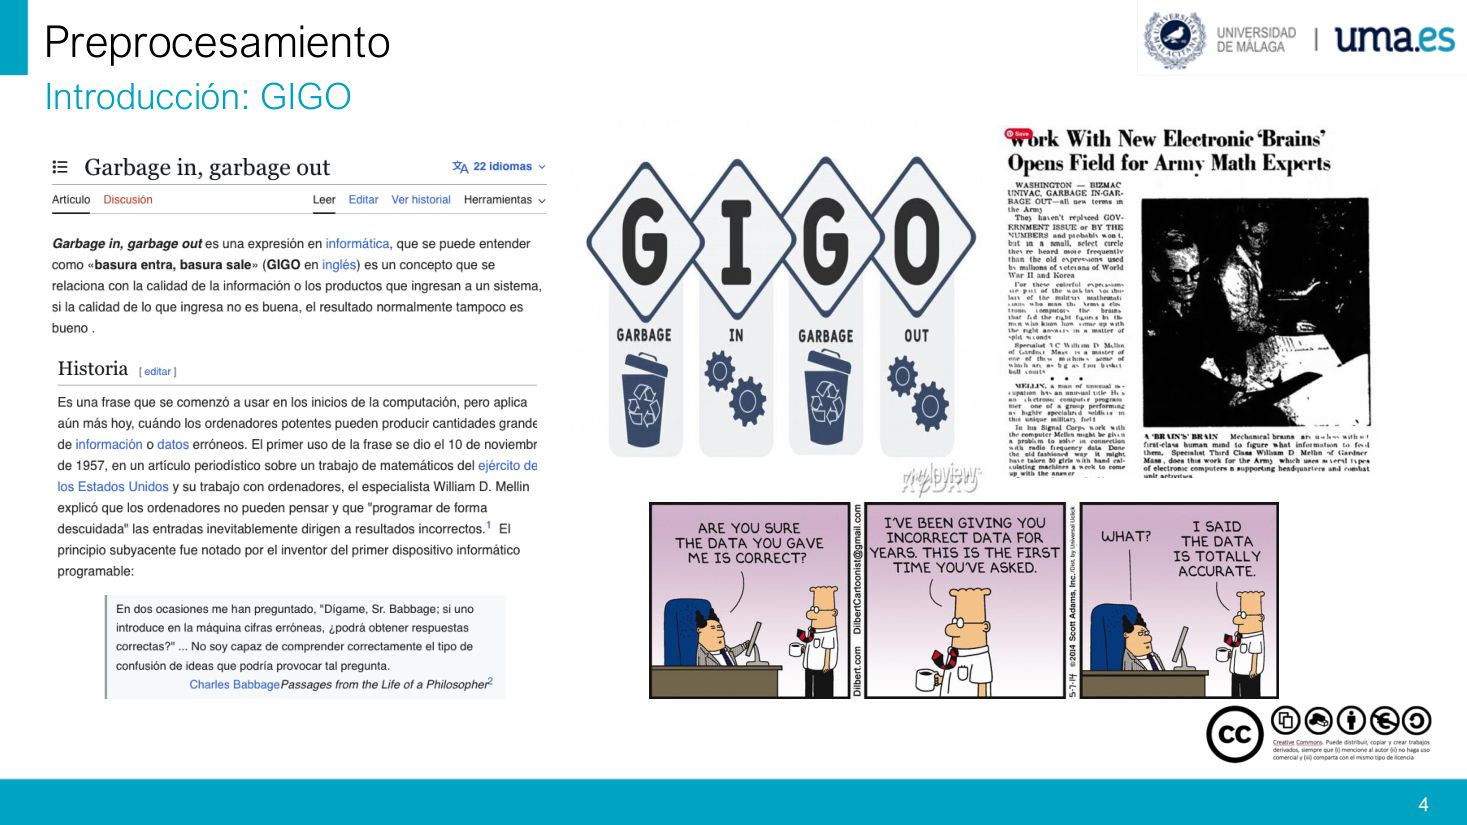
Garbage in, garbage out es una expresión informática, que se puede entender como «basura entra, basura sale» (GIGO en inglés) es un concepto que se relaciona con la calidad de la información o los productos que ingresan a un sistema, y la calidad de lo que ingresa no es buena, el resultado normalmente tampoco es bueno.
「Garbage in, garbage out」是一句计算机领域的说法,可以理解为「垃圾进去、垃圾出来」;它讲的是输入系统的信息或产品的质量:如果进入的东西质量不好,结果通常也好不了。
Es una frase que se comenzó a usar en los inicios de la computación, pero aplica aún más hoy, cuando los ordenadores potentes pueden producir cantidades grandes de información o datos erróneos.
这句话从计算机诞生之初就开始使用,但在今天更加适用——因为强大的计算机能大批量地生产错误信息或错误数据。
ARE YOU SURE THE DATA YOU GAVE ME IS CORRECT?
(漫画第 1 格)你确定给我的数据是对的吗?
I'VE BEEN GIVING YOU INCORRECT DATA FOR YEARS. THIS IS THE FIRST TIME YOU'VE ASKED.
(漫画第 2 格)我这么多年给你的数据一直是错的。这是你第一次问。
WHAT? I SAID THE DATA IS TOTALLY ACCURATE.
(漫画第 3 格)什么?我可说过数据完全准确。
Introducción: GIGO · 三次真实事故:单位、噪声、偏见
▸ 原页截图 p.5
En 1999, la sonda Mars Climate Orbiter se destruyó por una falta de
1999 年,火星气候探测者号(Mars Climate Orbiter)因为缺乏
Este error de
这个输入数据
En 2021, Zillow perdió 500 millones de dólares al no preprocesar el "
2021 年,Zillow 损失 5 亿美元,原因是它的算法没有预处理疫情造成的
El modelo compró miles de casas sobrevaloradas basándose en predicciones infladas. (Fuente: https://iceberg.digital/trust-incident-zillow/ )
该模型基于被抬高的预测,买下了数千套价格虚高的房子。(来源:iceberg.digital 的 Zillow 事故复盘)
En 2015, Amazon canceló su IA de reclutamiento porque los datos de entrenamiento estaban
2015 年,亚马逊取消了它的招聘 AI,因为训练数据
El sistema aprendió a penalizar currículums que incluían la palabra "mujeres", automatizando un prejuicio histórico. (Fuente: Reuters, "Amazon scraps secret AI recruiting tool").
系统学会了给包含「women(女性)」一词的简历扣分,把一个历史偏见自动化了。(来源:路透社《亚马逊放弃秘密 AI 招聘工具》)
① 火星探测器 = falta de estandarización / inconsistencia(单位不统一);
② Zillow = ruido / anomalías(异常值未处理);
③ Amazon = datos sesgados(训练数据有偏)。
二、五阶段总览 · 临床营养数据集贯穿案例
p.6–p.13Etapas del preprocesamiento de datos · 阶段一、二:清洗与集成
▸ 原页截图 p.6
1. Limpieza de Datos (Data Cleaning)
1. 数据清洗(Data Cleaning)
Es el primer paso para corregir errores obvios y asegurar la calidad de la información.
它是第一步:纠正明显的错误,确保信息的质量。
• Manejo de
• 处理
• Tratamiento de datos anómalos (outliers, ruido): Identificar datos que se alejan demasiado del promedio y decidir si son errores o casos especiales legítimos.
• 处理异常数据(
• Eliminación de duplicados: Borrar registros idénticos que puedan
• 去重:删除完全相同的记录,因为它们会让模型产生
2. Integración de Datos
2. 数据集成
Si los datos vienen de diferentes fuentes (bases de datos SQL, archivos CSV, APIs), en esta etapa se combinan. El reto aquí es resolver conflictos de estructuras o nombres de columnas para que todo hable el mismo "idioma".
如果数据来自不同来源(SQL 数据库、CSV 文件、API),就在这一步把它们合并。难点是解决结构冲突或列名冲突,让所有数据「说同一种语言」。
Etapas del preprocesamiento de datos · 阶段三、四、五:变换、归约、离散化
▸ 原页截图 p.7
3. Transformación de Datos
3. 数据变换
• Creación de nuevos atributos usando fórmulas o modelos matemáticos
• 用公式或数学模型
• Codificación de variables categóricas: Los modelos no entienden "Rojo" o "Azul". Usamos técnicas como
• 类别变量的
4. Reducción de Datos
4. 数据归约
• Selección de características o ejemplos
•
• Reducción de dimensionalidad: Usar algoritmos como
• 降维:用
5. Discretización
5. 离散化
Convertimos variables continuas en discretas
把
Índice · 全章目录:五阶段与各自的子技术
▸ 原页截图 p.8
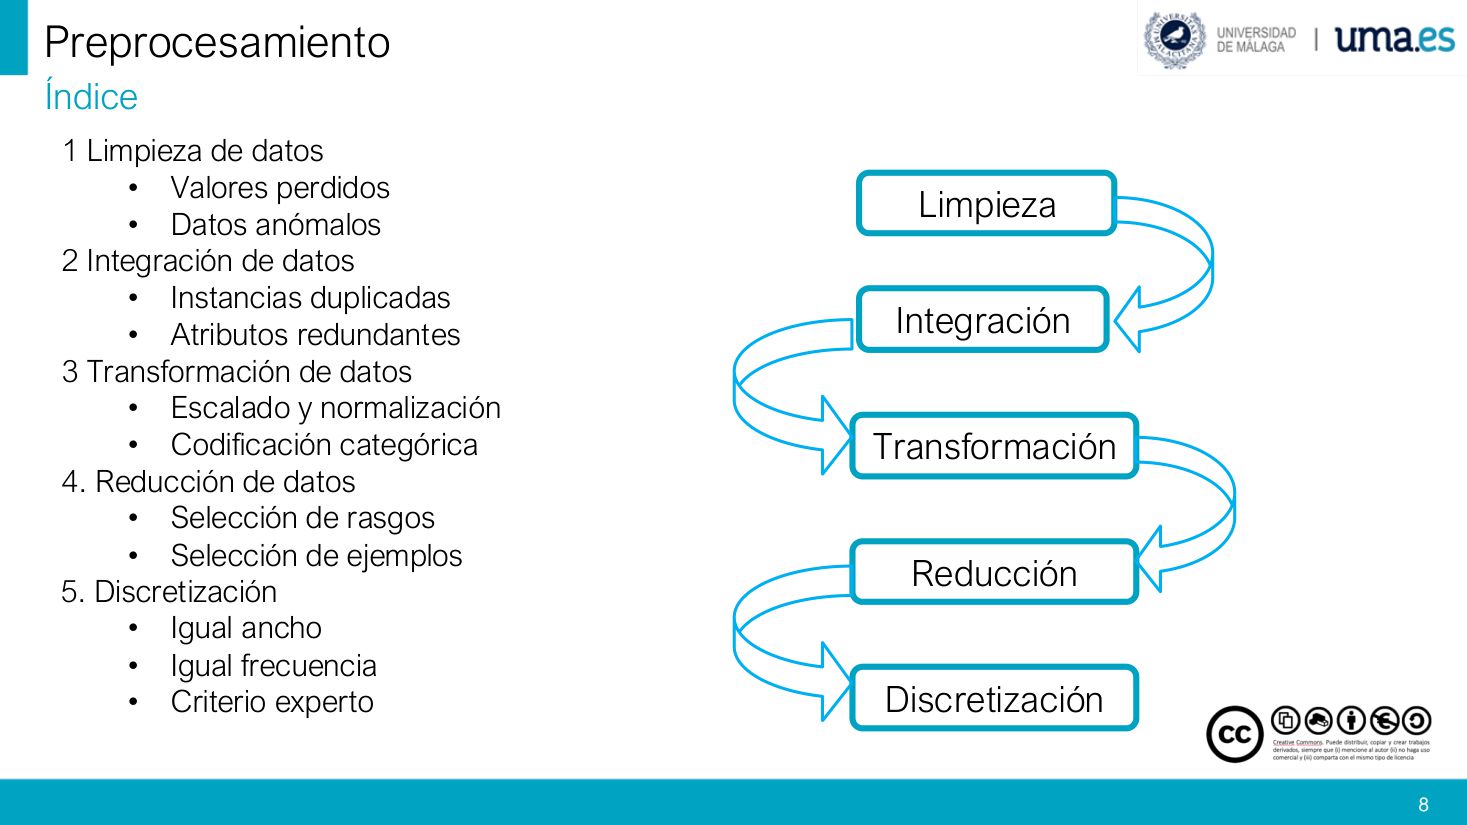
Índice
目录(本页是整章的路标,后面每一节都从这里展开)
| Etapa 阶段 | Sub-técnicas 子技术 |
|---|---|
| 1 Limpieza de datos 清洗 | Valores perdidos · Datos anómalos 缺失值 · 异常数据 |
| 2 Integración de datos 集成 | Instancias duplicadas · Atributos redundantes 重复实例 · 冗余属性 |
| 3 Transformación de datos 变换 | Escalado y normalización · Codificación categórica 缩放与规范化 · 类别编码 |
| 4. Reducción de datos 归约 | Selección de rasgos · Selección de ejemplos 特征选择 · 样本选择 |
| 5. Discretización 离散化 | Igual ancho · Igual frecuencia · Criterio experto 等宽 · 等频 · 专家准则 |
Etapas: ejemplo · 案例原表:三家来源合并后的营养诊所数据
▸ 原页截图 p.9
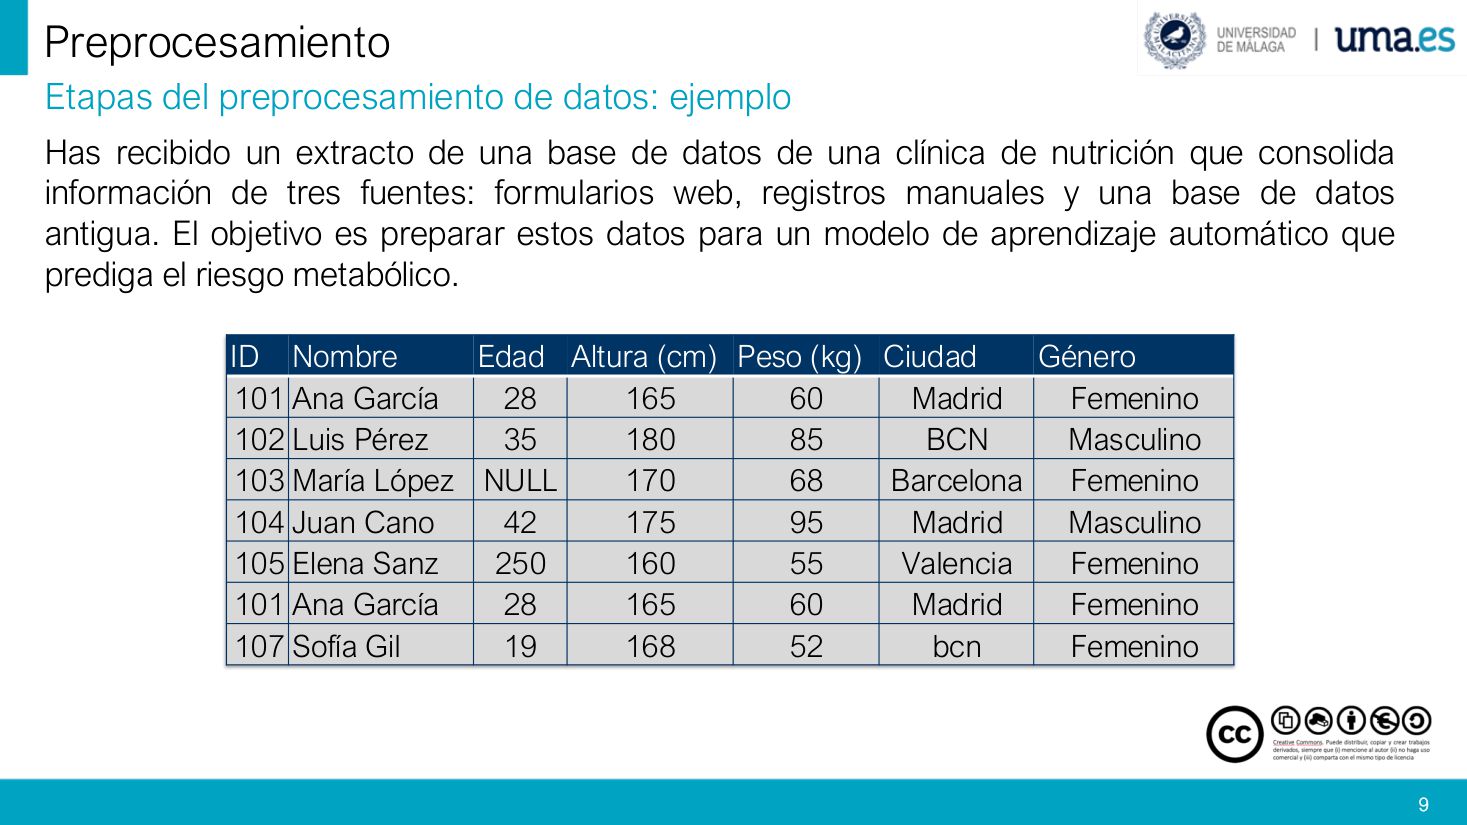
Has recibido un extracto de una base de datos de una clínica de nutrición que consolida información de tres fuentes: formularios web, registros manuales y una base de datos antigua.
你拿到了一份营养诊所数据库的摘录,它汇总了三个来源的信息:网页表单、手工登记、以及一个老数据库。
El objetivo es preparar estos datos para un modelo de aprendizaje automático que prediga el
目标是把这些数据整理好,交给一个预测
| ID | Nombre | Edad | Altura (cm) | Peso (kg) | Ciudad | Género |
|---|---|---|---|---|---|---|
| 101 | Ana García | 28 | 165 | 60 | Madrid | Femenino |
| 102 | Luis Pérez | 35 | 180 | 85 | BCN | Masculino |
| 103 | María López | NULL | 170 | 68 | Barcelona | Femenino |
| 104 | Juan Cano | 42 | 175 | 95 | Madrid | Masculino |
| 105 | Elena Sanz | 250 | 160 | 55 | Valencia | Femenino |
| 101 | Ana García | 28 | 165 | 60 | Madrid | Femenino |
| 107 | Sofía Gil | 19 | 168 | 52 | bcn | Femenino |
Etapas: ejemplo · 任务:按五阶段列出要做的动作
▸ 原页截图 p.10
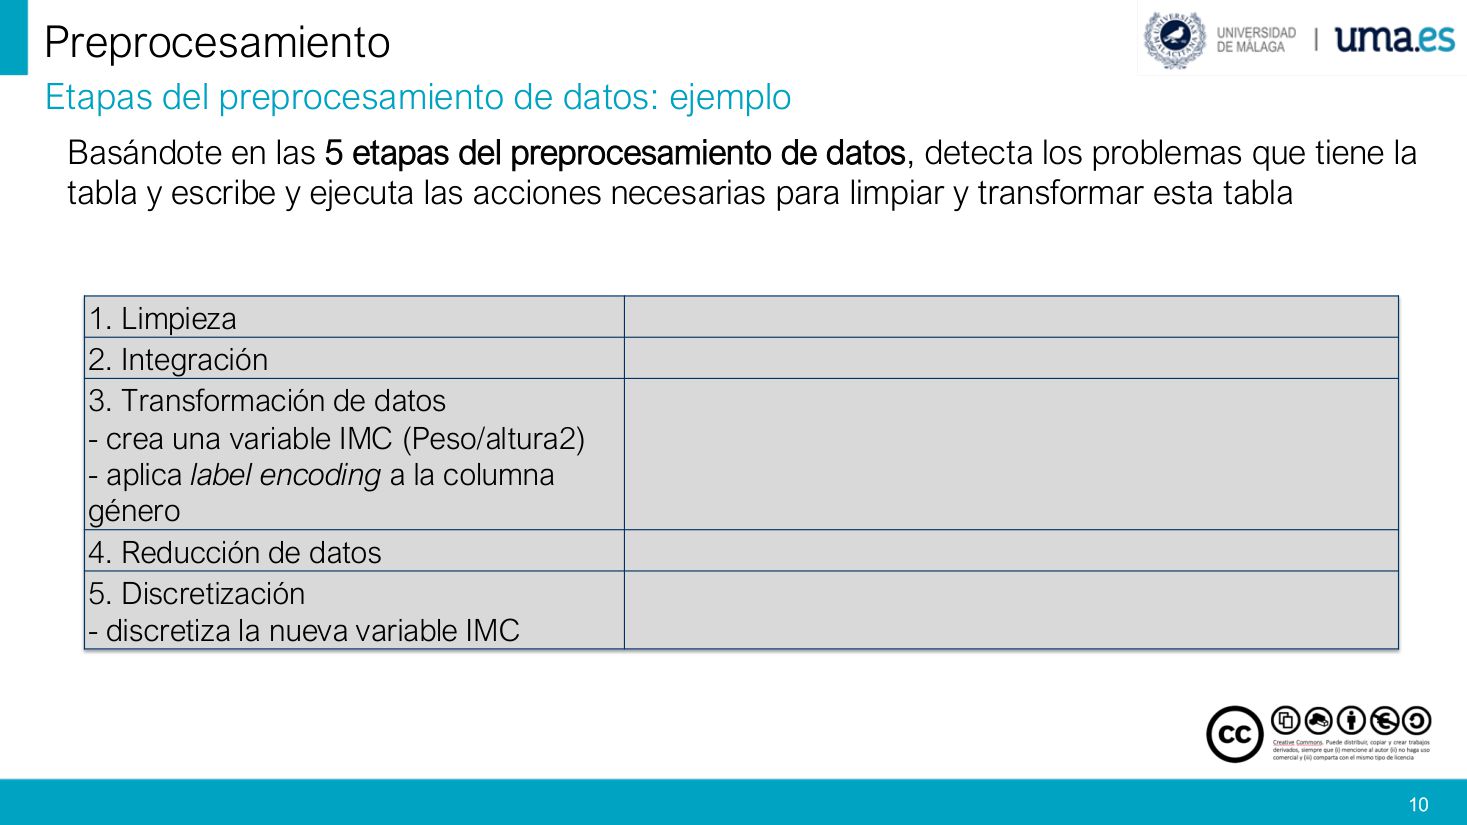
Basándote en las 5 etapas del preprocesamiento de datos, detecta los problemas que tiene la tabla y escribe y ejecuta las acciones necesarias para limpiar y transformar esta tabla
依据数据预处理的五个阶段,找出这张表存在的问题,并写出、执行必要的动作来清洗和变换这张表。
1. Limpieza
1. 清洗——(本页留白,答案在下一页)
2. Integración
2. 集成——(本页留白,答案在下一页)
3. Transformación de datos
• crea una variable
• aplica
3. 数据变换
• 构造一个
• 对 género(性别)列做
4. Reducción de datos
4. 数据归约——(本页留白,答案在下一页)
5. Discretización
• discretiza la nueva variable IMC
5. 离散化
• 把新造的 IMC 变量离散化
Etapas: ejemplo · 五阶段答案:删重、插补、改异、统一城市、造 IMC
▸ 原页截图 p.11
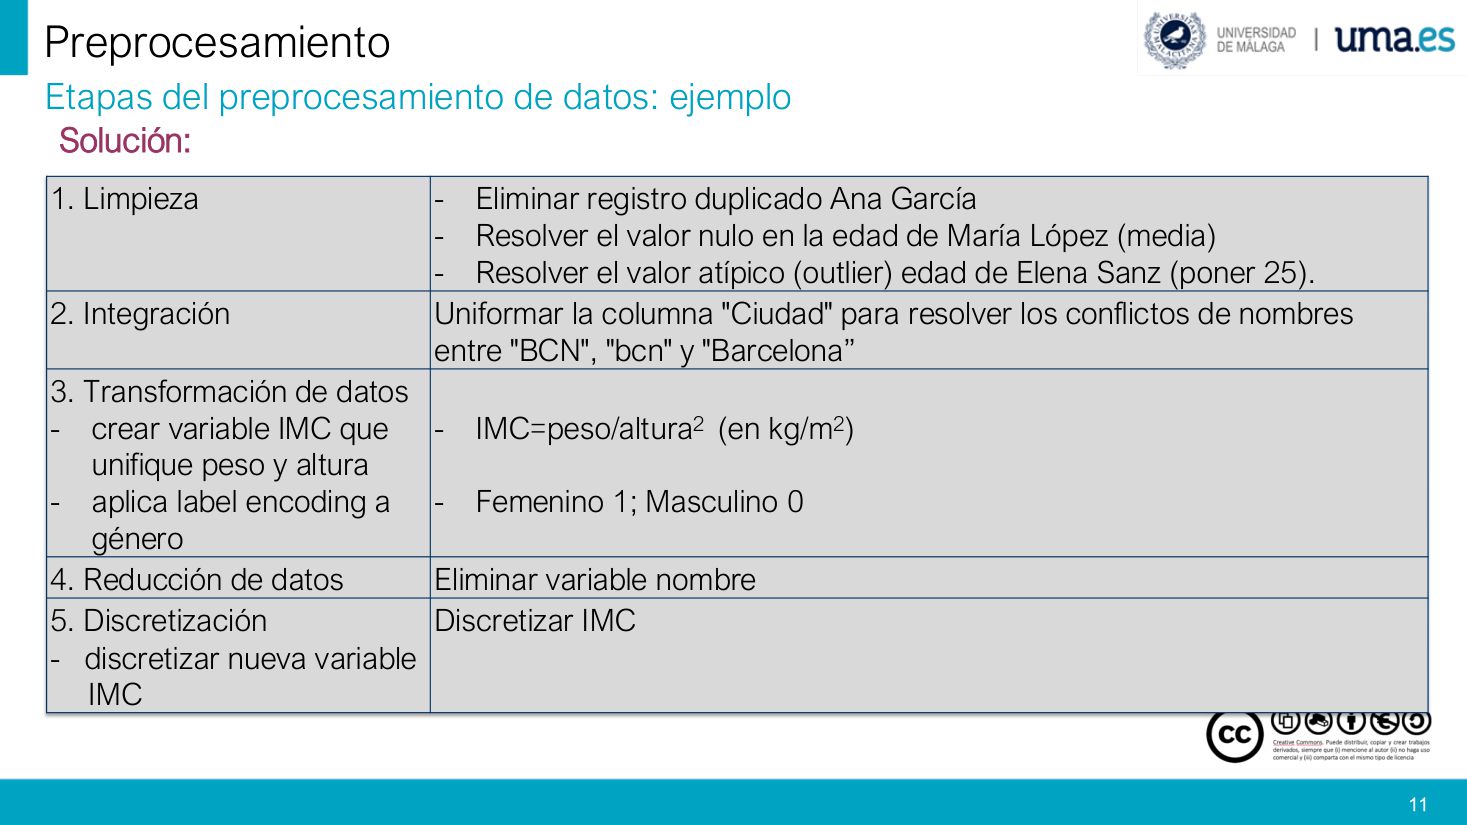
Solución:
解答:
1. Limpieza
- Eliminar registro duplicado Ana García
- Resolver el valor nulo en la edad de María López (
- Resolver el valor atípico (outlier) edad de Elena Sanz (poner 25).
1. 清洗
- 删除 Ana García 这条重复记录
- 处理 María López 年龄的
- 处理 Elena Sanz 年龄的
2. Integración
- Uniformar la columna "Ciudad" para resolver los conflictos de nombres entre "BCN", "bcn" y "Barcelona"
2. 集成
- 统一「Ciudad(城市)」列,解决 "BCN"、"bcn" 与 "Barcelona" 之间的命名冲突
3. Transformación de datos
- crear variable IMC que unifique peso y altura
- aplica label encoding a género
- IMC=peso/altura2 (en kg/m2)
- Femenino 1; Masculino 0
3. 数据变换
- 构造 IMC 变量,把体重与身高合并成一个指标
- 对性别做标签编码
- IMC = 体重 / 身高²(单位 kg/m²)
- 女 = 1;男 = 0
4. Reducción de datos
Eliminar variable nombre
4. 数据归约
删掉 nombre(姓名)变量
5. Discretización
- discretizar nueva variable IMC
5. 离散化
- 把新的 IMC 变量离散化(→ 低 / 正常 / 超重)
Etapas: ejemplo · 清洗后的最终表:6 行 × 5 列
▸ 原页截图 p.12
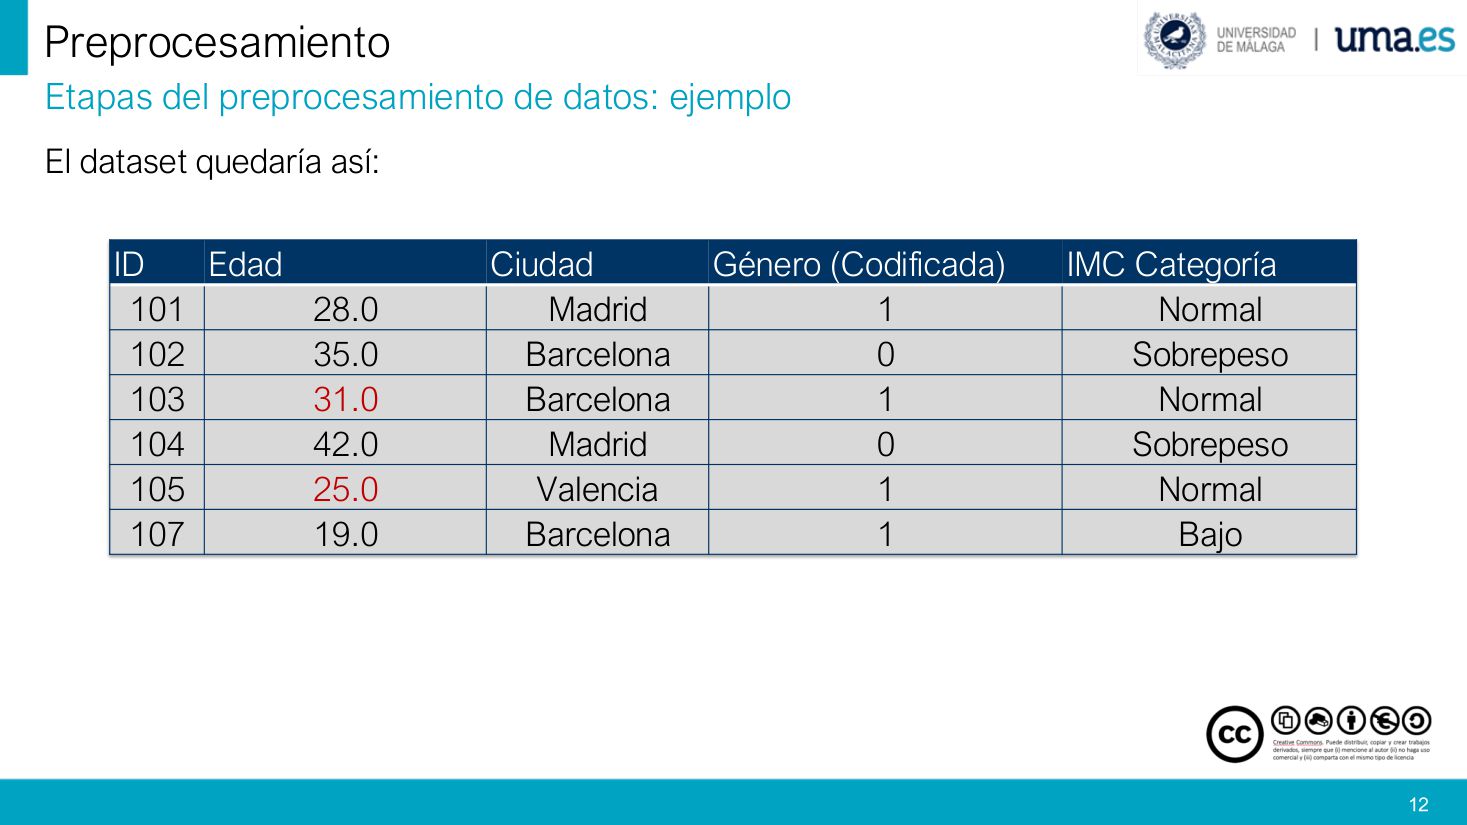
El dataset quedaría así:
数据集最后就变成这样:
| ID | Edad | Ciudad | Género (Codificada) | IMC Categoría |
|---|---|---|---|---|
| 101 | 28.0 | Madrid | 1 | Normal |
| 102 | 35.0 | Barcelona | 0 | Sobrepeso |
| 103 | 31.0 | Barcelona | 1 | Normal |
| 104 | 42.0 | Madrid | 0 | Sobrepeso |
| 105 | 25.0 | Valencia | 1 | Normal |
| 107 | 19.0 | Barcelona | 1 | Bajo |
Etapas: ejemplo propuesto · 练习表 201–208:自己动手挑毛病
▸ 原页截图 p.13
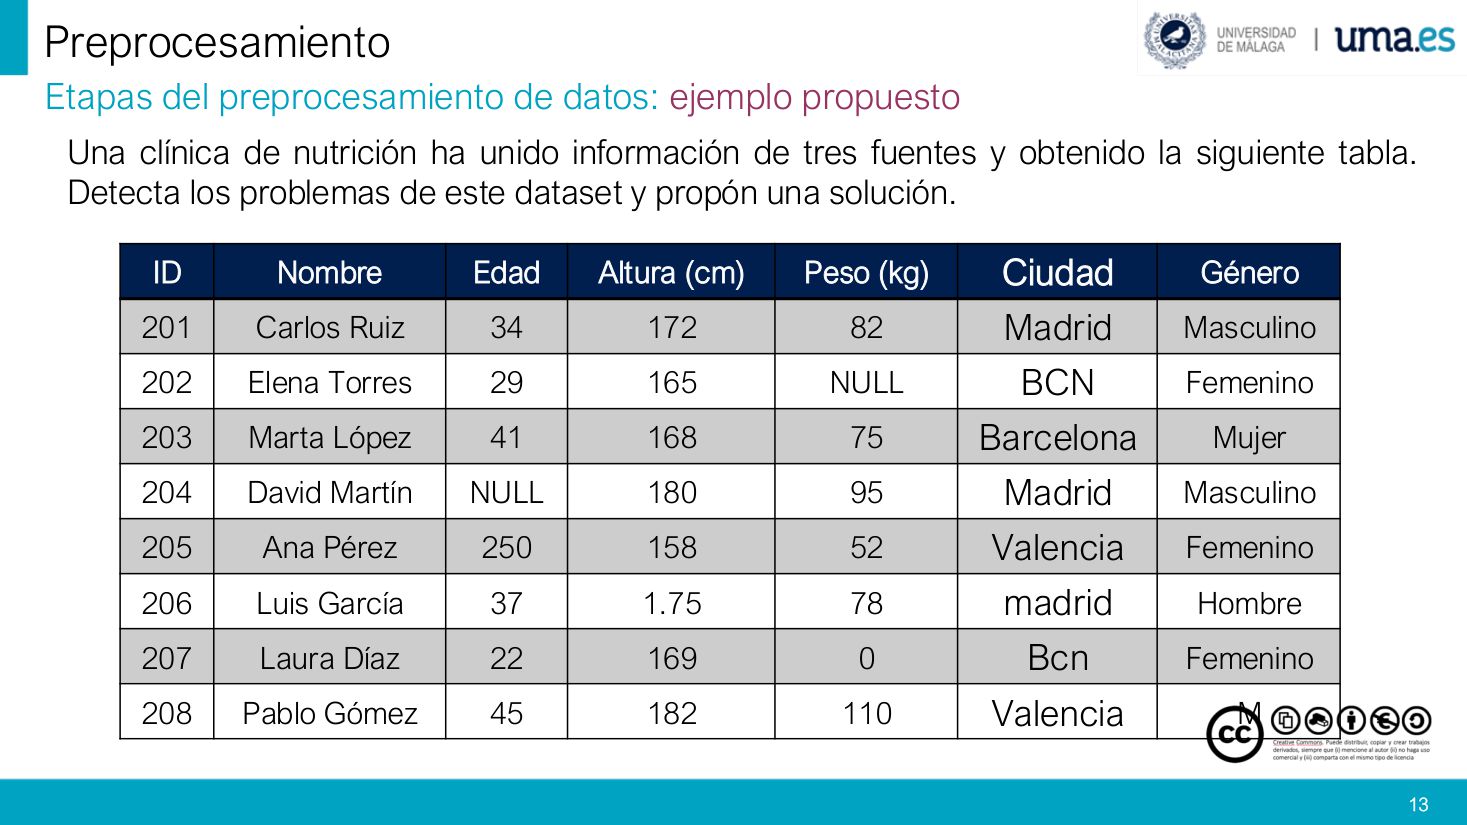
Una clínica de nutrición ha unido información de tres fuentes y obtenido la siguiente tabla.
一家营养诊所把三个来源的信息合并起来,得到了下面这张表。
Detecta los problemas de este dataset y propón una solución.
找出这个数据集的问题,并提出一个解决方案。
| ID | Nombre | Edad | Altura (cm) | Peso (kg) | Ciudad | Género |
|---|---|---|---|---|---|---|
| 201 | Carlos Ruiz | 34 | 172 | 82 | Madrid | Masculino |
| 202 | Elena Torres | 29 | 165 | NULL | BCN | Femenino |
| 203 | Marta López | 41 | 168 | 75 | Barcelona | Mujer |
| 204 | David Martín | NULL | 180 | 95 | Madrid | Masculino |
| 205 | Ana Pérez | 250 | 158 | 52 | Valencia | Femenino |
| 206 | Luis García | 37 | 1.75 | 78 | madrid | Hombre |
| 207 | Laura Díaz | 22 | 169 | 0 | Bcn | Femenino |
| 208 | Pablo Gómez | 45 | 182 | 110 | Valencia | M |
三、1. Limpieza de datos:缺失值的三条出路
p.14–p.341. Limpieza de datos · 第一节分隔页(印刷页 16)
▸ 原页截图 p.14
1. Limpieza de datos
1. 数据清洗(整章第一大节的标题页)
1. Limpieza de datos · 定义与四个关键问题
▸ 原页截图 p.15
La
Su objetivo principal es detectar y corregir errores, inconsistencias y datos faltantes en el conjunto de información original para evitar resultados
它的主要目标是在原始数据集中发现并纠正错误、不一致与缺失数据,以避免产生
Problemas clave:
关键问题:
•
•
•
•
• Manejo de
• 处理
• Detección de
• 检测
1.1 Tratamiento de valores perdidos · 1.1 节标题页(印刷页 18)
▸ 原页截图 p.16
1.1 Tratamiento de valores perdidos
1.1 缺失值的处理(本小节从 p.17 讲到 p.34,是全章篇幅最大的一块)
1.1 缺失值 · 问题从哪来:人为、传感器、当时不存在
▸ 原页截图 p.17
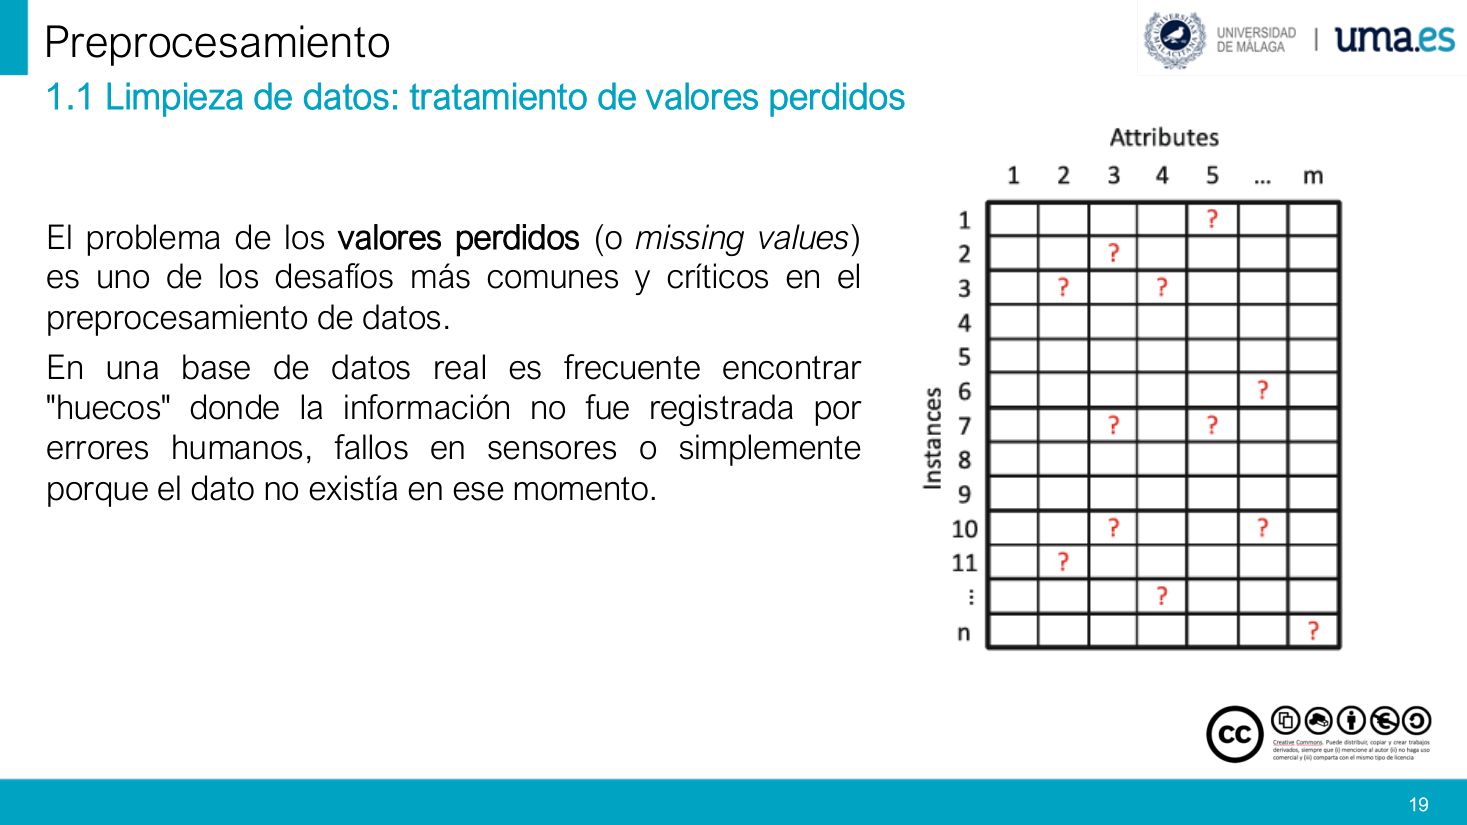
El problema de los
En una base de datos real es frecuente encontrar "huecos" donde la información no fue registrada por errores humanos, fallos en sensores o simplemente porque el dato no existía en ese momento.
在真实数据库里经常能看到「空洞」:信息没被登记下来,原因可能是人为失误、传感器故障,或者干脆当时这个数据并不存在。
1.1 缺失值 · 三条出路:删除、简单插补、模型插补
▸ 原页截图 p.18
Para resolver esto, existen tres alternativas principales:
要解决这个问题,主要有三条出路:
a) Eliminación: Borrar registros o variables incompletas.
a) 删除:把不完整的记录或变量直接删掉。
b) Imputación Simple: Rellenar el hueco con una medida estadística como el promedio, la mediana o la moda.
b) 简单插补:用一个统计量把洞填上——均值、中位数或众数。
c) Imputación Basada en Modelos: Usar modelos que, basándose en la información disponible, puedan predecir qué número debería ir en ese espacio vacío
c) 基于模型的插补:用模型,依据已有信息去
a. Eliminación · 删行:5% 经验规则与两大风险
▸ 原页截图 p.19
a. Eliminación (Discarding)
a. 删除法(Discarding)
Es la solución más drástica y su ventaja es que es sencilla de implementar. Se pueden eliminar filas o columnas.
这是最激进的做法,优点是实现简单。可以删行,也可以删列。
a.1. Eliminación de Instancias (Filas): Si hay algún o algunos valores perdidos, se elimina la fila. Como regla orientativa, en algunos contextos prácticos no se recomienda eliminar más del 5%.
a.1 删除实例(行):只要有缺失值,就把整行删掉。作为经验法则,在一些实际场景中不建议删掉超过 5%。
Cuidado con:
要小心两点:
- La pérdida de
-
- El
-
a.2 Eliminación de atributos · 删列,以及「死亡日期缺 65%」的提问
▸ 原页截图 p.20
a. Eliminación (Discarding) · a.2 Eliminación de Atributos (columnas)
a. 删除法 · a.2 删除属性(列)
Se elimina una columna cuando tiene valores faltantes
当一列存在缺失值时,就把这一列删掉。
Si hay muchos valores faltantes en una columna, intentar "rellenar" (imputar) implica que la mayor parte de los datos serían "inventados" por un algoritmo, lo que introduce más
如果一列里缺失值太多,强行「填补」意味着大部分数据都是算法「编」出来的,这会引入比真实信息更多的
Pregunta · Supongamos que tenemos una columna "fecha de defunción" con un 65% de valores faltantes. ¿Qué harías?
提问:假设有一列「死亡日期」,缺失率高达 65%,你会怎么做?
b) Imputación Simple · 众数 / 均值 / 中位数,以及体重数列的提问
▸ 原页截图 p.21
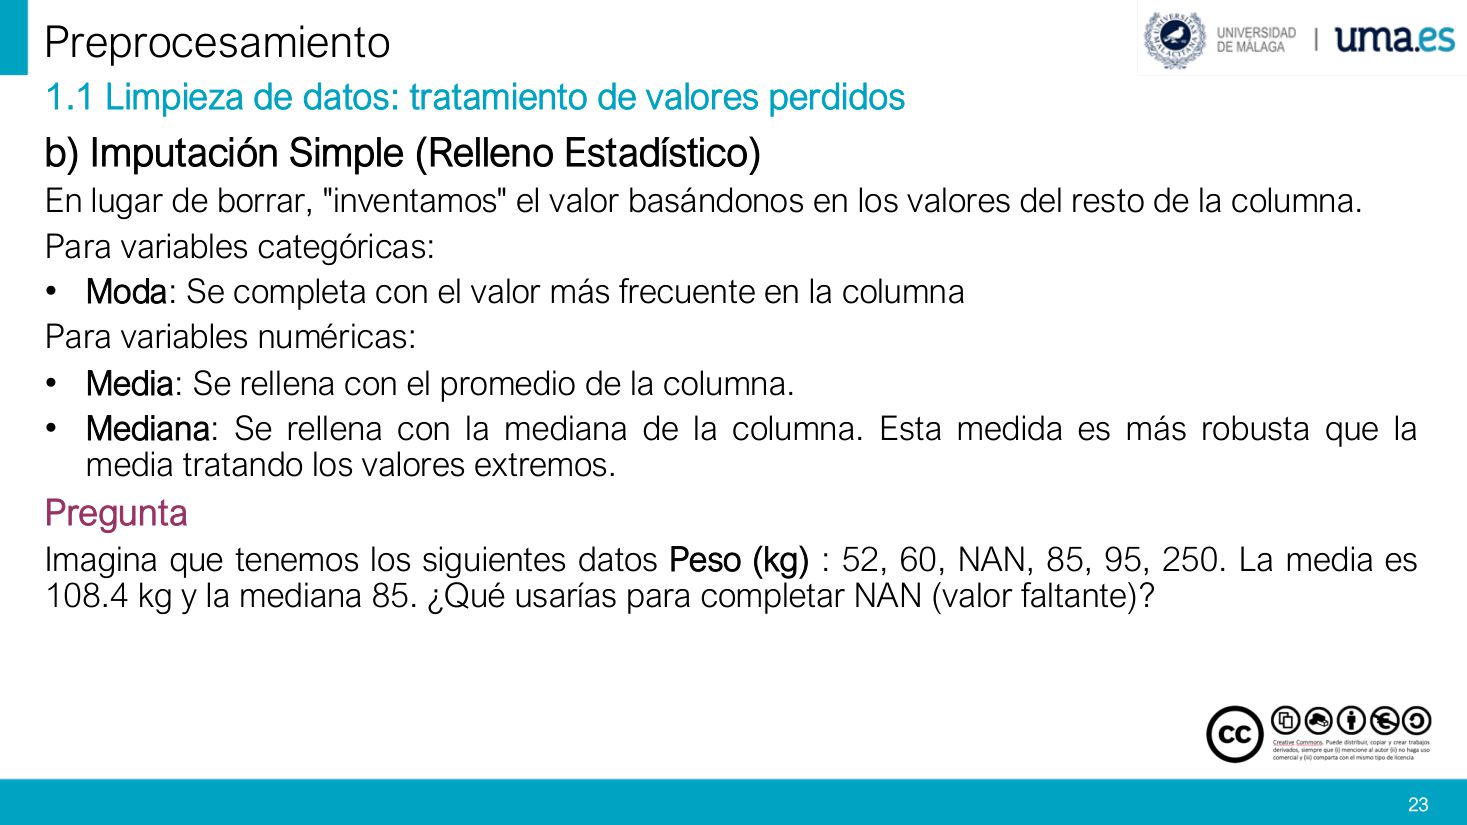
b) Imputación Simple (Relleno Estadístico)
b) 简单插补(用统计量填洞)
En lugar de borrar, "inventamos" el valor basándonos en los valores del resto de la columna.
我们不删,而是参照这一列其余的值,把缺失值「编」出来。
Para variables categóricas: • Moda: Se completa con el valor más frecuente en la columna
对
Para variables numéricas: • Media: Se rellena con el promedio de la columna.
对数值变量:• 均值(Media):用该列的平均值来填。
• Mediana: Se rellena con la mediana de la columna. Esta medida es más
• 中位数(Mediana):用该列的中位数来填。这个统计量在处理极端值时比均值更
Pregunta · Imagina que tenemos los siguientes datos Peso (kg): 52, 60, NAN, 85, 95, 250. La media es 108.4 kg y la mediana 85. ¿Qué usarías para completar NAN (valor faltante)?
提问:现有体重数据 52、60、NAN、85、95、250,均值是 108.4 kg,中位数是 85。你会用哪个数来补 NAN?
c. Imputación Basada en modelos (Estimación) · c. 模型插补 · 回归看「身高年龄」推体重;k-NN 抄「相似邻居」
▸ 原页截图 p.22
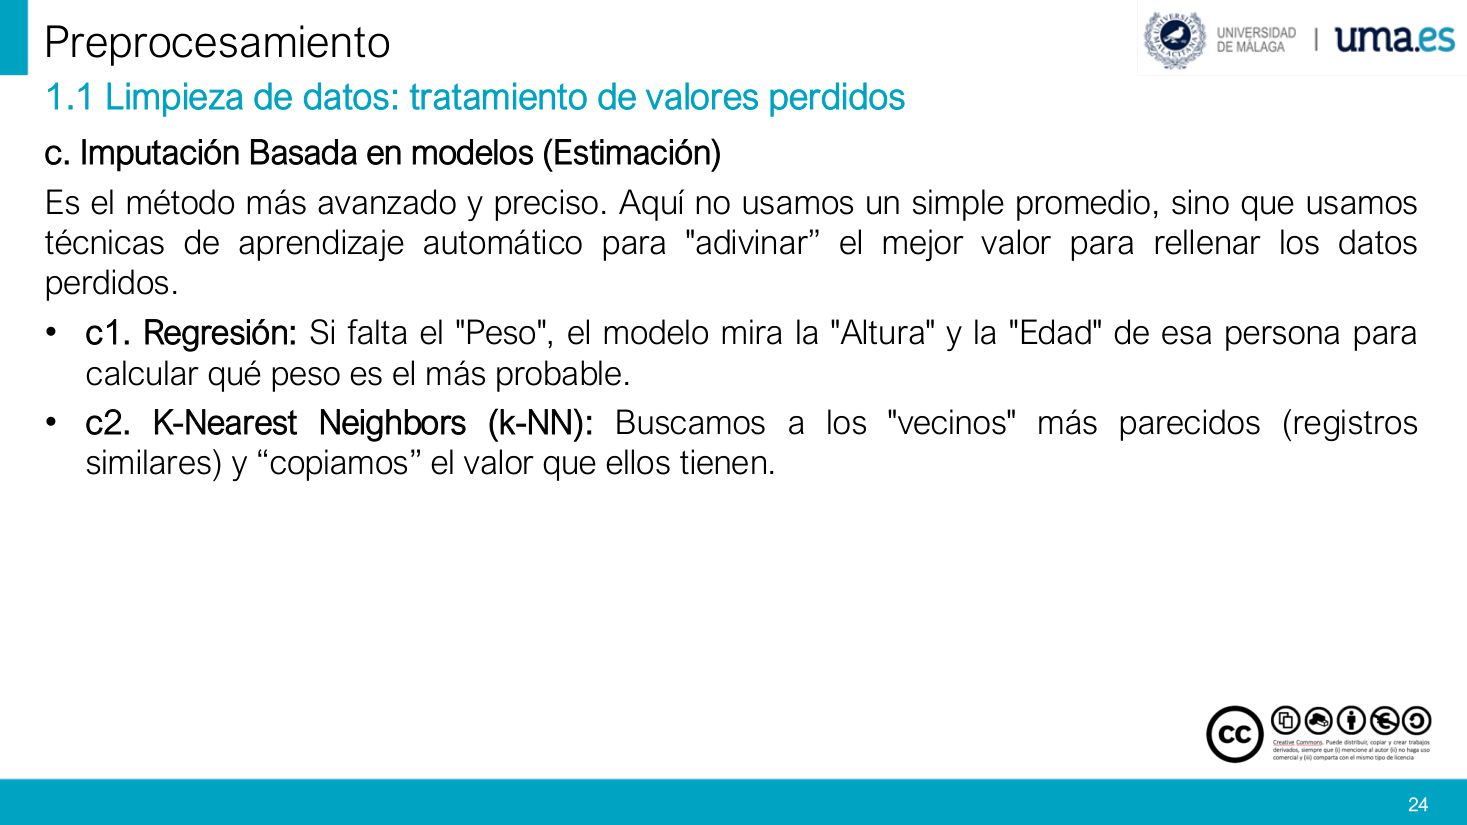
c. Imputación Basada en modelos (Estimación)
c. 基于模型的插补(估计法)
Es el método más avanzado y preciso. Aquí no usamos un simple promedio, sino que usamos técnicas de
这是最先进、最精确的方法。这里不用一个简单的平均值,而是用
• c1. Regresión: Si falta el "Peso", el modelo mira la "Altura" y la "Edad" de esa persona para calcular qué peso es el más probable.
• c1. 回归:如果缺的是「体重」,模型就看这个人的「身高」和「年龄」,算出最可能的体重。
• c2. K-Nearest Neighbors (k-NN): Buscamos a los "vecinos" más parecidos (registros similares) y "copiamos" el valor que ellos tienen.
• c2. K 近邻(k-NN):找出最像的「邻居」(相似记录),把它们的值「抄」过来。
c.1 Imputación por regresión · 线性回归式与「个性化 vs 一刀切」
▸ 原页截图 p.23
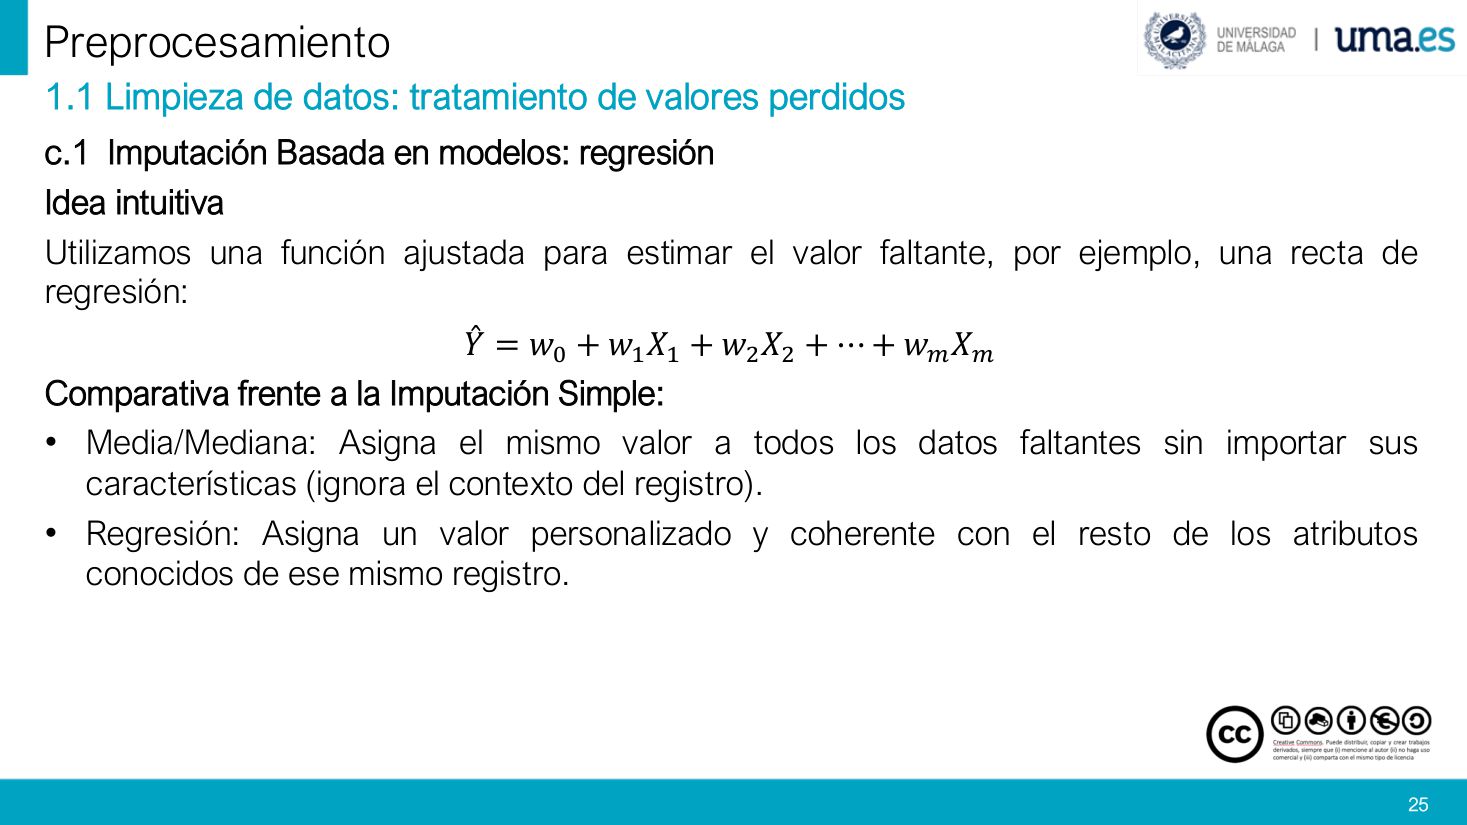
c.1 Imputación Basada en modelos: regresión
c.1 基于模型的插补:回归
Idea intuitiva · Utilizamos una función ajustada para estimar el valor faltante, por ejemplo, una recta de regresión:
直观想法:我们用一个拟合好的函数来估计缺失值,例如一条回归直线:
| 符号 | 西语读法 | 中文含义 |
|---|---|---|
| Ŷ | «Y gorro» / «Y estimada» | 预测值(要补的那个体重) |
| w0 | «w sub cero» / «término independiente» | 截距:所有属性都为 0 时的基准值 |
| wi | «w sub i» / «coeficiente» o «peso» | 第 i 个属性的权重(每 1 kg 身高 / 每 1 岁年龄值多少 kg) |
| Xi | «X sub i» / «atributo conocido» | 该记录已知的属性值(如身高、年龄) |
| m | «eme» / «número de atributos» | 参与预测的属性个数 |
Comparativa frente a la Imputación Simple:
与简单插补的对比:
• Media/Mediana: Asigna el mismo valor a todos los datos faltantes sin importar sus características (ignora el contexto del registro).
• 均值 / 中位数:给所有缺失值同一个数,不管它们各自的属性(忽略了该条记录的上下文)。
• Regresión: Asigna un valor personalizado y coherente con el resto de los atributos conocidos de ese mismo registro.
• 回归:给出一个「个性化」的值,与该条记录其他已知属性保持自洽。
1.1 例:房价表 · 用回归直线反推「几间房」与「多少平米」
▸ 原页截图 p.24
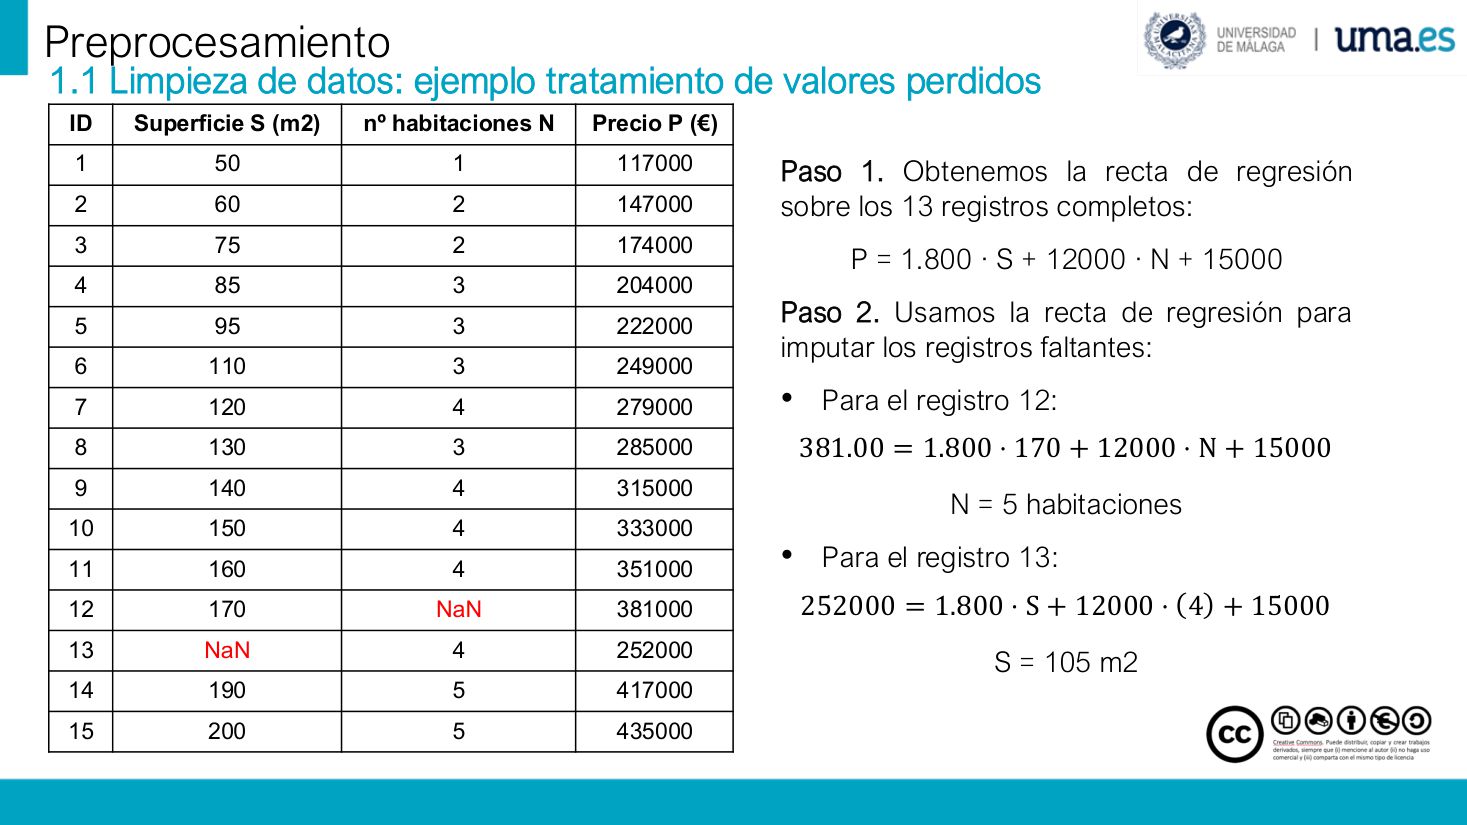
Paso 1. Obtenemos la recta de regresión sobre los 13 registros completos:
第 1 步:在 13 条完整记录上拟合出回归直线:
| 符号 | 西语读法 | 中文含义 |
|---|---|---|
| P | «pe» / «precio» | 房价(€),因变量 |
| S | «ese» / «superficie en metros cuadrados» | 面积(m²) |
| N | «ene» / «número de habitaciones» | 房间数 |
| 1.800 | «mil ochocientos» | 每平方米的单价(€/m²) |
| 12.000 | «doce mil» | 每多一间房的加价(€/间) |
| 15.000 | «quince mil» | 截距:面积为 0、房间为 0 时的基准价 |
Paso 2. Usamos la recta de regresión para imputar los registros faltantes:
第 2 步:用这条回归直线去插补缺失的记录:
• Para el registro 12: 381.00 = 1.800 · 170 + 12000 · N + 15000 → N = 5 habitaciones
• 对第 12 条记录:381 000 = 1 800 × 170 + 12 000 × N + 15 000 → N = 5 间房
• Para el registro 13: 252000 = 1.800 · S + 12000 · 4 + 15000 → S = 105 m2
• 对第 13 条记录:252 000 = 1 800 × S + 12 000 × 4 + 15 000 → S = 105 m²
| ID | Superficie S (m²) | nº habitaciones N | Precio P (€) |
|---|---|---|---|
| 1 | 50 | 1 | 117000 |
| 2 | 60 | 2 | 147000 |
| 3 | 75 | 2 | 174000 |
| 4 | 85 | 3 | 204000 |
| 5 | 95 | 3 | 222000 |
| 6 | 110 | 3 | 249000 |
| 7 | 120 | 4 | 279000 |
| 8 | 130 | 3 | 285000 |
| 9 | 140 | 4 | 315000 |
| 10 | 150 | 4 | 333000 |
| 11 | 160 | 4 | 351000 |
| 12 | 170 | NaN | 381000 |
| 13 | NaN | 4 | 252000 |
| 14 | 190 | 5 | 417000 |
| 15 | 200 | 5 | 435000 |
c2. Imputación basada en modelos: k-vecinos más próximos (K-Nearest Neighbors o k-NN) · c2 k-NN · 怎么量「两行有多像」:相对差 + 类别 0/1
▸ 原页截图 p.25
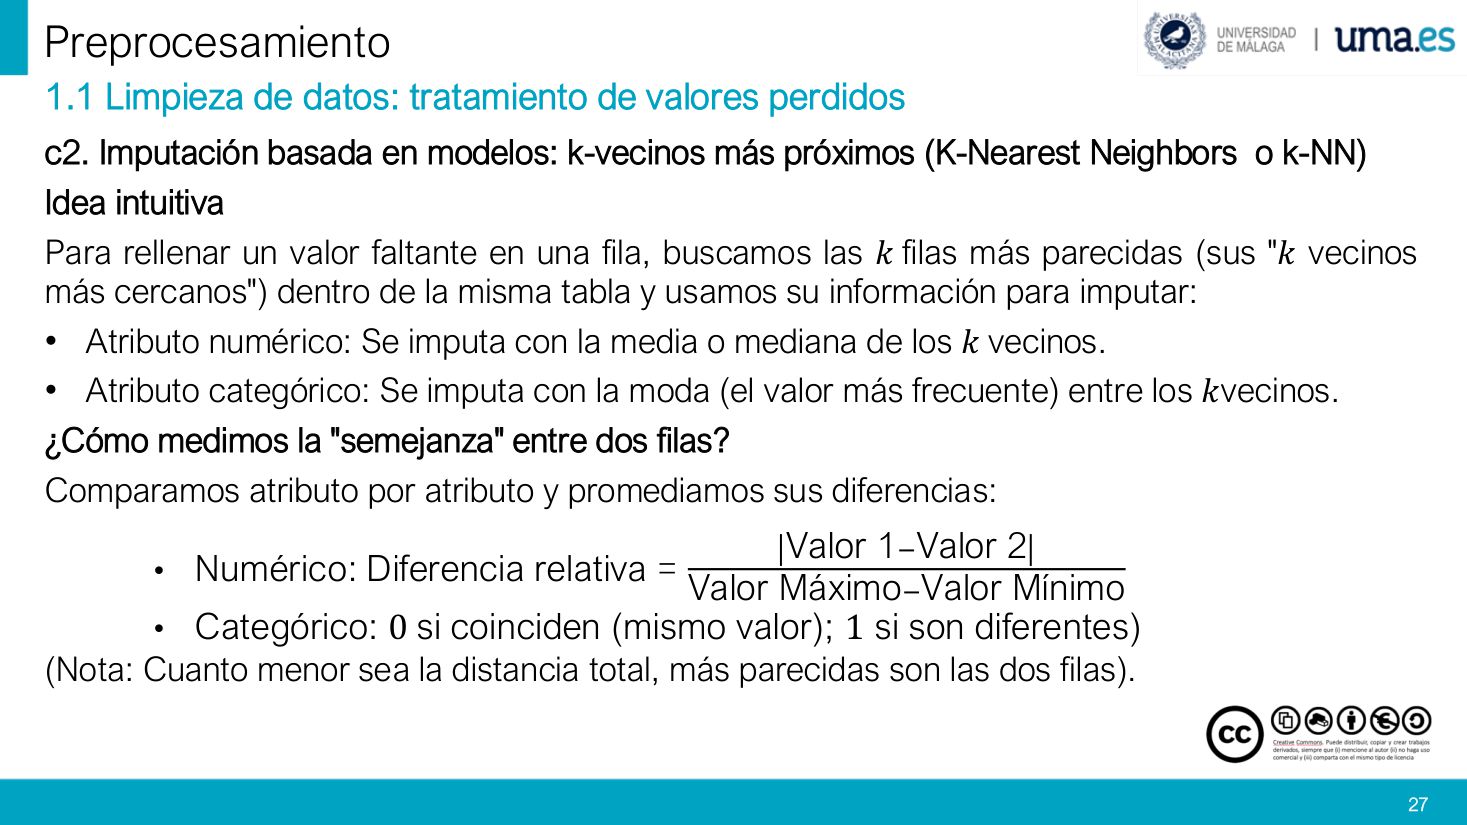
c2. Imputación basada en modelos: k-vecinos más próximos (K-Nearest Neighbors o k-NN)
c2. 基于模型的插补:k 近邻(K-Nearest Neighbors,k-NN)
Idea intuitiva · Para rellenar un valor faltante en una fila, buscamos las k filas más parecidas (sus "k vecinos más cercanos") dentro de la misma tabla y usamos su información para imputar:
直观想法:要补某一行的缺失值,就在同一张表里找出最像的 k 行(它的「k 个最近邻」),用这些邻居的信息来插补:
• Atributo numérico: Se imputa con la media o mediana de los k vecinos.
• 数值属性:用这 k 个邻居的均值或中位数插补。
• Atributo categórico: Se imputa con la moda (el valor más frecuente) entre los k vecinos.
• 类别属性:用这 k 个邻居中的众数(出现最多的取值)插补。
¿Cómo medimos la "semejanza" entre dos filas? Comparamos atributo por atributo y promediamos sus diferencias:
怎么衡量两行的「相似度」?逐个属性比较,再把差异取平均:
• Numérico: Diferencia relativa = (Valor 1 − Valor 2) / (Valor Máximo − Valor Mínimo)
• 数值型:相对差 = (值 1 − 值 2)/(该列最大值 − 最小值)
| 符号 | 西语读法 | 中文含义 |
|---|---|---|
| dnum | «diferencia relativa» | 该数值属性上的「相对差」,落在 0–1 之间 |
| V1, V2 | «valor uno, valor dos» | 两条记录在该属性上的取值 |
| Vmáx − Vmín | «rango» / «valor máximo menos mínimo» | 该列的极差(全表该列的取值范围) |
| |·| | «valor absoluto» | 绝对值:保证距离不为负(原文遗漏,见下) |
• Categórico: 0 si coinciden (mismo valor); 1 si son diferentes
• 类别型:相同取 0,不同取 1
(Nota: Cuanto menor sea la distancia total, más parecidas son las dos filas).
(注:总距离越小,两行越相似。)
1.1 Limpieza de datos: tratamiento de valores perdidos · c2. Imputación k-NN · k-NN 例 · 给 5 号会员补「运动项目」:算出 5 个距离,邻居是 1 和 3
▸ 原页截图 p.26
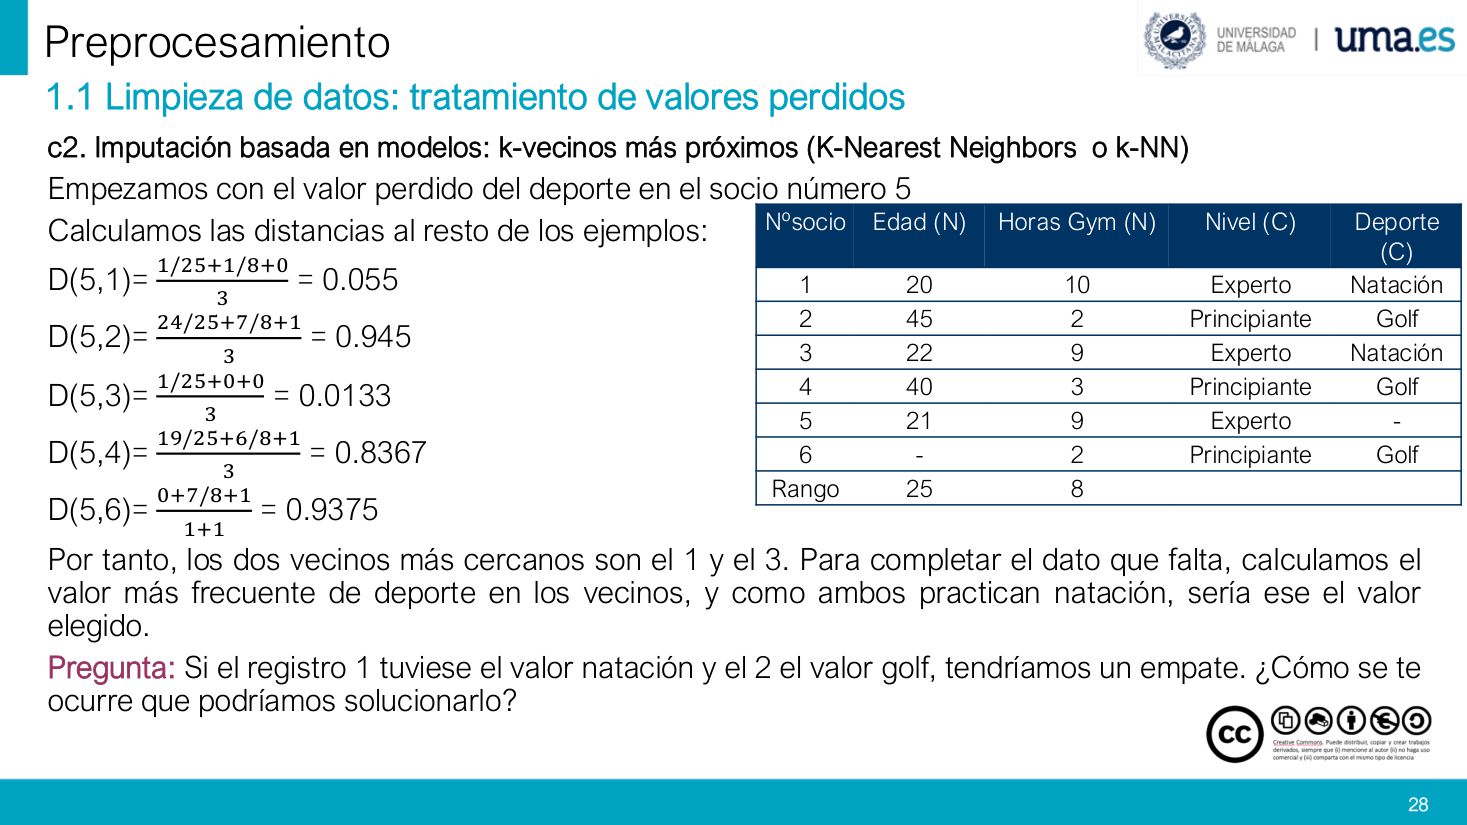
Empezamos con el valor perdido del deporte en el socio número 5
先处理 5 号会员「运动项目」的缺失值。
Calculamos las distancias al resto de los ejemplos:
计算它到其余各样本的距离:
D(5,1) = (1/25 + 1/8 + 0) / 3 = 0.055
D(5,1) =(年龄差 1/25 + 健身时长差 1/8 + 等级相同 0)÷ 3 = 0.055
D(5,2) = (24/25 + 7/8 + 1) / 3 = 0.945
D(5,2) =(24/25 + 7/8 + 等级不同 1)÷ 3 = 0.945
D(5,3) = (1/25 + 0 + 0) / 3 = 0.0133
D(5,3) =(1/25 + 0 + 0)÷ 3 = 0.0133
D(5,4) = (19/25 + 6/8 + 1) / 3 = 0.8367
D(5,4) =(19/25 + 6/8 + 1)÷ 3 = 0.8367
D(5,6) = (0 + 7/8 + 1) / (1 + 1) = 0.9375
D(5,6) =(0 + 7/8 + 1)÷(1+1)= 0.9375 — 6 号的年龄也缺失,故只比两个属性,分母为 2
Por tanto, los dos vecinos más cercanos son el 1 y el 3. Para completar el dato que falta, calculamos el valor más frecuente de deporte en los vecinos, y como ambos practican natación, sería ese el valor elegido.
因此最近的两个邻居是 1 号和 3 号。用邻居中最常见的运动项目来补:两人都练游泳(natación),所以补「游泳」。
Pregunta: Si el registro 1 tuviese el valor natación y el 2 el valor golf, tendríamos un empate. ¿Cómo se te ocurre que podríamos solucionarlo?
提问:如果 1 号是游泳、2 号是高尔夫,就会出现平票。你觉得该怎么解决?
| Nº socio | Edad (N) | Horas Gym (N) | Nivel (C) | Deporte (C) |
|---|---|---|---|---|
| 1 | 20 | 10 | Experto | Natación |
| 2 | 45 | 2 | Principiante | Golf |
| 3 | 22 | 9 | Experto | Natación |
| 4 | 40 | 3 | Principiante | Golf |
| 5 | 21 | 9 | Experto | — |
| 6 | — | 2 | Principiante | Golf |
| Rango | 25 | 8 | — | — |
c2. Imputación k-NN · Ejercicio · k-NN 练习 · 给 6 号会员补「年龄」:五个距离自己算
▸ 原页截图 p.27
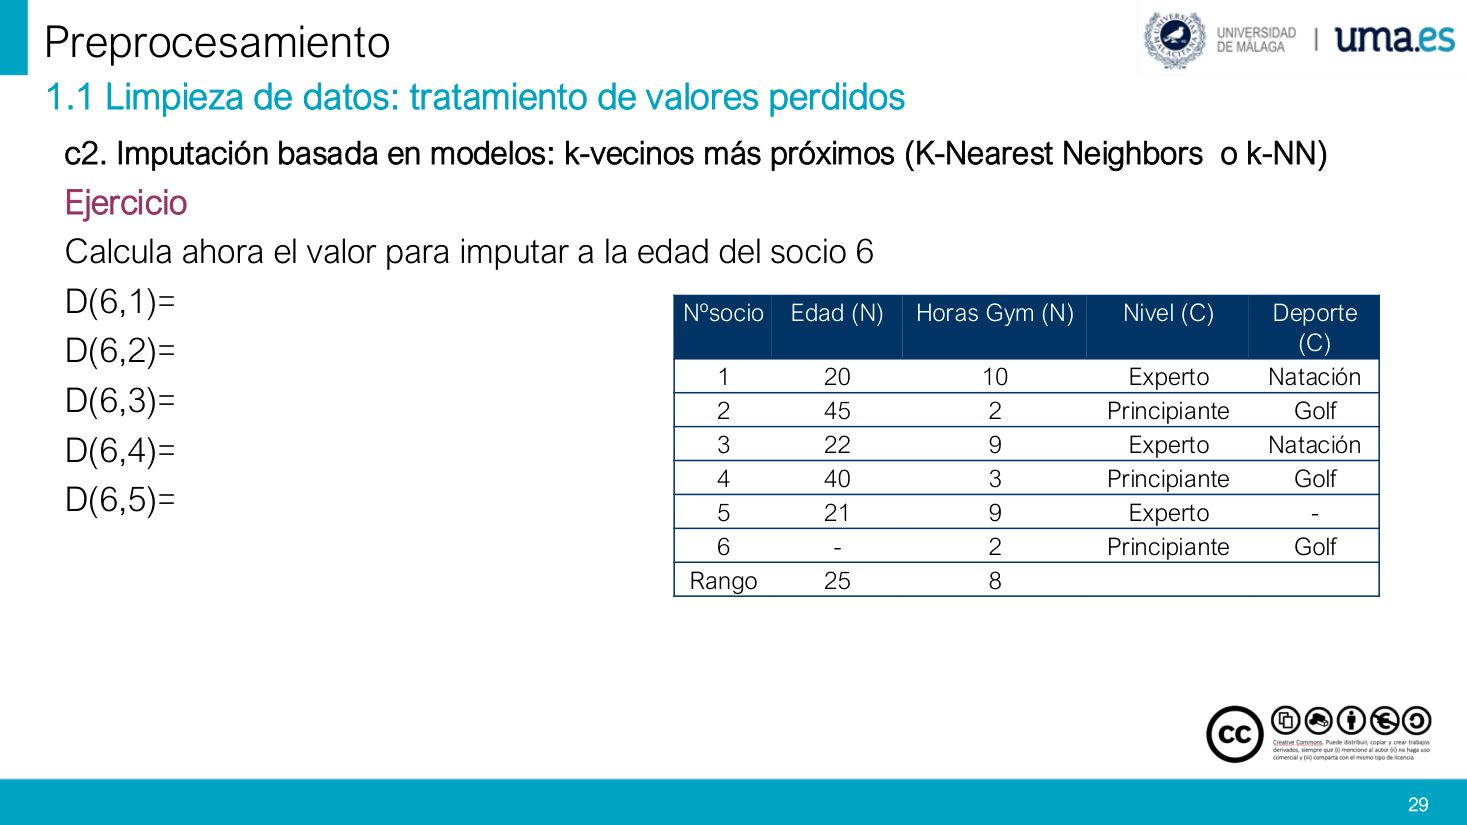
Ejercicio · Calcula ahora el valor para imputar a la edad del socio 6
练习:现在请你算出 6 号会员年龄的插补值。
D(6,1)= D(6,2)= D(6,3)= D(6,4)= D(6,5)=
五个距离待填:D(6,1)、D(6,2)、D(6,3)、D(6,4)、D(6,5)
c. Imputación k-NN · Ejercicio (solución) · k-NN 练习解答 · 五个距离 1.000 / 0.000 / 0.958 / 0.042 / 0.937 → 42.5 岁
▸ 原页截图 p.28
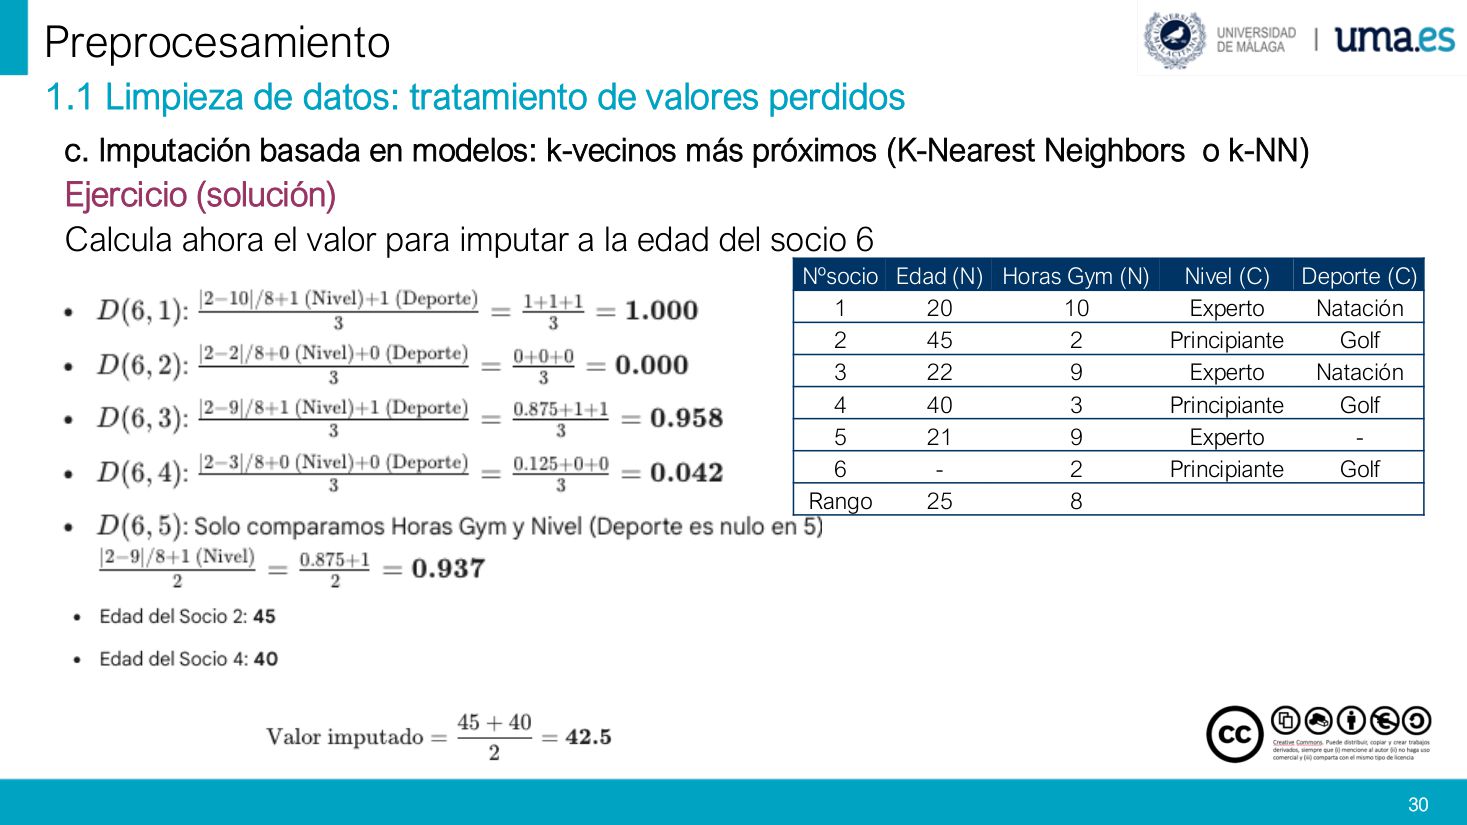
Ejercicio (solución) · Calcula ahora el valor para imputar a la edad del socio 6
练习(解答):算出 6 号会员年龄的插补值。
D(6,1): (|2−10|/8 + 1 (Nivel) + 1 (Deporte)) / 3 = (1+1+1)/3 = 1.000
D(6,1):(|2−10|/8 + 等级差 1 + 项目差 1)÷ 3 = 3/3 = 1.000
D(6,2): (|2−2|/8 + 0 (Nivel) + 0 (Deporte)) / 3 = 0/3 = 0.000
D(6,2):(|2−2|/8 + 等级同 0 + 项目同 0)÷ 3 = 0.000
D(6,3): (|2−9|/8 + 1 + 1) / 3 = (0.875+1+1)/3 = 0.958
D(6,3):(|2−9|/8 + 1 + 1)÷ 3 = 2.875/3 = 0.958
D(6,4): (|2−3|/8 + 0 + 0) / 3 = (0.125+0+0)/3 = 0.042
D(6,4):(|2−3|/8 + 0 + 0)÷ 3 = 0.042
D(6,5): Solo comparamos Horas Gym y Nivel (Deporte es nulo en 5) · (|2−9|/8 + 1) / 2 = 0.937
D(6,5):只比健身时长与等级(5 号的项目为空)·(|2−9|/8 + 1)÷ 2 = 0.937
• Edad del Socio 2: 45 • Edad del Socio 4: 40
• 2 号会员年龄:45 • 4 号会员年龄:40
Valor imputado = (45 + 40) / 2 = 42.5
插补值 =(45 + 40)÷ 2 = 42.5(岁)
1.1 练习 · 房价新表:4 处缺失 P1–P4(印刷页 31)
▸ 原页截图 p.29
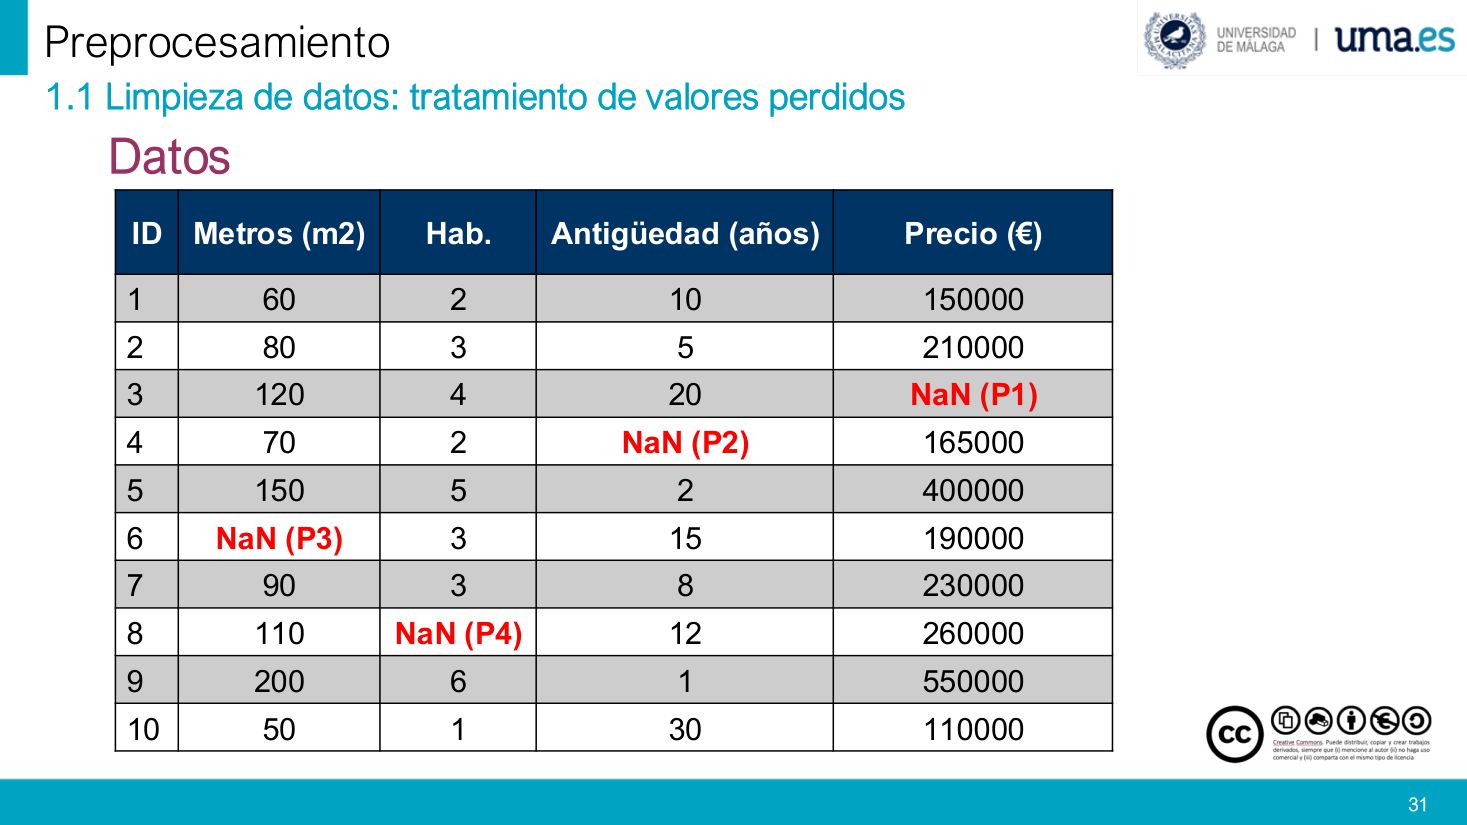
Datos
数据(接下来 p.30–p.34 会分别用四种方法把这 4 个 NaN 补上,结果对比着看)
| ID | Metros (m²) | Hab. | Antigüedad (años) | Precio (€) |
|---|---|---|---|---|
| 1 | 60 | 2 | 10 | 150000 |
| 2 | 80 | 3 | 5 | 210000 |
| 3 | 120 | 4 | 20 | NaN (P1) |
| 4 | 70 | 2 | NaN (P2) | 165000 |
| 5 | 150 | 5 | 2 | 400000 |
| 6 | NaN (P3) | 3 | 15 | 190000 |
| 7 | 90 | 3 | 8 | 230000 |
| 8 | 110 | NaN (P4) | 12 | 260000 |
| 9 | 200 | 6 | 1 | 550000 |
| 10 | 50 | 1 | 30 | 110000 |
a.1 Eliminar filas · 删掉含缺失的 4 行,10 行只剩 6 行(印刷页 32)
▸ 原页截图 p.30
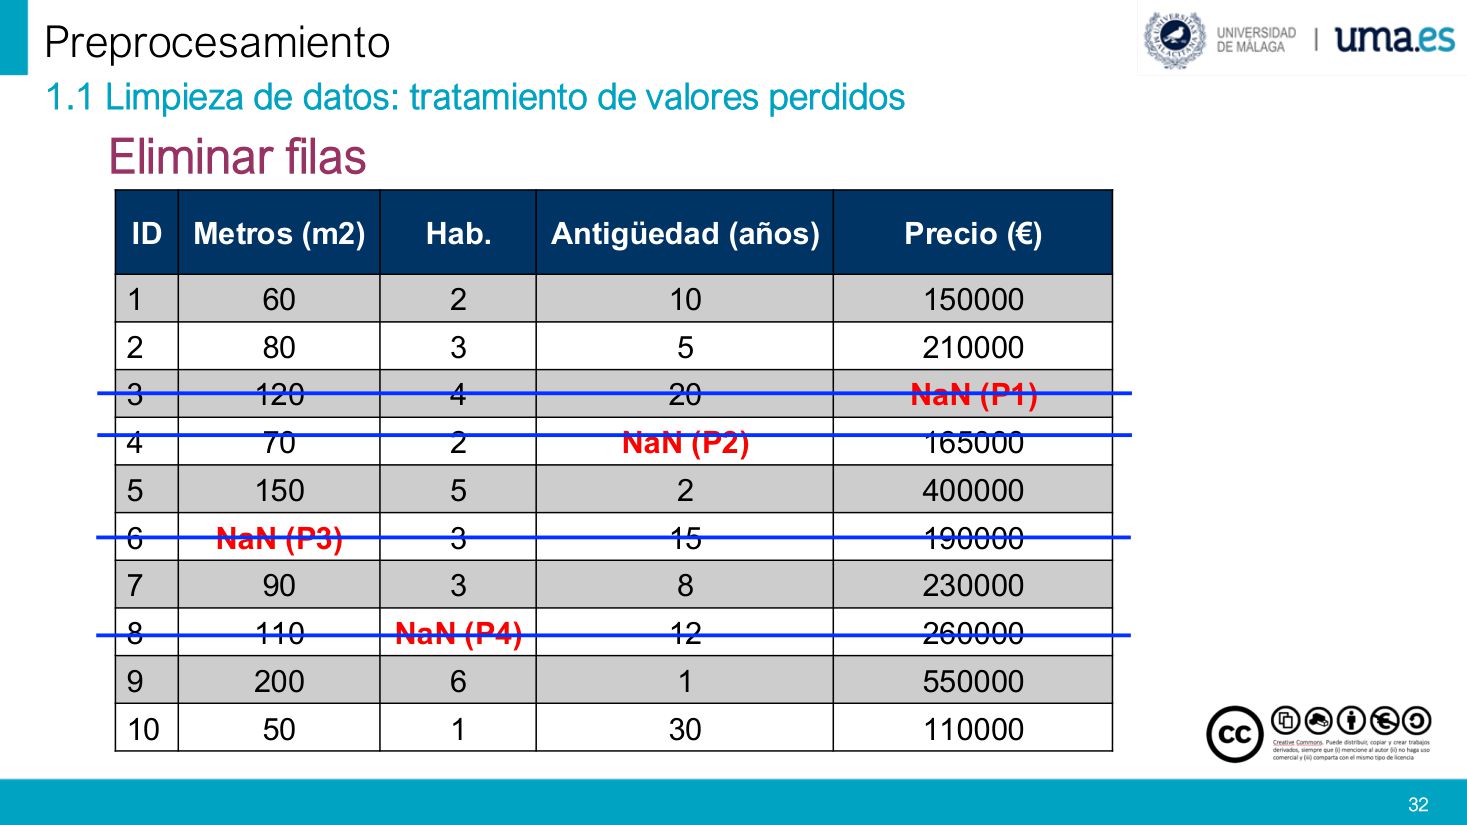
1.1 Limpieza de datos: tratamiento de valores perdidos
1.1 数据清洗:缺失值处理(本页所属小节)
Eliminar filas
删除行:一行里只要出现一个 NaN,整行一起丢掉——这是最简单、也最伤数据的做法。
| ID | Metros (m²) | Hab. | Antigüedad (años) | Precio (€) | 本页处置 |
|---|---|---|---|---|---|
| 1 | 60 | 2 | 10 | 150000 | 保留 |
| 2 | 80 | 3 | 5 | 210000 | 保留 |
| 3 | 120 | 4 | 20 | NaN (P1) | ✗ 整行删除 |
| 4 | 70 | 2 | NaN (P2) | 165000 | ✗ 整行删除 |
| 5 | 150 | 5 | 2 | 400000 | 保留 |
| 6 | NaN (P3) | 3 | 15 | 190000 | ✗ 整行删除 |
| 7 | 90 | 3 | 8 | 230000 | 保留 |
| 8 | 110 | NaN (P4) | 12 | 260000 | ✗ 整行删除 |
| 9 | 200 | 6 | 1 | 550000 | 保留 |
| 10 | 50 | 1 | 30 | 110000 | 保留 |
a.2 Eliminar columnas · 四列各缺 1 个,结果把四列全删光(印刷页 33)
▸ 原页截图 p.31
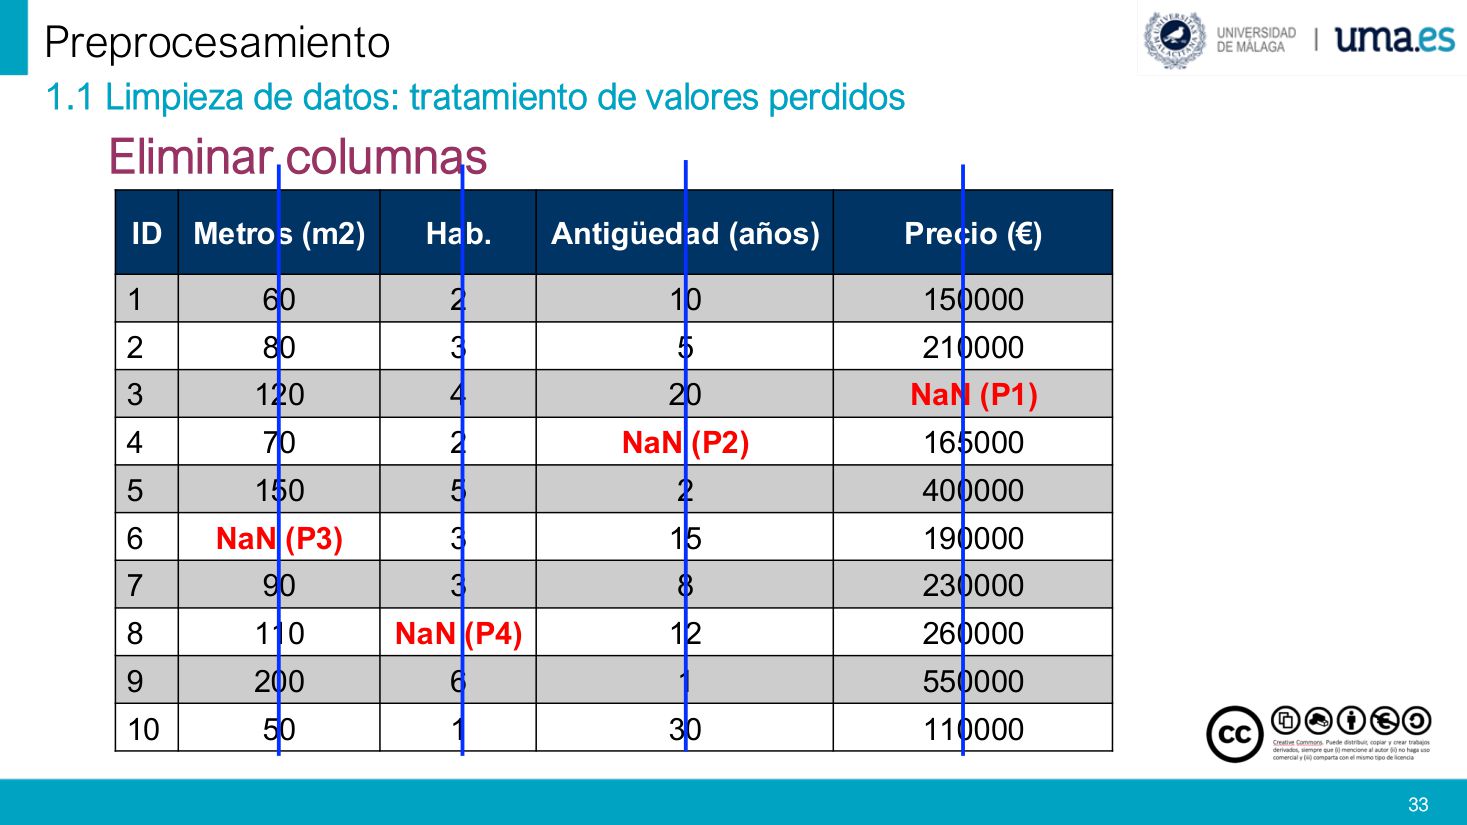
1.1 Limpieza de datos: tratamiento de valores perdidos
1.1 数据清洗:缺失值处理(本页所属小节)
Eliminar columnas
删除列:如果一整列里含缺失值,就把这一列(特征)整个删掉。
| 列 | 缺失个数 | 缺失比例 | 本页处置 |
|---|---|---|---|
| Metros (m²) | 1(P3,6 号) | 10% | ✗ 整列删除 |
| Hab. | 1(P4,8 号) | 10% | ✗ 整列删除 |
| Antigüedad (años) | 1(P2,4 号) | 10% | ✗ 整列删除 |
| Precio (€) | 1(P1,3 号) | 10% | ✗ 整列删除 |
| ID | 0 | 0% | 保留 |
b Imputación a la media · 四个均值 251666 / 11.444 / 103.333 / 3.222(印刷页 34)
▸ 原页截图 p.32
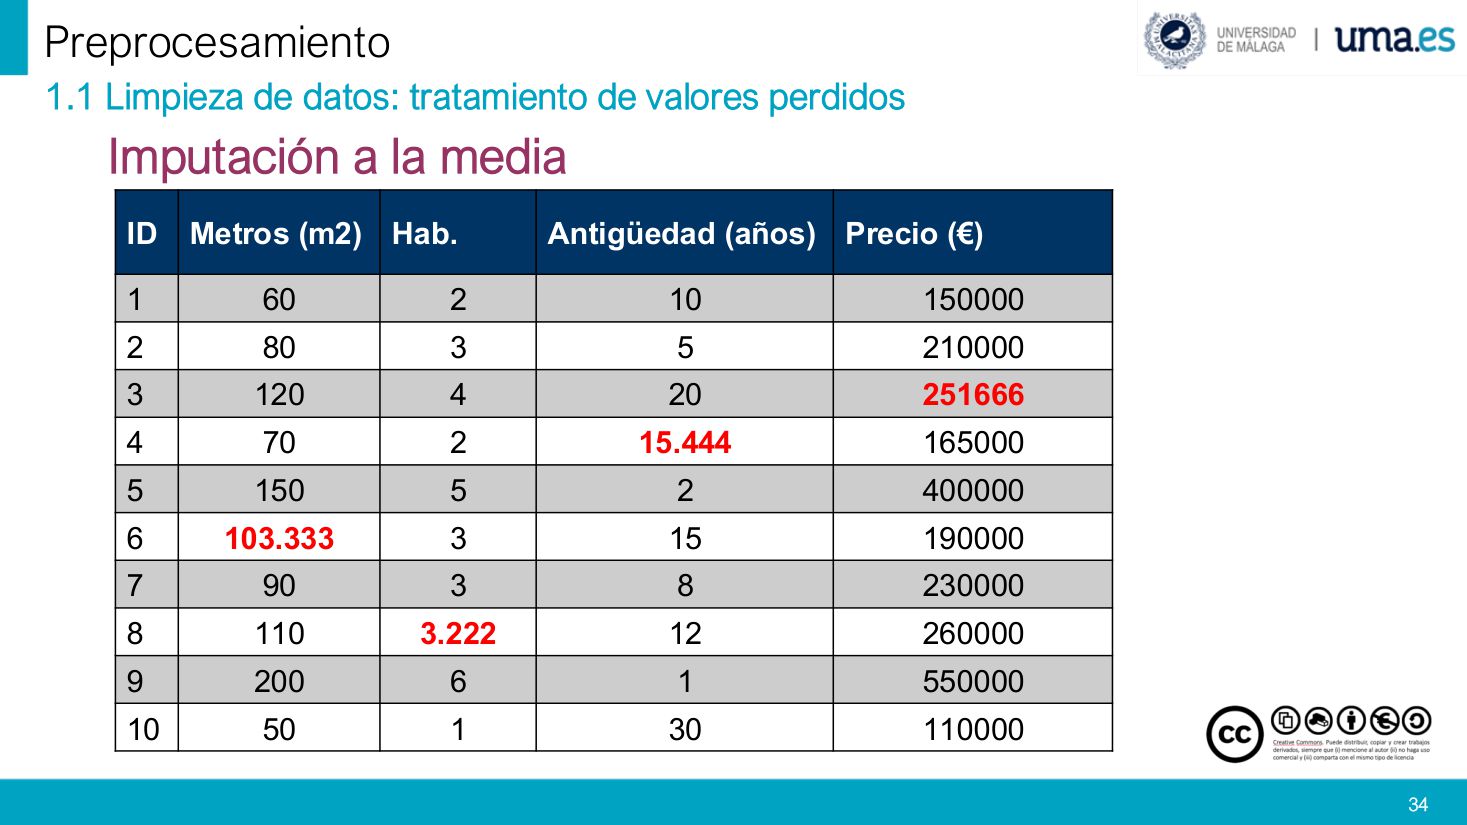
1.1 Limpieza de datos: tratamiento de valores perdidos
1.1 数据清洗:缺失值处理(本页所属小节)
Imputación a la media
均值插补:算出该列已有数值的算术平均,用这个数把所有空洞填上。
| 符号 | 西语读法 | 中文含义 |
|---|---|---|
| x̄ | «equis barra» / «media» | 该列已有数值的算术平均(读「x barra」) |
| xi | «equis sub i» | 第 i 个观测值(只取非缺失的那些) |
| n | «ene» / «número de valores no nulos» | 参与计算的有效值个数(本表 = 9,不含 NaN) |
| Σ 的写法 x1+⋯+xn | «sumatorio» | 把 9 个已知值加起来再除以 9 |
| 列 | 9 个已知值之和 | ÷ 9 = 均值 | 填入哪个空 |
|---|---|---|---|
| Metros (m²) | 930 | 103.333 | P3(6 号面积) |
| Hab. | 29 | 3.222 | P4(8 号房间数) |
| Antigüedad (años) | 103 | 原文 15.444(应为 11.444) | P2(4 号房龄) |
| Precio (€) | 2265000 | 251666 | P1(3 号价格) |
c.1 Regresión · 用其它列建模型,四个空各预测一次(印刷页 35)
▸ 原页截图 p.33
1.1 Limpieza de datos: tratamiento de valores perdidos
1.1 数据清洗:缺失值处理(本页所属小节)
Regresión
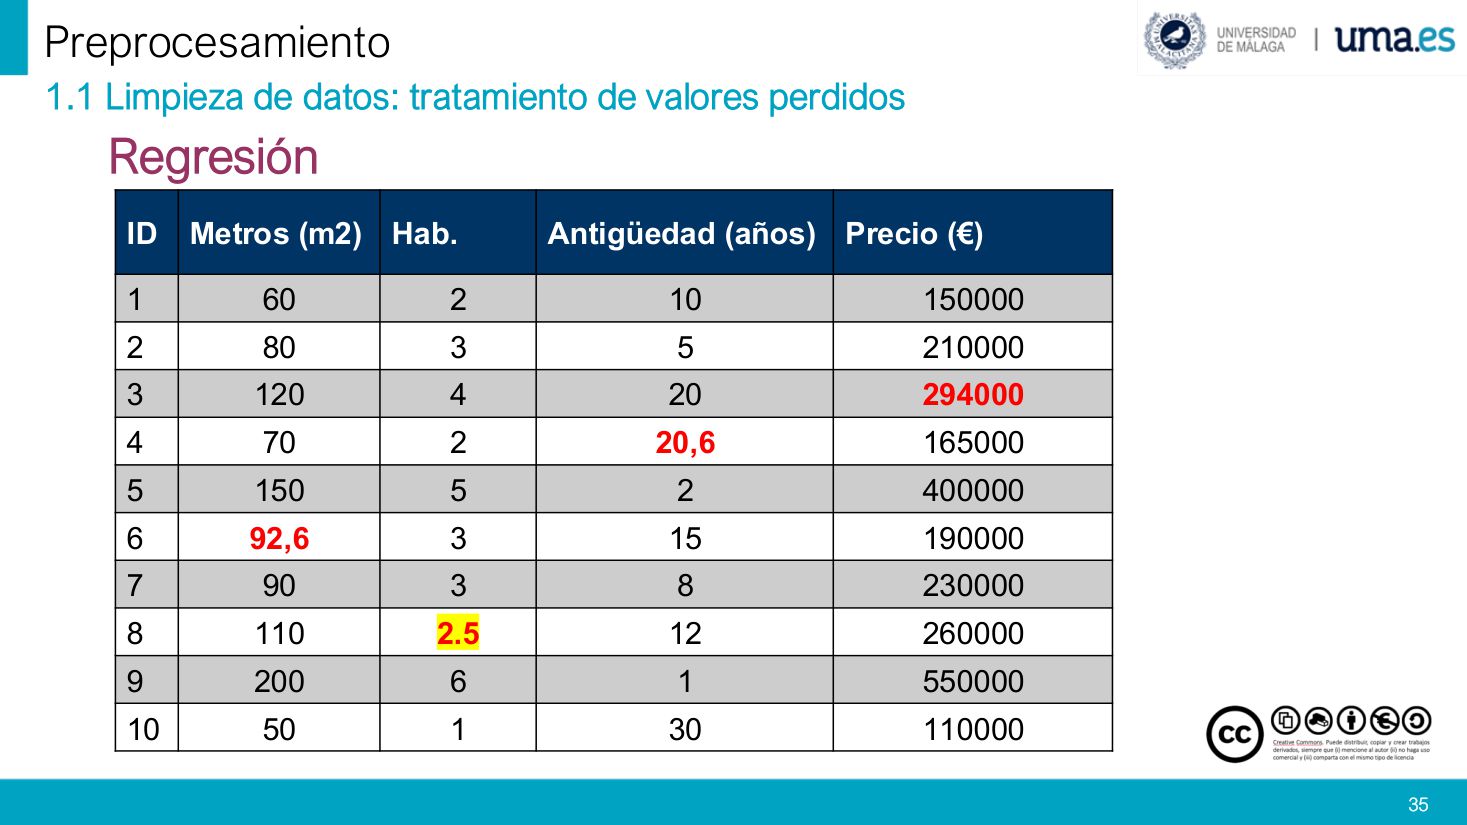
回归插补:把「有缺失的那一列」当因变量,其余列当自变量拟合直线,再代回去算出预测值填洞。
| 符号 | 西语读法 | 中文含义 |
|---|---|---|
| Ŷ | «i gorro» | 被插补那一列的预测值(本页分别指价格 / 房龄 / 面积 / 房间数) |
| w0 | «término independiente» | 截距(常数项) |
| wS, wN, wA | «pesos» / «coeficientes» | 面积 S、房间数 N、房龄 A 对应的权重 |
| S, N, A | «superficie, número de habitaciones, antigüedad» | 该行已知的三列取值 |
| 空位 | 用哪些列当自变量 | 代入的已知值 | 插补结果 |
|---|---|---|---|
| P1(3 号价格) | Metros, Hab., Antigüedad | 120 / 4 / 20 | 294000 |
| P2(4 号房龄) | Metros, Hab., Precio | 70 / 2 / 165000 | 20,6 |
| P3(6 号面积) | Hab., Antigüedad, Precio | 3 / 15 / 190000 | 92,6 |
| P4(8 号房间数) | Metros, Antigüedad, Precio | 110 / 12 / 260000 | 2.5 |
c.2 2 vecinos más próximos · 取最像的 2 行求均值(印刷页 36)
▸ 原页截图 p.34
1.1 Limpieza de datos: tratamiento de valores perdidos
1.1 数据清洗:缺失值处理(本页所属小节)
2 vecinos más próximos
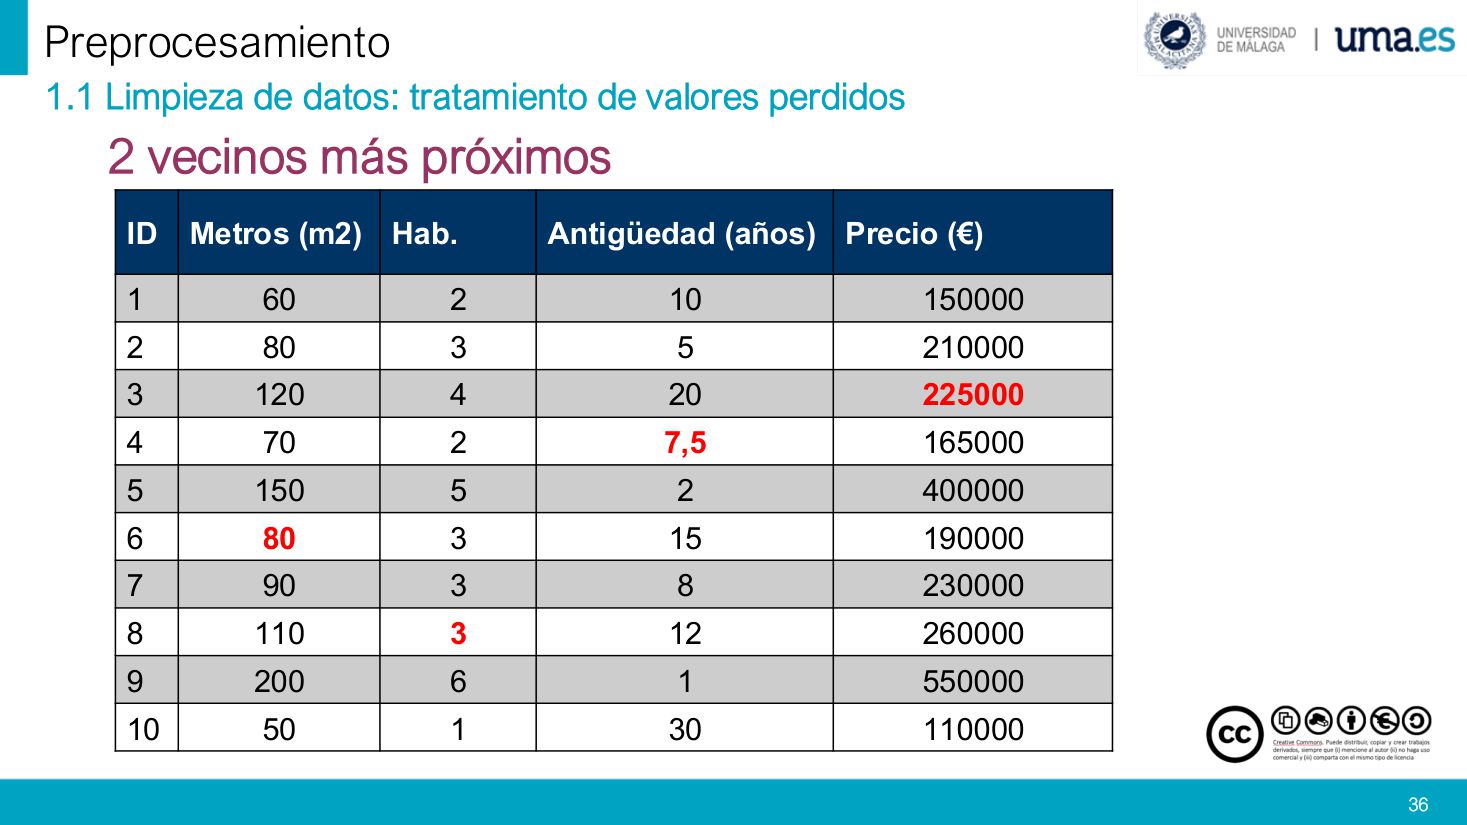
2 近邻插补:在本表里找出与这一行最像的 2 行(k = 2),用它们的取值来填洞。
| 空位 | 插补结果 | 结果是怎么来的 |
|---|---|---|
| P1(3 号价格) | 225000 | 两个最像的邻居的价格取平均 |
| P2(4 号房龄) | 7,5 | (10 + 5) / 2 |
| P3(6 号面积) | 80 | 与 2 号的面积 80 相同 |
| P4(8 号房间数) | 3 | 两个邻居的房间数都是 3 |
四、1.2 Tratamiento de datos anómalos:异常值与噪声
p.35–p.441.2. Tratamiento de datos anómalos · 第二节分隔页(印刷页 37)
▸ 原页截图 p.35
1. Limpieza de datos
1. 数据清洗(大节编号:本节仍属于「清洗」)
1.2. Tratamiento de datos anómalos
1.2 异常数据处理(清洗的第二个子问题)
1.2 概念地图 · 正常区域 / 异常 / 离群点 / 噪声(印刷页 38)
▸ 原页截图 p.36
1.2. Limpieza de datos: tratamiento de datos anómalos
1.2 数据清洗:异常数据处理(本页所属小节)
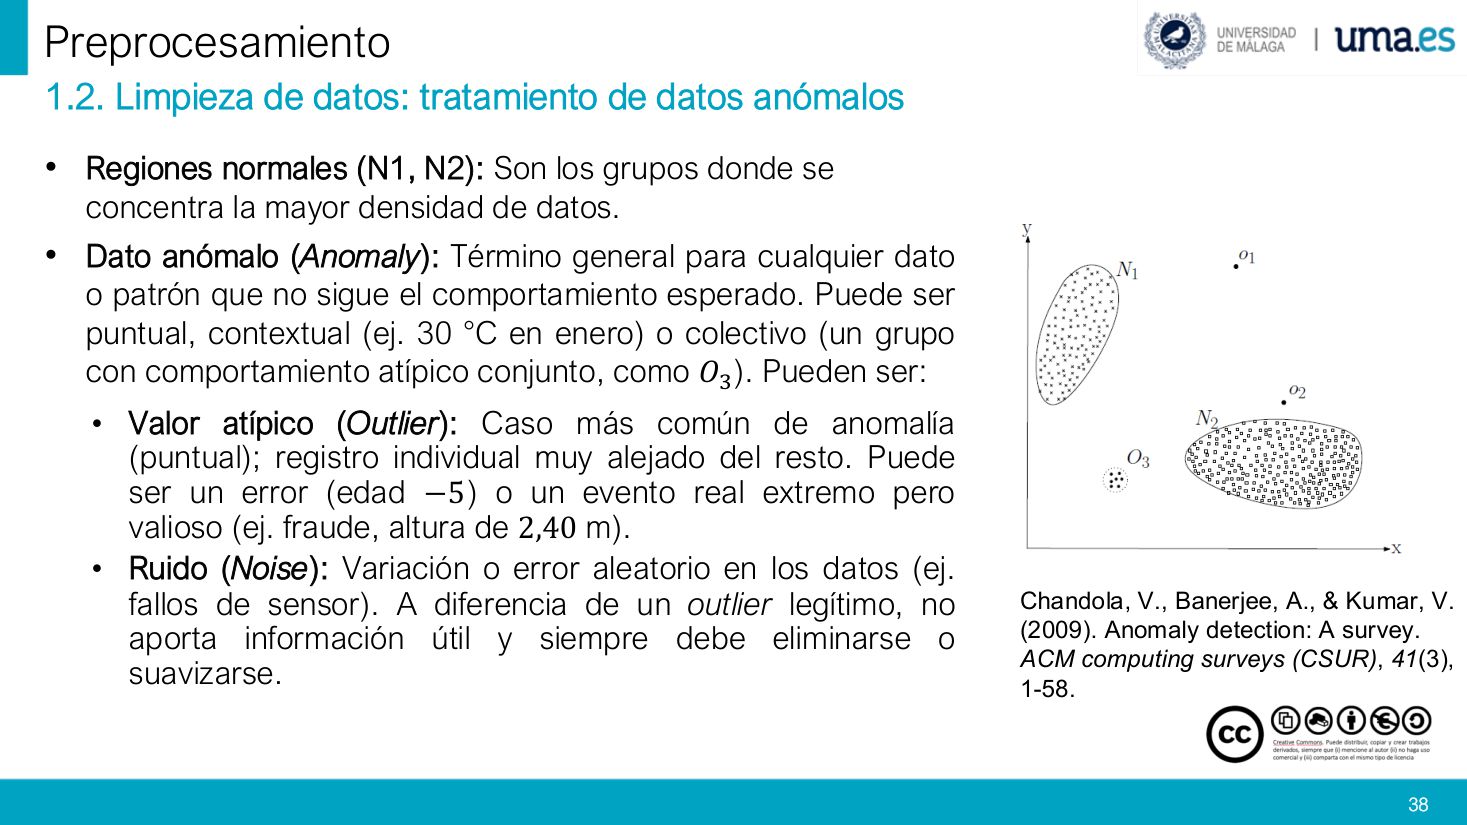
• Regiones normales (N1, N2): Son los grupos donde se concentra la mayor densidad de datos.
• 正常区域(N1、N2):数据密度最大的那些「团块」。
• Dato anómalo (Anomaly): Término general para cualquier dato o patrón que no sigue el comportamiento esperado. Puede ser puntual, contextual (ej. 30 °C en enero) o colectivo (un grupo con comportamiento atípico conjunto, como 𝑂3).
• 异常(Anomaly):一切不按预期规律走的数据或模式的统称。可分为:点异常(单个点)、上下文异常(如一月出现 30 °C)、集体异常(一组点整体反常,如臭氧 O₃ 的污染过程)。
• Valor atípico (Outlier): Caso más común de anomalía (puntual); registro individual muy alejado del resto. Puede ser un error (edad −5) o un evento real extremo pero valioso (ej. fraude, altura de 2,40 m).
• 离群点(Outlier):最常见的异常类型(点异常),即某条记录离其它记录很远。它可能是错误(年龄 −5),也可能是真实但极端的宝贵事件(欺诈交易、2.40 m 的身高)。
• Ruido (Noise): Variación o error aleatorio en los datos (ej. fallos de sensor). A diferencia de un outlier legítimo, no aporta información útil y siempre debe eliminarse o suavizarse.
• 噪声(Noise):数据中的随机波动或随机误差(如传感器故障)。与「合法的离群点」不同,噪声不携带有用信息,永远应当剔除或平滑掉。
Chandola, V., Banerjee, A., & Kumar, V. (2009). Anomaly detection: A survey. ACM computing surveys (CSUR), 41(3), 1-58.
本节理论出处:Chandola 等人 2009 年的异常检测综述(ACM Computing Surveys 41 卷 3 期)。
Reescalado Min-Max · Min-Max 重缩放 · 把值压到 [0,1],极值一压就露馅(印刷页 39)
▸ 原页截图 p.37
1.2. Limpieza de datos: tratamiento de datos anómalos: detección
1.2 数据清洗:异常数据检测(注意:本页标题虽写 detección,内容其实是重缩放)
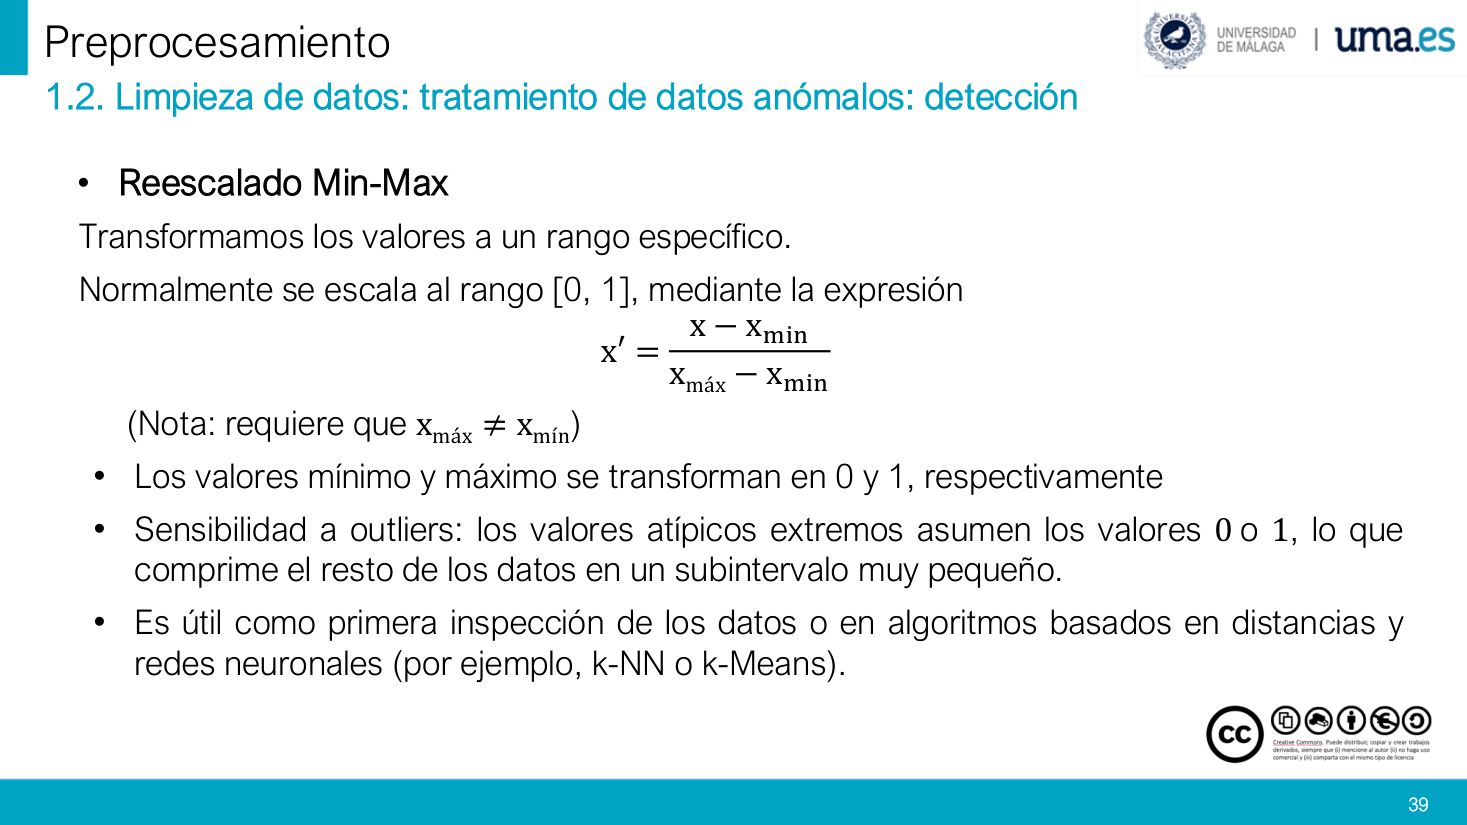
• Reescalado Min-Max · Transformamos los valores a un rango específico. Normalmente se escala al rango [0, 1], mediante la expresión
• Min-Max 重缩放:把所有取值搬到指定区间,通常缩放到 [0, 1],公式如下。
| 符号 | 西语读法 | 中文含义 |
|---|---|---|
| x′ | «equis prima» | 缩放后的新值,一定落在 [0, 1] |
| x | «equis» | 原始值 |
| xmín | «equis mínimo» | 该列最小值(缩放后变 0) |
| xmáx | «equis máximo» | 该列最大值(缩放后变 1) |
| xmáx − xmín | «rango» | 极差(分母,必须 ≠ 0,否则整列是常数,无法缩放) |
• (Nota: requiere que xmáx ≠ xmín)
• (注意:要求 xmáx ≠ xmín,否则分母为 0。)
• Los valores mínimo y máximo se transforman en 0 y 1, respectivamente.
• 最小值变成 0、最大值变成 1,其余值按比例落在两者之间。
• Sensibilidad a outliers: los valores atípicos extremos asumen los valores 0 o 1, lo que comprime el resto de los datos en un subintervalo muy pequeño.
• 对离群点敏感:极端值把 0 和 1 两个端点「占住」,其余数据全被挤进一个极窄的小区间。
• Es útil como primera inspección de los datos o en algoritmos basados en distancias y redes neuronales (por ejemplo, k-NN o k-Means).
• 适合用作数据的初步体检,也适合用在基于距离的算法与神经网络里(例如 k-NN、k-Means)。
统计方法 · Z-Score(|z|>3)与 IQR(Q1−1.5·IQR, Q3+1.5·IQR)(印刷页 40)
▸ 原页截图 p.38
Métodos estadísticos
统计方法(用分布的位置与离散程度来划「正常范围」)
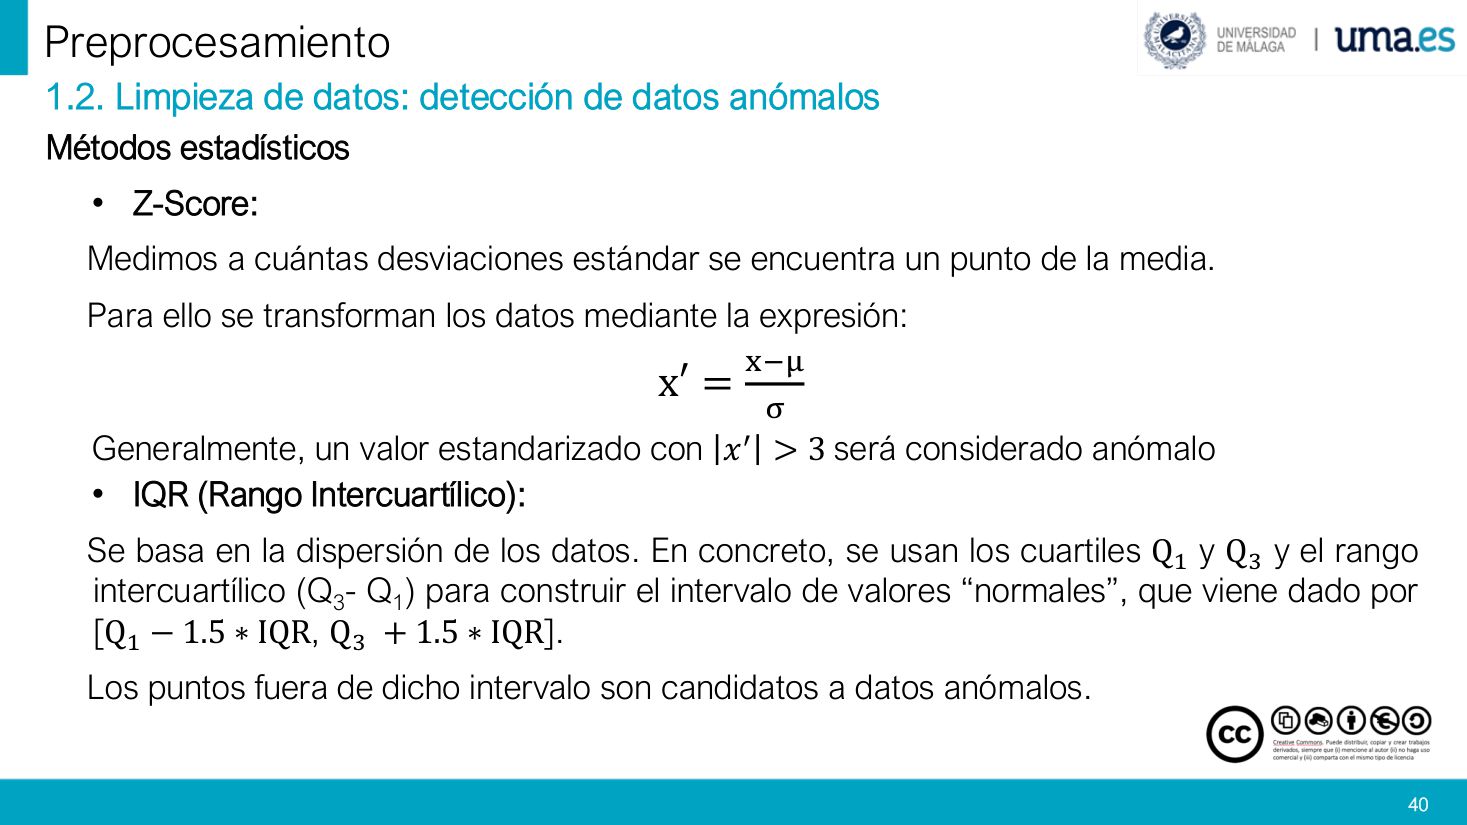
• Z-Score: Medimos a cuántas desviaciones estándar se encuentra un punto de la media. Para ello se transforman los datos mediante la expresión:
• Z 分数:衡量某个点离均值有几个标准差,用下面的式子把数据标准化。
| 符号 | 西语读法 | 中文含义 |
|---|---|---|
| z(原文 x′) | «zeta» / «puntuación z» | 标准化后的值,无量纲,可正可负 |
| x | «equis» | 原始观测值 |
| μ | «mu» / «media poblacional» | 总体均值 |
| σ | «sigma» / «desviación estándar» | 标准差(分母,必须 ≠ 0) |
| |z| > 3 | «valor absoluto de zeta mayor que tres» | 判定阈值:偏离超过 3 个标准差即视为异常候选 |
Generalmente, un valor estandarizado con 𝑥′ > 3 será considerado anómalo.
一般来说,标准化后 𝑥′ > 3 的值会被判为异常(严格说是 |𝑥′| > 3,负方向 −3 以下同样算)。
• IQR (Rango Intercuartílico): Se basa en la dispersión de los datos. En concreto, se usan los cuartiles Q1 y Q3 y el rango intercuartílico (Q3 - Q1) para construir el intervalo de valores "normales", que viene dado por [Q1 − 1.5 ∗ IQR, Q3 + 1.5 ∗ IQR].
• IQR(四分位距):基于数据的离散程度。用下四分位 Q1、上四分位 Q3 以及四分位距(Q3 − Q1)构造「正常值」区间:[Q1 − 1.5·IQR, Q3 + 1.5·IQR]。
| 符号 | 西语读法 | 中文含义 |
|---|---|---|
| Q1 | «cuartil uno» / «primer cuartil» | 下四分位:25% 的数据在它以下 |
| Q3 | «cuartil tres» | 上四分位:75% 的数据在它以下 |
| IQR | «rango intercuartílico» | 四分位距 = Q3 − Q1,中间 50% 数据的宽度 |
| 1.5 | «uno coma cinco» | 经典倍数(Tukey 经验常数),决定「胡须」的长度 |
| [ , ] | «intervalo cerrado» | 闭区间:区间之外的点才是异常候选 |
Los puntos fuera de dicho intervalo son candidatos a datos anómalos.
落在该区间之外的点,就是异常数据的候选。
实例演算 · 45, 50, 52, 55, 58, 60, 180 三种方法各判一次(印刷页 41)
▸ 原页截图 p.39
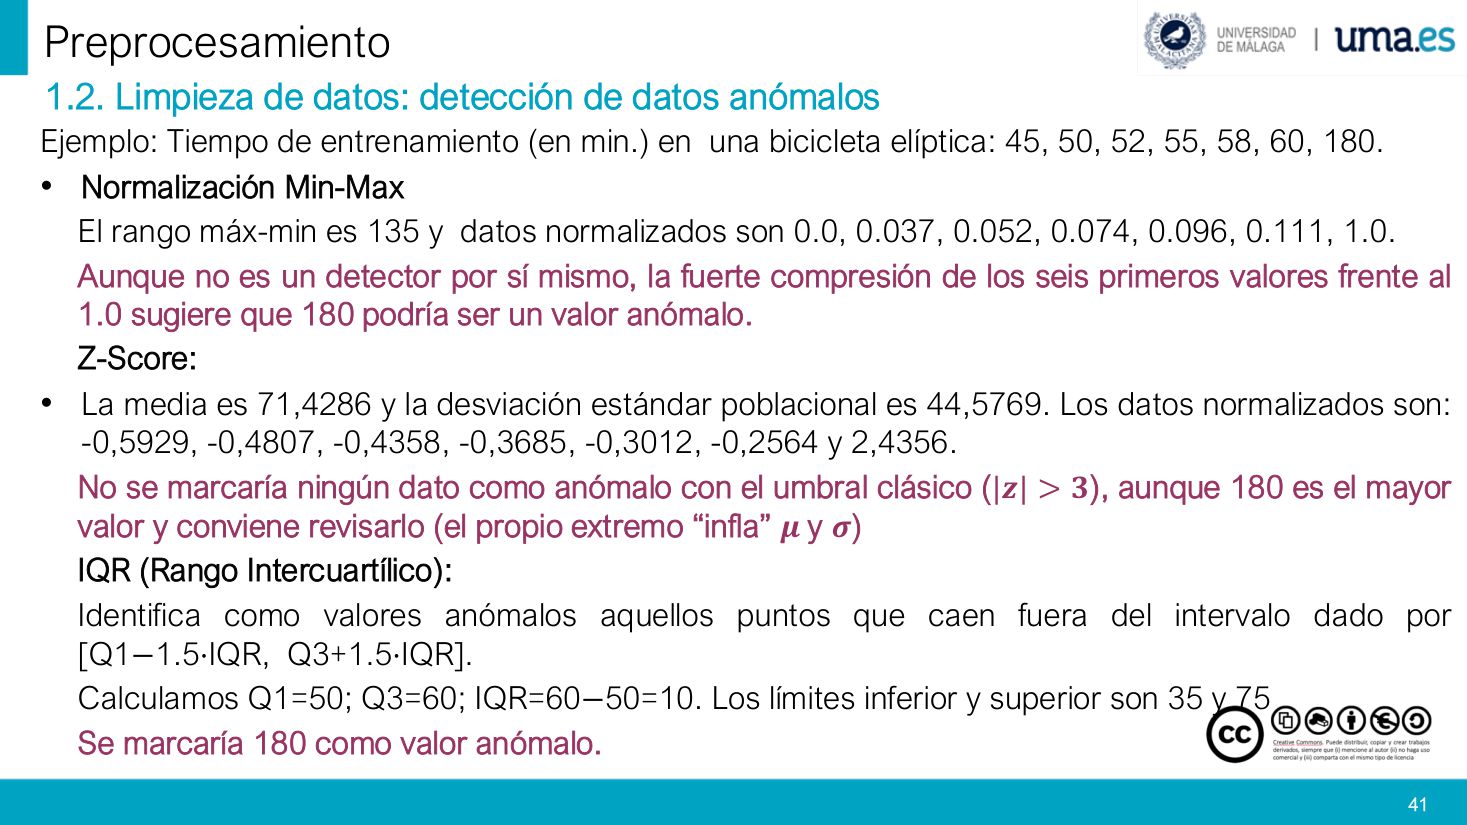
Ejemplo: Tiempo de entrenamiento (en min.) en una bicicleta elíptica: 45, 50, 52, 55, 58, 60, 180.
例:某人在椭圆机上每次的训练时长(分钟):45, 50, 52, 55, 58, 60, 180。
• Normalización Min-Max · El rango máx-min es 135 y datos normalizados son 0.0, 0.037, 0.052, 0.074, 0.096, 0.111, 1.0.
• Min-Max 归一化:极差 = 180 − 45 = 135,归一化结果为 0.0、0.037、0.052、0.074、0.096、0.111、1.0。
Aunque no es un detector por sí mismo, la fuerte compresión de los seis primeros valores frente al 1.0 sugiere que 180 podría ser un valor anómalo.
它本身虽然不算检测器,但前六个值被压缩得极扁、而最后一个稳稳顶在 1.0,这强烈提示 180 可能是异常值。
• Z-Score: La media es 71,4286 y la desviación estándar poblacional es 44,5769. Los datos normalizados son: -0,5929, -0,4807, -0,4358, -0,3685, -0,3012, -0,2564 y 2,4356.
• Z 分数:均值 μ = 500/7 ≈ 71.4286,总体标准差 σ ≈ 44.5769;标准化结果为 −0.5929、−0.4807、−0.4358、−0.3685、−0.3012、−0.2564 和 2.4356。
No se marcaría ningún dato como anómalo con el umbral clásico (|𝒛| > 𝟑), aunque 180 es el mayor valor y conviene revisarlo (el propio extremo "infla" 𝝁 y 𝝈).
按经典阈值 |z| > 3,一个都不会被判为异常——连 180 的 z 也只有 2.4356;但 180 终究是最大值,仍应人工复核(正是这个极端值把 μ 和 σ 一起「吹大」了,从而掩护了自己)。
• IQR (Rango Intercuartílico): Calculamos Q1=50; Q3=60; IQR=60−50=10. Los límites inferior y superior son 35 y 75.
• IQR:Q1 = 50、Q3 = 60、IQR = 60 − 50 = 10;下界 50 − 15 = 35,上界 60 + 15 = 75。
Se marcaría 180 como valor anómalo.
于是 180 被判为异常(180 > 75),其余六个值全部落在 [35, 75] 内。
| 原始值 x | Min-Max x′ | Z-Score z | 是否落在 IQR 区间 [35, 75] |
|---|---|---|---|
| 45 | 0.000 | −0.5929 | 是 |
| 50 | 0.037 | −0.4807 | 是 |
| 52 | 0.052 | −0.4358 | 是 |
| 55 | 0.074 | −0.3685 | 是 |
| 58 | 0.096 | −0.3012 | 是 |
| 60 | 0.111 | −0.2564 | 是 |
| 180 | 1.000 | 2.4356 | 否(> 75,异常) |
Técnicas de Visualización · 可视化三件套 · 箱线图 / 散点图 / 直方图(印刷页 42)
▸ 原页截图 p.40
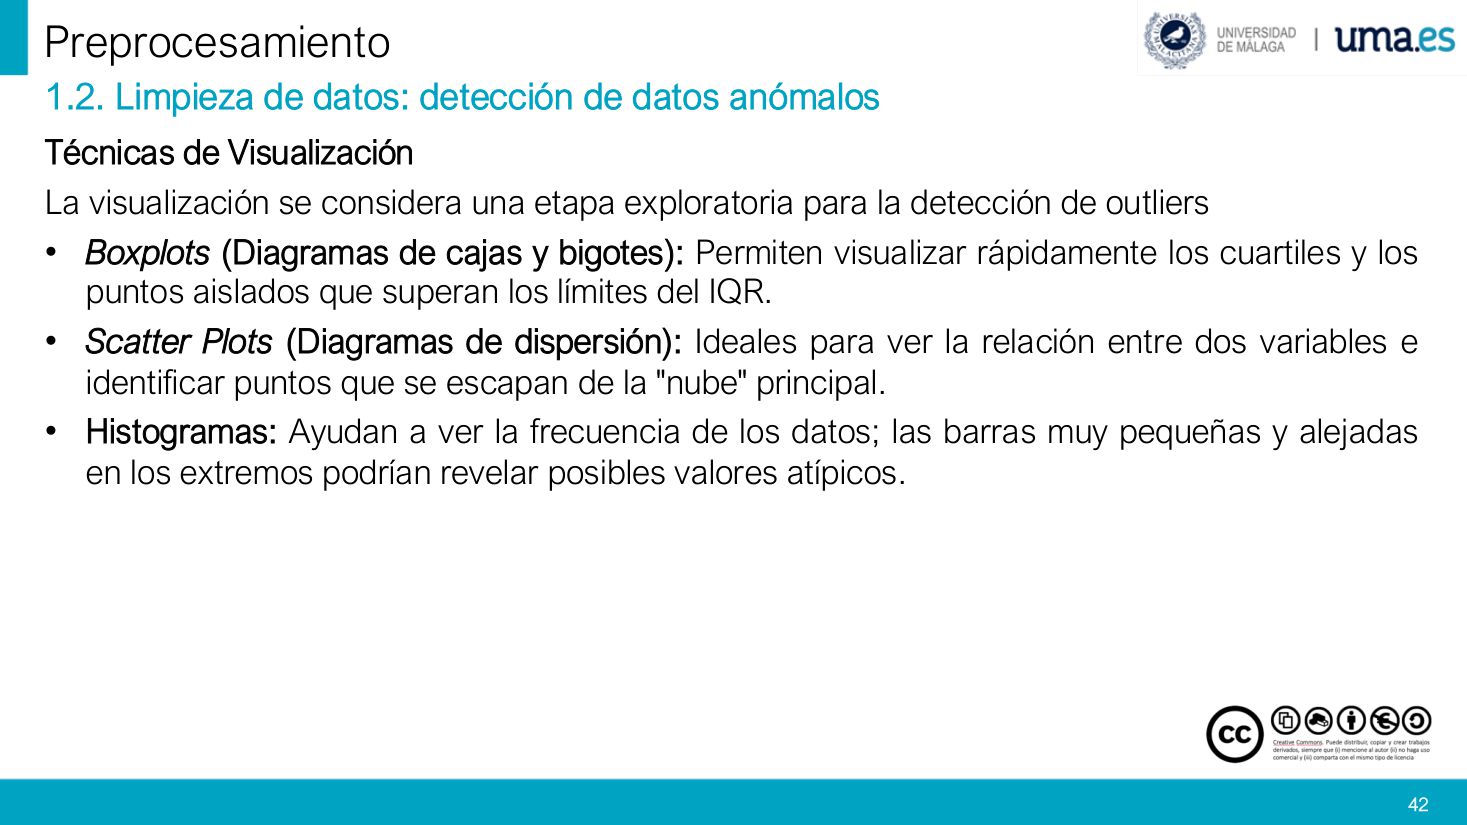
Técnicas de Visualización · La visualización se considera una etapa exploratoria para la detección de outliers.
可视化技术:可视化属于检测离群点的探索性阶段(先看,再判)。
• Boxplots (Diagramas de cajas y bigotes): Permiten visualizar rápidamente los cuartiles y los puntos aislados que superan los límites del IQR.
• 箱线图(Boxplot,盒子加胡须):快速看出四分位数,以及超出 IQR 上下界的孤立点。
• Scatter Plots (Diagramas de dispersión): Ideales para ver la relación entre dos variables e identificar puntos que se escapan de la "nube" principal.
• 散点图:最适合看两个变量之间的关系,并找出「逃离主云团」的点。
• Histogramas: Ayudan a ver la frecuencia de los datos; las barras muy pequeñas y alejadas en los extremos podrían revelar posibles valores atípicos.
• 直方图:看数据的频数分布;两端那些又矮又远的小柱子,往往就是可能的异常值。
Técnicas de Visualización · 可视化的边界 · 只能提「候选」,判定靠领域知识(印刷页 43)
▸ 原页截图 p.41
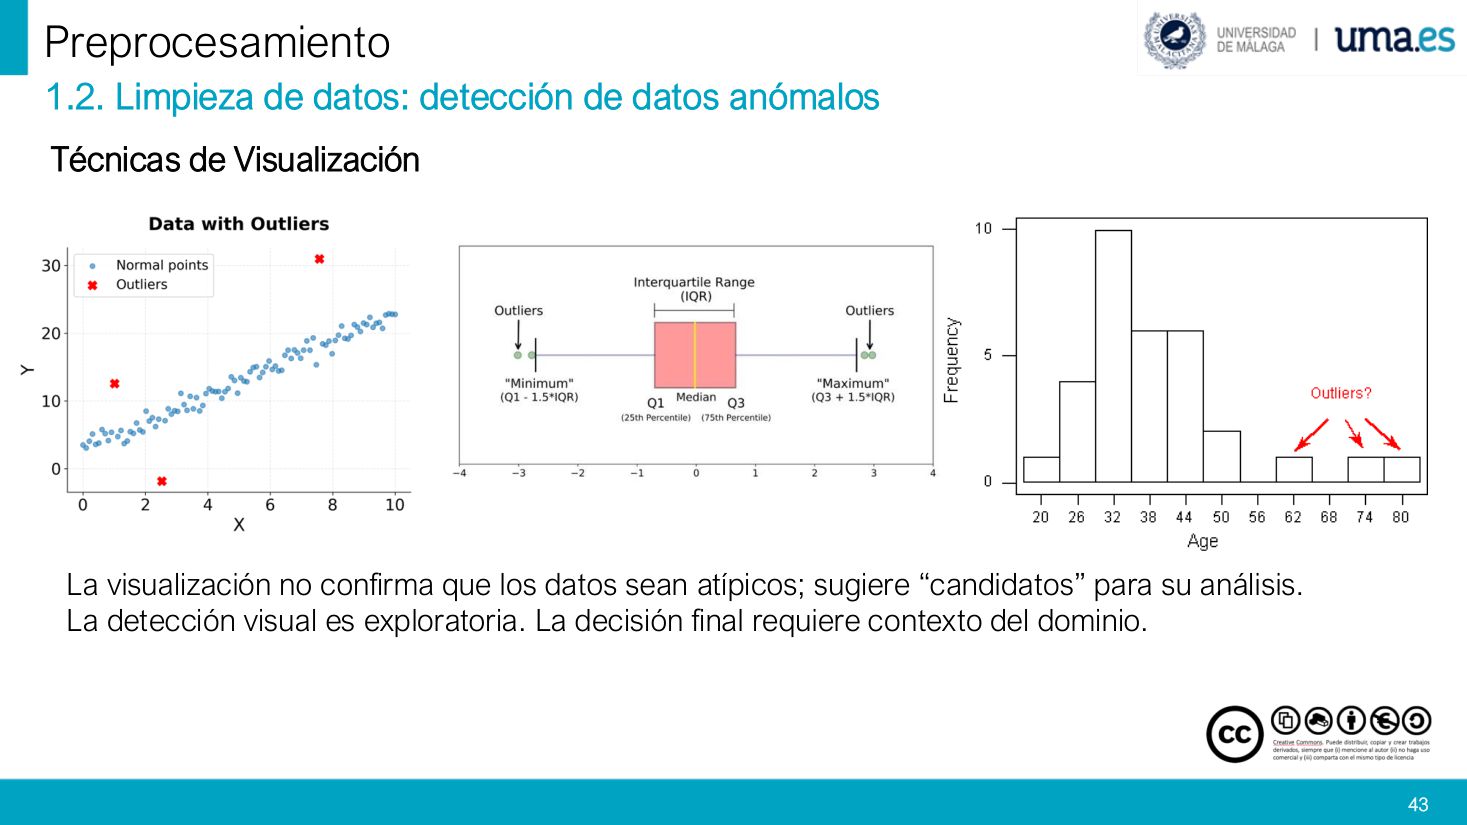
Técnicas de Visualización
可视化技术(承接上一页的三张图)
La visualización no confirma que los datos sean atípicos; sugiere "candidatos" para su análisis.
可视化不能证实某个数据就是异常,它只是给出待分析的「候选者」。
La detección visual es exploratoria. La decisión final requiere contexto del dominio.
视觉检测只是探索性的;最终判定必须结合领域背景(知道这个变量在现实中能取什么值)。
Eliminación Crítica · 处置 · 临界删除三条件 / 当信号存在时改用稳健模型 / 插补(印刷页 44)
▸ 原页截图 p.42
Eliminación Crítica: Suprimir el registro si:
临界删除:只有在下面三个条件同时成立时,才删掉这条记录。
i) se confirma el error (ej. Edad 200 años);
i) 能确认是错误(例:年龄 200 岁);
ii) el impacto en la cobertura es aceptable (ej. se elimina menos del 5% de los datos)
ii) 对覆盖率的影响可接受(例:删掉的不到全部数据的 5%);
iii) no provoca sesgos (ej. elimina personas de alto salario porque no dicen su salario)
iii) 不会引入偏差(反例:因为高收入者不愿报收入就把他们删掉——这会系统性地漏掉一类人)。
Si se considera que puede ser un evento real poco frecuente, lo recomendable es considerar tratamiento específico (ej. si eliminamos un número excesivamente alto de conexiones, podemos estar eliminando precisamente los casos interesantes).
若判断它可能是真实的稀有事件,应当考虑专门处理(例:把「连接数异常高」的记录全删掉,删掉的恰恰是最有意思的案例)。
Esto es señal, no ruido, y convendría usar modelos robustos a outliers (como random forest).
这属于信号而非噪声,此时应当改用对离群点稳健的模型(例如随机森林)。
Imputación: Sustituir valores extremos utilizando técnicas de imputación de datos (apartado anterior).
插补:把极端值替换掉,用的是上一小节(1.1)讲过的插补技术。
Transformaciones de datos · 不删也能治 · 非线性变换 / 聚类分段 / 平滑 + 三个自测问答(印刷页 45)
▸ 原页截图 p.43
Transformaciones de datos (se verán en más detalle en el apartado correspondiente)
数据变换(属于「保留异常值」的处置路线,详见后面 3. 变换一节)
• Transformaciones no Lineales: Aplicar funciones logarítmicas o raíz cuadrada para reducir el peso de los extremos ("suavizar" la joroba de la distribución) y facilitar el cumplimiento de la hipótesis de normalidad.
• 非线性变换:取对数或开平方,压低极端值的权重(「削平」分布的驼峰),让数据更容易满足正态性假设。
• Segmentación (Clustering) para detección de subpoblaciones. Identificar si las anomalías forman un grupo con patrón propio (ej. "socios de alto rendimiento") para tratarlos de forma aislada en lugar de eliminarlos.
• 聚类分段:用于发现子群体。先看这些「异常」是否自成一群、有自己的规律(例:「高产出会员」),然后单独建模,而不是删掉。
• Suavizado de Datos: Aplicar filtros de variabilidad (como medias móviles) para minimizar el impacto del ruido aleatorio en el análisis global.
• 数据平滑:用波动滤波器(如移动平均)降低随机噪声对整体分析的干扰。
Preguntas:
自测三问(答案就在下一行,先自己答一遍)
• ¿Cuándo es peligroso eliminar outliers aunque "estadísticamente" parezcan anómalos? → Cuando es señal y no ruido; cuando representan a una subpoblación real
• 什么时候「统计上确实异常」却不能删?→ 当它是信号而非噪声时;当它代表一个真实存在的子群体时。
• ¿Entre z-score y IQR, qué método eligirías si la distribución es muy asimétrica? ¿por qué? → El IQR, porque en z-score los valores extremos pueden sesgar la media y la desviación típica.
• 分布严重偏态时,Z-Score 与 IQR 选哪个?→ 选 IQR,因为 Z-Score 里的极端值会把均值与标准差本身带偏(自证失效)。
• Si escalas con Min–Max y aparece un 1.0… ¿es anomalía o simplemente el máximo? → Depende, hay que mirar los datos (no hay una "regla de detección" como en z-score)
• 用 Min-Max 缩放后看到 1.0,是异常还是「它就是最大值」?→ 要看数据本身:Min-Max 没有像 Z-Score 那样的判定规则,1.0 只说明「它是这一列最大的那个」。
1.2. Limpieza de datos: tratamiento de datos anómalos: resumen · 1.2 小结表 · 不一致 / 缺失 / 异常:定义—例子—策略(印刷页 46)
▸ 原页截图 p.44
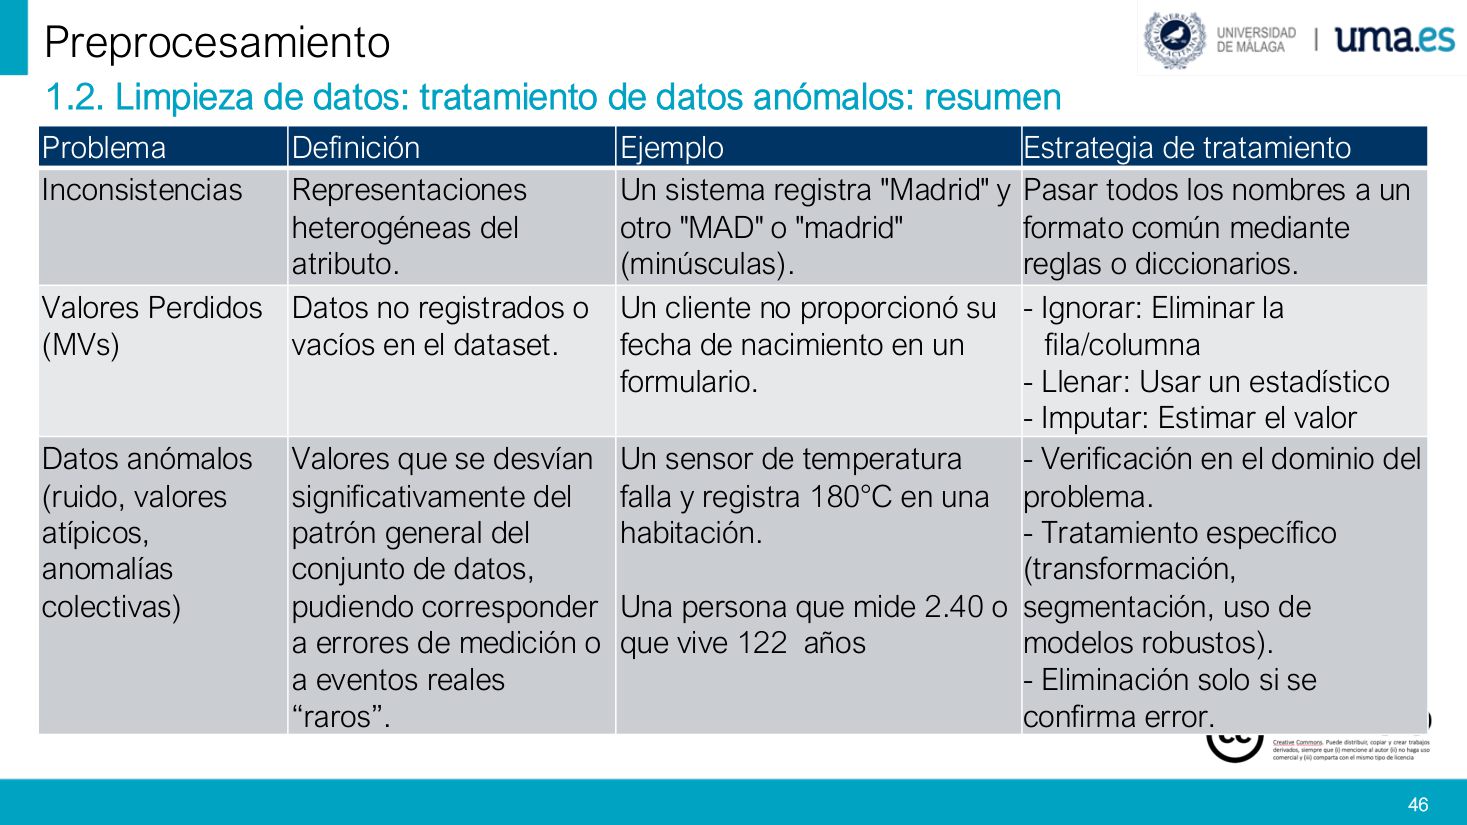
1.2. Limpieza de datos: tratamiento de datos anómalos: resumen
1.2 数据清洗:异常数据处理 · 小结
| Problema | Definición | Ejemplo | Estrategia de tratamiento |
|---|---|---|---|
| Inconsistencias | Representaciones heterogéneas del atributo. | Un sistema registra "Madrid" y otro "MAD" o "madrid" (minúsculas). | Pasar todos los nombres a un formato común mediante reglas o diccionarios. |
| Valores Perdidos (MVs) | Datos no registrados o vacíos en el dataset. | Un cliente no proporcionó su fecha de nacimiento en un formulario. | - Ignorar: Eliminar la fila/columna - Llenar: Usar un estadístico - Imputar: Estimar el valor |
| Datos anómalos (ruido, valores atípicos, anomalías colectivas) | Valores que se desvían significativamente del patrón general del conjunto de datos, pudiendo corresponder a errores de medición o a eventos reales "raros". | Un sensor de temperatura falla y registra 180 °C en una habitación. Una persona que mide 2.40 o que vive 122 años |
- Verificación en el dominio del problema. - Tratamiento específico (transformación, segmentación, uso de modelos robustos). - Eliminación solo si se confirma error. |
五、2. Integración de datos:合并多源、去重、消冗余
p.45–p.512. Integración de datos · 第二节分隔页(印刷页 47)
▸ 原页截图 p.45
2. Integración de datos
2. 数据集成(五阶段的第二阶段)
2 集成 · 定义 + 两个关键问题:重复实例与冗余属性(印刷页 48)
▸ 原页截图 p.46
La integración de datos es el proceso de combinar información proveniente de múltiples fuentes para crear una vista única, coherente y valiosa.
数据集成是把多个来源的信息合并起来,形成一个唯一、一致、有价值的视图。
Para lograr un dataset de calidad, nos enfocaremos en dos problemas críticos que pueden distorsionar cualquier análisis estadístico o modelo de aprendizaje:
要得到高质量的数据集,必须盯住两个关键问题——它们足以扭曲任何统计分析或机器学习模型。
Detección de instancias duplicadas: ¿Cómo identificamos registros repetidos?
重复实例检测:怎么认出「同一条记录出现了多次」?
• Un mismo objeto o evento puede aparecer varias veces debido a errores en la entrada de datos o solapamiento entre sistemas.
• 同一个对象或事件可能重复出现:数据录入出错,或两个系统的记录范围有重叠。
Localización de Datos Redundantes: ¿Qué información sobra?
冗余数据定位:哪些信息是多余的?
• La redundancia ocurre cuando un atributo puede ser derivado de otro (por ejemplo, tener "Fecha de nacimiento" y "Edad").
• 当一个属性可以由另一个属性推导出来时,就产生了冗余(例:同时存「出生日期」和「年龄」)。
2.1 重复实例示例 · Elena Lopez / Helena López 的三层比对(印刷页 49)
▸ 原页截图 p.47
2.1. Detección instancias duplicadas: ejemplo
2.1 重复实例检测 · 示例
Imagina que, al fusionar dos bases de datos, nos encontramos con estos dos registros:
假设合并两个数据库时,遇到下面两条记录:
A: "Elena Lopez", Calle Mayor 5, DNI 2345678X
A:「Elena Lopez」,Calle Mayor 5(马约尔街 5 号),身份证号 2345678X
B: "Helena López", 5, Mayor St., DNI 2345678-X
B:「Helena López」,5, Mayor St.(英文写法),身份证号 2345678-X
¿Cómo podemos algorítmicamente determinar si son el mismo registro?
怎么用算法判定这两条是不是同一个人?
1. Métricas de Caracteres (Edit Distance). Comparamos "Elena" vs "Helena" o "Lopez" vs "López" (con tilde). Se cuenta el número de transformaciones necesarias para hacerlos coincidir (en este caso, 2).
1. 字符级度量(编辑距离):比较「Elena」与「Helena」、「Lopez」与「López」(带重音符)。数一数要改几次才能让两者一致——本例共 2 次(插入一个 H、o 换成 ó)。
2. Métricas Fonéticas (Metaphone). "Elena" y "Helena" generan el mismo código fonético, luego podemos ignorar la diferencia ortográfica.
2. 语音度量(Metaphone):「Elena」与「Helena」生成相同的语音编码,于是可以忽略拼写差异。
3. Métricas de Tokens. Se generan tokens para comparar la dirección "Calle Mayor 5" vs "5, Mayor St." Para ello, se descompone la dirección en palabras sueltas y se ignora tanto el orden como palabras genéricas (en este caso, "Calle" o "St."). Ambos registros contienen los tokens clave "5" y "Mayor".
3. 词元(token)度量:把地址拆成一个个词来比较「Calle Mayor 5」与「5, Mayor St.」——忽略词序,也忽略通用词(本例的 "Calle"、"St.")。两条记录都含关键 token「5」和「Mayor」。
En los tres casos podríamos identificar los valores del registro como coincidentes.
三种方法都能判定这两条记录的取值相互吻合。
| 层级 | 比的是什么 | 本例的证据 | 典型算法 |
|---|---|---|---|
| 字符级 | 逐个字符的增删改 | Elena→Helena、Lopez→López = 2 次 | Edit Distance / Levenshtein |
| 语音级 | 读音是否相同 | Elena ≈ Helena(同码) | Metaphone / Soundex |
| 词元级 | 拆分后的关键词集合 | {5, Mayor} 两边都有 | Token / Jaccard |
2.1 Detección de instancias duplicadas · 2.1 重复实例检测 · 三技术对照表:字符 / 语音 / 词元(印刷页 50)
▸ 原页截图 p.48
2.1 Detección
2.1
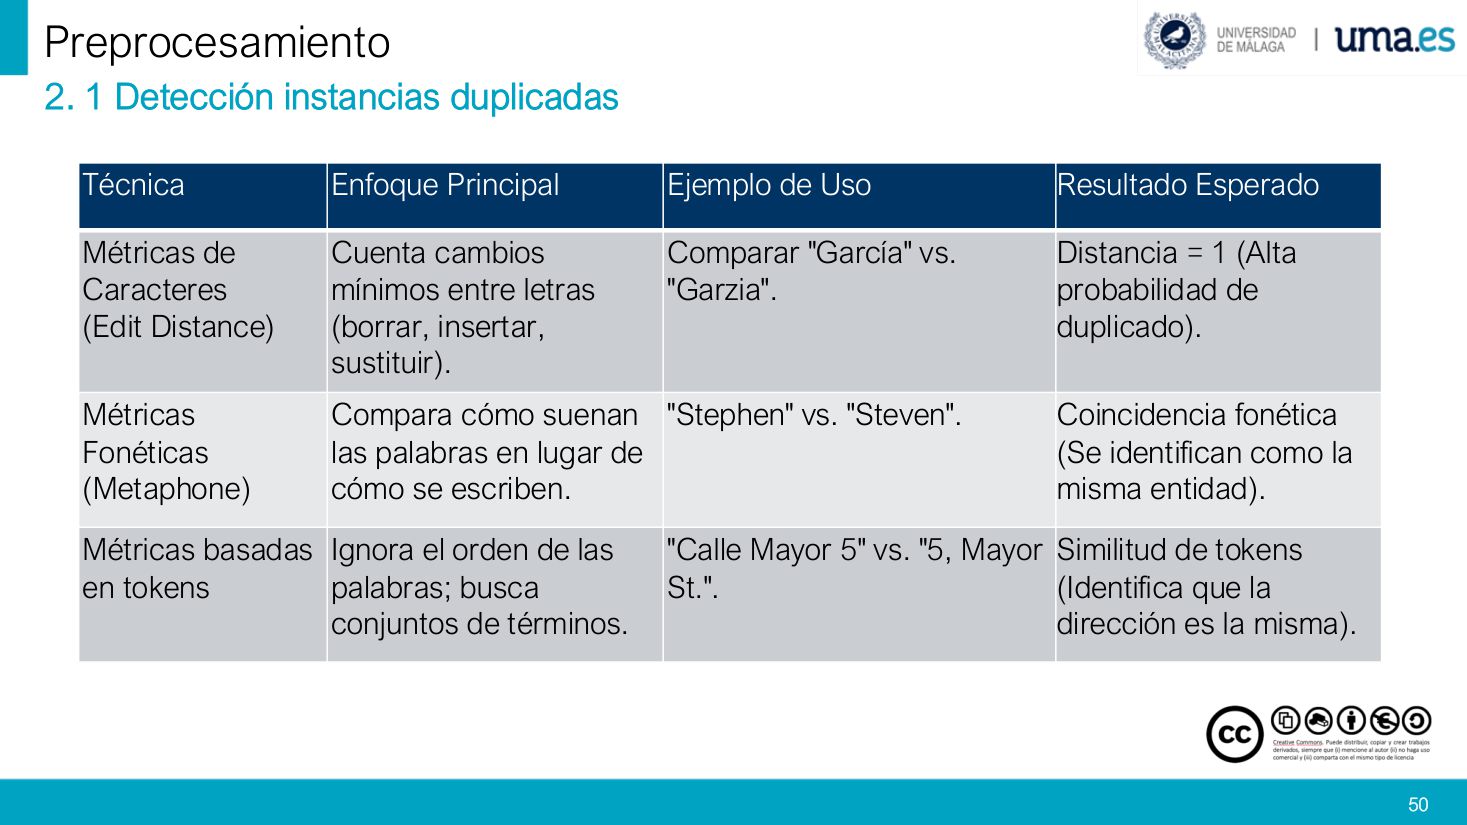
| Técnica | Enfoque Principal | Ejemplo de Uso | Resultado Esperado |
|---|---|---|---|
| Métricas de Caracteres (Edit Distance) |
Cuenta cambios mínimos entre letras (borrar, insertar, sustituir). | Comparar "García" vs. "Garzia". | Distancia = 1 (Alta probabilidad de duplicado). |
| Métricas Fonéticas (Metaphone) |
Compara cómo suenan las palabras en lugar de cómo se escriben. | "Stephen" vs. "Steven". | Coincidencia fonética (Se identifican como la misma entidad). |
| Métricas basadas en tokens | Ignora el orden de las palabras; busca conjuntos de términos. | "Calle Mayor 5" vs. "5, Mayor St.". | Similitud de tokens (Identifica que la dirección es la misma). |
Métricas de Caracteres (Edit Distance): cuenta cambios mínimos entre letras (borrar, insertar, sustituir). Ejemplo: comparar "García" vs. "Garzia". Resultado: distancia = 1, alta probabilidad de duplicado.
字符级度量(编辑距离):数出把 A 变成 B 所需的最少编辑操作(删除、插入、替换)。例:「García」对「Garzia」,只要把 c 换成 z,距离 = 1,因此极可能是重复记录。
Métricas Fonéticas (Metaphone): compara cómo suenan las palabras en lugar de cómo se escriben. Ejemplo: "Stephen" vs. "Steven". Resultado: coincidencia fonética, se identifican como la misma entidad.
语音度量(Metaphone):比的是读音而不是拼写。例:「Stephen」与「Steven」——拼写完全不同,读音一致,于是判定为同一实体。
Métricas basadas en tokens: ignora el orden de las palabras; busca conjuntos de términos. Ejemplo: "Calle Mayor 5" vs. "5, Mayor St.". Resultado: similitud de tokens, identifica que la dirección es la misma.
词元度量:不管词序,只看「出现了哪些词」。例:「Calle Mayor 5」与「5, Mayor St.」——去掉通用的 Calle / St. 后,两边都剩 {5, Mayor},于是判定地址相同。
2.2 Localización de atributos redundantes · 2.2 冗余属性定位 · 名义属性的 χ² 独立性检验(印刷页 51)
▸ 原页截图 p.49
2.2
2.2
Se emplean
用
Si se detecta una fuerte dependencia, puede valorarse la eliminación de uno de ellos, según el objetivo del modelo y el contexto del problema. Las principales técnicas son:
若检测到强依赖,就可以考虑删掉其中一个——但删不删要看模型目标与问题背景。主要技术如下:
Para atributos nominales: Test Chi-cuadrado (χ2) de independencia:
名义属性(类别型,无大小顺序)用 χ² 独立性检验:
• p−valor > α → No hay evidencia suficiente para afirmar dependencia → No hay evidencia de redundancia.
• p 值 > α:没有足够证据说两者相关 → 也就没有冗余的证据 → 两列都留着。
• p−valor ≤ α → Existe dependencia → Posible solapamiento informativo → Evaluar eliminación según relevancia y contexto del modelo.
• p 值 ≤ α:两者相关 → 可能存在信息重叠 → 再按相关性高低与模型需要决定要不要删。
| 符号 | 西语读法 | 中文含义 |
|---|---|---|
| χ² | «ji cuadrado» / «chi-cuadrado» | 卡方统计量:名义属性「观测频数 vs 期望频数」的偏离程度 |
| p-valor | «pe valor» / «valor p» | 在原假设(两属性独立)成立时,出现当前偏离或更极端的概率 |
| α | «alfa» / «nivel de significación» | 显著性水平,常用 0,05;是「误判为相关」的可容忍概率 |
2.2 冗余属性定位 · 数值属性:Pearson 与 Spearman(印刷页 52)
▸ 原页截图 p.50
2.2 Localización de atributos redundantes — Para atributos numéricos:
2.2 冗余属性定位 —— 数值属性(连续型)用相关系数:
Correlación de Pearson – si se sospecha relación lineal
Pearson 相关系数 —— 当你怀疑是线性关系时用。
• |r| ≈ 0 → No relación lineal → Mantener ambas variables.
• |r| ≈ 0:没有线性关系 → 两列都留。
• |r| alto (p. ej., > 0.8) → Fuerte dependencia lineal → Posible redundancia.
• |r| 很大(例如 > 0,8):强线性依赖 → 可能存在冗余。
Correlación de Spearman – si se quiere explorar relaciones no lineales
Spearman 相关系数 —— 当你想探查非线性(但单调)关系时用。
• |ρ| ≈ 0 → No relación monotónica → Mantener ambas variables.
• |ρ| ≈ 0:不存在单调关系 → 两列都留。
• |ρ| alto (p. ej., > 0.8) → Fuerte dependencia monotónica → Posible redundancia.
• |ρ| 很大(例如 > 0,8):强单调依赖 → 可能存在冗余。
Cuando se detecta posible redundancia hay que estudiar según el contexto si eliminar la menos relevante, menos interpretable o
发现可能冗余后,要结合背景判断:该删的是最不相关、最不好解释或
| 符号 | 西语读法 | 中文含义 |
|---|---|---|
| r | «erre» / «coeficiente de Pearson» | Pearson 相关系数,取值 [−1, 1],衡量线性关系强弱与方向 |
| ρ | «rho» / «coeficiente de Spearman» | Spearman 相关系数,用秩计算,衡量单调关系 |
| |·| | «valor absoluto» | 取绝对值:只关心强弱,不关心正负(−0,95 同样是强冗余) |
| 0.8 | «cero coma ocho» | 经验阈值:超过它才当作「可能冗余」,不是硬性规则 |
2.2 散点图提问 · 该用 Pearson 还是 Spearman?(印刷页 53)
▸ 原页截图 p.51
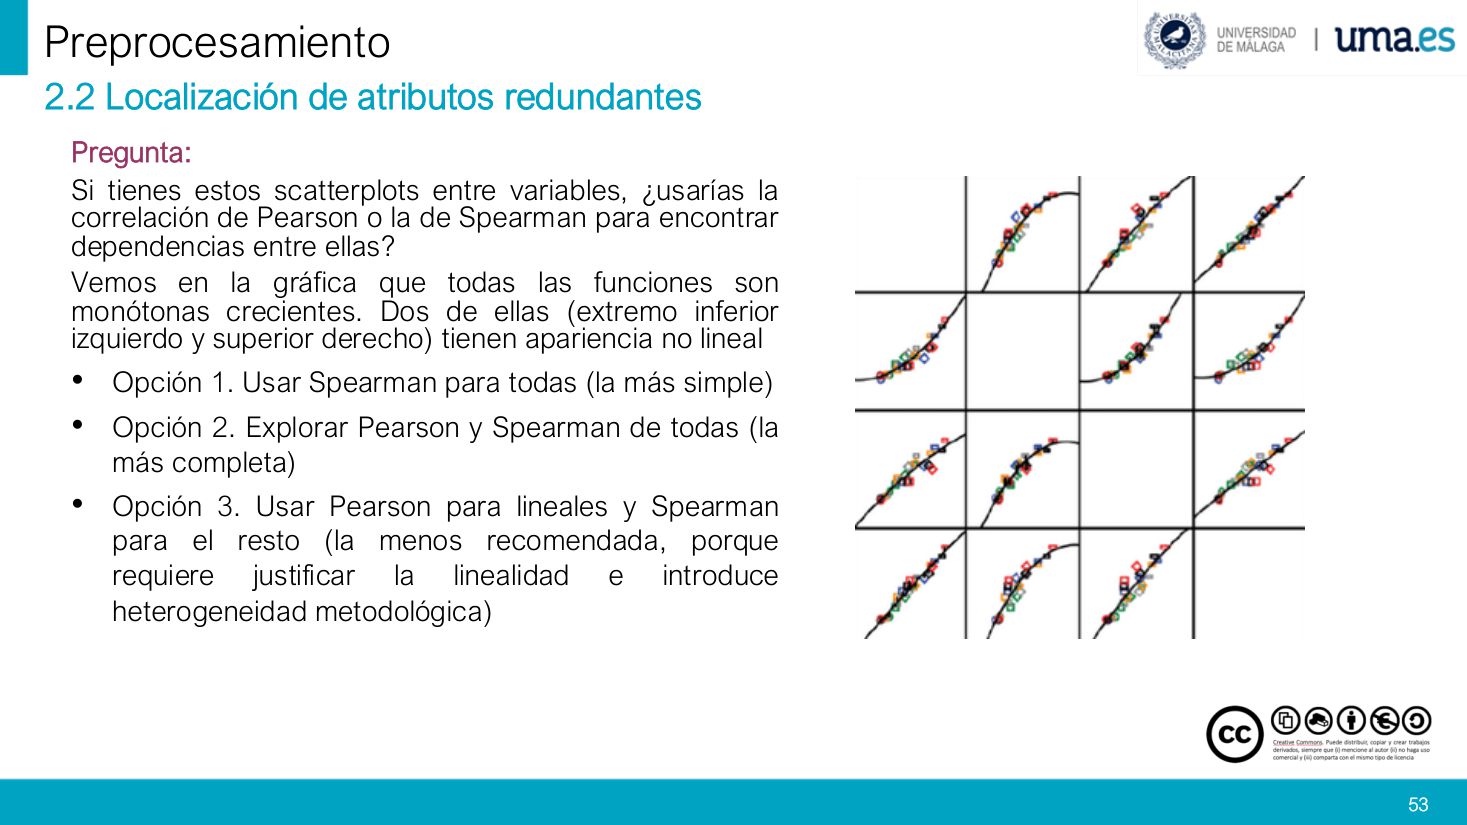
Pregunta: Si tienes estos
提问:若手上有这些变量间的
Vemos en la gráfica que todas las funciones son
图里所有函数都是
• Opción 1. Usar Spearman para todas (la más simple)
• 方案 1:全部用 Spearman(最省事)。
• Opción 2. Explorar Pearson y Spearman de todas (la más completa)
• 方案 2:所有变量对都同时算 Pearson 与 Spearman(信息最全)。
• Opción 3. Usar Pearson para lineales y Spearman para el resto (la menos recomendada, porque requiere justificar la linealidad e introduce
• 方案 3:线性的用 Pearson、其余用 Spearman(最不推荐:你得先逐对论证「它是线性的」,还会引入
六、3. Transformación de datos:缩放、函数变换、编码
p.52–p.713. Transformación de datos · 第三节分隔页(印刷页 54)
▸ 原页截图 p.52
3. Transformación de datos
3. 数据变换(五阶段的第三阶段)
3.1 变换的定义 + 三个子过程:缩放 / 函数变换 / 编码(印刷页 55)
▸ 原页截图 p.53
Llamamos
Esto se hace mediante los siguientes procesos:
它由下面三个过程构成:
• Normalización/Escalado: Se transforman los valores de las variables para que sus magnitudes sean comparables.
• 归一化 / 缩放:把各变量的取值变换到可相互比较的量级(否则「收入 3 万」会盖掉「年龄 35」)。
• Transformaciones funcionales: Aplicamos funciones matemáticas para "moldear" los datos según la necesidad.
• 函数变换:套用数学函数把数据「塑形」,以贴合建模需要(如拉直偏态、削弱极端值)。
• Codificación: Las variables cualitativas se codifican de forma que puedan ser procesadas por los algoritmos.
• 编码:把定性(类别)变量转成算法能处理的数字形式。
3 变换总目录 · 缩放 / 函数变换 / 编码 三大块九小项(印刷页 56)
▸ 原页截图 p.54
Escalado y normalización
① 缩放与归一化(改量级,不改形状)
• Escalado min-max
• Min-Max 缩放
• Normalización Z-score
• Z-Score 标准化
Transformaciones funcionales
② 函数变换(改形状,可能改变排序)
• Lineales
• 线性
• Cuadráticas
• 二次(平方)
• Logarítmicas
• 对数
• Raíz
• 开方
• Transformación Box-Cox
• Box-Cox 变换(用参数 λ 自动在「对数」与「幂」之间找最像正态的那一档)
Codificación
③ 编码(把类别变成数字)
• One hot encoding
• 独热编码
• Label encoding
• 标签编码
3.1 Escalado y normalización · 小节分隔页(印刷页 57)
▸ 原页截图 p.55
3.1 Escalado y normalización
3.1 缩放与归一化
3.1 Min-Max 重缩放 · 映射到任意区间 [a, b](印刷页 58)
▸ 原页截图 p.56
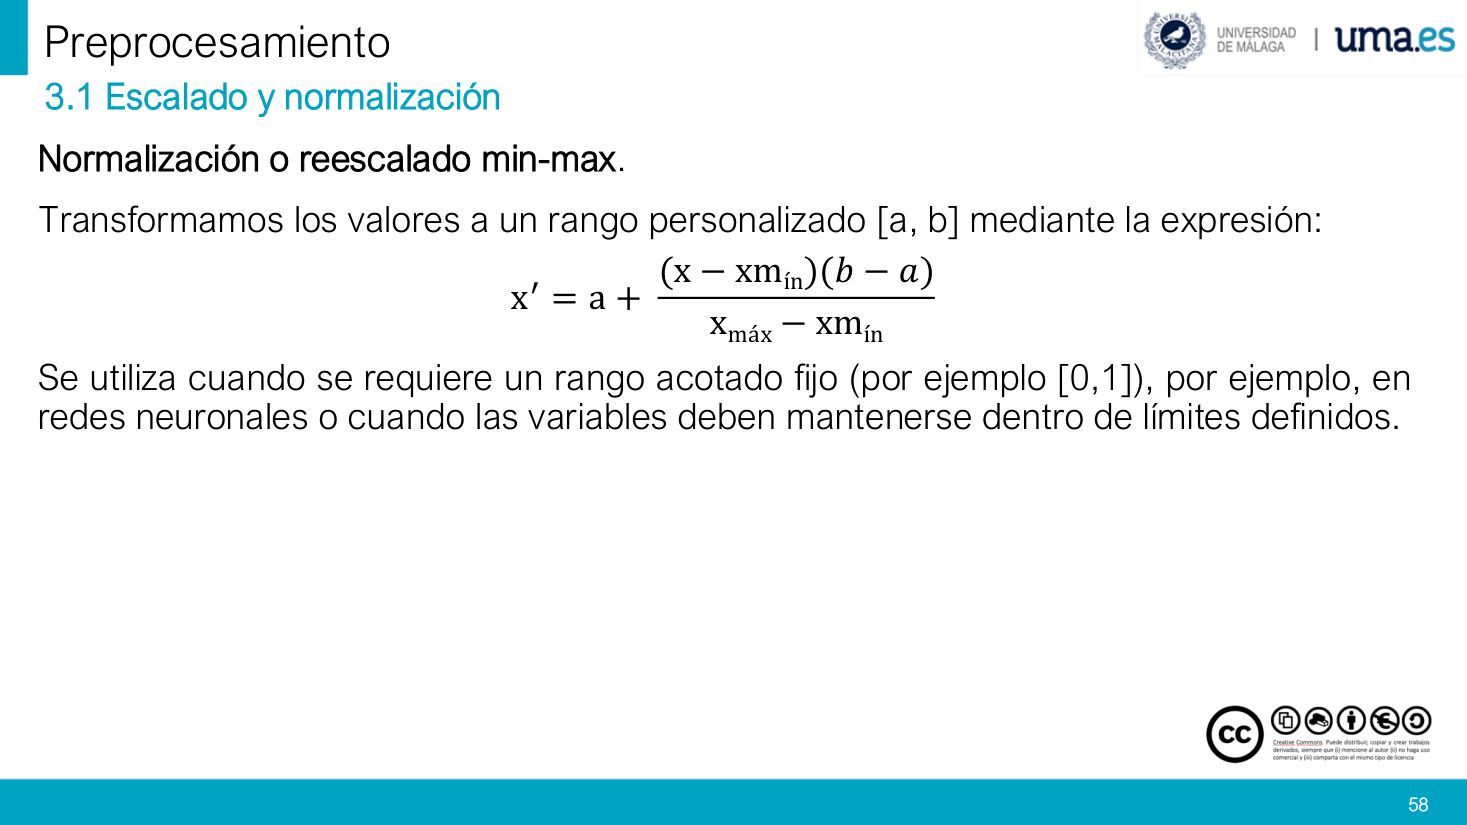
Normalización o
Min-Max
Transformamos los valores a un rango personalizado [a, b] mediante la expresión:
把取值线性映射到自定义区间 [a, b],用的式子是:
| 符号 | 西语读法 | 中文含义 |
|---|---|---|
| x′ | «equis prima» | 缩放后的新值,必落在 [a, b] 内 |
| x | «equis» | 原始值 |
| xmín, xmáx | «equis mínimo» / «equis máximo» | 该列的最小值与最大值(决定映射的两个端点) |
| a, b | «a» / «be» — «extremos del rango» | 目标区间的下界与上界:a 对应 xmín,b 对应 xmáx |
| (b − a) | «amplitud del rango» | 目标区间的宽度,决定缩放后的「拉伸倍数」 |
Se utiliza cuando se requiere un rango acotado fijo (por ejemplo [0,1]), por ejemplo, en redes neuronales o cuando las variables deben mantenerse dentro de límites definidos.
适用于需要固定有界区间(例如 [0,1])的场合:如神经网络,或某些变量必须被限制在明确边界内时。
3.1 Escalado y normalización: Normalización Z-score · 3.1 Z-Score 标准化 · 让均值 0、标准差 1(印刷页 59)
▸ 原页截图 p.57
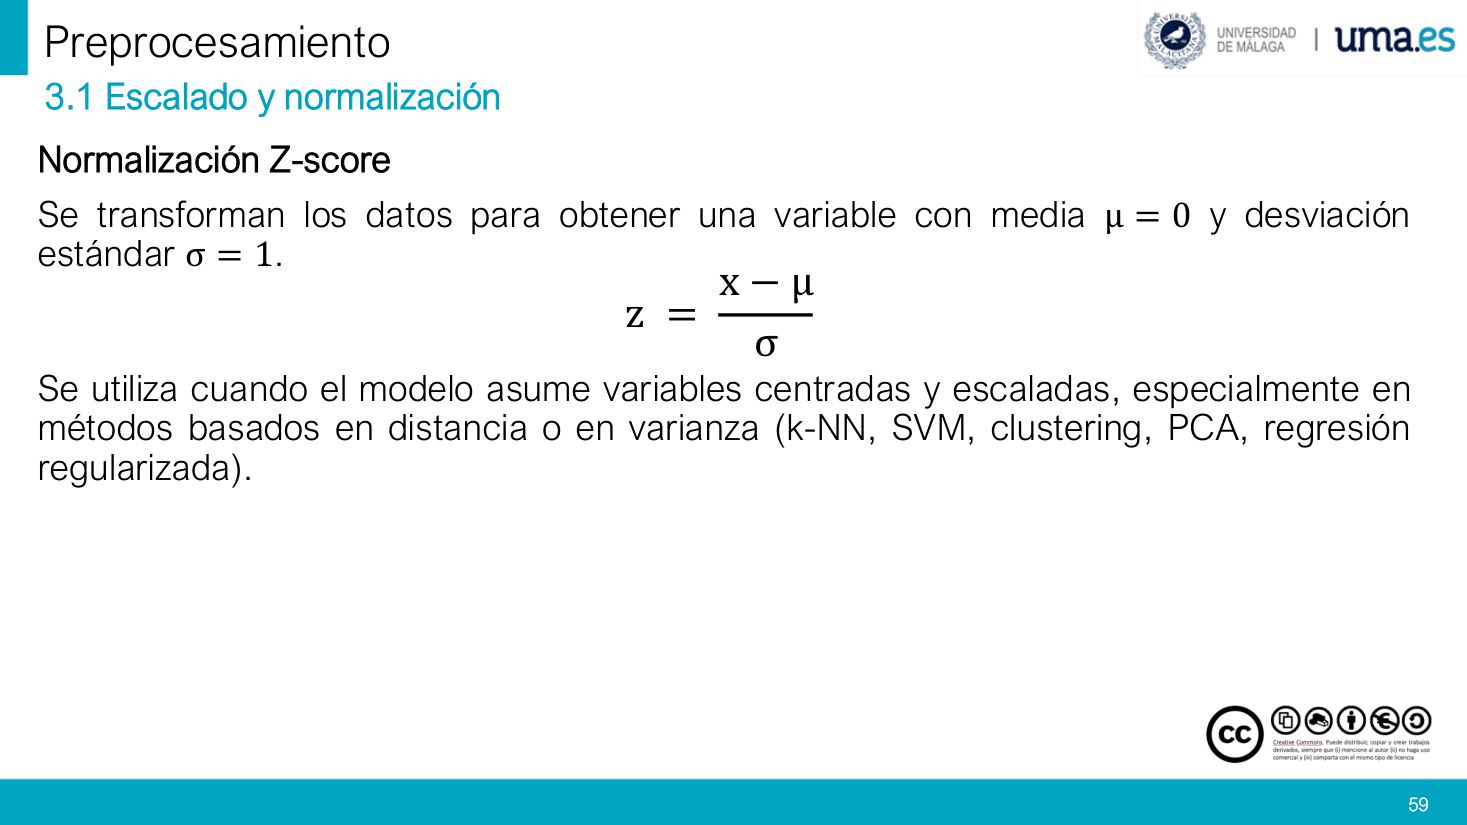
Normalización Z-score
Z-Score 标准化
Se transforman los datos para obtener una variable con
把数据变换成均值为 0、标准差为 1 的变量。
| 符号 | 西语读法 | 中文含义 |
|---|---|---|
| z | «zeta» / «puntuación z» / «valor estandarizado» | 标准化后的值:表示「这个样本距离均值有几个标准差」 |
| x | «equis» | 原始观测值 |
| μ | «mu» / «media» | 该列的均值(变换后整体平移到 0) |
| σ | «sigma» / «desviación estándar» | 该列的标准差(变换后整体缩放到 1) |
Se utiliza cuando el modelo asume variables centradas y escaladas, especialmente en métodos basados en distancia o en varianza (k-NN, SVM, clustering, PCA, regresión regularizada).
适用于「假定变量已中心化、已缩放」的模型,特别是基于距离或基于方差的方法:k-NN、SVM、聚类、PCA、正则化回归。
3.1 Escalado y normalización: Ejercicio · 3.1 练习 · x = 30 在四个区间 / 两种方法下的取值(印刷页 60)
▸ 原页截图 p.58
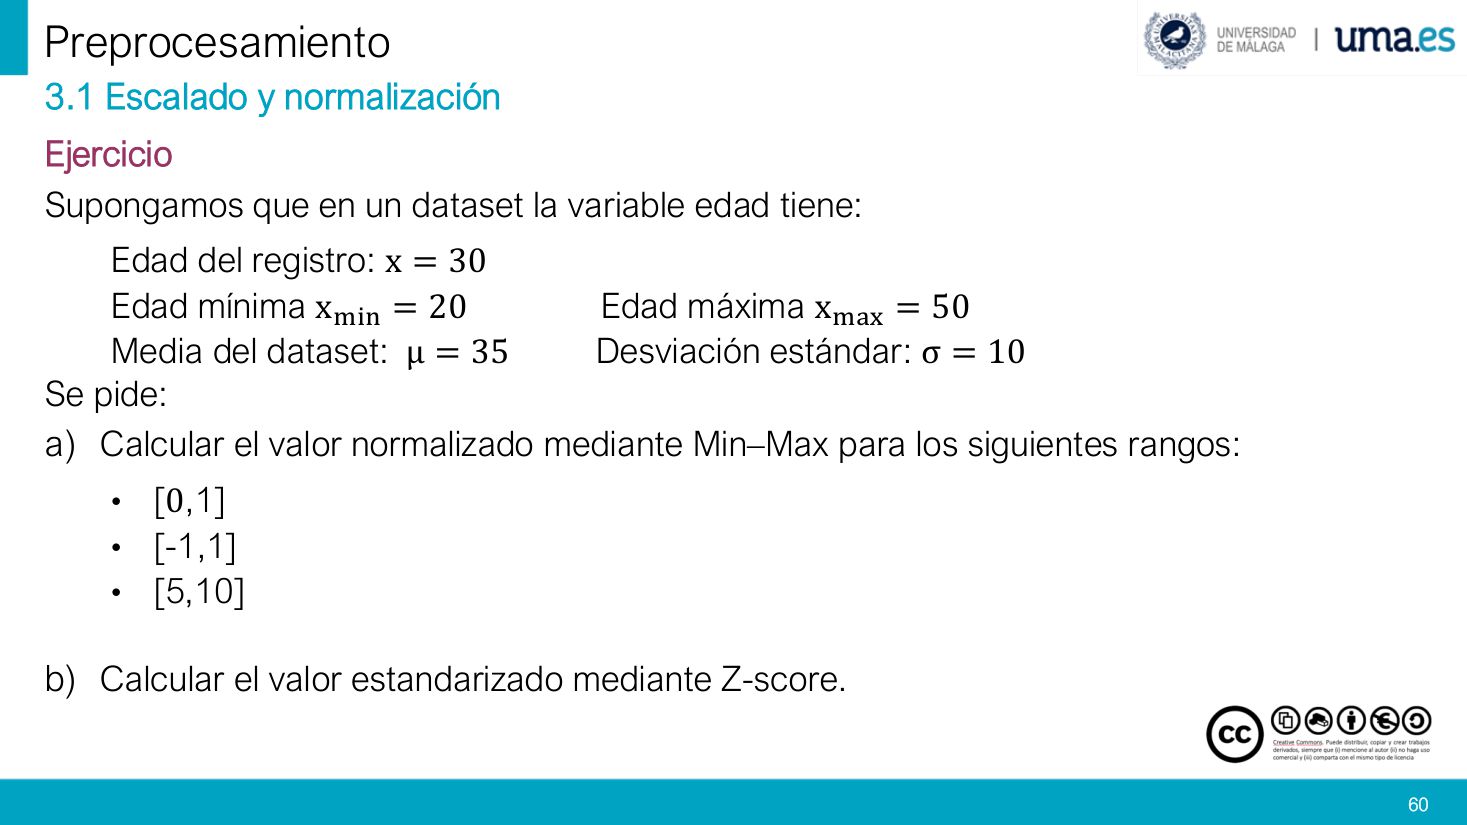
Ejercicio: Supongamos que en un dataset la variable edad tiene:
练习:设某数据集中「年龄」变量为:
Edad del registro: x = 30 | Edad mínima xmin = 20 | Edad máxima xmax = 50 | Media del dataset: μ = 35 | Desviación estándar: σ = 10
该记录的年龄 x = 30;最小值 20;最大值 50;数据集均值 μ = 35;标准差 σ = 10。
Se pide: a) Calcular el valor normalizado mediante Min–Max para los siguientes rangos: [0,1] · [-1,1] · [5,10]. b) Calcular el valor
求:a) 用 Min-Max 分别映射到 [0,1]、[−1,1]、[5,10];b) 用 Z-Score 求
| 方法 / 区间 | 代入 | 结果 | 读法 |
|---|---|---|---|
| Min-Max → [0, 1] | 0 + (30−20)/(50−20) · 1 = 10/30 | 0,3333 | 落在区间下三分之一处 |
| Min-Max → [−1, 1] | −1 + (10/30) · 2 | −0,3333 | 区间中点为 0,故取负 |
| Min-Max → [5, 10] | 5 + (10/30) · 5 | 6,6667 | 同样落在下三分之一 |
| Z-Score | (30 − 35) / 10 = −5/10 | −0,5 | 比均值低半个标准差 |
3.2 Transformaciones funcionales · 小节分隔页(印刷页 61)
▸ 原页截图 p.59
3.2 Transformaciones funcionales
3.2 函数变换
Transformaciones univariantes · 3.2 一元变换 · 对数 ln(X) 与幂 X^λ(印刷页 62)
▸ 原页截图 p.60
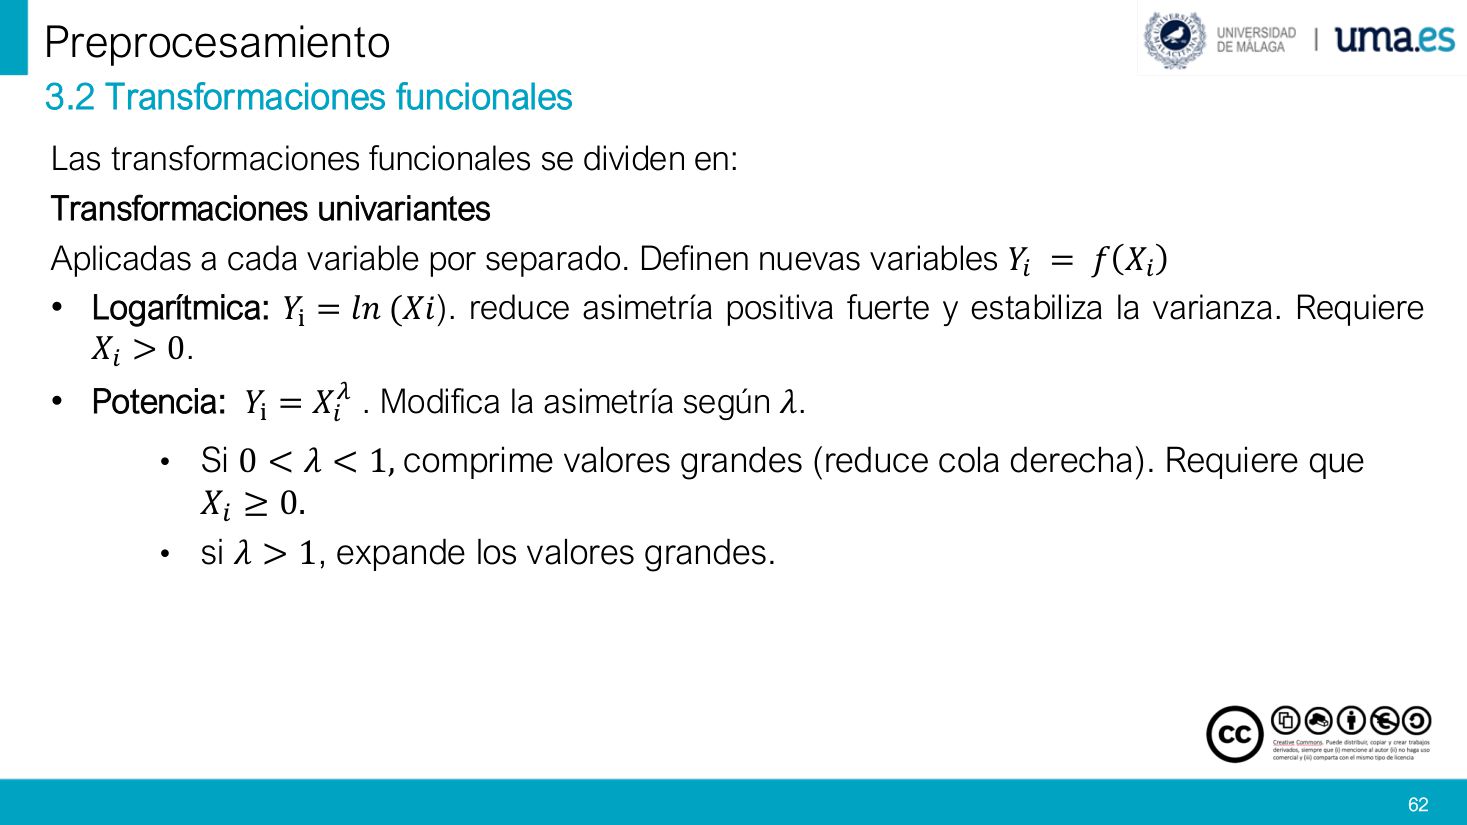
Las transformaciones funcionales se dividen en: Transformaciones univariantes
函数变换分为两类,先讲 一元(单变量)变换:
Aplicadas a cada variable por separado. Definen nuevas variables Yi = f(Xi).
对每一列单独施加,生成新变量 Yi = f(Xi)。
| 符号 | 西语读法 | 中文含义 |
|---|---|---|
| Yi | «i sub i» / «variable transformada» | 第 i 条记录变换后的新值 |
| Xi | «equis sub i» / «valor original» | 第 i 条记录的原始值 |
| f | «efe» / «función de transformación» | 所选的变换函数(对数、幂、开方……) |
| ln | «logaritmo neperiano» | 自然对数(以 e 为底),不是 log₁₀ |
| λ | «lambda» / «exponente» | 幂变换的指数,控制「压缩」还是「放大」 |
• Logarítmica: Yi = ln(Xi). Reduce
• 对数变换:Yi = ln(Xi)。能显著削弱
• Potencia: Yi = Xiλ. Modifica la asimetría según λ.
• 幂变换:Yi = Xiλ。偏度随 λ 改变。
• Si 0 < λ < 1, comprime valores grandes (reduce cola derecha). Requiere que Xi ≥ 0.
• 若 0 < λ < 1:压缩大值(缩短右尾),要求 Xi ≥ 0。
• Si λ > 1, expande los valores grandes.
• 若 λ > 1:放大差异,把大值拉得更大。
Transformaciones multivariantes · 3.2 多元变换 · 线性加权与二次(平方 + 交叉项)(印刷页 63)
▸ 原页截图 p.61
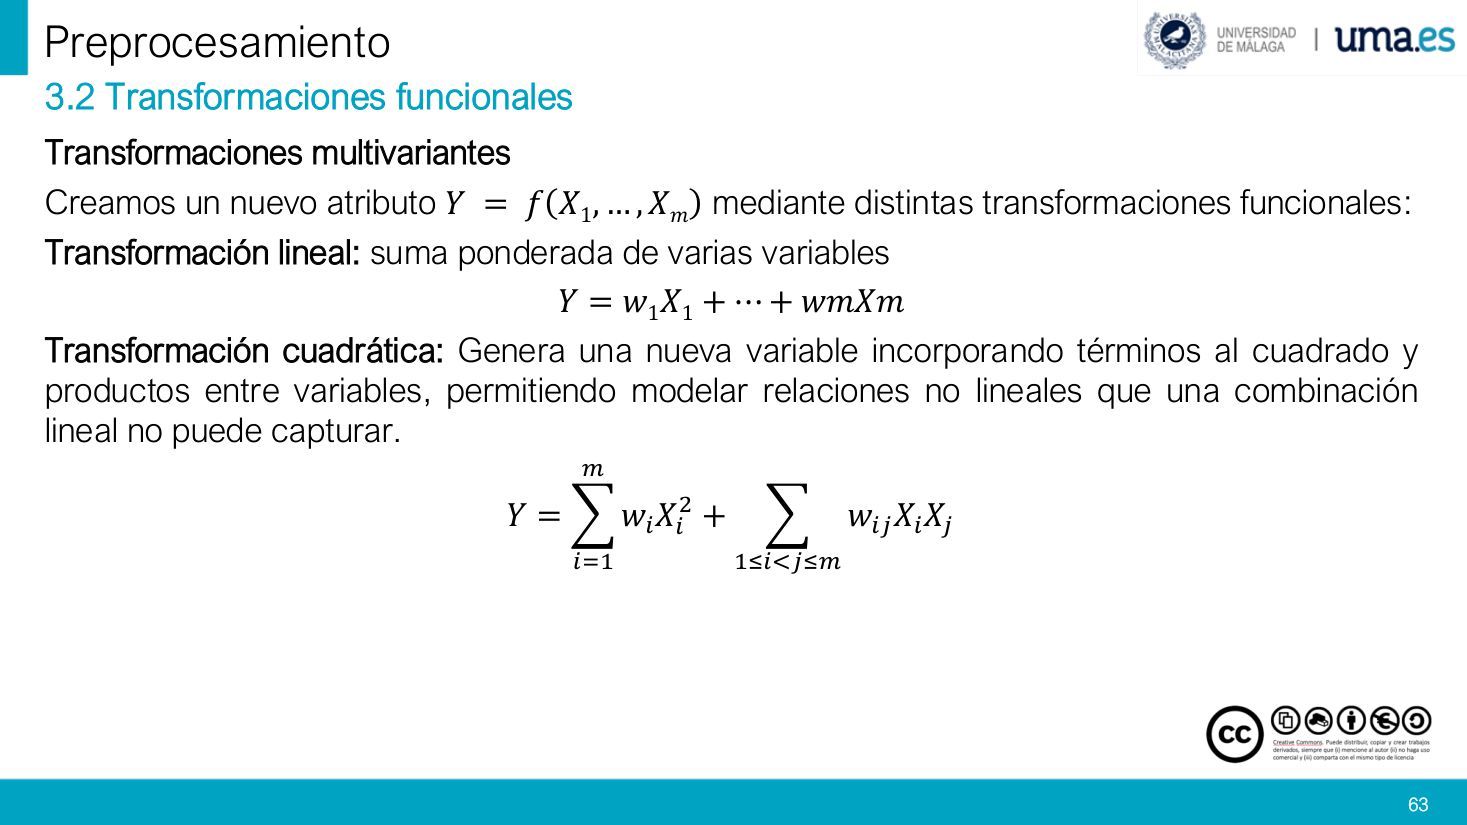
Transformaciones multivariantes
多元变换(由多列共同生成一个新列)
Creamos un nuevo atributo Y = f(X1, …, Xm) mediante distintas transformaciones funcionales:
通过不同的函数,由 m 个属性造出一个新属性 Y = f(X1, …, Xm):
Transformación lineal: suma ponderada de varias variables
线性变换:若干变量的加权和。
| 符号 | 西语读法 | 中文含义 |
|---|---|---|
| Y | «i griega» / «nuevo atributo» | 合成的因变量(如成绩、风险分) |
| w1 … wm | «pesos» / «coeficientes» | 各变量的权重,决定每个变量贡献多大 |
| X1 … Xm | «equis uno … equis eme» | 参与组合的 m 个原始属性 |
| m | «eme» / «número de variables» | 参与组合的变量个数 |
Transformación cuadrática: Genera una nueva variable incorporando términos al cuadrado y productos entre variables, permitiendo modelar relaciones no lineales que una combinación lineal no puede capturar.
二次变换:在新变量里同时加入平方项与变量间的乘积项,从而能刻画线性组合表达不了的非线性关系。
| 符号 | 西语读法 | 中文含义 |
|---|---|---|
| Σ | «sumatorio» | 求和号:把下标范围内所有项加起来 |
| Xi2 | «equis i al cuadrado» | 平方项:让单个变量产生「弯曲」效应 |
| wi | «peso del término cuadrático» | 第 i 个平方项的权重 |
| XiXj | «producto cruzado» / «interacción» | 交叉项:两个变量「共同作用」时才有额外效果 |
| wij | «peso de la interacción» | 交叉项权重;为 0 即「两者没有交互作用」 |
Transformaciones multivariantes: ejemplo · 3.2 多元变换示例 · 学习时数 H 与试卷难度 F 的交互(印刷页 64)
▸ 原页截图 p.62
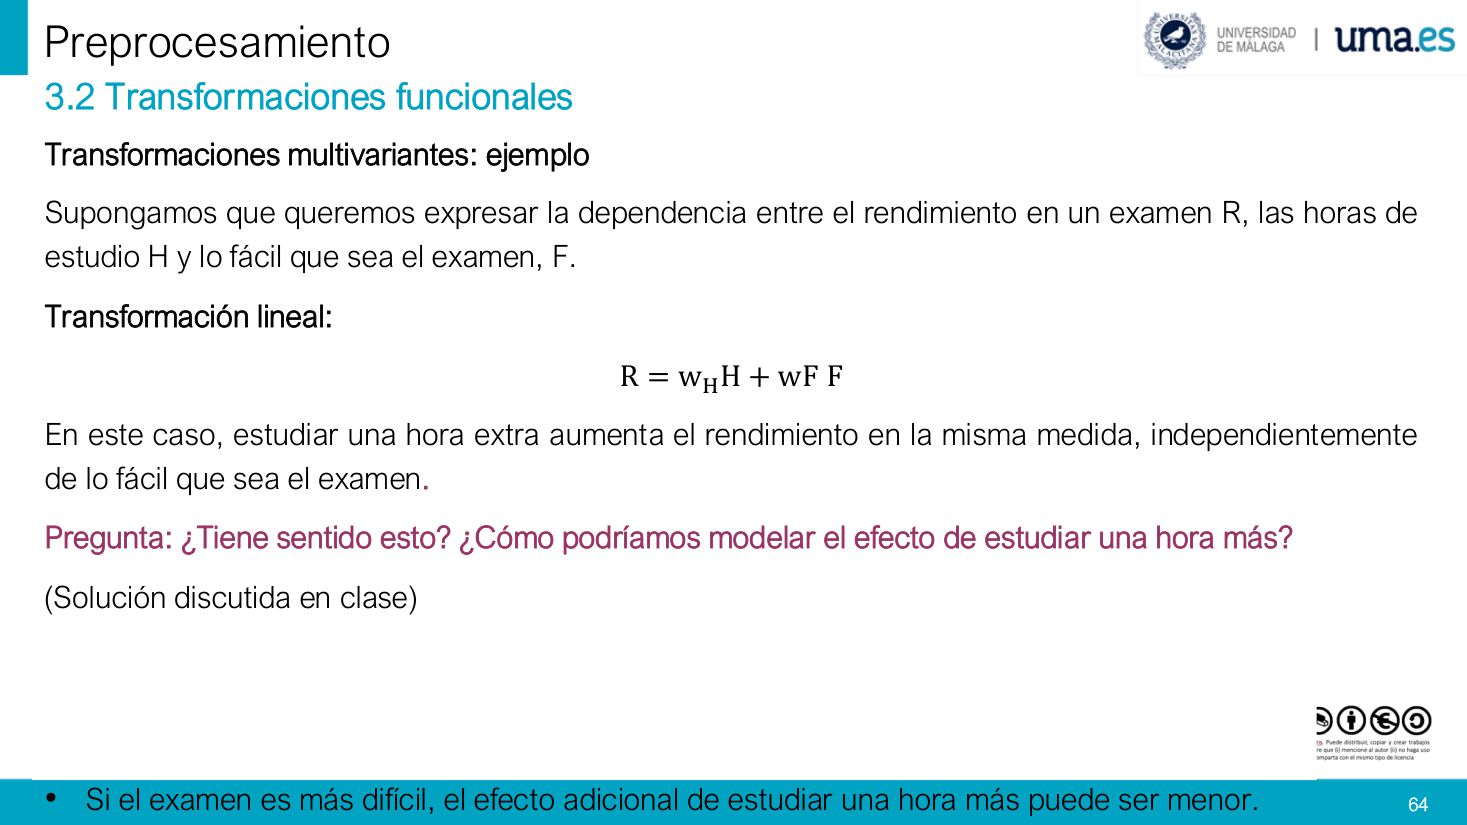
Transformaciones multivariantes: ejemplo. Supongamos que queremos expresar la dependencia entre el rendimiento en un examen R, las horas de estudio H y lo fácil que sea el examen, F.
多元变换示例:设我们要刻画考试成绩 R 与「学习时数 H」「试卷容易程度 F」之间的依赖关系。
Transformación lineal: R = wHH + wFF
线性变换:R = wHH + wFF
En este caso, estudiar una hora extra aumenta el rendimiento en la misma medida, independientemente de lo fácil que sea el examen.
在这种写法下,多学一小时带来的提分是固定的,与试卷难易无关。
| 符号 | 西语读法 | 中文含义 |
|---|---|---|
| R | «erre» / «rendimiento» | 考试成绩(因变量) |
| H | «hache» / «horas de estudio» | 学习时数 |
| F | «efe» / «facilidad del examen» | 试卷容易程度 |
| wH | «peso de H» | 每多学 1 小时的固定提分 |
| wF | «peso de F» | 试卷每容易 1 单位带来的固定提分 |
Pregunta: ¿Tiene sentido esto? ¿Cómo podríamos modelar el efecto de estudiar una hora más?
提问:这样写合理吗?要怎么刻画「多学一小时」的效果?
Transformación con interacción: R = wHH + wFF + wHF·(H·F)
带交互项的变换:R = wHH + wFF + wHF·(H·F)
Ahora el efecto de estudiar depende de lo fácil que sea el examen:
这时「多学一小时的效果」取决于试卷难易:
• Si el examen es más fácil, el impacto de estudiar una hora más puede ser mayor.
• 试卷越容易,多学一小时的收益越大。
• Si el examen es más difícil, el efecto adicional de estudiar una hora más puede ser menor.
• 试卷越难,多学一小时的额外收益越小。
3.2 Transformaciones funcionales · 3.2 五种变换一览表 · 例子 + 效果 + 压缩还是放大(印刷页 65)
▸ 原页截图 p.63
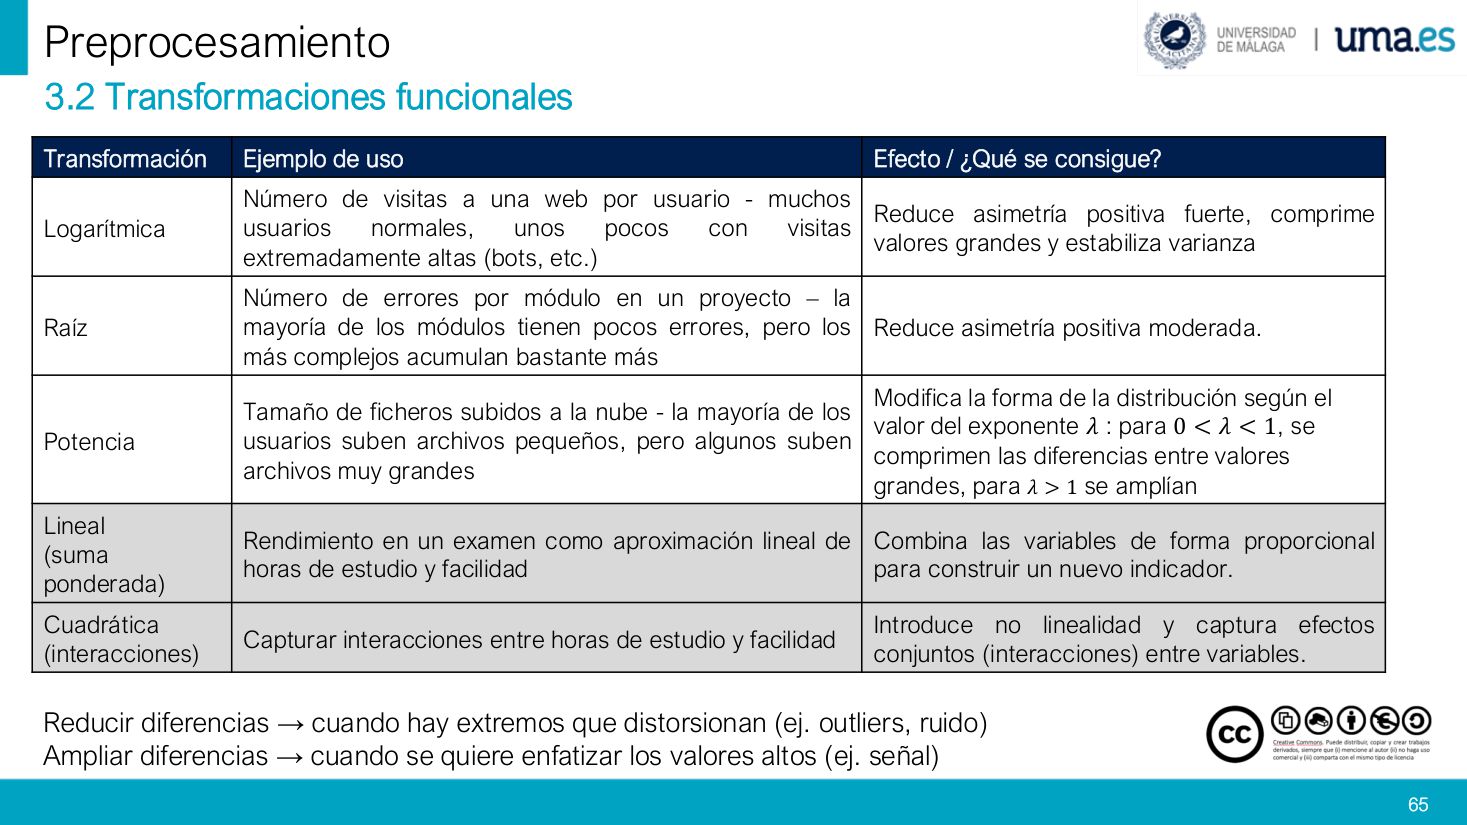
| Transformación | Ejemplo de uso | Efecto / ¿Qué se consigue? |
|---|---|---|
| Logarítmica | Número de visitas a una web por usuario — muchos usuarios normales, unos pocos con visitas extremadamente altas (bots, etc.) | Reduce asimetría positiva fuerte, comprime valores grandes y estabiliza varianza. |
| Raíz | Número de errores por módulo en un proyecto — la mayoría de los módulos tienen pocos errores, pero los más complejos acumulan bastante más. | Reduce asimetría positiva moderada. |
| Potencia | Tamaño de ficheros subidos a la nube — la mayoría de los usuarios suben archivos pequeños, pero algunos suben archivos muy grandes. | Modifica la forma de la distribución según λ: para 0 < λ < 1 se comprimen las diferencias entre valores grandes; para λ > 1 se amplían. |
| Lineal (suma ponderada) |
Rendimiento en un examen como aproximación lineal de horas de estudio y facilidad. | Combina las variables de forma proporcional para construir un nuevo indicador. |
| Cuadrática (interacciones) |
Capturar interacciones entre horas de estudio y facilidad. | Introduce no linealidad y captura efectos conjuntos (interacciones) entre variables. |
Reducir diferencias → cuando hay extremos que distorsionan (ej.
压缩差异 → 当存在会扭曲结果的极端值(如
Ampliar diferencias → cuando se quiere enfatizar los valores altos (ej. señal)
放大差异 → 当想强调高值(信号)时用。
3.3 Codificación de variables categóricas · 小节分隔页(印刷页 66)
▸ 原页截图 p.64
3.3 Codificación de variables categóricas
3.3 类别变量的编码
3.3 Definición · One-Hot / Ordinal / Label 三种编码(印刷页 67)
▸ 原页截图 p.65
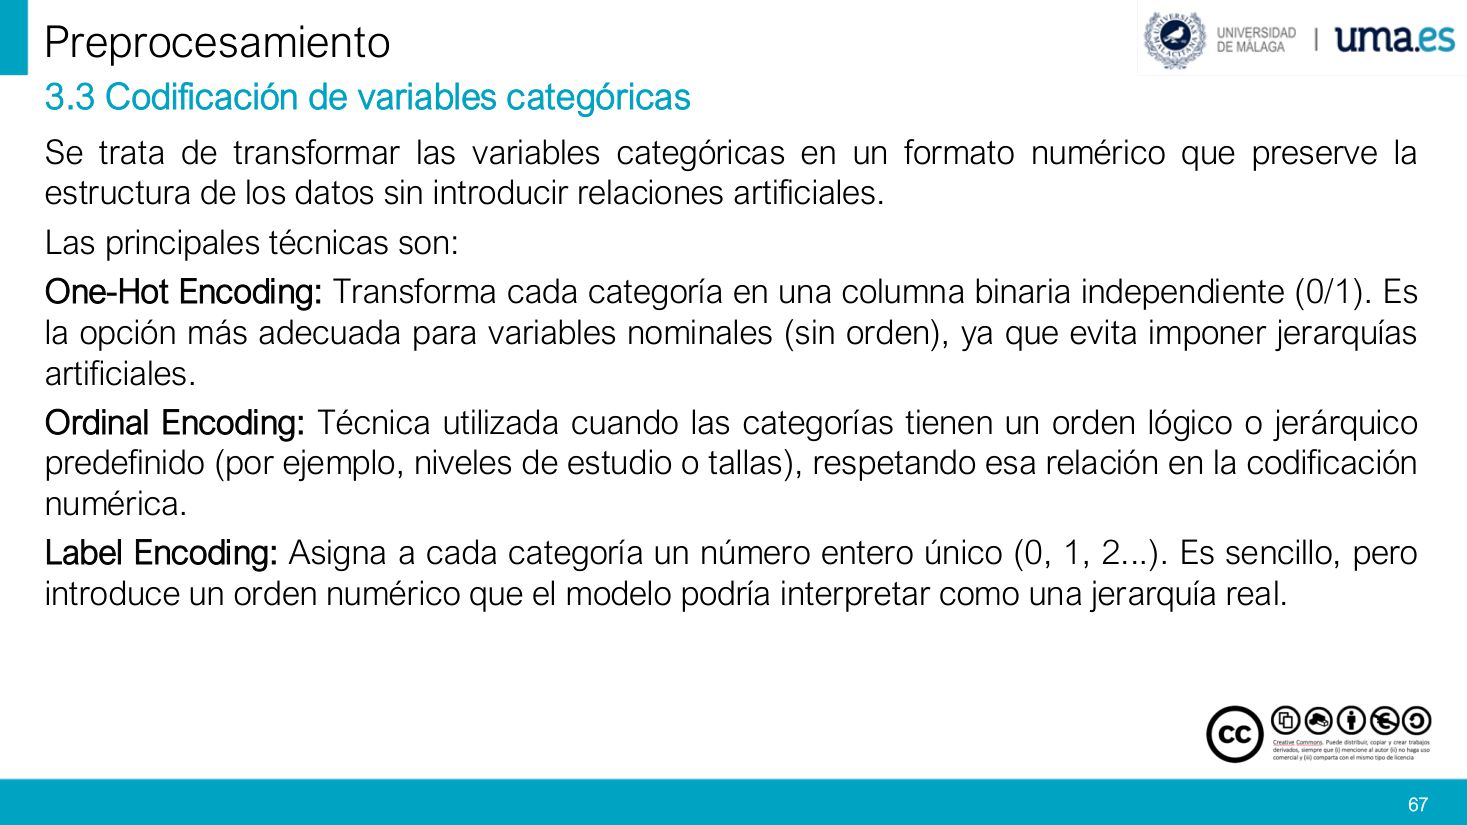
Se trata de transformar las
要做的是把
Las principales técnicas son:
主要技术有以下三种:
(0, 1, 2...),这里的「...」只是省略号,意思是「一直排到 k−1」,不是一个取值范围、也不是「0 到 2 之间任意小数」。若类别共 k 个,整数编号就是 0,1,…,k−1,共 k 个连续整数,不能跳号、不能取小数。3.3 One-Hot Encoding · 一个类别一列 0/1(印刷页 68)
▸ 原页截图 p.66
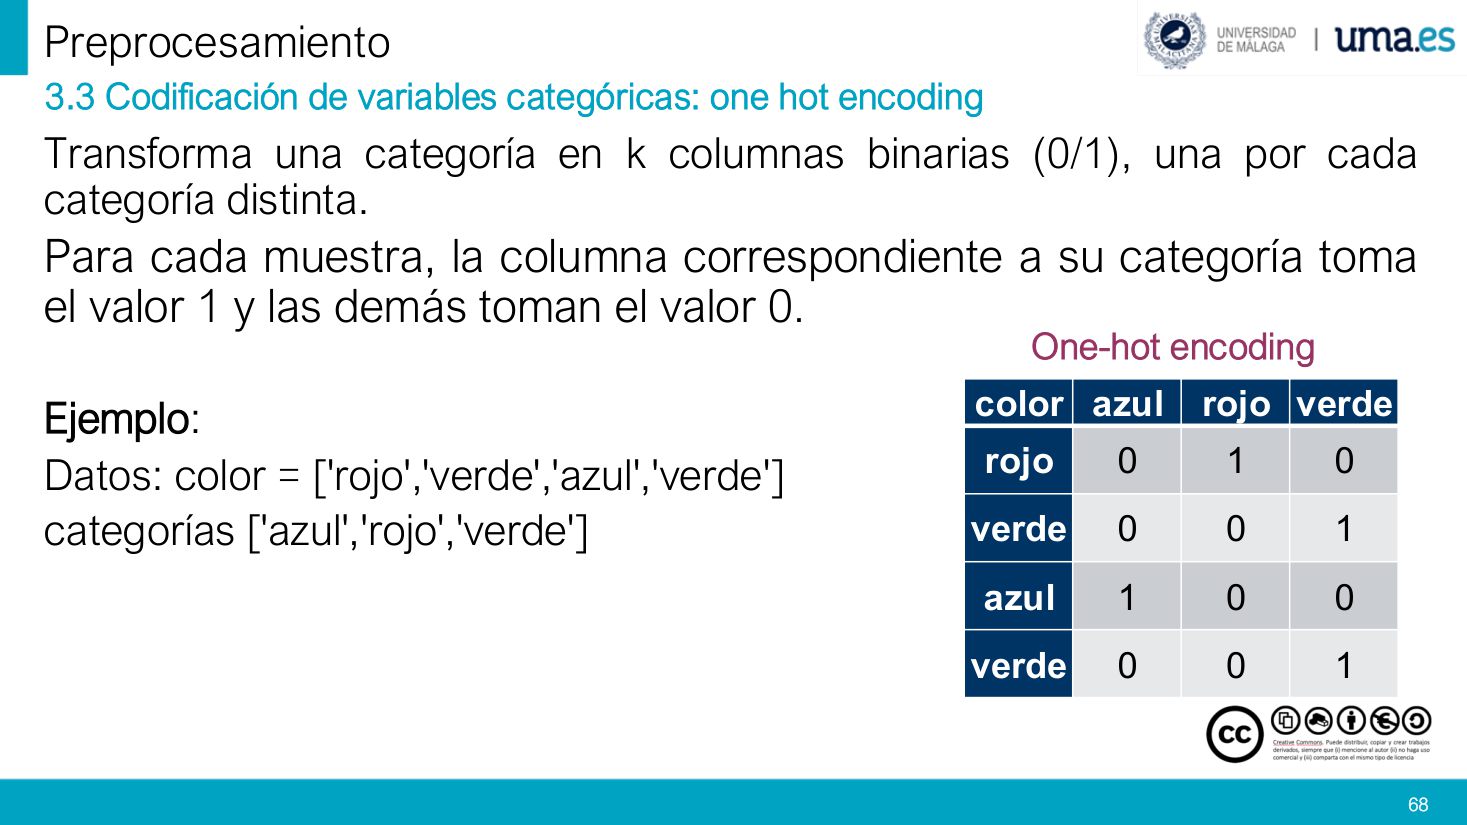
Transforma una categoría en k columnas binarias (0/1), una por cada categoría distinta.
把一个类别变量拆成 k 列二元变量(0/1),每个取值一列。
Para cada muestra, la columna correspondiente a su categoría toma el valor 1 y las demás toman el valor 0.
每条样本在自己所属那一列填 1,其余列一律填 0(所以每行只有一个 1)。
Ejemplo: Datos: color = ['rojo','verde','azul','verde']; categorías ['azul','rojo','verde']
例:数据 color = ['rojo','verde','azul','verde'];共三个类别 ['azul','rojo','verde']。
| color | azul | rojo | verde |
|---|---|---|---|
| rojo | 0 | 1 | 0 |
| verde | 0 | 0 | 1 |
| azul | 1 | 0 | 0 |
| verde | 0 | 0 | 1 |
3.3 Label Encoding · 一列整数标签(印刷页 69)
▸ 原页截图 p.67
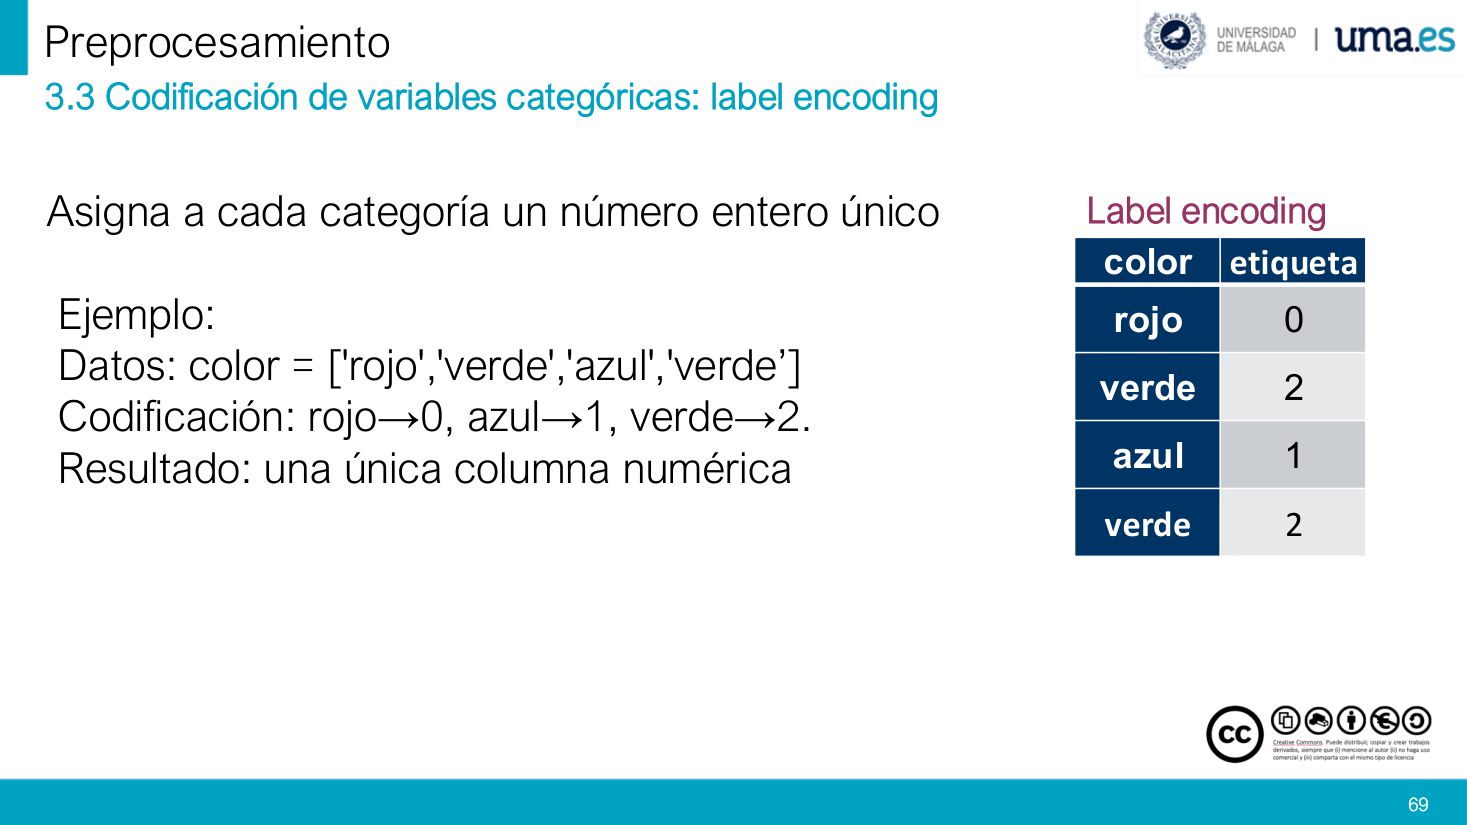
Label Encoding: Asigna a cada categoría un número entero único.
标签编码:给每个类别分配一个唯一整数。
Ejemplo: Datos: color = ['rojo','verde','azul','verde']
例:数据 color = ['rojo','verde','azul','verde']。
Codificación: rojo→0, azul→1, verde→2. Resultado: una única columna numérica.
编码:rojo→0、azul→1、verde→2。结果仍是一列数值。
| color | etiqueta |
|---|---|
| rojo | 0 |
| verde | 2 |
| azul | 1 |
| verde | 2 |
3.3 Ordinal Encoding · 让编号体现天然顺序(印刷页 70)
▸ 原页截图 p.68
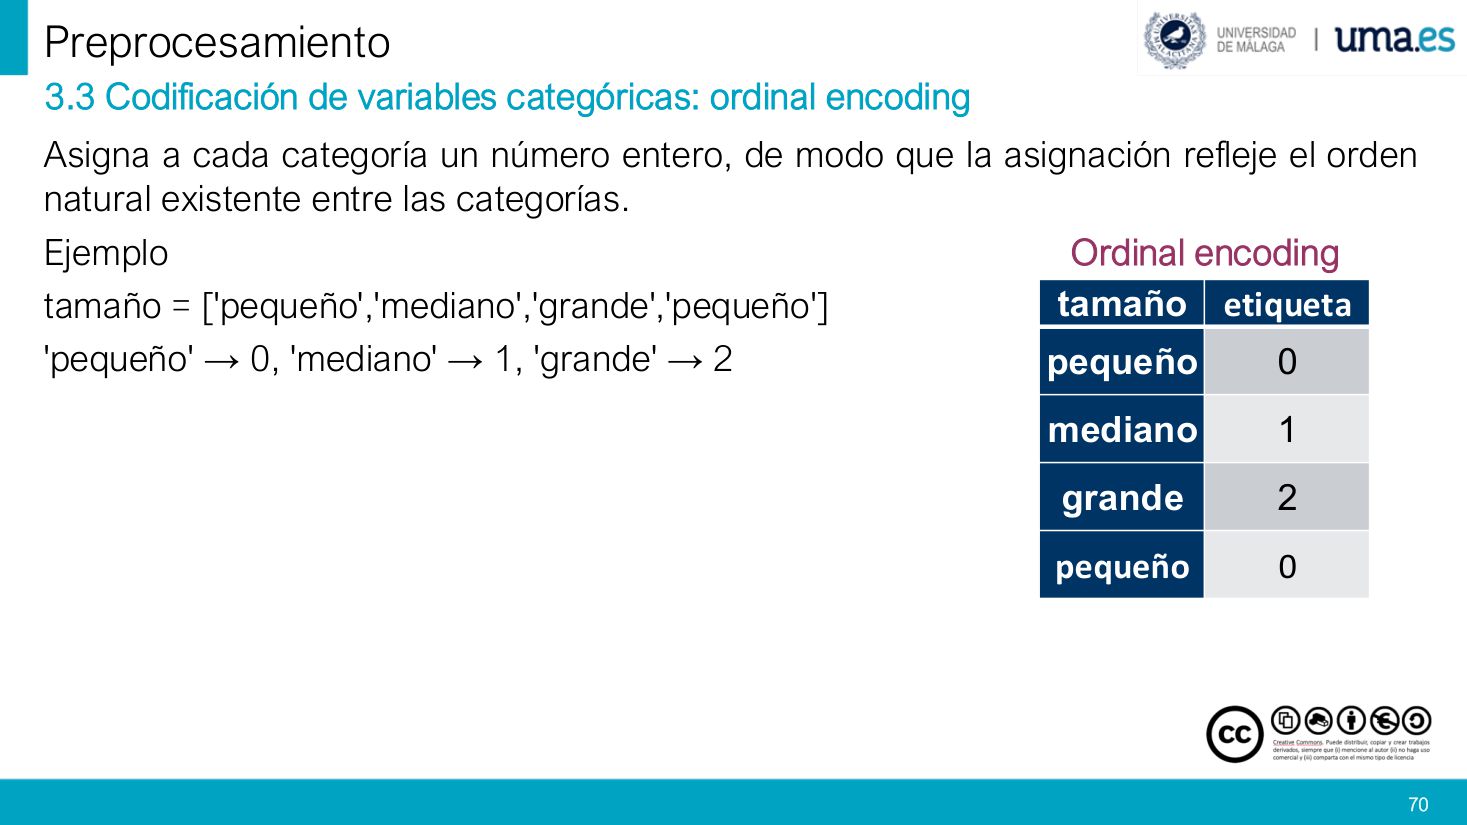
Ordinal Encoding: Asigna a cada categoría un número entero, de modo que la asignación refleje el
序号编码:给每个类别一个整数,且编号必须体现类别之间真实存在的
Ejemplo: tamaño = ['pequeño','mediano','grande','pequeño']
例:tamaño(尺码)= ['pequeño','mediano','grande','pequeño']。
'pequeño' → 0, 'mediano' → 1, 'grande' → 2
'pequeño' → 0、'mediano' → 1、'grande' → 2(编号顺序 = 真实的大小顺序)。
| tamaño | etiqueta |
|---|---|
| pequeño | 0 |
| mediano | 1 |
| grande | 2 |
| pequeño | 0 |
3.3 三种编码汇总表 + CUIDADO 警告(印刷页 71)
▸ 原页截图 p.69
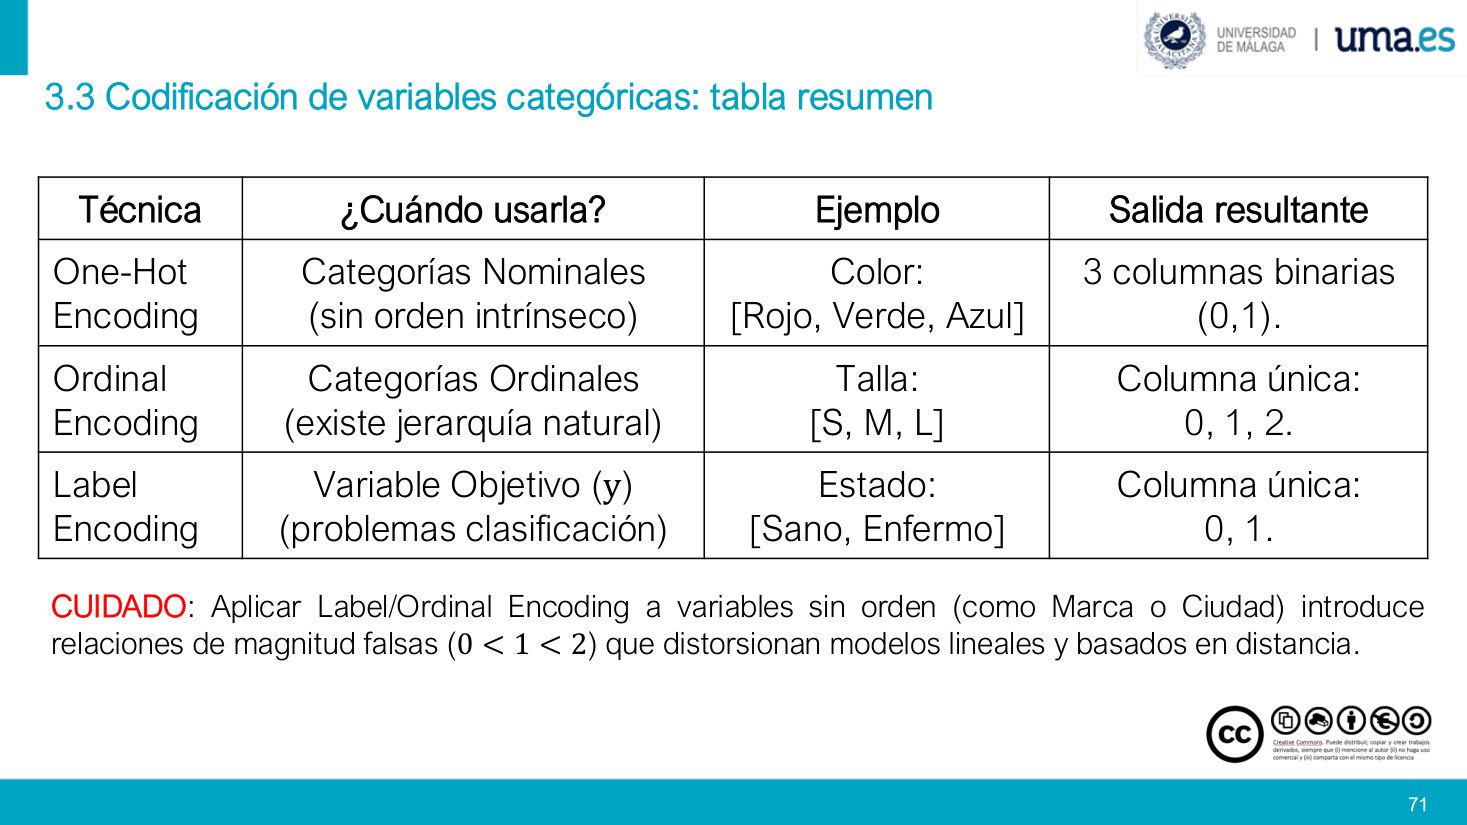
CUIDADO: Aplicar Label/Ordinal Encoding a variables sin orden (como Marca o Ciudad) introduce
注意:对没有顺序的变量(如「品牌」「城市」)套用 Label / Ordinal,会引入
| Técnica | ¿Cuándo usarla? | Ejemplo | Salida resultante |
|---|---|---|---|
| One-Hot Encoding | Categorías Nominales (sin orden intrínseco) | Color: [Rojo, Verde, Azul] | 3 columnas binarias (0,1). |
| Ordinal Encoding | Categorías Ordinales (existe jerarquía natural) | Talla: [S, M, L] | Columna única: 0, 1, 2. |
| Label Encoding | Variable Objetivo (y) (problemas clasificación) | Estado: [Sano, Enfermo] | Columna única: 0, 1. |
3.3 Codificación de variables categóricas: ventajas e inconvenientes · 三种编码的优缺点对照(印刷页 72)
▸ 原页截图 p.70
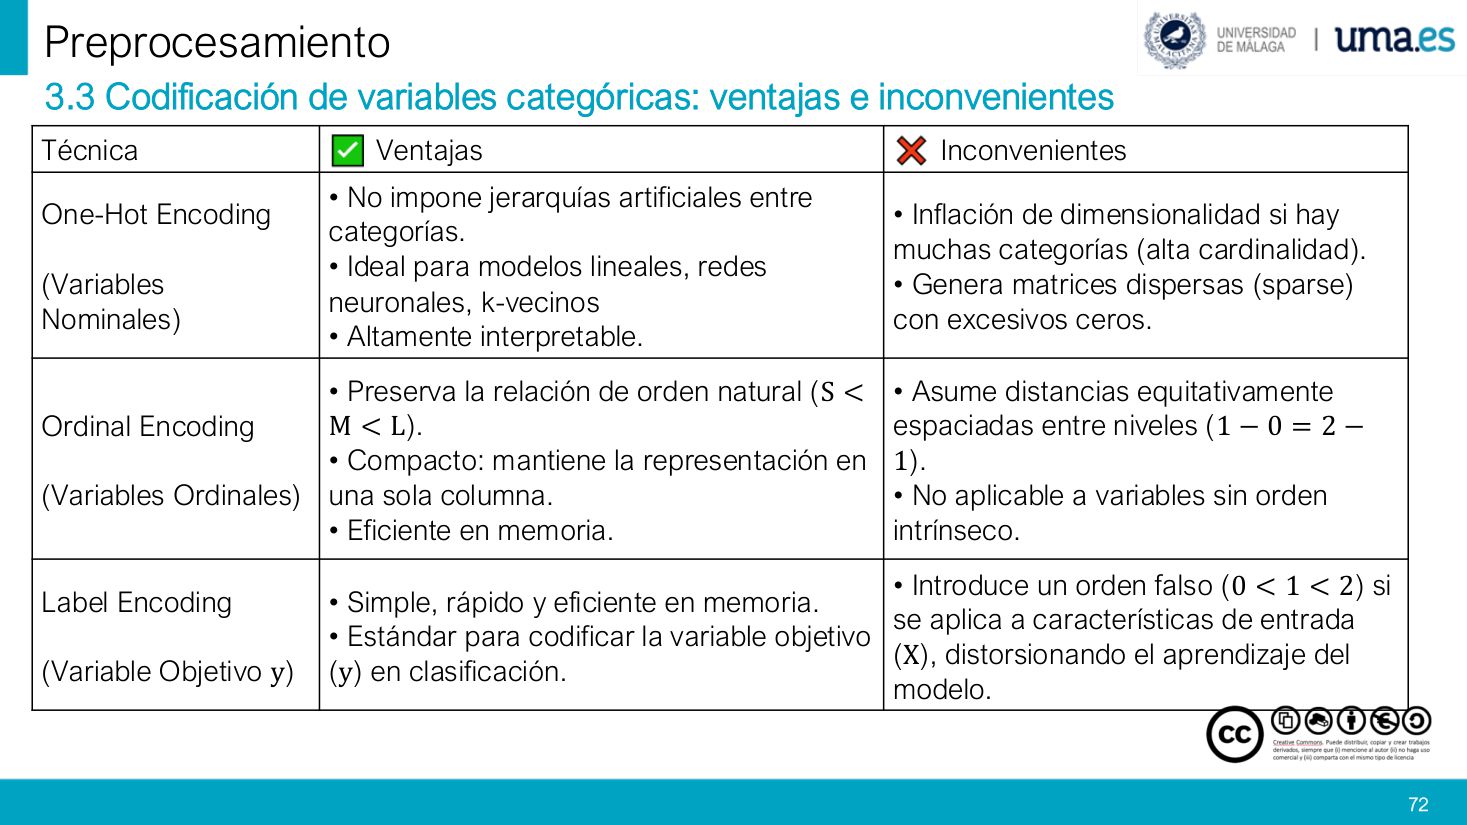
3.3 Codificación de variables categóricas: ventajas e inconvenientes
3.3 类别变量的编码:优点与缺点
•
•
•
•
•
•
| Técnica | Ventajas | Inconvenientes |
|---|---|---|
| One-Hot Encoding (Variables Nominales) |
• No impone jerarquías artificiales entre categorías. • Ideal para modelos lineales, redes neuronales, k-vecinos. • Altamente interpretable. |
• Inflación de dimensionalidad si hay muchas categorías (alta cardinalidad). • Genera matrices dispersas (sparse) con excesivos ceros. |
| Ordinal Encoding (Variables Ordinales) |
• Preserva la relación de orden natural (S < M < L). • Compacto: mantiene la representación en una sola columna. • Eficiente en memoria. |
• Asume distancias equitativamente espaciadas entre niveles (1 − 0 = 2 − 1). • No aplicable a variables sin orden intrínseco. |
| Label Encoding (Variable Objetivo y) |
• Simple, rápido y eficiente en memoria. • Estándar para codificar la variable objetivo (y) en clasificación. |
• Introduce un orden falso (0 < 1 < 2) si se aplica a características de entrada (X), distorsionando el aprendizaje del modelo. |
3.3 练习 · 车辆三属性各用哪种编码?(印刷页 73)
▸ 原页截图 p.71
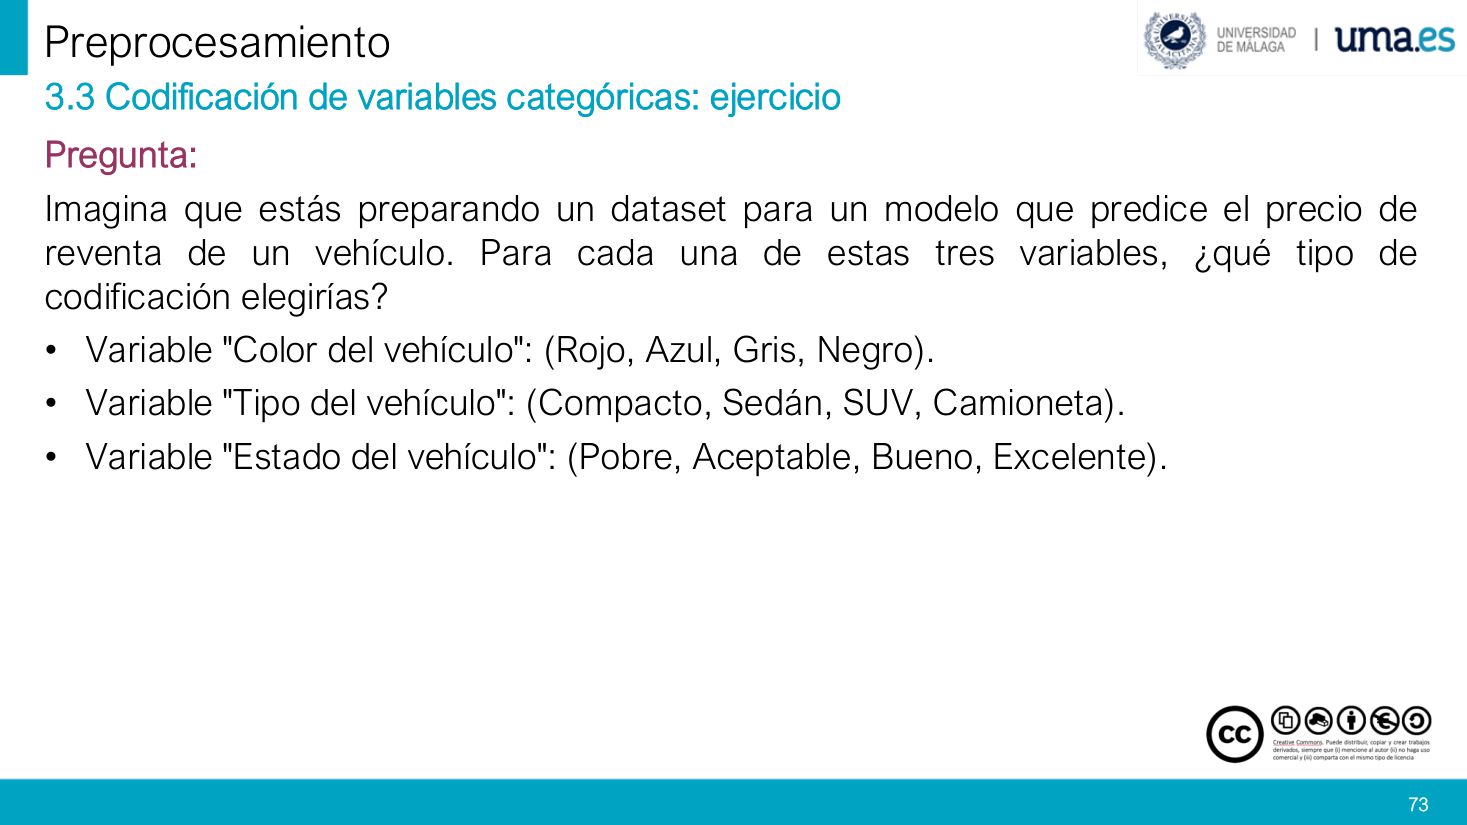
Pregunta: Imagina que estás preparando un dataset para un modelo que predice el precio de reventa de un vehículo. Para cada una de estas tres variables, ¿qué tipo de codificación elegirías?
提问:你在为一个「预测车辆转售价格」的模型准备数据。下面三个变量,各该用哪种编码?
• Variable "Color del vehículo": (Rojo, Azul, Gris, Negro).
• 变量「车身颜色」:(红、蓝、灰、黑)。
• Variable "Tipo del vehículo": (Compacto, Sedán, SUV, Camioneta).
• 变量「车型」:(紧凑型、轿车、SUV、皮卡)。
• Variable "Estado del vehículo": (Pobre, Aceptable, Bueno, Excelente).
• 变量「车况」:(差、可接受、良好、优秀)。
| 变量 | 有无顺序 | 选哪种编码 | 理由 |
|---|---|---|---|
| Color | 无(名义) | One-Hot | 颜色之间没有大小,独热可避免「红 < 蓝 < 灰」的假序 |
| Tipo | 无(名义) | One-Hot | 车型是分类不是等级;SUV 并不「大于」轿车 |
| Estado | 有(有序) | Ordinal | 差 < 可接受 < 良好 < 优秀,是天然等级,应保留顺序 |
七、4. Reducción de datos:降维、降样本与特征提取
p.72–p.914. Reducción de datos · 章节分隔页(印刷页 75)
▸ 原页截图 p.72
4. Reducción de datos
4. 数据归约(降维与降样本)
4. Reducción de datos · 复杂度取决于 d 与 n:d≫n 与 n≫d(印刷页 76)
▸ 原页截图 p.73
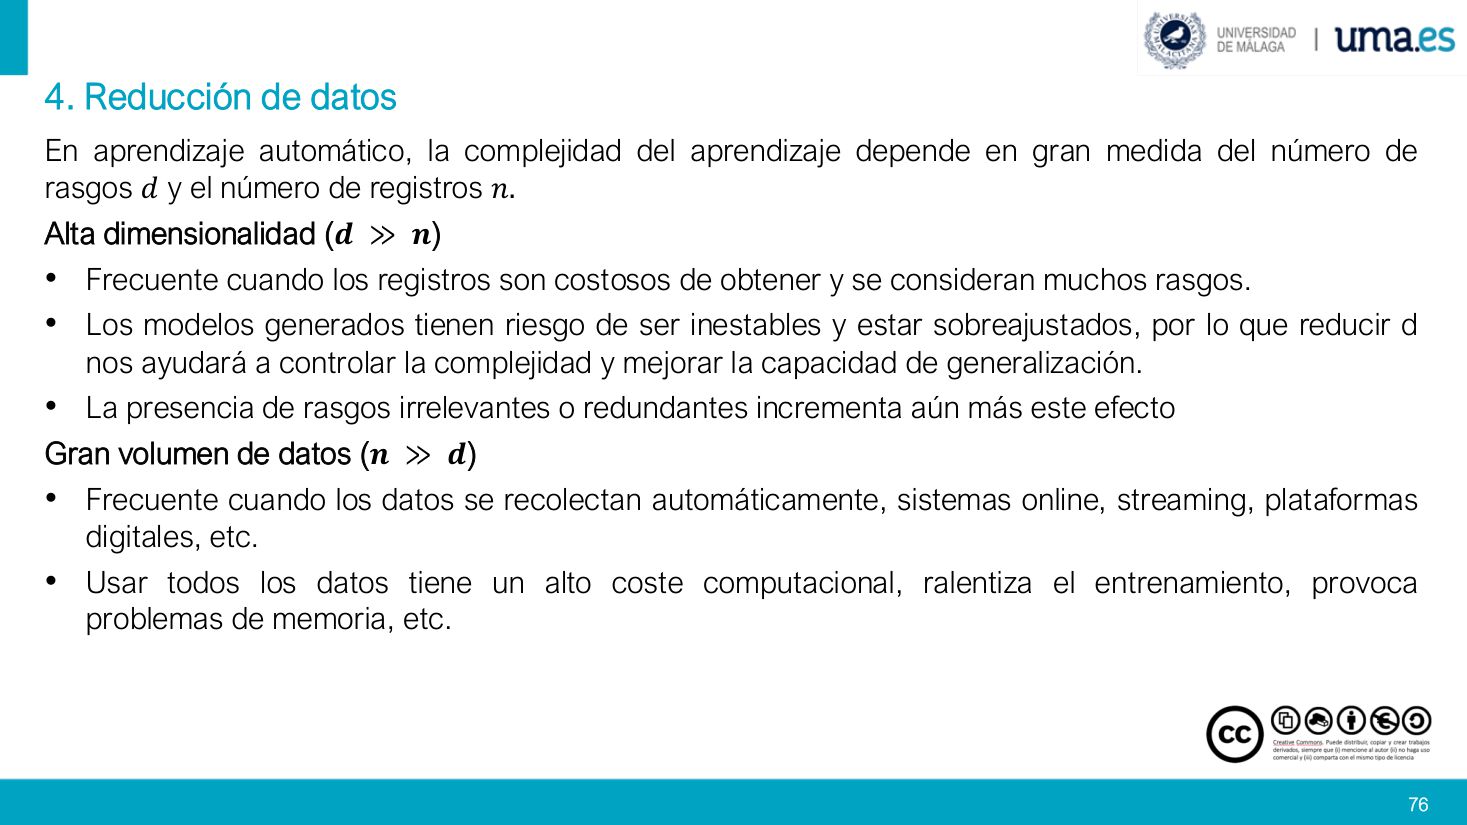
En aprendizaje automático, la complejidad del aprendizaje depende en gran medida del número de
在机器学习中,学习的复杂度在很大程度上取决于
• Frecuente cuando los registros son costosos de obtener y se consideran muchos rasgos.
• 常见于记录获取成本高、却又考虑了很多特征的场景(例如医学检查:样本难凑,指标一大堆)。
• Los modelos generados tienen riesgo de ser inestables y estar
• 这样得到的模型容易不稳定、
• La presencia de rasgos
• 若还存在
• Frecuente cuando los datos se recolectan automáticamente, sistemas online, streaming, plataformas digitales, etc.
• 常见于数据被自动采集的场景:在线系统、流式数据、数字平台等(每天自动堆出海量行)。
• Usar todos los datos tiene un alto
• 用全量数据
| 符号 | 西语读法 | 中文含义 |
|---|---|---|
| d | número de rasgos | 特征数(列数),也叫维度 |
| n | número de registros | 记录数(行数),也叫样本量 |
| ≫ | mucho mayor que | 「远大于」,强调两者数量级上的悬殊 |
| d ≫ n | alta dimensionalidad | 高维小样本:降列(特征选择 / 提取) |
| n ≫ d | gran volumen de datos | 大数据量低维:降行(记录选择 / 抽样) |
4. Reducción de datos · 定义与三种技术(印刷页 77)
▸ 原页截图 p.74
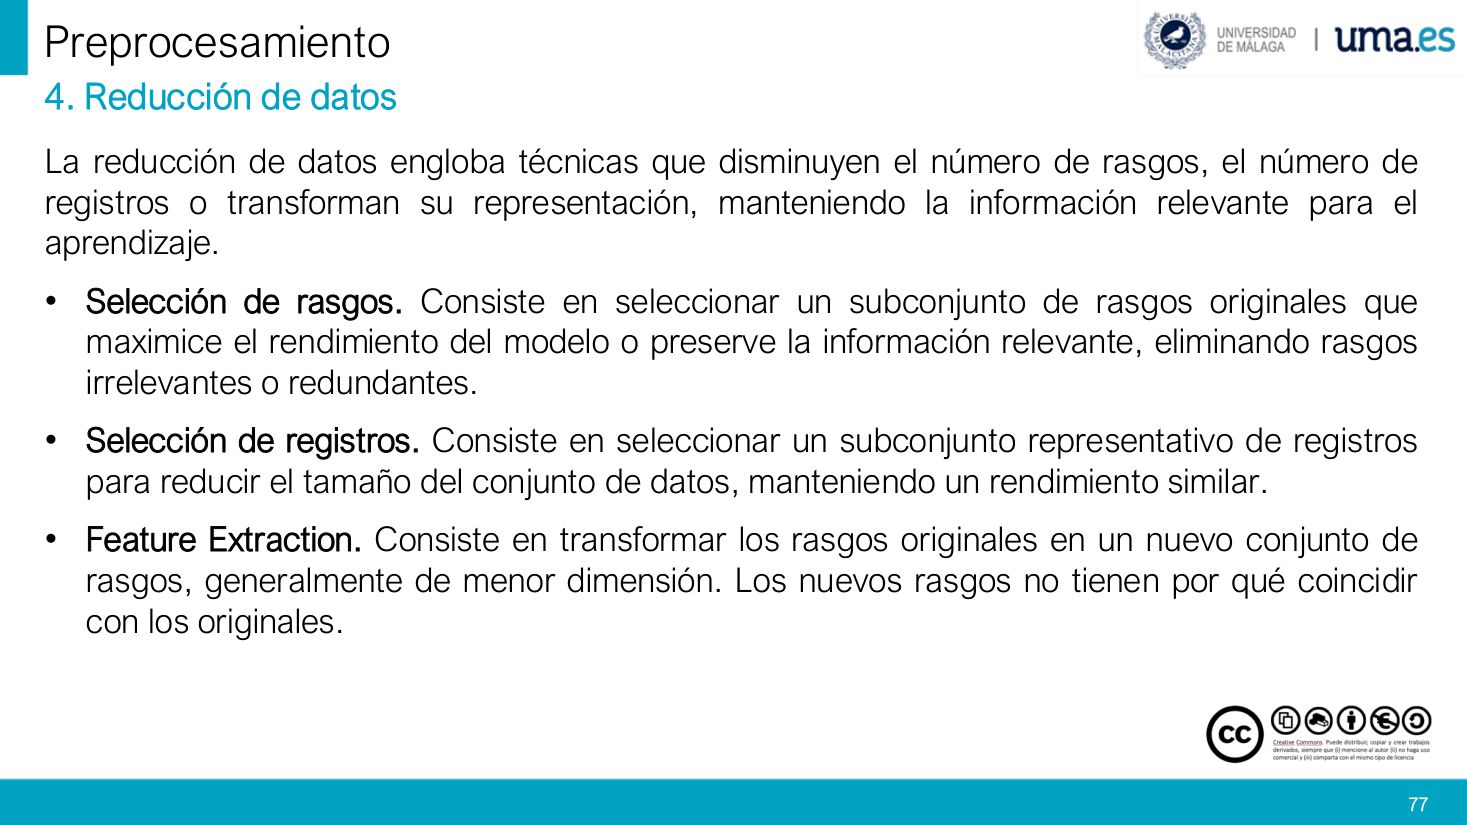
La
•
•
•
•
•
•
4. Reducción de datos · 三种技术对照表(印刷页 78)
▸ 原页截图 p.75
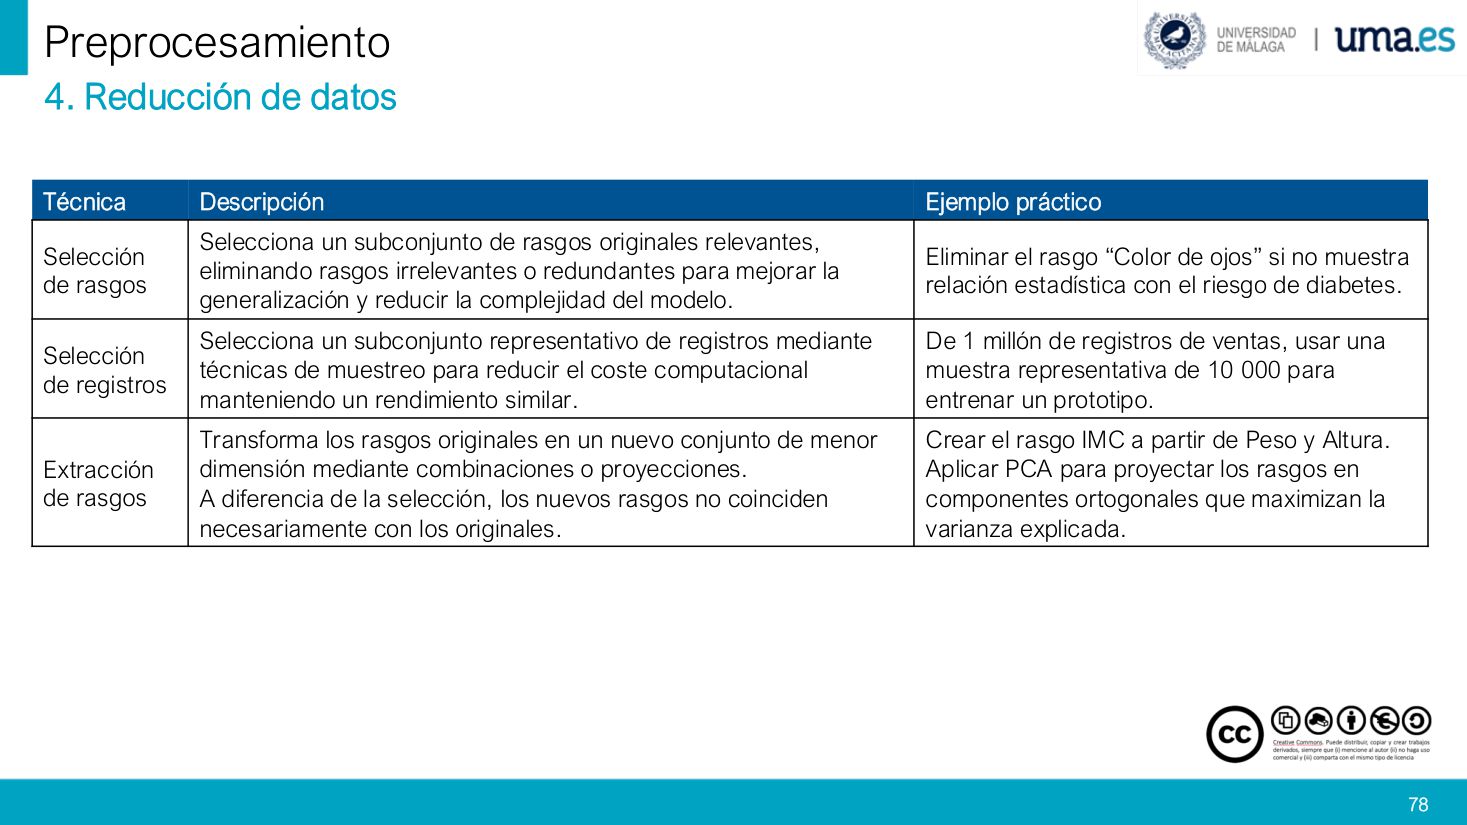
Técnica · Descripción · Ejemplo práctico
技术 · 说明 · 实例(本页为三行对照表)
Selección de rasgos: Selecciona un subconjunto de rasgos originales relevantes, eliminando rasgos irrelevantes o redundantes para mejorar la generalización y reducir la complejidad del modelo.
特征选择:挑出原特征中相关的子集,删掉无关或冗余的列,以提升泛化、降低模型复杂度。
Selección de registros: Selecciona un subconjunto representativo de registros mediante técnicas de muestreo para reducir el coste computacional manteniendo un rendimiento similar.
记录选择:用抽样技术挑出有代表性的记录子集,降低计算成本而性能基本不变。
Extracción de rasgos: Transforma los rasgos originales en un nuevo conjunto de menor dimensión mediante combinaciones o proyecciones. A diferencia de la selección, los nuevos rasgos no coinciden necesariamente con los originales.
特征提取:通过组合或投影把原特征变成一组维数更低的新特征。与「选择」不同,新特征不一定等于原特征。
| Técnica | Descripción(要点) | Ejemplo práctico |
|---|---|---|
| Selección de rasgos | 选原特征的子集,删无关 / 冗余,提升泛化、降复杂度 | 若「眼睛颜色」与糖尿病风险无统计关系,就删掉这一列 |
| Selección de registros | 用抽样选代表性子集,降计算成本、性能相近 | 100 万条销售记录里取 10 000 条有代表性的样本来训练原型 |
| Extracción de rasgos | 用组合 / 投影造出更低维的新特征,不必与原特征一致 | 由体重 + 身高造出 IMC;用 PCA 投影到「最大化解释方差」的正交成分上 |
4.1. Selección de rasgos · 小节分隔页(印刷页 79)
▸ 原页截图 p.76
4.1. Selección de rasgos
4.1 特征选择
4.1 Selección de rasgos · Filter / Wrapper / Embedded 三大流派(印刷页 80)
▸ 原页截图 p.77
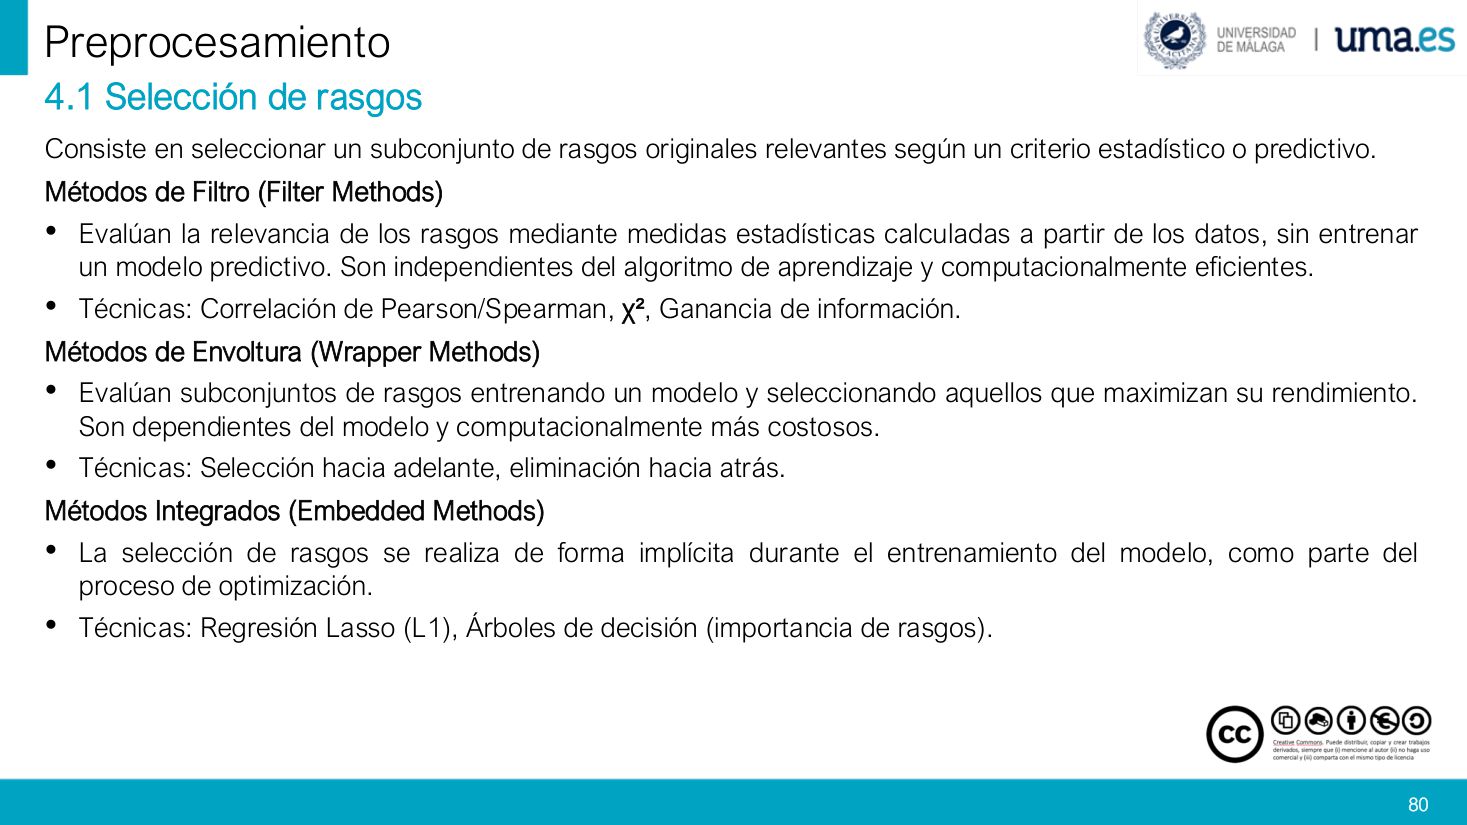
Consiste en seleccionar un subconjunto de rasgos originales relevantes según un
做法是依据某个
• Evalúan la relevancia de los rasgos mediante
• 用从数据算出的
• Técnicas: Correlación de Pearson/Spearman, χ²,
• 具体技术:Pearson / Spearman 相关系数、χ²、
• Evalúan subconjuntos de rasgos entrenando un modelo y seleccionando aquellos que maximizan su rendimiento. Son dependientes del modelo y computacionalmente más costosos.
• 通过真的训练模型来评估各个特征子集,挑出让性能最高的那一组。因此依赖模型、计算上更贵。
• Técnicas:
• 具体技术:
• La selección de rasgos se realiza de forma implícita durante el entrenamiento del modelo, como parte del proceso de optimización.
• 特征选择在模型训练过程中隐式完成,是优化过程的一部分(不单独另跑一轮筛选)。
• Técnicas:
• 具体技术:
4.1 Idea intuitiva con un ejemplo · 用「做菜」理解三种方法(印刷页 81)
▸ 原页截图 p.78
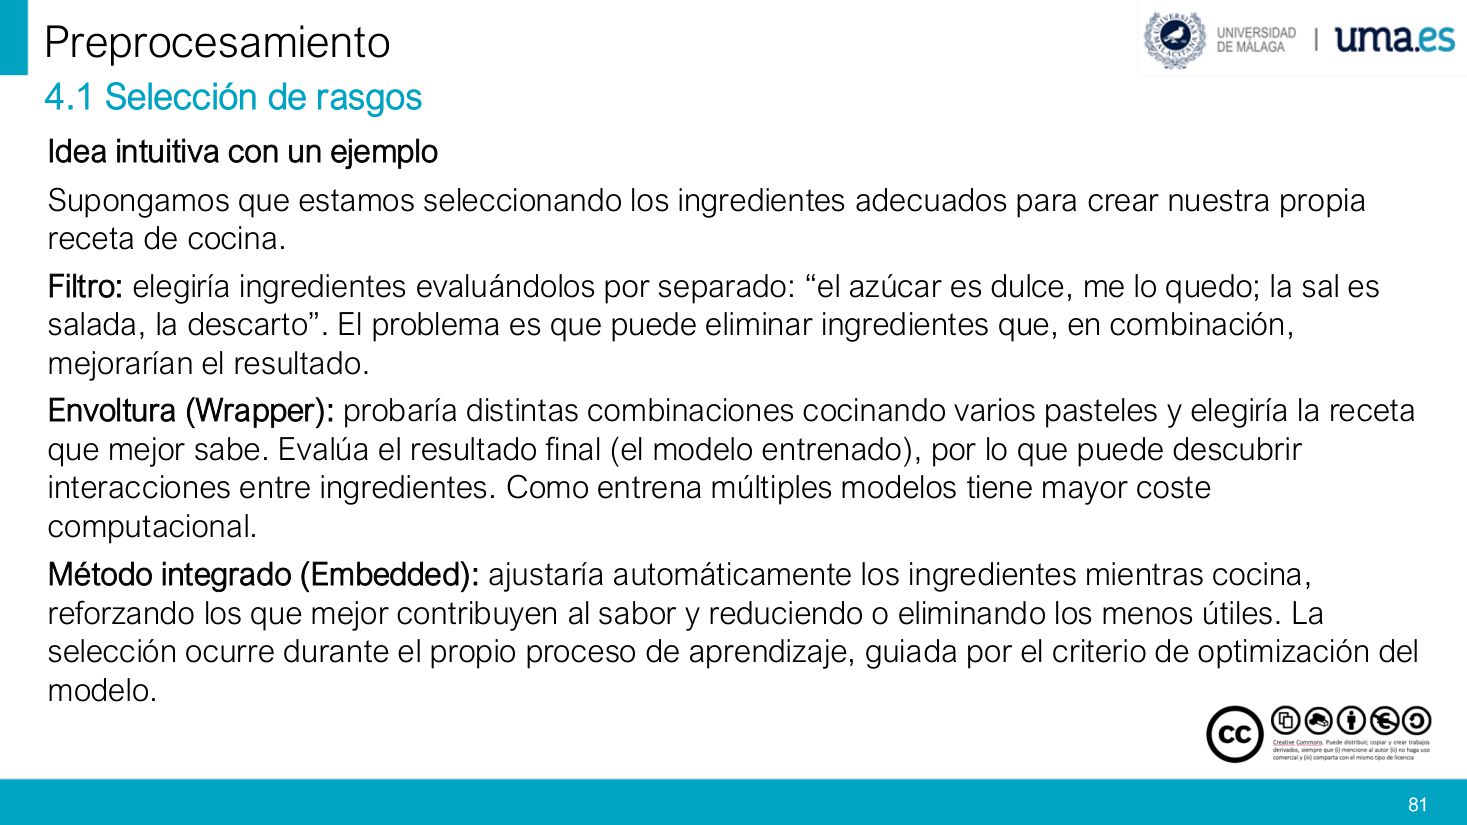
Idea intuitiva con un ejemplo
用一个例子建立直觉
Supongamos que estamos seleccionando los ingredientes adecuados para crear nuestra propia receta de cocina.
假设我们正在为自创的一道菜挑选合适的配料(配料 = 特征)。
Filtro: elegiría ingredientes evaluándolos por separado: “el azúcar es dulce, me lo quedo; la sal es salada, la descarto”. El problema es que puede eliminar ingredientes que, en combinación, mejorarían el resultado.
过滤式:把每种配料单独评估——「糖是甜的,留下;盐是咸的,扔掉」。问题在于:它可能删掉那些单独看一般、组合起来却出彩的配料(即看不到特征间的交互作用)。
Envoltura (Wrapper): probaría distintas combinaciones cocinando varios pasteles y elegiría la receta que mejor sabe. Evalúa el resultado final (el modelo entrenado), por lo que puede descubrir interacciones entre ingredientes. Como entrena múltiples modelos tiene mayor coste computacional.
包裹式(Wrapper):直接把各种搭配都做出来尝,选最好吃的那份配方。它评估的是最终成品(训练好的模型),所以能发现配料之间的交互作用;但因为要反复训练多个模型,计算成本更高。
Método integrado (Embedded): ajustaría automáticamente los ingredientes mientras cocina, reforzando los que mejor contribuyen al sabor y reduciendo o eliminando los menos útiles. La selección ocurre durante el propio proceso de aprendizaje, guiada por el criterio de optimización del modelo.
嵌入式(Embedded):边做边调——对贡献大的配料加量,对没用的减量或去掉。筛选发生在学习过程本身之中,由模型的优化准则来引导。
4.1 Métodos de Filtro · 通用流程三步(印刷页 82)
▸ 原页截图 p.79
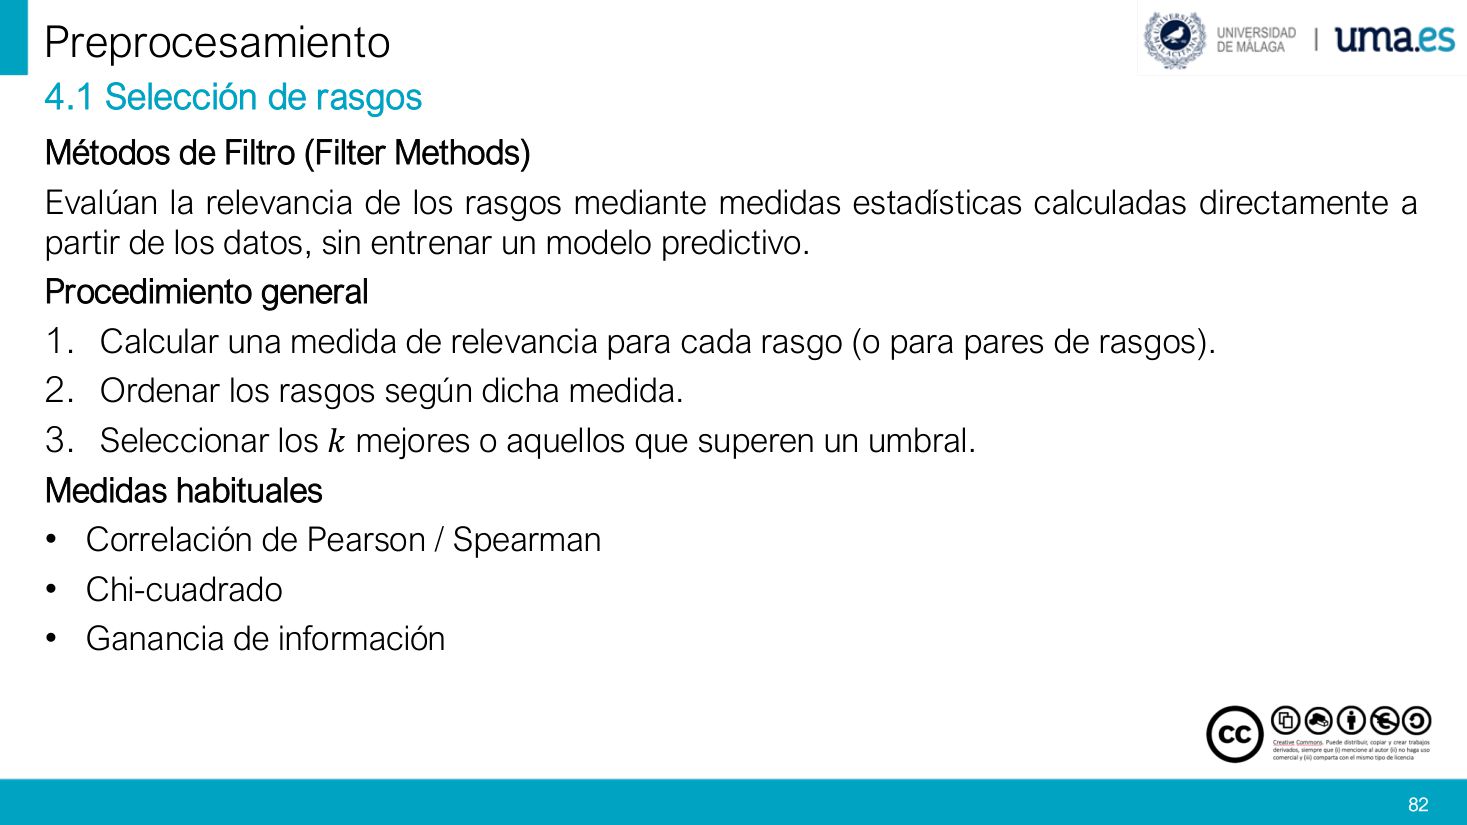
Métodos de Filtro (Filter Methods)
过滤式方法(Filter Methods)
Evalúan la relevancia de los rasgos mediante
用直接从数据算出的
Procedimiento general
通用流程
1. Calcular una medida de relevancia para cada rasgo (o para pares de rasgos).
1. 为每个特征(或每对特征)计算一个相关性度量值。
2. Ordenar los rasgos según dicha medida.
2. 按这个度量值给特征排序。
3. Seleccionar los k mejores o aquellos que superen un
3. 取排名前 k 个,或取超过
Medidas habituales: Correlación de Pearson / Spearman · Chi-cuadrado · Ganancia de información
常用度量:Pearson / Spearman 相关系数 · 卡方(χ²)· 信息增益
4.1 Métodos de Envoltura · 通用流程与两种策略(印刷页 83)
▸ 原页截图 p.80
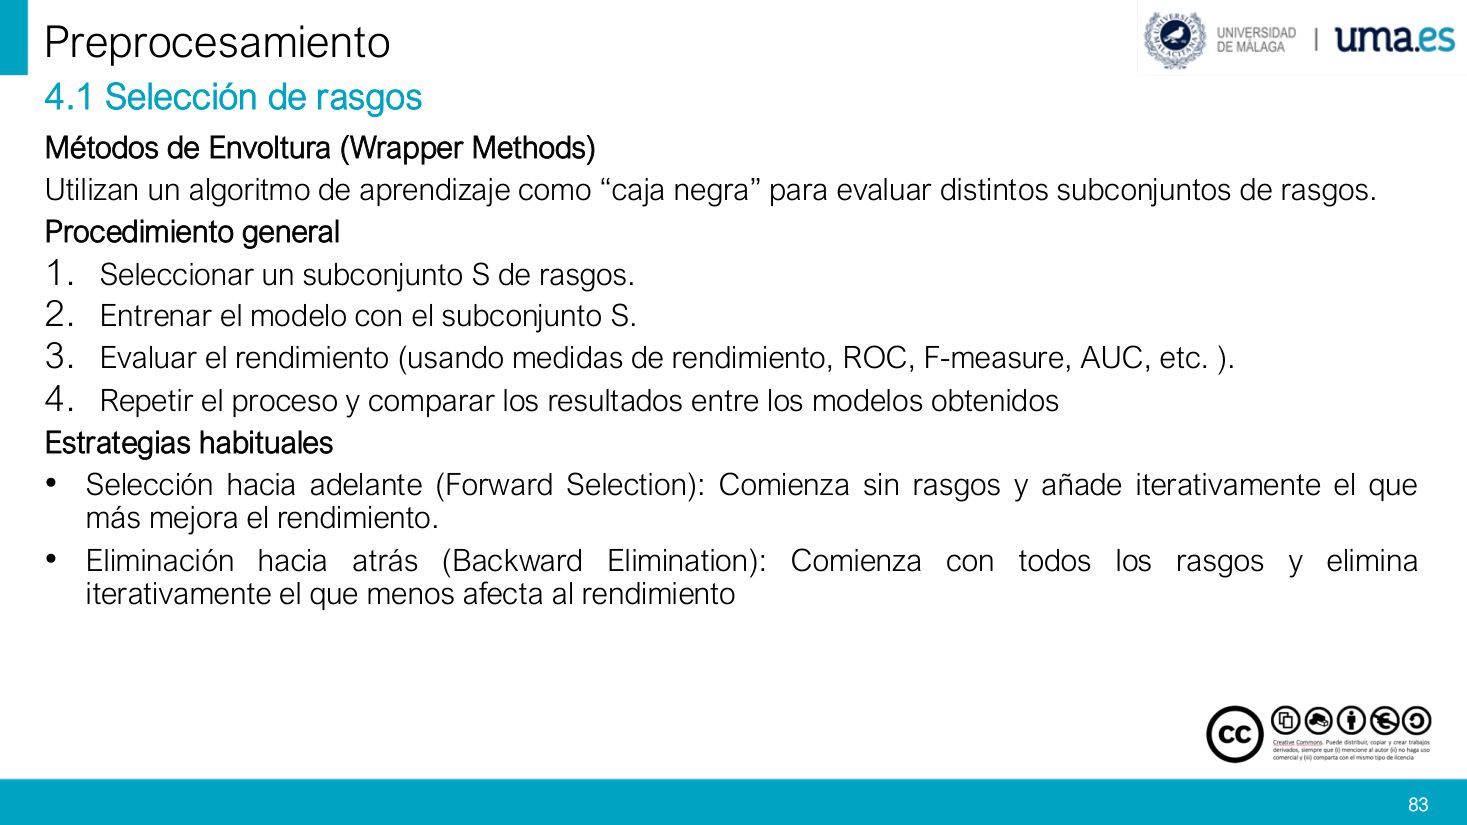
Métodos de Envoltura (Wrapper Methods)
包裹式方法(Wrapper Methods)
Utilizan un algoritmo de aprendizaje como
把某个学习算法当成
Procedimiento general
通用流程
1. Seleccionar un subconjunto S de rasgos.
1. 选定一个特征子集 S。
2. Entrenar el modelo con el subconjunto S.
2. 用子集 S 训练模型。
3. Evaluar el rendimiento (usando medidas de rendimiento, ROC, F-measure, AUC, etc.).
3. 评估性能(准确率等指标、ROC、F-measure、AUC 等)。
4. Repetir el proceso y comparar los resultados entre los modelos obtenidos
4. 重复上述过程,并在得到的各模型之间比较结果。
•
•
•
•
4.1 Métodos Integrados · Lasso(L1) 与决策树(印刷页 84)
▸ 原页截图 p.81
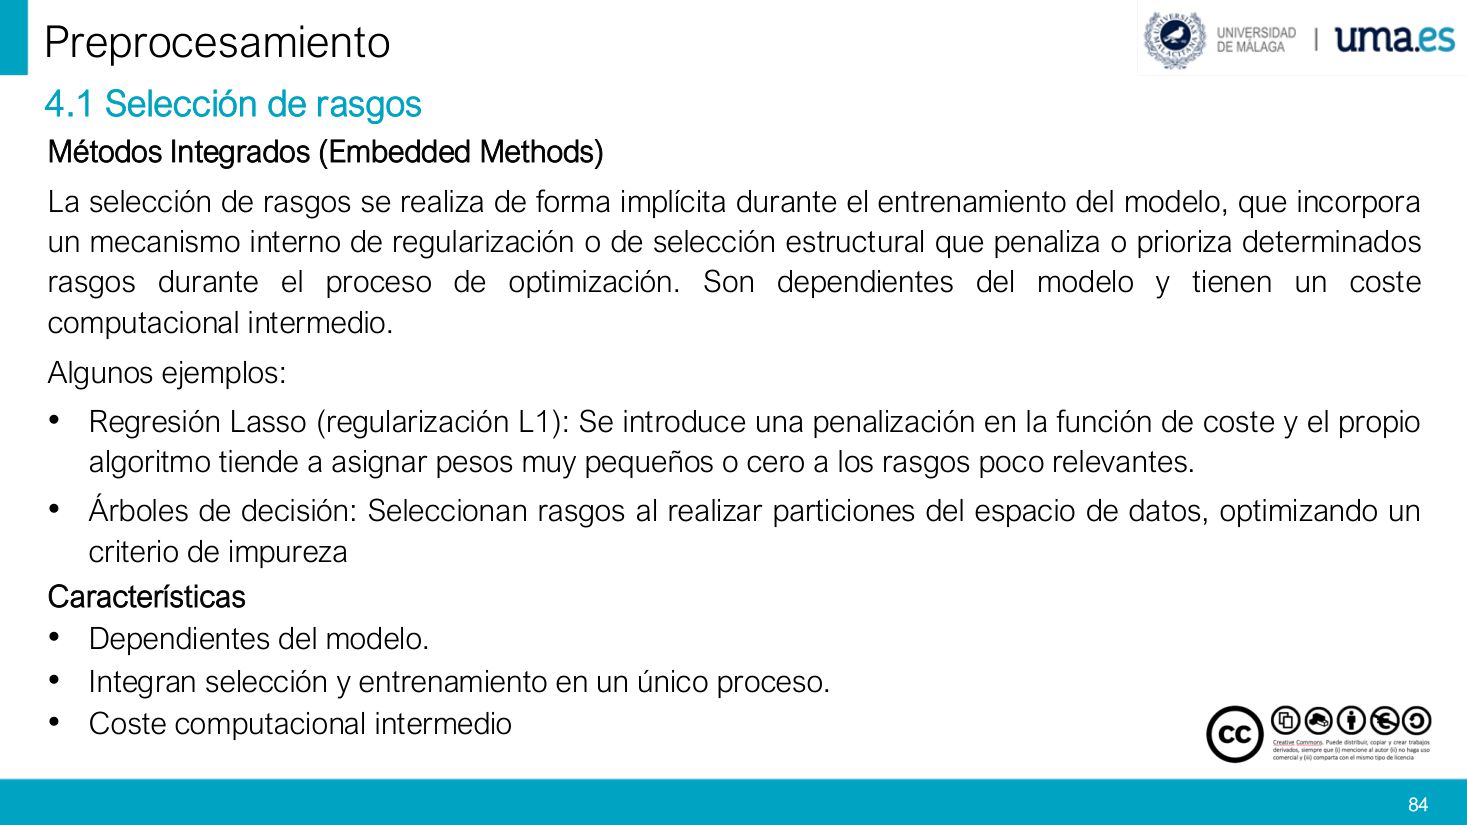
Métodos Integrados (Embedded Methods)
嵌入式方法(Embedded Methods)
La selección de rasgos se realiza de forma implícita durante el entrenamiento del modelo, que incorpora un mecanismo interno de
特征选择在模型训练中隐式完成:模型自带
Son dependientes del modelo y tienen un coste computacional
它们依赖具体模型,计算成本
•
•
•
•
Características: Dependientes del modelo · Integran selección y entrenamiento en un único proceso · Coste computacional intermedio
特点:依赖模型 · 把「选择」与「训练」合成一个过程 · 计算成本居中
4.1 三者对比表 · 何时用 Filter / 何时用 Wrapper(印刷页 85)
▸ 原页截图 p.82
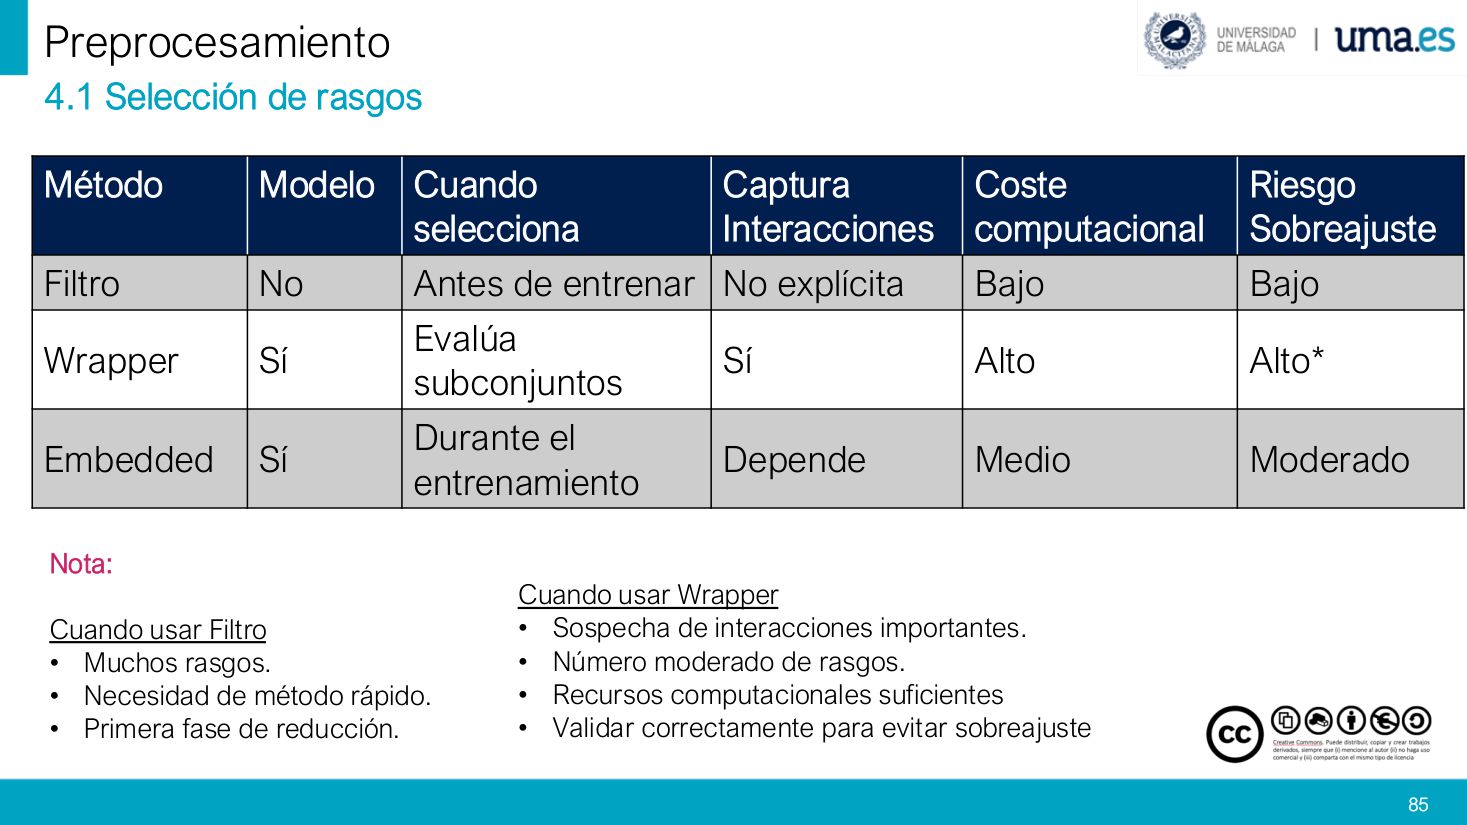
Método · Modelo · Cuándo selecciona · Captura interacciones · Coste computacional · Riesgo sobreajuste
方法 · 是否用模型 · 何时进行选择 · 能否捕捉交互 · 计算成本 · 过拟合风险(本页六列对比表)
Filtro — Modelo: No · Antes de entrenar · Interacciones: No explícita · Coste: Bajo · Riesgo: Bajo
过滤式——用模型:否 · 在训练前选 · 交互:不显式捕捉 · 成本:低 · 过拟合风险:低
Wrapper — Modelo: Sí · Evalúa subconjuntos · Interacciones: Sí · Coste: Alto · Riesgo: Alto*
包裹式——用模型:是 · 逐个评估子集 · 交互:能 · 成本:高 · 过拟合风险:高*(带星号,见下)
Embedded — Modelo: Sí · Durante el entrenamiento · Interacciones: Depende · Coste: Medio · Riesgo: Moderado
嵌入式——用模型:是 · 在训练过程中选 · 交互:视情况 · 成本:中 · 过拟合风险:中等
Nota: Cuando usar Filtro — Muchos rasgos · Necesidad de método rápido · Primera fase de reducción.
注:何时用 Filter——特征很多 · 需要快速方法 · 作为归约的第一阶段(先粗筛)。
Cuando usar Wrapper — Sospecha de
何时用 Wrapper——怀疑存在重要的
| Método | Modelo | Cuándo selecciona | Interacciones | Coste | Riesgo sobreajuste |
|---|---|---|---|---|---|
| Filtro | No | Antes de entrenar | No explícita | Bajo | Bajo |
| Wrapper | Sí | Evalúa subconjuntos | Sí | Alto | Alto* |
| Embedded | Sí | Durante el entrenamiento | Depende | Medio | Moderado |
4.2. Selección de ejemplos · 小节分隔页(印刷页 86)
▸ 原页截图 p.83
4.2. Selección de ejemplos
4.2 样本(记录)选择
4.2 Actividad · 从 20 条充电宝评论里怎么挑(印刷页 87)
▸ 原页截图 p.84
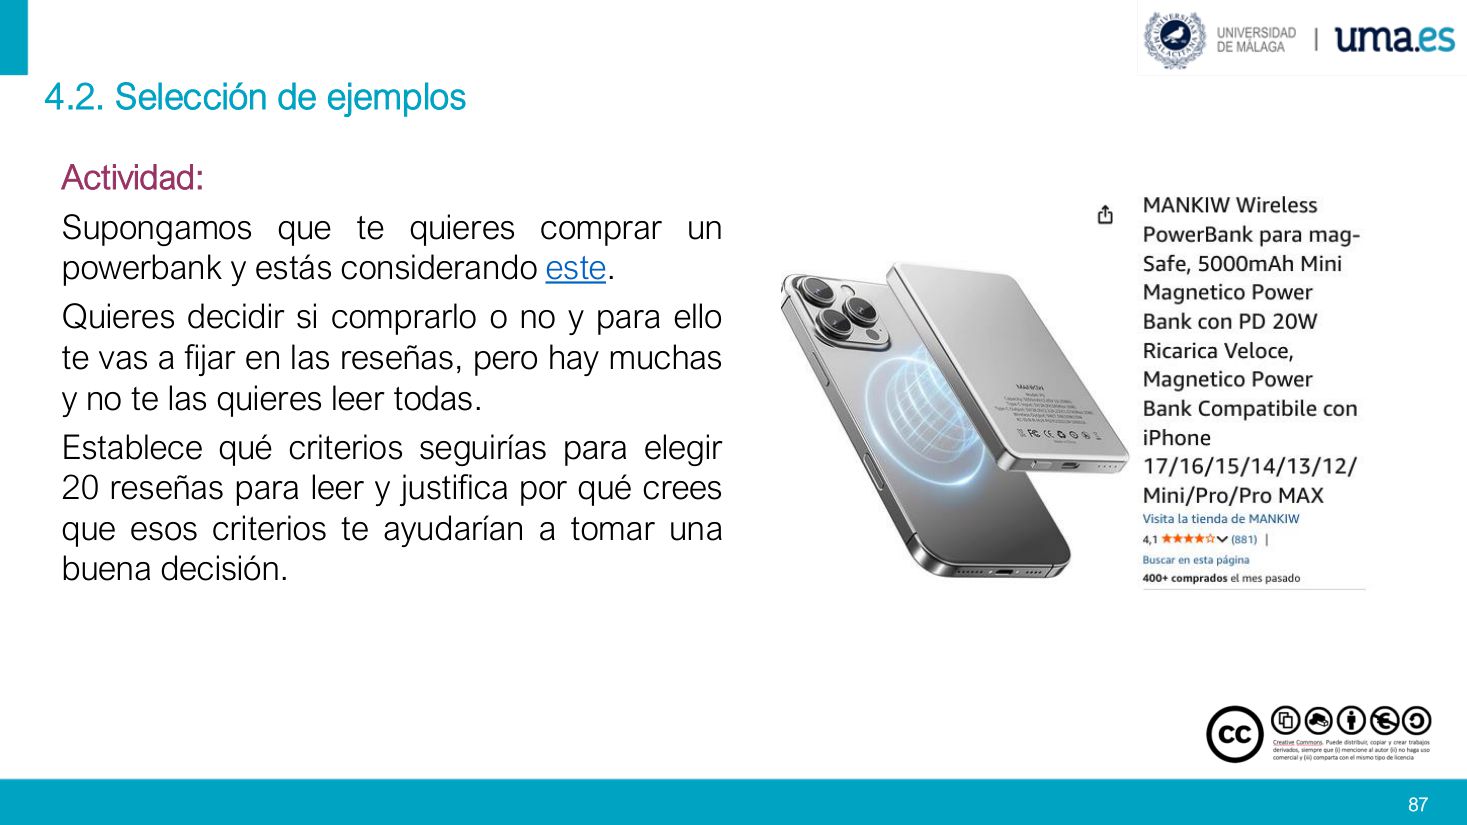
Actividad: Supongamos que te quieres comprar un powerbank y estás considerando este.
活动题:假设你想买一个充电宝(powerbank),正在考虑这一款。
Quieres decidir si comprarlo o no y para ello te vas a fijar en las
你要决定买还是不买,依据是
Establece qué criterios seguirías para elegir 20 reseñas para leer y justifica por qué crees que esos criterios te ayudarían a tomar una buena decisión.
请给出你挑选 20 条评论的标准,并说明为什么这些标准能帮你做出正确决定。
4.2 Selección de registros · D′ ⊂ D 与两条路线(印刷页 88)
▸ 原页截图 p.85
Sea D un dataset. La selección de registros construye un subconjunto D′ ⊂ D intentando preservar la información relevante para el aprendizaje.
设 D 为一个数据集。记录选择构造一个子集 D′ ⊂ D,力求保住对学习有用的信息。
Los enfoques principales son:
主要路线有两条:
•
•
•
•
• Cuando reducimos registros, no estamos simplificando la realidad de forma neutra. Estamos decidiendo qué aspecto de la realidad queremos preservar.
• 减记录时,我们并不是在中立地简化现实,而是在决定「要保留现实的哪一个侧面」——这个选择本身带有立场。
| 符号 | 西语读法 | 中文含义 |
|---|---|---|
| D | dataset original | 原始数据集(全部记录) |
| D′ | D prima | 归约后的子集(撇号读 «prima») |
| ⊂ | subconjunto de | 「是……的子集」,D′ 的元素全部来自 D |
| n′ | n prima | 保留的记录条数,必小于原 n |
4.2 Muestreo · 随机抽样 vs 分层抽样(印刷页 89)
▸ 原页截图 p.86
Sea D el dataset. El
设 D 为数据集。
• Cada registro se selecciona con
• 每条记录以
• Puede
• 可能让少数类
• Divide el conjunto en
• 先把数据切成若干
• Selecciona los registros para mantener la proporción original en cada grupo.
• 再在每层内抽样,使各组的比例与原数据保持一致。
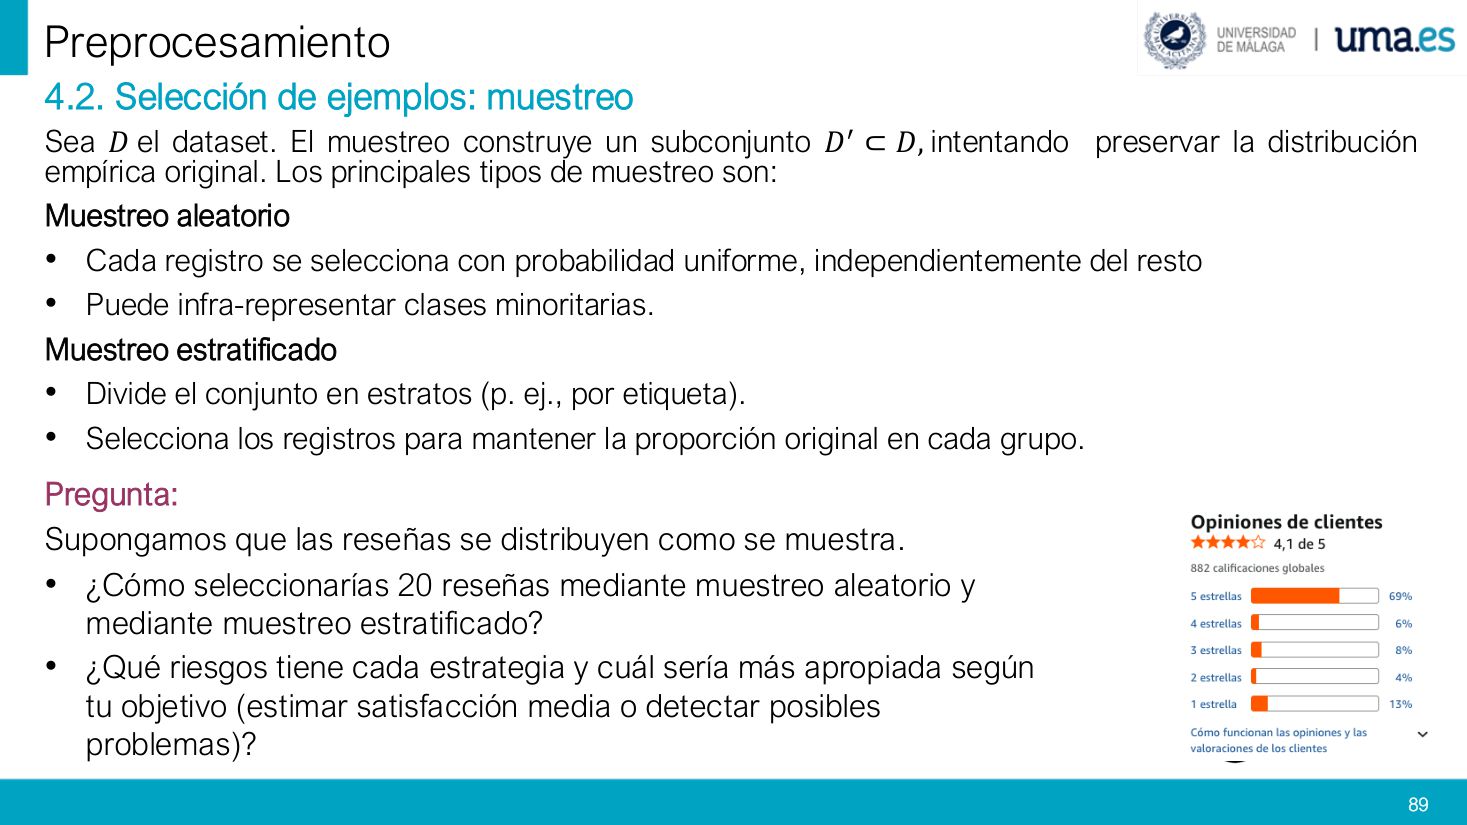
Pregunta: Supongamos que las reseñas se distribuyen como se muestra. ¿Cómo seleccionarías 20 reseñas mediante muestreo aleatorio y mediante muestreo estratificado? ¿Qué riesgos tiene cada estrategia y cuál sería más apropiada según tu objetivo (estimar satisfacción media o detectar posibles problemas)?
提问:假设评论的分布如页图所示。你会怎样用随机抽样、怎样用分层抽样各取 20 条?两种策略各有什么风险?按你的目标(估计平均满意度 还是 发现潜在问题),哪一种更合适?
4.2 Prototipos · 保边界,而不是保比例(印刷页 90)
▸ 原页截图 p.87
En lugar de mantener las proporciones del dataset, estos métodos buscan conservar los registros que influyen en la
这类方法不追求保住数据集的比例,而是保住那些会影响
Sea d(xi, xj) una
设 d(xi, xj) 为一个
La selección se basa en analizar la
选择依据是分析每条记录的
• Se conservan ejemplos representativos de su región.
• 保留能代表本区域的样本(密集区的「典型代表」)。
• Se eliminan ejemplos
• 删掉
• Se eliminan ejemplos
• 删掉与邻居不一致的样本(周围都是别的类别 → 疑似噪声)。
Pregunta: ¿Qué reseñas mirarías si quieres estar cerca de la frontera de decisión entre comprar y no comprar y por qué?
提问:如果你想贴近「买 / 不买」的决策边界,你会看哪些评论?为什么?
| 符号 | 西语读法 | 中文含义 |
|---|---|---|
| d(·,·) | distancia / métrica | 距离函数,衡量两条记录有多「像」 |
| xi, xj | equis sub i, equis sub j | 第 i 条与第 j 条记录的特征向量 |
| vecindad | vecindad local | 离该点最近的 k 个邻居构成的局部区域 |
| frontera | frontera de decisión | 类别交界处,模型最容易判错的地方 |
4.2 Prototipos · 去冗余与去噪声,以及执行代价(印刷页 91)
▸ 原页截图 p.88
Se utilizan
用基于
•
•
•
•
Reducimos la cantidad de datos y mejoramos su calidad (al quitar el “ruido”), haciendo que el algoritmo aprenda con datos más claros y definidos.
这样既减少了数据量,又提升了数据质量(去掉「噪声」),让算法在更清晰、更明确的数据上学习。
Sin embargo, hay que tener cuenta el coste de ejecutar el algoritmo de selección de prototipos.
但必须考虑运行原型选择算法本身的代价(省了训练时间,却要花时间先筛一遍)。
Pregunta: En el ejemplo del powerbank, ¿qué reseñas considerarías redundantes y cuáles considerarías ruido?
提问:在充电宝的例子中,哪些评论算冗余?哪些算噪声?
4.2 Prototipos · ENN(去噪)与 CNN(去冗余)(印刷页 92)
▸ 原页截图 p.89
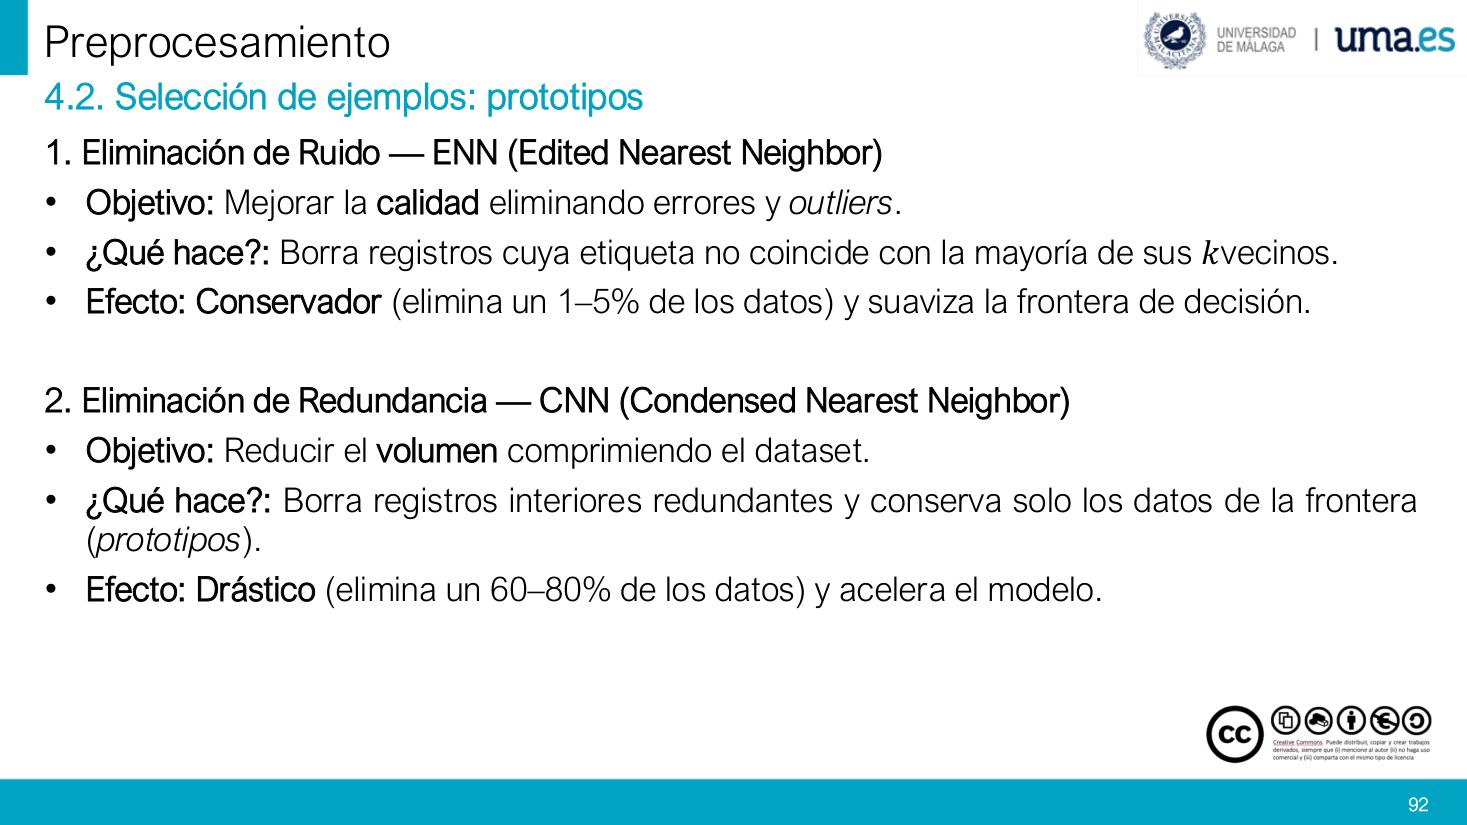
1. Eliminación de Ruido —
1. 去噪声 ——
• Objetivo: Mejorar la calidad eliminando errores y
• 目标:通过删掉错标样本与
• ¿Qué hace?: Borra registros cuya etiqueta no coincide con la mayoría de sus k vecinos.
• 做什么:删掉那些标签与它 k 个邻居的多数类别不一致的记录。
• Efecto: Conservador (elimina un 1–5 % de los datos) y
• 效果:保守(只删掉 1–5 % 的数据),并使决策边界
2. Eliminación de Redundancia —
2. 去冗余 ——
• Objetivo: Reducir el volumen comprimiendo el dataset.
• 目标:通过压缩数据集来减小体量。
• ¿Qué hace?: Borra registros interiores redundantes y conserva solo los datos de la frontera (prototipos).
• 做什么:删掉内部冗余记录,只保留边界上的数据(原型)。
• Efecto: Drástico (elimina un 60–80 % de los datos) y acelera el modelo.
• 效果:激进(删掉 60–80 % 的数据),并加快模型(因为 k-NN 要存全部样本,样本少了预测就快)。
| 算法 | 删什么 | 判据 | 删除比例 | 效果 |
|---|---|---|---|---|
| ENN | 噪声 / 错标 | 标签 ≠ 多数邻居的类别 | 1–5 % | 保守 · 边界平滑 · 提质 |
| CNN | 内部冗余 | 不在边界上(内部点) | 60–80 % | 激进 · 大幅压缩 · 提速 |
4.2 Prototipos · 三联图:62 → 60 → 14(印刷页 93)
▸ 原页截图 p.90
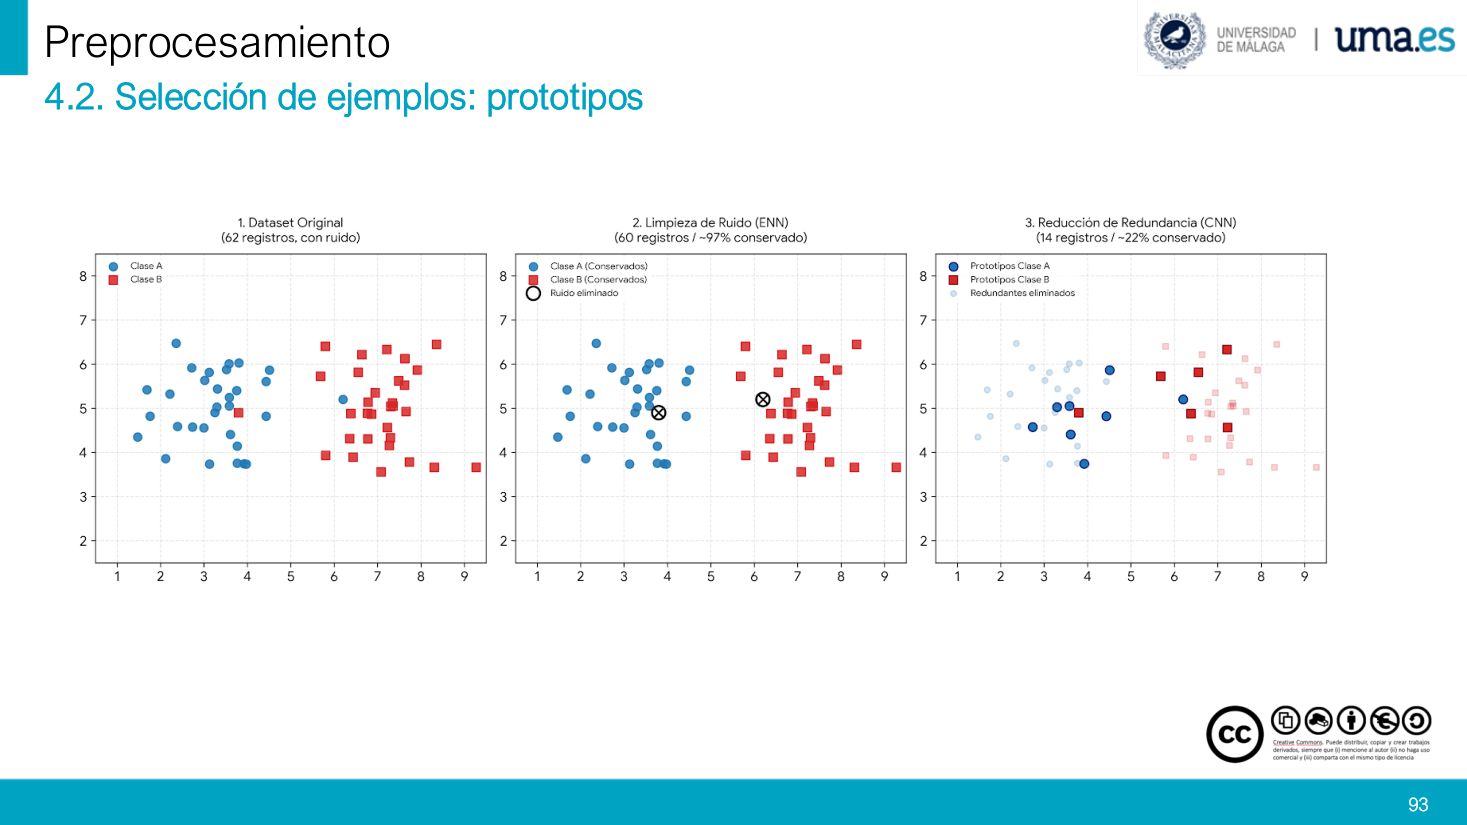
4.2. Selección de ejemplos: prototipos
4.2 样本选择:原型法(本页为同一数据的三张对比散点图)
1. Dataset Original (62 registros, con ruido)
1. 原始数据集(62 条记录,含噪声)
2. Limpieza de Ruido (ENN) (60 registros / ~97 % conservado)
2. 去噪声(ENN)(60 条记录 / 约保留 97 %)
3. Reducción de Redundancia (CNN) (14 registros / ~22 % conservado)
3. 去冗余(CNN)(14 条记录 / 约保留 22 %)
Leyenda: Clase A · Clase B · Ruido eliminado · Prototipos Clase A · Redundantes eliminados
图例:A 类(蓝)· B 类(红)· 被删的噪声(⊕)· A 类原型(深色实心)· 被删的冗余点(淡色)
| 阶段 | 记录数 | 相对原始 | 图上变化 |
|---|---|---|---|
| 1. 原始(含噪声) | 62 | 100 % | 两团点有重叠,中间混入异类点 |
| 2. ENN 去噪 | 60 | ≈ 97 % | 只删 2 个「孤立的异类点」(⊕) |
| 3. CNN 去冗余 | 14 | ≈ 22 % | 内部点全部淡出,只剩边界附近的点 |
4.2 汇总表 · 1000 笔交易、95 / 5 与 100 条(印刷页 94)
▸ 原页截图 p.91
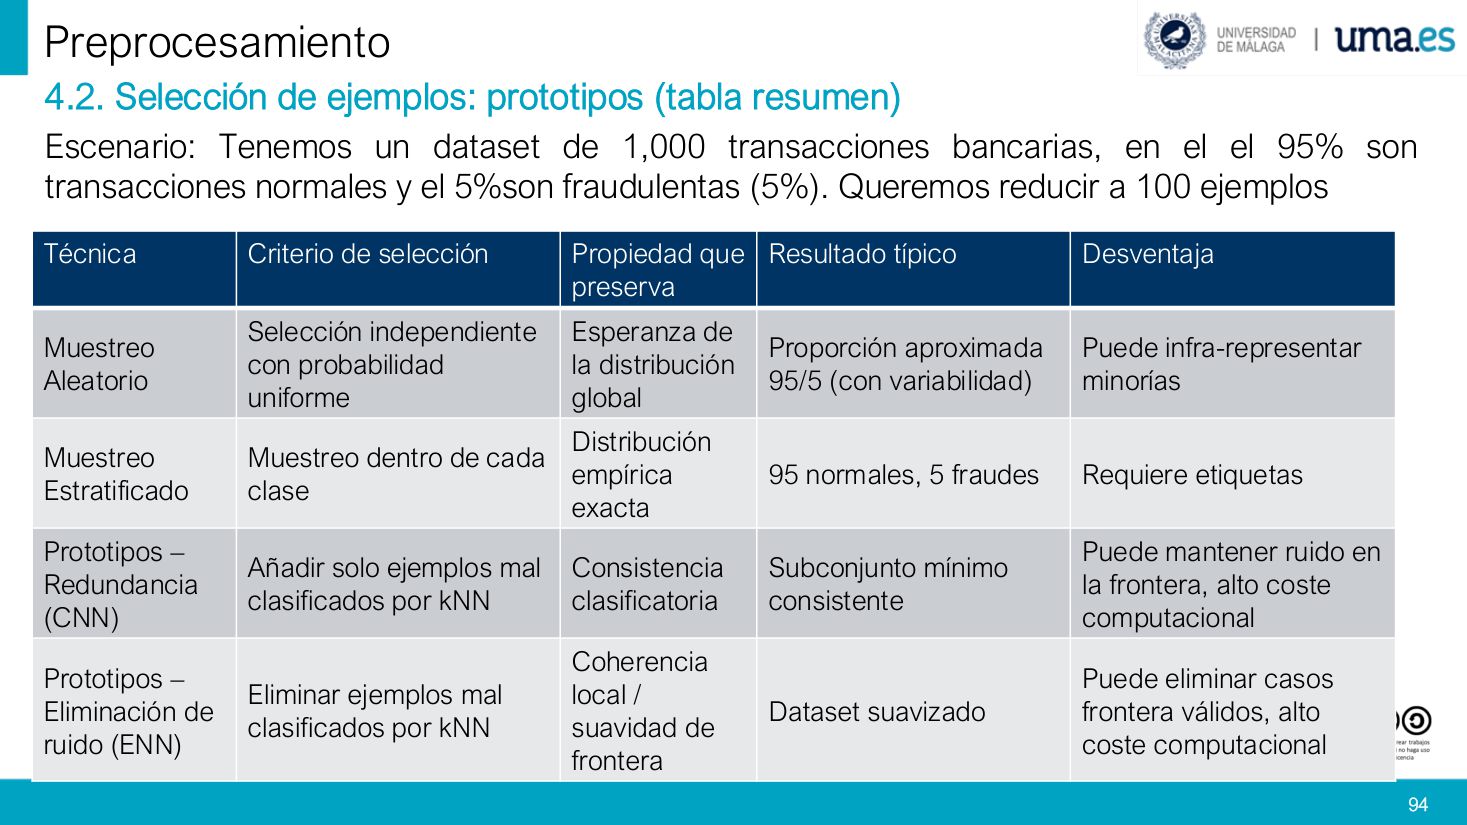
Escenario: Tenemos un dataset de 1.000 transacciones bancarias, en el 95 % son transacciones normales y el 5 % son fraudulentas. Queremos reducir a 100 ejemplos.
情境:有一个 1 000 笔银行交易的数据集,其中 95 % 是正常交易,5 % 是欺诈交易;我们要把它缩减到 100 条样本。
Muestreo Aleatorio — Selección independiente con probabilidad uniforme · Preserva: esperanza de la distribución global · Resultado típico: proporción aproximada 95/5 (con variabilidad) · Desventaja: puede infra-representar minorías
随机抽样——等概率独立抽取 · 保留:全局分布的期望 · 典型结果:比例约为 95 / 5(有波动)· 缺点:可能让少数类代表性不足
Muestreo Estratificado — Muestreo dentro de cada clase · Preserva: distribución empírica exacta · Resultado típico: 95 normales, 5 fraudes · Desventaja: requiere etiquetas
分层抽样——在每一类内部抽样 · 保留:精确的经验分布 · 典型结果:95 条正常 + 5 条欺诈 · 缺点:必须有标签才能分层
Prototipos – Redundancia (CNN) — Añadir solo ejemplos mal clasificados por kNN · Preserva: consistencia clasificatoria · Resultado típico: subconjunto mínimo consistente · Desventaja: puede mantener ruido en la frontera, alto coste computacional
原型 – 去冗余(CNN)——只保留被 kNN 误分类的样本(即边界点)· 保留:分类一致性 · 典型结果:最小一致子集 · 缺点:可能把边界上的噪声也留下来,计算成本高
Prototipos – Eliminación de ruido (ENN) — Eliminar ejemplos mal clasificados por kNN · Preserva: coherencia local / suavidad de frontera · Resultado típico: dataset suavizado · Desventaja: puede eliminar casos frontera válidos, alto coste computacional
原型 – 去噪声(ENN)——删掉被 kNN 误分类的样本 · 保留:局部一致性 / 边界平滑 · 典型结果:被平滑过的数据集 · 缺点:可能误删本来有效的边界样本,计算成本高
| Técnica | Criterio | Qué preserva | Resultado típico | Desventaja |
|---|---|---|---|---|
| Muestreo aleatorio | 等概率独立抽取 | 全局分布的期望 | ≈ 95 / 5(有波动) | 少数类可能不足 |
| Muestreo estratificado | 类内抽样 | 经验分布(精确) | 95 正常 + 5 欺诈 | 需要标签 |
| CNN | 保留 kNN 误分类者 | 分类一致性 | 最小一致子集 | 边界噪声留存;成本高 |
| ENN | 删除 kNN 误分类者 | 局部一致性 / 平滑 | 平滑后的数据集 | 可能误删有效边界样本;成本高 |
八、5. Discretización:把连续变量切成区间
p.92–p.955. Discretización · 章节分隔页(印刷页 95)
▸ 原页截图 p.92
5. Discretización
5. 离散化
5. Discretización · 定义、形式化划分、优缺点与年龄分箱(印刷页 96)
▸ 原页截图 p.93
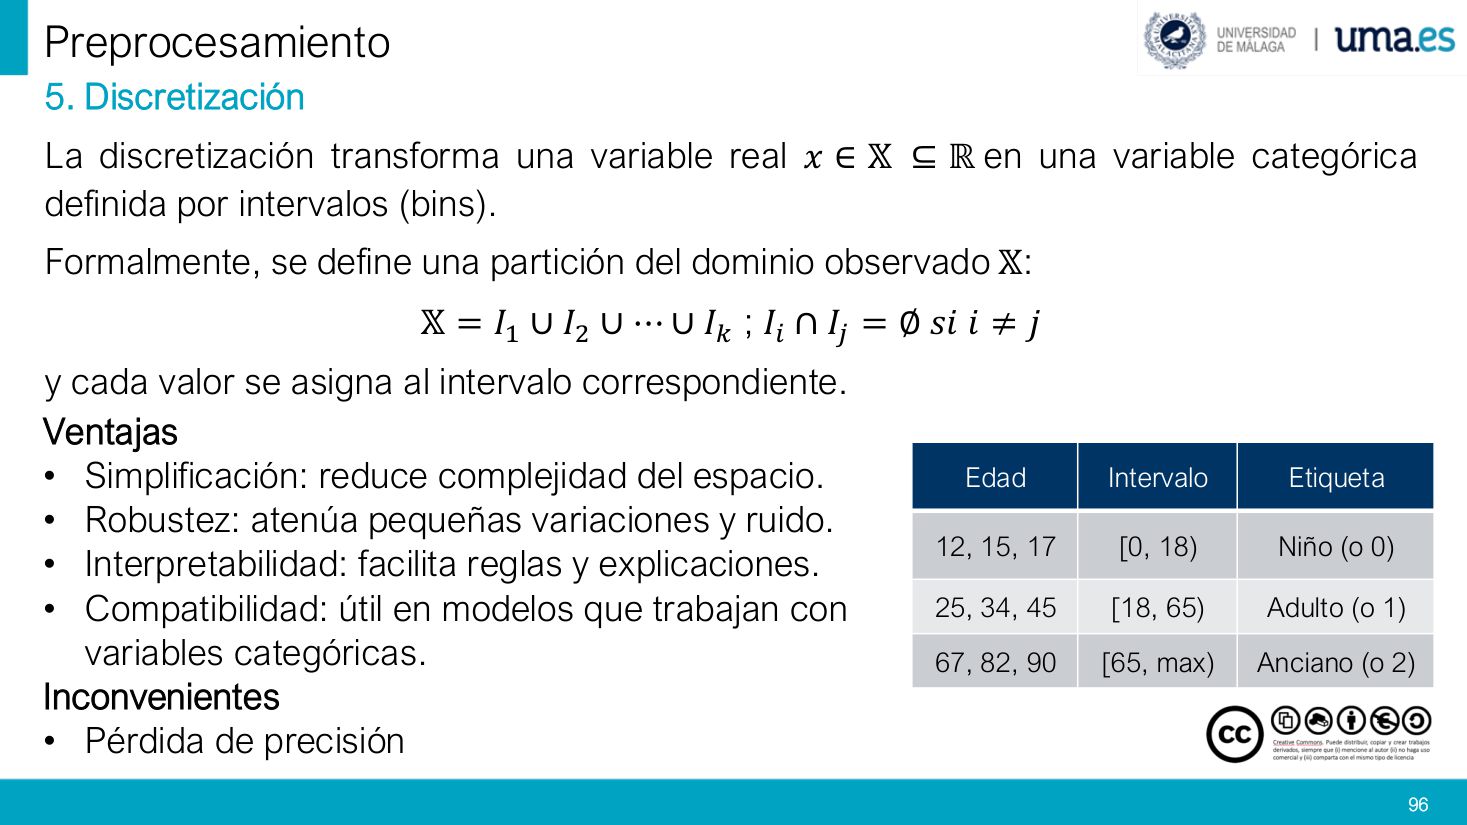
La
Formalmente, se define una
形式上,对观测到的定义域 𝕏 定义一个
y cada valor se asigna al intervalo correspondiente.
每个取值都被分配到它所属的那个区间。
Ventajas — Simplificación: reduce complejidad del espacio. Robustez: atenúa pequeñas variaciones y ruido. Interpretabilidad: facilita reglas y explicaciones. Compatibilidad: útil en modelos que trabajan con variables categóricas.
优点——简化:降低空间复杂度;鲁棒性:削弱微小波动与噪声的影响;可解释性:便于写成规则与解释;兼容性:适用于只能处理类别变量的模型。
Inconvenientes — Pérdida de precisión
缺点——精度损失(把 12 和 17 都叫「儿童」,细差别就没了)
| 符号 | 西语读法 | 中文含义 |
|---|---|---|
| x | variable real / continua | 待离散化的连续变量(如年龄) |
| 𝕏 | dominio observado | 观测到的取值范围(数据里出现过的值) |
| Ii | intervalo i-ésimo / bin | 第 i 个区间(分箱),共 k 个 |
| ∪ | unión | 并集:所有区间拼起来正好盖住 𝕏 |
| ∩ = ∅ | intersección vacía | 交集为空:区间互不重叠,每个值只落一处 |
| k | número de bins | 区间个数,由人选(如 3 箱) |
| Edad | Intervalo | Etiqueta |
|---|---|---|
| 12, 15, 17 | [0, 18) | Niño (o 0) |
| 25, 34, 45 | [18, 65) | Adulto (o 1) |
| 67, 82, 90 | [65, max) | Anciano (o 2) |
[0, 18) 与 [18, 65) 是「左闭右开」,而 [65, max) 同样是左闭右开——但标签里 90 岁落在 [65, max) 内,max 必须理解为 ≥ 90。另外区间用的分隔符是逗号,而 p.95 同一概念改用分号([12; 36,3)),因为那里小数点是逗号,属排版惯例差异,含义相同。5. Discretización · 等宽 / 等频 / 专家知识三法(印刷页 97)
▸ 原页截图 p.94
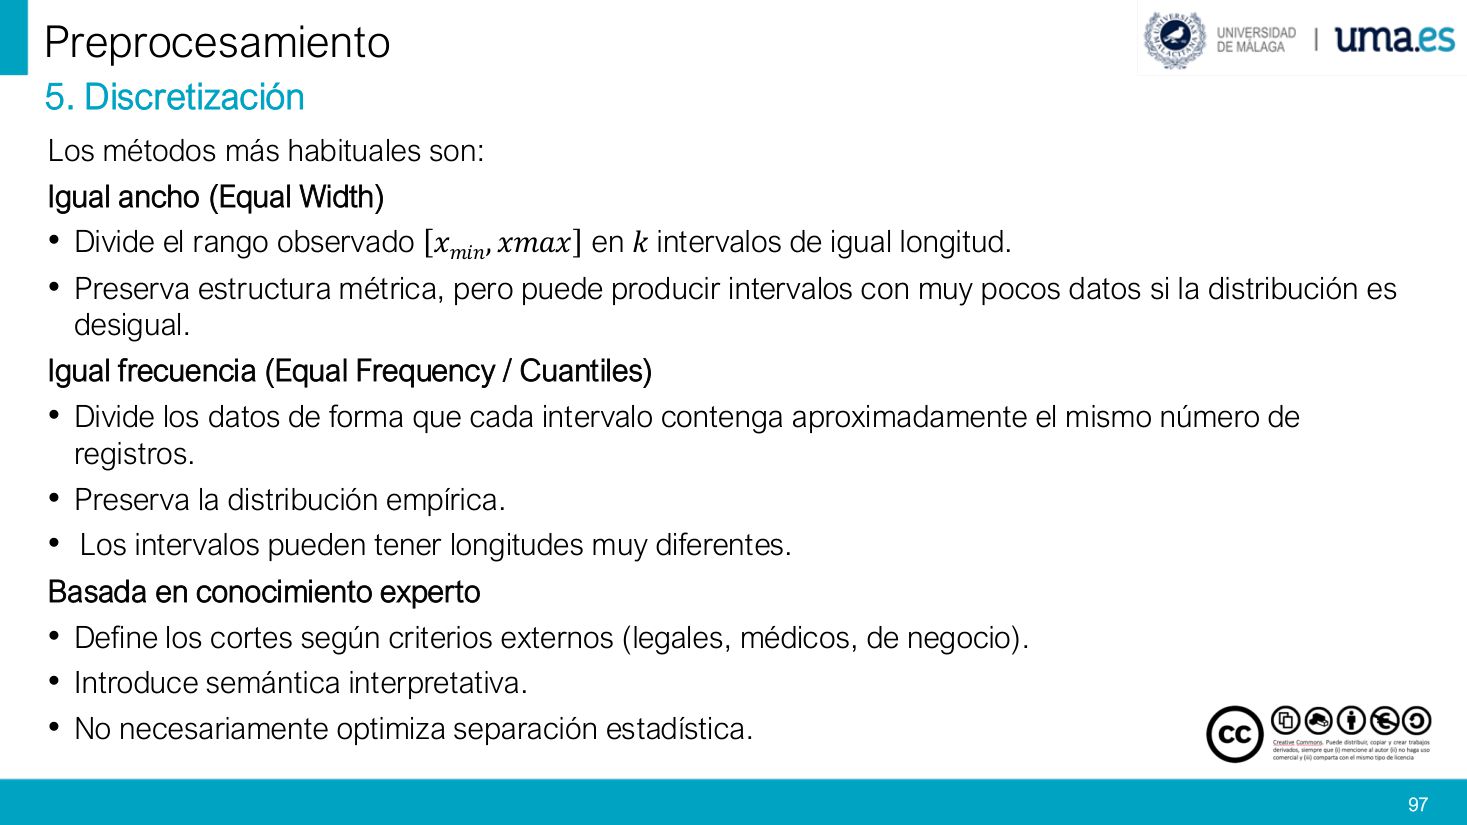
Los métodos más habituales son:
最常用的方法有三种:
• Divide el rango observado xmin, xmax en k intervalos de igual longitud.
• 把观测到的范围 xmin, xmax 切成 k 个长度相等的区间。
• Preserva
• 保住了
• Divide los datos de forma que cada intervalo contenga aproximadamente el mismo número de registros.
• 切分时让每个区间包含大致相同条数的记录(按数量分,不按长度分)。
• Preserva la
• 保住了
• Define los
• 按外部准则(法律、医学、业务)来定
• Introduce
• 带来了
| 方法 | 怎么切 | 保住什么 | 典型风险 |
|---|---|---|---|
| 等宽 | [xmin, xmax] 等分成 k 份 | 取值间距(度量结构) | 分布偏斜 → 空箱 / 挤爆箱 |
| 等频 | 按分位数切,每箱≈n/k 条 | 经验分布(样本量均衡) | 箱宽差异极大,边界随数据漂移 |
| 专家 | 按领域阈值切(18、65…) | 可解释性与业务语义 | 统计上未必分得开 |
5. Discretización 例 · 12 个年龄走完三种方法(印刷页 98)
▸ 原页截图 p.95
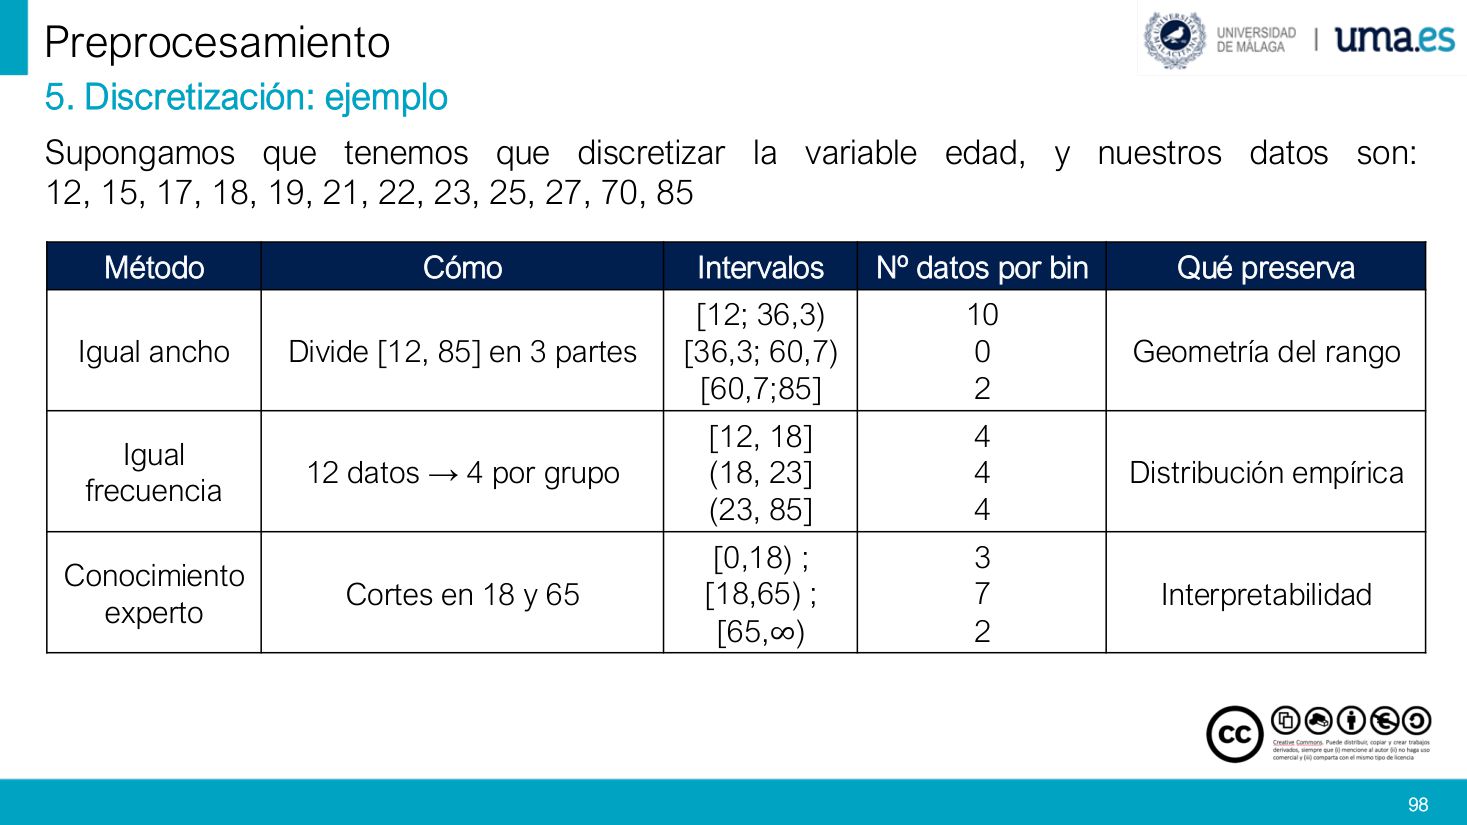
Supongamos que tenemos que discretizar la variable edad, y nuestros datos son: 12, 15, 17, 18, 19, 21, 22, 23, 25, 27, 70, 85
假设要离散化年龄变量,数据为:12, 15, 17, 18, 19, 21, 22, 23, 25, 27, 70, 85(共 12 个值,最小 12、最大 85)。
Igual ancho — Divide [12, 85] en 3 partes → [12; 36,3) · [36,3; 60,7) · [60,7; 85] → Nº datos por bin: 10 · 0 · 2 → Qué preserva: geometría del rango
等宽——把 [12, 85] 三等分 → [12; 36,3) · [36,3; 60,7) · [60,7; 85] → 每箱条数:10 · 0 · 2 → 保留:范围的几何结构(间距相等)
Igual frecuencia — 12 datos → 4 por grupo → [12, 18] · (18, 23] · (23, 85] → 4 · 4 · 4 → Qué preserva: distribución empírica
等频——12 个数据 → 每组 4 个 → [12, 18] · (18, 23] · (23, 85] → 4 · 4 · 4 → 保留:经验分布(每箱人数相同)
Conocimiento experto — Cortes en 18 y 65 → [0,18) ; [18,65) ; [65,∞) → 3 · 7 · 2 → Qué preserva: interpretabilidad
专家知识——切点定在 18 与 65 → [0,18) ; [18,65) ; [65,∞) → 3 · 7 · 2 → 保留:可解释性(未成年 / 成年 / 老年)
| Método | Cómo | Intervalos | Nº datos | Qué preserva |
|---|---|---|---|---|
| Igual ancho | [12, 85] 三等分 | [12; 36,3) / [36,3; 60,7) / [60,7; 85] | 10 / 0 / 2 | Geometría del rango |
| Igual frecuencia | 12 条 → 每组 4 条 | [12, 18] / (18, 23] / (23, 85] | 4 / 4 / 4 | Distribución empírica |
| Conocimiento experto | 切在 18 与 65 | [0,18) ; [18,65) ; [65,∞) | 3 / 7 / 2 | Interpretabilidad |
A–Z 术语速记表
共 97 条,覆盖全 95 页的高频术语。第三列点页码直接跳回原页;最后一列只写「一句话 + 最容易被扣分的点」,考前扫这一列就够。正文里带浅蓝底的西语词、带虚下划线的中文词,鼠标停上去都会显示对侧语言。
| 西语术语 | 中文 | 页码 | 一句话记住 · 易错点 |
|---|---|---|---|
| A | |||
| Alta dimensionalidad | 高维(特征远多于样本) | p.73 | d ≫ n 时先减列:选择或提取特征,否则必过拟合。 |
| Árboles de decisión | 决策树 | p.81 | 每次分裂挑「不纯度下降最多」的特征=Embedded 式选择。 |
| Aprendizaje automático | 机器学习 | p.22 | 插补也能用它:拿其他列当输入,预测缺的那一列。 |
| Asimetría positiva | 正偏(长尾在右) | p.60 | 右偏 → 用 log 变换压长尾,不要直接标准化了事。 |
| B | |||
| Basada en conocimiento experto | 基于专家知识(分箱) | p.94 | 按 18 / 65 这类领域阈值切;可解释,但不保证统计最优。 |
| C | |||
| caja negra | 黑箱 | p.80 | Wrapper 只调用模型、不看内部;此处是中性说法。 |
| capacidad de generalización | 泛化能力 | p.73 | 特征过多 → 过拟合 → 泛化掉;降维就是为了救它。 |
| características | 特征(=列) | p.2 | 与 rasgos / atributos 同义,西语三个词换着用。 |
| Chi-cuadrado (χ²) | 卡方检验 | p.49 | 两个类别变量的独立性检验;p ≤ α 才说明有关联。 |
| CNN (Condensed Nearest Neighbor) | 压缩最近邻 | p.89 | 只留边界原型,可删 60–80%;不是卷积神经网络! |
| codificación | 编码 | p.65 | 类别 → 数字;方向与「离散化」正好相反。 |
| consistencia | 一致性 | p.15 | 同一含义在不同列 / 不同表里写法要统一。 |
| coste computacional | 计算成本 | p.73 | Filter 低 < Embedded 中 < Wrapper 高。 |
| cortes | 切点 | p.94 | 专家分箱的切点是人定的,不是算法算出来的。 |
| criterio de impureza | 不纯度准则 | p.81 | 基尼 / 熵;分裂后不纯度降得最多的特征胜出。 |
| D | |||
| discretización | 离散化 | p.93 | 连续 → 区间类别;主动损失精度。 |
| distribución empírica | 经验分布 | p.86 | 等频分箱、分层抽样都保它;随机抽样只保「期望」。 |
| Duplicados | 重复记录 | p.15 | 整行重复先删;别把它当成「样本很多」。 |
| E | |||
| Eliminación de redundancia | 去冗余 | p.88 | 删「与邻居同类、又位于内部」的点;CNN 属此类。 |
| Eliminación de ruido | 去噪声 | p.88 | 删「标签与邻居不一致」的点;ENN 属此类。 |
| Eliminación hacia atrás | 后向消除 | p.80 | 从全集起步,每轮删「影响最小」的那一个。 |
| ENN (Edited Nearest Neighbor) | 编辑最近邻 | p.89 | 只删 1–5%,保守、平滑边界。 |
| estandarización | 标准化(Z-score) | p.57 | (x − μ) / σ;不受量纲影响,但假设分布近似正态。 |
| estratos | 层 | p.86 | 分层抽样里的子群;按各层占比分配名额。 |
| estructura métrica | 度量结构(取值间距) | p.94 | 等宽保住「间距相等」,不等于保住原值。 |
| F | |||
| Feature Extraction | 特征提取 | p.74 | 造新特征(PCA、IMC),列变少但每列是组合。 |
| frontera de decisión | 决策边界 | p.87 | 原型选择要保住的就是这条边界。 |
| función de coste | 代价函数 | p.81 | Lasso 就是在它上面加 L1 惩罚项。 |
| G | |||
| Ganancia de información | 信息增益 | p.77 | Filter 常用指标:分裂前后熵减少多少。 |
| Gran volumen de datos | 数据量庞大 | p.73 | n 太大 → 减行(抽样 / 原型),别硬算全量。 |
| H | |||
| heterogeneidad metodológica | 方法异质性 | p.51 | 不同来源的口径 / 单位不同,集成前必须先统一。 |
| I | |||
| Igual ancho | 等宽分箱 | p.94 | 极差 ÷ k;分布偏斜就会出空箱。 |
| Igual frecuencia | 等频分箱 | p.94 | 每箱≈n/k 条;保经验分布,但箱宽可能差很多。 |
| IMC | 体质指数 | p.10 | peso / altura²;人工构造特征的教科书例子。 |
| imputación | 插补 | p.21 | 用统计量或模型把空格填上,而不是删行。 |
| infra-representar | 代表性不足 | p.86 | 随机抽样可能抽不到少数类 → 用分层解决。 |
| instancias duplicadas | 重复实例 | p.48 | 集成时先查重,否则同一条记录被算两次。 |
| interacciones | 交互作用 | p.82 | 两个特征合起来才有用;Filter 单看一个发现不了。 |
| intervalos | 区间 | p.93 | 离散化的产物,必须「不重不漏」。 |
| irrelevantes | 无关特征 | p.73 | 与标签无关;留着只增加噪声与成本。 |
| K | |||
| k-NN (k vecinos más cercanos) | k 近邻 | p.25 | 插补与原型选择都用它;先标准化再算距离。 |
| L | |||
| Label Encoding | 标签编码 | p.65 | 一列整数 0…k−1;会造出假顺序,一般只用于 y。 |
| limpieza de datos | 数据清洗 | p.15 | 五阶段第一步:缺失、异常、重复、不一致。 |
| Localización de atributos redundantes | 冗余属性定位 | p.49 | 用相关 / χ² 找「信息重叠」的列,再决定删哪列。 |
| M | |||
| media | 均值 | p.21 | 均值插补最省事,但会被离群点拉跑 → 改用中位数。 |
| medida de dependencia | 依赖度量 | p.49 | 衡量两列关联强度的统称(r、ρ、χ²)。 |
| medidas estadísticas | 统计指标 | p.79 | Filter 全靠它打分,不训练模型。 |
| Métodos de Envoltura | 包裹式方法 | p.77 | 用模型表现当评分;最准也最贵,能看交互。 |
| Métodos de Filtro | 过滤式方法 | p.77 | 先打分再挑,不碰模型;最快但看不见交互。 |
| Métodos Integrados | 嵌入式方法 | p.77 | 选择发生在训练内部;Lasso、决策树。 |
| métrica | 度量(距离) | p.87 | 原型 / 邻域都靠它定义「近」。 |
| Muestreo aleatorio | 随机抽样 | p.86 | 等概率抽;只保「期望」分布,少数类可能丢。 |
| Muestreo estadístico | 统计抽样 | p.85 | 目标:小样本仍能代表总体分布。 |
| Muestreo estratificado | 分层抽样 | p.86 | 类内按比例抽,分布精确;需要标签。 |
| muestreo | 抽样 | p.86 | 减行第一路线;与「原型」并列为两大策略。 |
| N | |||
| Normalización (Min-Max) | 归一化 | p.56 | 压到 [a, b](常 [0, 1]);对离群点非常敏感。 |
| O | |||
| One-Hot Encoding | 独热编码 | p.65 | 1 列拆 k 列 0/1;名义变量首选,不造假顺序。 |
| Ordinal Encoding | 序数编码 | p.65 | 按真实等级给整数;顺序必须真的存在。 |
| orden natural | 天然顺序 | p.68 | 有序变量才有;没有就别用序数编码。 |
| outliers | 离群点 | p.36 | 数值远离主体;先判断是错误还是真实极端值。 |
| P | |||
| partición | 划分 | p.93 | 离散化=把 𝕏 划成若干互不重叠的区间。 |
| PCA | 主成分分析 | p.75 | 特征提取代表:把 d 列压成少数几列线性组合。 |
| penalización | 惩罚项 | p.81 | L1 惩罚让无关特征的系数被压到 0。 |
| poder estadístico | 统计功效 | p.19 | 样本越少越弱;删行之前先算这笔账。 |
| preprocesamiento | 预处理 | p.1 | 建模之前的一切准备;本课五阶段的总称。 |
| probabilidad uniforme | 均匀概率 | p.86 | 随机抽样里每条样本的入选概率相同。 |
| R | |||
| rasgos | 特征(列) | p.73 | 与 características / atributos 同义。 |
| redundantes | 冗余的 | p.73 | 与别的列信息重叠;两列留一列就够。 |
| reducción de datos | 数据归约 | p.74 | 体积变小、信息不丢;减列或减行。 |
| reescalado | 重缩放 | p.56 | 只改范围不改形状;Min-Max 属此类。 |
| Regresión Lasso | Lasso 回归 | p.81 | L1 正则 → 稀疏解 → 自动选特征。 |
| registros | 记录(行) | p.73 | 与 ejemplos / instancias 同义。 |
| regularización | 正则化 | p.81 | 在代价函数里加约束,防止过拟合。 |
| relaciones artificiales | 人为(虚构)的关系 | p.65 | 编码最怕造出数据里不存在的顺序。 |
| representativo | 有代表性的 | p.74 | 减行后的子集要能代表原分布。 |
| reseñas | 评论 | p.84 | 本章减行练习的数据:20 条酒店评论。 |
| ruido | 噪声 | p.20 | 随机错误值;与「异常值」不同,噪声通常无信息。 |
| S | |||
| scatterplots | 散点图 | p.51 | 看两列关系的第一步;相关 ≠ 因果。 |
| selección estructural | 结构选择 | p.81 | 模型自带的结构性筛选(如树的分裂)。 |
| Selección de rasgos | 特征选择 | p.74 | 从原列里挑子集,不造新列。 |
| Selección de registros | 记录选择 | p.74 | 从原行里挑子集,列不变。 |
| Selección geométrica | 几何选择(原型) | p.85 | 按邻域 / 边界挑代表性样本,不按比例。 |
| Selección hacia adelante | 前向选择 | p.80 | 从空集起步,每轮加「最好」的那一个。 |
| semántica interpretativa | 可解释语义 | p.94 | 专家分箱换来「18 岁=成年」这种业务含义。 |
| sesgo de selección | 选择偏差 | p.19 | 删掉的是特定群体 → 模型系统性偏向。 |
| sesgados | 有偏的 | p.15 | 数据整体偏向某群体,不是个别错值。 |
| subconjunto | 子集 | p.74 | 选择的结果:D′ ⊂ D。 |
| superfluos | 多余的 | p.2 | 与任务无关的属性;集成 / 选择时要清掉。 |
| T | |||
| transformación de datos | 数据变换 | p.53 | 五阶段第三步:缩放、函数变换、编码。 |
| U | |||
| umbral | 阈值 | p.79 | Filter 收尾两种方式之一:过线才留。 |
| V | |||
| valores anómalos | 异常值 | p.15 | 与噪声、离群点的区分见下方易混卡。 |
| valores faltantes | 缺失值 | p.6 | 空格;三条出路:删、简单插补、模型插补。 |
| valores perdidos | 缺失值(同义) | p.17 | faltantes / perdidos 两个西语词都指空值。 |
| variables categóricas | 类别变量 | p.65 | 名义 / 有序;编码前先判断有没有顺序。 |
| variables continuas | 连续变量 | p.7 | 可无限细分;要离散化才能当类别用。 |
| variables nominales | 名义变量 | p.65 | 无顺序(颜色、城市)→ 只能 One-Hot。 |
| vecindad local | 局部邻域 | p.87 | k 个最近邻围出的区域;ENN / CNN 的判据都基于它。 |
阈值与流程速记卡
这一章的数字几乎全是「经验规则」,但它们照样是送分点:删多少、相关多强算冗余、删几成样本、几个箱子。背下这张表,判断与简答都能秒答。
| 编号 | 阈值 / 数字 | 出处 | 含义与用法 |
|---|---|---|---|
| 1 | 5 % | p.19 | 删行的经验上限;超过就别硬删,改插补。是「regla orientativa」,不是硬标准。 |
| 2 | |r| > 0.8 | p.50 | Pearson 强线性相关 → 可能冗余,两列留一列。 |
| 3 | |ρ| > 0.8 | p.50 | Spearman 强单调相关(非线性也算)→ 可能冗余。 |
| 4 | p ≤ α | p.49 | χ² 检验:拒绝「相互独立」→ 两列有关联 / 信息重叠。 |
| 5 | 2^d | p.78 | Wrapper 的全部候选子集数;d 稍大就组合爆炸。 |
| 6 | d ≫ n | p.73 | 特征远多于样本 → 减列(选择 / 提取),治过拟合。 |
| 7 | n ≫ d | p.73 | 样本远多于特征 → 减行(抽样 / 原型),治算力。 |
| 8 | 1–5 % | p.89 | ENN 的删除比例:保守、提质、平滑边界。 |
| 9 | 60–80 % | p.89 | CNN 的删除比例:激进、大幅压缩、提速。 |
| 10 | 62 → 60(≈97 %) | p.90 | ENN 示例:62 条只删掉 2 条噪声点。 |
| 11 | 62 → 14(≈22 %) | p.90 | CNN 示例:只保留 14 个原型,其余冗余全删。 |
| 12 | 95 / 5 → 95 + 5 | p.91 | 1 000 笔缩到 100 笔:分层得 95 正常 + 5 欺诈。 |
| 13 | 18 / 65 | p.93 | 年龄专家分箱切点:未成年 / 成年 / 老年 → 3 / 7 / 2。 |
| 14 | (85 − 12) / 3 ≈ 24,3 | p.95 | 等宽先求极差再除 k,边界 36,3 与 60,7;不是 85 ÷ 3。 |
| 15 | 10 / 0 / 2 | p.95 | 同一组 12 个年龄走等宽 → 中箱空箱,证明「偏斜别用等宽」。 |
易混对照卡
这 14 组是选择题与简答题最爱挖的坑:每组只差一个关键词,抓住那个词就不会翻车。
噪声 = 随机错误值(无信息);outlier = 数值远离主体(可能是真的);anomalía = 「异常」的统称,三者常被混用(p.15 / p.36)。
缺失 = 格子空着;不一致 = 有值但放错 / 写法冲突;重复 = 整行抄了两遍(p.15)。
删 = 扔掉行或列(简单但丢信息、可能引入选择偏差);插补 = 填上(保样本量,但可能编造数据)(p.19–p.22)。
简单 = 均值 / 中位数 / 众数,一步到位;模型 = 用其他列预测(k-NN、回归),更准但更贵(p.21–p.22)。
Min-Max 压到 [0,1](或 [a,b]),受离群点影响大;Z-score 变成 μ=0、σ=1,假设近似正态(p.56 / p.57)。
选择 = 从原列里挑(列还是原来那些);提取 = 造新列(PCA、IMC),列的含义变了(p.74)。
选特征 = 减列(d 变小);选记录 = 减行(n 变小)。别把「降维」一律当成「减行」(p.74 / p.85)。
Filter 不训模型(快,看不见交互);Wrapper 反复训模型(准,最贵);Embedded 训练时顺带选(居中,Lasso / 树)(p.77 / p.82)。
随机 = 等概率、保「期望」分布、可能丢少数类;分层 = 类内按比例、保精确分布、需要标签(p.86)。
ENN = 删误分类者(去噪声,1–5%);CNN = 只留误分类者(去冗余,60–80%)。此 CNN 不是卷积网络(p.89)。
噪声 = 标签与邻居不一致(改质量);冗余 = 与邻居同类且在内部(减数量)。前者改质,后者改量(p.88 / p.90)。
One-Hot 拆 k 列(无顺序,名义变量);Ordinal 一列整数且顺序为真;Label 一列整数但顺序未必为真(只给 y)(p.65)。
离散化:连续 → 区间(损失精度);编码:类别 → 数字(不改粒度)。先离散化、再编码是常见组合(p.93 / p.65)。
等宽切范围(偏斜会空箱);等频切人数(箱宽不等);专家切意义(可解释但未必统计最优)(p.94)。