- 一页一块:页号胶囊是 PDF 物理页序(1–28);幻灯片上印的页码可能另有编号,以胶囊为准。
- 逐句对照:蓝色左框内是西语原句(逐字照抄,含原文笔误),下面带「中」字标的是中文翻译;项目符号统一用 • 表示。
- 提示框:绿色「考点」= 这页怎么考;红色「陷阱」= 易错点与原文勘误;紫色「记忆钩子」= 口诀;橙色「补充」= 前后页串联。
- 术语悬停:西语句里带浅蓝底的词,鼠标停上去出中文;中文句里带虚下划线的词,停上去出西语原词。
- 公式:一律用本地 MathJax 渲染(断网也能显示),每个公式下附「符号 / 西语读法 / 中文含义」三列小表——口语考试念的就是这一列。
一、从 docker run 到编排器
p.1–p.4Inicialización del clúster Kubernetes multi-nodo con Kind · 用 Kind 初始化多节点 Kubernetes 集群
▸ 原页截图 p.1
BLOQUE II —
第二篇——
Inicialización del clúster
用
Duración: 2 horas — teoría con tareas cortas intercaladas
时长:2 小时——理论讲解中穿插短任务。
4
4
Objetivos de esta sesión · 本节课目标
▸ 原页截图 p.2
Objetivos de esta sesión
本节课目标
3 min
3 分钟
Hasta ahora habéis manejado
到现在为止,你们都是在一台机器上、手工地、一个接一个地管理
Hoy dais el salto: quién los arranca por vosotros, quién decide dónde, y quién los vuelve a levantar cuando se caen.
今天你们要跨一步:谁来替你们启动它们、谁来决定放在哪、以及它们挂掉时谁来重新拉起。
• Qué problema resuelve un
•
• La arquitectura de Kubernetes:
• Kubernetes 架构:
• El
•
• Qué es Kind y por qué nos sirve un clúster hecho de contenedores
• Kind 是什么,以及为什么「用容器搭出来的集群」对我们够用
• Levantar y explorar vuestro propio clúster de 3 nodos
• 启动并探索你们自己的 3 节点集群
A partir de hoy: este clúster es vuestro entorno de trabajo hasta el final de la asignatura.
从今天起:这个集群就是你们的工作环境,直到本课程结束。
Cuidadlo.
爱惜它。
El problema que aparece al crecer · 规模变大后暴露的问题
▸ 原页截图 p.3
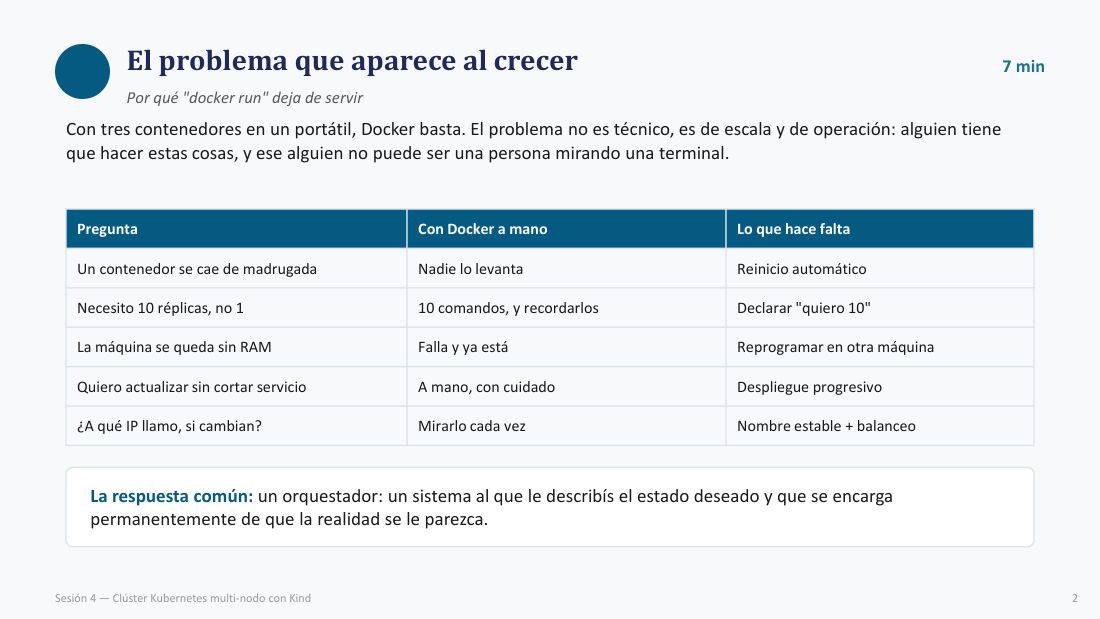
Por qué "docker run" deja de servir
为什么「docker run」不再够用
Con tres contenedores en un portátil, Docker basta.
笔记本上跑三个容器,Docker 足够。
El problema no es técnico, es de
问题不是技术性的,而是
| Pregunta | Con Docker a mano | Lo que hace falta |
|---|---|---|
| Un contenedor se cae de madrugada | Nadie lo levanta | Reinicio automático |
| Necesito 10 réplicas, no 1 | 10 comandos, y recordarlos | Declarar "quiero 10" |
| La máquina se queda sin RAM | Falla y ya está | Reprogramar en otra máquina |
| Quiero actualizar sin cortar servicio | A mano, con cuidado | Despliegue progresivo |
| ¿A qué IP llamo, si cambian? | Mirarlo cada vez | Nombre estable + balanceo |
La respuesta común: un
共同的答案是:一个
La idea central: declarativo, no imperativo · 核心思想:声明式而非命令式
▸ 原页截图 p.4
Si entendéis esto, el resto de Kubernetes se deduce
只要理解这一点,Kubernetes 其余部分都能推导出来
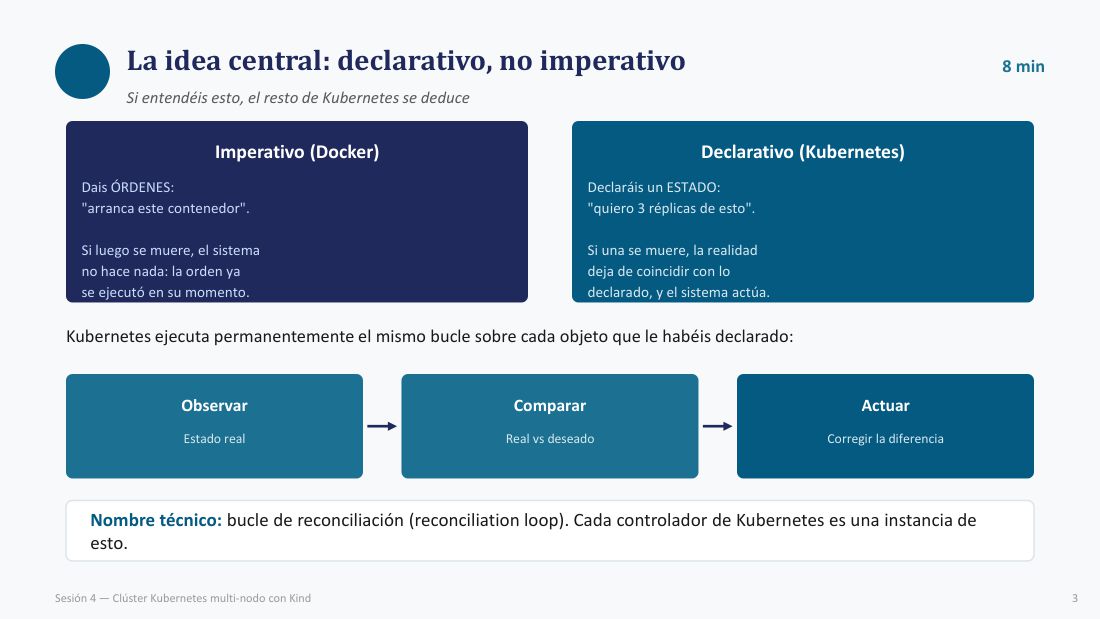
Imperativo (Docker)
命令式(Docker)
Dais ÓRDENES: "arranca este contenedor".
你们下的是
Si luego se muere, el sistema no hace nada: la orden ya se ejecutó en su momento.
如果它随后死了,系统什么也不做:命令在当初就已经执行完了。
Declarativo (Kubernetes)
声明式(Kubernetes)
Declaráis un ESTADO: "quiero 3
你们声明的是一个
Si una se muere, la realidad deja de coincidir con lo declarado, y el sistema actúa.
如果其中一个死了,现实就与所声明的不再一致,系统于是采取行动。
Kubernetes ejecuta permanentemente el mismo bucle sobre cada objeto que le habéis declarado:
Kubernetes 会对你们声明过的每个对象,持续执行同一个循环:
Observar — Estado real
观察——真实状态
Comparar — Real vs deseado
比较——现实对期望
Actuar — Corregir la diferencia
行动——修正差异
Nombre técnico:
技术名称:
Cada
Kubernetes 的每一个
二、Kubernetes 架构与对象
p.5–p.8Arquitectura: dos planos · 架构:两个平面
▸ 原页截图 p.5
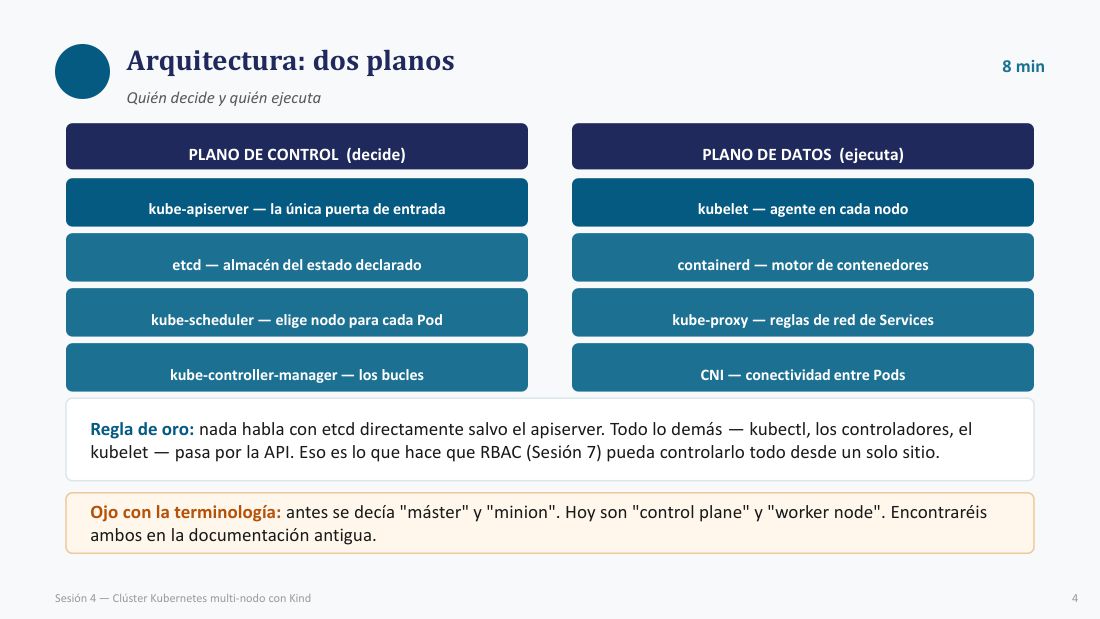
Quién decide y quién ejecuta
谁做决定,谁去执行
•
•
•
•
• kube-scheduler — elige nodo para cada Pod
• kube-scheduler——为每个 Pod 挑选节点
• kube-controller-manager — los bucles
• kube-controller-manager——那些循环
•
•
• containerd — motor de contenedores
• containerd——容器运行时
• kube-proxy — reglas de red de Services
• kube-proxy——Service 的网络规则
•
•
Regla de oro: nada habla con etcd directamente salvo el apiserver.
黄金法则:除了 apiserver,没有任何组件直接跟 etcd 说话。
Todo lo demás — kubectl, los controladores, el kubelet — pasa por la API.
其他一切——kubectl、各个控制器、kubelet——都要经过 API。
Eso es lo que hace que
正因如此,
Ojo con la terminología: antes se decía "máster" y "minion".
注意术语:以前叫「máster」和「minion」。
Hoy son "
如今是「
Encontraréis ambos en la documentación antigua.
在旧文档里两种说法都会遇到。
Los componentes, uno a uno · 逐个认识组件
▸ 原页截图 p.6
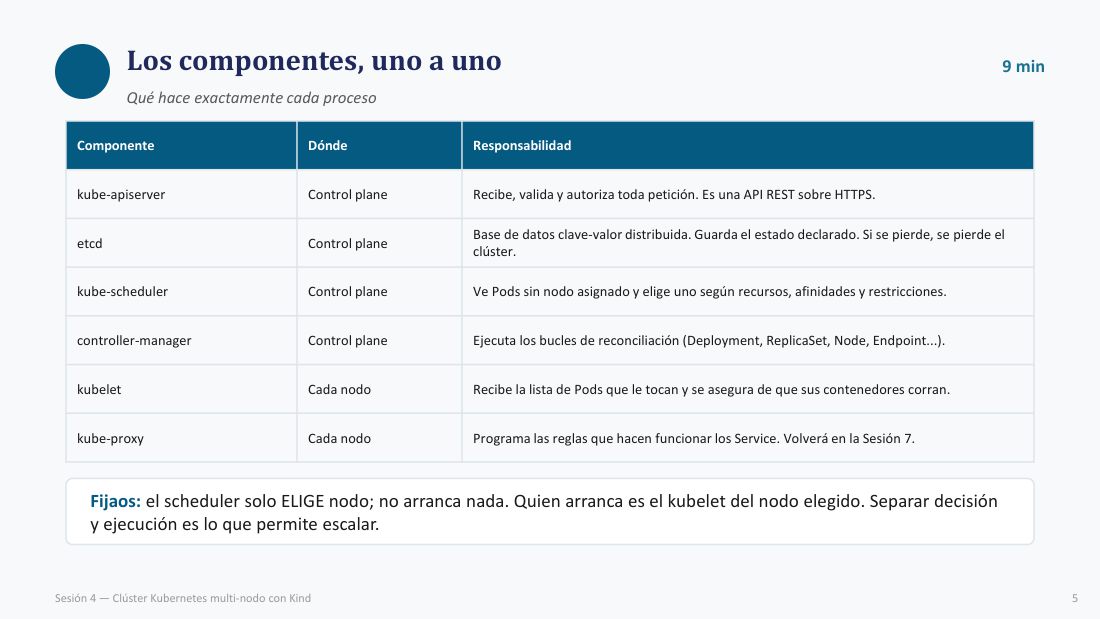
Qué hace exactamente cada proceso
每个进程到底做什么
| Componente | Dónde | Responsabilidad |
|---|---|---|
| kube-apiserver | Control plane | Recibe, valida y autoriza toda petición. Es una API REST sobre HTTPS. |
| etcd | Control plane | Base de datos clave-valor distribuida. Guarda el estado declarado. Si se pierde, se pierde el clúster. |
| kube-scheduler | Control plane | Ve Pods sin nodo asignado y elige uno según recursos, afinidades y restricciones. |
| controller-manager | Control plane | Ejecuta los bucles de reconciliación (Deployment, ReplicaSet, Node, Endpoint...). |
| kubelet | Cada nodo | Recibe la lista de Pods que le tocan y se asegura de que sus contenedores corran. |
| kube-proxy | Cada nodo | Programa las reglas que hacen funcionar los Service. Volverá en la Sesión 7. |
Fijaos: el scheduler solo ELIGE nodo; no arranca nada.
注意:调度器只「选」节点,它不启动任何东西。
Quien arranca es el
真正启动容器的是被选中节点上的
Separar decisión y ejecución es lo que permite escalar.
把「决定」和「执行」分开,正是能够扩展的原因。
Tarea — antes de instalar nada — leed la API · 任务:装任何东西之前,先读 API
▸ 原页截图 p.7
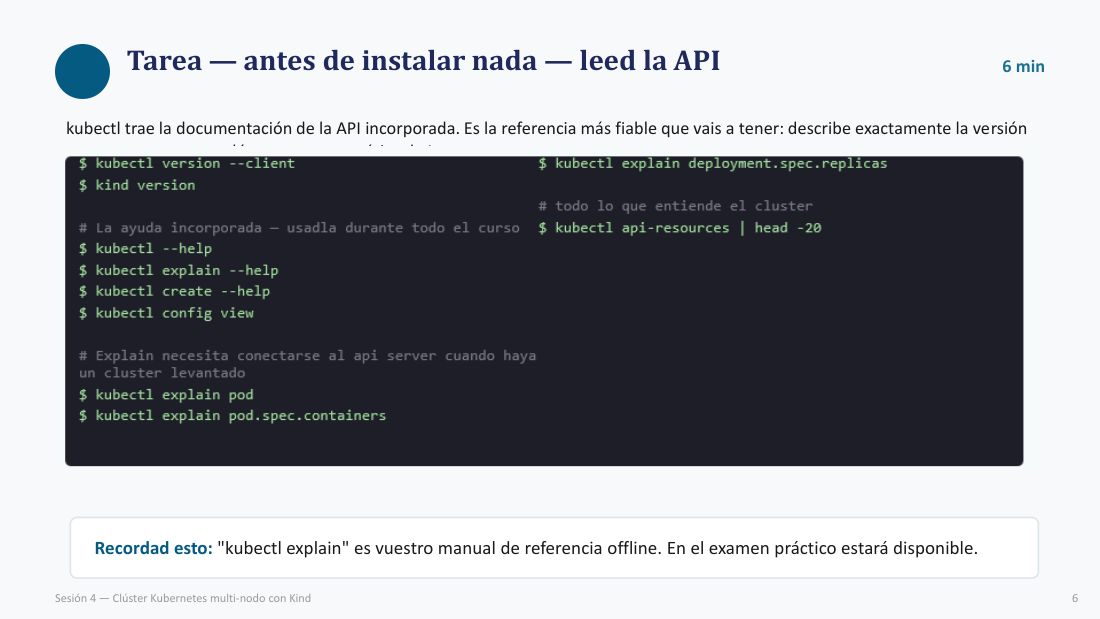
kubectl trae la documentación de la API incorporada.
kubectl 自带一份内建的 API 文档。
Es la referencia más fiable que vais a tener: describe exactamente la versión que corre en vuestro clúster, no una genérica de Internet.
这是你们能拿到的最可靠的参考:它描述的正是你们集群里运行的那个版本,而不是网上某个通用版本。
Recordad esto: "kubectl explain" es vuestro manual de referencia offline.
记住这一点:「kubectl explain」就是你们的离线参考手册。
En el examen práctico estará disponible.
实操考试中它是可用的。
终端 · 出处:Sesión 4 · p.7
$ kubectl explain pod.spec.containers
$ kubectl explain deployment.spec --recursive
| 命令 / 参数 | 逐行说明 |
|---|---|
| kubectl explain | 查字段文档。不联网,读的是本集群 apiserver 里的 OpenAPI,所以版本永远对得上。 |
| pod.spec.containers | 点号就是路径:资源类型 → 顶层字段 → 子字段,一层层往下钻。 |
| deployment.spec | 资源名写小写、单数(deploy 这类缩写也认);换成 svc、ing 一样能查。 |
| --recursive | 递归打印整棵字段树,一次看清嵌套结构;不加只显示当前这一层。 |
| $ | 提示符,不用输入;它表示后面这行在普通用户终端里执行。 |
Los objetos que vais a manejar · 你们将要操作的对象
▸ 原页截图 p.8
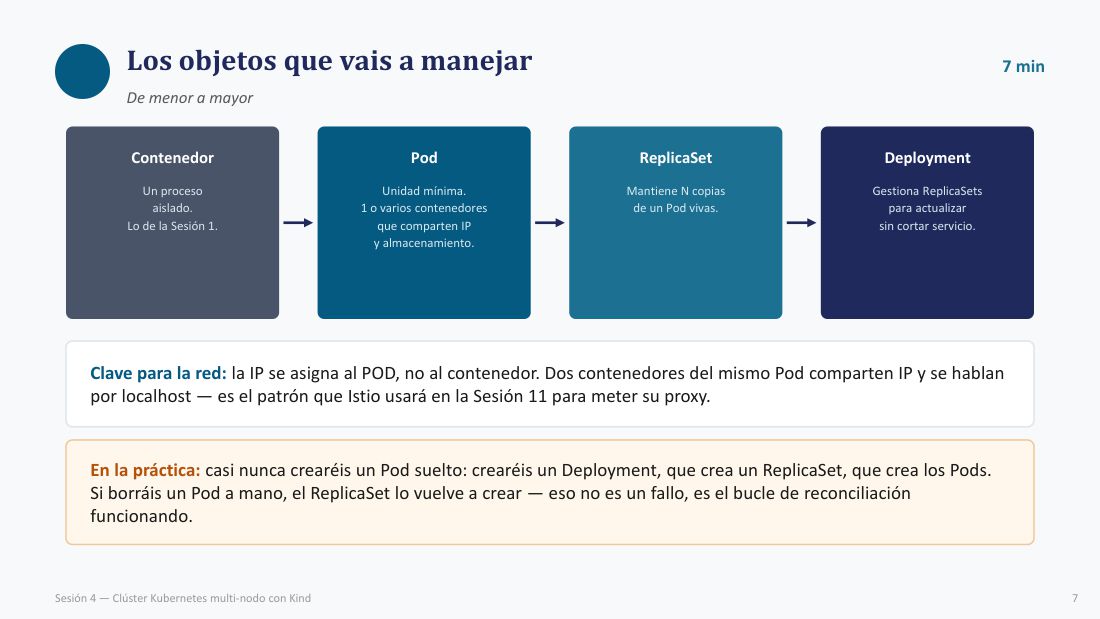
De menor a mayor
由小到大
Contenedor — Un proceso aislado. Lo de la Sesión 1.
容器——一个被隔离的进程。第 1 讲的内容。
Clave para la red: la IP se asigna al POD, no al contenedor.
网络上的关键点:IP 分配给的是 POD,不是容器。
Dos contenedores del mismo Pod comparten IP y se hablan por localhost — es el patrón que
同一个 Pod 的两个容器共享 IP,通过 localhost 通信——第 11 讲
En la práctica: casi nunca crearéis un Pod suelto: crearéis un Deployment, que crea un ReplicaSet, que crea los Pods.
实践上:几乎不会去创建一个孤零零的 Pod——你们创建 Deployment,它创建 ReplicaSet,ReplicaSet 再创建 Pod。
Si borráis un Pod a mano, el ReplicaSet lo vuelve a crear — eso no es un fallo, es el bucle de reconciliación funcionando.
如果你手动删掉一个 Pod,ReplicaSet 会再建一个——这不是故障,而是调和循环在工作。
三、Kind:用容器搭一个真集群
p.9–p.12¿Cómo se instala Kubernetes? · Kubernetes 怎么装
▸ 原页截图 p.9
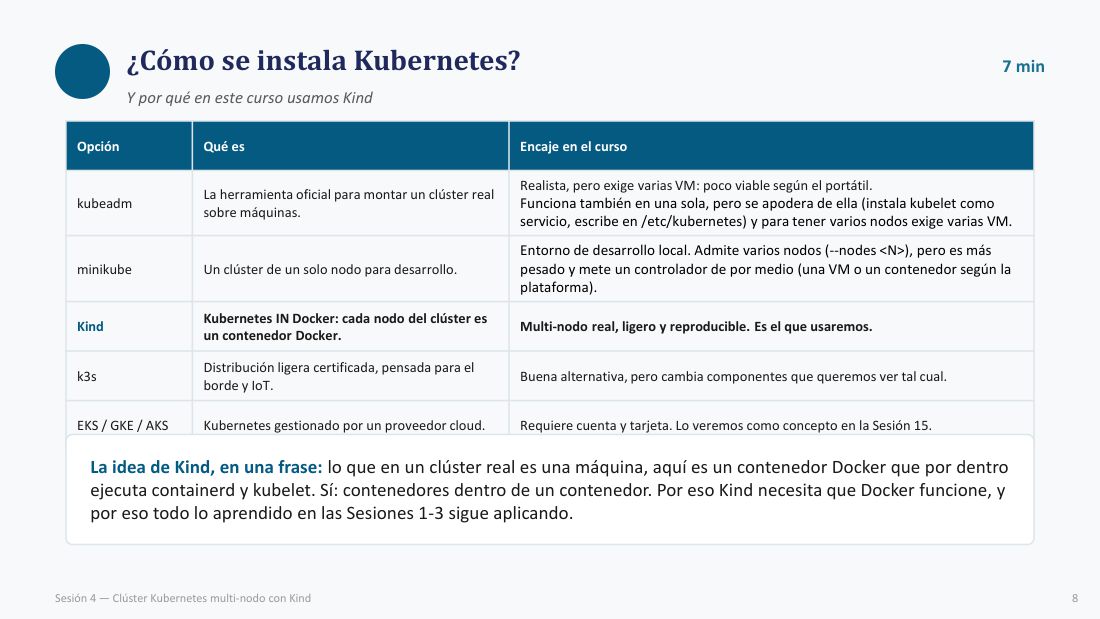
¿Cómo se instala Kubernetes?
Kubernetes 怎么安装?
Y por qué en este curso usamos Kind
以及为什么本课程用 Kind
| Opción | Qué es | Encaje en el curso |
|---|---|---|
| kubeadm | La herramienta oficial para montar un clúster real sobre máquinas. | Realista, pero exige varias VM: poco viable según el portátil. Funciona también en una sola, pero se apodera de ella (instala kubelet como servicio, escribe en /etc/kubernetes) y para tener varios nodos exige varias VM. |
| minikube | Un clúster de un solo nodo para desarrollo. | Entorno de desarrollo local. Admite varios nodos (--nodes <N>), pero es más pesado y mete un controlador de por medio (una VM o un contenedor según la plataforma). |
| Kind | Kubernetes IN Docker: cada nodo del clúster es un contenedor Docker. | Multi-nodo real, ligero y reproducible. Es el que usaremos. |
| k3s | Distribución ligera certificada, pensada para el borde y IoT. | Buena alternativa, pero cambia componentes que queremos ver tal cual. |
| EKS / GKE / AKS | Kubernetes gestionado por un proveedor cloud. | Requiere cuenta y tarjeta. Lo veremos como concepto en la Sesión 15. |
La idea de Kind, en una frase: lo que en un clúster real es una máquina, aquí es un contenedor Docker que por dentro ejecuta containerd y kubelet.
用一句话概括 Kind 的思路:真实集群里的一台机器,在这里就是一个 Docker 容器,容器内部跑着 containerd 和 kubelet。
Sí: contenedores dentro de un contenedor.
没错:容器里的容器。
Por eso Kind necesita que Docker funcione, y por eso todo lo aprendido en las Sesiones 1-3 sigue aplicando.
所以 Kind 要求 Docker 能正常工作,也所以第 1–3 讲学到的东西全部继续适用。
Declarar el clúster: kind-cluster.yaml · 声明集群
▸ 原页截图 p.10
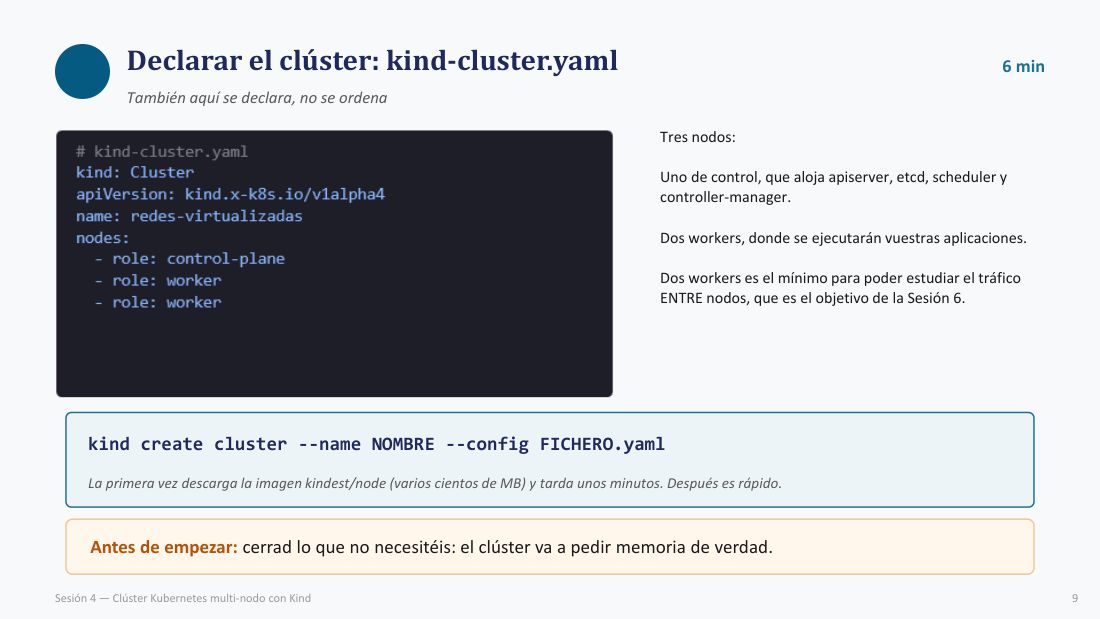
También aquí se declara, no se ordena
这里同样是「声明」,不是「下命令」
Tres nodos:
三个节点:
Uno de control, que aloja apiserver, etcd, scheduler y controller-manager.
一个控制节点,承载 apiserver、etcd、scheduler 和 controller-manager。
Dos workers, donde se ejecutarán vuestras aplicaciones.
两个 worker,你们的应用将运行在那里。
Dos workers es el mínimo para poder estudiar el tráfico ENTRE nodos, que es el objetivo de la Sesión 6.
两个 worker 是研究「节点之间」流量的最低配置,而这正是第 6 讲的目标。
kind-cluster.yaml · 出处:Sesión 4 · p.10
# kind-cluster.yaml
kind: Cluster
apiVersion: kind.x-k8s.io/v1alpha4
name: redes-virtualizadas
nodes:
  - role: control-plane
  - role: worker
  - role: worker
| 配置项 | 逐行说明 |
|---|---|
| kind: Cluster | 对象类型:这是 kind 的集群配置,不是 K8s 里的某个资源。 |
| apiVersion: kind.x-k8s.io/v1alpha4 | kind 自己的配置版本,与 K8s 资源的 apiVersion 无关;照着写 v1alpha4。 |
| name: redes-virtualizadas | 集群名;之后 kubeconfig 里的 context 就叫 kind-redes-virtualizadas。 |
| nodes: | 节点清单,每一项对应一个 Docker 容器。 |
| - role: control-plane / worker | role 只有这两种身份:1 个控制面 + 2 个 worker。 |
创建命令 · 出处:Sesión 4 · p.10
kind create cluster --name NOMBRE --config FICHERO.yaml
| 命令 | 逐行说明 |
|---|---|
| kind create cluster | 建集群子命令;kind 建的「节点」其实是 Docker 容器。 |
| --name NOMBRE | 集群名,同时决定 kubeconfig 的 context 名与容器名前缀。 |
| --config FICHERO.yaml | 指定节点清单文件;省略就只建一个单节点集群。 |
La primera vez descarga la imagen kindest/node (varios cientos de MB) y tarda unos minutos.
第一次会下载 kindest/node 镜像(几百 MB),要花几分钟。
Después es rápido.
之后就很快了。
Antes de empezar: cerrad lo que no necesitéis: el clúster va a pedir memoria de verdad.
开始之前:把不需要的程序关掉——这个集群是真的要吃内存。
Tarea — cread vuestro clúster · 任务:创建你们的集群
▸ 原页截图 p.11
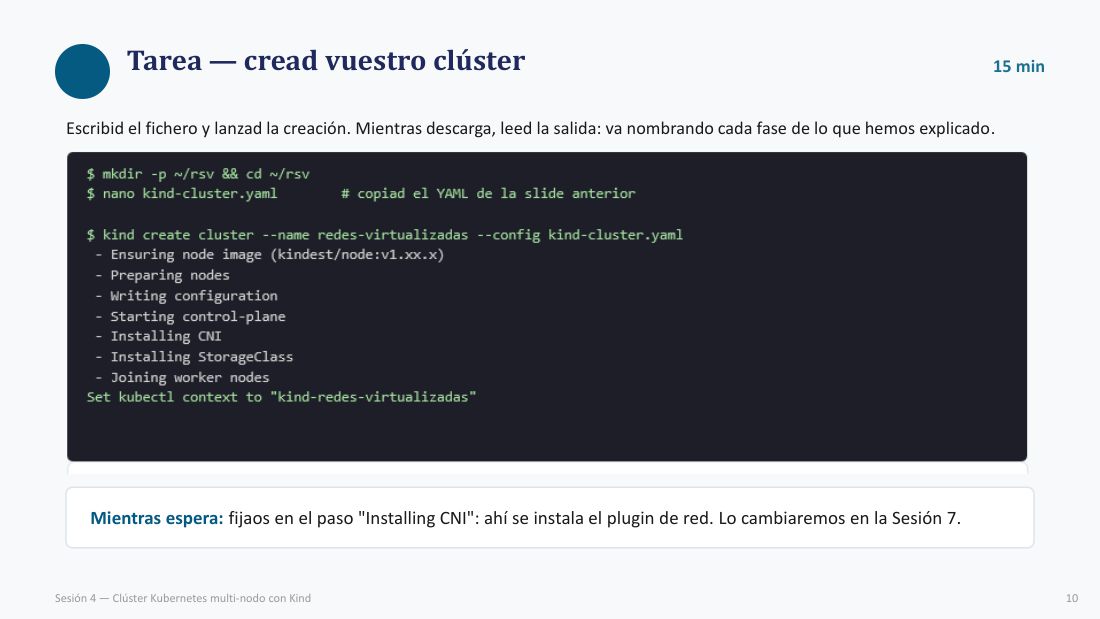
Escribid el fichero y lanzad la creación.
写好文件,然后启动创建。
Mientras descarga, leed la salida: va nombrando cada fase de lo que hemos explicado.
下载的时候读一读输出:它会把我们讲过的每个阶段一一命名。
Mientras espera: fijaos en el paso "Installing CNI": ahí se instala el plugin de red.
等待时注意 «Installing CNI» 这一步:网络插件就是在这里装上的。
Lo cambiaremos en la Sesión 7.
第 7 讲我们会把它换掉。
终端实录 · 出处:Sesión 4 · p.11
$ mkdir -p ~/rsv && cd ~/rsv
$ nano kind-cluster.yaml          # copiad el YAML de la slide anterior

$ kind create cluster --name redes-virtualizadas --config kind-cluster.yaml
  - Ensuring node image (kindest/node:v1.xx.x)
  - Preparing nodes
  - Writing configuration
  - Starting control-plane
  - Installing CNI
  - Installing StorageClass
  - Joining worker nodes
Set kubectl context to "kind-redes-virtualizadas"
| 命令 | 逐行说明 |
|---|---|
| mkdir -p ~/rsv | -p:目录已存在也不报错;建立工作目录。 |
| cd ~/rsv | 进入工作目录,后面的相对路径都以它为准。 |
| nano kind-cluster.yaml | 用编辑器把 p.10 的 YAML 粘进去并保存。 |
| kind create cluster --name ... --config ... | 按文件建集群;--name 与文件里的 name 保持一致,context 才是 kind-redes-virtualizadas。 |
| - Ensuring node image … - Joining worker nodes | 每个缩进行是一个阶段,顺序见下方「这段在考什么」。 |
Anidamiento en despliegues Kind · Kind 部署中的嵌套
▸ 原页截图 p.12
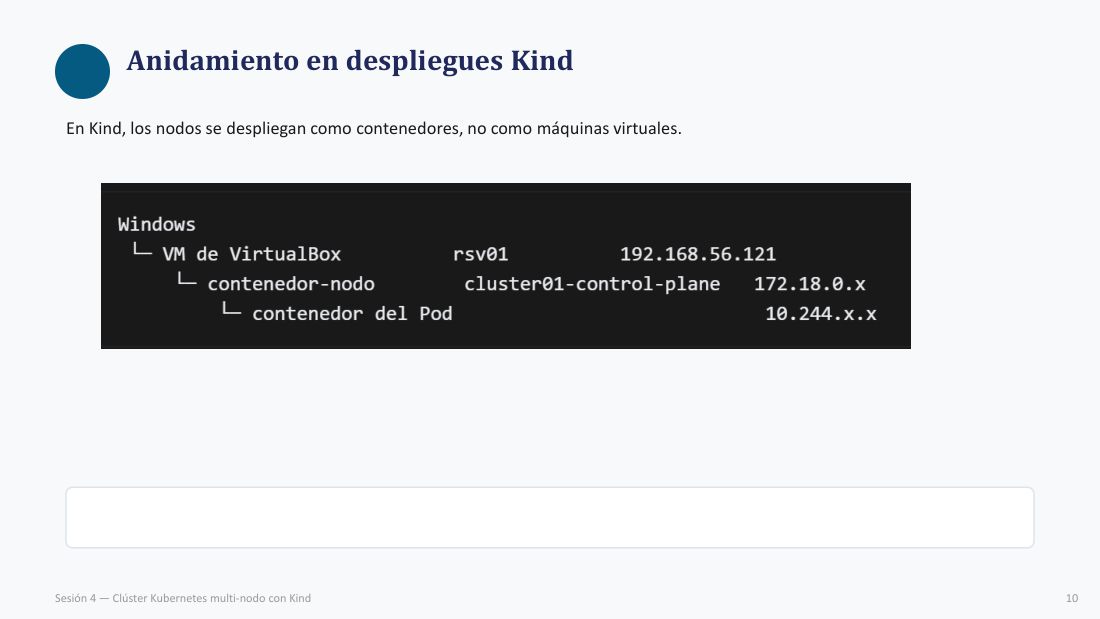
En Kind, los nodos se despliegan como contenedores, no como máquinas virtuales.
在 Kind 里,节点是以容器形式部署的,不是虚拟机。
Anidamiento · 出处:Sesión 4 · p.12
Windows
 └─ VM de VirtualBox          rsv01                  192.168.56.121
     └─ contenedor-nodo       cluster01-control-plane  172.18.0.x
         └─ contenedor del Pod                          10.244.x.x
| 图中的层 | 逐行说明 |
|---|---|
| Windows | 宿主机,VirtualBox 跑在这里。 |
| VM de VirtualBox · 192.168.56.121 | 第一层:Host-Only 网段的虚拟机 rsv01。 |
| contenedor-nodo · 172.18.0.x | 第二层:kind 的节点容器,走 Docker bridge 网段。 |
| contenedor del Pod · 10.244.x.x | 第三层:Pod,走 CNI 网段。 |
四、连上集群:kubeconfig 与 kubectl
p.13–p.15¿Cómo sabe kubectl a qué clúster hablar? · kubectl 怎么知道跟哪个集群说话
▸ 原页截图 p.13
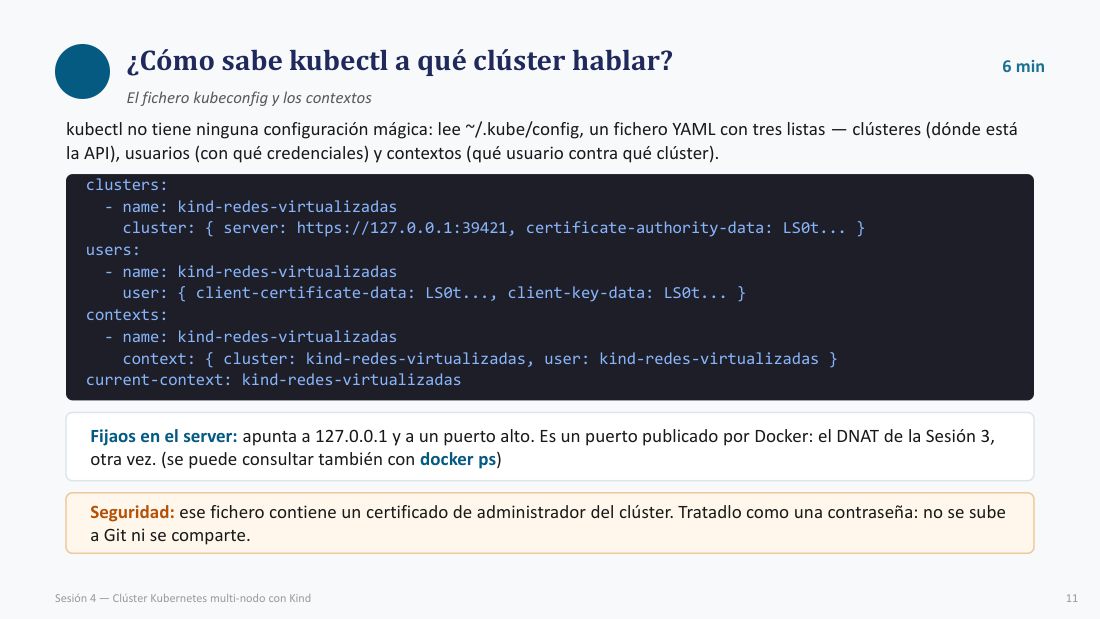
El fichero
kubectl no tiene ninguna configuración mágica: lee ~/.kube/config, un fichero YAML con tres listas —
kubectl 没有什么魔法配置:它读的是 ~/.kube/config,一个含三个列表的 YAML 文件——
~/.kube/config(节选)· 出处:Sesión 4 · p.13
clusters:
- name: kind-redes-virtualizadas
  cluster: { server: https://127.0.0.1:39421, certificate-authority-data: LS0t... }
users:
- name: kind-redes-virtualizadas
  user: { client-certificate-data: LS0t..., client-key-data: LS0t... }
contexts:
- name: kind-redes-virtualizadas
  context: { cluster: kind-redes-virtualizadas, user: kind-redes-virtualizadas }
current-context: kind-redes-virtualizadas
| 字段 | 逐行说明 |
|---|---|
| clusters: | 集群条目:server 地址 + certificate-authority-data(CA 证书,base64)。 |
| users: | 身份条目:client-certificate-data + client-key-data(客户端证书与私钥,base64)。 |
| contexts: | 用名字把 cluster 和 user 绑成一条上下文。 |
| current-context: | 默认使用哪一条上下文。 |
| server: https://127.0.0.1:39421 | 本机高位端口,由 Docker 转发到控制面容器;集群重建后端口可能变化。 |
| LS0t... | 证书内容的 base64 开头,不是真的省略号。 |
Fijaos en el server: apunta a 127.0.0.1 y a un puerto alto.
注意 server:它指向 127.0.0.1,而且是一个高位端口。
Es un puerto publicado por Docker: el
这是 Docker 发布出来的端口:第 3 讲的
Seguridad: ese fichero contiene un certificado de administrador del clúster.
安全提醒:这个文件里含有集群管理员证书。
Tratadlo como una contraseña: no se sube a Git ni se comparte.
把它当密码对待:不要提交到 Git,也不要分享。
kubectl: la gramática · kubectl 的语法
▸ 原页截图 p.14
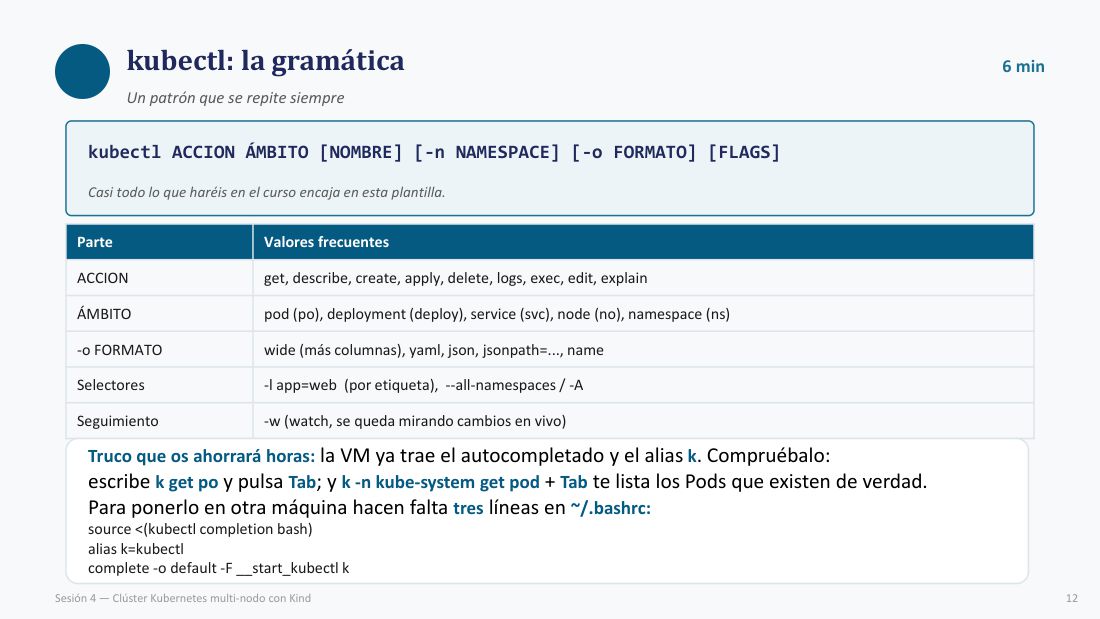
Un patrón que se repite siempre
一个永远重复的模式
kubectl ACCION ÁMBITO [NOMBRE] [-n NAMESPACE] [-o FORMATO] [FLAGS]
kubectl 动作 范围 [名字] [-n 命名空间] [-o 格式] [其他标志]
Casi todo lo que haréis en el curso encaja en esta plantilla.
本课程中你们要做的几乎所有事,都能套进这个模板。
| Parte | Valores frecuentes |
|---|---|
| ACCION | get, describe, create, apply, delete, logs, exec, edit, explain |
| ÁMBITO | pod (po), deployment (deploy), service (svc), node (no), namespace (ns) |
| -o FORMATO | wide (más columnas), yaml, json, jsonpath=..., name |
| Selectores | -l app=web (por etiqueta), --all-namespaces / -A |
| Seguimiento | -w (watch, se queda mirando cambios en vivo) |
Truco que os ahorrará horas: la VM ya trae el
能给你们省下几个小时的技巧:虚拟机已经自带
Comprueba: escribe k get po y pulsa Tab; y k -n kube-system get pod + Tab te lista los Pods que existen de verdad.
验证一下:输入 k get po 按 Tab;再输入 k -n kube-system get pod + Tab,它会列出真实存在的 Pod。
Para ponerlo en otra máquina hacen falta tres líneas en ~/.bashrc:
要在别的机器上也启用,需要在 ~/.bashrc 里加三行:
~/.bashrc · 出处:Sesión 4 · p.14
source <(kubectl completion bash)
alias k=kubectl
complete -o default -F __start_kubectl k
| 命令 | 逐行说明 |
|---|---|
| source <(kubectl completion bash) | 把 kubectl 生成的补全脚本加载进当前 shell;<(...) 是进程替换。 |
| alias k=kubectl | 起短别名,之后 k get pods 等价于 kubectl get pods。 |
| complete -o default -F __start_kubectl k | -F 指定补全函数;-o default 允许回退到默认补全;末尾的 k 是绑定对象。 |
Tarea — explorad el clúster que acabáis de crear · 任务:探索刚建好的集群
▸ 原页截图 p.15
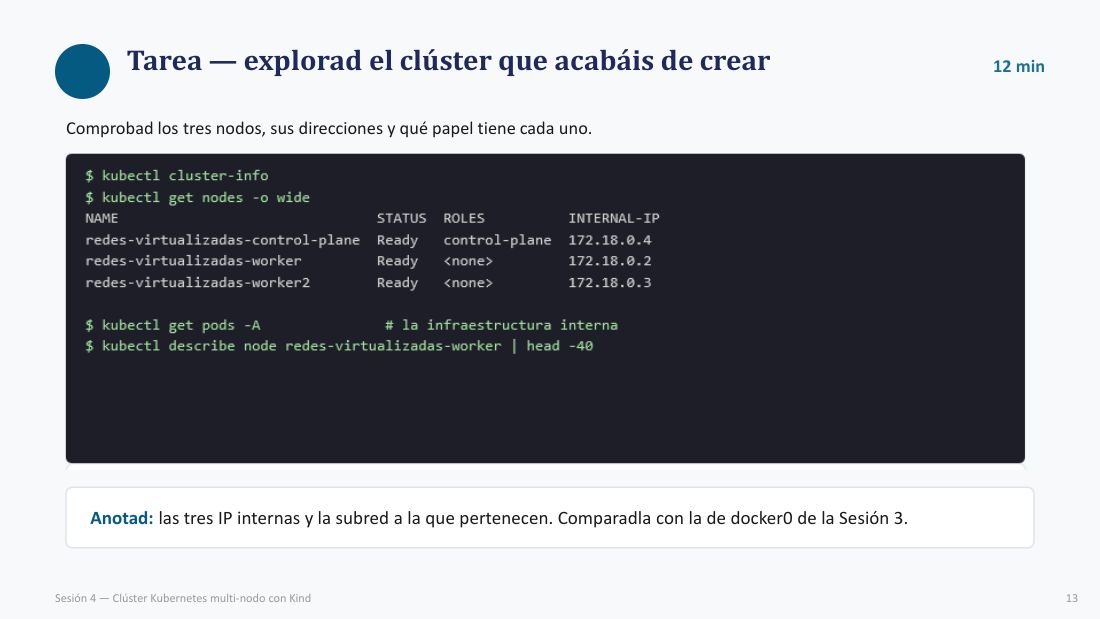
Comprobad los tres nodos, sus direcciones y qué papel tiene cada uno.
检查三个节点、它们的地址,以及各自扮演的角色。
Anotad: las tres IP internas y la subred a la que pertenecen.
记录:三个内部 IP,以及它们所属的子网。
Comparadla con la de docker0 de la Sesión 3.
把它和第 3 讲里 docker0 的网段做比较。
终端实录 · 出处:Sesión 4 · p.15
$ kubectl cluster-info
$ kubectl get nodes -o wide
NAME                                    STATUS   ROLES           INTERNAL-IP
redes-virtualizadas-control-plane       Ready    control-plane   172.18.0.4
redes-virtualizadas-worker              Ready    <none>          172.18.0.2
redes-virtualizadas-worker2             Ready    <none>          172.18.0.3

$ kubectl get pods -A            # la infraestructura interna
$ kubectl describe node redes-virtualizadas-worker | head -40
| 命令 | 逐行说明 |
|---|---|
| cluster-info | 控制面地址(以及 CoreDNS 是否在跑)。 |
| get nodes -o wide | -o wide 增加 INTERNAL-IP、OS、内核等列。 |
| get pods -A | -A = --all-namespaces,列出所有命名空间的 Pod。 |
| describe node ... | head -40 | head -40 只取前 40 行,避免刷屏。 |
五、进入集群:节点、命名空间与调度
p.16–p.20La comprobación que lo une todo · 把一切串起来的验证
▸ 原页截图 p.16
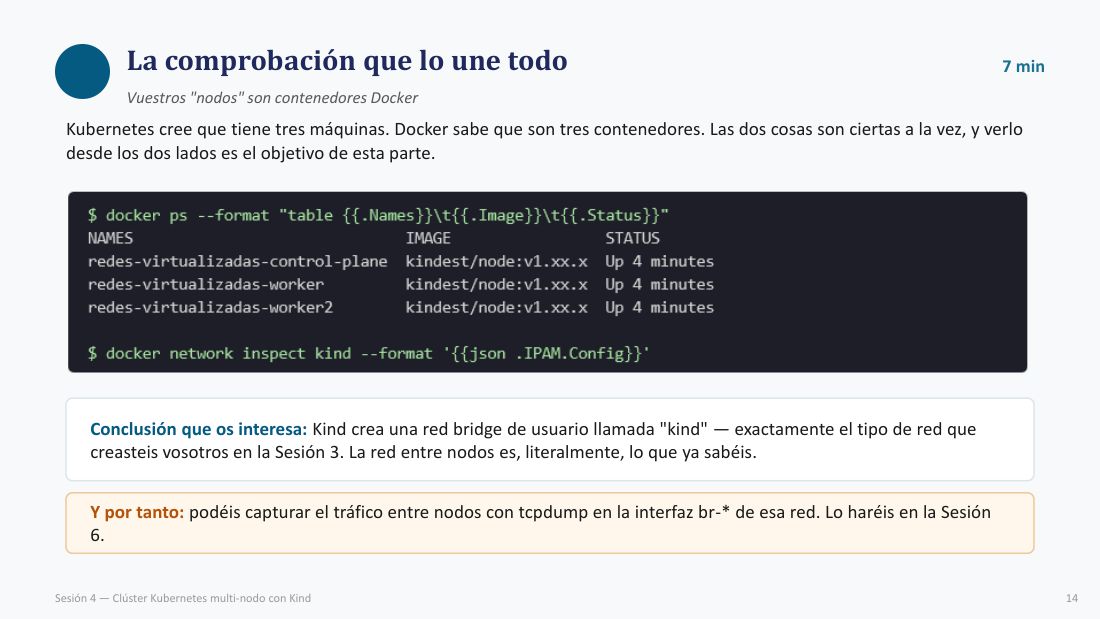
Vuestros "nodos" son contenedores Docker
你们的「节点」是 Docker 容器
Kubernetes cree que tiene tres máquinas.
Kubernetes 以为自己有三台机器。
Docker sabe que son tres contenedores.
Docker 知道它们是三个容器。
Las dos cosas son ciertas a la vez, y verlo desde los dos lados es el objetivo de esta parte.
两件事同时为真,而从两个视角都看一遍,就是这一部分的目的。
Conclusión que os interesa: Kind crea una
你们该记住的结论:Kind 会创建一张名为 «kind» 的用户
La red entre nodos es, literalmente, lo que ya sabéis.
节点之间的网络,字面上就是你们已经会的东西。
Y por tanto: podéis capturar el tráfico entre nodos con tcpdump en la interfaz br-* de esa red.
因此:你们可以在这张网络的 br-* 接口上用 tcpdump 抓节点之间的流量。
Lo haréis en la Sesión 6.
第 6 讲你们就会这么做。
Tarea — entrad dentro de un nodo · 任务:进入一个节点内部
▸ 原页截图 p.17
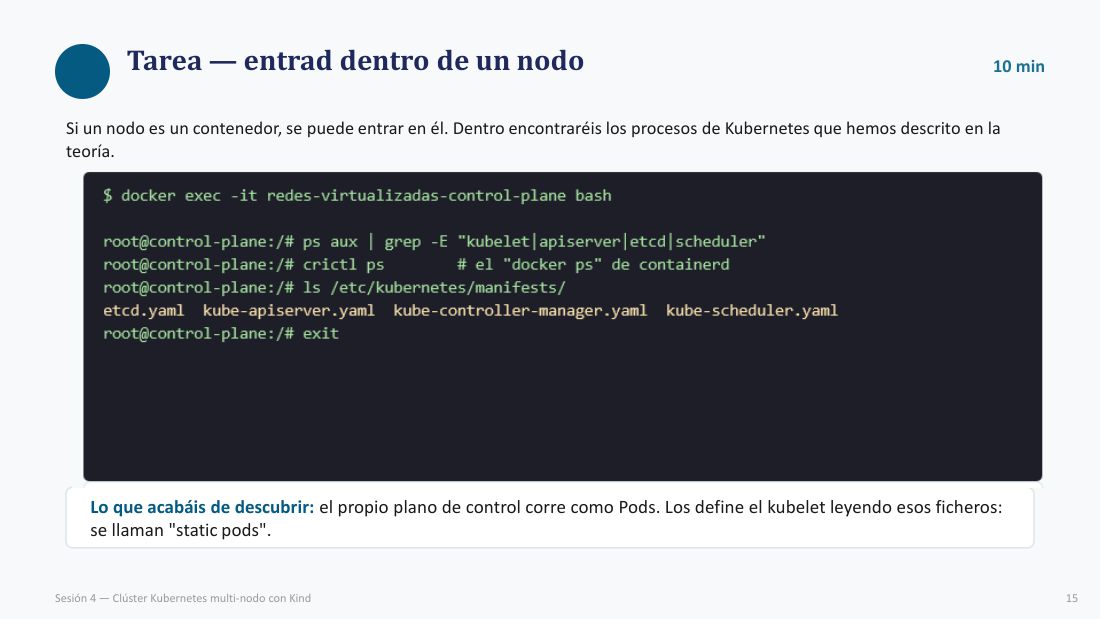
Si un nodo es un contenedor, se puede entrar en él.
既然节点是一个容器,就能进到它里面。
Dentro encontraréis los procesos de Kubernetes que hemos descrito en la teoría.
在里面你们会看到理论部分描述过的那些 Kubernetes 进程。
Lo que acabáis de descubrir: el propio plano de control corre como Pods.
你们刚刚发现的是:控制平面本身就以 Pod 形式运行。
Los define el kubelet leyendo esos ficheros: se llaman "
它们由 kubelet 读取这些文件来定义:叫做「
终端实录 · 出处:Sesión 4 · p.17
$ docker exec -it redes-virtualizadas-control-plane bash

root@control-plane:/# ps aux | grep -E "kubelet|apiserver|etcd|scheduler"
root@control-plane:/# crictl ps            # el "docker ps" de containerd
root@control-plane:/# ls /etc/kubernetes/manifests/
etcd.yaml  kube-apiserver.yaml  kube-controller-manager.yaml  kube-scheduler.yaml
root@control-plane:/# exit
| 命令 | 逐行说明 |
|---|---|
| docker exec -it ... bash | -i 保持 stdin,-t 分配终端;在节点容器里开交互 shell。 |
| ps aux | grep -E "kubelet|apiserver|etcd|scheduler" | -E 用扩展正则,一次筛四个进程。 |
| crictl ps | containerd 的容器列表;节点里没有 Docker CLI,所以用 crictl。 |
| ls /etc/kubernetes/manifests/ | 查看 static pod 的四个清单文件。 |
| exit | 退出容器 shell,回到宿主机。 |
Namespaces de Kubernetes · Kubernetes 的命名空间
▸ 原页截图 p.18
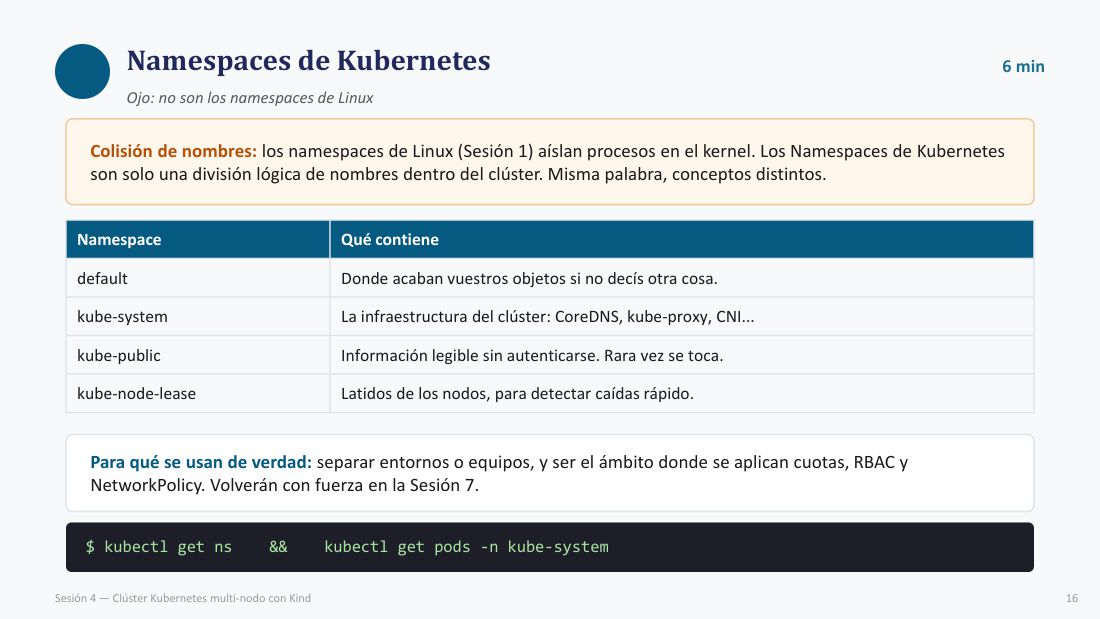
Ojo: no son los namespaces de Linux
注意:它们不是 Linux 的 namespace
Colisión de nombres: los
命名冲突:
Los
Misma palabra, conceptos distintos.
同一个词,两个不同的概念。
| Namespace | Qué contiene |
|---|---|
| default | Donde acaban vuestros objetos si no decís otra cosa. |
| kube-system | La infraestructura del clúster: CoreDNS, kube-proxy, CNI... |
| kube-public | Información legible sin autenticarse. Rara vez se toca. |
| kube-node-lease | Latidos de los nodos, para detectar caídas rápido. |
Para qué se usan de verdad: separar entornos o equipos, y ser el ámbito donde se aplican cuotas, RBAC y NetworkPolicy.
真正的用途:隔离环境或团队,并作为施加配额、RBAC 与 NetworkPolicy 的作用域。
Volverán con fuerza en la Sesión 7.
第 7 讲它们会强势回归。
终端 · 出处:Sesión 4 · p.18
$ kubectl get ns && kubectl get pods -n kube-system
| 命令 | 逐行说明 |
|---|---|
| kubectl get ns | 列出全部命名空间(ns 是 namespace 的缩写)。 |
| kubectl get pods -n kube-system | -n 指定命名空间,只看系统分区里的 Pod。 |
| && | 前一条成功才执行后一条。 |
Tarea — primer despliegue y primera reconciliación · 任务:第一次部署与第一次调和
▸ 原页截图 p.19
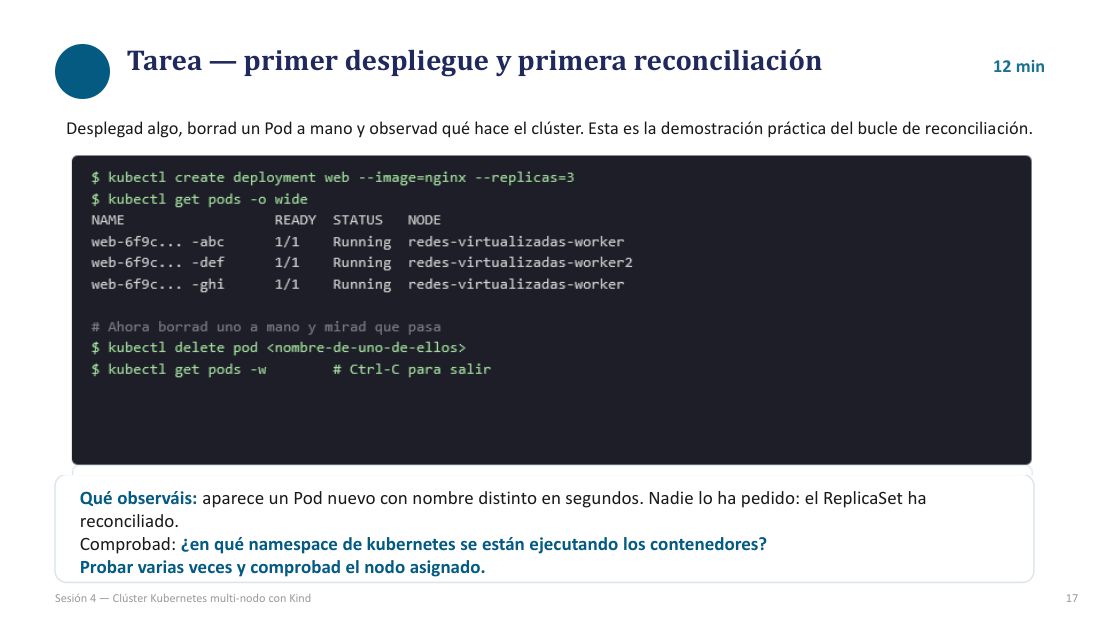
Desplegad algo, borrad un Pod a mano y observad qué hace el clúster.
部署点东西,手动删掉一个 Pod,观察集群会做什么。
Esta es la demostración práctica del
这就是
Qué observáis: aparece un Pod nuevo con nombre distinto en segundos.
你们会看到:几秒内出现一个名字不同的新 Pod。
Nadie lo ha pedido: el ReplicaSet ha reconciliado.
没人要求它这么做:是 ReplicaSet 完成了调和。
Comprobad: ¿en qué namespace de kubernetes se están ejecutando los contenedores?
检查一下:这些容器跑在 Kubernetes 的哪个 namespace 里?
Probar varias veces y comprobad el nodo asignado.
多试几次,并确认被分配到的节点。
终端实录 · 出处:Sesión 4 · p.19
$ kubectl create deployment web --image=nginx --replicas=3
$ kubectl get pods -o wide
NAME                    READY   STATUS    NODE
web-6f9c...-abc         1/1     Running   redes-virtualizadas-worker
web-6f9c...-def         1/1     Running   redes-virtualizadas-worker2
web-6f9c...-ghi         1/1     Running   redes-virtualizadas-worker

# Ahora borrad uno a mano y mirad qué pasa
$ kubectl delete pod <nombre-de-uno-de-ellos>
$ kubectl get pods -w            # Ctrl-C para salir
| 命令 | 逐行说明 |
|---|---|
| kubectl create deployment web --image=nginx --replicas=3 | 命令式创建;--image 指定镜像,--replicas 指定副本数。 |
| get pods -o wide | 多出 NODE、IP 列,用来看 Pod 被调度到哪。 |
| delete pod <nombre> | 手动删一个 Pod,名字从上一行输出里抄。 |
| get pods -w | -w 持续监听变化,Ctrl-C 退出。 |
¿Por qué ese nodo y no otro? · 为什么是这个节点而不是另一个
▸ 原页截图 p.20
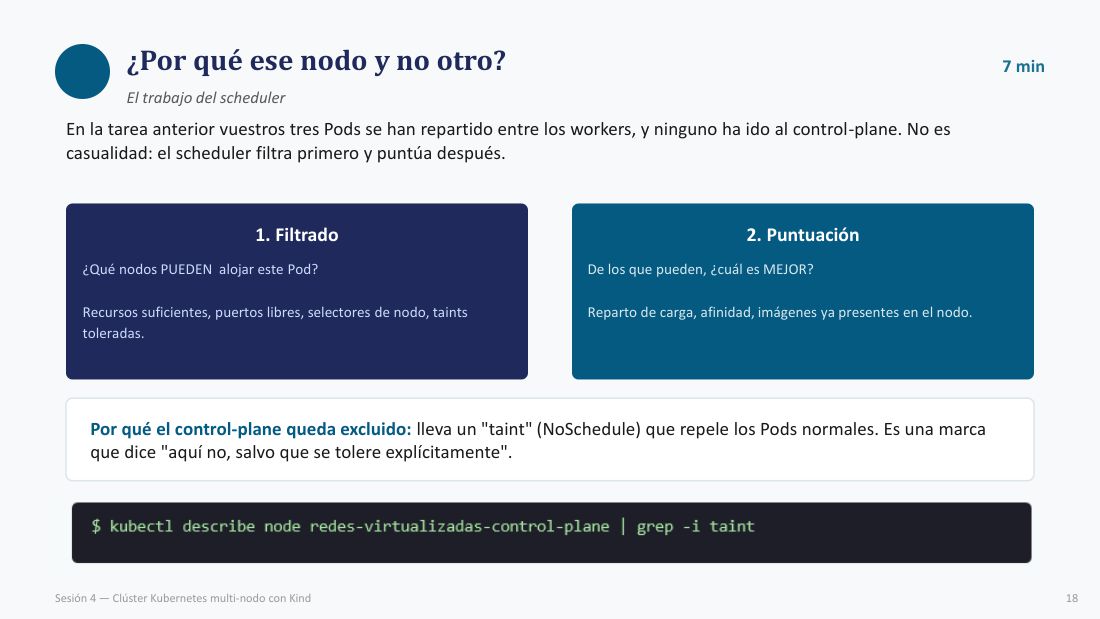
El trabajo del
En la tarea anterior vuestros tres Pods se han repartido entre los workers, y ninguno ha ido al control-plane.
在上一个任务里,你们的三个 Pod 分布在各个 worker 上,没有一个去 control-plane。
No es casualidad: el scheduler
这不是巧合:调度器先
1. Filtrado — ¿Qué nodos PUEDEN alojar este Pod?
1. 过滤——哪些节点「能够」承载这个 Pod?
Recursos suficientes, puertos libres, selectores de nodo,
资源足够、端口空闲、节点选择器、可容忍的
2. Puntuación — De los que pueden, ¿cuál es MEJOR?
2. 打分——在能承载的里面,哪个「最好」?
Reparto de carga, afinidad, imágenes ya presentes en el nodo.
负载分布、亲和性、镜像是否已在节点上。
Por qué el control-plane queda excluido: lleva un "
为什么 control-plane 被排除:它带有一个「
Es una marca que dice "aquí no, salvo que se tolere explícitamente".
它是一句标记:「这里不行,除非被显式容忍」。
终端 · 出处:Sesión 4 · p.20
$ kubectl describe node redes-virtualizadas-control-plane | grep -i taint
| 命令 | 逐行说明 |
|---|---|
| kubectl describe node ... | 节点完整详情:容量、条件、taint 等。 |
| | grep -i taint | -i 忽略大小写,只保留含 taint 的行。 |
六、从命令到交付物:YAML、资源与诊断
p.21–p.23Tarea — del comando al YAML · 任务:从命令到 YAML
▸ 原页截图 p.21
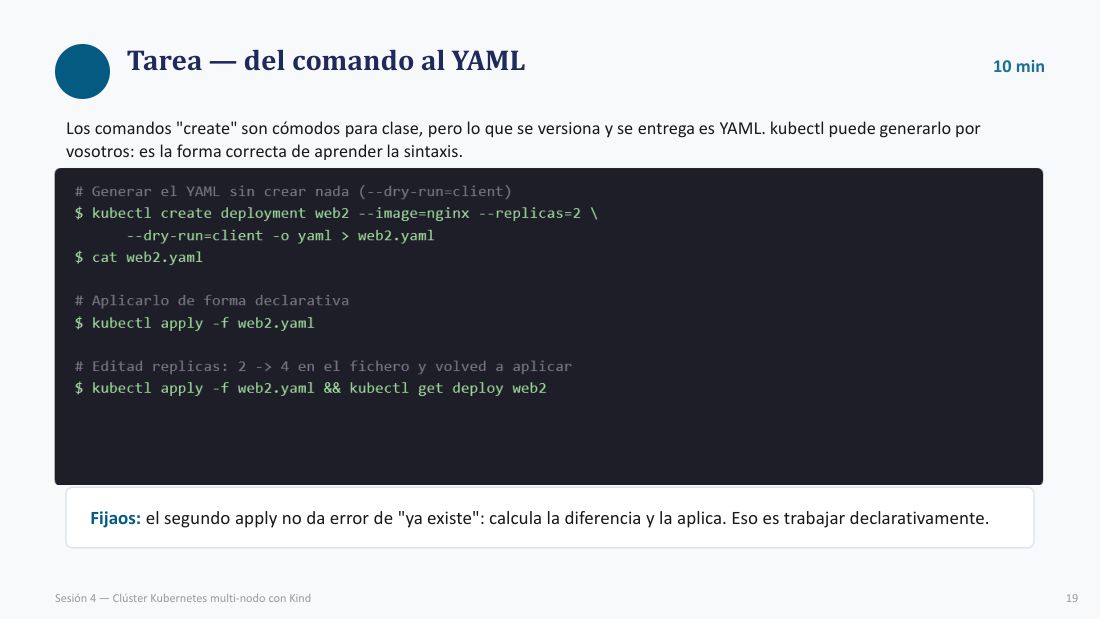
Los comandos "create" son cómodos para clase, pero lo que se versiona y se entrega es YAML.
「create」类命令在课堂上很方便,但真正纳入版本管理、真正交付的是 YAML。
kubectl puede generarlo por vosotros: es la forma correcta de aprender la sintaxis.
kubectl 可以替你们把它生成出来:这是学习语法的正确途径。
Fijaos: el segundo apply no da error de "ya existe": calcula la diferencia y la aplica.
注意:第二次 apply 不会报「已存在」的错——它会计算差异并应用。
Eso es trabajar
这就是
终端实录 · 出处:Sesión 4 · p.21
# Generar el YAML sin crear nada (--dry-run=client)
$ kubectl create deployment web2 --image=nginx --replicas=2 \
    --dry-run=client -o yaml > web2.yaml
$ cat web2.yaml

# Aplicarlo de forma declarativa
$ kubectl apply -f web2.yaml

# Editad replicas: 2 -> 4 en el fichero y volved a aplicar
$ kubectl apply -f web2.yaml && kubectl get deploy web2
| 命令 | 逐行说明 |
|---|---|
| create deployment web2 --image=nginx --replicas=2 | 命令式创建,立即提交给 apiserver。 |
| --dry-run=client -o yaml > web2.yaml | 只在客户端生成 YAML 并重定向到文件,不发给 apiserver。 |
| cat web2.yaml | 查看生成出来的清单。 |
| apply -f web2.yaml | 声明式提交;改完副本数再 apply 也不会报「已存在」。 |
| apply ... && get deploy web2 | &&:前一条成功才执行后一条。 |
Requests y limits: cgroups, otra vez · requests 与 limits:又是 cgroups
▸ 原页截图 p.22
El enlace con la Sesión 1
与第 1 讲的衔接
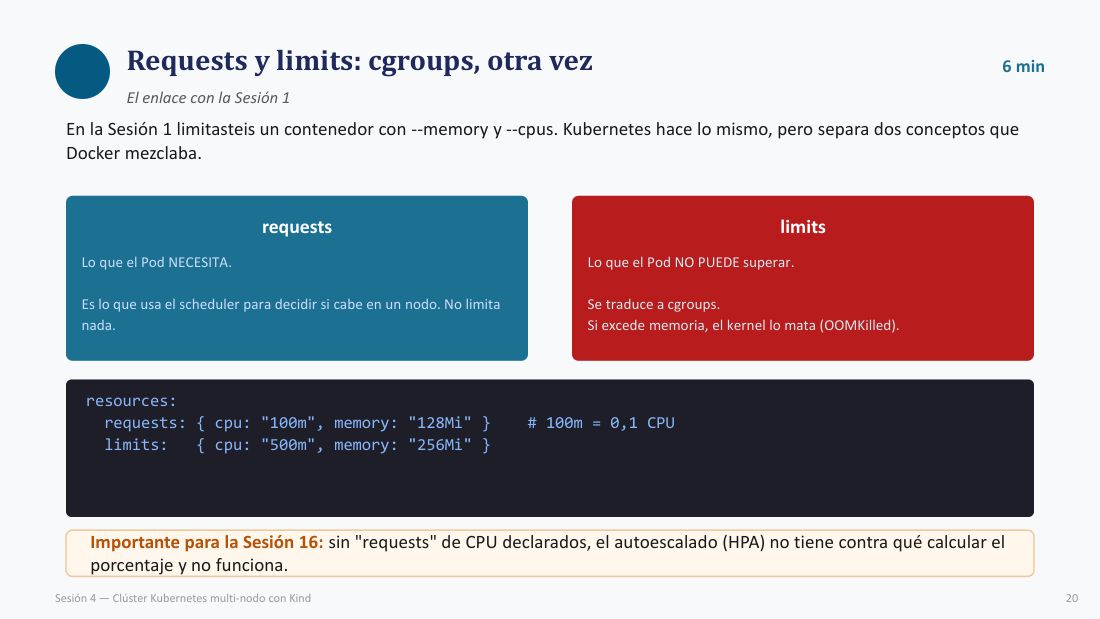
En la Sesión 1 limitasteis un contenedor con --memory y --cpus.
在第 1 讲,你们用 --memory 和 --cpus 限制过一个容器。
Kubernetes hace lo mismo, pero separa dos conceptos que Docker mezclaba.
Kubernetes 做的是同一件事,但把 Docker 混在一起的两个概念拆开了。
Lo que el Pod NECESITA.
Pod「需要」的量。
Es lo que usa el
这是
Lo que el Pod NO PUEDE superar.
Pod「不能超过」的量。
Se traduce a
它会被翻译成
Si excede memoria, el kernel lo mata (OOMKilled).
如果超出内存,内核就把它杀掉(OOMKilled)。
resources · 出处:Sesión 4 · p.22
resources:
  requests: { cpu: "100m", memory: "128Mi" }    # 100m = 0,1 CPU
  limits:   { cpu: "500m", memory: "256Mi" }
| 字段 | 逐行说明 |
|---|---|
| resources: | 容器的资源声明块,requests 与 limits 都写在这里。 |
| requests: | 调度依据:Pod 至少要拿到这么多资源才被放到节点上。 |
| limits: | 运行时上限:超过 CPU 被节流,超过内存被 OOMKilled。 |
| cpu: "100m" / memory: "128Mi" | 100m = 0.1 核;Mi 是 2 的幂单位。 |
Importante para la Sesión 16: sin "requests" de CPU declarados, el
对第 16 讲很重要:没有声明 CPU 的 requests,
Diagnóstico: los estados de un Pod · 诊断:Pod 的各个状态
▸ 原页截图 p.23
Qué significa cada uno y qué mirar
每一个状态的含义,以及该去看什么
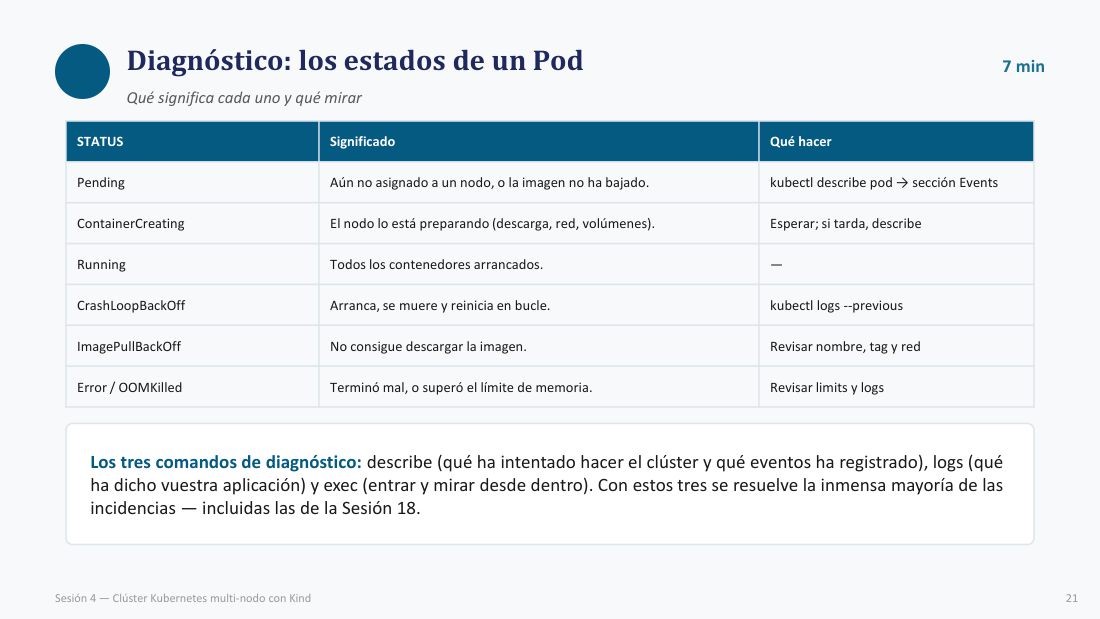
| STATUS | Significado | Qué hacer |
|---|---|---|
| Pending | Aún no asignado a un nodo, o la imagen no ha bajado. | kubectl describe pod → sección Events |
| ContainerCreating | El nodo lo está preparando (descarga, red, volúmenes). | Esperar; si tarda, describe |
| Running | Todos los contenedores arrancados. | — |
| CrashLoopBackOff | Arranca, se muere y reinicia en bucle. | kubectl logs --previous |
| ImagePullBackOff | No consigue descargar la imagen. | Revisar nombre, tag y red |
| Error / OOMKilled | Terminó mal, o superó el límite de memoria. | Revisar limits y logs |
Los tres comandos de diagnóstico: describe (qué ha intentado hacer el clúster y qué eventos ha registrado), logs (qué ha dicho vuestra aplicación) y exec (entrar y mirar desde dentro).
三个诊断命令:describe(集群尝试做了什么、记录了哪些事件)、logs(你们的应用说了什么)、exec(进去从里面看)。
Con estos tres se resuelve la inmensa mayoría de las incidencias — incluidas las de la Sesión 18.
有这三个,绝大多数故障都能解决——包括第 18 讲的那些。
七、小结、作业与延伸:etcd、生产环境与参考
p.24–p.28Síntesis de la sesión · 本课小结
▸ 原页截图 p.24
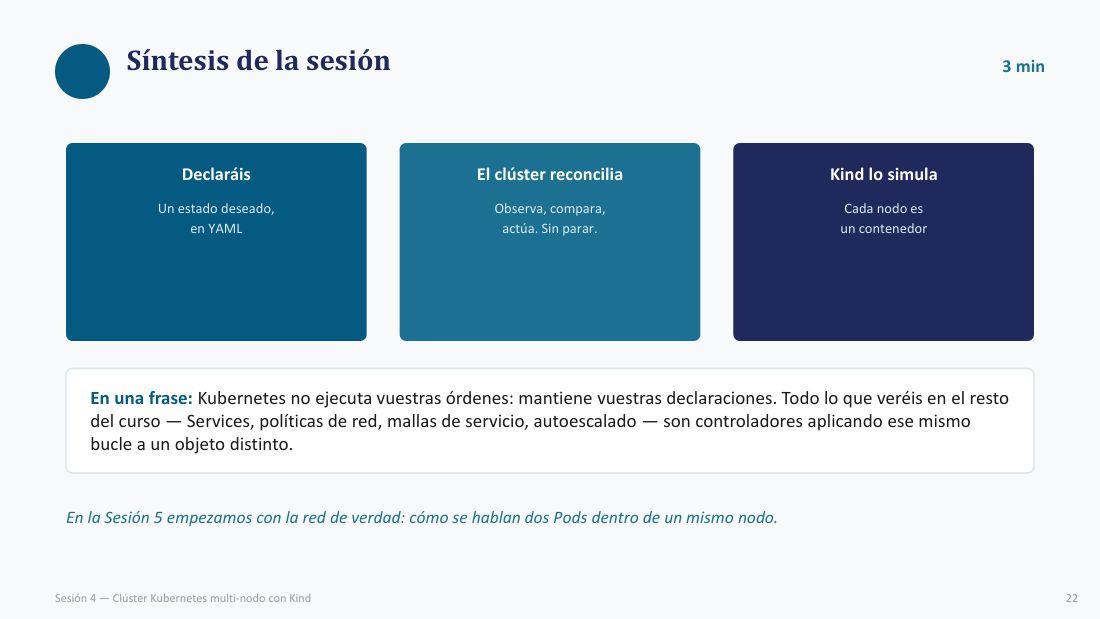
Declaráis — Un estado deseado, en YAML
你们声明——一个期望状态,写在 YAML 里
El clúster
集群做
Kind lo simula — Cada nodo es un contenedor
Kind 把它模拟出来——每个节点就是一个容器
En una frase: Kubernetes no ejecuta vuestras órdenes: mantiene vuestras declaraciones.
一句话:Kubernetes 不执行你们的命令,它维护你们的声明。
Todo lo que veréis en el resto del curso — Services, políticas de red, mallas de servicio, autoescalado — son controladores aplicando ese mismo bucle a un objeto distinto.
课程余下部分你们会看到的一切——Service、网络策略、服务网格、自动扩缩容——都是控制器把同一个循环套用到另一个对象上。
En la Sesión 5 empezamos con la red de verdad: cómo se hablan dos Pods dentro de un mismo nodo.
第 5 讲我们开始讲真正的网络:同一个节点内两个 Pod 如何通信。
Para casa · 课后作业
▸ 原页截图 p.25
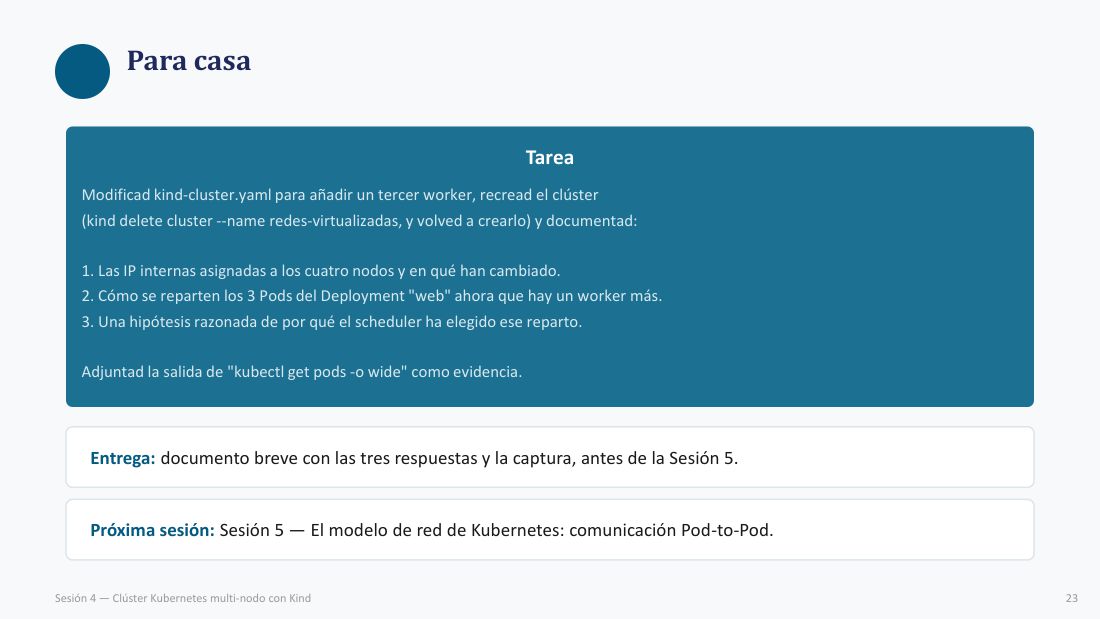
Tarea
作业
Modificad kind-cluster.yaml para añadir un tercer worker, recread el clúster (kind delete cluster --name redes-virtualizadas, y volved a crearlo) y documentad:
修改 kind-cluster.yaml 增加第三个 worker,重建集群(kind delete cluster --name redes-virtualizadas,然后重新创建),并记录:
1. Las IP internas asignadas a los cuatro nodos y en qué han cambiado.
1. 四个节点分配到的内部 IP,以及它们发生了什么变化。
2. Cómo se reparten los 3 Pods del Deployment "web" ahora que hay un worker más.
2. 多了一个 worker 之后,Deployment「web」的 3 个 Pod 如何分布。
3. Una hipótesis razonada de por qué el
3. 对
Adjuntad la salida de "kubectl get pods -o wide" como evidencia.
附上「kubectl get pods -o wide」的输出作为证据。
Entrega: documento breve con las tres respuestas y la captura, antes de la Sesión 5.
提交:一份含三问答案与截图的简短文档,在第 5 讲之前交。
Próxima sesión: Sesión 5 — El modelo de red de Kubernetes: comunicación Pod-to-Pod.
下一讲:第 5 讲——Kubernetes 网络模型:Pod 到 Pod 的通信。
[Opcional] Dónde vive realmente el estado: etcd · 状态到底存在哪里:etcd
▸ 原页截图 p.26
Solo si sobra tiempo — no imprescindible para seguir el bloque
仅当时间有剩余——不是跟上本模块的必需内容
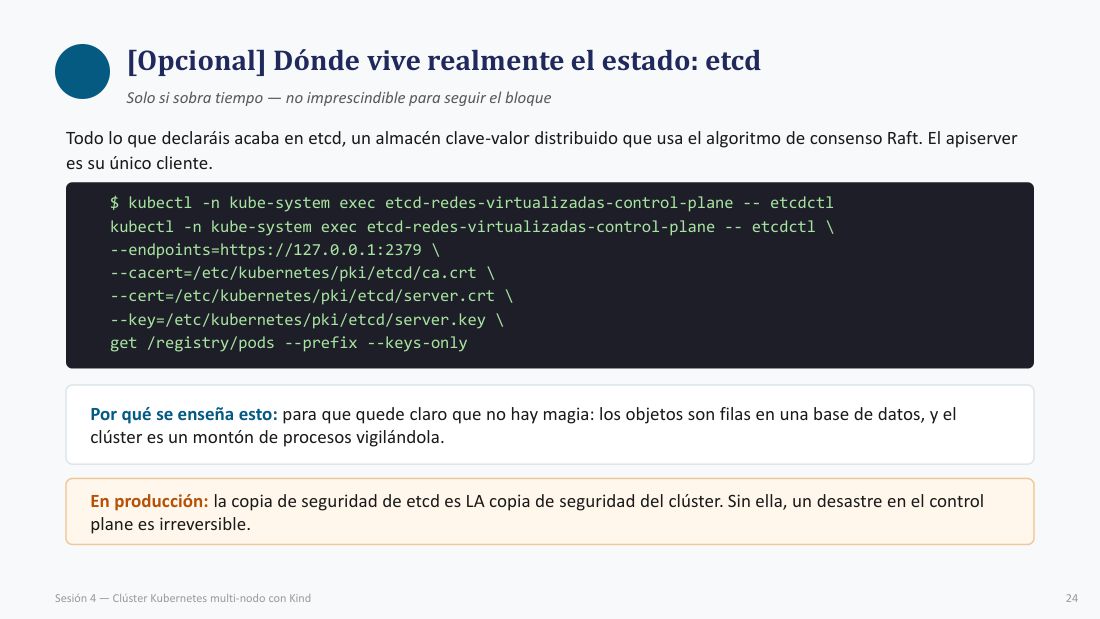
Todo lo que declaráis acaba en
你们声明的一切最终都写进
El
终端 · 出处:Sesión 4 · p.26
$ kubectl -n kube-system exec etcd-redes-virtualizadas-control-plane -- etcdctl
kubectl -n kube-system exec etcd-redes-virtualizadas-control-plane -- etcdctl \
--endpoints=https://127.0.0.1:2379 \
--cacert=/etc/kubernetes/pki/etcd/ca.crt \
--cert=/etc/kubernetes/pki/etcd/server.crt \
--key=/etc/kubernetes/pki/etcd/server.key \
get /registry/pods --prefix --keys-only
| 命令 | 逐行说明 |
|---|---|
| kubectl -n kube-system exec <pod> -- etcdctl | 在 etcd 的 Pod 里执行 etcdctl;-- 之后才是容器内的命令。 |
| --endpoints=https://127.0.0.1:2379 | etcd 在 Pod 内监听的地址,所以在容器里用 localhost。 |
| --cacert / --cert / --key | 双向 TLS 三件套:CA 证书、客户端证书、私钥。 |
| get /registry/pods --prefix --keys-only | 按前缀列键、不返回 value,所以输出很轻。 |
Por qué se enseña esto: para que quede claro que no hay magia: los objetos son filas en una base de datos, y el clúster es un montón de procesos vigilándola.
为什么要讲这个:为了说清楚这里没有魔法——对象就是数据库里的行,而集群不过是一堆进程在盯着这张表。
En producción: la copia de seguridad de etcd es LA copia de seguridad del clúster. Sin ella, un desastre en el control plane es irreversible.
生产环境里:etcd 的备份就是集群的备份。没有它,控制面一旦出事就不可挽回。
[Opcional] Qué cambia en un clúster real · 真实集群有什么不同
▸ 原页截图 p.27
Solo si sobra tiempo — no imprescindible para seguir el bloque
仅当时间有剩余——不是跟上本模块的必需内容
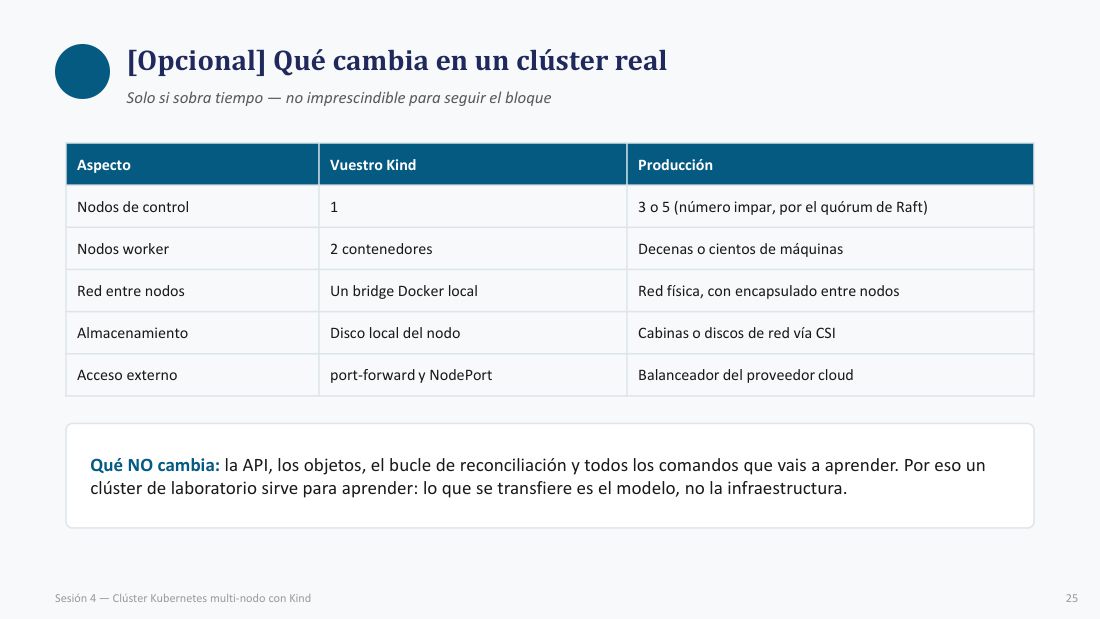
| Aspecto | Vuestro Kind | Producción |
|---|---|---|
| Nodos de control | 1 | 3 o 5 (número impar, por el quórum de Raft) |
| Nodos worker | 2 contenedores | Decenas o cientos de máquinas |
| Red entre nodos | Un bridge Docker local | Red física, con encapsulado entre nodos |
| Almacenamiento | Disco local del nodo | Cabinas o discos de red vía CSI |
| Acceso externo | port-forward y NodePort | Balanceador del proveedor cloud |
Qué NO cambia: la API, los objetos, el bucle de reconciliación y todos los comandos que vais a aprender.
不变的是:API、对象、调和循环,以及你们要学的所有命令。
Por eso un clúster de laboratorio sirve para aprender: lo que se transfiere es el
所以实验集群足以用来学习:被迁移过去的是
Bibliografía y recursos · 参考文献与资源
▸ 原页截图 p.28
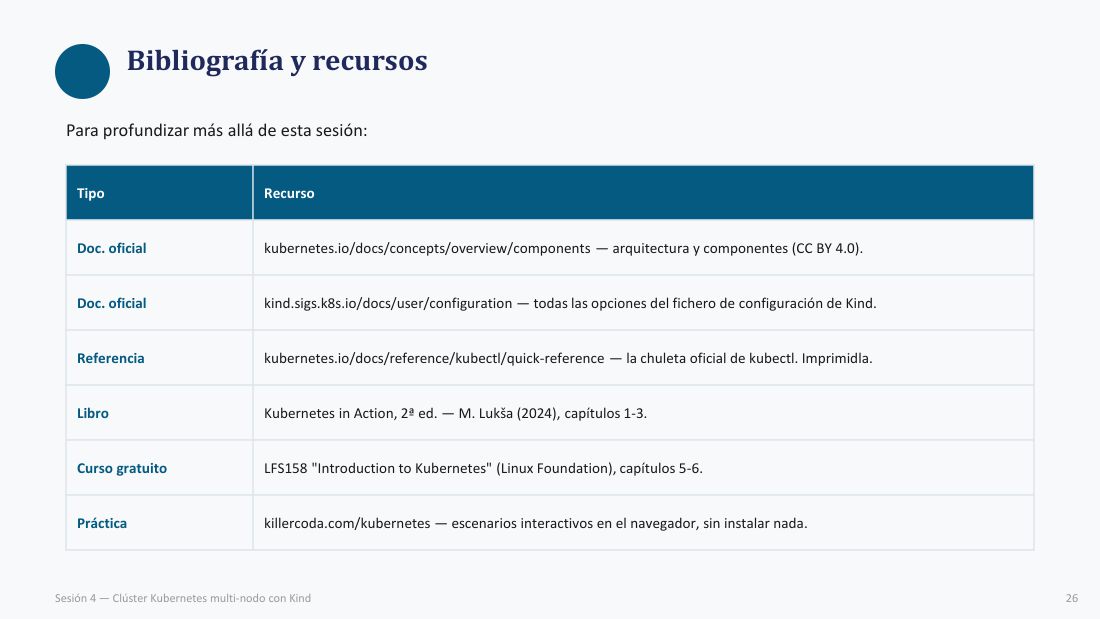
Para profundizar más allá de esta sesión:
想在本讲之外继续深入:
| Tipo | Recurso |
|---|---|
| Doc. oficial | kubernetes.io/docs/concepts/overview/components — arquitectura y componentes (CC BY 4.0). |
| Doc. oficial | kind.sigs.k8s.io/docs/user/configuration — todas las opciones del fichero de configuración de Kind. |
| Referencia | kubernetes.io/docs/reference/kubectl/quick-reference — la chuleta oficial de kubectl. Imprimidla. |
| Libro | Kubernetes in Action, 2ª ed. — M. Lukša (2024), capítulos 1-3. |
| Curso gratuito | LFS158 "Introduction to Kubernetes" (Linux Foundation), capítulos 5-6. |
| Práctica | killercoda.com/kubernetes — escenarios interactivos en el navegador, sin instalar nada. |
专有名词速记表(A–Z)
共 40 条,覆盖全 28 页的高频术语。第三列点页码直接跳回原页;最后一列只写「一句话 + 最容易被扣分的点」。
| 西语术语 | 中文 | 页码 | 一句话记住 · 易错点 |
|---|---|---|---|
| A | |||
| apiserver | apiserver,API 服务器 | p.26 | etcd 的唯一客户端;任何组件都绕不过它。 |
| autocompletado | 自动补全 | p.14 | 别名 k 要配 complete -F __start_kubectl k 才生效。 |
| autoescalado | 自动扩缩容 | p.22 | HPA 按 CPU 百分比扩缩,所以必须先写 requests。 |
| B | |||
| bucle de reconciliación | 调和循环 | p.2 | 观察 → 比较 → 行动,永不停;每个控制器都是它的实例。 |
| C | |||
| cgroups | cgroups,内核资源控制组 | p.22 | limits 最终翻译成 cgroups;超内存就是 OOMKilled。 |
| CNI | CNI,容器网络接口插件 | p.5 | 负责 Pod 之间连通性,属于数据平面。 |
| contextos | 上下文(集群 + 用户的组合) | p.13 | kubeconfig 的三列表之一:context = 哪个 user 对哪个 cluster。 |
| control plane | 控制平面 | p.5 | 做决定:apiserver、etcd、scheduler、controller-manager。 |
| controlador | 控制器 | p.4 | 一个控制器守一种对象,跑同一个调和循环。 |
| D | |||
| declarativamente | 声明式地 | p.21 | apply 可重复执行;create 是一次性的命令式。 |
| Deployment | Deployment,管理 ReplicaSet | p.8 | 它管 ReplicaSet,ReplicaSet 才管 Pod;不要越级。 |
| DNAT | DNAT,目的地址转换 | p.13 | kubeconfig 里 127.0.0.1:高位端口就是 Docker 的 DNAT。 |
| E | |||
| estado deseado | 期望状态 | p.3 | 写在 YAML 里的目标;系统负责让现实向它靠拢。 |
| etcd | etcd,键值存储 | p.5 | 集群唯一数据源;备份 etcd 就是备份整个集群。 |
| F | |||
| filtra | 过滤 | p.20 | 调度的第一阶段:先筛掉「不能」的节点。 |
| H | |||
| HPA | Horizontal Pod Autoscaler,水平自动扩缩 | p.22 | 没有 CPU requests 就没有百分比基准,HPA 直接失效。 |
| I | |||
| Istio | Istio,服务网格 | p.8 | 给 Pod 塞 sidecar 代理;同 Pod 内容器共享 IP 是它的前提。 |
| K | |||
| Kind | Kind(Kubernetes IN Docker,用容器当节点) | p.1 | 每个「节点」就是一个 Docker 容器;重建集群 IP 必变。 |
| kube-apiserver | kube-apiserver,集群唯一入口 | p.5 | kubectl、控制器的所有请求都走它,RBAC 才能一处生效。 |
| kubeconfig | kubeconfig,集群连接配置 | p.13 | ~/.kube/config,含管理员证书:等同密码,禁止进 Git。 |
| kubelet | kubelet,每个节点上的代理 | p.5 | 数据平面代理;静态 Pod 由它直接读文件启动。 |
| L | |||
| limits | limits,上限 | p.22 | 天花板:超内存被内核杀;只限上限不保证调度。 |
| N | |||
| namespaces de Linux | Linux 命名空间(内核隔离) | p.18 | 内核级隔离(PID/NET/MNT),与 Kubernetes 的同名概念无关。 |
| Namespaces de Kubernetes | Kubernetes 命名空间(逻辑分区) | p.18 | 只是 API 里的名字分区;配额、RBAC、NetworkPolicy 的作用域。 |
| O | |||
| OOMKilled | OOMKilled,超出内存被杀 | p.23 | 状态是 Error 的一种;查 limits,不是查网络。 |
| P | |||
| Pod | Pod,最小调度单元 | p.8 | IP 属于 Pod 而不属于容器;同 Pod 内容器用 localhost。 |
| puntúa | 打分 | p.20 | 调度的第二阶段:在能装的节点里挑最好的。 |
| Q | |||
| quórum | 法定多数 | p.27 | Raft 要多数派,所以控制面节点取奇数 3 或 5。 |
| R | |||
| Raft | Raft,共识算法 | p.26 | etcd 靠它复制日志;成员数必须是奇数。 |
| RBAC | RBAC,基于角色的访问控制 | p.5 | 因为所有请求都过 apiserver,权限能在一处统一控制。 |
| reconcilia | 调和(观察-比较-行动) | p.24 | 同 bucle de reconciliación;手动删 Pod 被重建就是它在工作。 |
| red bridge | 网桥网络 | p.16 | Kind 建一个名为 kind 的 bridge;节点间就是第 3 讲那张网。 |
| réplicas | 副本 | p.4 | 「quiero 3 réplicas」是声明,不是三条命令。 |
| ReplicaSet | ReplicaSet,维持副本数 | p.8 | 维持 N 个 Pod 存活;Deployment 通过它做滚动更新。 |
| requests | requests,所需资源 | p.22 | 入场券:决定调度,不设上限;CPU 不写 HPA 就废。 |
| S | |||
| scheduler | 调度器 | p.20 | Filter(能不能)→ Score(哪个更好)两阶段。 |
| static pods | 静态 Pod | p.17 | kubelet 读本地文件直接起,不受调度器管;控制面组件就是这样跑的。 |
| T | |||
| taint | 污点 | p.20 | 节点拒绝 Pod 的标记;control-plane 带 NoSchedule。 |
| toleration | 容忍 | p.20 | Pod 侧的「我接受这个污点」;与 taint 成对出现。 |
| W | |||
| worker node | 工作节点 | p.5 | 跑业务 Pod 的机器;旧文档里叫 minion。 |
编号规则速记卡
口诀:三观察、四层级、四控制、四数据、两筛选、三列表、六状态、三命令——本讲的编号全是「几步、几层、几个组件」,按数量背最省力。
| 编号 | 原文关键词 | 中文 | 性质归类 | 页 |
|---|---|---|---|---|
| 1 | Observar / Comparar / Actuar | 观察真实状态 → 与期望比较 → 纠正差异 | 调和循环三拍(最核心) | p.4 |
| 2 | Contenedor → Pod → ReplicaSet → Deployment | 从下到上:容器 → Pod → 副本集 → 部署 | 对象层级四层 | p.8 |
| 3 | kube-apiserver / etcd / kube-scheduler / kube-controller-manager | 入口、状态库、选节点、跑循环 | 控制平面四组件(决定) | p.5 |
| 4 | kubelet / containerd / kube-proxy / CNI | 节点代理、容器引擎、Service 规则、Pod 连通 | 数据平面四组件(执行) | p.5 |
| 5 | clusters / users / contexts | kubeconfig 三张列表:集群地址、凭据、组合 | 连接配置三列表 | p.13 |
| 6 | Filtrado / Puntuación | 先筛「能不能」,再选「哪个更好」 | 调度两阶段 | p.20 |
| 7 | Pending / ContainerCreating / Running / CrashLoopBackOff / ImagePullBackOff / Error | 待调度 / 准备中 / 运行 / 崩溃重启 / 拉镜像失败 / 异常 | Pod 六状态 | p.23 |
| 8 | describe / logs / exec | 看集群、看应用、进现场 | 诊断三命令 | p.23 |
| 9 | IP internas / reparto de Pods / hipótesis del scheduler | IP 变化、Pod 分布、调度假设 | 作业三问(第 3 问=考试原型) | p.25 |
| 10 | Nodos de control / worker / red / almacenamiento / acceso externo | 控制节点、worker 数量、节点网络、存储、外部入口 | 生产差异五方面 | p.27 |
易混概念对照卡
每一对只问一句:差别落在哪一个词上?考前扫一遍,比背定义快。