- 一页一块:页号胶囊是 PDF 物理页序(1–30);幻灯片上印的页码可能另有编号,以胶囊为准。
- 逐句对照:蓝色左框内是西语原句(逐字照抄,含原文笔误),下面带「中」字标的是中文翻译;项目符号统一用 • 表示。
- 提示框:绿色「考点」= 这页怎么考;红色「陷阱」= 易错点与原文勘误;紫色「记忆钩子」= 口诀;橙色「补充」= 前后页串联。
- 术语悬停:西语句里带浅蓝底的词,鼠标停上去出中文;中文句里带虚下划线的词,停上去出西语原词。
- 公式:一律用本地 MathJax 渲染(断网也能显示),每个公式下附「符号 / 西语读法 / 中文含义」三列小表——口语考试念的就是这一列。
一、三件套:bridge + veth + netfilter
p.1–p.7Portada · 封面:Rendimiento y NAT: el modo Bridge de Docker(性能与 NAT:Bridge 模式)
▸ 原页截图 p.1
3
第 3 讲(封面左侧的大号数字,指课时编号,不是页码)。
BLOQUE II — CONTENEDORES Y ORQUESTACIÓN
第二模块 —— 容器与编排。
Rendimiento y NAT: el modo Bridge de Docker
性能与 NAT:Docker 的 Bridge 模式。
Duración: 2 horas — teoría con tareas cortas intercaladas
时长:2 小时 —— 理论讲授,中间穿插短任务(tarea)。
Objetivos de esta sesión · 本课目标(3 min)
▸ 原页截图 p.2
En la Sesión 2 visteis los modos "none" (sin red) y "host" (la red de la VM, sin aislamiento). Hoy toca el tercero: "
第 2 讲你们看了 "none"(没有网络)和 "host"(直接用虚拟机的网络,没有隔离)两种模式。今天讲第三种:"
• Cómo construye Docker el modo
Docker 是怎么把
• Qué reglas de iptables crea Docker, y qué hace exactamente cada una
Docker 会创建哪些 iptables 规则,每一条到底干什么。
• Diferencia entre publicar un puerto (-p) y salir a Internet (
「发布端口(-p)」和「访问外网(
• Redes
用户自定义
• Medir con
用
Idea que se defiende hoy: el modo
今天要立住的一个观点:
Recordatorio: los tres modos de red · 回顾:三种网络模式(5 min)
▸ 原页截图 p.3
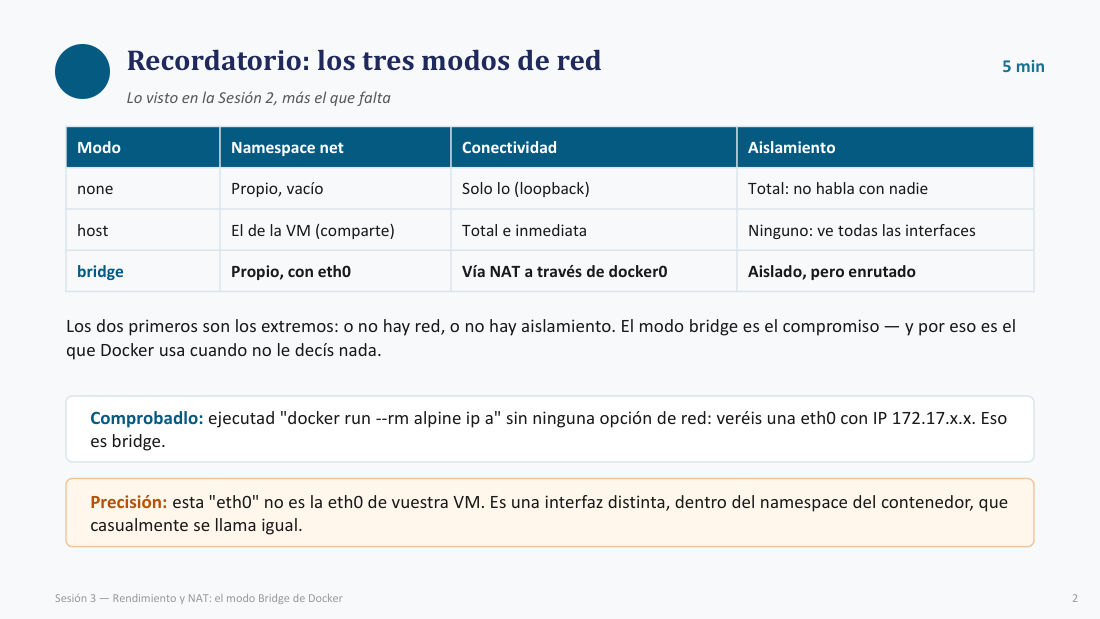
Lo visto en la Sesión 2, más el que falta
第 2 讲看过的内容,再加上还差的那一个。
Modo ·
表头四列:模式 ·
none: Propio, vacío · Solo lo (
none:自己的、空的 namespace;只有
host: El de la VM (comparte) · Total e inmediata · Ninguno: ve todas las interfaces
host:共用虚拟机的 namespace;立刻全通;零隔离 —— 能看到所有网卡。
Los dos primeros son los extremos: o no hay red, o no hay aislamiento. El modo
前两个是两极:要么没网,要么没隔离。
Comprobadlo: ejecutad "docker run --rm alpine ip a" sin ninguna opción de red: veréis una eth0 con IP 172.17.x.x. Eso es
验证一下:不加任何网络选项执行 "docker run --rm alpine ip a",你会看到一块 IP 为 172.17.x.x 的 eth0。这就是
Precisión: esta "eth0" no es la eth0 de vuestra VM. Es una interfaz distinta, dentro del namespace del contenedor, que casualmente se llama igual.
说清楚:这块 "eth0" 不是你虚拟机的 eth0。它是容器 namespace 里的另一块网卡,只是碰巧同名。
Primera pieza: el bridge de Linux · 第一块拼图:Linux bridge(7 min)
▸ 原页截图 p.4(对比图)
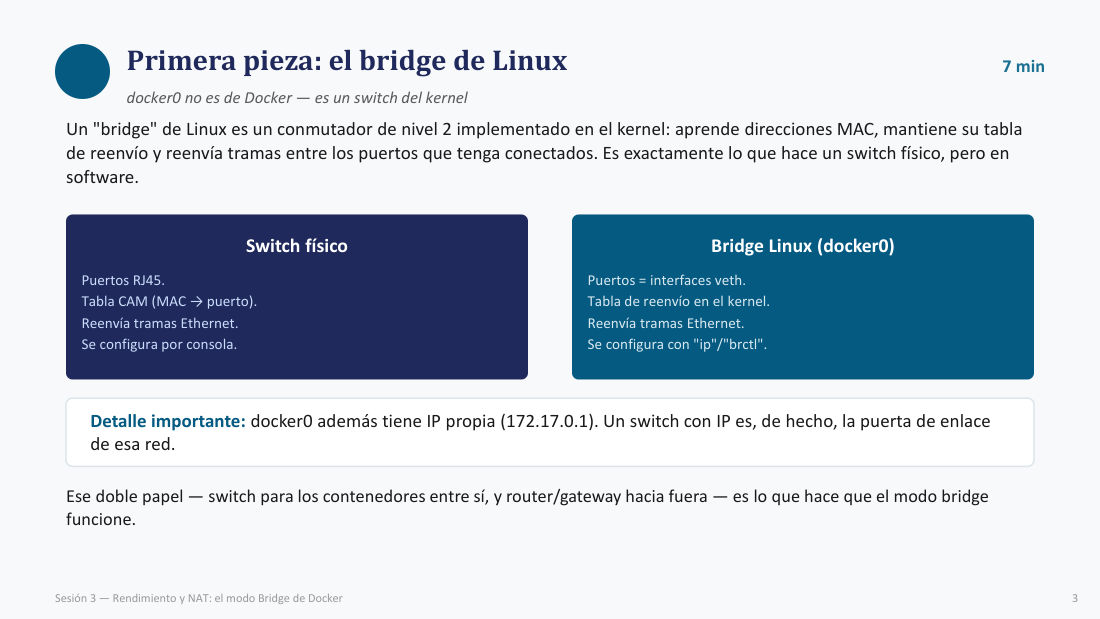
Un "
Linux 的 "
Switch físico: Puertos RJ45. · Tabla CAM (MAC → puerto). · Reenvía tramas
物理交换机:RJ45 端口;CAM 表(MAC → 端口);转发
Bridge Linux (
Linux bridge(
Detalle importante:
关键细节:
Ese doble papel — switch para los contenedores entre sí, y router/
这种双重身份 —— 对容器之间是交换机,对外是路由器/
Segunda pieza: la pareja veth · 第二块拼图:veth 网卡对(7 min)
▸ 原页截图 p.5(veth 配对图)
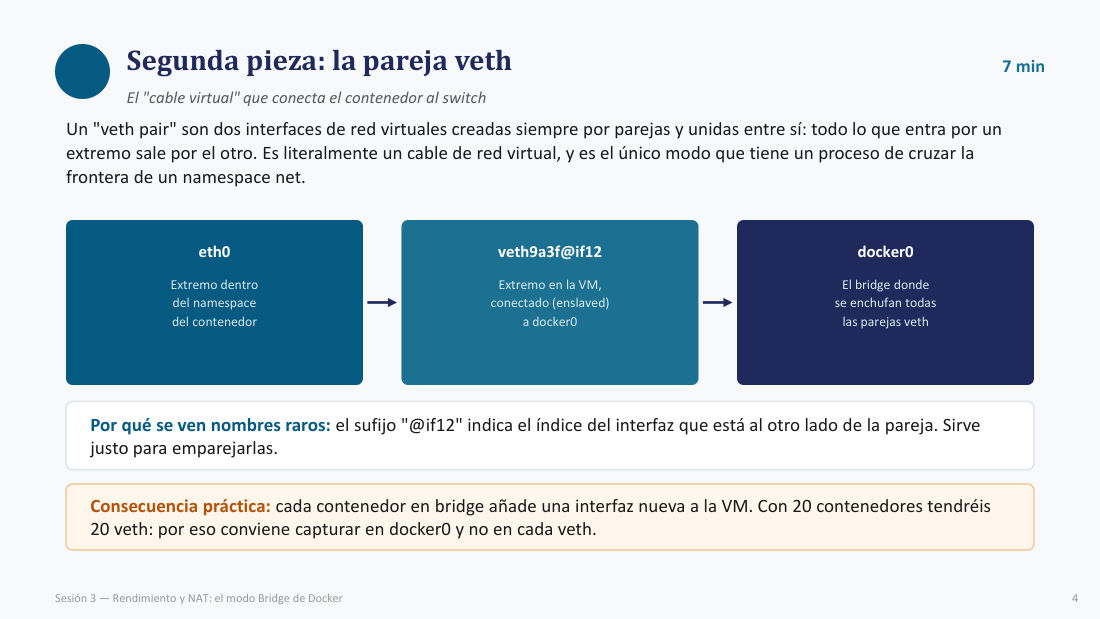
El "cable virtual" que conecta el contenedor al switch
把容器接到交换机上的「虚拟网线」。
Un "
"
eth0 · Extremo dentro del namespace del contenedor
eth0:位于容器 namespace 内部的那一端。
veth9a3f@if12 · Extremo en la VM, conectado (enslaved) a
veth9a3f@if12:位于虚拟机里的那一端,被「收编」(enslaved)进
Por qué se ven nombres raros: el sufijo "@if12" indica el índice del interfaz que está al otro lado de la pareja. Sirve justo para emparejarlas.
名字为什么这么怪:"@if12" 这个后缀指的是网线另一端的接口索引 —— 就是用来配对认亲的。
Consecuencia práctica: cada contenedor en
实际后果:
Anatomía completa del modo bridge · bridge 模式全解剖(8 min)
▸ 原页截图 p.6(全链路示意图)
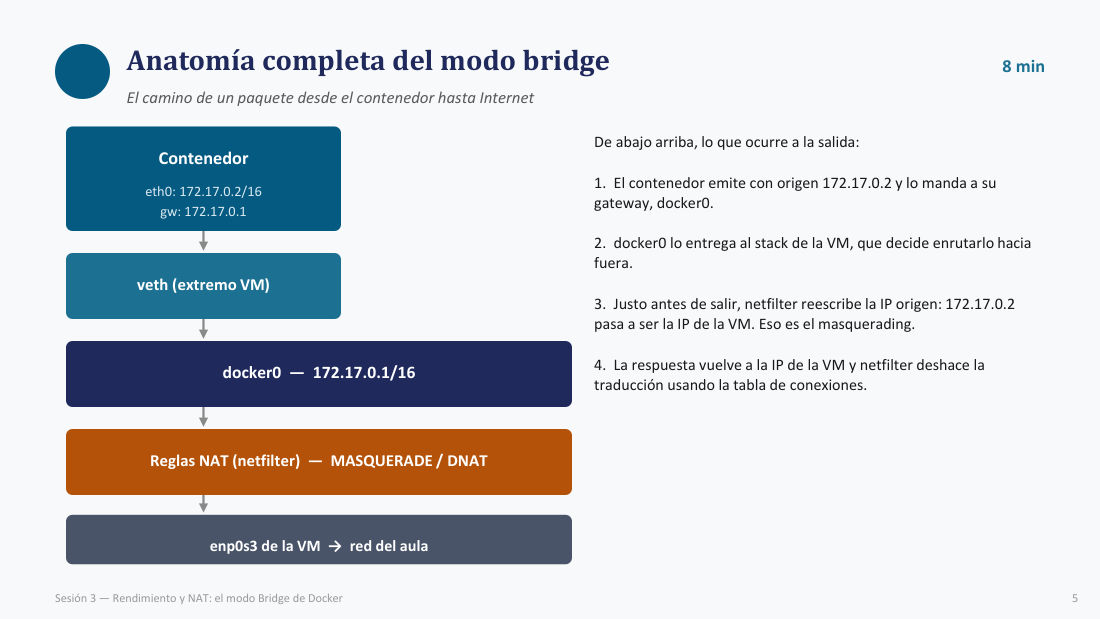
El camino de un paquete desde el contenedor hasta Internet
一个包从容器走到 Internet 的完整路径。
Contenedor · eth0: 172.17.0.2/16 · gw: 172.17.0.1
容器:eth0 为 172.17.0.2/16,网关 gw 为 172.17.0.1。
veth (extremo VM)
veth(留在虚拟机里的那一端)。
Reglas NAT (
NAT 规则(
enp0s3 de la VM → red del aula
虚拟机的 enp0s3 网卡 → 教室网络。
De abajo arriba, lo que ocurre a la salida:
从下往上,出站时依次发生:
1. El contenedor emite con origen 172.17.0.2 y lo manda a su
1. 容器以源地址 172.17.0.2 发包,交给
2.
2.
3. Justo antes de salir,
3. 就在出门之前,
4. La respuesta vuelve a la IP de la VM y
4. 回包发到虚拟机 IP,
Tarea — localizad el bridge y la pareja veth · 任务:找到 bridge 和那条 veth(8 min)
▸ 原页截图 p.7(任务命令)
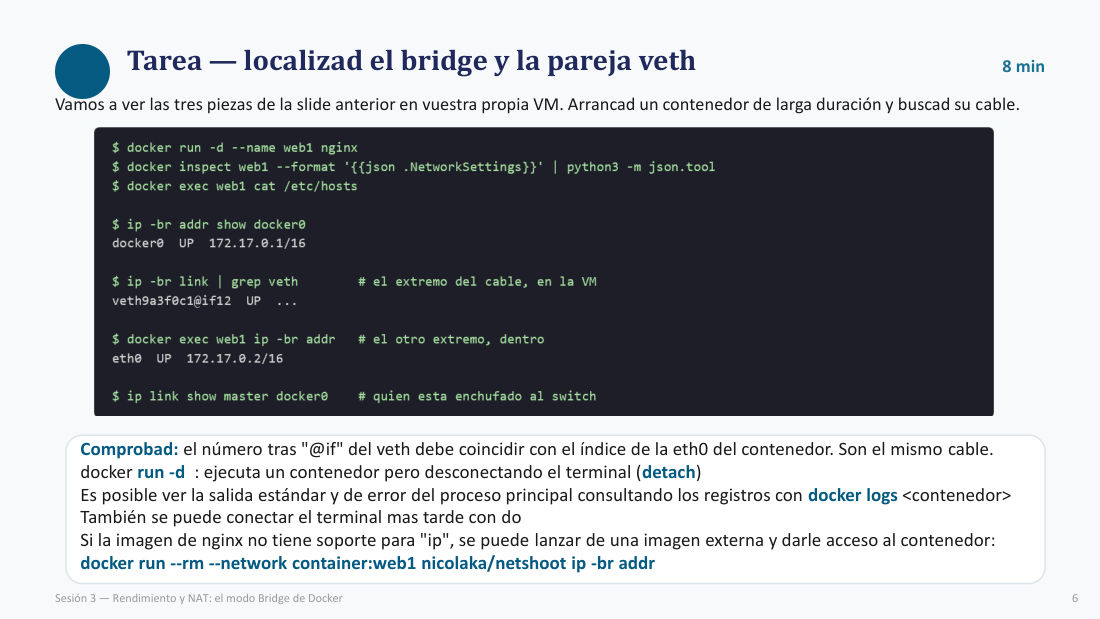
Vamos a ver las tres piezas de la slide anterior en vuestra propia VM. Arrancad un contenedor de larga duración y buscad su cable.
我们把上一页那三块拼图在你们自己的虚拟机里实地看一遍。先启动一个长期运行的容器,然后去找到它那根「网线」。
$ docker run -d --name web1 nginx
$ docker inspect web1 --format '{{json .NetworkSettings}}' | python3 -m json.tool
$ docker exec web1 cat /etc/hosts

$ ip -br addr show docker0
docker0  UP  172.17.0.1/16

$ ip -br link | grep veth        # el extremo del cable, en la VM
veth9a3f0c1@if12  UP  ...

$ docker exec web1 ip -br addr   # el otro extremo, dentro
eth0  UP  172.17.0.2/16

$ ip link show master docker0    # quién está enchufado al switch
Comprobad: el número tras "@if" del veth debe coincidir con el índice de la eth0 del contenedor. Son el mismo cable.
验证:veth 名字里 "@if" 后面的数字,必须等于容器内 eth0 的接口索引 —— 它们是同一根线缆的两头。
• docker run -d : ejecuta un contenedor pero desconectando el terminal (detach)
docker run -d:启动容器但断开终端(detach,后台运行)。
• Es posible ver la salida estándar y de error del proceso principal consultando los registros con docker logs <contenedor>
主进程的标准输出和标准错误可以随时用 docker logs <容器> 查看。
• También se puede conectar el terminal mas tarde con do
也可以稍后再把终端接回去,用 do……(原文此处被截断,见下方陷阱)。
• Si la imagen de nginx no tiene soporte para "ip", se puede lanzar de una imagen externa y darle acceso al contenedor: docker run --rm --network container:web1 nicolaka/netshoot ip -br addr
如果 nginx 镜像里没有 "ip" 命令,可以另起一个外部镜像并共享该容器的网络:docker run --rm --network container:web1 nicolaka/netshoot ip -br addr。
二、地址与 NAT:出站、入站与规则地图
p.8–p.14Direccionamiento: quién reparte las IP · 编址:谁在发 IP(IPAM,6 min)
▸ 原页截图 p.8
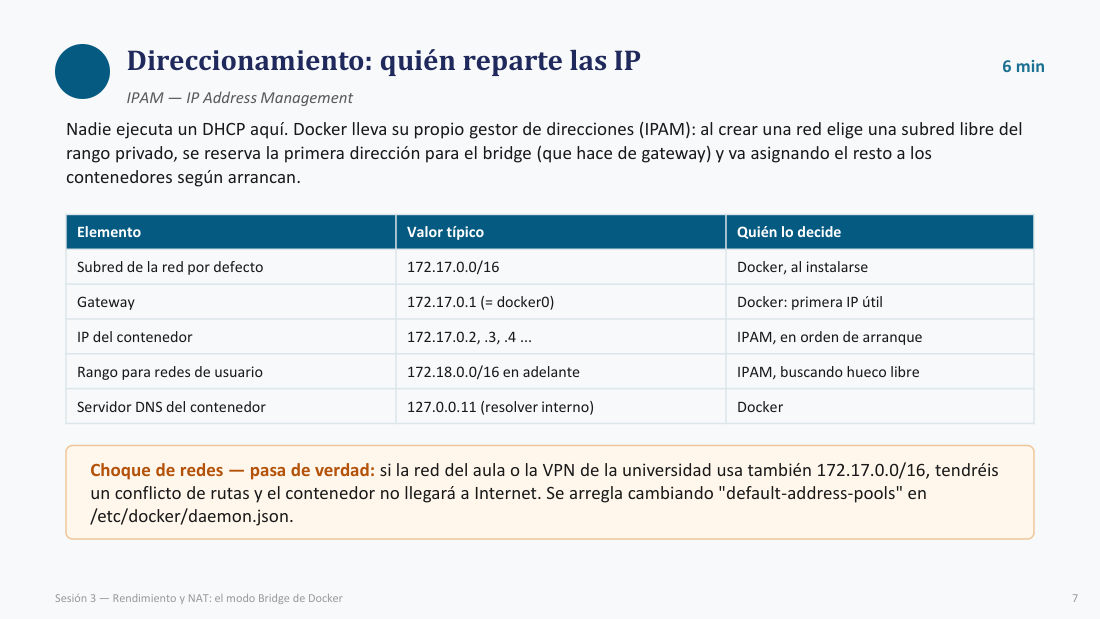
IPAM ——
Nadie ejecuta un
这里没人跑
Elemento · Valor típico · Quién lo decide(表头)
表头三列:要素 · 典型值 · 谁决定。
Subred de la
Gateway: 172.17.0.1 (=
网关:172.17.0.1(即
IP del contenedor: 172.17.0.2, .3, .4 ... ·
容器 IP:172.17.0.2、.3、.4…… ——
Rango para redes de usuario: 172.18.0.0/16 en adelante ·
用户自定义网络的地址段:从 172.18.0.0/16 往后 ——
Servidor DNS del contenedor: 127.0.0.11 (resolver interno) · Docker
容器里的 DNS 服务器:127.0.0.11(Docker 内部解析器)—— 由 Docker 决定。
Choque de redes — pasa de verdad: si la red del aula o la VPN de la universidad usa también 172.17.0.0/16, tendréis un conflicto de rutas y el contenedor no llegará a Internet. Se arregla cambiando "default-address-pools" en /etc/docker/daemon.json.
网络撞段 —— 真的会发生:如果教室网络或学校 VPN 也用 172.17.0.0/16,就会出现路由冲突,容器上不了网。解决办法是改 /etc/docker/daemon.json 里的 "default-address-pools"。
Tarea — inspeccionad el IPAM de la red bridge · 任务:检查 bridge 网络的 IPAM(7 min)
▸ 原页截图 p.9(任务命令)
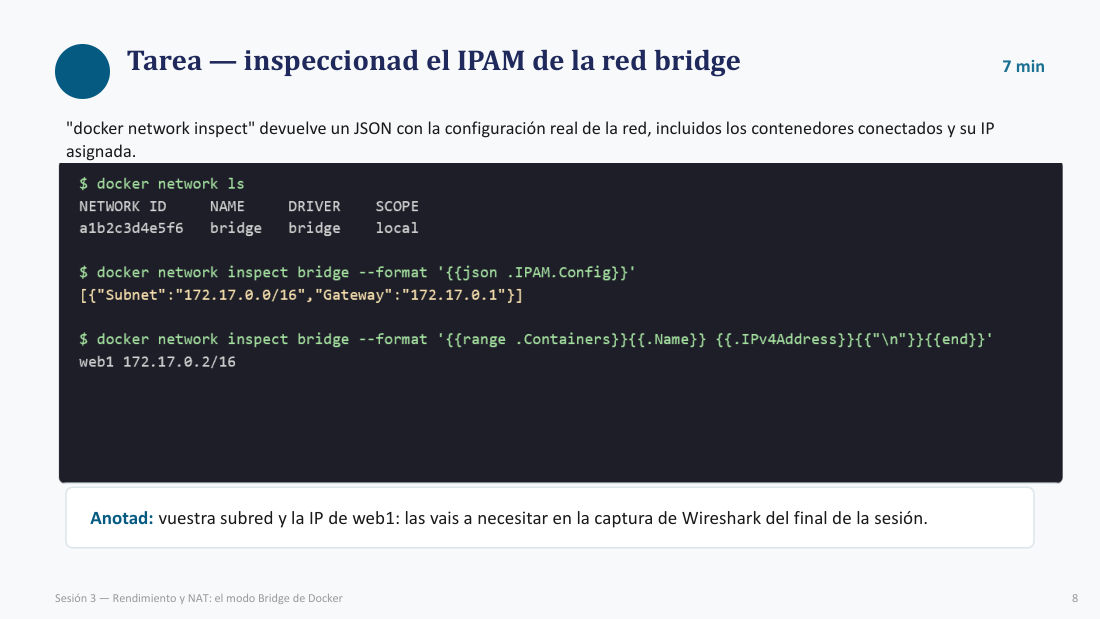
"docker network inspect" devuelve un JSON con la configuración real de la red, incluidos los contenedores conectados y su IP asignada.
"docker network inspect" 返回一段 JSON,里面是该网络的真实配置,包括已连接的容器及其被分配的 IP。
$ docker network ls
NETWORK ID     NAME      DRIVER    SCOPE
a1b2c3d4e5f6   bridge    bridge    local

$ docker network inspect bridge --format '{{json .IPAM.Config}}'
[{"Subnet":"172.17.0.0/16","Gateway":"172.17.0.1"}]

$ docker network inspect bridge --format '{{range .Containers}}{{.Name}} {{.IPv4Address}}{{"\n"}}{{end}}'
web1 172.17.0.2/16
Anotad: vuestra subred y la IP de web1: las vais a necesitar en la captura de
记下来:你们的子网和 web1 的 IP —— 本讲最后用
Salir a Internet: masquerading (SNAT) · 出网:地址伪装(SNAT,8 min)
▸ 原页截图 p.10
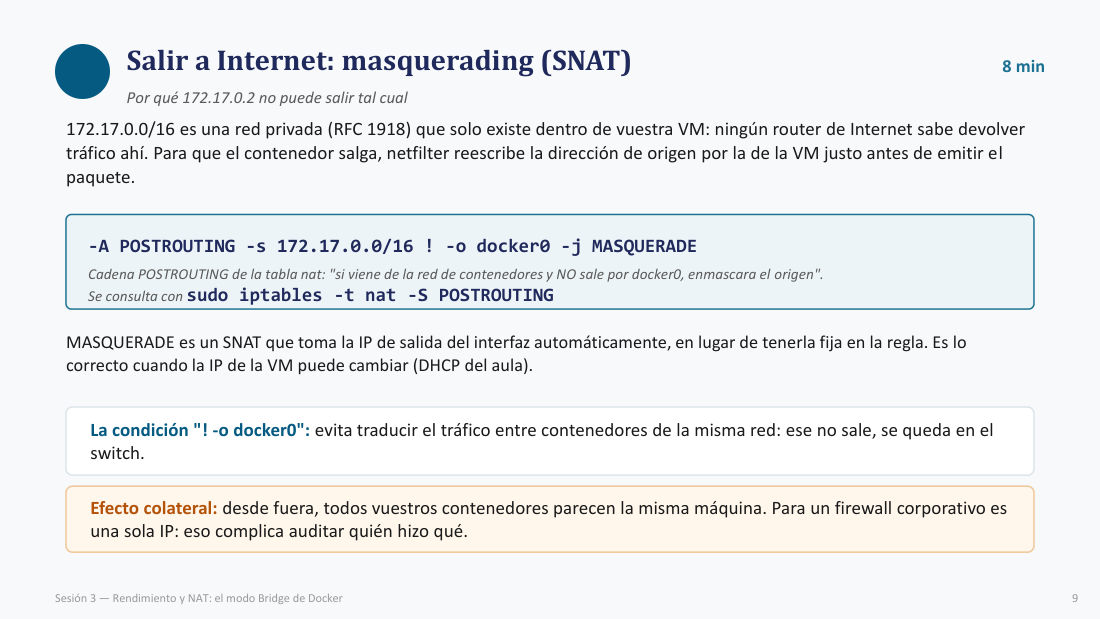
Por qué 172.17.0.2 no puede salir tal cual
为什么 172.17.0.2 不能就这么直接出门。
172.17.0.0/16 es una red privada (
172.17.0.0/16 是私有地址(
-A POSTROUTING -s 172.17.0.0/16 ! -o docker0 -j MASQUERADE
Cadena
nat 表的
Se consulta con sudo iptables -t nat -S
用 sudo iptables -t nat -S
La condición "! -o
条件 "! -o
Efecto colateral: desde fuera, todos vuestros contenedores parecen la misma máquina. Para un firewall corporativo es una sola IP: eso complica auditar quién hizo qué.
副作用:从外面看,你所有容器都像同一台机器。对企业防火墙而言只有一个 IP —— 这让审计「谁做了什么」变难。
Entrar desde fuera: publicar puertos (DNAT) · 从外部进来:发布端口(DNAT,8 min)
▸ 原页截图 p.11
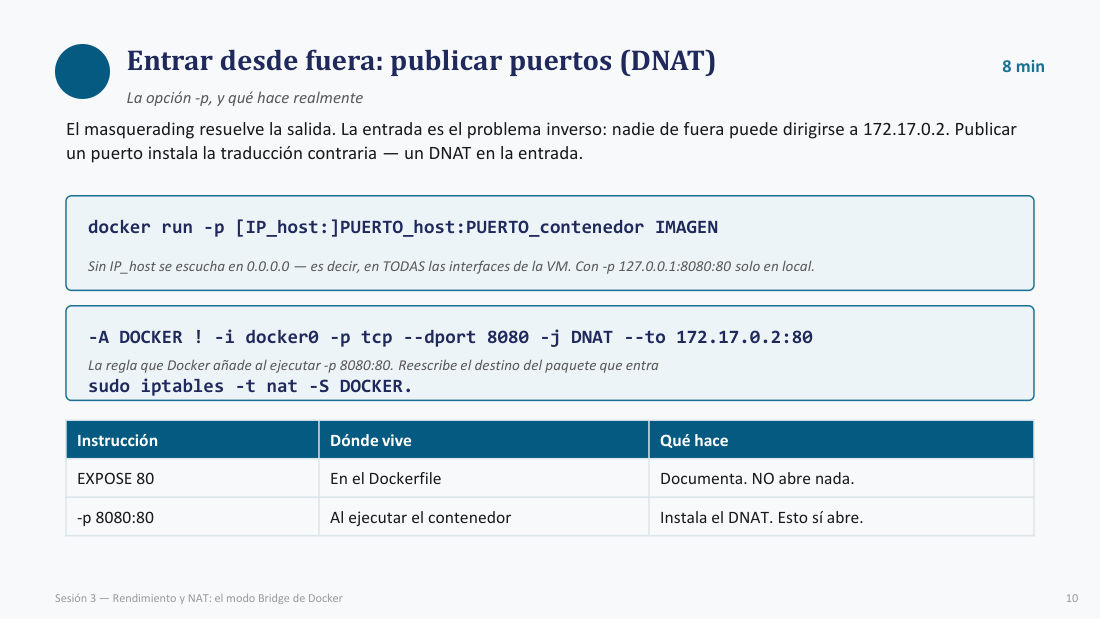
La opción -p, y qué hace realmente
-p 选项,以及它到底干了什么。
El masquerading resuelve la salida. La entrada es el problema inverso: nadie de fuera puede dirigirse a 172.17.0.2. Publicar un puerto instala la traducción contraria — un
masquerading 解决了出站。入站是反过来的问题:外面没人能直接寻址 172.17.0.2。发布端口就是装上反向翻译 —— 一个入站的
docker run -p [IP_host:]PUERTO_host:PUERTO_contenedor IMAGEN
Sin IP_host se escucha en 0.0.0.0 — es decir, en TODAS las interfaces de la VM. Con -p 127.0.0.1:8080:80 solo en local.
不写 IP_host 就监听 0.0.0.0 —— 也就是虚拟机的所有网卡。写成 -p 127.0.0.1:8080:80 就只监听本机。
-A DOCKER ! -i docker0 -p tcp --dport 8080 -j DNAT --to 172.17.0.2:80
La regla que Docker añade al ejecutar -p 8080:80. Reescribe el destino del paquete que entra
这就是执行 -p 8080:80 时 Docker 添加的规则:改写进入报文的目的地址。
sudo iptables -t nat -S DOCKER.
用 sudo iptables -t nat -S DOCKER 查看这些规则。
Instrucción · Dónde vive · Qué hace(表头)
表头三列:指令 · 写在哪里 · 起什么作用。
EXPOSE 80: En el Dockerfile · Documenta. NO abre nada.
EXPOSE 80:写在 Dockerfile 里 —— 只是文档说明,什么也不打开。
-p 8080:80: Al ejecutar el contenedor · Instala el
-p 8080:80:运行时给出 —— 会安装
El mapa de reglas que instala Docker · Docker 装的规则地图(7 min)
▸ 原页截图 p.12
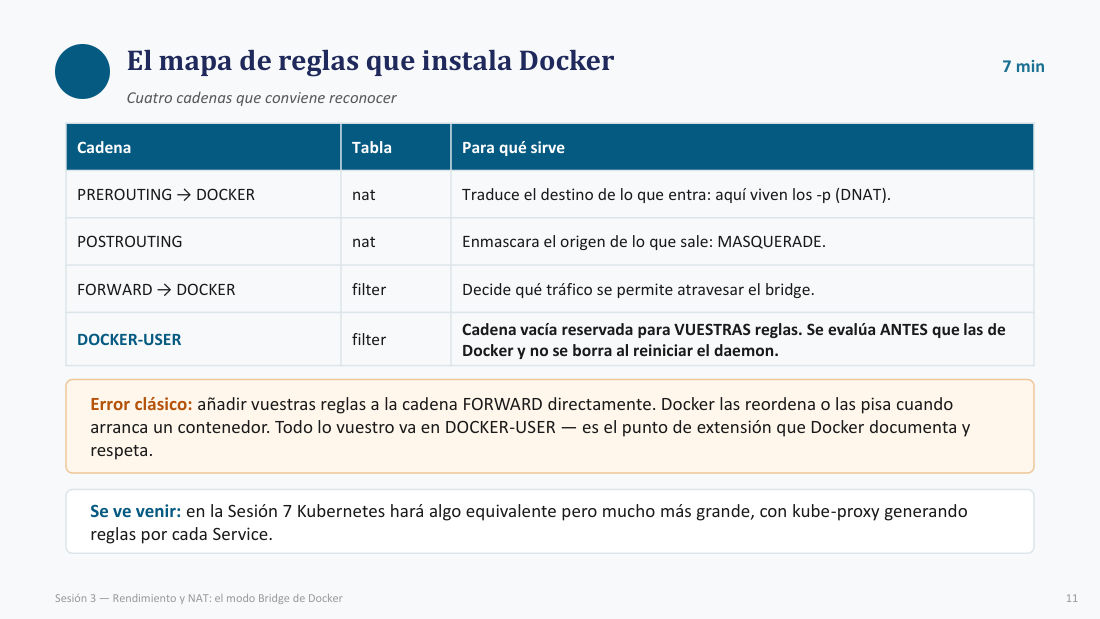
Cuatro cadenas que conviene reconocer
四条值得认出来的链。
Cadena · Tabla · Para qué sirve(表头)
表头三列:链 · 表 · 用途。
DOCKER-USER · filter · Cadena vacía reservada para VUESTRAS reglas. Se evalúa ANTES que las de Docker y no se borra al reiniciar el daemon.
DOCKER-USER|filter|一条空链,专门留给你们写自己的规则。它在 Docker 自己的规则之前被求值,而且重启 daemon 时不会被清掉。
Error clásico: añadir vuestras reglas a la cadena
经典错误:把自定义规则直接加进
Se ve venir: en la Sesión 7 Kubernetes hará algo equivalente pero mucho más grande, con kube-proxy generando reglas por cada Service.
可以预见:第 7 讲 Kubernetes 会做同样的事,只是规模大得多 —— kube-proxy 会为每个 Service 生成规则。
Tarea — leed las reglas NAT reales de vuestra VM · 任务:读你虚拟机里真实的 NAT 规则(10 min)
▸ 原页截图 p.13(任务命令)
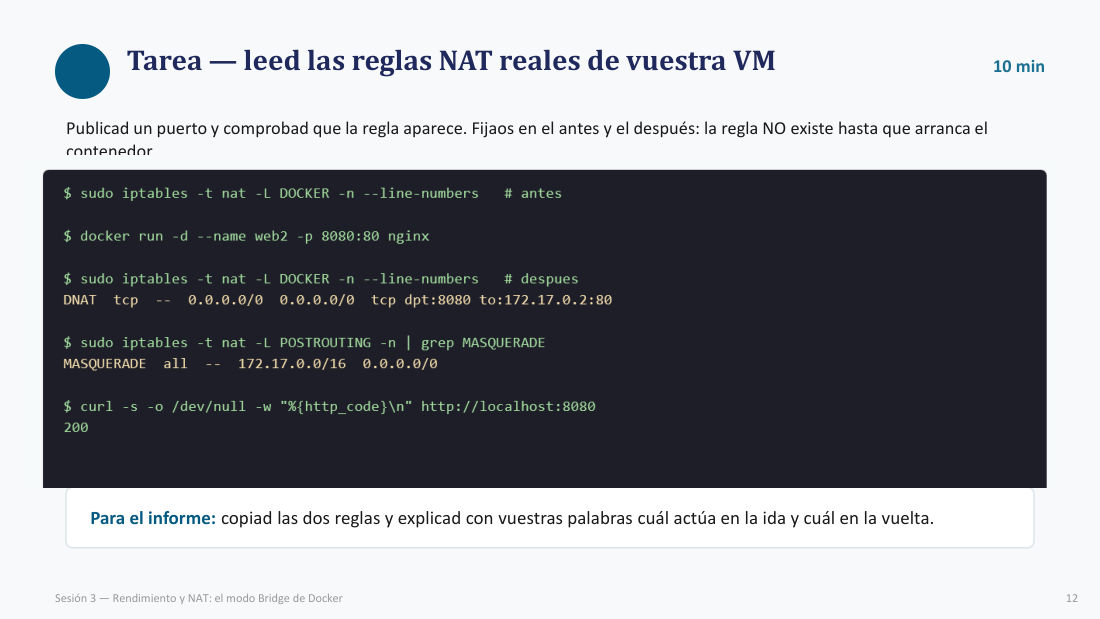
Publicad un puerto y comprobad que la regla aparece. Fijaos en el antes y el después: la regla NO existe hasta que arranca el contenedor.
发布一个端口,确认规则出现了。注意「之前」和「之后」:容器启动前,这条规则根本不存在。
$ sudo iptables -t nat -L DOCKER -n --line-numbers    # antes

$ docker run -d --name web2 -p 8080:80 nginx

$ sudo iptables -t nat -L DOCKER -n --line-numbers    # despues
DNAT  tcp  --  0.0.0.0/0  0.0.0.0/0  tcp dpt:8080 to:172.17.0.2:80

$ sudo iptables -t nat -L POSTROUTING -n | grep MASQUERADE
MASQUERADE  all  --  172.17.0.0/16  0.0.0.0/0

$ curl -s -o /dev/null -w "%{http_code}\n" http://localhost:8080
200
Para el informe: copiad las dos reglas y explicad con vuestras palabras cuál actúa en la ida y cuál en la vuelta.
给实验报告:把这两条规则抄下来,并用自己的话解释哪条管「去程」、哪条管「回程」。
El detalle que casi nadie mira: docker-proxy · 几乎没人看的细节:docker-proxy(6 min)
▸ 原页截图 p.14
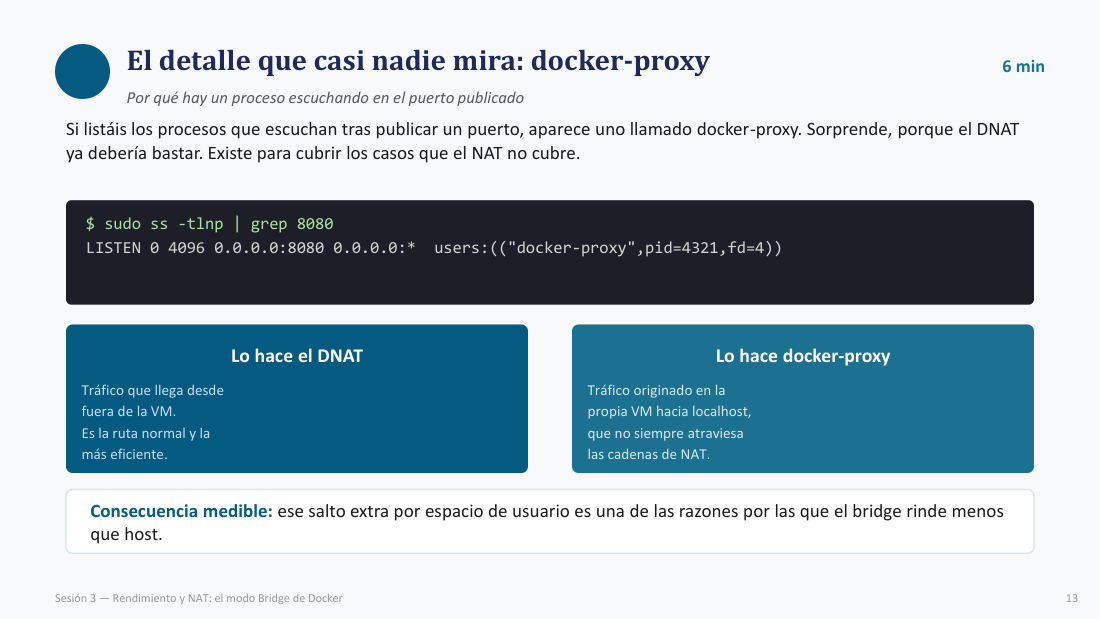
Por qué hay un proceso escuchando en el
为什么已发布的端口上会有一个进程在监听。
Si listáis los procesos que escuchan tras publicar un puerto, aparece uno llamado
发布端口后如果你列出正在监听的进程,会看到一个叫
$ sudo ss -tlnp | grep 8080
LISTEN 0 4096 0.0.0.0:8080 0.0.0.0:*  users:(("docker-proxy",pid=4321,fd=4))
Lo hace el
Lo hace
Consecuencia medible: ese salto extra por espacio de usuario es una de las razones por las que el
可测量的后果:这次绕到用户态的多余一跳,正是
三、用户网络与性能实测
p.15–p.22Redes bridge de usuario · 用户自定义 bridge 网络(7 min)
▸ 原页截图 p.15(双栏对比)
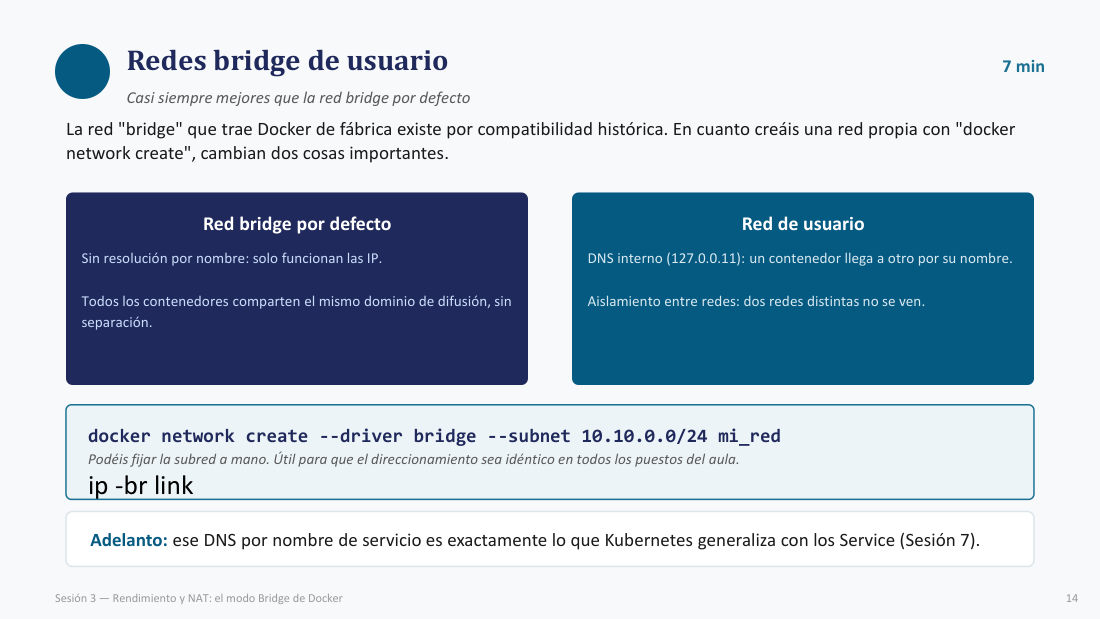
Casi siempre mejores que la red
几乎总是比默认
La red "
Docker 出厂自带的那张 "
Red
默认
Red
默认
Red de usuario · DNS interno (127.0.0.11): un contenedor llega a otro por su nombre.
用户网络:有内部 DNS(127.0.0.11)—— 一个容器可以用名字访问另一个。
Red de usuario · Aislamiento entre redes: dos redes distintas no se ven.
用户网络:网络之间相互隔离 —— 两张不同网络互相看不见。
docker network create --driver bridge --subnet 10.10.0.0/24 mi_red
Podéis fijar la subred a mano. Útil para que el direccionamiento sea idéntico en todos los puestos del aula.
子网可以手动指定。好处是教室里每台机器的地址规划都一模一样。
ip -br link
Adelanto: ese DNS por nombre de servicio es exactamente lo que Kubernetes generaliza con los Service (Sesión 7).
预告:这种「按服务名解析」的 DNS,正是 Kubernetes 用 Service 推广开来的东西(第 7 讲)。
Tarea — red de usuario y DNS interno · 任务:用户网络与内部 DNS(10 min)
▸ 原页截图 p.16(任务命令)
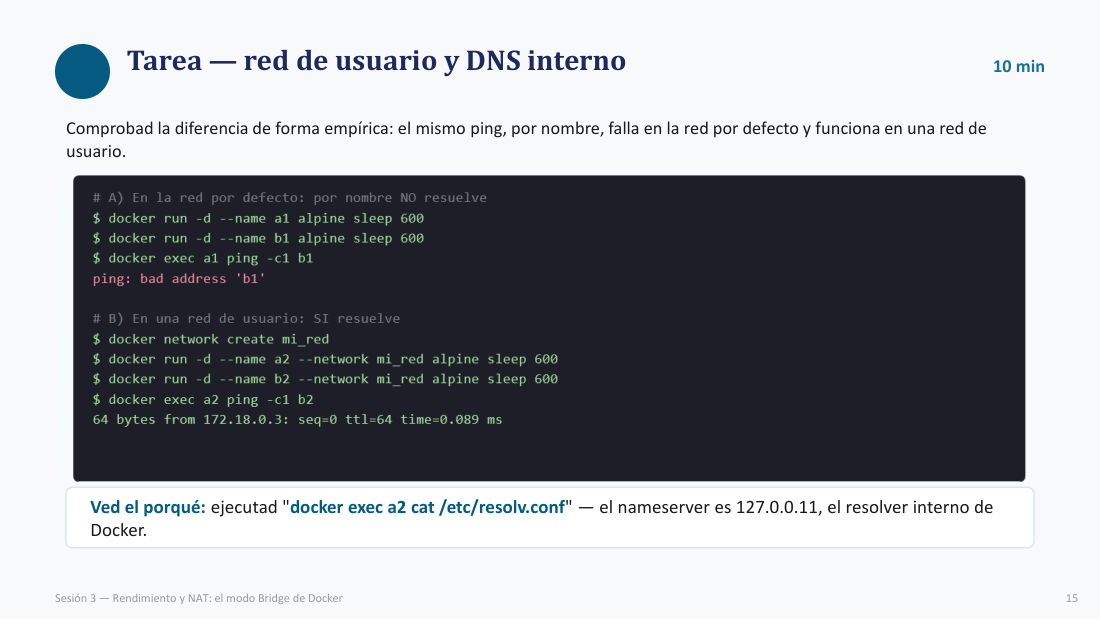
Comprobad la diferencia de forma empírica: el mismo ping, por nombre, falla en la
用实验验证差别:同样的 ping、同样用名字,在
# A) En la red por defecto: por nombre NO resuelve
$ docker run -d --name a1 alpine sleep 600
$ docker run -d --name b1 alpine sleep 600
$ docker exec a1 ping -c1 b1
ping: bad address 'b1'

# B) En una red de usuario: SÍ resuelve
$ docker network create mi_red
$ docker run -d --name a2 --network mi_red alpine sleep 600
$ docker run -d --name b2 --network mi_red alpine sleep 600
$ docker exec a2 ping -c1 b2
64 bytes from 172.18.0.3: seq=0 ttl=64 time=0.089 ms
Ved el porqué: ejecutad "docker exec a2 cat /etc/resolv.conf" — el nameserver es 127.0.0.11, el resolver interno de Docker.
看原因:执行 "docker exec a2 cat /etc/resolv.conf" —— nameserver 是 127.0.0.11,也就是 Docker 的内部解析器。
¿Qué cuesta todo esto? · 这一切的代价是什么(7 min)
▸ 原页截图 p.17
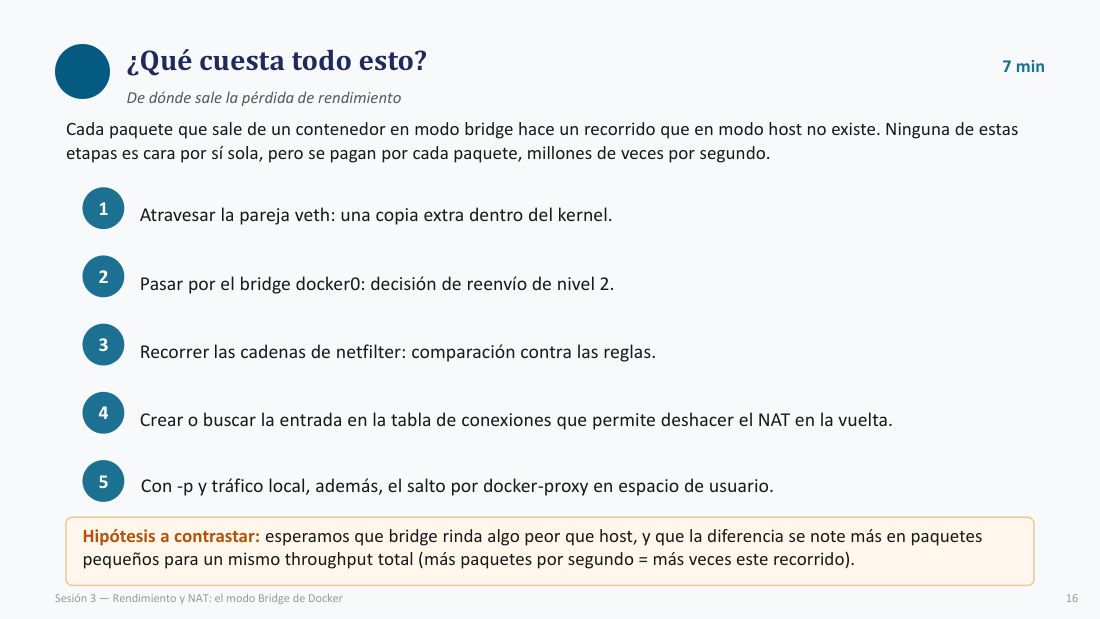
De dónde sale la
性能损失从哪儿来。
Cada paquete que sale de un contenedor en modo
1 Atravesar la pareja veth: una copia extra dentro del kernel.
1. 穿过 veth 对:内核里多一次拷贝。
2 Pasar por el
2. 经过
3 Recorrer las cadenas de
3. 走一遍
4 Crear o buscar la entrada en la
4. 在
5 Con -p y tráfico local, además, el salto por
5. 用了 -p 且是本机流量时,还要额外绕一次用户态的
Hipótesis a contrastar: esperamos que
待检验的假设:
Qué vamos a medir exactamente · 到底测什么(6 min)
▸ 原页截图 p.18
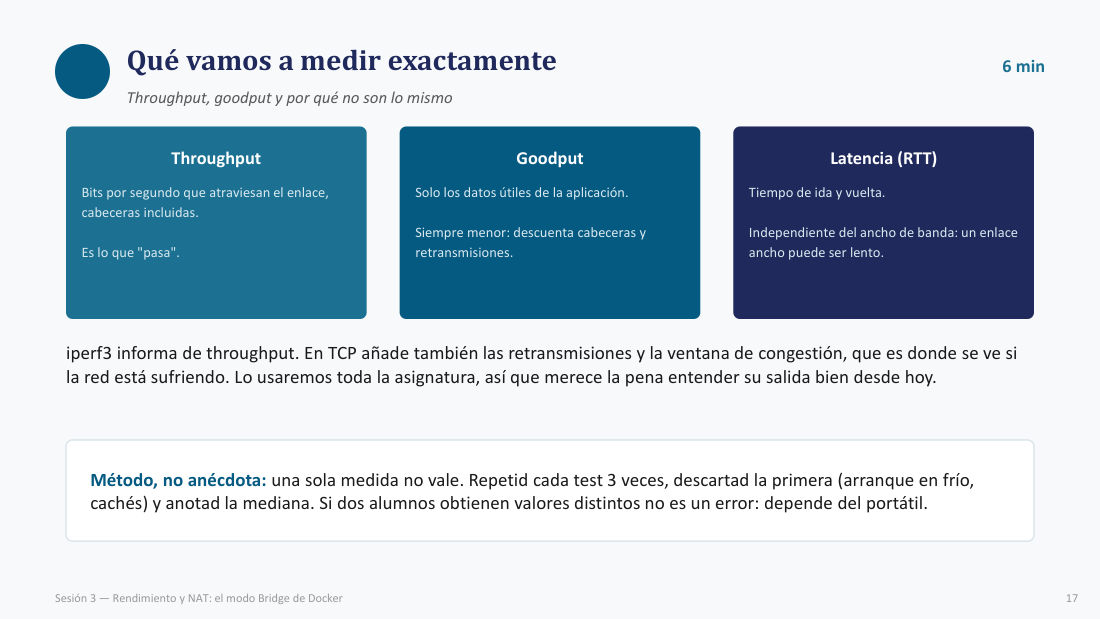
Throughput,
吞吐量、
Throughput: Bits por segundo que atraviesan el
Throughput:每秒通过
Goodput: Solo los datos útiles de la aplicación. Siempre menor: descuenta cabeceras y retransmisiones.
Goodput:只算应用层的有效数据。永远更小 —— 要扣掉头部和重传。
Latencia (
时延(
Método, no anécdota: una sola medida no vale. Repetid cada test 3 veces, descartad la primera (arranque en frío, cachés) y anotad la
要方法,不要轶事:单次测量不算数。每个测试重复 3 次,丢掉第一次(冷启动、缓存),记录
iperf3: cómo se usa · iperf3 怎么用(5 min)
▸ 原页截图 p.19(命令与选项表)
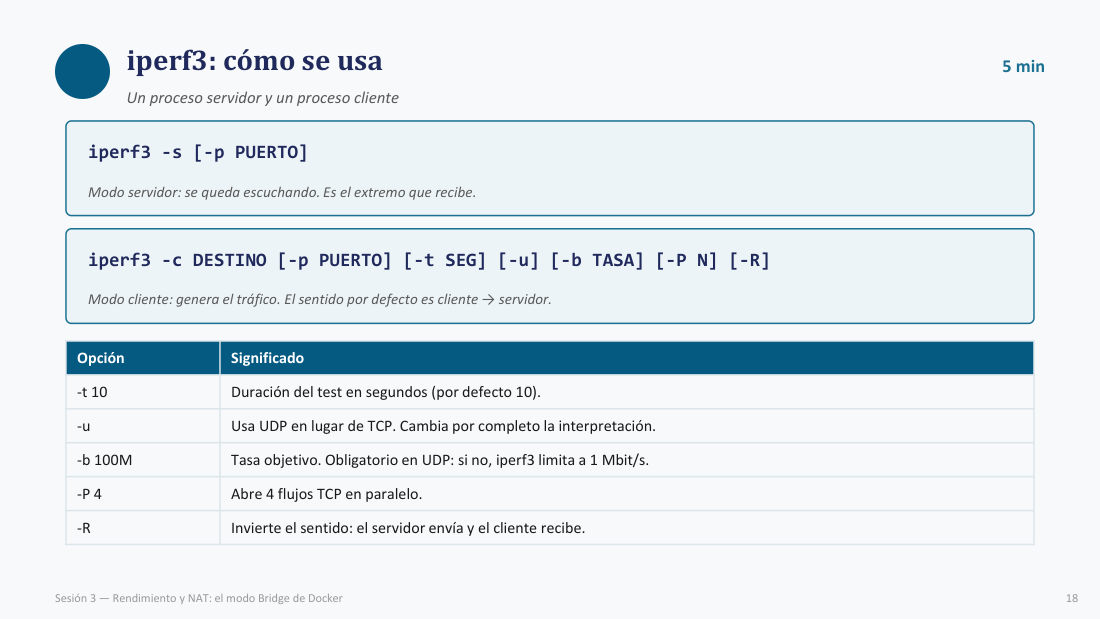
Un proceso servidor y un proceso
一个服务端进程 + 一个
Modo servidor: se queda escuchando. Es el extremo que recibe.
服务端模式:蹲在那儿监听,是接收数据的那一端。
Modo
# 服务端:监听 5201(默认端口)
iperf3 -s [-p PUERTO]

# 客户端:向目标打流,默认 10 秒、TCP、客户端 → 服务端
iperf3 -c DESTINO [-p PUERTO] [-t SEG] [-u] [-b TASA] [-P N] [-R]
| Opción | Significado · 含义 |
|---|---|
| -t 10 | Duración del test en segundos (por defecto 10). · 测试时长(秒),默认 10。 |
| -u | Usa UDP en lugar de TCP. Cambia por completo la interpretación. · 改用 UDP,读数方式完全变了。 |
| -b 100M | Tasa objetivo. Obligatorio en UDP: si no, iperf3 limita a 1 Mbit/s. · 目标速率。UDP 必填,否则只发 1 Mbit/s。 |
| -P 4 | Abre 4 flujos TCP en paralelo. · 并行开 4 条 TCP 流。 |
| -R | Invierte el sentido: el servidor envía y el cliente recibe. · 反向:服务端发、客户端收。 |
Tarea — línea base — iperf3 en modo host · 任务:host 模式基线(10 min)
▸ 原页截图 p.20(基线命令与输出)
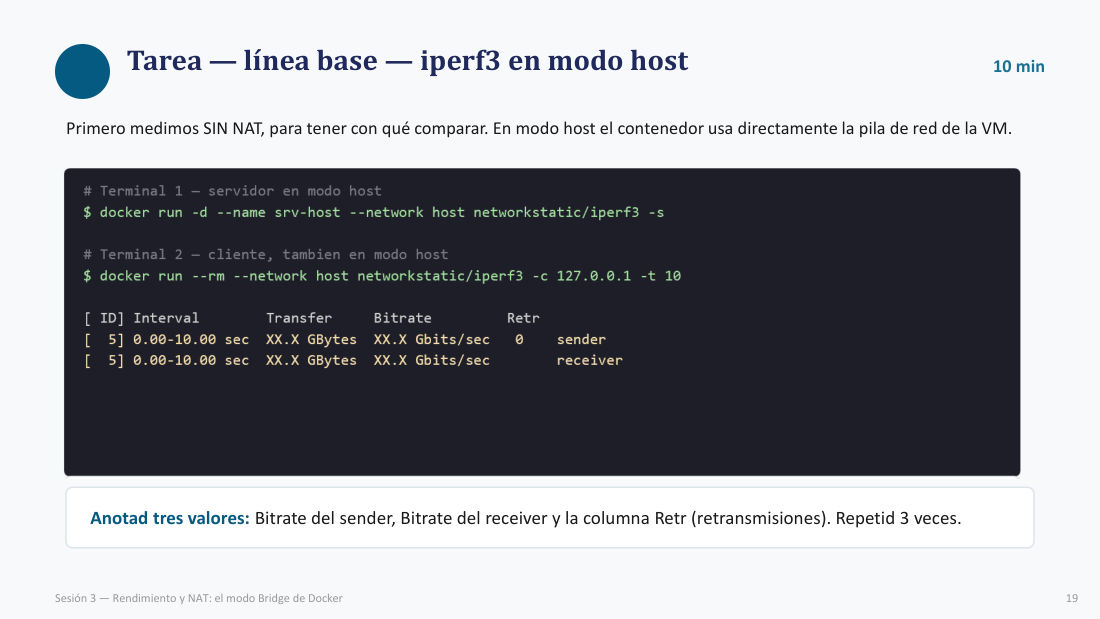
Primero medimos SIN NAT, para tener con qué comparar. En modo host el contenedor usa directamente la pila de red de la VM.
先测没有 NAT 的情况,好有个比较对象。host 模式下,容器直接用虚拟机的网络协议栈。
# 终端 1 — host 模式的服务端
$ docker run -d --name srv-host --network host networkstatic/iperf3 -s

# 终端 2 — 客户端,同样是 host 模式
$ docker run --rm --network host networkstatic/iperf3 -c 127.0.0.1 -t 10

[ ID] Interval           Transfer     Bitrate         Retr
[  5] 0.00-10.00 sec  XX.X GBytes  XX.X Gbits/sec  0     sender
[  5] 0.00-10.00 sec  XX.X GBytes  XX.X Gbits/sec        receiver
Anotad tres valores: Bitrate del sender, Bitrate del receiver y la columna
记下三个值:发送端 Bitrate、接收端 Bitrate,以及
Tarea — ahora con NAT — iperf3 en modo bridge · 任务:加上 NAT 再测(12 min)
▸ 原页截图 p.21(三组对比命令)
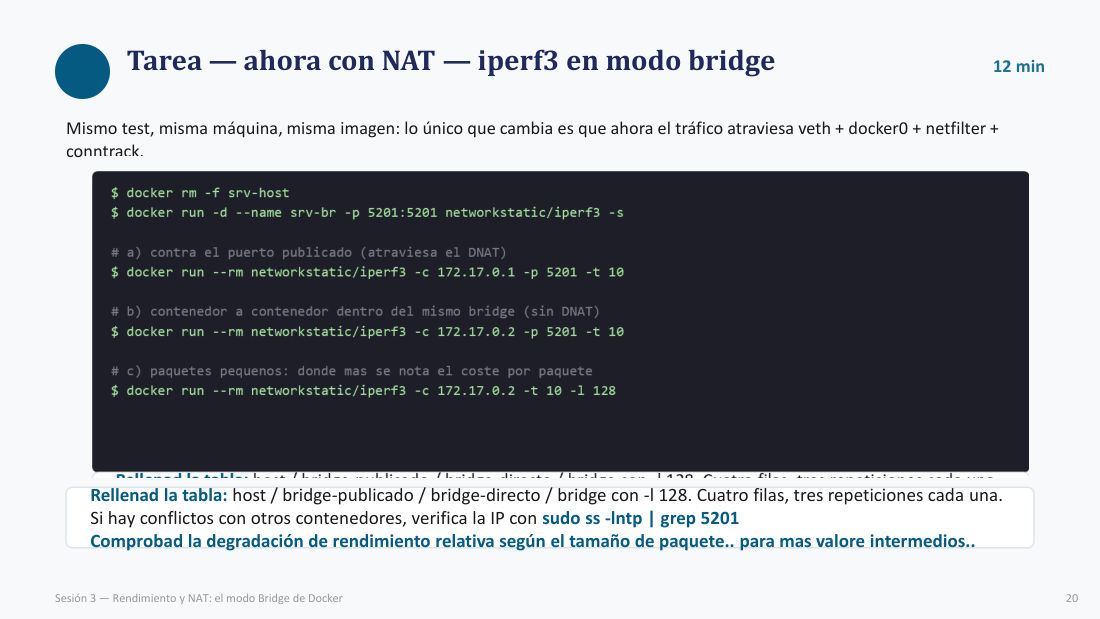
Mismo test, misma máquina, misma imagen: lo único que cambia es que ahora el tráfico atraviesa veth +
同一个测试、同一台机器、同一个镜像:唯一变化是流量现在要穿过 veth +
$ docker rm -f srv-host
$ docker run -d --name srv-br -p 5201:5201 networkstatic/iperf3 -s

# a) 打已发布的端口(要过 DNAT)
$ docker run --rm networkstatic/iperf3 -c 172.17.0.1 -p 5201 -t 10

# b) 同一 bridge 内,容器到容器(不过 DNAT)
$ docker run --rm networkstatic/iperf3 -c 172.17.0.2 -p 5201 -t 10

# c) 小包:按包计费的成本在这里最明显
$ docker run --rm networkstatic/iperf3 -c 172.17.0.2 -t 10 -l 128
Rellenad la tabla: host /
填表:host /
| Modo · 路径 | Ruta que recorre | 1ª | 2ª | 3ª | Mediana |
|---|---|---|---|---|---|
| host | loopback(无 veth / 无 NAT) | ____ | ____ | ____ | ____ |
| bridge-publicado | veth + docker0 + DNAT (+ proxy) | ____ | ____ | ____ | ____ |
| bridge-directo | veth + docker0(无 DNAT) | ____ | ____ | ____ | ____ |
| bridge -l 128 | 同上,但每包只装 128 B | ____ | ____ | ____ | ____ |
Si hay conflictos con otros contenedores, verifica la IP con sudo ss -lntp | grep 5201
如果和其他容器的端口打架,用 sudo ss -lntp | grep 5201 核对一下谁占了 IP/端口。
Comprobad la degradación de rendimiento relativa según el tamaño de paquete.. para mas valore intermedios..
验证性能下降与包大小的相对关系……若需要中间值可自行补测。
Cómo leer lo que os ha salido · 结果怎么读(7 min)
▸ 原页截图 p.22
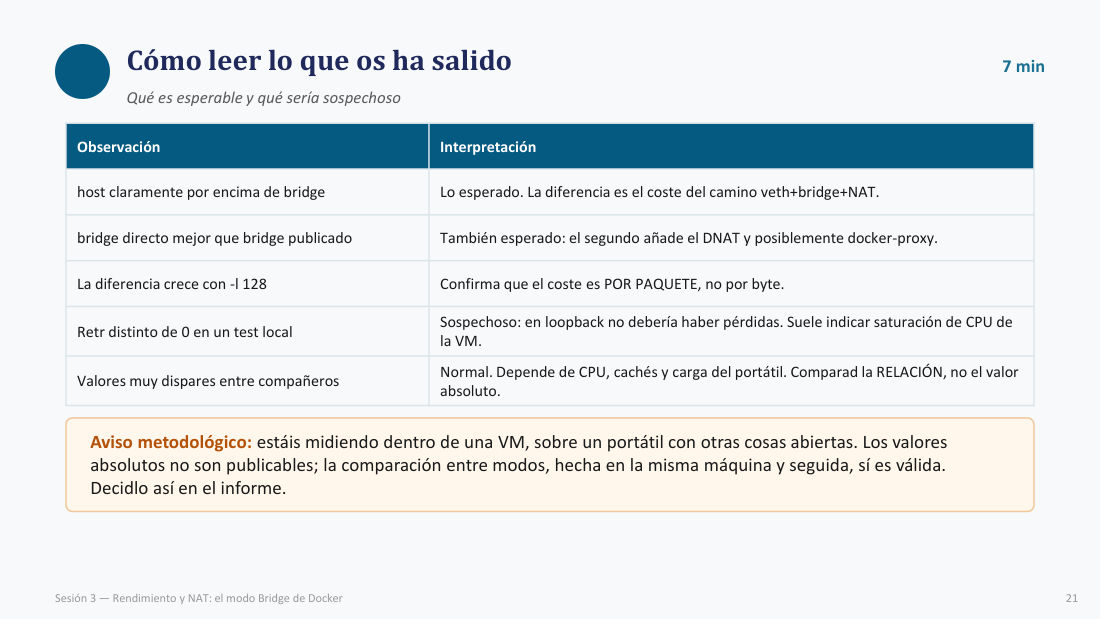
Qué es esperable y qué sería sospechoso
哪些是正常现象,哪些是可疑信号。
| Observación · 观察 | Interpretación · 解读 |
|---|---|
| host claramente por encima de bridge | Lo esperado. La diferencia es el coste del camino veth+bridge+NAT. · 正常。差值就是 veth+bridge+NAT 这段路的开销。 |
| bridge directo mejor que bridge publicado | También esperado: el segundo añade el DNAT y posiblemente docker-proxy. · 也正常:后者多一层 DNAT,可能还多一跳 docker-proxy。 |
| La diferencia crece con -l 128 | Confirma que el coste es POR PAQUETE, no por byte. · 证实成本是按包算,不是按字节。 |
| Retr distinto de 0 en un test local | Sospechoso: en loopback no debería haber pérdidas. Suele indicar saturación de CPU de la VM. · 可疑:本机回环不该丢包,通常是虚拟机 CPU 跑满了。 |
| Valores muy dispares entre compañeros | Normal. Depende de CPU, cachés y carga del portátil. Comparad la RELACIÓN, no el valor absoluto. · 正常,取决于 CPU、缓存和笔记本负载。要比比值,不比绝对值。 |
Aviso metodológico: estáis midiendo dentro de una VM, sobre un portátil con otras cosas abiertas.
方法论提醒:你们是在虚拟机里测,而且宿主机笔记本还开着一堆东西。
Los valores absolutos no son publicables; la comparación entre modos, hecha en la misma máquina y seguida, sí es válida. Decidlo así en el informe.
绝对数值不能拿去发表;但在同一台机器上、连续做出来的模式间对比是有效的。报告里就这么写。
四、UDP、抓包与综合复盘
p.23–p.30El mismo test con UDP · 同一个测试换成 UDP(6 min)
▸ 原页截图 p.23(UDP 三指标)
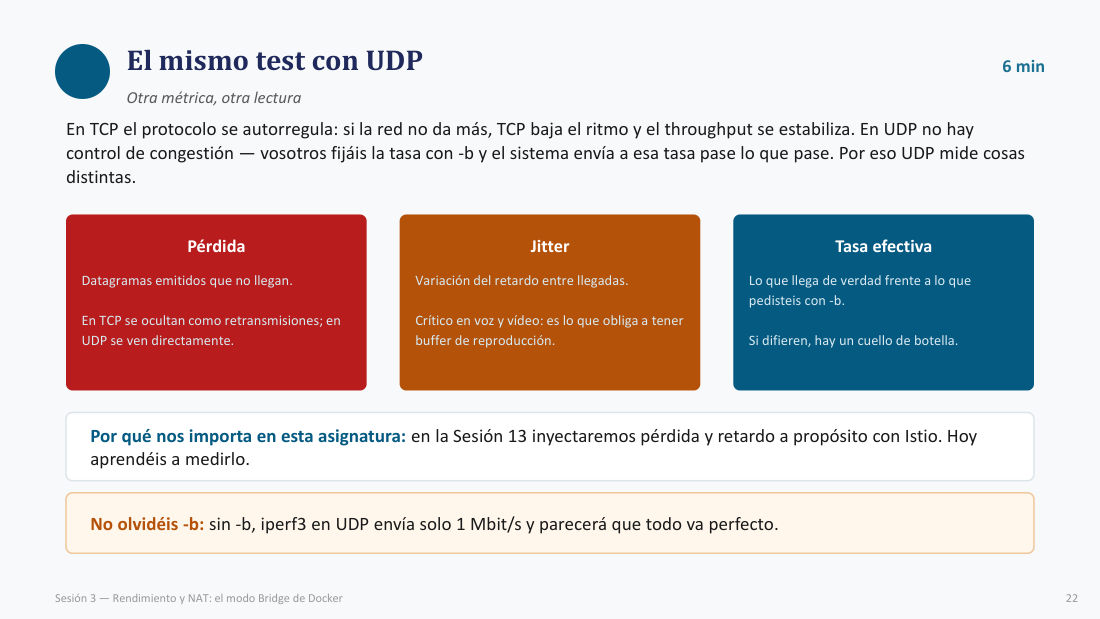
Otra métrica, otra lectura
换一种指标,就换一种读法。
En TCP el protocolo se autorregula: si la red no da más, TCP baja el ritmo y el
TCP 会自我调节:网络撑不住时,TCP 自己降速,吞吐就稳定下来了。
En UDP no hay
UDP 没有
Por eso UDP mide cosas distintas.
所以 UDP 量的是另外一些东西。
Pérdida: Datagramas emitidos que no llegan. En TCP se ocultan como retransmisiones; en UDP se ven directamente.
丢包(Pérdida):发出去却没到的数据报。TCP 里它们被「重传」遮住了,UDP 里则赤裸裸地摆在眼前。
Jitter: Variación del retardo entre llegadas. Crítico en voz y vídeo: es lo que obliga a tener
抖动(Jitter):相邻包到达时延的波动。语音和视频的要害 —— 正是它逼着你上
Tasa efectiva: Lo que llega de verdad frente a lo que pedisteis con -b. Si difieren, hay un cuello de botella.
有效速率(Tasa efectiva):真正到达的量 vs 你用 -b 要求的量。两者不一致,就说明有瓶颈。
Por qué nos importa en esta asignatura: en la Sesión 13 inyectaremos
为什么这门课在乎这个:第 13 讲我们会用 Istio 故意注入
No olvidéis -b: sin -b,
别忘了 -b:UDP 下不给 -b,
Tarea — UDP — pérdida y jitter bajo NAT · 任务:NAT 下的丢包与抖动(10 min)
▸ 原页截图 p.24(UDP 命令与输出)
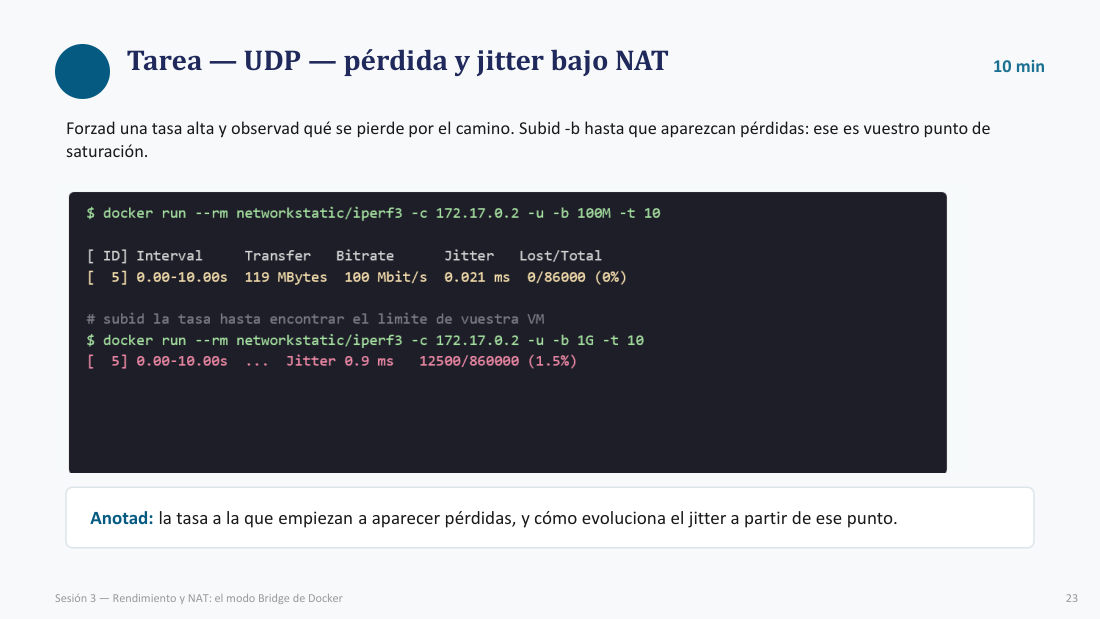
Forzad una tasa alta y observad qué se pierde por el camino. Subid -b hasta que aparezcan pérdidas: ese es vuestro punto de saturación.
把速率硬拉高,看路上丢了多少。把 -b 一路加上去,直到开始丢包 —— 那就是你的饱和点。
$ docker run --rm networkstatic/iperf3 -c 172.17.0.2 -u -b 100M -t 10

[ ID] Interval        Transfer     Bitrate      Jitter   Lost/Total
[  5] 0.00-10.00 secs 119 MBytes   100 Mbit/s   0.021 ms 0/86000 (0%)

# subid la tasa hasta encontrar el límite de vuestra VM
$ docker run --rm networkstatic/iperf3 -c 172.17.0.2 -u -b 1G -t 10
[  5] 0.00-10.00 secs  ...   Jitter 0.9 ms   12500/860000 (1.5%)
Anotad: la tasa a la que empiezan a aparecer pérdidas, y cómo evoluciona el
记录:从哪一档速率开始丢包,以及过了这个点之后
Tarea — ver la traducción con vuestros ojos · 任务:亲眼看 NAT 翻译(12 min)
▸ 原页截图 p.25(双点抓包命令)
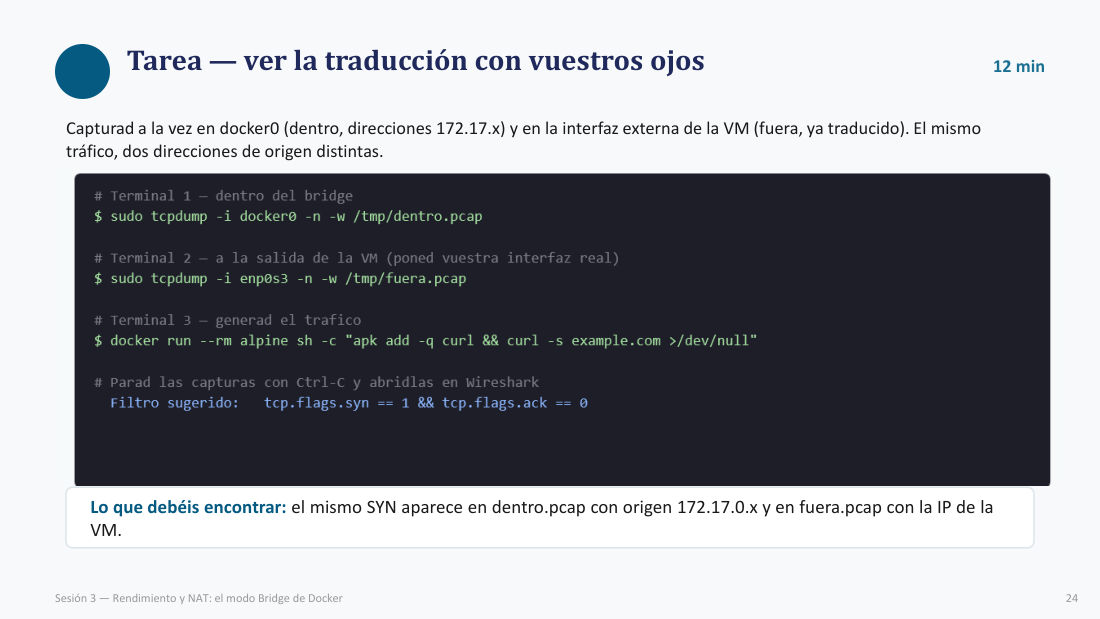
Capturad a la vez en
同时在
El mismo tráfico, dos direcciones de origen distintas.
同一份流量,两个不同的源地址。
# 终端 1 — bridge 内侧
$ sudo tcpdump -i docker0 -n -w /tmp/dentro.pcap

# 终端 2 — VM 出口(换成你自己的真实网卡)
$ sudo tcpdump -i enp0s3 -n -w /tmp/fuera.pcap

# 终端 3 — 制造流量
$ docker run --rm alpine sh -c "apk add -q curl && curl -s example.com >/dev/null"

# 用 Ctrl-C 停止抓包,再在 Wireshark 里打开
# 建议过滤器:
   tcp.flags.syn == 1 && tcp.flags.ack == 0
Lo que debéis encontrar: el mismo
你应该看到:同一个
Síntesis de la sesión · 本讲小结(3 min)
▸ 原页截图 p.26
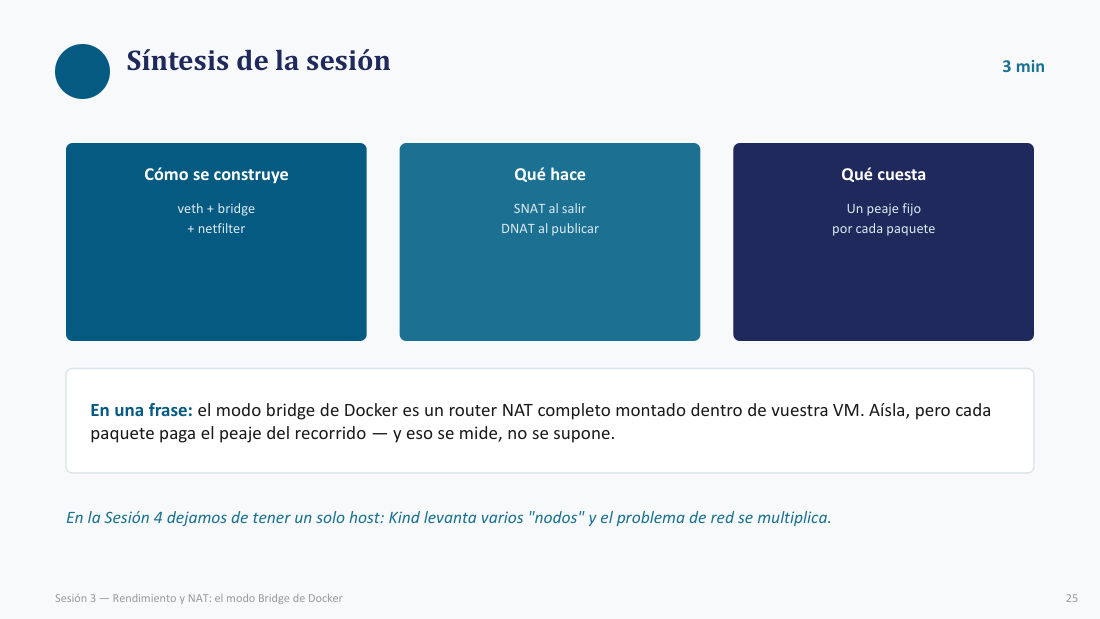
Cómo se construye: veth +
怎么搭:veth +
Qué hace:
干什么:出站做
Qué cuesta: Un peaje fijo por cada paquete
代价:每个包都要交一笔固定「过路费」。
En una frase: el modo
一句话:Docker 的
En la Sesión 4 dejamos de tener un solo host: Kind levanta varios "nodos" y el problema de red se multiplica.
第 4 讲我们就不再是单机了:Kind 会拉起多个「节点」,网络问题直接翻倍。
Para casa · 课后作业
▸ 原页截图 p.27(作业要求)
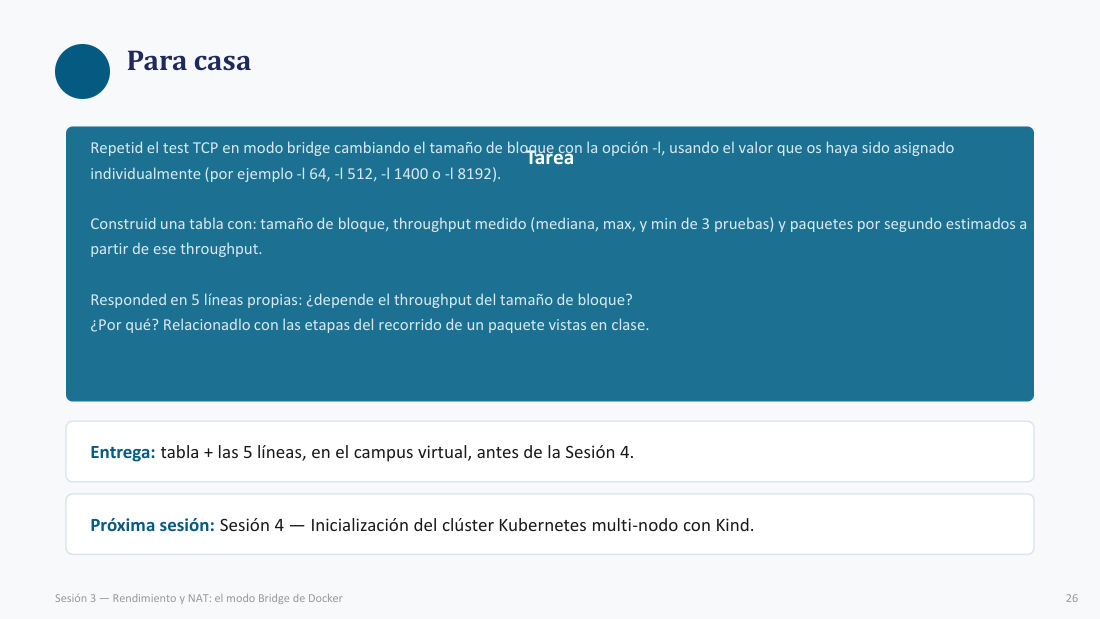
Repetid el test TCP en modo
在
Construid una tabla con: tamaño de bloque,
做一张表:块大小、实测吞吐(3 次的
Responded en 5 líneas propias: ¿depende el
用你自己的 5 行话回答:
¿Por qué? Relacionadlo con las etapas del recorrido de un paquete vistas en clase.
为什么?把它和课上讲的「一个包要走的那几段路」联系起来。
# 固定块大小跑 TCP(示例:64 B)
$ docker run --rm networkstatic/iperf3 -c 172.17.0.2 -t 10 -l 64

# pps ≈ throughput(bits/s) / (block_size + 头部开销)(bits)
# 例:1 Gbit/s、-l 128 → 约 1e9 / (128×8) ≈ 97 万 pps
| Bloque | Mediana | Máx | Mín | pps estimados |
|---|---|---|---|---|
| -l 64 | ____ | ____ | ____ | ____ |
| -l 512 | ____ | ____ | ____ | ____ |
| -l 1400 | ____ | ____ | ____ | ____ |
| -l 8192 | ____ | ____ | ____ | ____ |
Entrega: tabla + las 5 líneas, en el campus virtual, antes de la Sesión 4.
提交:表格 + 那 5 行文字,第 4 讲之前在虚拟校园平台交。
Próxima sesión: Sesión 4 — Inicialización del clúster Kubernetes multi-
下一讲:第 4 讲 —— 用 Kind 初始化多
[Opcional] MTU: el parámetro que romperá cosas más adelante · [选学] MTU:以后会搞事的那个参数
▸ 原页截图 p.28
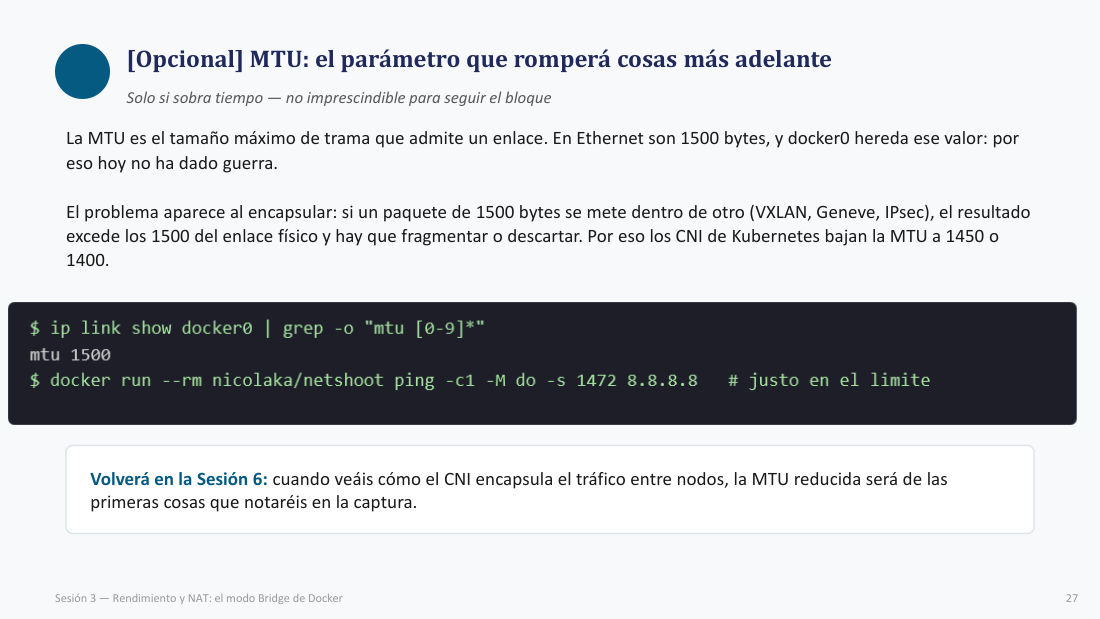
Solo si sobra tiempo — no imprescindible para seguir el bloque
有时间才看 —— 不是跟上本模块的必备内容。
La
El problema aparece al
问题出在「再
Por eso los
所以 Kubernetes 的
Volverá en la Sesión 6: cuando veáis cómo el
第 6 讲还会回来:等看到
[Opcional] Un matiz: "iptables" ya no es iptables · [选学] 一个细节:iptables 已不是 iptables
▸ 原页截图 p.29(版本命令)
Solo si sobra tiempo — no imprescindible para seguir el bloque
有时间才看 —— 不是跟上本模块的必备内容。
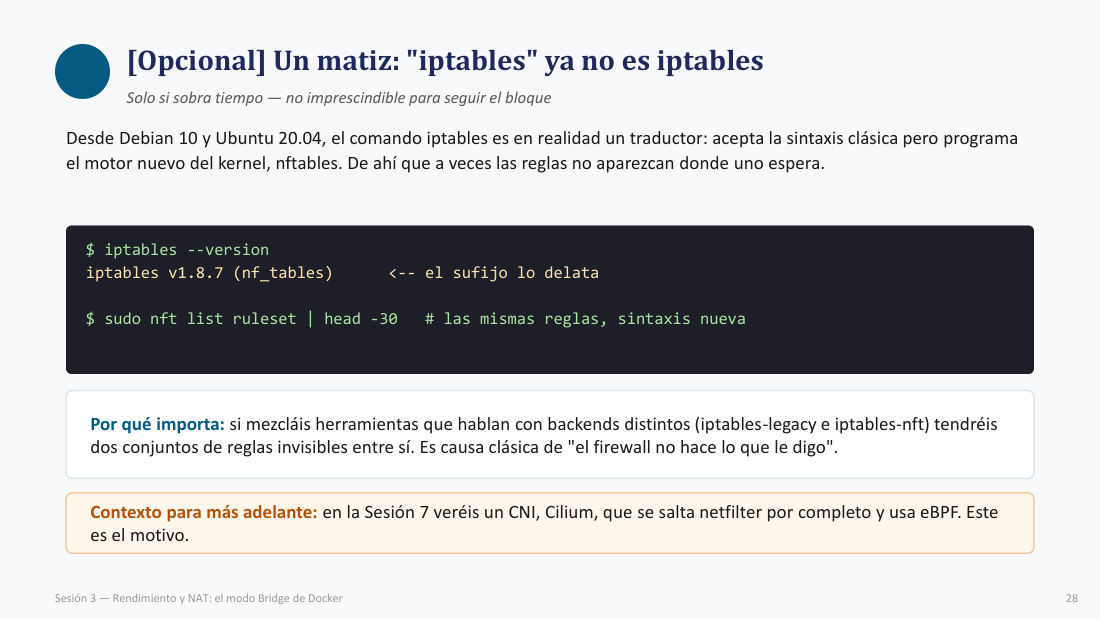
Desde Debian 10 y Ubuntu 20.04, el comando iptables es en realidad un traductor: acepta la sintaxis clásica pero programa el motor nuevo del kernel,
从 Debian 10 和 Ubuntu 20.04 起,iptables 命令其实只是个「翻译器」:接受经典语法,实际去配置内核的新引擎
De ahí que a veces las reglas no aparezcan donde uno espera.
所以才会有「规则没出现在你以为的地方」这种事。
$ iptables --version
iptables v1.8.7 (nf_tables)      <-- 后缀暴露了后端
$ sudo nft list ruleset | head -30   # 同一批规则,新语法
Por qué importa: si mezcláis herramientas que hablan con backends distintos (
为什么重要:混用对接不同后端的工具(
Contexto para más adelante: en la Sesión 7 veréis un
后续背景:第 7 讲会看到
Bibliografía y recursos · 参考书目与资源
▸ 原页截图 p.30
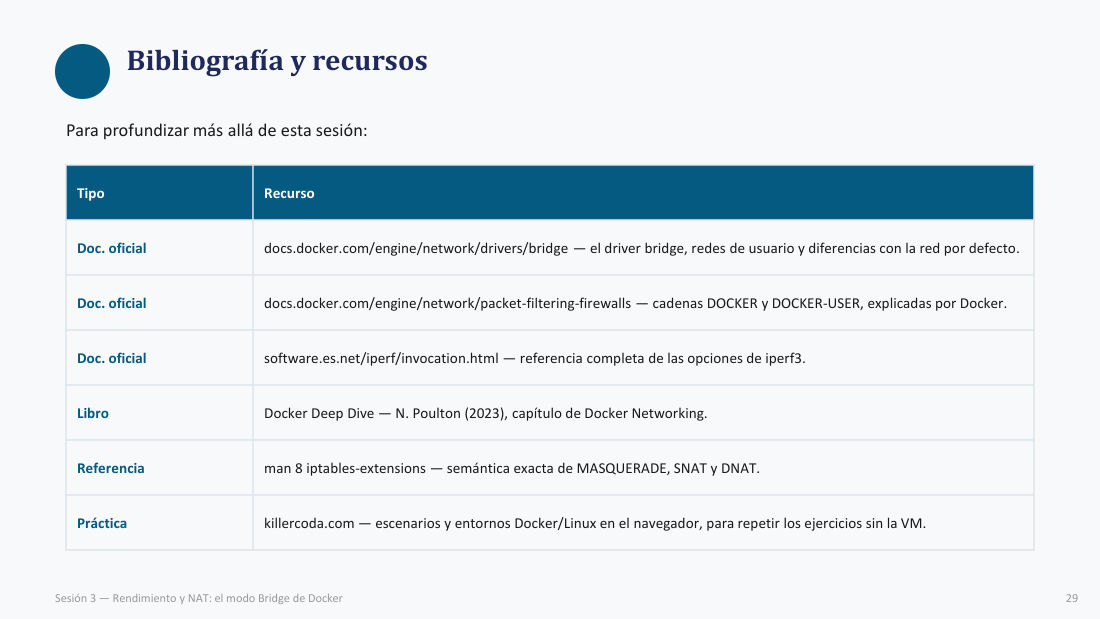
Para profundizar más allá de esta sesión:
想在本讲之外再深入的话:
| Tipo | Recurso · 资源 |
|---|---|
| Doc. oficial | docs.docker.com/engine/network/drivers/bridge — el driver bridge, redes de usuario y diferencias con la red por defecto. · bridge 驱动、用户网络与默认网络的区别。 |
| Doc. oficial | docs.docker.com/engine/network/packet-filtering-firewalls — cadenas DOCKER y DOCKER-USER, explicadas por Docker. · Docker 官方解释 DOCKER 与 DOCKER-USER 链。 |
| Doc. oficial | software.es.net/iperf/invocation.html — referencia completa de las opciones de iperf3. · iperf3 全部选项参考。 |
| Libro | Docker Deep Dive — N. Poulton (2023), capítulo de Docker Networking. · 第 2023 版「Docker 网络」一章。 |
| Referencia | man 8 iptables-extensions — semántica exacta de MASQUERADE, SNAT y DNAT. · MASQUERADE / SNAT / DNAT 的精确语义。 |
| Práctica | killercoda.com — escenarios y entornos Docker/Linux en el navegador, para repetir los ejercicios sin la VM. · 浏览器里的 Docker/Linux 环境,不用虚拟机也能重做实验。 |
五、专有名词总表
A–Z · 全章 30 页专有名词速记表(A–Z)
共 60 条,覆盖全 30 页的高频术语。按西语字母排序,点页码直接跳回对应页块。最后一列是「一句话记住 / 易错点」——考前只扫这一列也能救急。
| 西语术语 | 中文 | 页 | 一句话记住 / 易错点 |
|---|---|---|---|
| A | |||
| aislamiento de redes | 网络间隔离 | p.15 | 用户自定义网络之间互相看不见;默认 bridge 全部同域 |
| ancho de banda | 带宽 | p.18 | 管道粗细 ≠ 快慢;宽链路也可能 RTT 很高 |
| B | |||
| backend | 后端(规则引擎) | p.29 | iptables 只是前端,真正干活的是 legacy 或 nftables |
| bridge | 网桥(二层交换机) | p.4 | Linux bridge 是软件交换机;docker0 同时还是网关 |
| buffer de reproducción | 播放缓冲 | p.23 | jitter 越大,缓冲越深,延迟越高 |
| C | |||
| cadena (netfilter) | 链 | p.12 | PREROUTING / POSTROUTING / FORWARD / DOCKER-USER |
| captura (pcap) | 抓包 | p.25 | tcpdump 抓、Wireshark 看;两个点各抓一份 |
| cliente | 客户端 | p.19 | iperf3 -c 造流量;默认方向 客户端 → 服务端 |
| CNI | 容器网络接口插件 | p.28 | K8s 的 CNI 因封装把 MTU 降到 1450/1400 |
| conntrack | 连接跟踪 | p.21 | 记下 NAT 前的五元组,回程才能反翻译 |
| control de congestión | 拥塞控制 | p.23 | TCP 有(会刹车),UDP 没有(只会踩油门) |
| coste por paquete | 按包计的成本 | p.17 | 不是按字节;包越小,同样吞吐越吃亏 |
| D | |||
| datagrama | 数据报 | p.23 | UDP 的传输单位;丢了不会自动补 |
| DHCP | 动态主机配置协议 | p.8 | Docker 的 IPAM 不用 DHCP,直接分配 172.17.x |
| DNAT | 目的地址转换 | p.11 | 进门改「去哪儿」:-p 8080:80 → 172.17.0.2:80 |
| docker-proxy | Docker 用户态代理 | p.14 | 本机访问发布端口时多出来的一跳 |
| docker0 | 默认网桥 | p.6 | 172.17.0.1/16,既是交换机又是网关 |
| E | |||
| eBPF | 内核可编程字节码 | p.29 | Cilium 用它绕过 netfilter,第 7 讲见 |
| encapsular | 封装 | p.28 | 1500 再套一层头 → 超 MTU → 分片或丢弃 |
| enlace | 链路 | p.28 | MTU 是「一条链路」的上限,不是全网统一值 |
| Ethernet | 以太网 | p.28 | 标准 MTU = 1500 B,docker0 继承它 |
| F | |||
| FORWARD | 转发链 | p.12 | 决定谁能穿过 bridge;自己的规则别写这里 |
| fragmentar | 分片 | p.28 | 超过 MTU 的两种下场:分片,或者丢弃 |
| G | |||
| gateway | 网关 | p.8 | 容器的默认网关就是 docker0 的 172.17.0.1 |
| Geneve | Geneve 隧道协议 | p.28 | 和 VXLAN、IPsec 一样,封装后要降 MTU |
| goodput | 有效吞吐 | p.18 | 只算有效载荷,永远 ≤ throughput |
| I | |||
| iperf3 | 吞吐测量工具 | p.19 | -s 服务端、-c 客户端;UDP 必须带 -b |
| IPAM | IP 地址管理 | p.8 | Docker 自己分配,无 DHCP,网段 172.17.0.0/16 |
| iptables-legacy | 旧版规则后端 | p.29 | 和 iptables-nft 的规则互相看不见 |
| iptables-nft | nftables 兼容后端 | p.29 | 新版发行版默认走它,版本号后缀 (nf_tables) |
| IPsec | IP 安全协议族 | p.28 | 同样是「封装导致 MTU 不够」的元凶之一 |
| J | |||
| jitter | 抖动 | p.23 | 到达时延的波动;语音视频最怕它 |
| L | |||
| línea base | 基线 | p.20 | host 模式 + loopback,没有 veth/NAT 的参照组 |
| loopback | 回环 | p.3 | 127.0.0.1 不出网卡;本机丢包先怀疑 CPU |
| -l (tamaño de bloque) | 块大小 | p.27 | 不是 MTU;块越小,包越多,每包成本越贵 |
| M | |||
| MASQUERADE | 动态源地址伪装 | p.10 | 自动取出口网卡 IP;SNAT 则是写死 IP |
| mediana | 中位数 | p.18 | 3 次测量、丢掉第一次、取中位数 |
| MTU | 最大传输单元 | p.28 | 以太网 1500;封装后 1450/1400 |
| N | |||
| netfilter | Linux 包过滤框架 | p.12 | Docker 的 NAT 规则全在里面;每包都要过一遍 |
| nftables | 新一代内核规则引擎 | p.29 | iptables 命令翻译成它;nft list ruleset 看真身 |
| nodo | 节点 | p.26 | Kind 起的「节点」其实是容器,网络问题翻倍 |
| P | |||
| paquetes por segundo | 每秒包数(pps) | p.27 | 吞吐 ÷ 块大小;作业里用它证明「按包计费」 |
| pérdida | 丢包 | p.23 | UDP 里直接可见;TCP 里被重传遮住 |
| POSTROUTING | 出站后置链 | p.10 | MASQUERADE 住这里,管「出门换马甲」 |
| PREROUTING | 入站前置链 | p.12 | DNAT 住这里,管「进门改目的地」 |
| puerto publicado | 已发布端口 | p.11 | -p 才真开;EXPOSE 只是文档说明 |
| R | |||
| red de usuario | 用户自定义网络 | p.15 | 有内建 DNS 127.0.0.11,能按名字互 ping |
| red por defecto | 默认网络 | p.3 | 只为历史兼容;无按名解析、无隔离 |
| retransmisión | 重传 | p.18 | iperf3 的 Retr 列;本机测试应接近 0 |
| RFC 1918 | 私有地址标准 | p.10 | 172.17.0.0/16 是私网,公网不可路由,所以要 NAT |
| S | |||
| saturación (punto de) | 饱和点 | p.24 | 丢包首次稳定出现的速率,不是最高速率 |
| SNAT | 源地址转换 | p.10 | 出门改「从哪儿来」;MASQUERADE 是它的动态版 |
| SYN | TCP 建连首包 | p.25 | 抓包里找 SYN,就能看到源 IP 被换掉 |
| T | |||
| tabla de conexiones | 连接跟踪表 | p.17 | 回程反翻译靠它;建表项也是每包成本之一 |
| tasa efectiva | 有效速率 | p.23 | 实际到达 vs -b 要求;不一致即有瓶颈 |
| tcpdump | 命令行抓包工具 | p.25 | -i 选网卡、-n 不解析、-w 写文件 |
| throughput | 吞吐量 | p.18 | 含头部的「过磅总重」,不等于 goodput |
| V | |||
| veth pair | 虚拟网卡对 | p.5 | 一头在容器、一头在 docker0;@ifNN 是配对索引 |
| VXLAN | VXLAN 隧道 | p.28 | 封装开销让 MTU 从 1500 降到 1450 |
| W | |||
| Wireshark | 图形化抓包分析器 | p.25 | 过滤器 tcp.flags.syn == 1 && tcp.flags.ack == 0 |
六、编号规则速记卡
五段路 · 四条链编号规则速记卡
口诀:「线、桥、规、表、代」走完五段路;「进改、出掩、过筛、自留」记住四条链。
| 编号 | 原文关键词 | 中文 | 性质归类 | 页 |
|---|---|---|---|---|
| R1 | pareja veth: una copia extra | 穿过 veth 对,内核多一次拷贝 | 数据面 · 转发 | p.17 |
| R2 | bridge docker0: reenvío de nivel 2 | docker0 做二层转发决策 | 数据面 · 转发 | p.17 |
| R3 | cadenas de netfilter | 逐条比对 netfilter 规则 | 数据面 · 过滤 | p.17 |
| R4 | tabla de conexiones | 建 / 查 conntrack 表项 | 数据面 · 状态 | p.17 |
| R5 | salto por docker-proxy | 本机流量多绕一次用户态代理 | 用户态 · 额外跳 | p.17 |
| C1 | PREROUTING → DOCKER | 入站改目的地:-p 的 DNAT | nat 表 | p.12 |
| C2 | POSTROUTING | 出站改源地址:MASQUERADE | nat 表 | p.12 |
| C3 | FORWARD → DOCKER | 决定谁能穿过 bridge | filter 表 | p.12 |
| C4 | DOCKER-USER | 官方预留的自定义扩展点 | filter 表 · 最先评估 | p.12 |
七、易混对照卡
14 对 · 差别只在一个词易混概念对照
每对只记「差在哪个词」,比背两段定义省力得多。
容器直接用 VM 的网络栈,无 veth、无 NAT,端口不隔离。
容器有独立 IP,经 veth → docker0 → netfilter,隔离但每包付费。
写在 Dockerfile 里,只是文档,不开任何端口。
运行时安装 DNAT,真正把外部 8080 映射到容器 80。
改源地址,管出站;让私网能上网,回程靠 conntrack 还原。
改目的地址,管入站;-p 发布端口就是它。
SNAT 的动态版:自动取出口网卡 IP,适合地址会变的场景。
把源 IP 写死在规则里;出口 IP 固定时更高效、更明确。
线上过的总比特,含头部;「过磅总重」。
只算应用有效数据,永远更小;「净菜重量」。
往返一趟的时间;和带宽无关,宽链路也可能慢。
管道粗细;决定「一次能过多少」,不决定「多久到」。
一块网桥,同时是 172.17.0.1 的网关;所有 veth 都接上来。
一根虚拟网线的两端:一头在容器里,一头 enslave 到 docker0。
无内建 DNS、无隔离,所有容器同一广播域;只为兼容而存在。
有 127.0.0.11 内建 DNS、可按名解析、网络间互相隔离。
访问 172.17.0.1:5201,要过 DNAT,可能还多一跳 docker-proxy。
容器直连 172.17.0.2:5201,走纯 bridge 转发,无 DNAT。
用户态前端,接受经典语法;本身不是内核引擎。
真正执行规则的后端;iptables v1.8.7 (nf_tables) 即走它。
发出去没到;UDP 里直接可见,TCP 里被重传掩盖。
到达时延的波动;不丢包也可能抖得没法通话。
iperf3 每次写多少字节;影响包数与每包成本。
链路能承载的最大帧;影响是否分片,两者不是一回事。
反转方向:服务端发、客户端收;用来测下行。
并行开 N 条流;用来压多核 / 多队列,不是改方向。
受 CPU、缓存、笔记本负载影响,不可发表。
同机、同镜像、连续测得的模式间比值,才是有效结论。