- 一页一块:页号胶囊是 PDF 物理页序(1–108);幻灯片上印的页码可能另有编号,以胶囊为准。
- 逐句对照:蓝色左框内是西语原句(逐字照抄,含原文笔误),下面带「中」字标的是中文翻译;项目符号统一用 • 表示。
- 提示框:绿色「考点」= 这页怎么考;红色「陷阱」= 易错点与原文勘误;紫色「记忆钩子」= 口诀;橙色「补充」= 前后页串联。
- 术语悬停:西语句里带浅蓝底的词,鼠标停上去出中文;中文句里带虚下划线的词,停上去出西语原词。
- 公式:一律用本地 MathJax 渲染(断网也能显示),每个公式下附「符号 / 西语读法 / 中文含义」三列小表——口语考试念的就是这一列。
一、课程概览:目标、环境与准备工作
p.1–p.7Portada · 封面
▸ 原页截图 p.1
BLOQUE II — CONTENEDORES Y ORQUESTACIÓN
第二板块——容器与编排。
Fundamentos de contenedores y Docker
容器与 Docker 基础。
Duración: 2 horas — teoría con tareas cortas intercaladas
时长:2 小时——理论讲授,中间穿插短任务。
1
封面右下角的页码 1(这是讲义内部印的页码,与 PDF 物理页序从第 9 页起就开始错位)。
Comentarios previos. Consejos · 课前说明:学习建议
▸ 原页截图 p.2
Comentarios previos. Consejos
课前说明·学习建议。
Algunas clases se pasará lista para tenerlo en cuenta positivamente con aquellos que trabajen en clase.
有些课会点名,课堂上动手做的人会被正面计入考核。
Para poder repasar los ejercicios, se recomienda ir guardando copias de los comandos utilizados durante las prácticas y ejercicios en clase en algún documento personal.
为了能复习练习,建议把课上实践和习题中用过的命令,持续保存到自己的一份文档里。
Por ejemplo se puede exportar el texto del terminal.
例如可以把终端的文本导出。
También algunas clases se habilitarán entregas para recoger los documentos con las anotaciones de los ejercicios y ejemplos realizados en clase.
另外有些课会开放提交入口,收走你课堂练习与示例的笔记文档。
Comentarios previos. Conexión SSH a la máquina virtual · 课前说明:SSH 连接虚拟机
▸ 原页截图 p.3
Comentarios previos. Conexión SSH a la
课前说明:用 SSH 连接
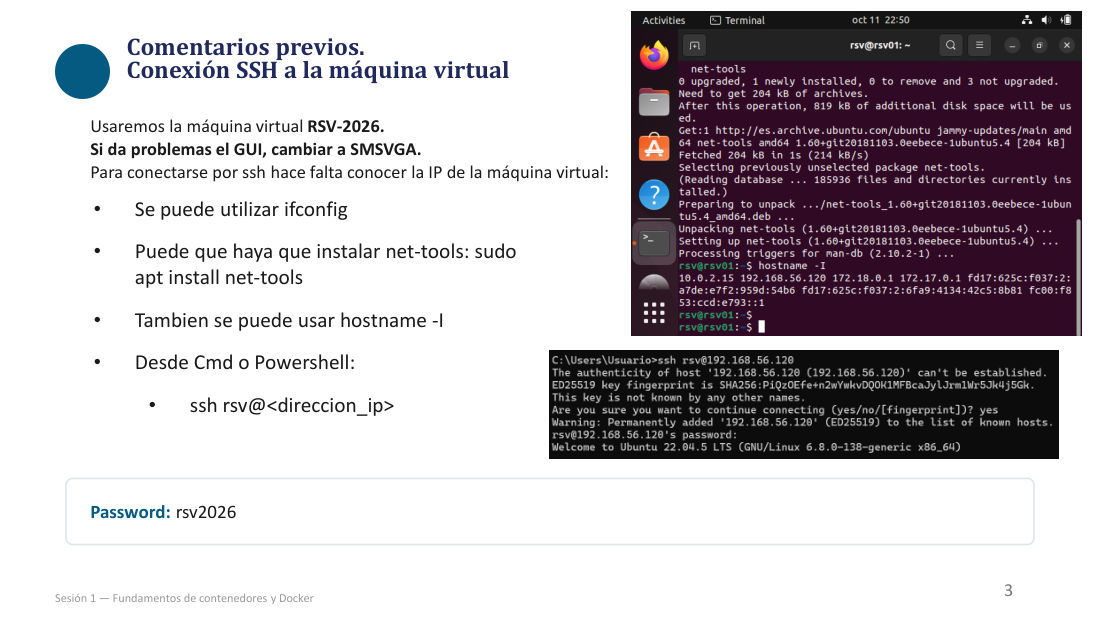
Usaremos la
我们将使用
Si da problemas el GUI, cambiar a SMSVGA.
如果图形界面出问题,就切换到 SMSVGA。
Para conectarse por ssh hace falta conocer la IP de la
要用 ssh 连接,必须先知道
Se puede utilizar ifconfig
可以用 ifconfig 查看。
Puede que haya que instalar net-tools: sudo apt install net-tools
可能需要先装 net-tools:sudo apt install net-tools。
Tambien se puede usar hostname -I
也可以用 hostname -I 查看本机所有 IP。
Desde Cmd o Powershell:
在 Windows 的 Cmd 或 PowerShell 里:
ssh rsv@<direccion_ip>
ssh rsv@<虚拟机IP>(尖括号只是占位,真正敲的时候要换成实际 IP,不带尖括号)。
Password: rsv2026
密码:rsv2026。
Comentarios previos. Instalación de docker · 课前说明:安装 Docker
▸ 原页截图 p.4
Comentarios previos. Instalación de docker
课前说明:安装 Docker。
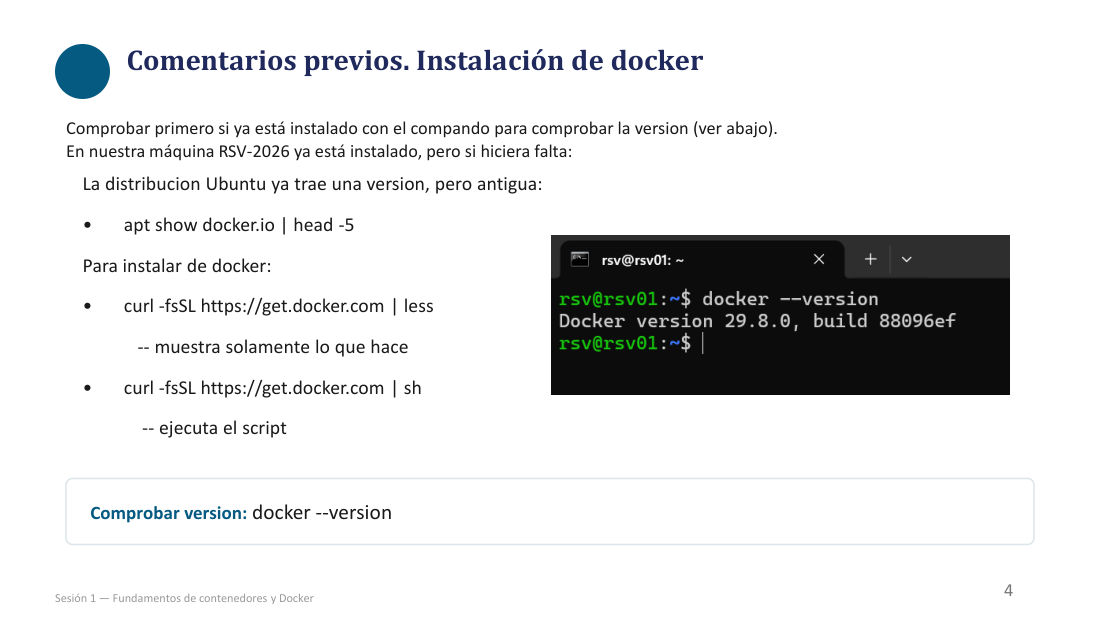
Comprobar primero si ya está instalado con el compando para comprobar la version (ver abajo).
先用查版本的命令确认是不是已经装好了(见下)。
En nuestra máquina RSV-2026 ya está instalado, pero si hiciera falta:
我们的 RSV-2026 机器上已经装好了,但万一需要装:
La distribucion Ubuntu ya trae una version, pero antigua:
Ubuntu 发行版自带一个版本,但很旧。
apt show docker.io | head -5
apt show docker.io | head -5(只显示前 5 行,快速看仓库里那个 docker.io 包的版本)。
Para instalar de docker:
要安装 Docker 官方版:
curl -fsSL https://get.docker.com | less
curl -fsSL https://get.docker.com | less —— 只查看脚本内容,不执行。
-- muestra solamente lo que hace
(原文旁注)——只展示脚本做了什么。
curl -fsSL https://get.docker.com | sh
curl -fsSL https://get.docker.com | sh —— 真正执行脚本。
-- ejecuta el script
(原文旁注)——执行该脚本。
Comprobar version: docker --version
检查版本:docker --version。
Comentarios previos. Instalación de docker: Permisos · 课前说明:权限
▸ 原页截图 p.5
Comentarios previos. Instalación de docker: Permisos
课前说明:安装 Docker 之权限。
Para las prácticas, usaremos docker con permisos de
实验课上我们会用
Lo necesitaremos más Adelante en algunos ejercicios, pero no siempre sería necesario en general.
后面的某些练习会需要它,但总体上并非永远必要。
Para dar permisos, añadimos un grupo docker:
为了给权限,我们新增一个 docker 组:
sudo usermod -aG docker $
sudo usermod -aG docker $
Lo hacemos por comodidad, y para que sea más fácil trabajar sin problemas porque a alguien se le olvide hacer sudo en algunos ejemplos de las clases.
这么做是为了方便,也免得课上演示时有人忘了加 sudo 而出问题。
De nuevo, en un uso real habría que revisar esto.
再说一遍:真实生产环境里这种做法需要重新评估。
Objetivos de esta unidad de contenido · 本单元学习目标
▸ 原页截图 p.6
Objetivos de esta unidad de contenido
本单元内容的学习目标。
Esta sesión sienta la base conceptual de todo el bloque.
这一节课为整个板块打下概念基础。
No se asume ningún conocimiento previo de contenedores.
不预设任何容器的前置知识。
Cada concepto se comprueba inmediatamente con una tarea corta en vuestra propia VM: la idea es que se apliquen practicamente y no se queden en la teoría.
每个概念都立刻在你们自己的虚拟机上用一个小任务验证:目的是真正动手用起来,而不是停留在理论。
Qué problema resuelven los contenedores, y en qué se diferencian de una
容器解决什么问题,以及它和
Cómo aísla Linux: los namespaces. Cómo limita: los cgroups.
Linux 靠什么隔离:namespaces;靠什么限制:cgroups。
Cómo se origina el sistema de ficheros de un
Qué es exactamente una
La arquitectura de Docker: cliente, demonio,
Docker 的架构:客户端、守护进程、注册中心。
Construir vuestra primera
用
Formato : entrelazaremos conceptos teóricos con breves ejercicios prácticos para ir fijando mejor las materias.
形式:理论与简短实操交替穿插,把内容一点点钉牢。
El problema: "en mi máquina funciona" · 问题所在:「在我机器上明明能跑」
▸ 原页截图 p.7
El problema: "en mi máquina funciona"
问题所在:「在我机器上明明能跑」。
Por qué apareció todo esto
这一切(容器技术)为什么会诞生。
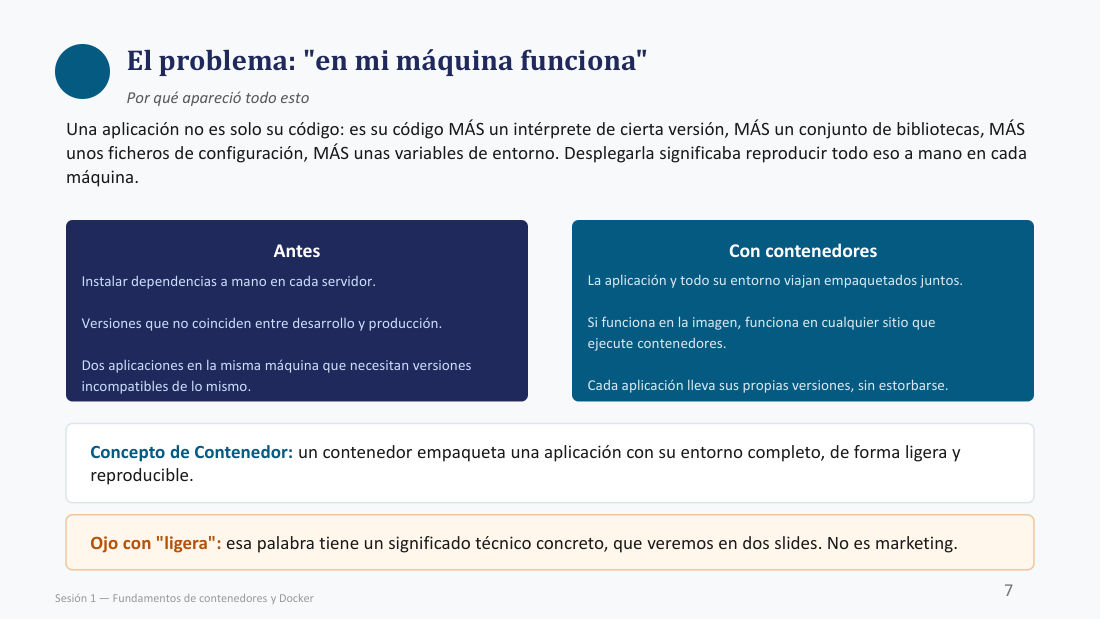
Una aplicación no es solo su código: es su código MÁS un intérprete de cierta versión, MÁS un conjunto de bibliotecas, MÁS unos ficheros de configuración, MÁS unas variables de entorno.
一个应用不只是它的代码:而是代码 加上 某个版本的解释器、加上 一组库、加上 若干配置文件、加上 若干环境变量。
Desplegarla significaba reproducir todo eso a mano en cada máquina.
部署它就意味着在每台机器上手工把这套东西重新做一遍。
Antes
以前(的做法)。
Instalar dependencias a mano en cada servidor.
在每台服务器上手工安装依赖。
Versiones que no coinciden entre desarrollo y producción.
开发环境和生产环境的版本对不上。
Dos aplicaciones en la misma máquina que necesitan versiones incompatibles de lo mismo.
同一台机器上的两个应用,需要同一个东西的两个互不兼容版本。
Con contenedores
用了容器之后。
La aplicación y todo su entorno viajan empaquetados juntos.
应用和它整个运行环境被打包在一起一起「旅行」。
Si funciona en la
只要在
Cada aplicación lleva sus propias versiones, sin estorbarse.
每个应用带自己的一套版本,互不干扰。
Concepto de Contenedor: un
Ojo con "ligera": esa palabra tiene un significado técnico concreto, que veremos en dos slides. No es marketing.
注意「轻量」这个词:它有具体的技术含义,两页之后就会讲。不是营销话术。
二、前身技术之一:cgroups —— 限制用多少
p.8–p.241a · Antecedentes. Cgroups, Namespaces y Sistemas de ficheros por capas · 第一板块(上):前身技术
▸ 原页截图 p.8
1a
1a(讲义内部编号:第 1 部分 a 小节)。
Antecedentes.
前身技术 / 背景知识。
Cgroups, Namespaces y Sistemas de ficheros por capas
Cgroups、Namespaces 与分层文件系统。
Fundamentos de contenedores y Docker
容器与 Docker 基础(课程名,重复页眉)。
Duración: 2 horas — teoría con tareas cortas intercaladas
时长:2 小时——理论课,中间穿插短任务。
8
讲义内部印的页码 8(本页恰好与 PDF 物理页序一致)。
Control Groups (Cgroups) · 控制组
▸ 原页截图 p.9
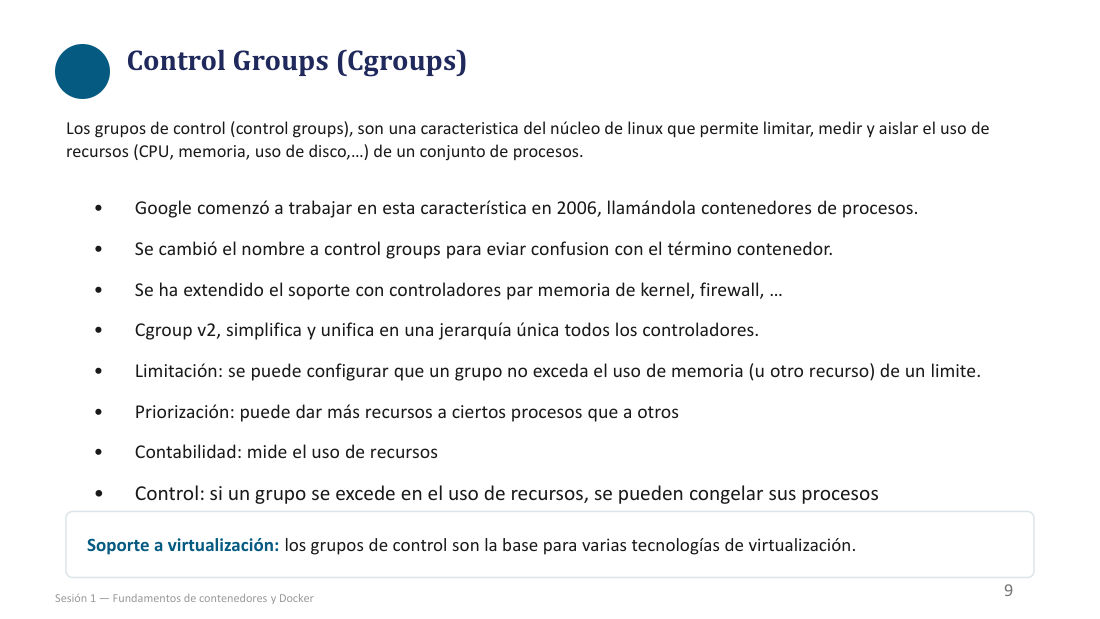
Control Groups (Cgroups)
控制组(Cgroups)。
Los
Google comenzó a trabajar en esta característica en 2006, llamándola contenedores de procesos.
Google 于 2006 年开始做这个特性,当时叫「进程容器」。
Se cambió el nombre a control groups para eviar confusion con el término
后来改名为 control groups,以免和「
Se ha extendido el soporte con controladores par memoria de kernel, firewall, …
支持范围扩展到内核内存、防火墙等控制器。
Cgroup v2, simplifica y unifica en una jerarquía única todos los controladores.
Cgroup v2 把所有控制器简化、统一到单一层级里。
Limitación: se puede configurar que un grupo no exceda el uso de memoria (u otro recurso) de un limite.
限制:可以配置某个组使用的内存(或其他资源)不超过某个上限。
Priorización: puede dar más recursos a ciertos procesos que a otros
优先级:可以给某些进程比另一些更多的资源。
Contabilidad: mide el uso de recursos
计量/记账:测量资源用量。
Control: si un grupo se excede en el uso de recursos, se pueden congelar sus procesos
控制:如果某个组超用资源,可以冻结它的进程。
Soporte a
对
Control Groups. Uso · 控制组:怎么用
▸ 原页截图 p.10
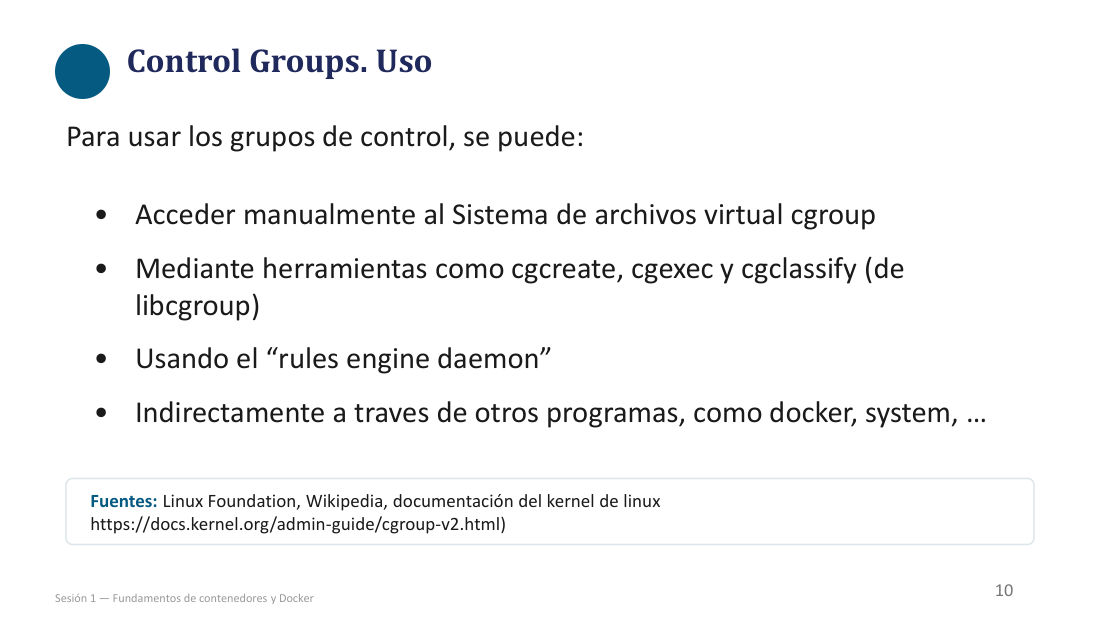
Control Groups. Uso
控制组:使用方式。
Para usar los
要使用
Acceder manualmente al Sistema de archivos virtual
手工访问
Mediante herramientas como cgcreate, cgexec y cgclassify (de libcgroup)
通过 cgcreate、cgexec、cgclassify 这类工具(来自 libcgroup)。
Usando el “rules engine daemon”
使用「规则引擎守护进程」。
Indirectamente a traves de otros programas, como docker, system, …
间接地通过其他程序,比如 docker、systemd……
Fuentes: Linux Foundation, Wikipedia, documentación del kernel de linux
资料来源:Linux 基金会、维基百科、Linux 内核文档。
https://docs.kernel.org/admin-guide/
内核官方文档地址(原文末尾多了一个右括号)。
Control Groups. Interfaces · 控制组:接口(文件清单)
▸ 原页截图 p.11
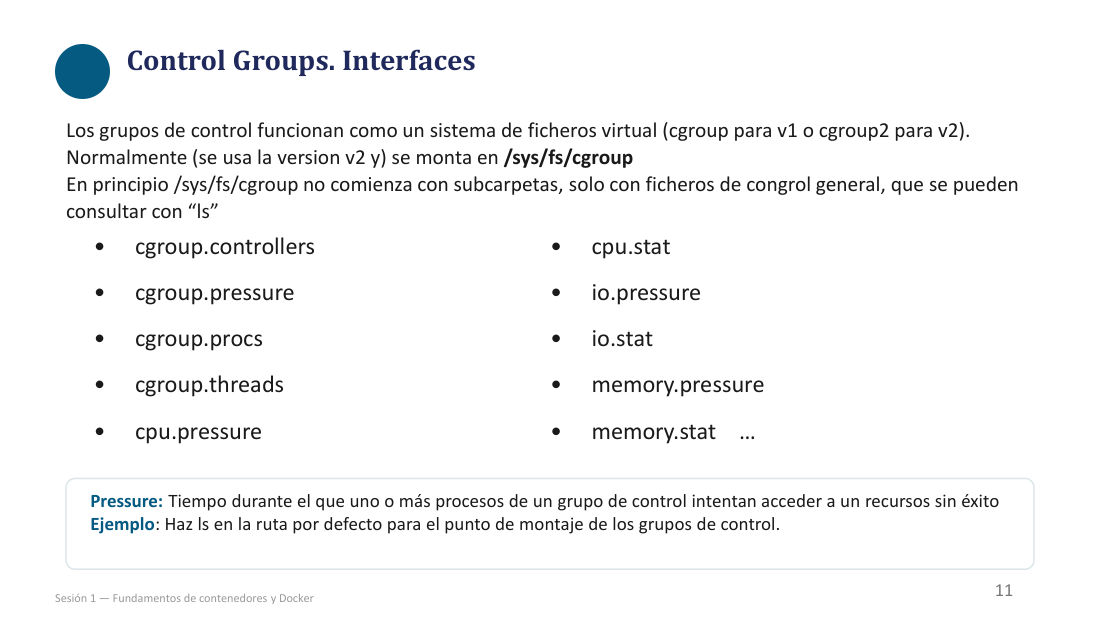
Control Groups. Interfaces
控制组:接口。
Los
Normalmente (se usa la version v2 y) se monta en /sys/fs/
通常(现在用的是 v2)挂载在 /sys/fs/
En principio /sys/fs/
一开始 /sys/fs/
cpu.pressure
cpu.pressure —— CPU 压力指标。
cpu.stat
cpu.stat —— CPU 使用统计。
io.pressure
io.pressure —— 磁盘 I/O 压力指标。
io.stat
io.stat —— I/O 统计。
memory.pressure
memory.pressure —— 内存压力指标。
memory.stat
memory.stat —— 内存使用统计。
…
……(还有更多,省略号表示列表未穷尽)。
Pressure: Tiempo durante el que uno o más procesos de un grupo de control intentan acceder a un recursos sin éxito
Pressure(压力):控制组里一个或多个进程尝试访问某资源但没成功的那段时间。
Ejemplo: Haz ls en la ruta por defecto para el punto de montaje de los
练习:在
Control Groups. Controladores · 控制组:控制器与启用
▸ 原页截图 p.12
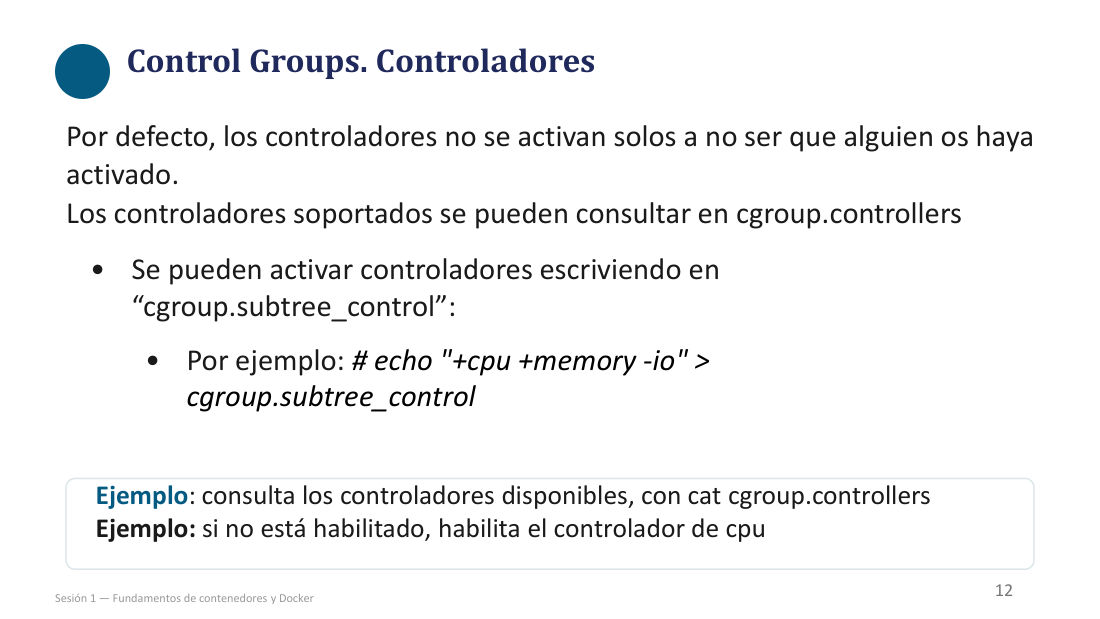
Control Groups. Controladores
控制组:控制器。
Por defecto, los controladores no se activan solos a no ser que alguien os haya activado.
默认情况下控制器不会自动启用,除非有人替你启用过。
Los controladores soportados se pueden consultar en
系统支持的控制器可以在
Se pueden activar controladores escriviendo en “
控制器可以通过往
Por ejemplo: # echo "+cpu +memory -io" >
例如:echo "+cpu +memory -io" >
Ejemplo: consulta los controladores disponibles, con cat
练习:用 cat
Ejemplo: si no está habilitado, habilita el
练习:如果 CPU
Control Groups. Consulta de versión · 控制组:查版本
▸ 原页截图 p.13
Control Groups. Consulta de versión
控制组:查询版本。
Como hemos visto hay dos posibles versions de
如我们所见,
Aunque la más moderna es v2, es útil asegurarse.
虽然最新的是 v2,但确认一下总是有用的。
Se puede consultar los puntos de montaje con mount -l
可以用 mount -l 查看挂载点。
y filtrar buscando la expression
再用 grep 过滤,搜索
Las versions modernas de Ubuntu usan únicamente
现代版本的 Ubuntu 只用
Control Groups. Crear grupos · 控制组:创建组
▸ 原页截图 p.14
Control Groups. Crear grupos
控制组:创建组。
Para crear un grupo de control:
要创建一个控制组:
Basta con crear una subcarpeta dentro del punto de montaje de los control groups
只要在控制组挂载点里建一个子目录就够了。
Cada grupo de control debe contener sus propios ficheros para interactuar con los controladores de los distintos tipos de recursos
每个控制组都会自带一套文件,用来和各类资源的控制器交互。
Debe de haber más ficheros que en la raiz del punto de montaje. Por ejemplo:
这里的文件应该比挂载点根目录下更多。例如:
Para asignar procesos a un grupo de control, se escribe en /
要把进程分配进某个控制组,就往
Se consulta con cat /proc/<PID>/
用 cat /proc/<PID>/
Consejo para pruebas: $! Representa el PID del ultimo proceso lanzado en segundo plano con $
测试小技巧:$! 表示最后一个用 & 放到后台运行的进程的 PID。
Consejo para pruebas: $$ representa el PID del shell actual
测试小技巧:$$ 表示当前 shell 的 PID。
Puedes consultar con ps el PID de un proceso
可以用 ps 查某个进程的 PID。
Ejemplo: crea una carpeta llamada ejemplo1 dentro de /sys/fs/
练习:在 /sys/fs/
Ejemplo : Añade el pid de tu shell actual al grupo de control, consulta el listado de procesos con cat. Busca el origen de todos los procesos incluidos en el fichero de procesos.
练习:把当前 shell 的 PID 加进该控制组,用 cat 查看进程列表,并追查文件里列出的所有进程的来源。
systemd-cgtop, systemd-cgls · systemd 的两个观察工具
▸ 原页截图 p.15
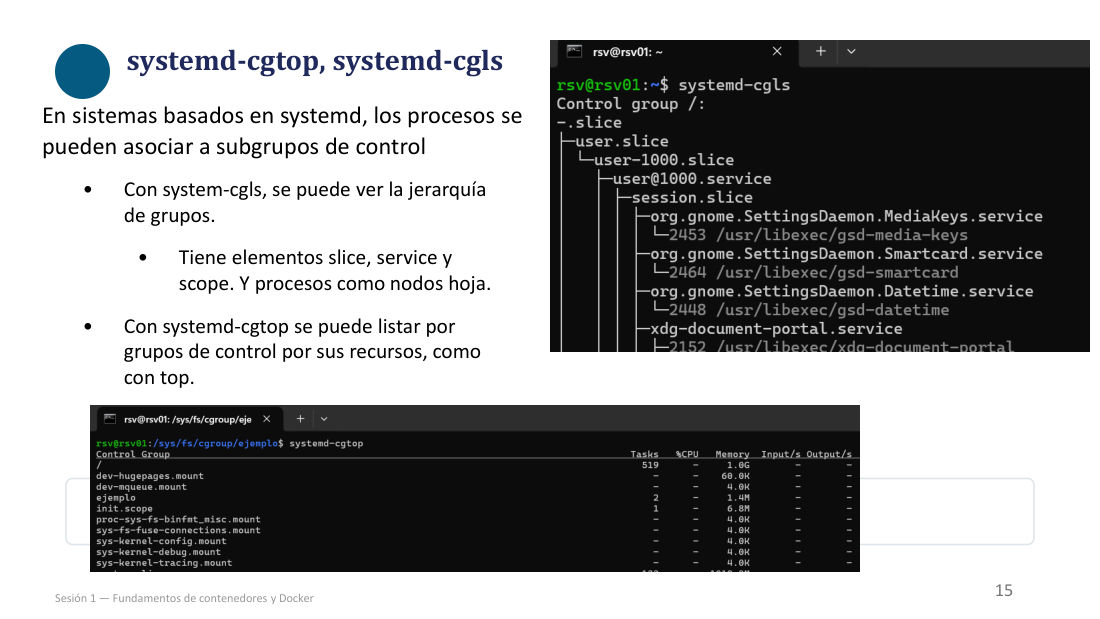
systemd-cgtop, systemd-cgls
systemd-cgtop 与 systemd-cgls。
En sistemas basados en systemd, los procesos se pueden asociar a subgrupos de control
在基于 systemd 的系统里,进程可以被关联到各个控制子组。
Con system-cgls, se puede ver la jerarquía de grupos.
用 systemd-cgls 可以看到组的层级结构。
Tiene elementos slice, service y scope. Y procesos como nodos hoja.
层级里有 slice、service、scope 三类元素,进程则是叶子节点。
Con systemd-cgtop se puede listar por
用 systemd-cgtop 可以像 top 一样,按
cgroup-tools, cgroup-utils · 命令行工具箱
▸ 原页截图 p.16
El paquete
cgroup-tools 这个包提供与这些
Se puede instalar con: sudo apt install
安装命令:sudo apt install
Creación de grupo de control: sudo cgcreate -g cpu,memory:/mi_grupo
创建控制组:sudo cgcreate -g cpu,memory:/mi_grupo。
Restricción de memoria: sudo cgset -r
限制内存:sudo cgset -r
Consulta limites y restricciones con cgget , p.ej: cgget -r
用 cgget 查看上限与限制,例如 cgget -r
Ejecucion de programa en un grupo: cgexec -g cpu,memory:/mi_grupo <mi_programa>
在某个组里运行程序:cgexec -g cpu,memory:/mi_grupo <mi_programa>。
Reasignacion de grupo: sudo cgclassify -g cpu,memory:/mi_grupo 1234
改组归属:sudo cgclassify -g cpu,memory:/mi_grupo 1234(把 PID 1234 挪进该组)。
Eliminación de grupo: sudo cgdelete cpu,memory:/mi_grupo
删除组:sudo cgdelete cpu,memory:/mi_grupo。
Listar todos los
列出系统里所有已创建的
En la siguiente slide veremos ejemplos practicos de estos comandos
下一页我们看这些命令的实操例子。
Ejercicio en clase. Consulta de grupos · 课堂练习:查看控制组
▸ 原页截图 p.17
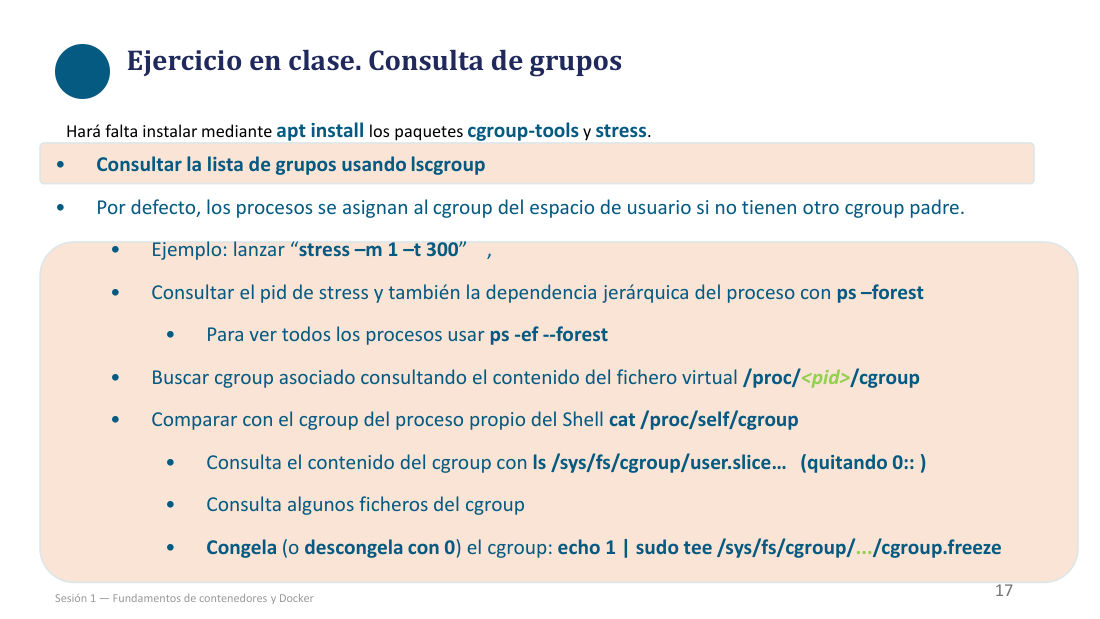
Ejercicio en clase. Consulta de grupos
课堂练习:查看控制组。
Hará falta instalar mediante apt install los paquetes
需要先用 apt install 安装
Consultar la lista de grupos usando lscgroup
用 lscgroup 查看组列表。
Por defecto, los procesos se asignan al
默认情况下,进程若没有别的父
Ejemplo: lanzar “stress –m 1 –t 300” ,
示例:运行 stress -m 1 -t 300(1 个内存工作进程,持续 300 秒)。
Consultar el pid de stress y también la dependencia jerárquica del proceso con ps –forest
查出 stress 的 PID,并用 ps --forest 看进程的层级依赖。
Para ver todos los procesos usar ps -ef --forest
要看到所有进程,用 ps -ef --forest。
Buscar
通过查看虚拟文件 /proc/<pid>/
Comparar con el
用 cat /proc/self/
Consulta el contenido del
用 ls /sys/fs/
Consulta algunos ficheros del
查看组内的若干文件。
Congela (o descongela con 0) el
冻结该
Ejercicio en clase. Eliminación explícita de grupo · 课堂练习:显式删除组
▸ 原页截图 p.18
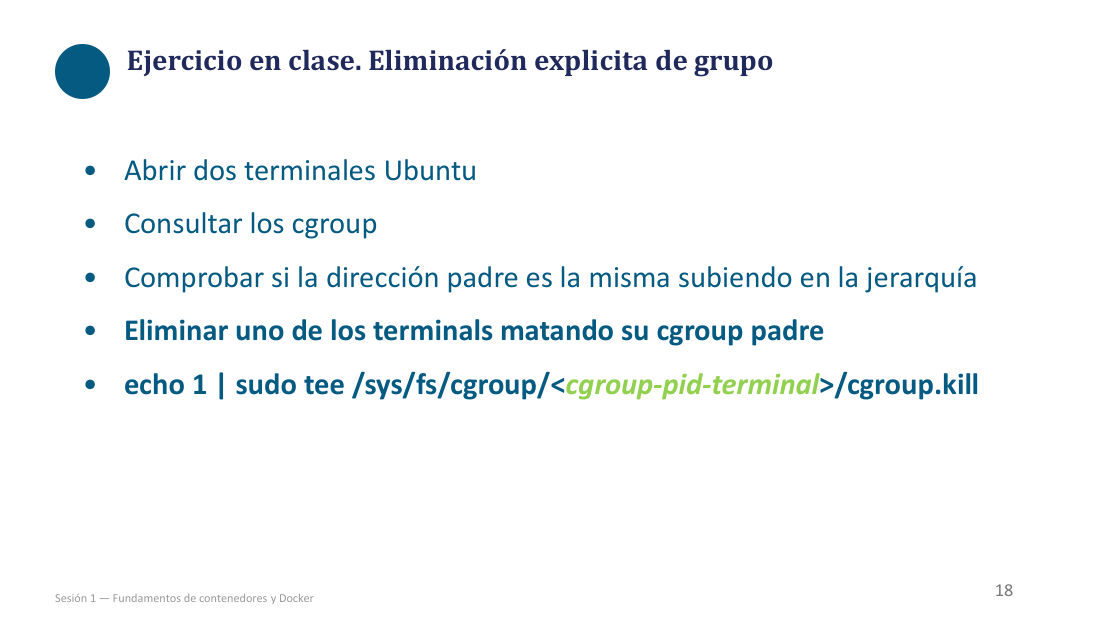
Ejercicio en clase. Eliminación explicita de grupo
课堂练习:显式删除控制组。
Abrir dos terminales Ubuntu
打开两个 Ubuntu 终端。
Consultar los
查看各自的
Comprobar si la dirección padre es la misma subiendo en la jerarquía
沿着层级往上走,确认父级路径是否相同。
Eliminar uno de los terminals matando su
通过杀掉它父级
echo 1 | sudo tee /sys/fs/
echo 1 | sudo tee /sys/fs/
Ejercicio en clase. Gestión de PIDs. Paso de controladores a hijos · 课堂练习:PID 管理与控制器下传
▸ 原页截图 p.19
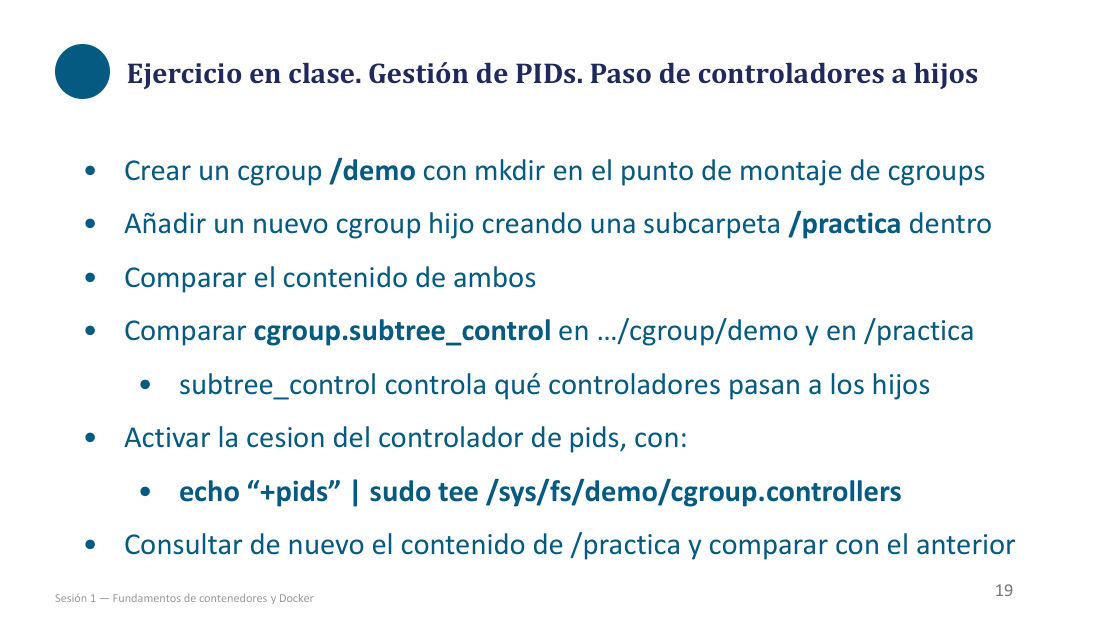
Ejercicio en clase. Gestión de PIDs. Paso de controladores a hijos
课堂练习:PID 管理——控制器向子组下传。
Crear un
在
Añadir un nuevo
在里面再建一个子目录 /practica,作为子
Comparar el contenido de ambos
对比两者的内容。
Comparar
比较 demo 和 practica 里的
subtree_control controla qué controladores pasan a los hijos
subtree_control 决定哪些控制器会下传给子组。
Activar la cesion del
启用 pids
echo “+pids” | sudo tee /sys/fs/demo/
echo "+pids" | sudo tee /sys/fs/demo/
Consultar de nuevo el contenido de /practica y comparar con el anterior
再次查看 /practica 的内容,与之前对比。
Ejercicio en clase. Gestión de PIDs (II) · 课堂练习:PID 管理(续)
▸ 原页截图 p.20
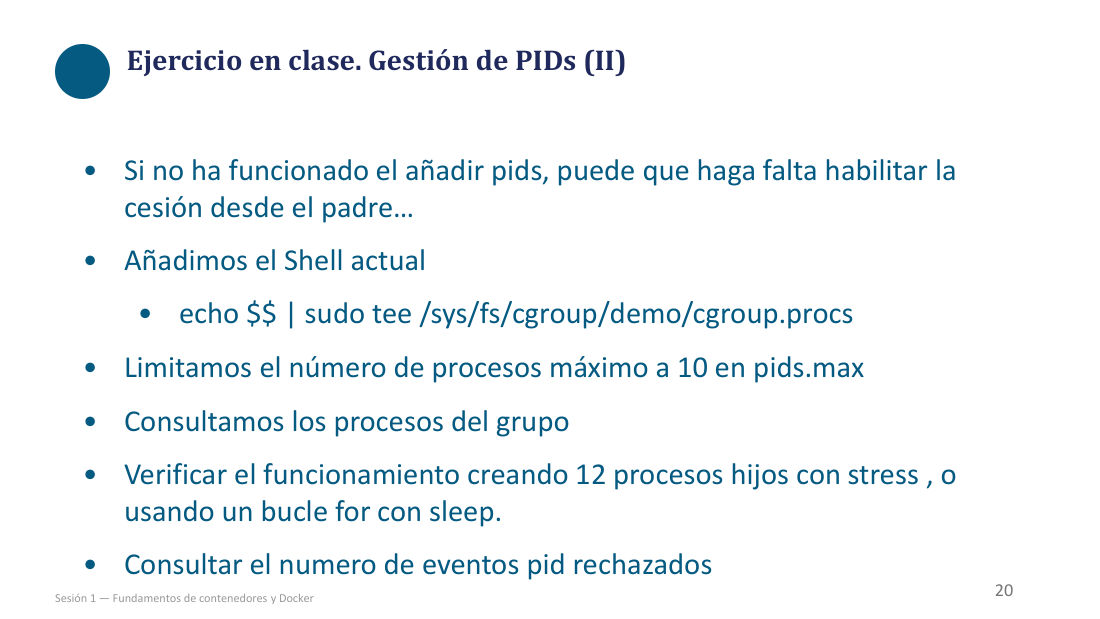
Ejercicio en clase. Gestión de PIDs (II)
课堂练习:PID 管理(第二页)。
Si no ha funcionado el añadir pids, puede que haga falta habilitar la cesión desde el padre…
如果加 pids 没成功,可能需要先从父组启用下传……
Añadimos el Shell actual
把当前 shell 加进去。
echo $$ | sudo tee /sys/fs/
echo $$ | sudo tee /sys/fs/
Limitamos el número de procesos máximo a 10 en
在
Consultamos los procesos del grupo
查看组内的进程。
Verificar el funcionamiento creando 12 procesos hijos con stress , o usando un bucle for con sleep.
用 stress 造 12 个子进程来验证,或者用一个带 sleep 的 for 循环。
Consultar el numero de eventos pid rechazados
查看被拒绝的 pid 事件次数。
Ejercicio en clase. Eliminacion de cgroup · 课堂练习:删除 cgroup
▸ 原页截图 p.21
Ejercicio en clase. Eliminacion de
课堂练习:删除
Con sudo rmdir, intentar eliminar el grupo demo
用 sudo rmdir 试着删掉 demo 组。
Si falla, eliminar todos los procesos del
如果失败,就把这个
21
讲义内部印的页码 21(与 PDF 物理页序一致)。
Ejercicio en clase. Manejo de grupos de control (I) · 课堂练习:控制组综合(一)
▸ 原页截图 p.22
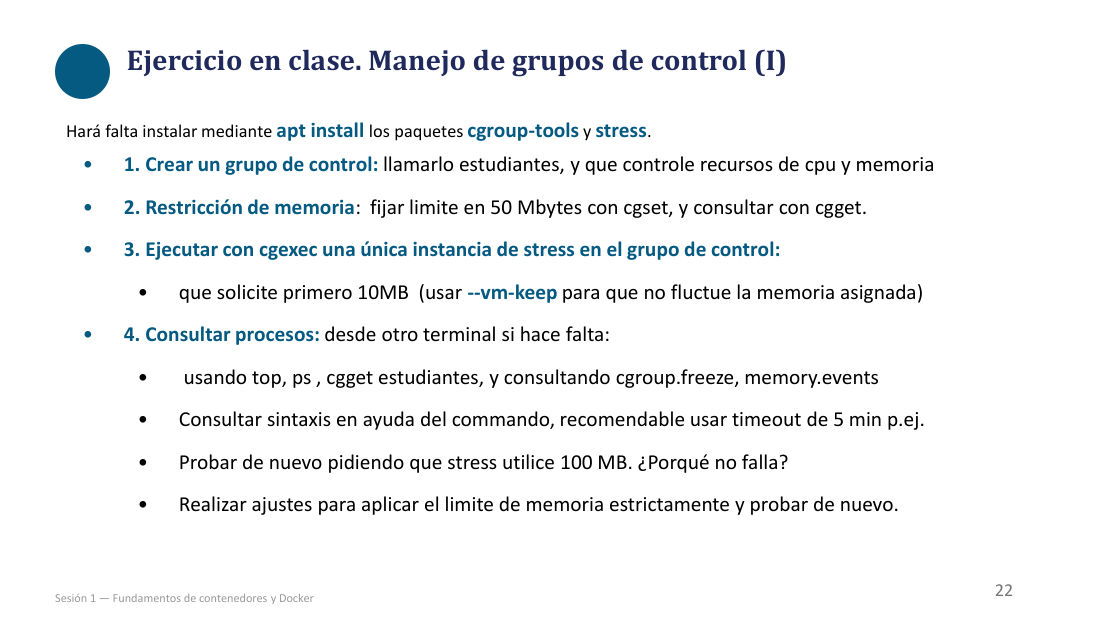
Ejercicio en clase. Manejo de
课堂练习:
Hará falta instalar mediante apt install los paquetes
需要先 apt install 安装
1. Crear un grupo de control: llamarlo estudiantes, y que controle recursos de cpu y memoria
1. 建一个控制组,命名为 estudiantes,管控 CPU 与内存资源。
2. Restricción de memoria: fijar limite en 50 Mbytes con cgset, y consultar con cgget.
2. 限制内存:用 cgset 把上限设为 50 MB,再用 cgget 查询。
3. Ejecutar con cgexec una única instancia de stress en el grupo de control:
3. 用 cgexec 在该控制组里跑一个 stress 实例:
que solicite primero 10MB (usar --vm-keep para que no fluctue la memoria asignada)
先让它申请 10MB(加 --vm-keep,让分配到的内存不来回波动)。
4. Consultar procesos: desde otro terminal si hace falta:
4. 查看进程:必要时另开一个终端。
usando top, ps , cgget estudiantes, y consultando
用 top、ps、cgget estudiantes,并查看
Consultar sintaxis en ayuda del commando, recomendable usar timeout de 5 min p.ej.
在命令的帮助里查语法,建议顺手加个 5 分钟的 timeout。
Probar de nuevo pidiendo que stress utilice 100 MB. ¿Porqué no falla?
再试一次,让 stress 用 100 MB。为什么它没崩?
Realizar ajustes para aplicar el limite de memoria estrictamente y probar de nuevo.
作出调整,让内存上限被严格生效,然后重新测试。
Ejercicio en clase. Manejo de grupos de control (II) · 课堂练习:控制组综合(二)
▸ 原页截图 p.23
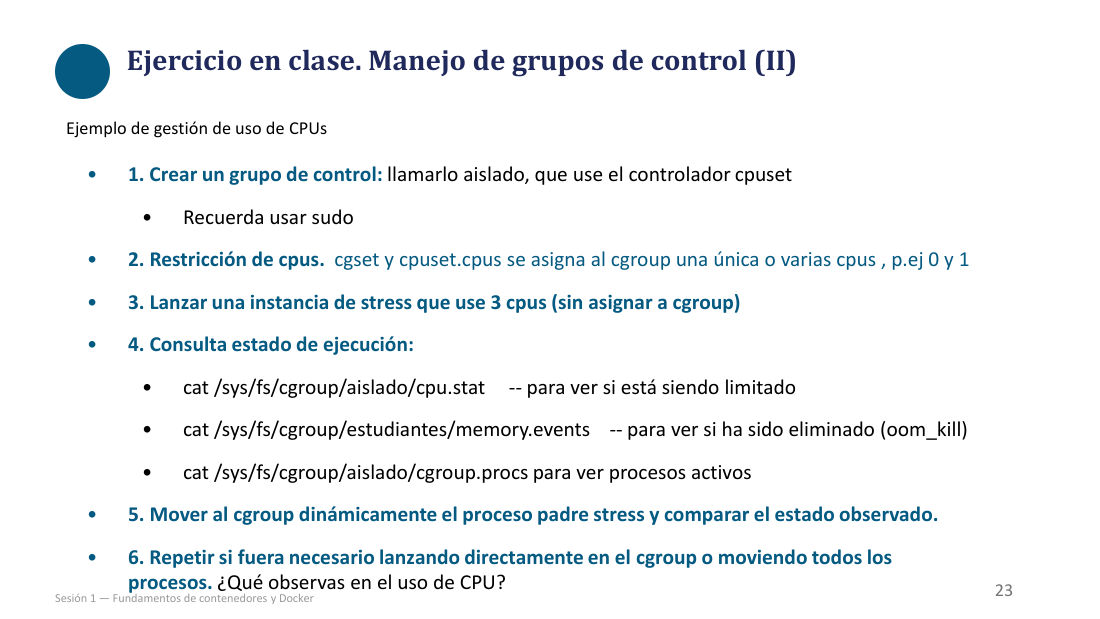
Ejercicio en clase. Manejo de
课堂练习:
Ejemplo de gestión de uso de CPUs
CPU 使用管理的示例。
1. Crear un grupo de control: llamarlo aislado, que use el
1. 建一个控制组,命名为 aislado,使用 cpuset
Recuerda usar sudo
记得加 sudo。
2. Restricción de cpus. cgset y
2. 限制 CPU:用 cgset 给该
3. Lanzar una instancia de stress que use 3 cpus (sin asignar a
3. 启动一个用 3 颗 CPU 的 stress 实例(先不放进
4. Consulta estado de ejecución:
4. 查看运行状态:
cat /sys/fs/
cat /sys/fs/
-- para ver si está siendo limitado
——看它是否正在被限流。
cat /sys/fs/
cat /sys/fs/
-- para ver si ha sido eliminado (oom_kill)
——看它是否已被 OOM 杀掉(oom_kill 计数)。
cat /sys/fs/
cat /sys/fs/
5. Mover al
5. 动态地把 stress 的父进程移进该
6. Repetir si fuera necesario lanzando directamente en el
6. 必要时重做:直接在
Consejos y referencias para los ejemplos · 示例操作技巧与参考
▸ 原页截图 p.24
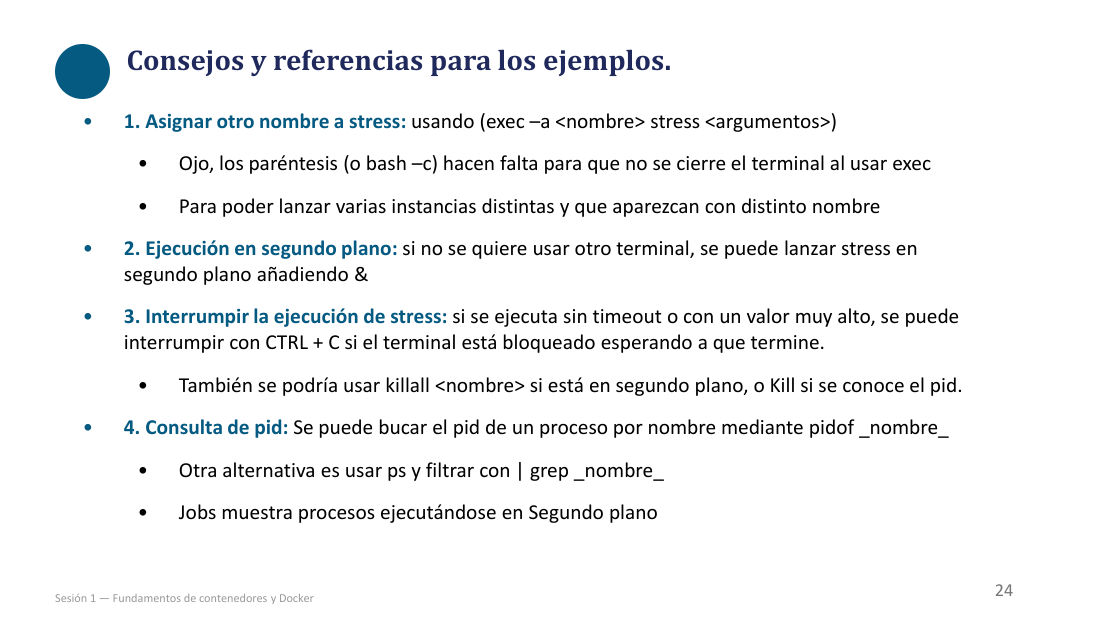
Consejos y referencias para los ejemplos.
示例操作的技巧与参考。
1. Asignar otro nombre a stress: usando (exec –a <nombre> stress <argumentos>)
1. 给 stress 换个进程名:用 (exec -a <nombre> stress <argumentos>)。
Ojo, los paréntesis (o bash –c) hacen falta para que no se cierre el terminal al usar exec
注意:必须加括号(或 bash -c),否则用了 exec 之后终端会被顶掉关闭。
Para poder lanzar varias instancias distintas y que aparezcan con distinto nombre
这样才能同时跑多个实例,并且它们在 ps 里显示不同名字。
2. Ejecución en segundo plano: si no se quiere usar otro terminal, se puede lanzar stress en segundo plano añadiendo &
2. 后台运行:不想另开终端的话,在命令末尾加 & 把 stress 放到后台。
3. Interrumpir la ejecución de stress: si se ejecuta sin timeout o con un valor muy alto, se puede interrumpir con CTRL + C si el terminal está bloqueado esperando a que termine.
3. 中断 stress:如果没加 timeout 或设得很大,而终端正卡在等它结束,用 CTRL + C 中断。
También se podría usar killall <nombre> si está en segundo plano, o Kill si se conoce el pid.
如果它在后台,也可以用 killall <nombre>;知道 PID 的话直接 kill。
4. Consulta de pid: Se puede bucar el pid de un proceso por nombre mediante pidof _nombre_
4. 查 PID:可以用 pidof <nombre> 按名字找进程的 PID。
Otra alternativa es usar ps y filtrar con | grep _nombre_
另一个办法是用 ps 配合 | grep <nombre> 过滤。
Jobs muestra procesos ejecutándose en Segundo plano
jobs 显示正在后台运行的进程。
三、前身技术之二:namespaces —— 看得见什么
p.25–p.35Control Groups y Contenedores · 控制组与容器
▸ 原页截图 p.25
Hemos visto que los
前面已经看到,
Esto se aprovecha en los entornos de ejecución de contenedores
容器的运行时环境正是利用了这一点。
Un
一个
De esa forma todos los recursos de sus subprocesos pueden gestionarse de forma conjunta
这样它所有子进程占用的资源就能被统一管理。
Namespaces (Espacios de Nombres) · 命名空间
▸ 原页截图 p.26
Un Namespace es una funcionalidad del kernel de linux que permite aislar grupos de procesos y controlar su visibilidad y acceso a los recursos del sistema, protegiendo asi al sistema.
Namespace(命名空间)是 Linux 内核的一项功能,用来隔离进程组,控制它们对系统资源的可见性与访问权,从而保护整个系统。
Lo usan tecnologías como docker o
Docker、
Se pueden crear vistas limitadas de los recursos, incluyendo:
可以创建出资源的「受限视图」,包括:
Control groups(cgroups), identificadores de procesos (PIDs), mecanismos de comunicación (IPC), interfaces de red, tablas de enrutamiento, …
控制组(cgroups)、进程标识符(PID)、进程间通信机制(IPC)、网络接口、路由表……
Los recursos asignados a un
分配给某个
Puede haber distintos niveles de
命名空间之间的
Referencias: Linux foundation, https://es.wikipedia.org/wiki/Espacio_de_nombres_Linux
参考:Linux Foundation;西语维基条目 Espacio de nombres (Linux)。
Namespaces. Tipos (I) · 命名空间类型(一)
▸ 原页截图 p.27
Existen distintos tipos de espacios de nombres
命名空间有多种类型。
mnt: controla lo spuntos de montaje.
mnt:管理挂载点。
pid: crea un conjunto de IDs de proceso separado de otros espacios.
pid:创建一套与其它空间彼此独立的进程 ID 集合。
Se pueden repetir IDs en distintos espacios, son independientes.
不同空间里可以出现重复的 ID,因为它们互相独立。
Están anidados, el padre puede verlos todos, pero con distinto ID
它们是嵌套的:父空间能看到全部子进程,只是编号不同。
El PID 1 de cada espacio de PID se gestiona como proceso de inicio, y termina todos los procesos del espacio si se cierra
每个 PID 空间里的 PID 1 被当作 init 进程处理;它一旦结束,该空间内所有进程都会被终止。
net:Virtualiza la pila de red. Empiezan con un interfaz de loopback.
net:虚拟化网络栈。新建时只有一个 loopback 接口。
Un interfaz se asocia solo a un espacio, pero se puede mover.
一个接口同一时间只属于一个空间,但可以移动过去。
Cada espacio tiene sus direcciones, sockets, tablas de rutas, …
每个空间都有自己的地址、socket、路由表……
ipc: gestiona comunicación entre procesos sin necesidad de usar memoria compartida.
ipc:管理进程间通信,不必依赖共享内存。
Namespaces. Tipos (II) · 命名空间类型(二)
▸ 原页截图 p.28
Más tipos de espacios de nombres:
更多类型的命名空间:
uts: permiten que un sistema parezca tener múltiples nombres de host y de dominio para distintos procesos.
uts:让同一个系统对不同进程呈现出不同的主机名与域名。
User: permiten
user:实现权限与用户身份的
Hay herencia entre espacios anidados
嵌套的空间之间存在继承关系。
Se mapean al sistema mediante tablas
通过映射表与真实系统建立对应关系。
cgroups: el espacio de nombres
time: permite ver diferentes tiempos de sistema
time:让不同空间看到不同的系统时间(含开机时间与单调时钟)。
syslog (propuesto): se creó journal
syslog(提案中):systemd 由此做成了 journal
IMA ( propuesto ): planea añadir verificación criptográfica de ficheros.
IMA(提案中):计划加入文件的加密校验(完整性度量)。
Namespaces. Operaciones y Utilidades (I) · 操作与工具(一)
▸ 原页截图 p.29
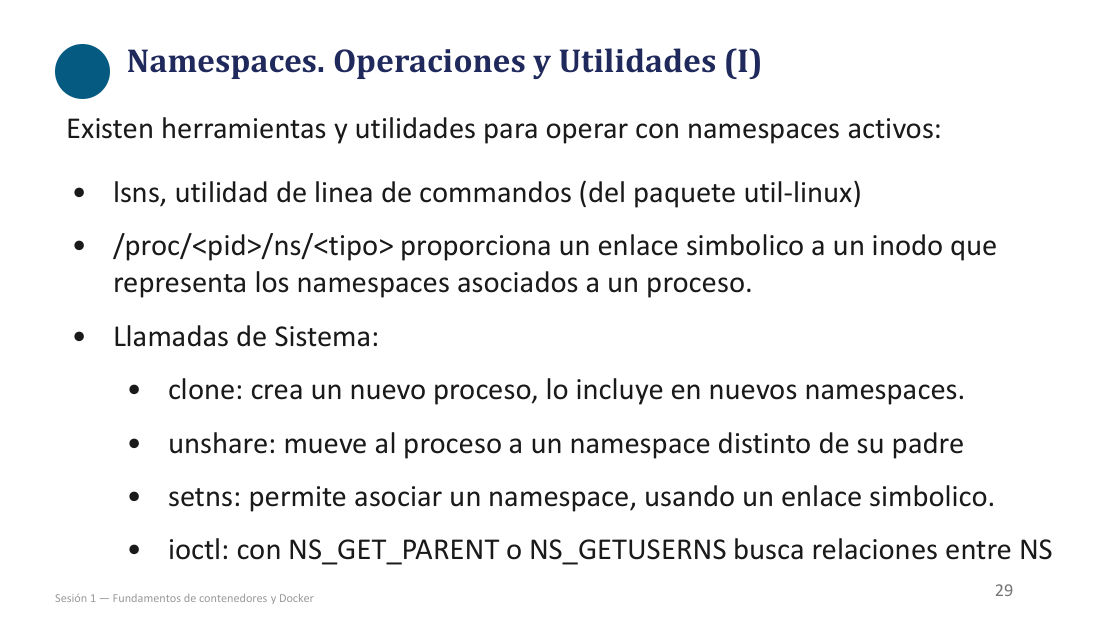
Existen herramientas y utilidades para operar con namespaces activos:
有一些工具和实用程序可以用来操作正在运行的命名空间:
Llamadas de Sistema:
系统调用:
clone: crea un nuevo proceso, lo incluye en nuevos namespaces.
clone:创建新进程,并让它进入新的命名空间。
ioctl: con NS_GET_PARENT o NS_GETUSERNS busca relaciones entre NS
ioctl:用 NS_GET_PARENT 或 NS_GET_USERNS 查询命名空间之间的父子/所属关系。
Namespaces. Operaciones y Utilidades (II) · 操作与工具(二)
▸ 原页截图 p.30
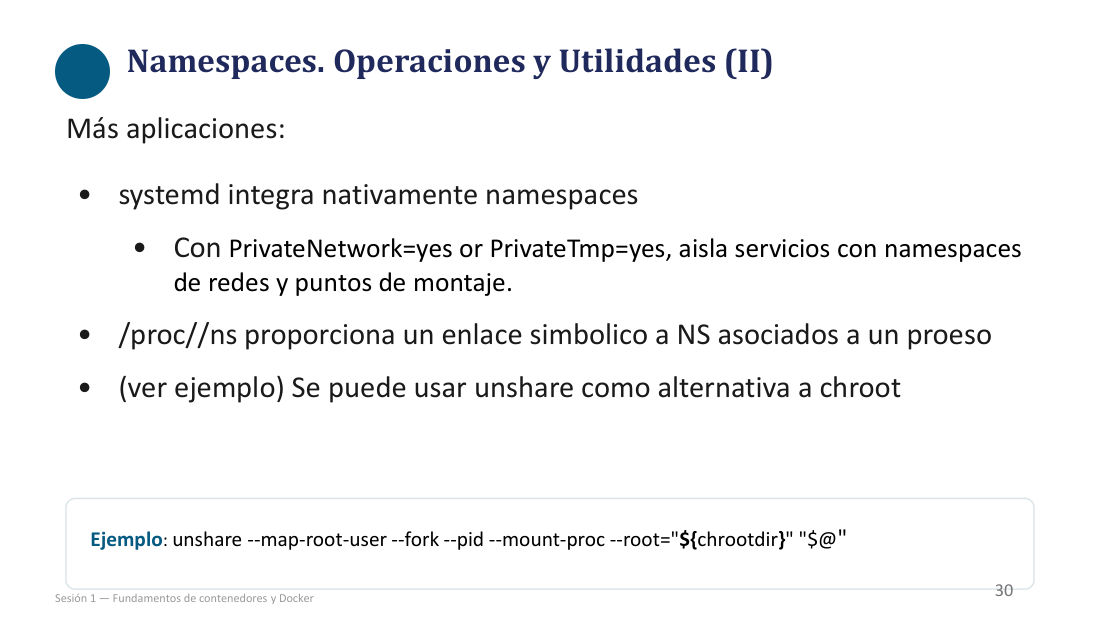
Más aplicaciones:
更多应用方式:
systemd integra nativamente namespaces
systemd 原生集成了命名空间。
Con PrivateNetwork=yes or PrivateTmp=yes, aisla servicios con namespaces de redes y puntos de montaje.
用 PrivateNetwork=yes 或 PrivateTmp=yes,就能借助网络与挂载点命名空间把服务隔离起来。
/proc//ns proporciona un enlace simbolico a NS asociados a un proeso
/proc/<pid>/ns 提供符号链接,指向某个进程所关联的命名空间。
(ver ejemplo) Se puede usar
(见示例)可以用
Ejemplo:
示例:
Ejemplo: creando un namespace en carpeta root virtual (I) · 示例:在虚拟根目录里造一个命名空间(一)
▸ 原页截图 p.31
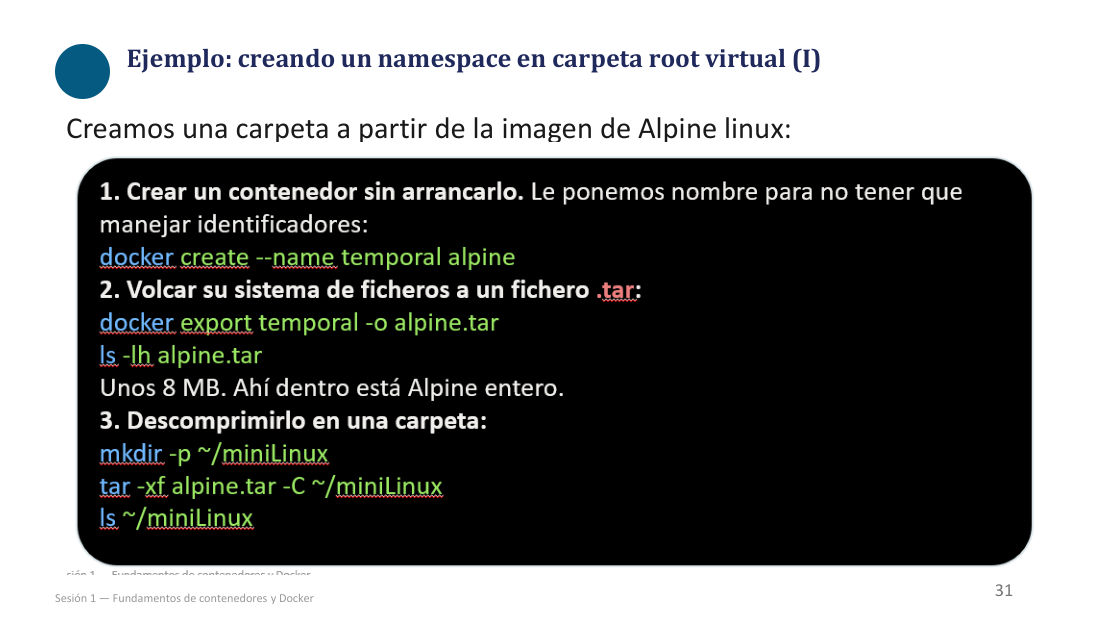
Creamos una carpeta a partir de la
从一个 Alpine Linux
1. Crear un
1. 创建一个
docker create --name temporal alpine
docker create --name temporal alpine
2. Volcar su sistema de ficheros a un fichero .
2. 把它的文件系统导出成一个 .
docker export temporal -o alpine.
docker export temporal -o alpine.
ls -lh alpine.
ls -lh alpine.
Unos 8 MB. Ahí dentro está Alpine entero.
大约 8 MB,整个 Alpine 就在里面。
3. Descomprimirlo en una carpeta:
3. 把它解压到一个目录里。
mkdir -p ~/miniLinux
mkdir -p ~/miniLinux
ls ~/miniLinux
ls ~/miniLinux
1. Crear un contenedor sin arrancarlo. Le ponemos nombre para no tener que
manejar identificadores:
docker create --name temporal alpine
2. Volcar su sistema de ficheros a un fichero .tar:
docker export temporal -o alpine.tar
ls -lh alpine.tar
Unos 8 MB. Ahí dentro está Alpine entero.
3. Descomprimirlo en una carpeta:
mkdir -p ~/miniLinux
tar -xf alpine.tar -C ~/miniLinux
ls ~/miniLinux
Ejemplo: creando un namespace en carpeta root virtual (II) · 示例:在虚拟根目录里造一个命名空间(二)
▸ 原页截图 p.32
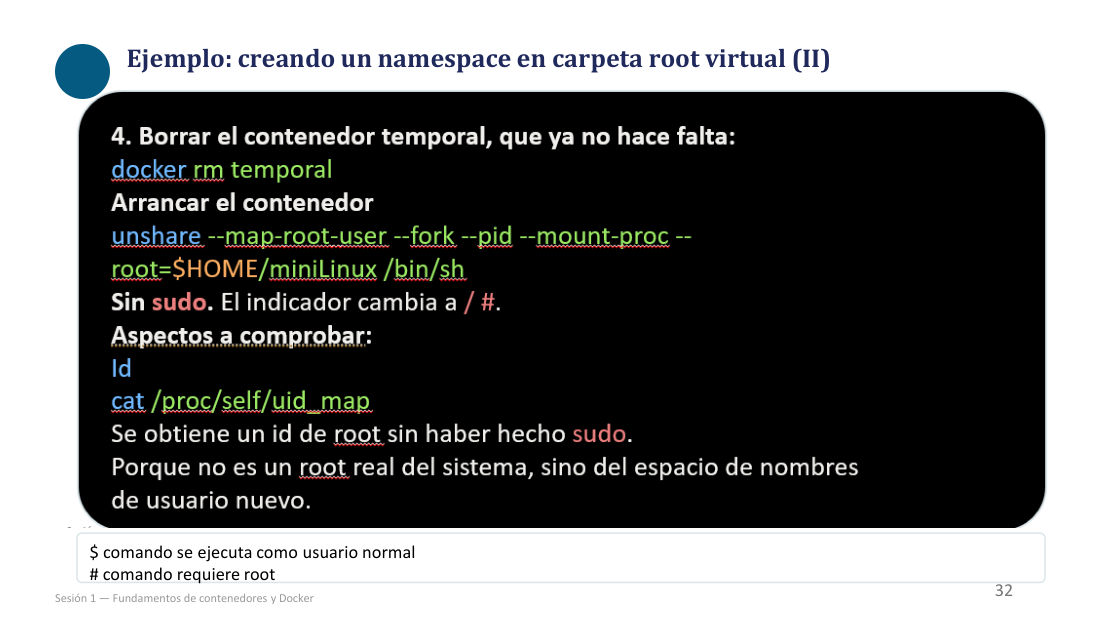
4. Borrar el
4. 删掉那个临时
docker rm temporal
docker rm temporal
Arrancar el
启动「
Sin sudo. El indicador cambia a / #.
不用 sudo。提示符会变成 / #。
Aspectos a comprobar:
要检查的几点:
id
id
cat /proc/self/uid_map
cat /proc/self/uid_map
Se obtiene un id de
没敲 sudo 却拿到了
Porque no es un
因为它不是系统里真正的
$ comando se ejecuta como usuario normal
$ 表示以普通用户执行。
# comando requiere
# 表示需要
4. Borrar el contenedor temporal, que ya no hace falta:
docker rm temporal
Arrancar el contenedor
unshare --map-root-user --fork --pid --mount-proc --
root=$HOME/miniLinux /bin/sh
Sin sudo. El indicador cambia a / #.
Aspectos a comprobar:
id
cat /proc/self/uid_map
Se obtiene un id de root sin haber hecho sudo.
Porque no es un root real del sistema, sino del espacio de nombres
de usuario nuevo.

$ comando se ejecuta como usuario normal
# comando requiere root
Ejemplo: creando un namespace en carpeta root virtual (III) · 示例:在虚拟根目录里造一个命名空间(三)
▸ 原页截图 p.33
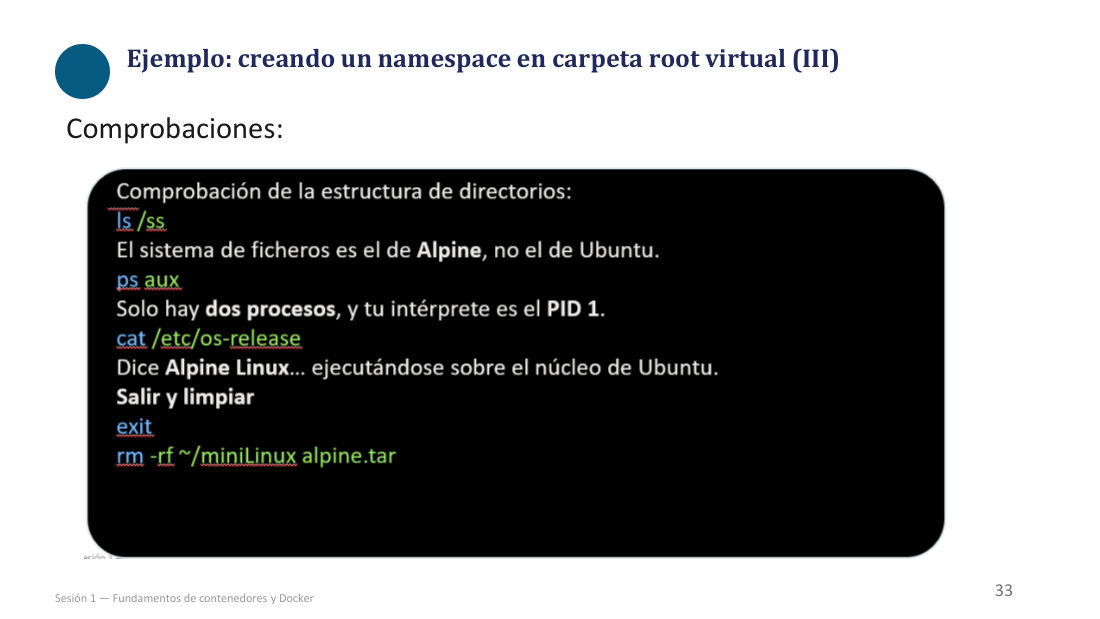
Comprobaciones:
检查项:
Comprobación de la estructura de directorios:
检查目录结构:
ls /ss
ls /
El sistema de ficheros es el de Alpine, no el de Ubuntu.
看到的文件系统是 Alpine 的,不是 Ubuntu 的。
ps aux
ps aux
Solo hay dos procesos, y tu intéprete es el PID 1.
只有两个进程,而且你的解释器就是 PID 1。
cat /etc/os-release
cat /etc/os-release
Dice Alpine Linux… ejecutándose sobre el núcleo de Ubuntu.
它显示 Alpine Linux……但实际跑在 Ubuntu 的内核上。
Salir y limpiar
退出并清理:
exit
exit
rm -rf ~/miniLinux alpine.
rm -rf ~/miniLinux alpine.
Comprobación de la estructura de directorios:
ls /ss
El sistema de ficheros es el de Alpine, no el de Ubuntu.
ps aux
Solo hay dos procesos, y tu intéprete es el PID 1.
cat /etc/os-release
Dice Alpine Linux… ejecutándose sobre el núcleo de Ubuntu.
Salir y limpiar
exit
rm -rf ~/miniLinux alpine.tar
Ejemplo: creando un namespace en carpeta root virtual (IV) · 示例:在虚拟根目录里造一个命名空间(四)
▸ 原页截图 p.34
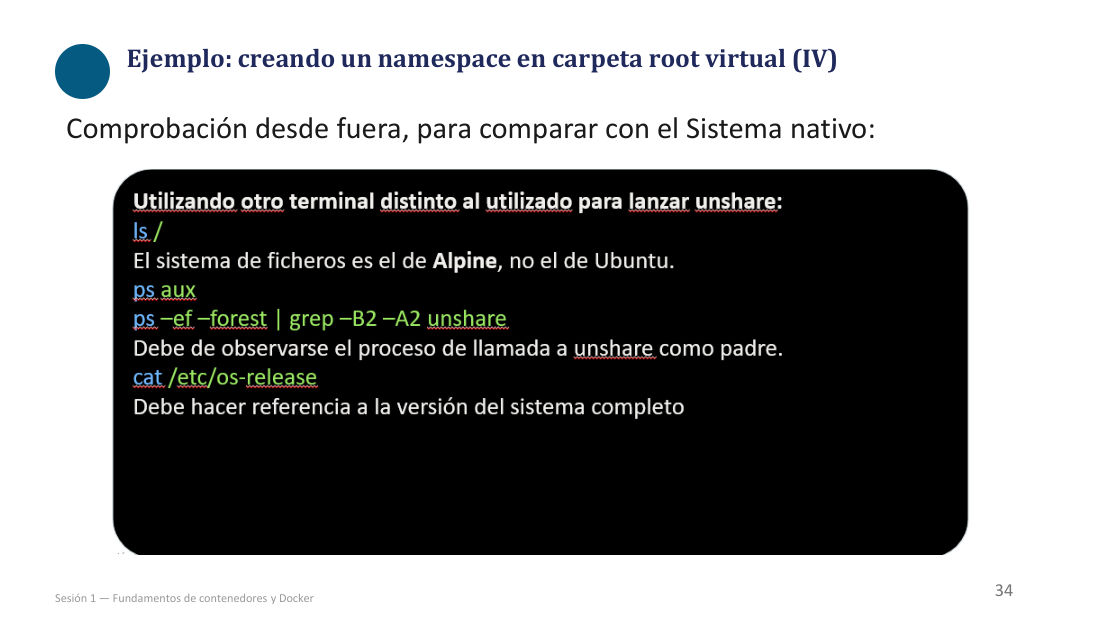
Comprobación desde fuera, para comparar con el Sistema nativo:
从外面(宿主机)再看一遍,和原生系统作对比:
Utilizando otro terminal distinto al utilizado para lanzar
另开一个终端,不要用启动
ls /
ls /
El sistema de ficheros es el de Alpine, no el de Ubuntu.
(原文如此)这里写的仍然是「文件系统是 Alpine 的」。
ps aux
ps aux
ps –ef –forest | grep –B2 –A2
ps -ef --forest | grep -B2 -A2
Debe observarse el proceso de llamada a
应该能看到调用
cat /etc/os-release
cat /etc/os-release
Debe hacer referencia a la versión del sistema completo
它应当指向完整系统(宿主机)的版本。
Utilizando otro terminal distinto al utilizado para lanzar unshare:
ls /
El sistema de ficheros es el de Alpine, no el de Ubuntu.
ps aux
ps –ef –forest | grep –B2 –A2 unshare
Debe observarse el proceso de llamada a unshare como padre.
cat /etc/os-release
Debe hacer referencia a la versión del sistema completo
Ejemplo de comunicación entre espacios de nombre de red · 示例:网络命名空间之间的通信
▸ 原页截图 p.35(页脚印 39)
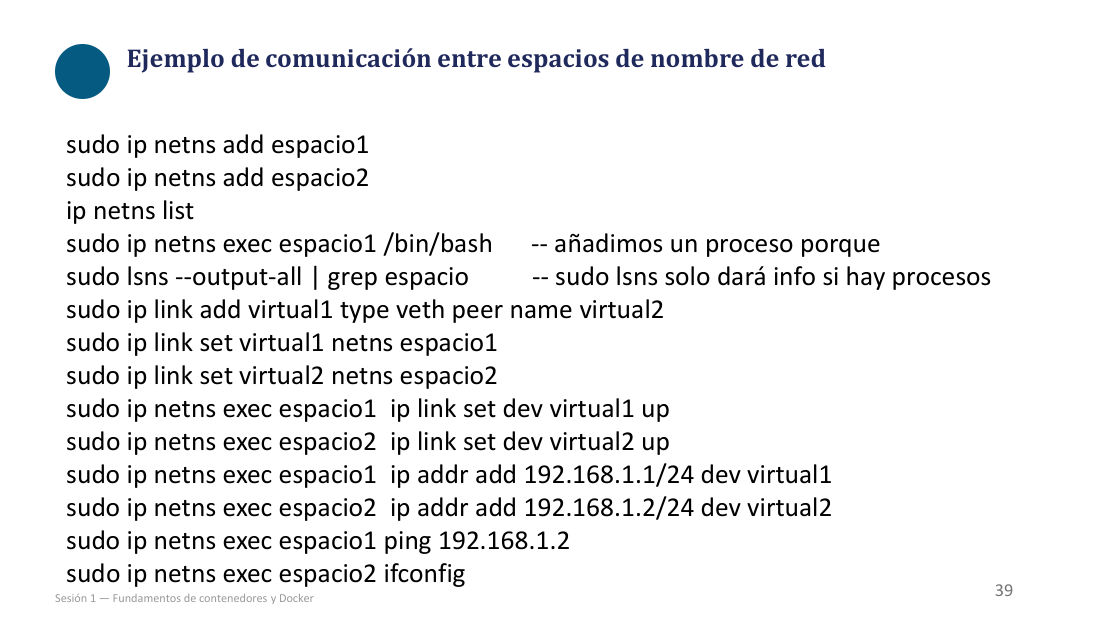
sudo ip netns add espacio1
sudo ip netns add espacio1——建第一个网络空间。
sudo ip netns add espacio2
sudo ip netns add espacio2——建第二个。
ip netns list
ip netns list——列出已存在的网络空间。
sudo ip netns exec espacio1 /bin/bash -- añadimos un proceso porque
sudo ip netns exec espacio1 /bin/bash——先在里面起一个进程,因为……
sudo
sudo
sudo ip link add virtual1 type veth peer name virtual2
sudo ip link add virtual1 type veth peer name virtual2——造一对 veth 虚拟网线。
sudo ip link set virtual1 netns espacio1
sudo ip link set virtual1 netns espacio1——把一头塞进 espacio1。
sudo ip link set virtual2 netns espacio2
sudo ip link set virtual2 netns espacio2——另一头塞进 espacio2。
sudo ip netns exec espacio1 ip link set dev virtual1 up
在 espacio1 里启用 virtual1。
sudo ip netns exec espacio2 ip link set dev virtual2 up
在 espacio2 里启用 virtual2。
sudo ip netns exec espacio1 ip addr add 192.168.1.1/24 dev virtual1
给 virtual1 配地址 192.168.1.1/24。
sudo ip netns exec espacio2 ip addr add 192.168.1.2/24 dev virtual2
给 virtual2 配同网段的 192.168.1.2/24。
sudo ip netns exec espacio1 ping 192.168.1.2
从 espacio1 里 ping espacio2 的地址。
sudo ip netns exec espacio2 ifconfig
最后在 espacio2 里 ifconfig 看接口状态。
sudo ip netns add espacio1
sudo ip netns add espacio2
ip netns list
sudo ip netns exec espacio1 /bin/bash      -- añadimos un proceso porque
sudo lsns --output-all | grep espacio          -- sudo lsns solo dará info si hay procesos
sudo ip link add virtual1 type veth peer name virtual2
sudo ip link set virtual1 netns espacio1
sudo ip link set virtual2 netns espacio2
sudo ip netns exec espacio1  ip link set dev virtual1 up
sudo ip netns exec espacio2  ip link set dev virtual2 up
sudo ip netns exec espacio1  ip addr add 192.168.1.1/24 dev virtual1
sudo ip netns exec espacio2  ip addr add 192.168.1.2/24 dev virtual2
sudo ip netns exec espacio1 ping 192.168.1.2
sudo ip netns exec espacio2 ifconfig
Union File System · 联合文件系统(章节页)
▸ 原页截图 p.36(页脚印 40)
Union File System
联合文件系统(Union File System)。
Más aplicaciones:
(原文正文,疑为沿用)更多应用方式:
systemd integra nativamente namespaces
systemd 原生集成命名空间。
Con PrivateNetwork=yes or PrivateTmp=yes, aisla servicios con namespaces de redes y puntos de montaje.
用 PrivateNetwork=yes 或 PrivateTmp=yes 通过网络与挂载点命名空间隔离服务。
/proc/<pid>/ns proporciona un enlace simbolico a NS asociados a un proeso
/proc/<pid>/ns 提供指向进程所关联命名空间的符号链接。
四、第三块基石:UnionFS / OverlayFS —— 写在哪
p.36–p.39Union File System / OverlayFS · 联合文件系统 / OverlayFS(一)
▸ 原页截图 p.37(页脚印 41)
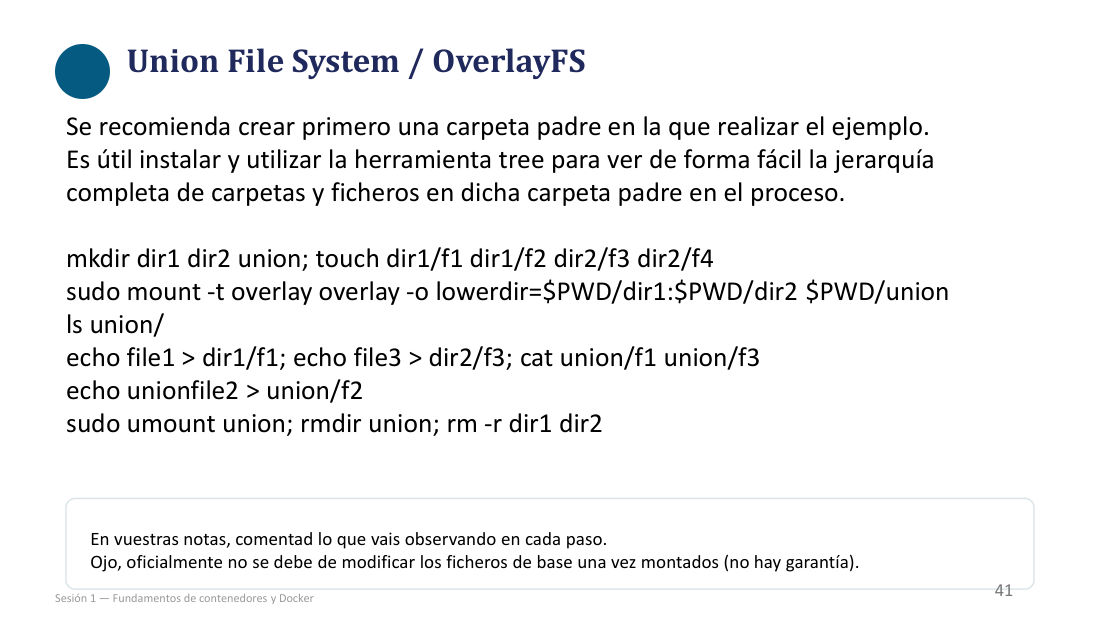
Se recomienda crear primero una carpeta padre en la que realizar el ejemplo.
建议先建一个父目录,把实验都放在里面做。
Es útil instalar y utilizar la herramienta tree para ver de forma fácil la jerarquía completa de carpetas y ficheros en dicha carpeta padre en el proceso.
装个 tree 工具会很有用,能一眼看清这个父目录里完整的目录与文件层级。
mkdir dir1 dir2 union; touch dir1/f1 dir1/f2 dir2/f3 dir2/f4
建 dir1、dir2、union 三个目录,再在里面造 4 个空文件。
sudo mount -t overlay overlay -o lowerdir=$PWD/dir1:$PWD/dir2 $PWD/union
把 dir1 与 dir2 作为两层 lower,叠加挂载到 union。
ls union/
ls union/——两层的文件同时出现。
echo file1 > dir1/f1; echo file3 > dir2/f3; cat union/f1 union/f3
往两个底层目录里写内容,再从叠加视图里读出来。
echo unionfile2 > union/f2
试着通过叠加视图写文件。
sudo umount union; rmdir union; rm -r dir1 dir2
卸载并清理:umount → rmdir → rm -r。
En vuestras notas, comentad lo que vais observando en cada paso.
在笔记里记录每一步观察到什么。
Ojo, oficialmente no se debe de modificar los ficheros de base una vez montados (no hay garantía).
注意:挂载之后,官方规定不应再改动底层文件(没有一致性保证)。
mkdir dir1 dir2 union; touch dir1/f1 dir1/f2 dir2/f3 dir2/f4
sudo mount -t overlay overlay -o lowerdir=$PWD/dir1:$PWD/dir2 $PWD/union
ls union/
echo file1 > dir1/f1; echo file3 > dir2/f3; cat union/f1 union/f3
echo unionfile2 > union/f2
sudo umount union; rmdir union; rm -r dir1 dir2
Union File System / OverlayFS · 联合文件系统 / OverlayFS(二)
▸ 原页截图 p.38(页脚印 42)
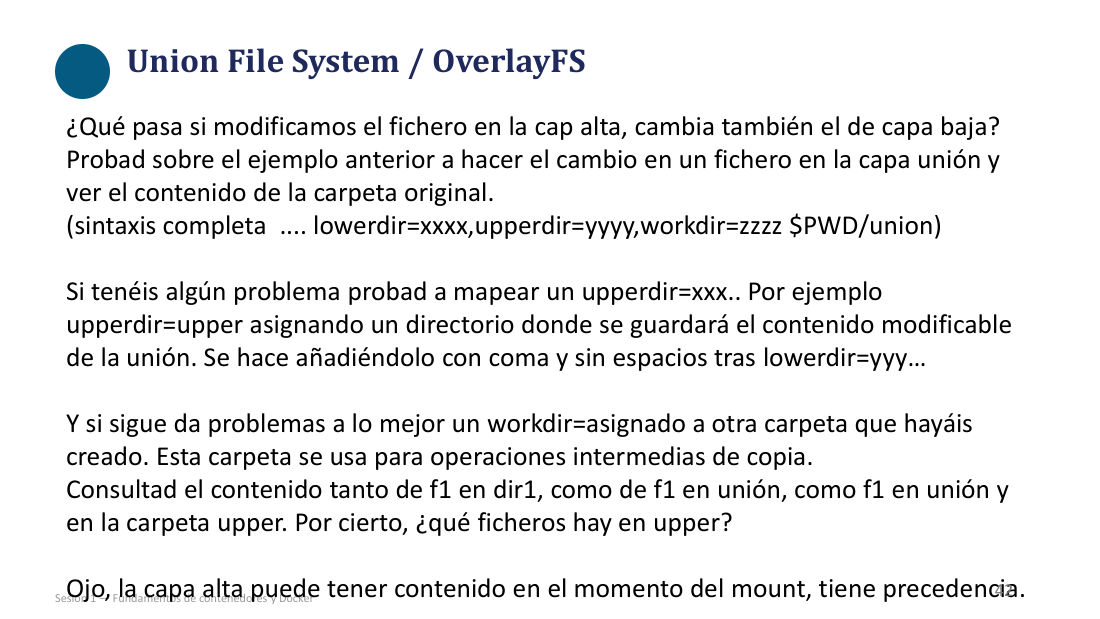
¿Qué pasa si modificamos el fichero en la cap alta, cambia también el de
如果在高
Probad sobre el ejemplo anterior a hacer el cambio en un fichero en la
在上一个例子的基础上,通过叠加
(sintaxis completa .... lowerdir=xxxx,upperdir=yyyy,workdir=zzzz $PWD/union)
完整的语法:lowerdir=xxxx,upperdir=yyyy,workdir=zzzz $PWD/union。
Si tenéis algún problema probad a mapear un upperdir=xxx.. Por ejemplo upperdir=upper asignando un directorio donde se guardará el contenido modificable de la unión.
如果出问题,就显式指定 upperdir,例如 upperdir=upper,这个目录用来存放叠加层里可被修改的内容。
Se hace añadiéndolo con coma y sin espacios tras lowerdir=yyy…
写法是紧跟在 lowerdir=yyy 之后,用逗号连接、不能有空格。
Y si sigue da problemas a lo mejor un workdir=asignado a otra carpeta que hayáis creado.
要是还不行,再给 workdir 指定一个你另外建好的目录。
Esta carpeta se usa para operaciones intermedias de copia.
这个目录用于「复制」时的中间操作(copy-up 的暂存区)。
Consultad el contenido tanto de f1 en dir1, como de f1 en unión, como f1 en unión y en la carpeta upper.
对比查看:dir1 里的 f1、叠加层里的 f1、以及 upper 目录里的 f1。
Por cierto, ¿qué ficheros hay en upper?
顺便问一句:upper 里到底有哪些文件?
Ojo, la
注意:挂载那一刻高
Union File System / OverlayFS · 联合文件系统 / OverlayFS(内核文档佐证)
▸ 原页截图 p.39(页脚印 43)
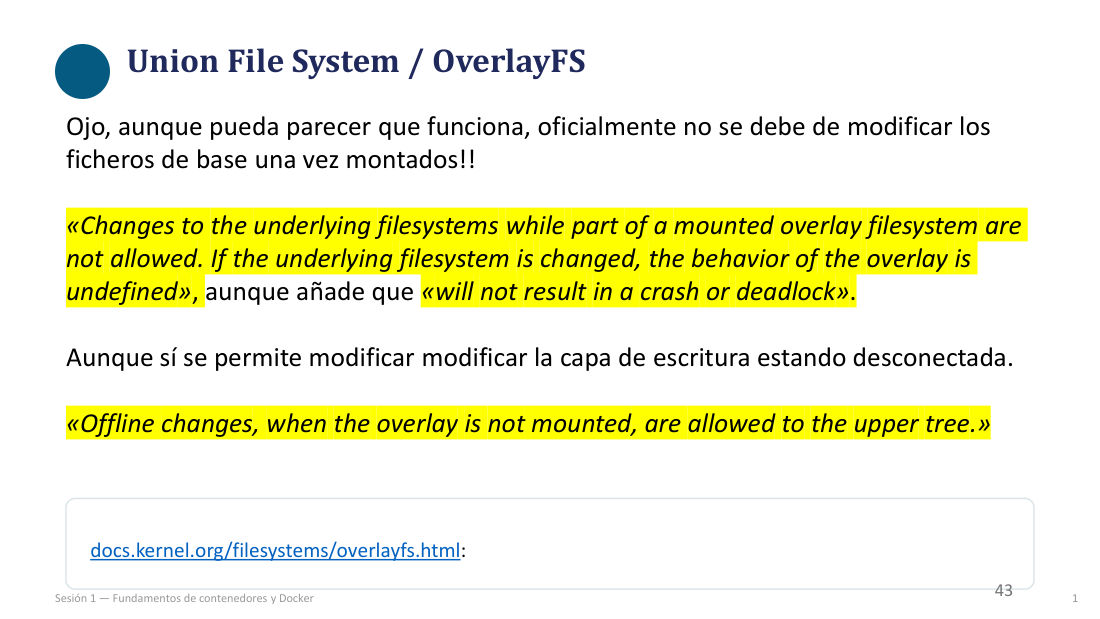
Ojo, aunque pueda parecer que funciona, oficialmente no se debe de modificar los ficheros de base una vez montados!!
注意:即便看起来能跑通,官方也明确不许在挂载后修改底层文件!
«Changes to the underlying filesystems while part of a mounted overlay filesystem are not allowed. If the underlying filesystem is changed, the behavior of the overlay is undefined»
「当某个文件系统已作为已挂载 overlay 的一部分时,不允许修改其底层文件系统。若底层被改动,overlay 的行为是未定义的。」
aunque añade que «will not result in a crash or deadlock».
不过文档补充说「不会因此崩溃或死锁」。
Aunque sí se permite modificar modificar la
但在未挂载的状态下,是允许修改可写
«Offline changes, when the overlay is not mounted, are allowed to the upper tree.»
「离线修改——即 overlay 未挂载时——对 upper 树是允许的。」
docs.kernel.org/filesystems/overlayfs.html:
出处:docs.kernel.org/filesystems/overlayfs.html。
五、前身机制:chroot / systemd-nspawn / LXC
p.40–p.481b · Antecedentes. Mecanismos previos de virtualización · 1b 前史:此前的虚拟化机制
▸ 原页截图 p.40(页脚印 44)
1b
1b——课程第 1 部分的第二个小节。
Antecedentes.
前史 / 背景。
Mecanismos previous de virtualizacion:
此前的虚拟化机制:
Duración: 2 horas — teoría con tareas cortas intercaladas
时长:2 小时——理论讲解中穿插短任务。
chroot · chroot 换根隔离
▸ 原页截图 p.41(页脚印 45)
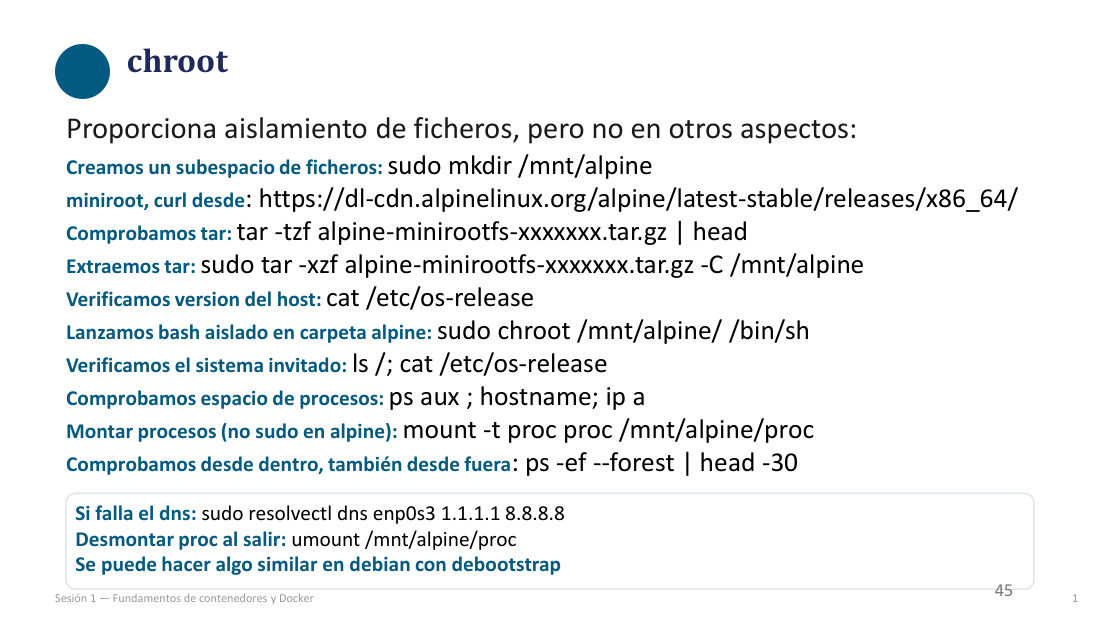
Proporciona
它只提供文件系统层面的
Creamos un subespacio de ficheros: sudo mkdir /mnt/alpine
建一个文件子空间:sudo mkdir /mnt/alpine。
miniroot, curl desde: https://dl-cdn.alpinelinux.org/alpine/
用 curl 下载 miniroot:https://dl-cdn.alpinelinux.org/alpine/
Comprobamos
先看看包里有什么:
Extraemos
解压到目标目录:sudo
Verificamos version del host: cat /etc/os-release
先确认宿主机版本:cat /etc/os-release。
Lanzamos bash aislado en carpeta alpine: sudo
在 alpine 目录里启动隔离的 shell:sudo
Verificamos el sistema invitado: ls /; cat /etc/os-release
验证「来宾」系统:ls / 与 cat /etc/os-release。
Comprobamos espacio de procesos: ps aux ; hostname; ip a
检查进程空间与网络:ps aux、hostname、ip a。
Montar procesos (no sudo en alpine): mount -t proc proc /mnt/alpine/proc
挂载 proc(alpine 里没有 sudo,用 root 直接执行):mount -t proc proc /mnt/alpine/proc。
Comprobamos desde dentro, también desde fuera: ps -ef --forest | head -30
从里面看、也从外面看:ps -ef --forest | head -30。
Si falla el dns: sudo resolvectl dns enp0s3 1.1.1.1 8.8.8.8
DNS 不通时:sudo resolvectl dns enp0s3 1.1.1.1 8.8.8.8。
Desmontar proc al salir: umount /mnt/alpine/proc
退出前卸载 proc:umount /mnt/alpine/proc。
Se puede hacer algo similar en debian con debootstrap
在 Debian 上可以用 debootstrap 做类似的事。
systemd-nspawn (I) · systemd-nspawn(一)
▸ 原页截图 p.42(页脚印 46)
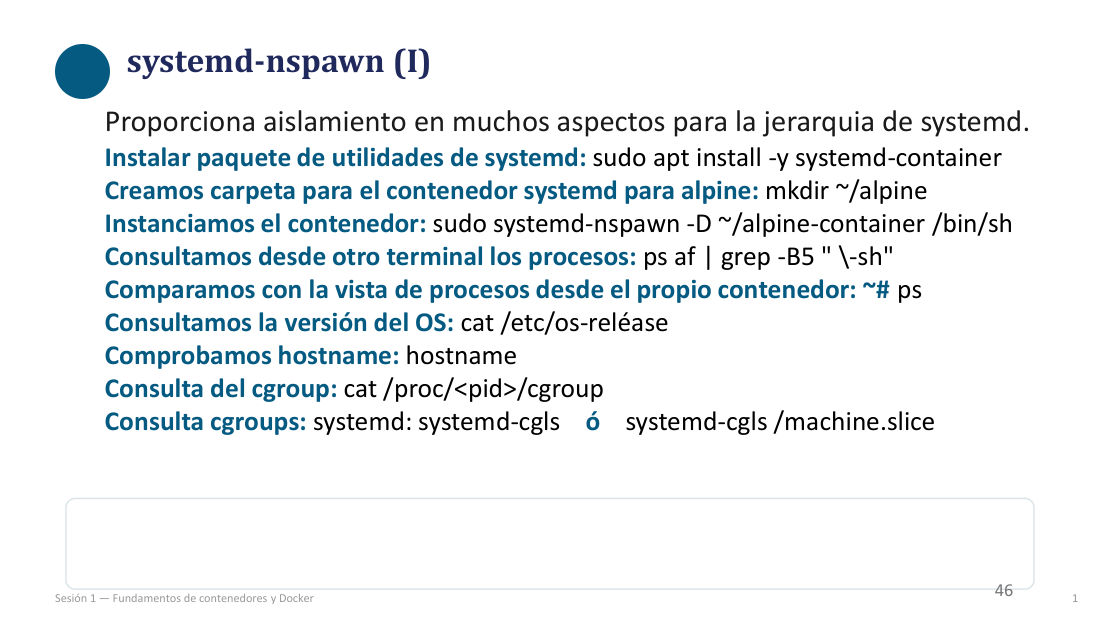
Proporciona
对 systemd 的层级体系提供多方面的
Instalar paquete de utilidades de systemd: sudo apt install -y systemd-container
安装 systemd 工具包:sudo apt install -y systemd-container。
Creamos carpeta para el
给 alpine 的
Instanciamos el
实例化
Consultamos desde otro terminal los procesos: ps af | grep -B5 " \-sh"
在另一个终端查进程:ps af | grep -B5 " -sh"。
Comparamos con la
再和
Consultamos la versión del OS: cat /etc/os-reléase
查操作系统版本:cat /etc/os-release。
Comprobamos hostname: hostname
查主机名:hostname。
Consulta del
查
Consulta cgroups: systemd: systemd-cgls
用 systemd 查 cgroups:systemd-cgls……
ó
或者……
systemd-cgls /machine.slice
systemd-cgls /machine.slice(nspawn 的容器都挂在 machine.slice 下)。
Para lanzar un proceso en el mismo entorno de otro proceso · 在另一个进程的环境里启动进程(nsenter)
▸ 原页截图 p.43(页脚印 47)
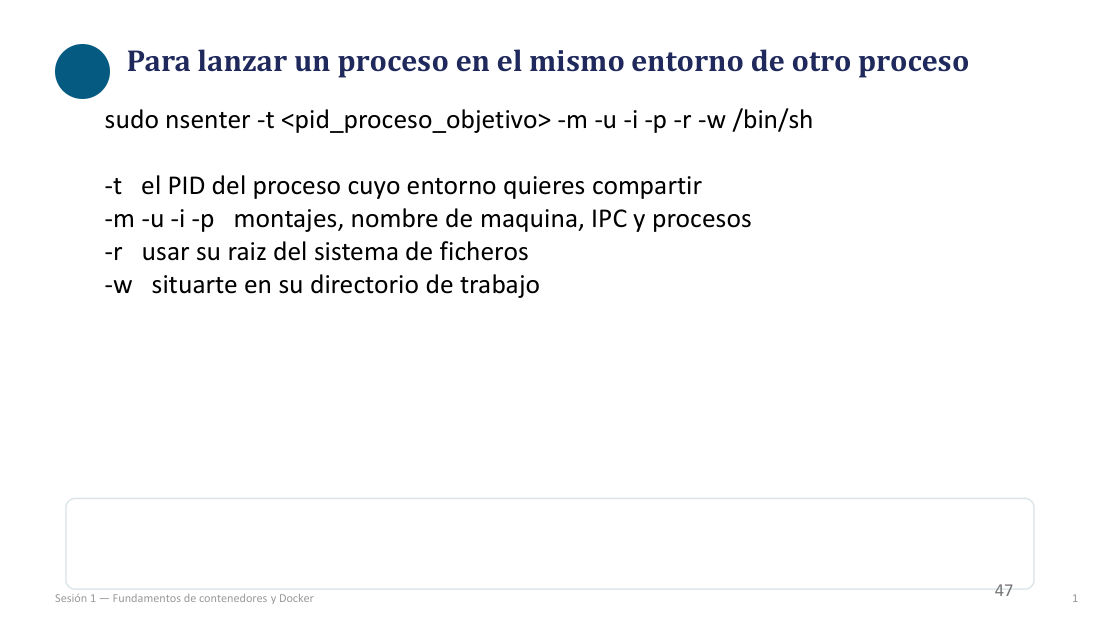
Para lanzar un proceso en el mismo entorno de otro proceso
要想在另一个进程的同一套环境里启动一个新进程:
sudo
sudo
-t el PID del proceso cuyo entorno quieres compartir
-t:目标进程的 PID,也就是你想共享其环境的那个进程。
-m -u -i -p montajes, nombre de maquina, IPC y procesos
-m -u -i -p:分别对应挂载点、主机名(uts)、IPC 与进程(pid)命名空间。
-r usar su raiz del sistema de ficheros
-r:使用它的文件系统根目录(root)。
-w situarte en su directorio de trabajo
-w:把自己放到它的工作目录里。
systemd-nspawn (II) · systemd-nspawn(二)
▸ 原页截图 p.44(页脚印 48)
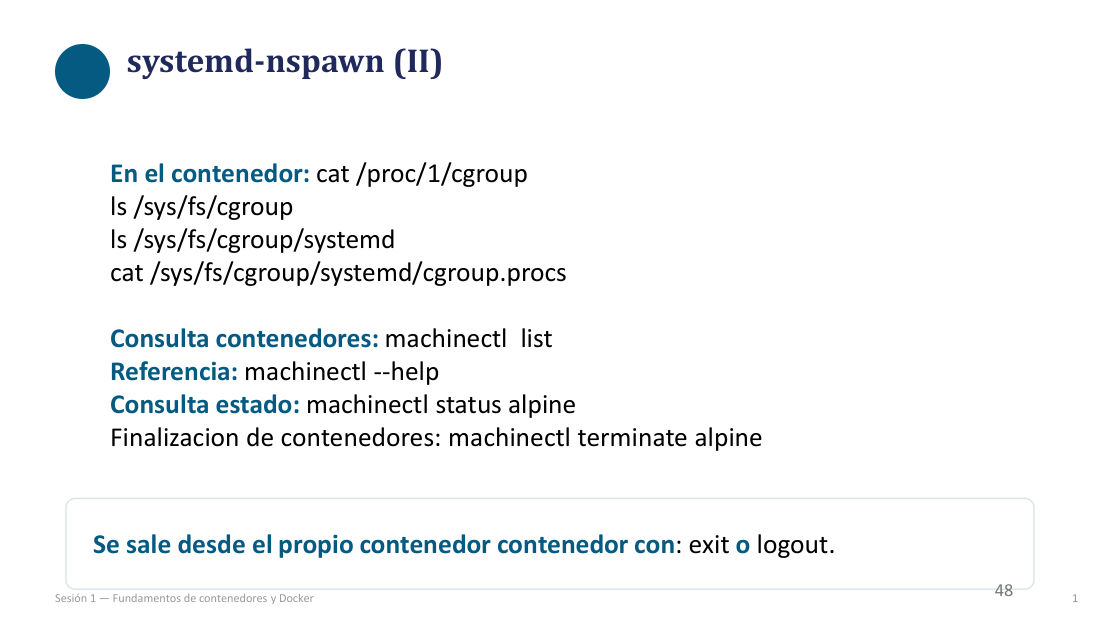
En el
在
ls /sys/fs/
列出
ls /sys/fs/
看 systemd 自己的层级:ls /sys/fs/
cat /sys/fs/
列出该组里的进程:cat /sys/fs/
Consulta contenedores: machinectl list
查有哪些容器:machinectl list。
Referencia: machinectl --help
参考:machinectl --help。
Consulta estado: machinectl status alpine
查状态:machinectl status alpine。
Finalizacion de contenedores: machinectl terminate alpine
结束容器:machinectl terminate alpine。
Se sale desde el propio
从
LXC · LXC(一)
▸ 原页截图 p.45(页脚印 49)
Utiliza comandos para gestionar el ciclo de vida de contenedores (similar a Docker)
用一组命令管理容器生命周期(与 Docker 类似)。
Crear, Arrancar, Parar, Inspeccionar y Destruir.
创建、启动、停止、检查、销毁。
Soporta ejecución de contenedores CON y SIN PRIVILEGIOS.
支持有特权与无特权两种容器运行方式。
Cuando el
LXC (II) · LXC(二)
▸ 原页截图 p.46(页脚印 50)
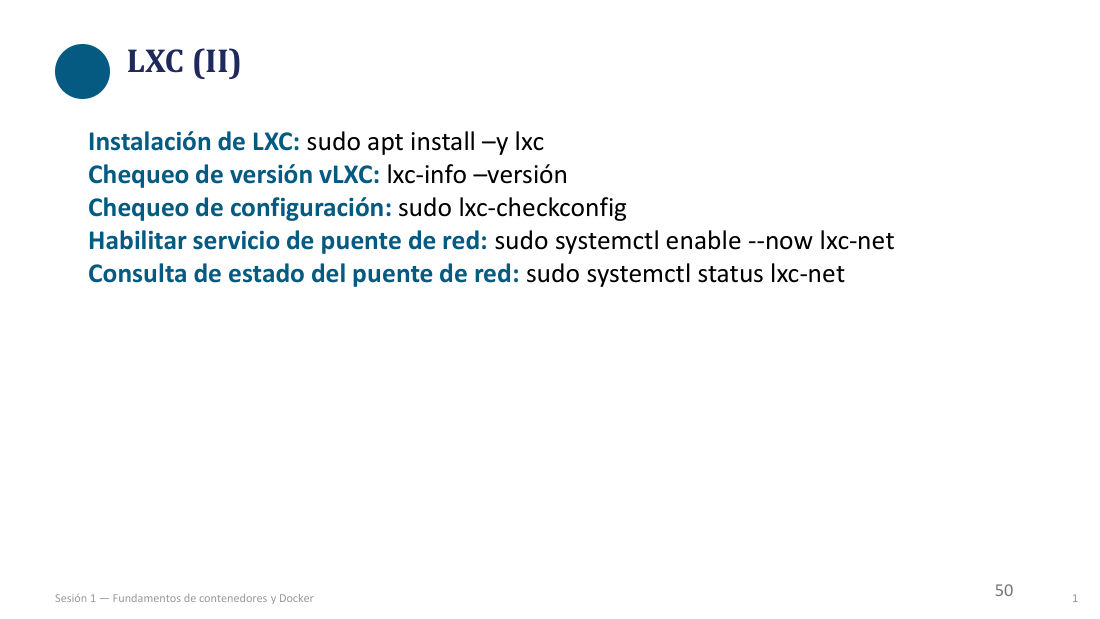
Instalación de
安装
Chequeo de versión vLXC: lxc-info –versión
查版本:lxc-info --version。
Chequeo de configuración: sudo lxc-checkconfig
检查内核配置是否支持:sudo lxc-checkconfig。
Habilitar servicio de puente de red: sudo systemctl enable --now lxc-net
启用网桥服务:sudo systemctl enable --now lxc-net。
Consulta de estado del puente de red: sudo systemctl status lxc-net
查网桥服务状态:sudo systemctl status lxc-net。
LXC (III) · LXC(三)
▸ 原页截图 p.47(页脚印 51)
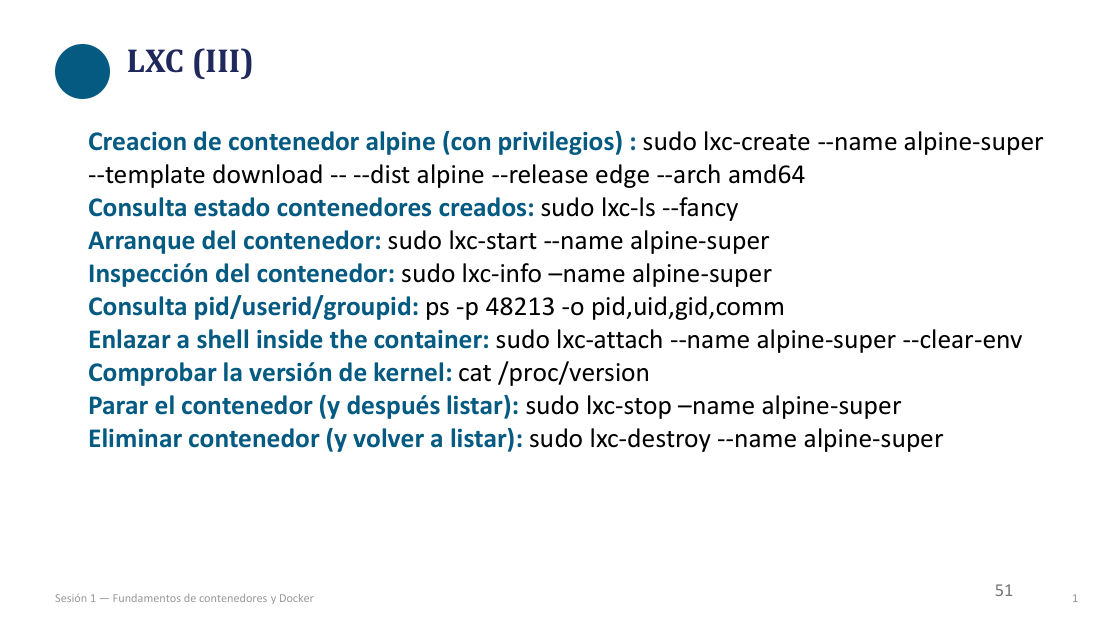
Creacion de
创建有特权的 alpine
Consulta estado contenedores creados: sudo lxc-ls --fancy
查看已创建的容器:sudo lxc-ls --fancy。
Arranque del
启动
Inspección del
查看
Consulta pid/userid/groupid: ps -p 48213 -o pid,uid,gid,comm
查 PID / 用户 ID / 组 ID:ps -p 48213 -o pid,uid,gid,comm(48213 是示例里容器 init 的 PID)。
Enlazar a shell inside the container: sudo lxc-attach --name alpine-super --clear-env
接到容器内部的 shell:sudo lxc-attach --name alpine-super --clear-env。
Comprobar la versión de kernel: cat /proc/version
确认内核版本(注意:是宿主机的内核):cat /proc/version。
Parar el
停止
Eliminar
销毁
LXC (IV) · LXC(四):无特权容器
▸ 原页截图 p.48(页脚印 52)
Creacion de contenedores sin privilegios
创建无特权容器。
Sin entrar en todos los detalles, require:
不展开全部细节,它要求:
Requiere mapear los ID de Usuario y grupo entre el Usuario normal y
需要在普通用户与
Permitir al Usuario crear interfaces virtuales
允许该用户创建虚拟网络接口。
Crear ficheros de mapeo de identidades yd e control de acceso por Usuario.
创建身份映射文件,以及按用户划分的访问控制文件。
六、从虚拟机到容器:真正的差别在哪
p.49–p.521c · 分隔页:Estándares de Contenedores y aspectos comunes · 容器标准与共性问题
▸ 原页截图 p.49(页脚印 53)
1c
「1c」——这是第三部分(Bloque 1c)的章节分隔页。
Estándares de Contenedores y aspectos comunes
容器标准与共性问题。
Fundamentos de contenedores y Docker
容器与 Docker 基础(课程总标题)。
Duración: 2 horas — teoría con tareas cortas intercaladas
时长:2 小时——理论讲解,中间穿插短任务。
Máquina virtual frente a contenedor · 虚拟机 vs 容器:差别到底在哪
▸ 原页截图 p.50(页脚印 54)
Máquina virtual frente a
虚拟机与
Dónde está la diferencia real
真正的差别在哪里。
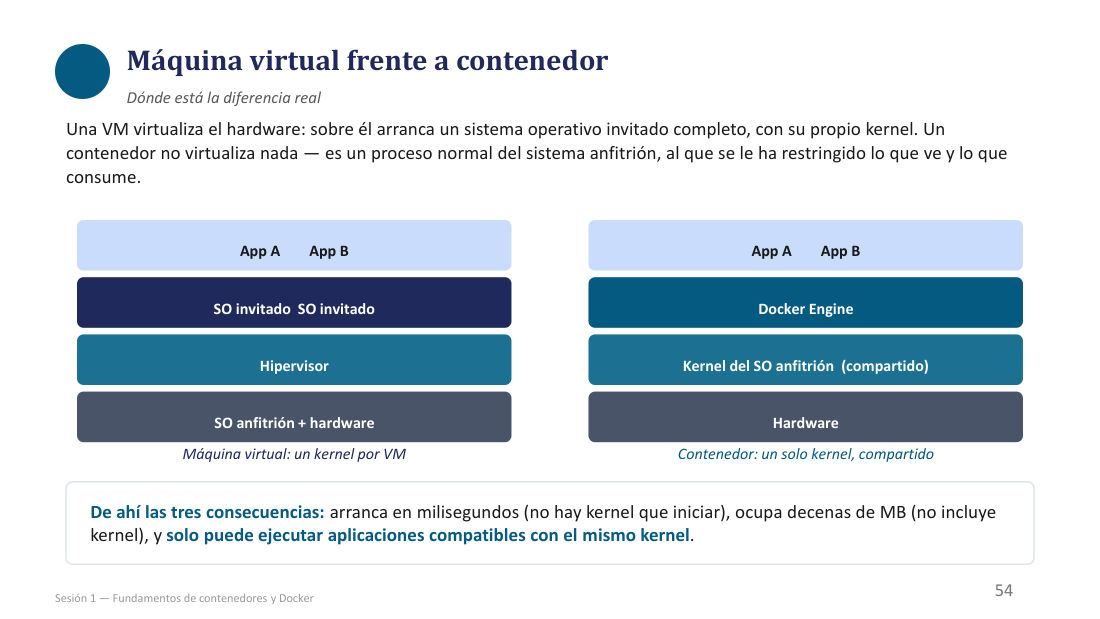
Una VM virtualiza el hardware: sobre él arranca un sistema operativo invitado completo, con su propio kernel.
虚拟机虚拟化的是硬件:在虚拟硬件之上启动一个完整的来宾操作系统,并且带自己的内核。
Un
App A / App B / SO invitado / SO invitado / Hipervisor / SO
左图从上到下:应用 A、应用 B → 来宾操作系统 ×2 → 虚拟机管理程序(Hypervisor)→
App A / App B /
右图从上到下:应用 A、应用 B →
Máquina virtual: un kernel por VM
虚拟机:每台 VM 一个内核。
Contenedor: un solo kernel, compartido
容器:只有一个内核,大家共享。
De ahí las tres consecuencias: arranca en milisegundos (no hay kernel que iniciar), ocupa decenas de MB (no incluye kernel), y solo puede ejecutar aplicaciones compatibles con el mismo kernel.
由此得出三个直接后果:启动只需毫秒级(没有内核要引导)、体积只有几十 MB(不含内核)、并且只能运行与同一内核兼容的应用程序。
Máquina virtual                       Contenedor
┌─────────┬─────────┐                ┌─────────┬─────────┐
│  App A  │  App B  │                │  App A  │  App B  │
├─────────┴─────────┤                ├─────────┴─────────┤
│  SO invitado (1)  │                │   Docker Engine   │
│  SO invitado (2)  │                ├───────────────────┤
├───────────────────┤                │ Kernel del SO     │
│    Hipervisor     │                │ anfitrión (compartido)
├───────────────────┤                ├───────────────────┤
│ SO anfitrión + HW │                │     Hardware      │
└───────────────────┘                └───────────────────┘
      un kernel por VM                    un solo kernel, compartido
Ventajas e inconvenientes · 优缺点:共享内核的代价
▸ 原页截图 p.51(页脚印 55)
Ventajas e inconvenientes
优点与缺点。
De compartir kernel o no hacerlo
取决于是否共享内核。
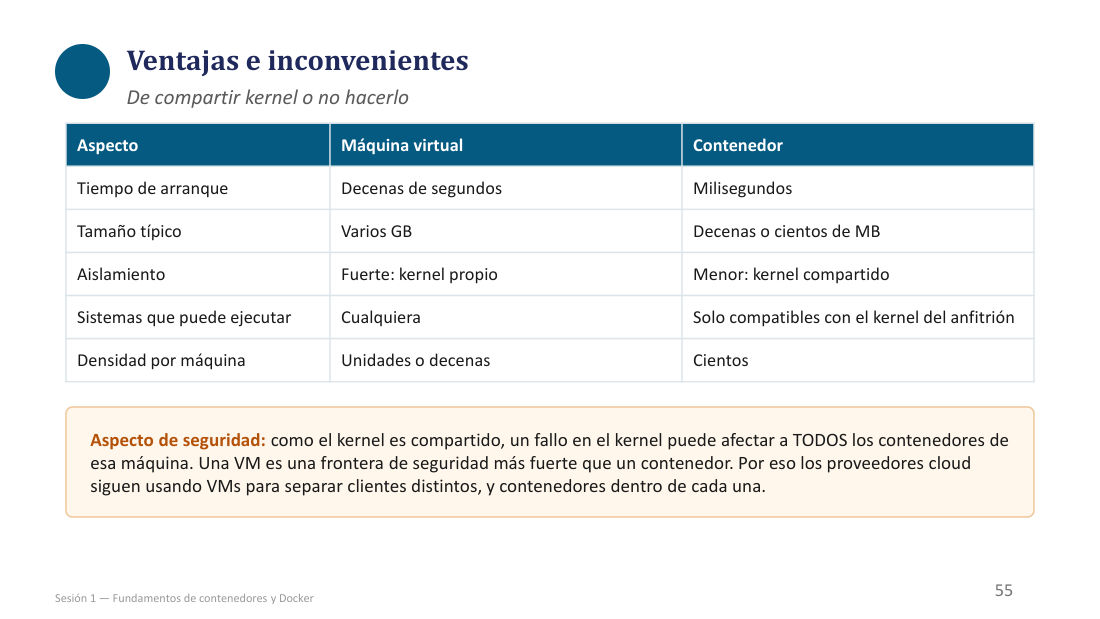
Aspecto / Máquina virtual / Contenedor
对比维度 / 虚拟机 / 容器。
Tiempo de arranque: decenas de segundos / milisegundos
启动时间:几十秒 / 毫秒级。
Tamaño típico: varios GB / decenas o cientos de MB
典型体积:数 GB / 几十到几百 MB。
Aislamiento: fuerte, kernel propio / menor,
隔离性:强(自带内核)/ 较弱(
Sistemas que puede ejecutar: cualquiera / solo compatibles con el kernel del
可运行的系统:任意系统 / 只能是与
Densidad por máquina: unidades o decenas / cientos
单机密度:几台到几十台 / 数百个。
Aspecto de seguridad: como el kernel es compartido, un fallo en el kernel puede afectar a TODOS los contenedores de esa máquina.
安全层面:由于内核是共享的,内核中的一个漏洞可能影响该机器上所有容器。
Una VM es una frontera de seguridad más fuerte que un
虚拟机是比
Por eso los proveedores cloud siguen usando VMs para separar clientes distintos, y contenedores dentro de cada una.
所以云厂商仍然用虚拟机来隔离不同租户,再在每台虚拟机内部跑容器。
| Aspecto(维度) | Máquina virtual(虚拟机) | Contenedor(容器) |
|---|---|---|
| Tiempo de arranque | Decenas de segundos | Milisegundos |
| Tamaño típico | Varios GB | Decenas o cientos de MB |
| Aislamiento | Fuerte: kernel propio | Menor: kernel compartido |
| Sistemas que puede ejecutar | Cualquiera | Solo compatibles con el kernel del anfitrión |
| Densidad por máquina | Unidades o decenas | Cientos |
Definición de trabajo · 工作定义:三个维度一句话
▸ 原页截图 p.52(页脚印 56)
Definición de trabajo
工作定义(本课程采用的操作性定义)。
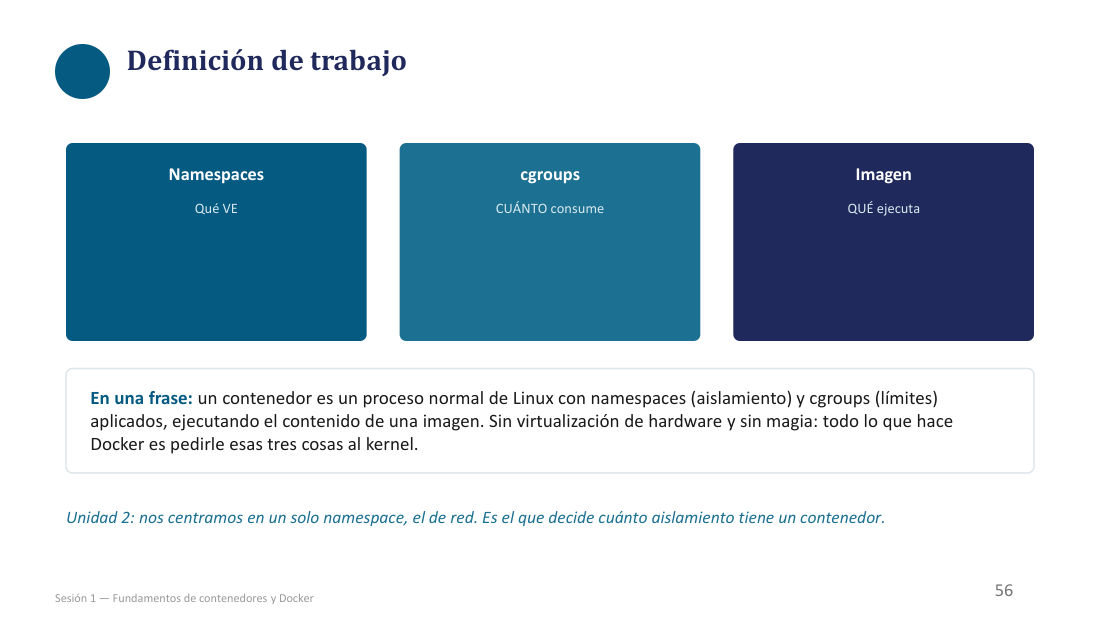
Namespaces — Qué VE
namespaces —— 决定它看得见什么。
cgroups — CUÁNTO consume
cgroups —— 决定它消耗多少。
Imagen — QUÉ ejecuta
镜像 —— 决定它运行什么。
En una frase: un
一句话说:
Sin
没有硬件
Unidad 2: nos centramos en un solo
第二单元:我们只聚焦一个 namespace——网络
七、标准化与 OCI 三规范
p.53–p.55Estándares de Contenedores · 容器标准:为什么需要标准化
▸ 原页截图 p.53(页脚印 57)
Estándares de Contenedores
容器标准。
La diversidad de implementaciones creó fragmentación.
实现方式的多样化造成了碎片化。
Para evitarla, han ido apareciendo e integrándose éstandares de contenedores.
为避免碎片化,容器标准陆续出现并不断整合。
Buscando facilitar interoperabilidad y movimiento de contenedores entre entornos.
目的是方便互操作性,以及容器在不同环境之间的迁移。
App Container Standard se integró en Open Container Initiative.
App Container Standard 被整合进了 Open Container Initiative(OCI)。
Incorporando firma de imágenes, gestión de dependencias y soporte de pods.
并带入了镜像签名、依赖管理以及 pod 支持。
Open Container Initiative (OCI) · OCI 三份规范
▸ 原页截图 p.54(页脚印 58)
Open Container Initiative (
Se creó en 2015 por Docker y otros miembros para crear estándares abiertos de formatos y entornos de contenedores.
2015 年由 Docker 及其他成员共同创建,目的是制定容器格式与运行环境的开放标准。
Runtime Specification
运行时规范(Runtime Specification)。
Fichero de configuración,…
配置文件……(规定容器如何被创建与启动)。
Operaciones sobre contenedores, …
对容器的各种操作……(create / start / kill / delete 等生命周期动作)。
Image Specification
镜像规范(Image Specification)。
Manifiestos de configuración y capas
配置清单与层(manifest + layers)。
Indice de manifiestos para distintas plataformas, ..
面向不同平台的清单索引(manifest index,多架构镜像靠它)。
Protocolo API para distribución de imágenes
用于镜像分发的 API 协议(也就是 pull / push 的接口)。
Entornos de ejecución de contenedores · 容器运行时环境
▸ 原页截图 p.55(页脚印 59)
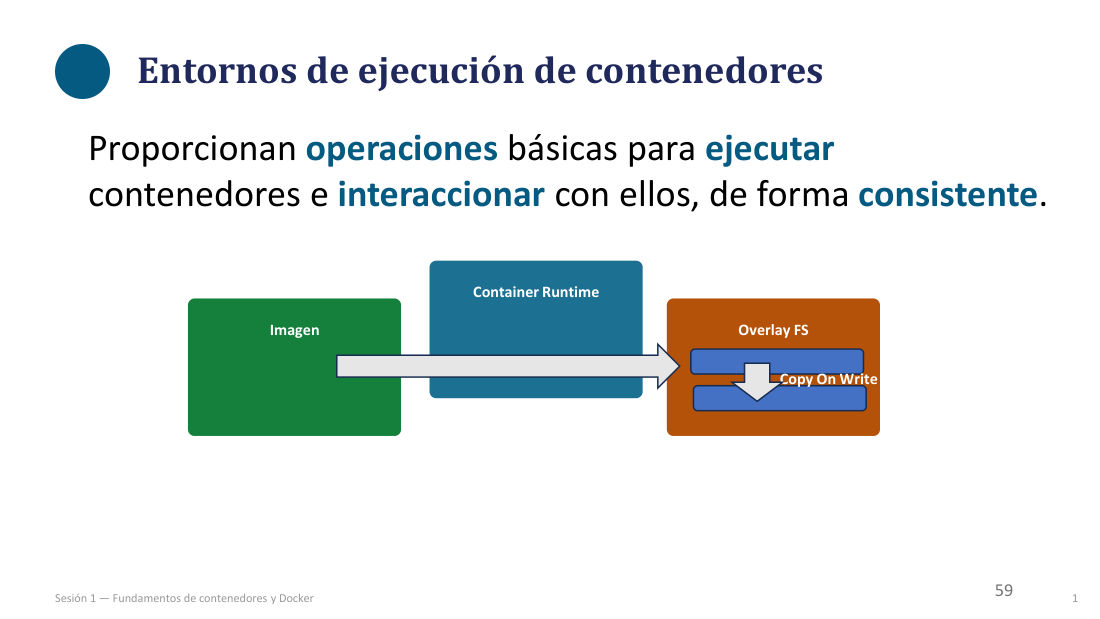
Entornos de ejecución de contenedores
容器的运行环境(container runtime)。
Proporcionan operaciones básicas para ejecutar contenedores e interaccionar con ellos, de forma consistente.
它们以一致的方式,提供运行容器并与容器交互的基础操作。
Container Runtime
容器运行时。
Imagen
镜像。
Overlay FS
Overlay 文件系统(分层叠加)。
Copy On Write
写时复制(COW)。
八、容器运行时与 Docker 架构
p.56–p.62Docker no es el único: el estándar OCI · Docker 不是唯一:OCI 标准
▸ 原页截图 p.56(页脚印 60)
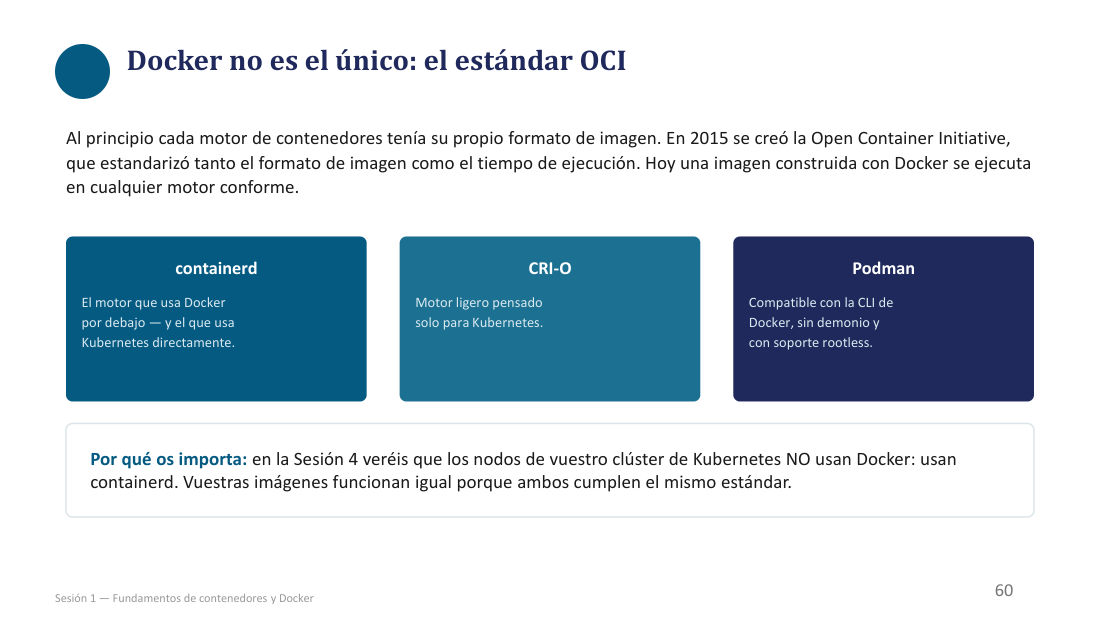
Docker no es el único: el estándar
Docker 并不是唯一:
Al principio cada motor de contenedores tenía su propio formato de
起初,每个容器引擎都有自己的
En 2015 se creó la Open Container Initiative, que estandarizó tanto el formato de
2015 年成立了 Open Container Initiative,把
Hoy una
今天,用 Docker 构建的
Por qué os importa: en la Sesión 4 veréis que los nodos de vuestro clúster de Kubernetes NO usan Docker: usan
为什么这对你们重要:第 4 课会看到,你们 Kubernetes 集群的节点不用 Docker,而是用
Vuestras imágenes funcionan igual porque ambos cumplen el mismo estándar.
你们的镜像照样能用,因为两者遵循同一个标准。
runc · 最底层的运行时
▸ 原页截图 p.57(页脚印 61)
[✓] CLI, sencillo
[✓] 命令行接口,简单。
Basado en
基于
[X] No expone API, descargas, ..
[X] 不对外提供 API,也不负责下载镜像等。
[X] No expone un daemon
[X] 不提供守护进程。
Puede integrarse con el Linux service manager, systemd.
可以与 Linux 的服务管理器 systemd 集成。
Implementa capas bajas
只实现底层功能。
containerd · 容器总管
▸ 原页截图 p.58(页脚印 62)
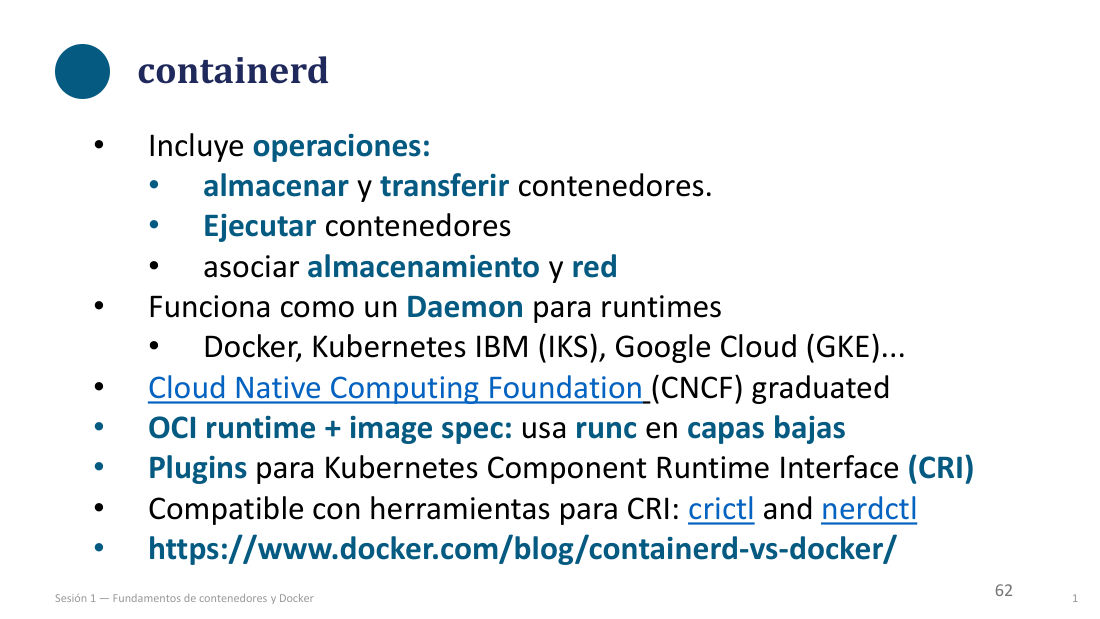
Incluye operaciones:
包含以下操作:
almacenar y transferir contenedores.
存储与传输容器(镜像)。
Ejecutar contenedores
运行容器。
asociar almacenamiento y red
关联存储与网络。
Funciona como un Daemon para runtimes
作为运行时的守护进程工作。
Docker, Kubernetes IBM (IKS), Google Cloud (GKE)...
被 Docker、IBM Kubernetes(IKS)、Google Cloud(GKE)等采用……
Cloud Native Computing Foundation (
是
遵循
Plugins para Kubernetes Component Runtime Interface (
提供 Kubernetes
Compatible con herramientas para
兼容
https://www.docker.com/blog/
参考链接:https://www.docker.com/blog/
docker · 不只是运行时
▸ 原页截图 p.59(页脚印 66)
docker
docker。
Es más que un entorno de ejecución de contenedores.
它不只是一个容器运行时。
Plataforma para desarrollo y gestión
它是一个开发与管理平台。
Operaciones sobre:
操作对象包括:
Originalmente usaba
最初使用
Implementa especificaciones
实现
firma de imágenes de contenedores,
容器镜像签名,
容器镜像仓库管理,
ciclo de vida, …
生命周期管理……
Se base en el
在架构层面基于
Docker. Arquitectura · Docker 架构图
▸ 原页截图 p.60(页脚印 67)
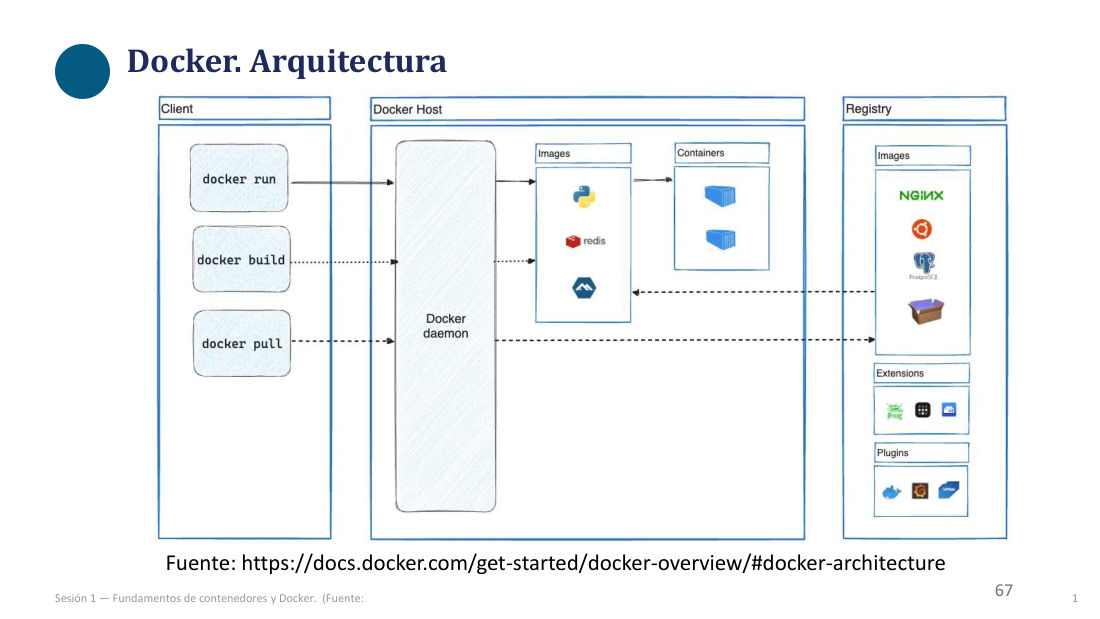
Docker. Arquitectura
Docker 架构。
Client
客户端(Client):docker run / docker build / docker pull。
Docker Host
Docker 主机(Host):里面跑 Docker daemon。
Images
镜像区(图中示例:python、redis、nginx)。
Containers
容器区(由镜像启动出的运行实例)。
Registry
镜像仓库(Registry):Images、Extensions、Plugins 三栏。
Fuente: https://docs.docker.com/get-started/docker-overview/#docker-architecture
来源:https://docs.docker.com/get-started/docker-overview/#docker-architecture。
┌─ Client ─────┐      ┌─ Docker Host ────────────────────────────┐      ┌─ Registry ──────┐
│ docker run   │─────▶│                ┌─ Images ─┐  ┌ Containers┐│      │ Images          │
│ docker build │─────▶│  Docker        │  python  │─▶│           ││◀╌╌╌╌ │  nginx / redis  │
│ docker pull  │─────▶│  daemon        │  redis   │  │           ││      │  python / ubuntu│
└──────────────┘      │                │  nginx   │  └───────────┘│╌╌╌╌╌▶│ Extensions      │
                      └────────────────└──────────┘───────────────┘      │ Plugins         │
                                                                          └─────────────────┘
   ──▶ 本地调用(socket)        ╌╌▶ 网络拉取 / 推送(HTTPS)
La arquitectura de Docker · Docker 架构:客户端、守护进程与仓库
▸ 原页截图 p.61(页脚印 68)
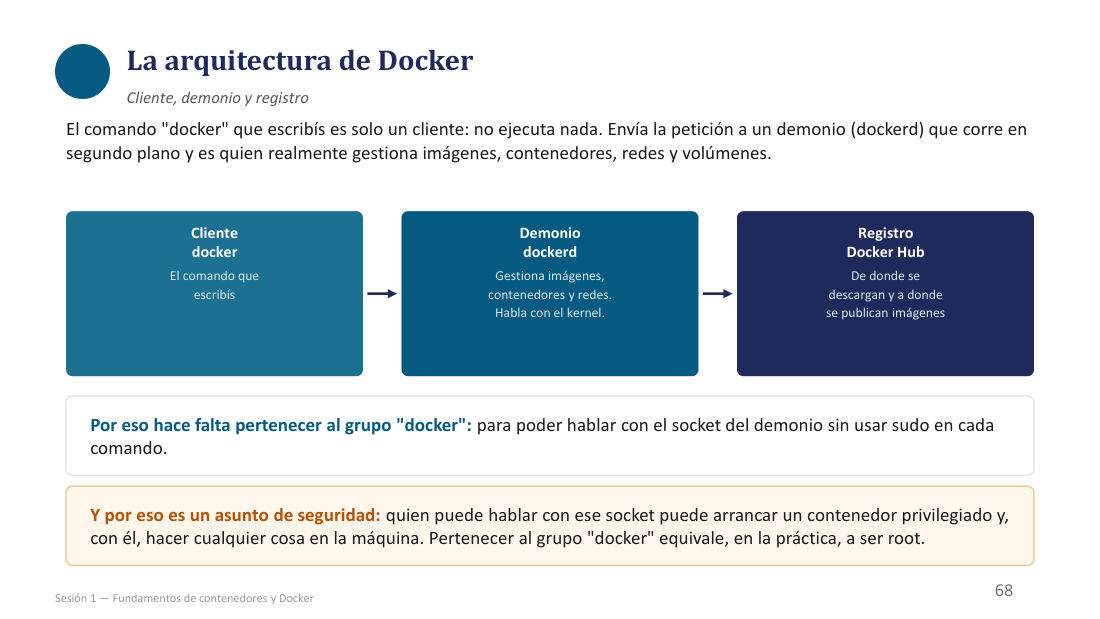
La arquitectura de Docker
Docker 的架构。
Cliente, demonio y
客户端、守护进程与镜像仓库。
El comando "docker" que escribís es solo un cliente: no ejecuta nada.
你敲下的 docker 命令只是一个客户端:它本身什么都不执行。
Envía la petición a un demonio (
它把请求发给后台运行的守护进程(
Cliente — docker — El comando que escribís
客户端 —— docker —— 你敲的那个命令。
Demonio —
守护进程 ——
Registro —
仓库 ——
Por eso hace falta pertenecer al grupo "docker": para poder hablar con el
所以才需要加入 docker 用户组:这样不必每条命令都加 sudo 就能与守护进程的
Y por eso es un asunto de seguridad: quien puede hablar con ese
也正因如此它是个安全问题:能访问该
Pertenecer al grupo "docker" equivale, en la práctica, a ser
加入 docker 组,实际上等同于拿到了
El ciclo de vida de un contenedor · 容器生命周期与命令
▸ 原页截图 p.62(页脚印 69)
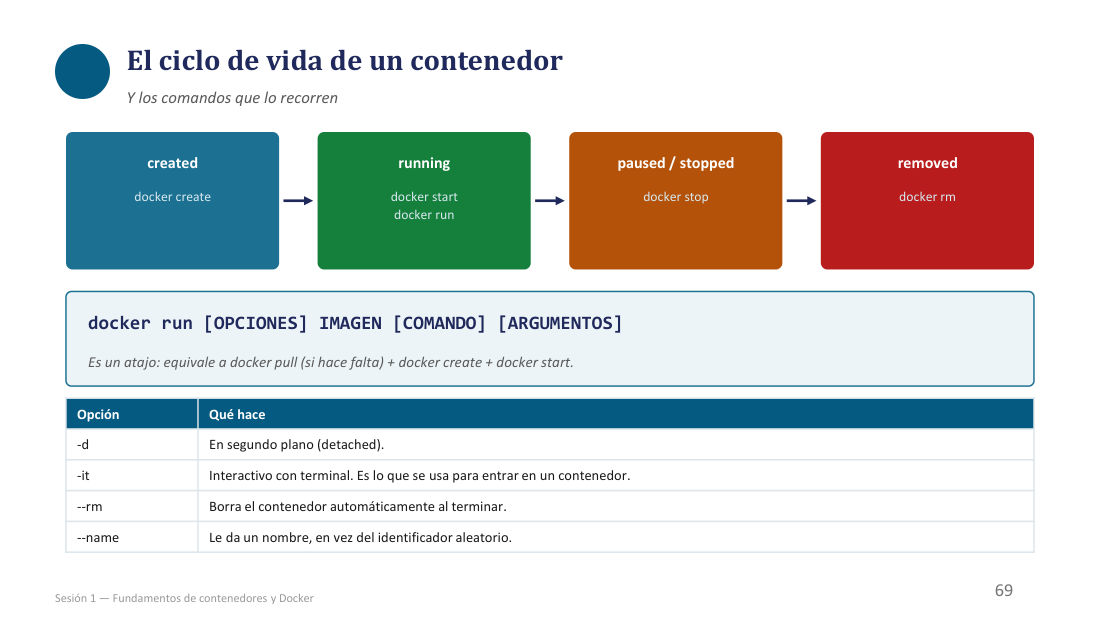
El ciclo de vida de un
Y los comandos que lo recorren
以及走完这条链的命令。
created — docker create
已创建(created)—— docker create。
running — docker start /
运行中(running)—— docker start 或
paused / stopped — docker stop
暂停 / 已停止(paused / stopped)—— docker stop。
removed — docker rm
已删除(removed)—— docker rm。
命令语法:
Es un atajo: equivale a
它是个快捷方式:等价于
-d — En segundo plano (detached).
-d —— 后台运行(detached)。
-it — Interactivo con terminal. Es lo que se usa para entrar en un
-it —— 交互式并分配终端,就是「进入
--rm — Borra el
--rm ——
--name — Le da un nombre, en vez del identificador aleatorio.
--name —— 给容器起名字,替代随机 ID。
docker create ──▶ created ──docker start──▶ running ──docker stop──▶ stopped
                        ▲                    │
                        └──docker run────────┘   (run = pull + create + start)
                                             │
                                       docker rm ──▶ removed
九、Dockerfile 指令详解
p.63–p.70Dockerfile · 什么是 Dockerfile
▸ 原页截图 p.63(页脚印 70)
Un
Estos incluyen:
其中包括:
1. Copia del código fuente a la
1. 把源代码复制进
2. Instalación de las librerías necesarias (tanto para compilar como para ejecutar la aplicación).
2. 安装所需的库(既包括编译用的,也包括运行应用用的)。
3. Exposición de un puerto para acceder a la aplicación (de nuevo los contenedores son entornos aislados y hay que habilitar su acceso si se necesita).
3. 暴露一个端口以便访问应用(容器是隔离环境,需要访问就得显式开放)。
4. Comando para ejecutar la aplicación.
4. 启动应用的命令。
Docker construye las imágenes leyendo los comandos de forma descendente de un
Docker 自上而下读取
Por tanto, antes de ejecutar la aplicación deben de estar instaladas las librerías necesarias!
因此,在运行应用之前,必须先装好所需的库!
Dockerfile comando FROM · FROM:指定基础镜像
▸ 原页截图 p.64(页脚印 71)
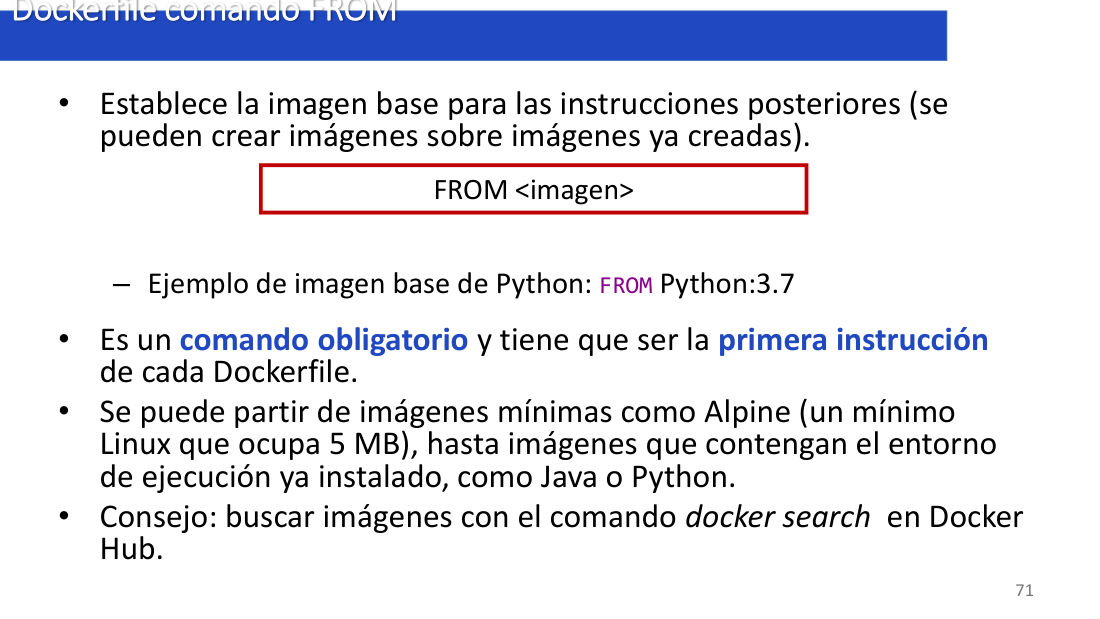
语法:
Establece la
为后续指令设定基础
Ejemplo de
Python 基础
Es un comando obligatorio y tiene que ser la primera instrucción de cada
它是必填指令,并且必须是每个
Se puede partir de imágenes mínimas como Alpine (un mínimo Linux que ocupa 5 MB), hasta imágenes que contengan el entorno de ejecución ya instalado, como Java o Python.
既可以从 Alpine 这种极简镜像起步(一个只有 5 MB 的迷你 Linux),也可以从已装好运行环境的镜像起步,比如 Java 或 Python。
Consejo: buscar imágenes con el comando
小贴士:在
Dockerfile comando COPY/ADD · COPY 与 ADD:往镜像里放文件
▸ 原页截图 p.65(页脚印 72)
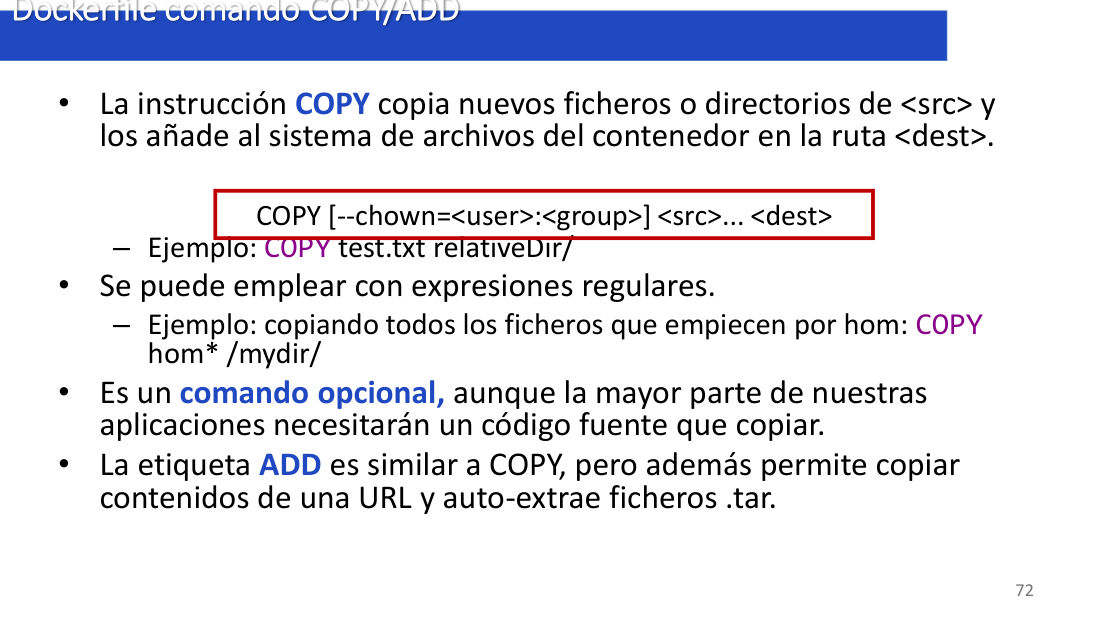
COPY [--chown=<user>:<group>] <src>... <dest>
语法:COPY [--chown=<user>:<group>] <src>... <dest>。
La instrucción COPY copia nuevos ficheros o directorios de <src> y los añade al sistema de archivos del
COPY 把 <src> 处的新文件或目录复制到
Ejemplo: COPY test.txt relativeDir/
示例:COPY test.txt relativeDir/。
Se puede emplear con expresiones regulares.
可以使用(通配)表达式。
Ejemplo: copiando todos los ficheros que empiecen por hom: COPY hom* /mydir/
示例:复制所有以 hom 开头的文件:COPY hom* /mydir/。
Es un comando opcional, aunque la mayor parte de nuestras aplicaciones necesitarán un código fuente que copiar.
它是可选指令,不过我们大多数应用都需要复制源代码进去。
La
Dockerfile comando RUN · RUN:构建时执行命令
▸ 原页截图 p.66(页脚印 73)
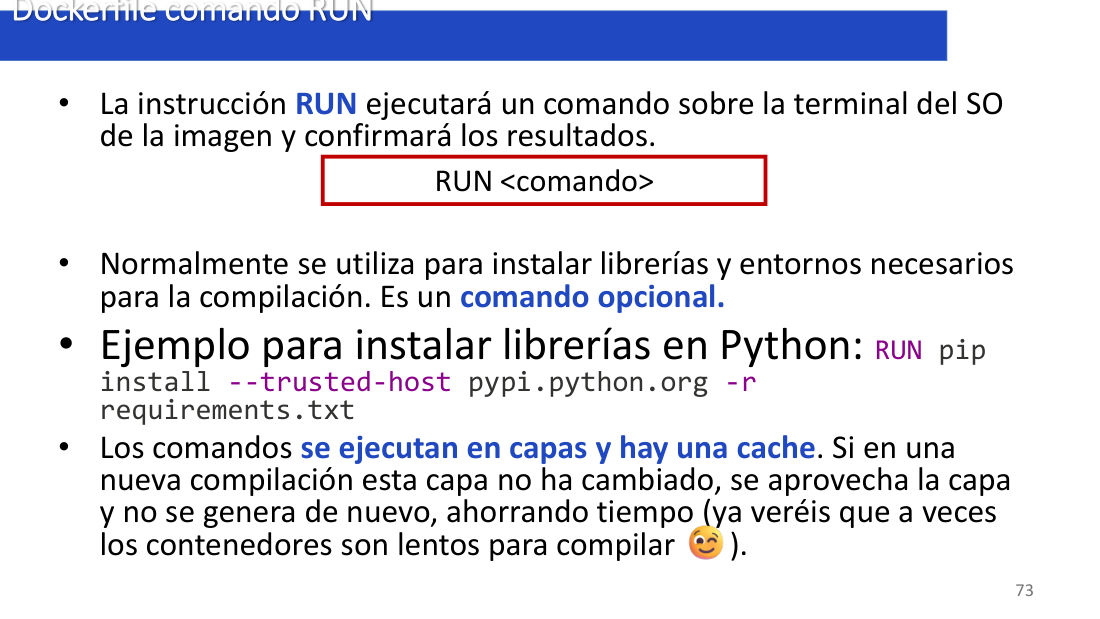
语法:
La instrucción
Normalmente se utiliza para instalar librerías y entornos necesarios para la compilación. Es un comando opcional.
通常用来安装编译所需的库和环境。它是可选指令。
Ejemplo para instalar librerías en Python:
Python 安装依赖的示例:
Los comandos se ejecutan en capas y hay una cache.
命令按层执行,并且存在缓存。
Si en una nueva compilación esta
如果新一次构建中这一
# 安装 Python 依赖(构建时执行)
RUN pip install --trusted-host pypi.python.org -r requirements.txt

# 层缓存示意:内容不变 → 直接复用
Step 5/8 : RUN pip install -r requirements.txt
 ---> Using cache
 ---> 3f2a9c1b7d40
Dockerfile comando EXPOSE · EXPOSE:声明端口
▸ 原页截图 p.67(页脚印 74)
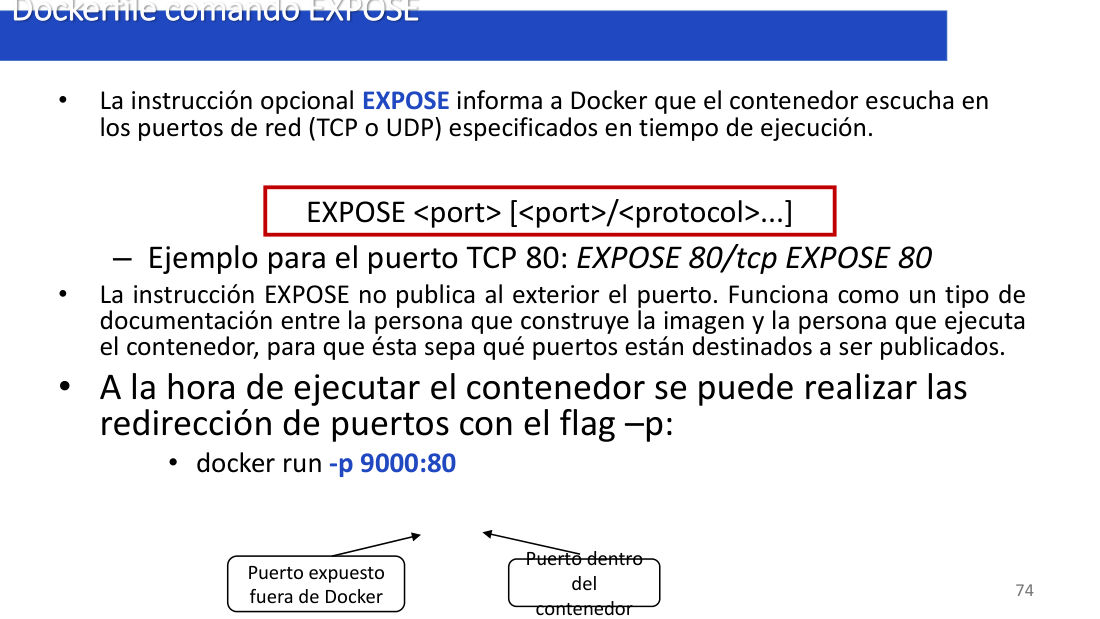
语法:
La instrucción opcional
可选指令
Ejemplo para el puerto TCP 80:
TCP 80 端口示例:
La instrucción
Funciona como un tipo de documentación entre la persona que construye la
它更像一种「文档」:告诉运行
A la hora de ejecutar el
运行
Puerto dentro del
docker run -p 9000:80 imagen
                 │    │
     宿主机端口 ◀─┘    └─▶ 容器内端口
     (fuera de Docker)   (dentro del contenedor)
Dockerfile comando CMD · CMD:默认启动命令
▸ 原页截图 p.68(页脚印 75)
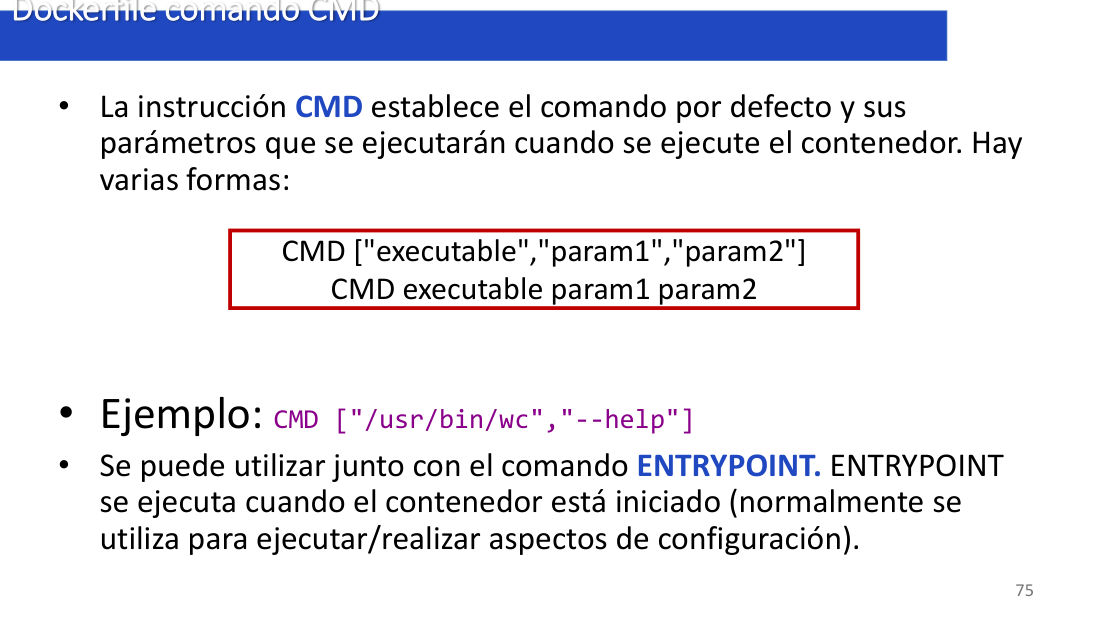
CMD ["executable","param1","param2"]
JSON 数组形式:CMD ["executable","param1","param2"](exec form,推荐)。
CMD executable param1 param2
Shell 形式:CMD executable param1 param2(会经由 /bin/sh -c 执行)。
La instrucción CMD establece el comando por defecto y sus parámetros que se ejecutarán cuando se ejecute el
CMD 设定
Hay varias formas:
有多种写法:
Ejemplo: CMD ["/usr/bin/wc","--help"]
示例:CMD ["/usr/bin/wc","--help"]。
Se puede utilizar junto con el comando
可以与
Dockerfile otros comandos · WORKDIR 与 ENV
▸ 原页截图 p.69(页脚印 76)
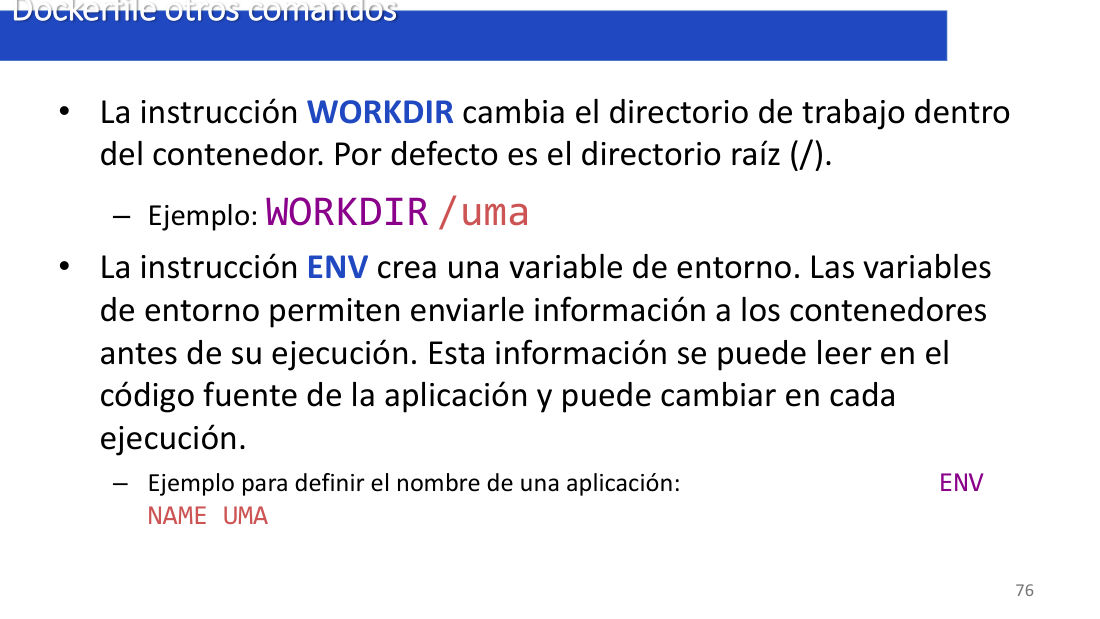
La instrucción
WORKDIR 切换
Por defecto es el directorio raíz (/).
默认是根目录(/)。
Ejemplo:
示例:
La instrucción
ENV 创建
Las variables de entorno permiten enviarle información a los contenedores antes de su ejecución.
环境变量让你在容器运行之前就把信息传进去。
Esta información se puede leer en el código fuente de la aplicación y puede cambiar en cada ejecución.
这些信息可以在应用源码中读取,并且每次运行都可以不同。
Ejemplo para definir el nombre de una aplicación:
定义应用名称的示例:
Ejemplo Dockerfile · 完整示例:Python Flask 应用
▸ 原页截图 p.70(页脚印 77)
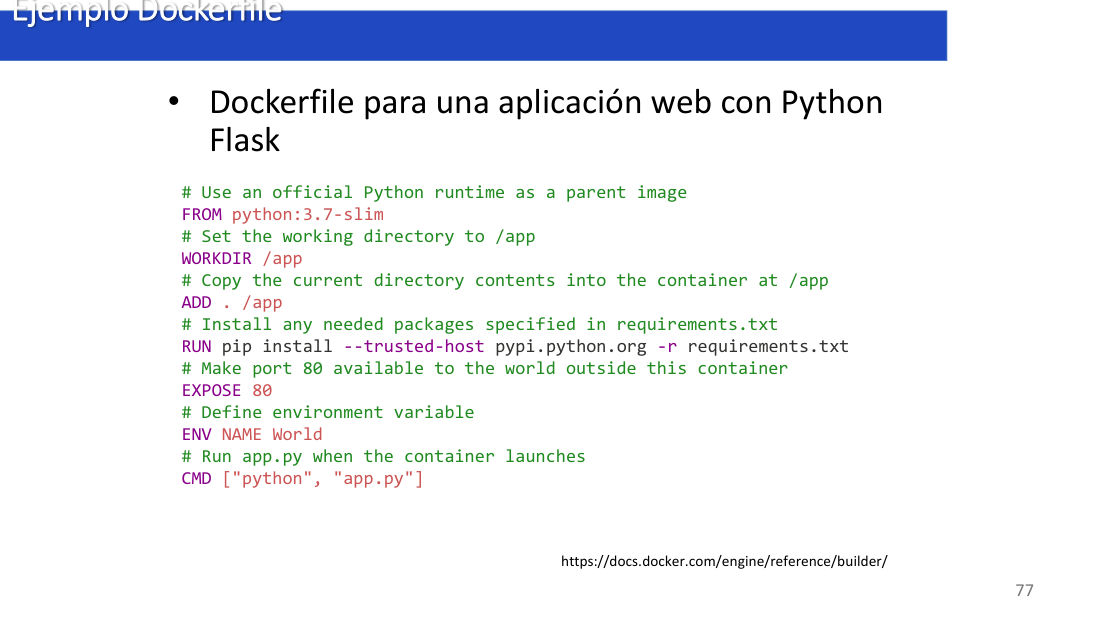
Ejemplo
一个 Python Flask Web 应用的
# Use an official Python
# 使用官方 Python
# Set the working directory to /app
# 把工作目录设为 /app。
# Copy the current directory contents into the container at /app
# 把当前目录内容复制到容器的 /app。
# Install any needed packages specified in requirements.txt
# 安装 requirements.txt 中指定的依赖。
# Make port 80 available to the world outside this container
# 让 80 端口可被容器外部访问(注释这么说,实际只是声明)。
# Define environment variable
# 定义环境变量。
# Run app.py when the container launches
# 容器启动时运行 app.py。
CMD ["python", "app.py"]
CMD ["python", "app.py"]。
https://docs.docker.com/engine/reference/builder/
官方参考:https://docs.docker.com/engine/reference/builder/。
# Use an official Python runtime as a parent image
FROM python:3.7-slim
# Set the working directory to /app
WORKDIR /app
# Copy the current directory contents into the container at /app
ADD . /app
# Install any needed packages specified in requirements.txt
RUN pip install --trusted-host pypi.python.org -r requirements.txt
# Make port 80 available to the world outside this container
EXPOSE 80
# Define environment variable
ENV NAME World
# Run app.py when the container launches
CMD ["python", "app.py"]
十、Docker 组件与桌面工具
p.71–p.76Docker. Componentes y Herramientas · Docker 组件与工具
▸ 原页截图 p.71(页脚印 78)
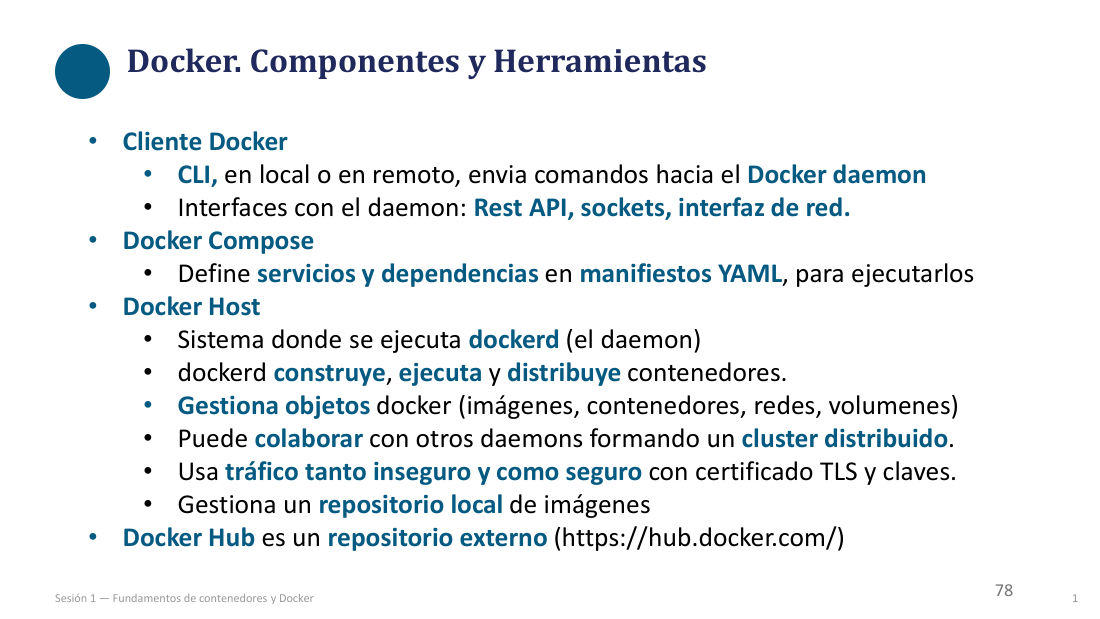
Docker. Componentes y Herramientas
Docker 组件与工具。
Cliente Docker
Docker 客户端。
CLI, en local o en remoto, envia comandos hacia el Docker daemon
命令行工具,可在本地或远程,向 Docker 守护进程发送命令。
Interfaces con el daemon: Rest API, sockets, interfaz de red.
与守护进程的接口:REST API、socket、网络接口。
Docker Compose
Docker Compose。
Define servicios y dependencias en manifiestos YAML, para ejecutarlos
用 YAML 清单定义服务与依赖,然后统一执行。
Docker Host
Docker 主机。
Sistema donde se ejecuta
运行
Gestiona objetos docker (imágenes, contenedores, redes, volumenes)
管理 Docker 对象(镜像、容器、网络、卷)。
Puede colaborar con otros daemons formando un cluster distribuido.
可与其他守护进程协作,组成分布式集群。
Usa tráfico tanto inseguro y como seguro con certificado TLS y claves.
既使用不加密流量,也使用带 TLS 证书与密钥的加密流量。
Gestiona un
管理本地镜像
Docker. Herramientas de instalación y configuración · Docker Desktop
▸ 原页截图 p.72(页脚印 79)
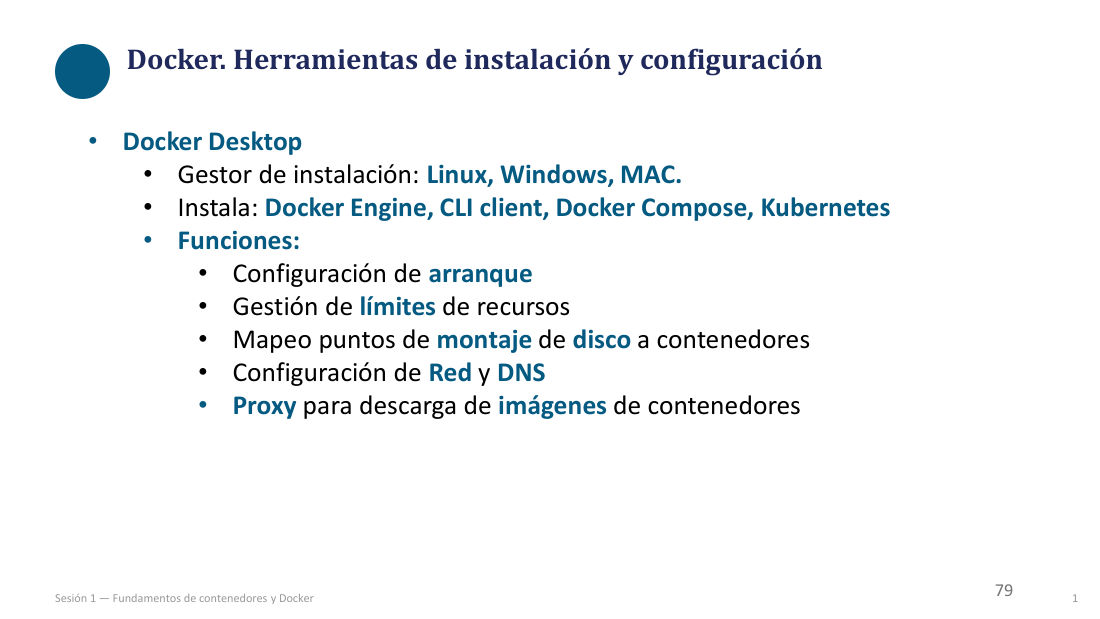
Docker. Herramientas de instalación y configuración
Docker 安装与配置工具。
Gestor de instalación: Linux, Windows, MAC.
安装管理器:支持 Linux、Windows、Mac。
Instala:
安装内容:
Funciones:
功能:
Configuración de arranque
启动配置(开机自启、启动参数)。
Gestión de límites de recursos
资源限额管理(CPU、内存、磁盘)。
Mapeo puntos de montaje de disco a contenedores
把磁盘挂载点映射到容器。
Configuración de Red y DNS
网络与 DNS 配置。
Proxy para descarga de imágenes de contenedores
用于拉取容器镜像的代理。
Podman · 无守护进程的容器引擎
▸ 原页截图 p.73(页脚印 80)
Container engine:
容器引擎:
Desarrollo, gestion y ejecución de contenedores
面向
Sin demonio
无守护进程(daemonless)。
Usa libpod para gestionar pods, contenedores, imagenes y volumenes.
用 libpod 管理 Pod、容器、镜像与卷。
Usa conmon para monitorizar contenedores
用 conmon 监控容器。
Servicio API REST: bajo petición de aplicaciones remotas
REST API 服务:按远程应用的请求提供服务。
Instala:
安装内容:
Imita el CLI de docker (podman-tui)
模仿 Docker 的命令行(podman-tui)。
También tienne un GUI (
也有图形界面(
CRI-O · 面向 Kubernetes 的极简运行时
▸ 原页截图 p.74(页脚印 81)
Implementación minimalista del
CRI(
Orientado a Kubernetes
面向 Kubernetes。
Implementa el Container Network Interface (CNI)
实现 CNI(容器网络接口)。
usa
使用 runc 作为
compatible con
兼容
Otros entornos · 其他容器环境:LXC 与 Kata
▸ 原页截图 p.75(页脚印 82)
Otros entornos
其他环境。
Distintos enfoques de densidad de integracion, vs seguridad y
在集成密度与安全
Ofrece Full system containers
提供「完整系统容器」(整机式容器)。
Comparten kernel pero se asemejan a máquinas virtuales.
共享内核,但使用体验接近虚拟机。
Contenedores Kata
Kata 容器。
Se basa en maquinas virtuales ligeras semejantes a contenedores
基于类似容器的轻量级虚拟机。
Utilizan kernels dedicados para conseguir
使用独立内核,在不损失性能的前提下获得
Soporta contenedores UCI y el Kubernetes
支持 UCI 容器与 Kubernetes
…
……(原文以省略号收尾,表示还有其他环境未展开)
Página en blanco · 空白预留页
▸ 原页截图 p.76(页脚印 84)
A…..
A……(预留条目 A,正文未填)。
B…..
B……(预留条目 B,正文未填)。
十一、镜像:定义、引用与注册表
p.77–p.841d · Imágenes · 第四节分隔页:镜像
▸ 原页截图 p.77(页脚印 85)
1d
第 1 部分 d 小节。
Imágenes
镜像。
Fundamentos de contenedores y Docker
容器与 Docker 基础。
Duración: 2 horas — teoría con tareas cortas intercaladas
时长:2 小时——理论讲授,中间穿插短任务。
¿Qué es una imagen de contenedor? · 什么是容器镜像?
▸ 原页截图 p.78(页脚印 86)
¿Qué es una
什么是
Una
y con métodos de despliegue y ejecución en distintos entornos aislados y seguros.
并附带在不同隔离、安全环境中部署与执行的方法。
Los contenedores pueden ejecutarse en bare-metal, máquinas virtuales o en cloud.
容器可以跑在裸金属、虚拟机或云上。
Registros Públicos · 公共镜像注册表
▸ 原页截图 p.79(页脚印 87)
Registros Públicos
公共注册表。
Un
镜像
Permite compartir imágenes globalmente.
它让镜像可以在全球范围内共享。
Algunos servidores populares:
一些常用服务器:
GitHub Container Registry (GHCR)
GitHub 容器注册表(GHCR)。
GitLab Container Registry
GitLab 容器注册表。
Amazon Elastic Container Registry (ECR)
亚马逊弹性容器注册表(ECR)。
Azure Container Registry (ACR)
Azure 容器注册表(ACR)。
Google Artifact Registry (GAR)
Google 制品注册表(GAR)。
Referencias a repositorios · 镜像引用的五个组成部分
▸ 原页截图 p.80(页脚印 88)
Referencias a repositorios
仓库引用(镜像的完整名字怎么写)。
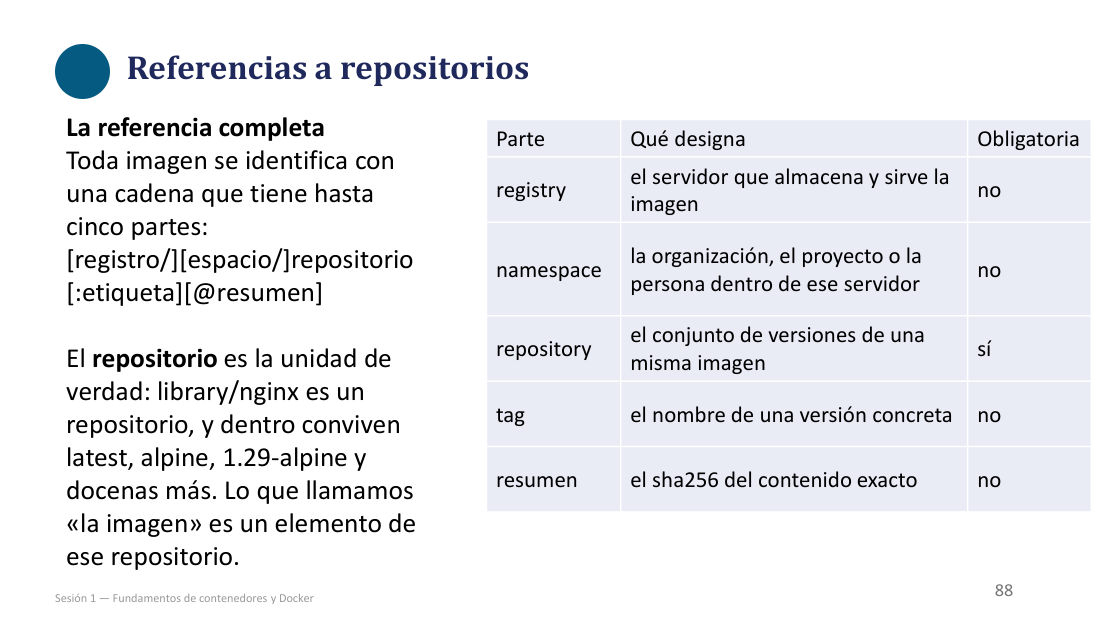
| Parte(部分) | Qué designa(指什么) | Obligatoria(是否必填) |
|---|---|---|
| registry | el servidor que almacena y sirve la imagen | no |
| namespace | la organización, el proyecto o la persona dentro de ese servidor | no |
| repository | el conjunto de versiones de una misma imagen | sí |
| tag | el nombre de una versión concreta | no |
| resumen | el sha256 del contenido exacto | no |
registry — el servidor que almacena y sirve la
registry —— 存放并提供
repository — el conjunto de versiones de una misma
repository —— 同一
tag — el nombre de una versión concreta — no
tag —— 某个具体版本的名字 —— 非必填。
resumen — el sha256 del contenido exacto — no
digest(摘要)—— 精确内容的 sha256 —— 非必填。
La referencia completa
完整引用。
Toda
每个
[registro/][espacio/]repositorio[:etiqueta][@resumen]
[
[
El
y dentro conviven
其中并存着
Lo que llamamos «la
我们口头说的「那个
Referencias incompletas · 不完整引用如何被自动补全
▸ 原页截图 p.81(页脚印 89)
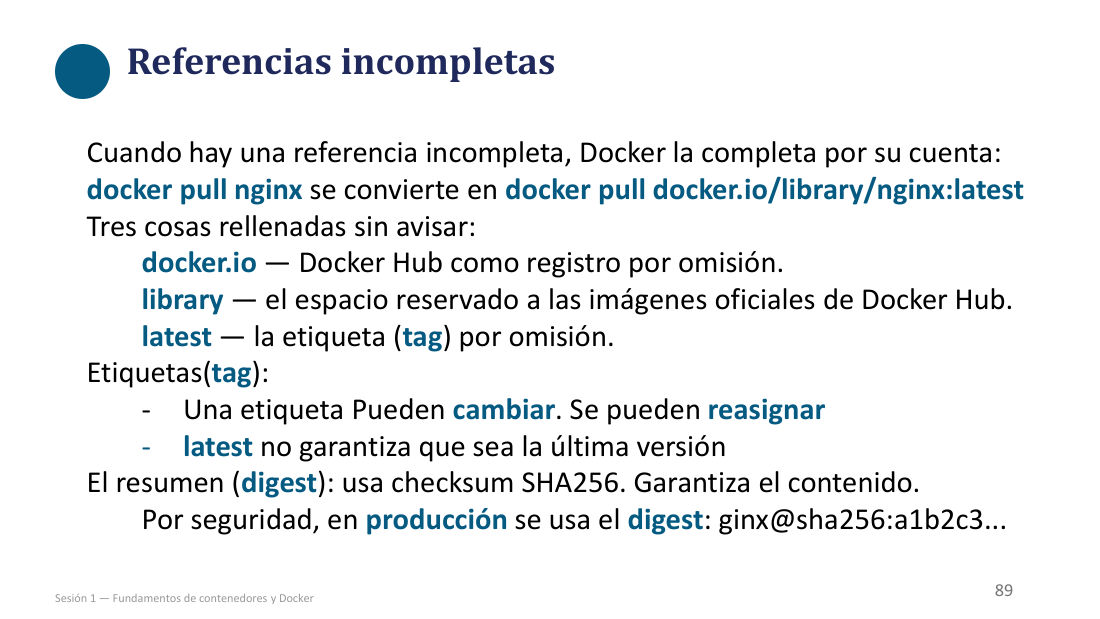
Referencias incompletas
不完整引用。
Cuando hay una referencia incompleta, Docker la completa por su cuenta:
当引用不完整时,Docker 会自己把它补全:
docker pull nginx → docker pull docker.io/library/nginx:latest
Tres cosas rellenadas sin avisar:
三处被悄悄补上:
docker.io —
docker.io —— 默认
Etiquetas(tag):
标签(tag):
Una
El resumen (
Por seguridad, en producción se usa el
出于安全考虑,生产环境应使用
Tipos de Registros · 注册表的类型:私有 / 代理镜像
▸ 原页截图 p.82(页脚印 90)
Tipos de Registros
注册表的类型。
Privados / Self-Hosted
私有 / 自建(Self-Hosted)。
Para uso interno.
供内部使用。
Docker Registry v2 , open source pero menos seguro
Docker Registry v2:开源,但安全性较弱。
Registros Proxy y Mirror
代理注册表与镜像站(Proxy / Mirror)。
Cachean descargas / pull de repositorios públicos
缓存对公共仓库的下载 / pull 请求。
Previenen limitaciones o bloqueos por uso excesivo
防止因过度使用而被限流或封禁。
Especificaciones de Imagen y Distribución OCI · OCI 镜像与分发规范
▸ 原页截图 p.83(页脚印 91)
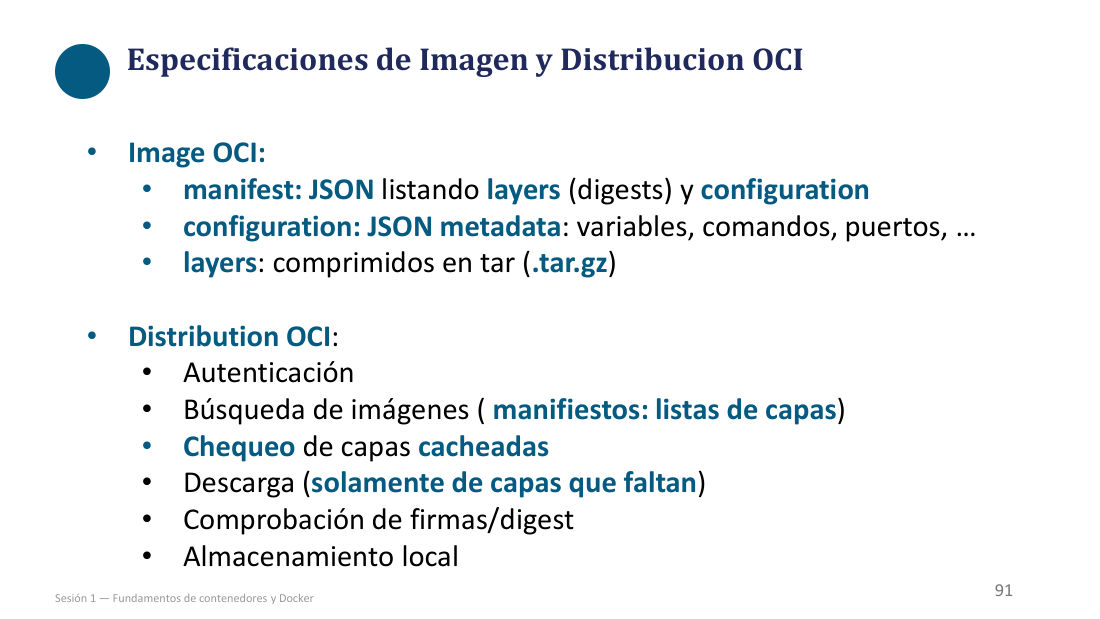
Especificaciones de Imagen y Distribucion
Image
manifest(
configuration: JSON metadata: variables, comandos, puertos, …
configuration(配置):包含变量、命令、端口等元数据的 JSON。
layers: comprimidos en
layers(层):以
Autenticación
认证。
Búsqueda de imágenes ( manifiestos: listas de capas)
镜像检索(manifest:层的列表)。
Chequeo de capas cacheadas
检查已缓存的层。
Descarga (solamente de capas que faltan)
下载(只下载缺失的层)。
Comprobación de firmas/
校验签名 /
Almacenamiento local
本地存储。
Herramientas. Skopeo · 不落地检查与搬运镜像
▸ 原页截图 p.84(页脚印 92)
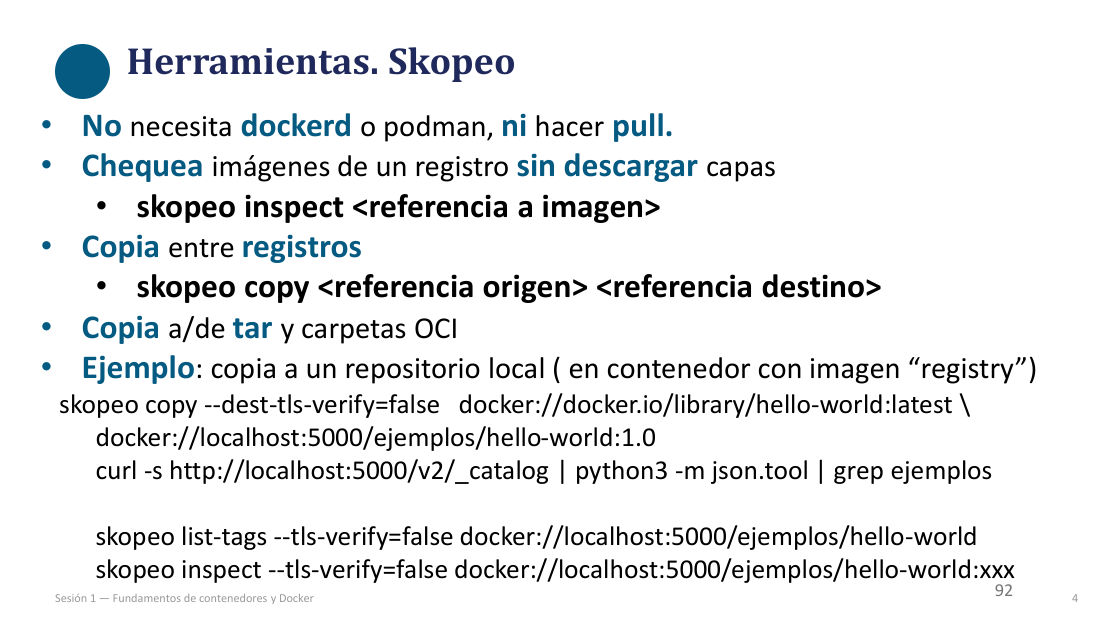
Herramientas. Skopeo
工具:Skopeo。
No necesita
不需要
Chequea imágenes de un
无需下载层就能检查
Copia entre registros
在注册表之间复制镜像。
Copia a/de
可复制为 / 从
Ejemplo: copia a un
示例:复制到本地
# 1) 把 Docker Hub 的 hello-world 复制到本地 5000 端口的私有 registry
skopeo copy --dest-tls-verify=false   docker://docker.io/library/hello-world:latest \
        docker://localhost:5000/ejemplos/hello-world:1.0

# 2) 列出本地 registry 里所有仓库,过滤出 ejemplos 命名空间
curl -s http://localhost:5000/v2/_catalog | python3 -m json.tool | grep ejemplos

# 3) 列出该仓库的所有标签
skopeo list-tags --tls-verify=false docker://localhost:5000/ejemplos/hello-world

# 4) 查看某个具体标签的元数据(xxx 处需换成真实 tag)
skopeo inspect --tls-verify=false docker://localhost:5000/ejemplos/hello-world:xxx
十二、Engine vs Desktop:装什么、怎么装
p.85–p.87Docker Engine vs Docker Desktop · 引擎与桌面的七项对比
▸ 原页截图 p.85(页脚印 93)
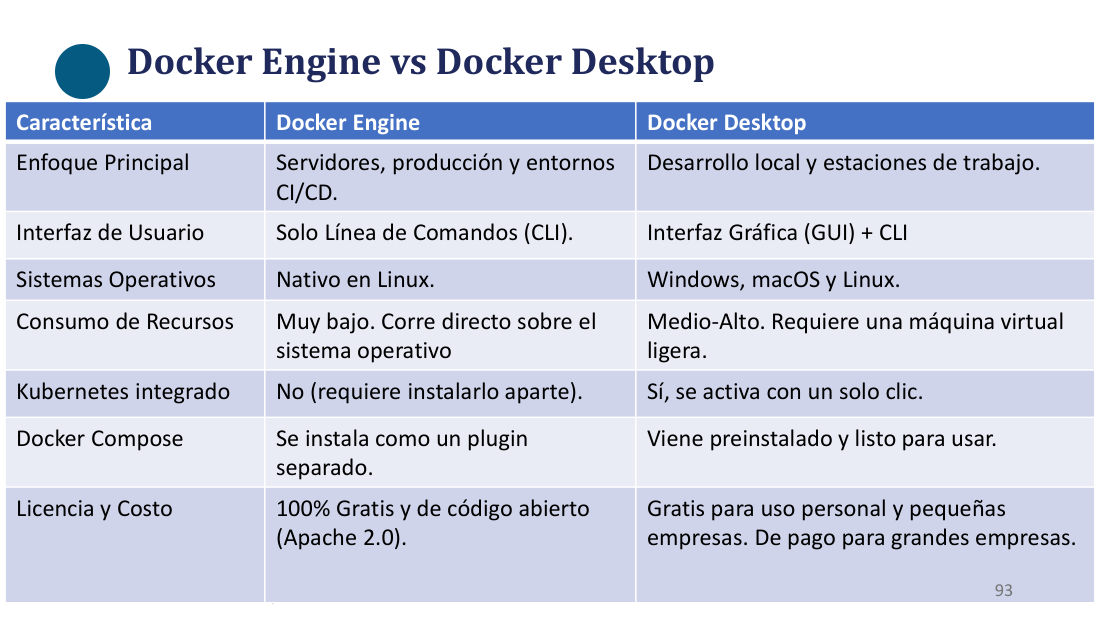
| Característica | Docker Engine | Docker Desktop |
|---|---|---|
| Enfoque Principal | Servidores, producción y entornos CI/CD. | Desarrollo local y estaciones de trabajo. |
| Interfaz de Usuario | Solo Línea de Comandos (CLI). | Interfaz Gráfica (GUI) + CLI |
| Sistemas Operativos | Nativo en Linux. | Windows, macOS y Linux. |
| Consumo de Recursos | Muy bajo. Corre directo sobre el sistema operativo | Medio-Alto. Requiere una máquina virtual ligera. |
| Kubernetes integrado | No (requiere instalarlo aparte). | Sí, se activa con un solo clic. |
| Docker Compose | Se instala como un plugin separado. | Viene preinstalado y listo para usar. |
| Licencia y Costo | 100% Gratis y de código abierto (Apache 2.0). | Gratis para uso personal y pequeñas empresas. De pago para grandes empresas. |
Enfoque Principal — Servidores, producción y entornos CI/CD. / Desarrollo local y estaciones de trabajo.
主要定位 —— 服务器、生产环境与 CI/CD。/ 本地开发与工作站。
Interfaz de Usuario — Solo Línea de Comandos (CLI). / Interfaz Gráfica (GUI) + CLI
用户界面 —— 仅命令行(CLI)。/ 图形界面(GUI)+ CLI。
Sistemas Operativos — Nativo en Linux. / Windows, macOS y Linux.
操作系统 —— Linux 原生。/ Windows、macOS 与 Linux。
Consumo de Recursos — Muy bajo. Corre directo sobre el sistema operativo / Medio-Alto. Requiere una
资源占用 —— 极低,直接跑在操作系统上。/ 中到高,需要一台轻量
Kubernetes integrado — No (requiere instalarlo aparte). / Sí, se activa con un solo clic.
内置 Kubernetes —— 否(需另行安装)。/ 是,一键启用。
Docker Compose — Se instala como un plugin separado. / Viene preinstalado y listo para usar.
Docker Compose —— 作为独立插件安装。/ 预装即用。
Licencia y Costo — 100% Gratis y de código abierto (Apache 2.0). / Gratis para uso personal y pequeñas empresas. De pago para grandes empresas.
许可与费用 —— 100% 免费且开源(Apache 2.0)。/ 个人与小企业免费,大企业付费。
Instalación de Docker Engine · Engine 安装步骤(仅作参考,别执行)
▸ 原页截图 p.86(页脚印 94)
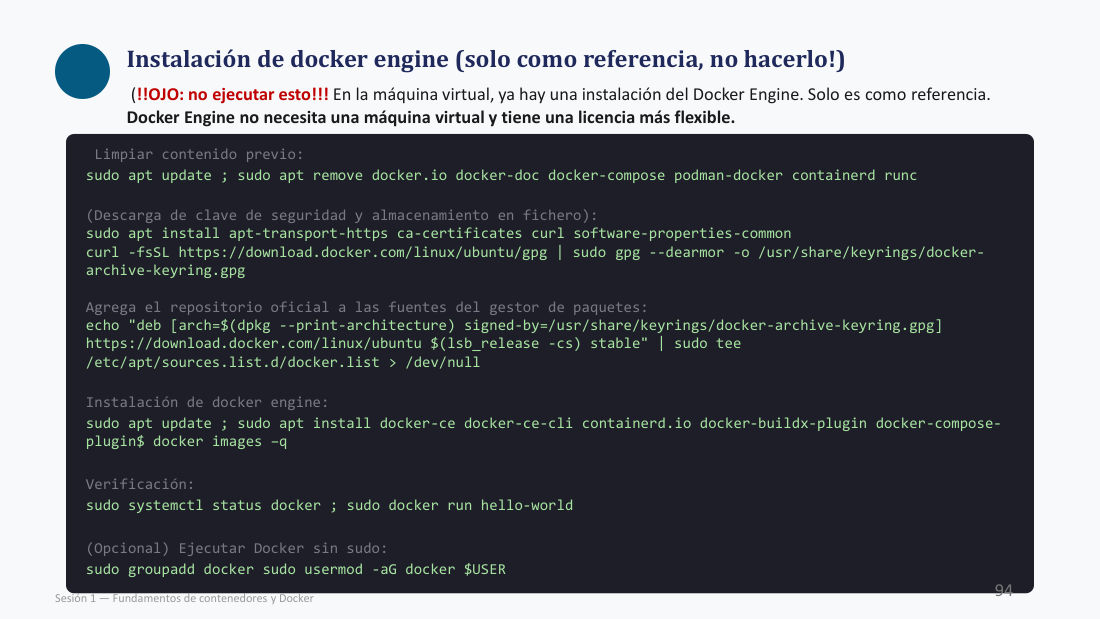
Instalación de docker engine (solo como referencia, no hacerlo!)
Docker Engine 安装(仅作参考,不要执行!)。
(!!OJO: no ejecutar esto!!! En la
(注意:不要执行这些命令!!!
Limpiar contenido previo:
清理旧内容:
(Descarga de clave de seguridad y almacenamiento en fichero):
(下载安全密钥并写入文件):
Agrega el
把官方
Instalación de docker engine:
安装 Docker Engine:
Verificación:
验证:
(Opcional) Ejecutar Docker sin sudo:
(可选)免 sudo 运行 Docker:
# 1) 清理可能冲突的旧包
sudo apt update ; sudo apt remove docker.io docker-doc docker-compose podman-docker containerd runc

# 2) 安装前置依赖
sudo apt install apt-transport-https ca-certificates curl software-properties-common

# 3) 下载 GPG 密钥
curl -fsSL https://download.docker.com/linux/ubuntu/gpg | sudo gpg --dearmor -o /usr/share/keyrings/docker-archive-keyring.gpg

# 4) 添加官方软件源
echo "deb [arch=$(dpkg --print-architecture) signed-by=/usr/share/keyrings/docker-archive-keyring.gpg] https://download.docker.com/linux/ubuntu $(lsb_release -cs) stable" | sudo tee /etc/apt/sources.list.d/docker.list > /dev/null

# 5) 安装 Engine 全家桶
sudo apt update ; sudo apt install docker-ce docker-ce-cli containerd.io docker-buildx-plugin docker-compose-plugin

# 6) 验证
sudo systemctl status docker ; sudo docker run hello-world

# 7) 可选:免 sudo(把当前用户加入 docker 组)
sudo groupadd docker
sudo usermod -aG docker $USER
Instalación de Docker Desktop · Desktop 安装(本课不用)
▸ 原页截图 p.87(页脚印 95)
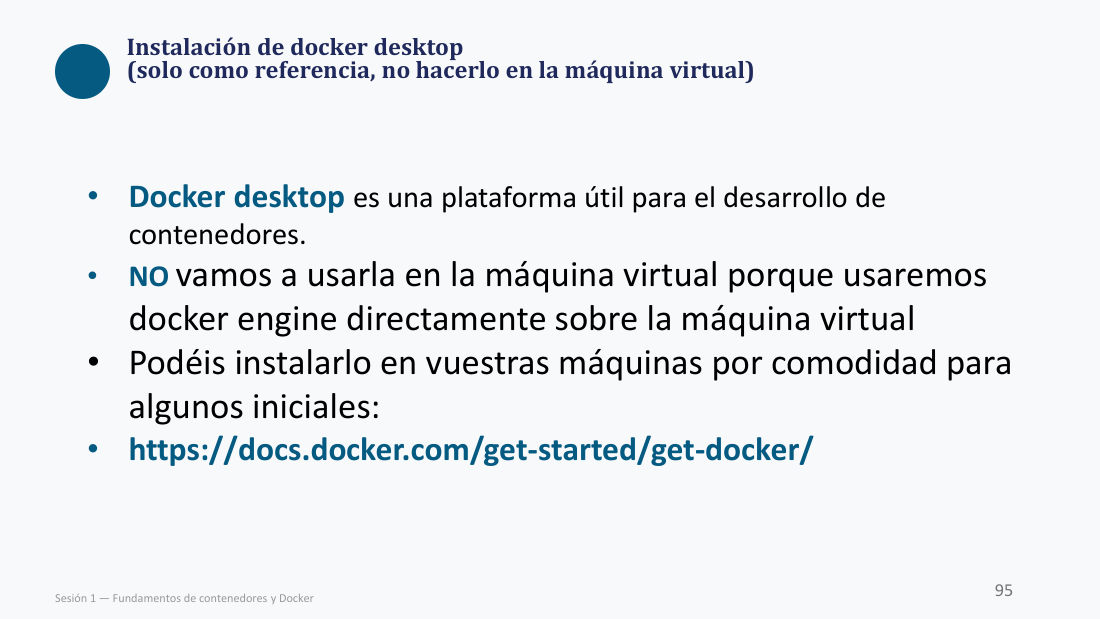
Instalación de docker desktop (solo como referencia, no hacerlo en la
Docker Desktop 安装(仅作参考,不要在
Docker desktop es una plataforma útil para el desarrollo de contenedores.
Docker Desktop 是一个便于容器开发的平台。
NO vamos a usarla en la
我们不会在
Podéis instalarlo en vuestras máquinas por comodidad para algunos iniciales:
你们可以在自己机器上安装,方便做一些入门操作:
https://docs.docker.com/get-started/get-docker/
https://docs.docker.com/get-started/get-docker/
十三、镜像查询与本地管理
p.88–p.95Consulta de Imágenes con Docker · 用命令查询本地镜像
▸ 原页截图 p.88(页脚印 96)
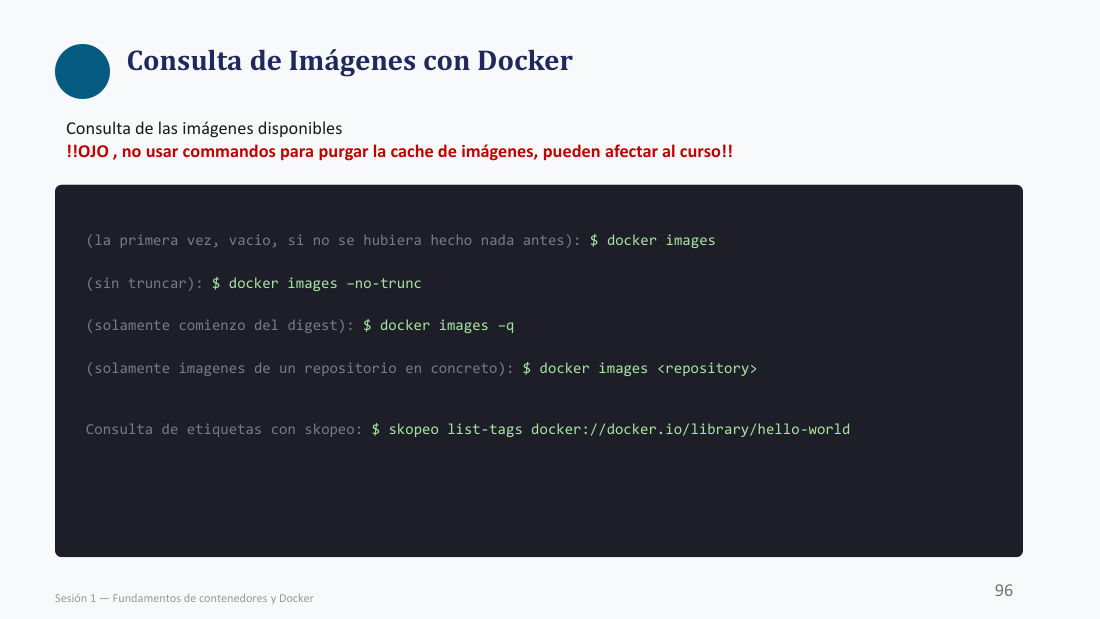
Consulta de Imágenes con Docker
用 Docker 查询镜像。
Consulta de las imágenes disponibles
查询可用镜像。
!!OJO , no usar commandos para purgar la cache de imágenes, pueden afectar al curso!!
注意:不要用命令清空镜像缓存,可能影响课程环境!!
(la primera vez, vacio, si no se hubiera hecho nada antes): $
(第一次执行、此前没做过任何操作时,输出为空):$
(sin truncar): $
(不截断 digest):$
(solamente comienzo del
(只显示
(solamente imagenes de un
(只看某个
Consulta de etiquetas con
用
docker images                 # 列出本地镜像
docker images --no-trunc      # 显示完整 IMAGE ID / digest
docker images -q              # 只输出镜像 ID
docker images <repository>    # 只列某仓库的镜像
skopeo list-tags docker://docker.io/library/hello-world
Consulta de imágenes con Docker Desktop · 用桌面版查镜像
▸ 原页截图 p.89(页脚印 97)
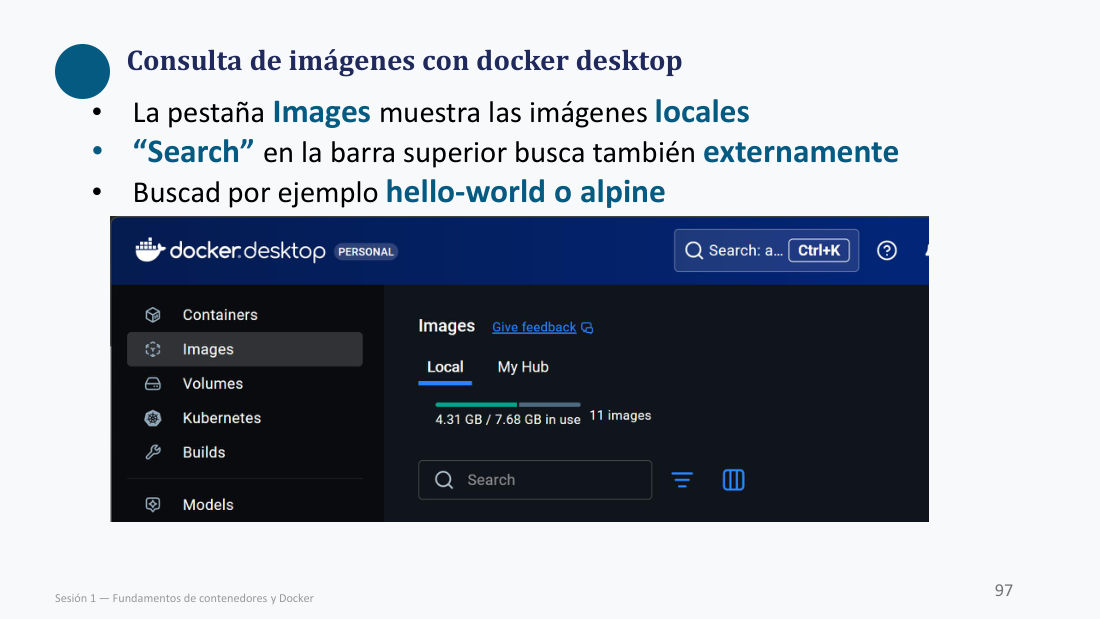
Consulta de imágenes con docker desktop
用 Docker Desktop 查询镜像。
La pestaña Images muestra las imágenes locales
「Images」标签页显示本地镜像。
“Search” en la barra superior busca también externamente
顶部的「Search」还会到外部(Docker Hub)搜索。
Buscad por ejemplo hello-world o alpine
比如搜一下 hello-world 或 alpine。
Consulta de imágenes con Docker Desktop · 界面截图:搜索 alpine
▸ 原页截图 p.90(页脚印 98)
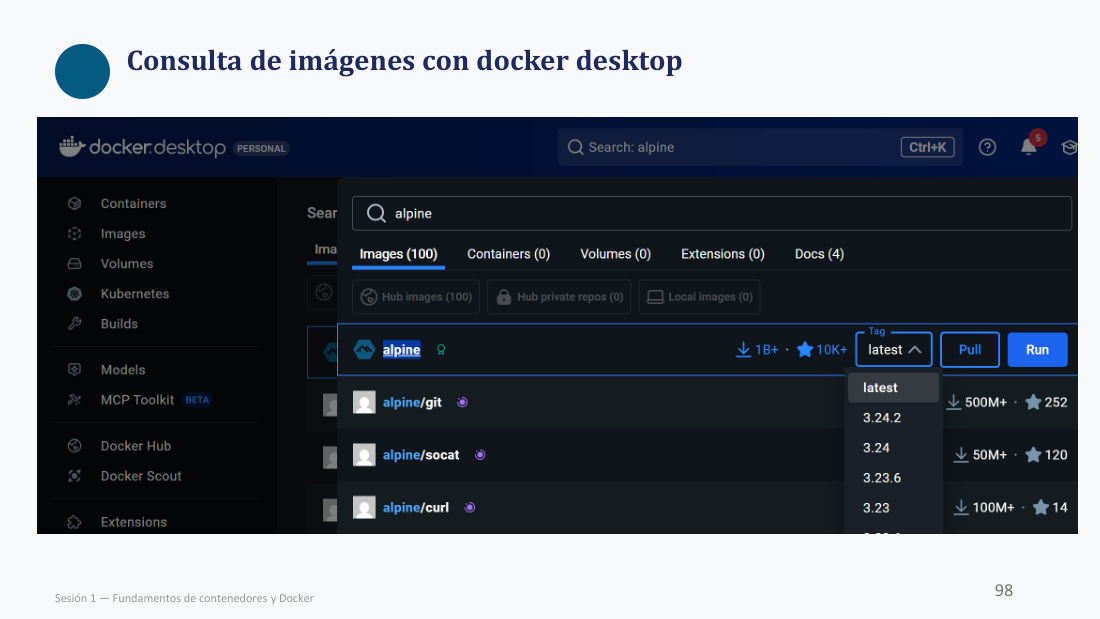
Consulta de imágenes con docker desktop
用 Docker Desktop 查询镜像(本页为纯界面截图)。
| 界面区域(原文) | 中文说明 |
|---|---|
| docker desktop PERSONAL | 左上角品牌与授权类型(个人版)。 |
| Search: alpine Ctrl K | 顶部搜索框,已输入 alpine;Ctrl+K 唤起。 |
| Containers / Images / Volumes / Kubernetes / Builds / Models / MCP Toolkit BETA / Docker Hub / Docker Scout / Extensions | 左侧导航栏的十个入口。 |
| Images (100) Containers (0) Volumes (0) Extensions (0) Docs (4) | 搜索结果分类页签及命中数量。 |
| Hub images (100) Hub private repos (0) Local images (0) | 二级筛选:远程公开 / 远程私有 / 本地。 |
| alpine — Tag: latest → Pull / Run | 官方 alpine 镜像,可选标签,右侧「拉取」「运行」按钮。 |
| latest 3.24.2 3.24 3.23.6 3.23 | Tag 下拉列表中的具体版本。 |
| alpine/git 500M+ ★252 / alpine/socat 50M+ ★120 / alpine/curl 100M+ ★14 | 其余搜索结果:下载量与星标数。 |
Consulta de imágenes con Docker Desktop · 界面截图:本地镜像列表
▸ 原页截图 p.91(页脚印 99)
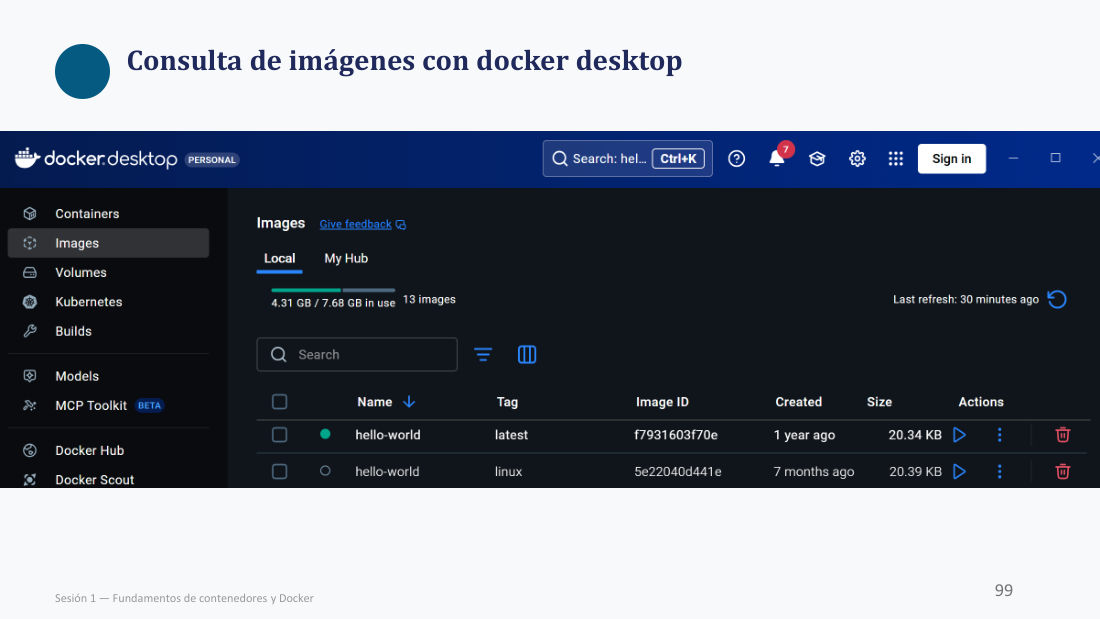
Consulta de imágenes con docker desktop
用 Docker Desktop 查询镜像(本页为纯界面截图)。
| 界面元素(原文) | 中文说明 |
|---|---|
| Images Local My Hub | Images 页签下的两个来源:本地 / 我的 Hub 仓库。 |
| 4.31 GB / 7.68 GB in use 13 images | 磁盘占用(已用 / 上限)与镜像总数。 |
| Last refresh: 30 minutes ago | 上次刷新时间(30 分钟前)。 |
| Name Tag Image ID Created Size Actions | 列表六列:名称、标签、镜像 ID、创建时间、大小、操作。 |
| hello-world latest f7931603f70e 1 year ago 20.34 KB | 第一行:latest 标签,约 20 KB。 |
| hello-world linux 5e22040d441e 7 months ago 20.39 KB | 第二行:linux 标签,另一套 ID 与大小。 |
Inspección de imágenes via CLI · 用 inspect 查看镜像配置
▸ 原页截图 p.92(页脚印 100)
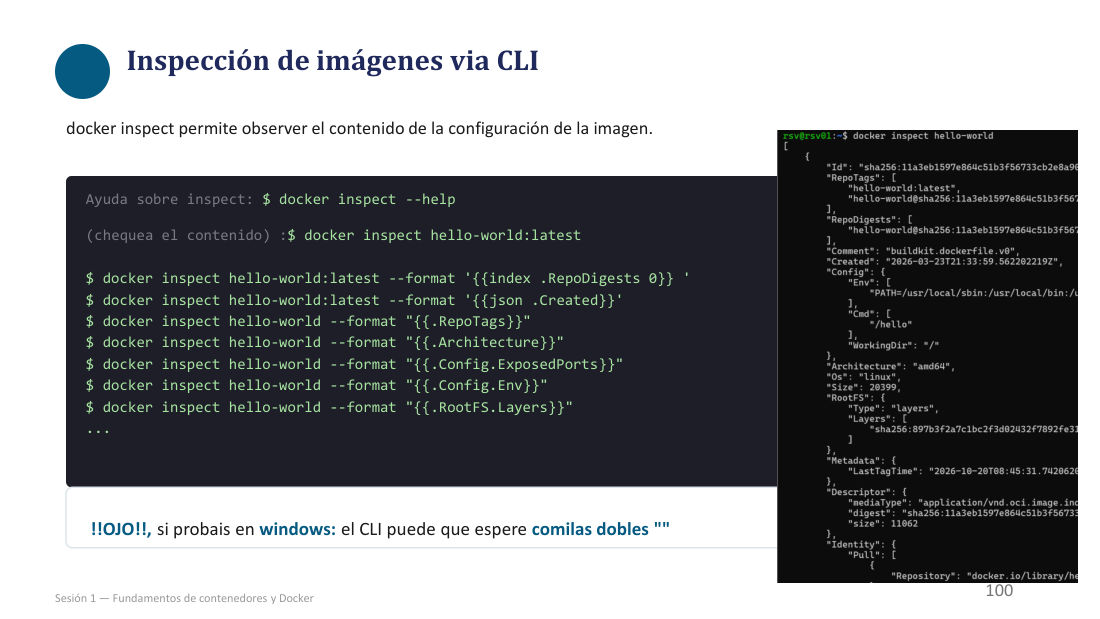
Inspección de imágenes via CLI
通过 CLI 检查镜像。
Ayuda sobre inspect: $
查看 inspect 帮助:$
(chequea el contenido) :$
(检查内容):$
$
取第一个 RepoDigest(注册表里的 digest)。
$
以 JSON 形式输出创建时间。
$
输出该镜像的所有仓库标签。
$
输出镜像架构(amd64 / arm64…)。
$
输出配置里声明的暴露端口。
$
输出环境变量列表。
$
输出根文件系统的所有层 digest。
...
……(原文以省略号表示还有更多字段)
!!OJO!!, si probais en windows: el CLI puede que espere comilas dobles ""
注意:在 Windows 上测试时,CLI 可能要求使用双引号 ""。
docker inspect hello-world:latest
docker inspect hello-world:latest --format '{{index .RepoDigests 0}}'
docker inspect hello-world:latest --format '{{json .Created}}'
docker inspect hello-world --format "{{.RepoTags}}"
docker inspect hello-world --format "{{.Architecture}}"
docker inspect hello-world --format "{{.Config.ExposedPorts}}"
docker inspect hello-world --format "{{.Config.Env}}"
docker inspect hello-world --format "{{.RootFS.Layers}}"
Historia y Capas con docker CLI · 用 history 看每一层怎么来的
▸ 原页截图 p.93(页脚印 101)
Historia y Capas con docker CLI
用 Docker CLI 查看历史与分层。
Cada
每一
Se puede inspeccionar con el comando history:
可以用 history 命令来查看:
docker image history --help
docker image history --help
Consultar la historia de las imagenes:
查询这些镜像的历史:
hello-world, alpine, nginx, python
hello-world、alpine、nginx、python。
docker image history --help
docker image history hello-world
docker image history alpine
docker image history nginx
docker image history python
Historia y Capas con Docker Desktop · 界面截图:nginx 的 8 层
▸ 原页截图 p.94(页脚印 102)
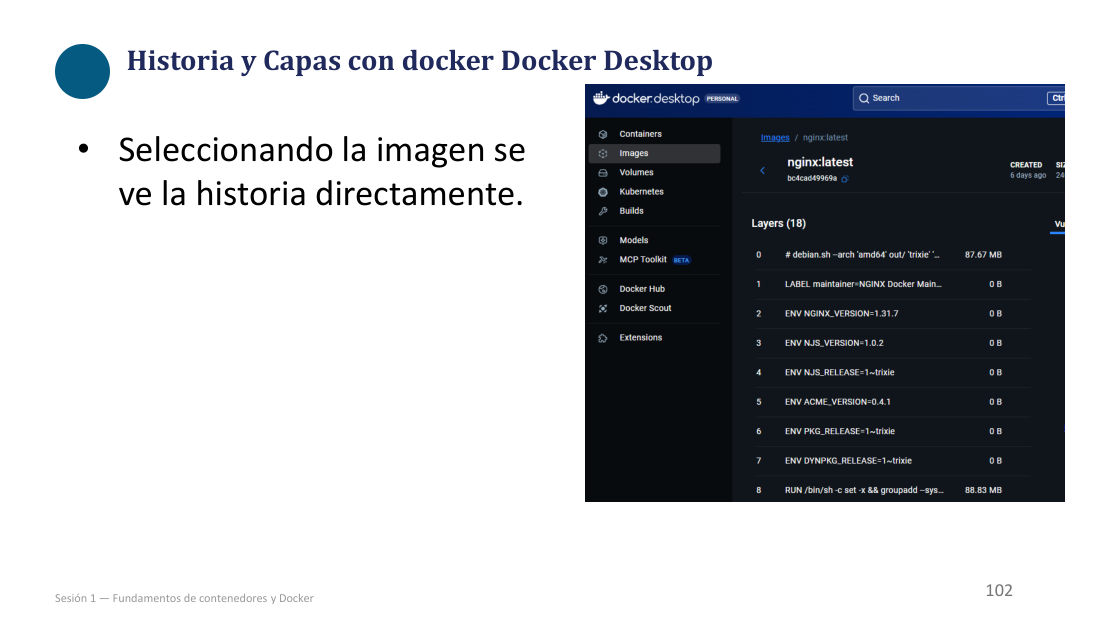
Historia y Capas con docker
用
Seleccionando la
选中
Layers (16)
层(共 16 层)。
| # | 指令(截图原文,节选前 8 层) | 大小 |
|---|---|---|
| 0 | # debian sh -arch amd64 out 'trixie' | 67.67 MB |
| 1 | LABEL maintainer=NGINX Docker Main… | 0 B |
| 2 | ENV NGINX_VERSION=1.31.7 | 0 B |
| 3 | ENV NJS_VERSION=1.0.2 | 0 B |
| 4 | ENV NJS_RELEASE=1~trixie | 0 B |
| 5 | ENV ACME_VERSION=0.4.1 | 0 B |
| 6 | ENV PKG_RELEASE=1~trixie | 0 B |
| 7 | ENV DYNPKG_RELEASE=1~trixie | 0 B |
| 8 | RUN /bin/sh -c set -x && groupadd --sys… | 88.83 MB |
Descarga (pull) de imagen via CLI · 拉取镜像并观察体积
▸ 原页截图 p.95(页脚印 103)
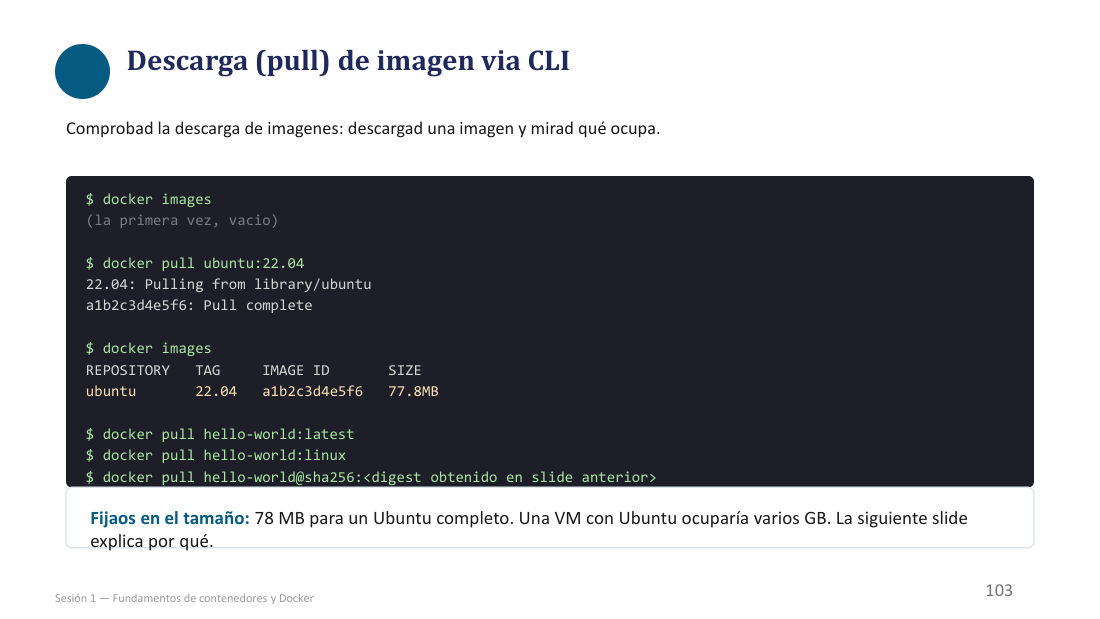
Descarga (pull) de
通过 CLI 拉取
Comprobad la descarga de imagenes: descargad una
验证
(la primera vez, vacio)
(第一次执行时为空。)
$
$
22.04: Pulling from
22.04: Pulling from
$
$
$
$
$
按
Fijaos en el tamaño: 78 MB para un Ubuntu completo. Una VM con Ubuntu ocuparía varios GB. La siguiente slide explica por qué.
注意体积:一个完整的 Ubuntu 只有 78 MB,而 Ubuntu 虚拟机要占好几个 GB。下一页解释原因。
docker images                       # 第一次:空
docker pull ubuntu:22.04
# 22.04: Pulling from library/ubuntu
# a1b2c3d4e5f6: Pull complete
docker images
# REPOSITORY   TAG     IMAGE ID       SIZE
# ubuntu       22.04   a1b2c3d4e5f6   77.8MB

docker pull hello-world:latest
docker pull hello-world:linux
docker pull hello-world@sha256:<digest>
十四、镜像分层:只读模板与写时复制
p.96–p.97Imágenes: qué son y por qué van en capas · 镜像是什么、为什么分层
▸ 原页截图 p.96(页脚印 104)
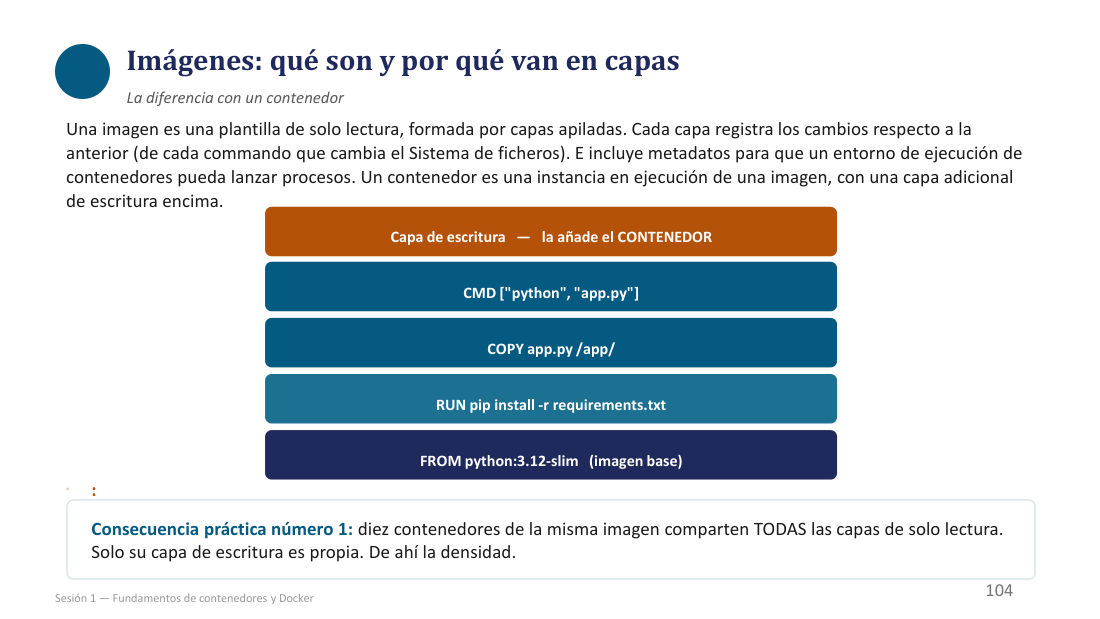
Imágenes: qué son y por qué van en capas
镜像:是什么,以及为什么分层。
La diferencia con un
与
Una
Cada
每一
E incluye metadatos para que un entorno de ejecución de contenedores pueda lanzar procesos.
并且包含元数据,好让容器运行时能够启动进程。
Un
Capa de escritura — la añade el CONTENEDOR
写入层 —— 由容器添加。
CMD ["python", "app.py"]
默认启动命令。
COPY app.py /app/
把应用代码复制进镜像。
安装 Python 依赖。
Consecuencia práctica número 1: diez contenedores de la misma
实用结论一:同一
Solo su
只有各自的写入
┌──────────────────────────────────────────────┐
│ Capa de escritura — la añade el CONTENEDOR   │  ← 可写、每容器独有
└──────────────────────────────────────────────┘
     CMD ["python", "app.py"]        # 元数据(0 B)
     COPY app.py /app/               # 应用代码层
     RUN pip install -r requirements.txt  # 依赖层
     FROM python:3.12-slim           # 基础镜像层(最大)
Dos consecuencias de las capas · 分层带来的两个后果
▸ 原页截图 p.97(页脚印 105)
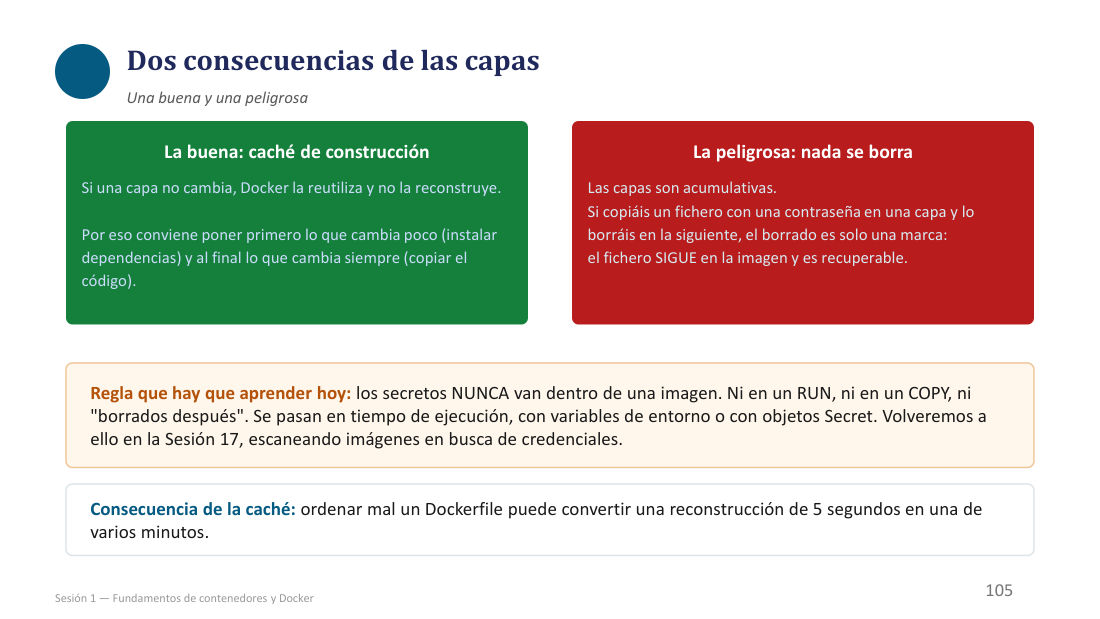
Dos consecuencias de las capas
分层带来的两个后果。
Una buena y una peligrosa
一个好消息,一个危险信号。
La buena:
好消息:
Si una
如果某
Por eso conviene poner primero lo que cambia poco (instalar dependencias) y al final lo que cambia siempre (copiar el código).
所以要把「很少变的东西」放前面(安装依赖),把「每次都变的东西」放最后(拷贝代码)。
La peligrosa: nada se borra
危险的一面:什么都不会真正被删掉。
Las capas son acumulativas.
层是累积叠加的。
Si copiáis un fichero con una contraseña en una
如果你在某一
Regla que hay que aprender hoy: los secretos NUNCA van dentro de una
今天必须记住的规则:机密永远不要放进
Se pasan en tiempo de ejecución, con variables de entorno o con objetos Secret.
机密要在运行时传入:用环境变量,或用 Secret 对象。
Volveremos a ello en la Sesión 17, escaneando imágenes en busca de credenciales.
第 17 讲还会回到这个话题:扫描镜像里有没有凭据。
Consecuencia de la caché: ordenar mal un
缓存的连带后果:
十五、Dockerfile:九条指令与构建缓存
p.98–p.101Tarea — ver las capas de una imagen · 任务:看清一个镜像的层
▸ 原页截图 p.98(页脚印 106)
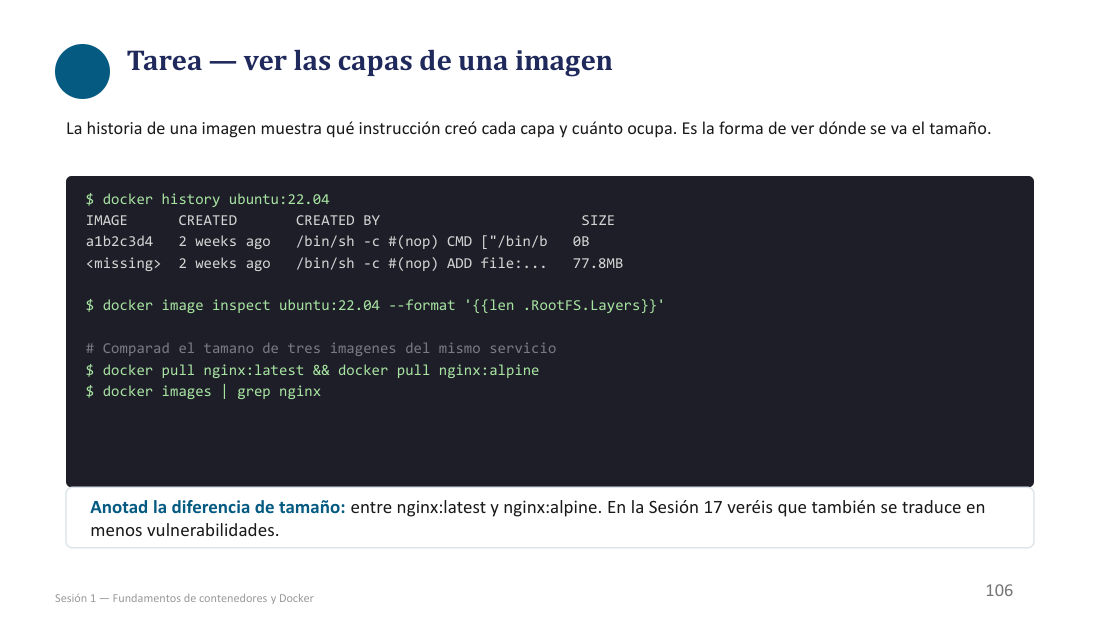
Tarea — ver las capas de una
任务:查看一个
La historia de una
| IMAGE | CREATED | CREATED BY | SIZE |
|---|---|---|---|
| a1b2c3d4 | 2 weeks ago | /bin/sh -c #(nop) CMD ["/bin/b | 0B |
| <missing> | 2 weeks ago | /bin/sh -c #(nop) ADD file:... | 77.8MB |
$ docker history ubuntu:22.04

$ docker image inspect ubuntu:22.04 --format '{{len .RootFS.Layers}}'

# Comparad el tamano de tres imagenes del mismo servicio
$ docker pull nginx:latest && docker pull nginx:alpine
$ docker images | grep nginx
Anotad la diferencia de tamaño: entre nginx:
把两者的体积差记下来:nginx:
El Dockerfile: la receta de una imagen · Dockerfile:镜像的配方
▸ 原页截图 p.99(页脚印 107)
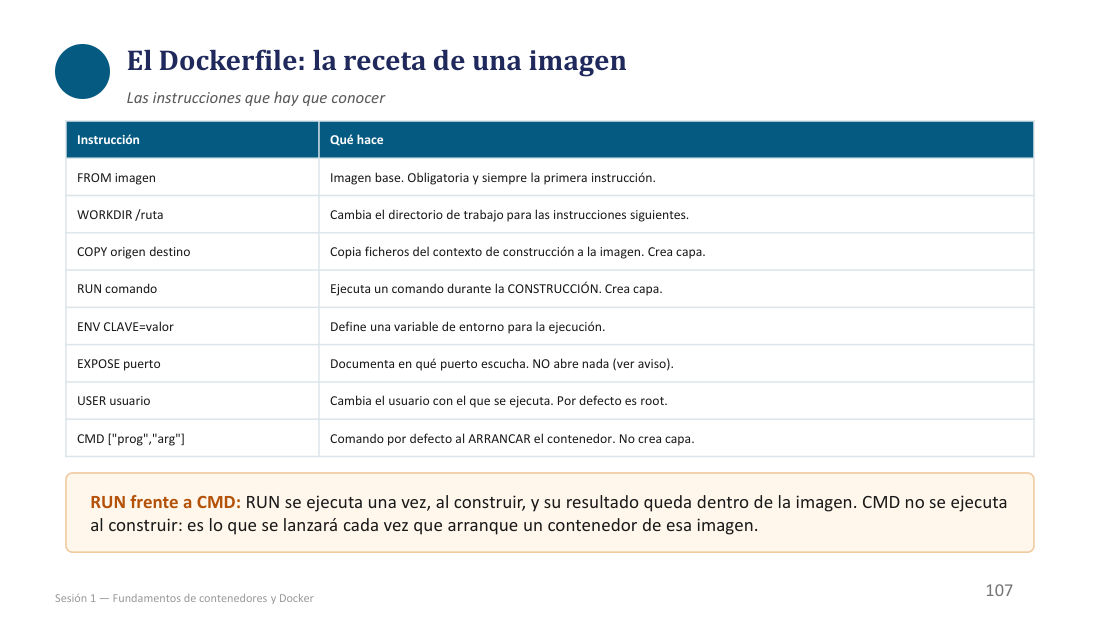
El
Las instrucciones que hay que conocer
必须认识的指令。
| Instrucción | Qué hace |
|---|---|
| FROM imagen | Imagen base. Obligatoria y siempre la primera instrucción. |
| WORKDIR /ruta | Cambia el directorio de trabajo para las instrucciones siguientes. |
| COPY origen destino | Copia ficheros del contexto de construcción a la imagen. Crea capa. |
| RUN comando | Ejecuta un comando durante la CONSTRUCCIÓN. Crea capa. |
| ENV CLAVE=valor | Define una variable de entorno para la ejecución. |
| EXPOSE puerto | Documenta en qué puerto escucha. NO abre nada (ver aviso). |
| USER usuario | Cambia el usuario con el que se ejecuta. Por defecto es root. |
| CMD ["prog","arg"] | Comando por defecto al ARRANCAR el contenedor. No crea capa. |
Tarea — construir vuestra primera imagen · 任务:构建你的第一个镜像
▸ 原页截图 p.100(页脚印 108)
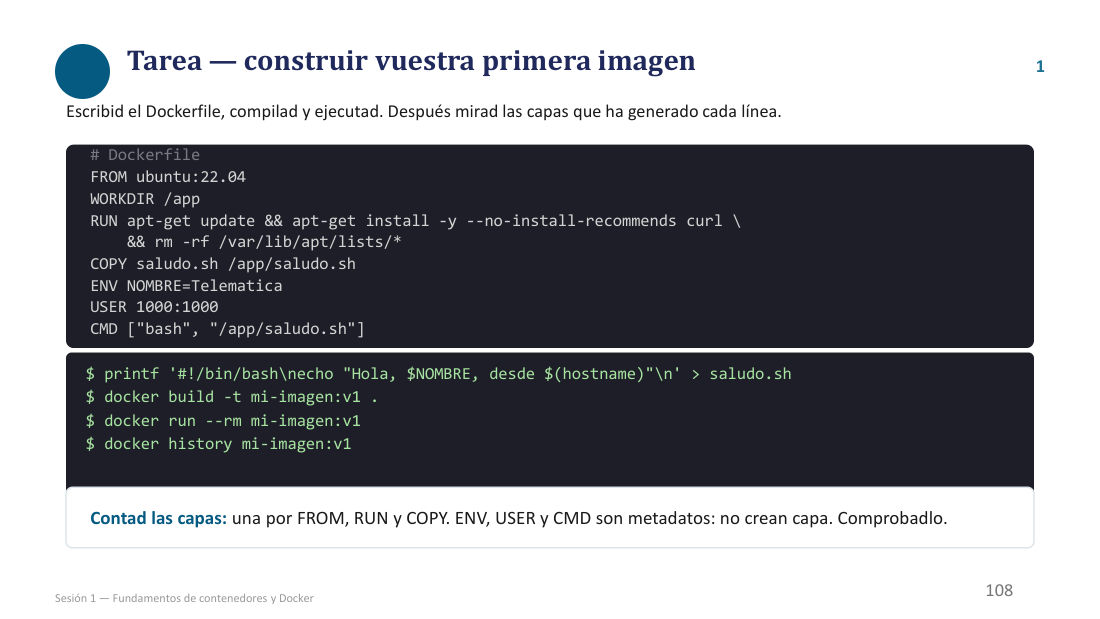
Tarea — construir vuestra primera
任务:构建你们的第一个
1
(左上角孤立的步骤序号「1」)
Escribid el
写出
# Dockerfile
FROM ubuntu:22.04
WORKDIR /app
RUN apt-get update && apt-get install -y --no-install-recommends curl \
    && rm -rf /var/lib/apt/lists/*
COPY saludo.sh /app/saludo.sh
ENV NOMBRE=Telematica
USER 1000:1000
CMD ["bash", "/app/saludo.sh"]

$ printf '#!/bin/bash\necho "Hola, $NOMBRE, desde $(hostname)"\n' > saludo.sh
$ docker build -t mi-imagen:v1 .
$ docker run --rm mi-imagen:v1
$ docker history mi-imagen:v1
Contad las capas: una por
数一数
Tarea — ver la caché de construcción funcionando · 任务:让构建缓存跑起来
▸ 原页截图 p.101(页脚印 109)
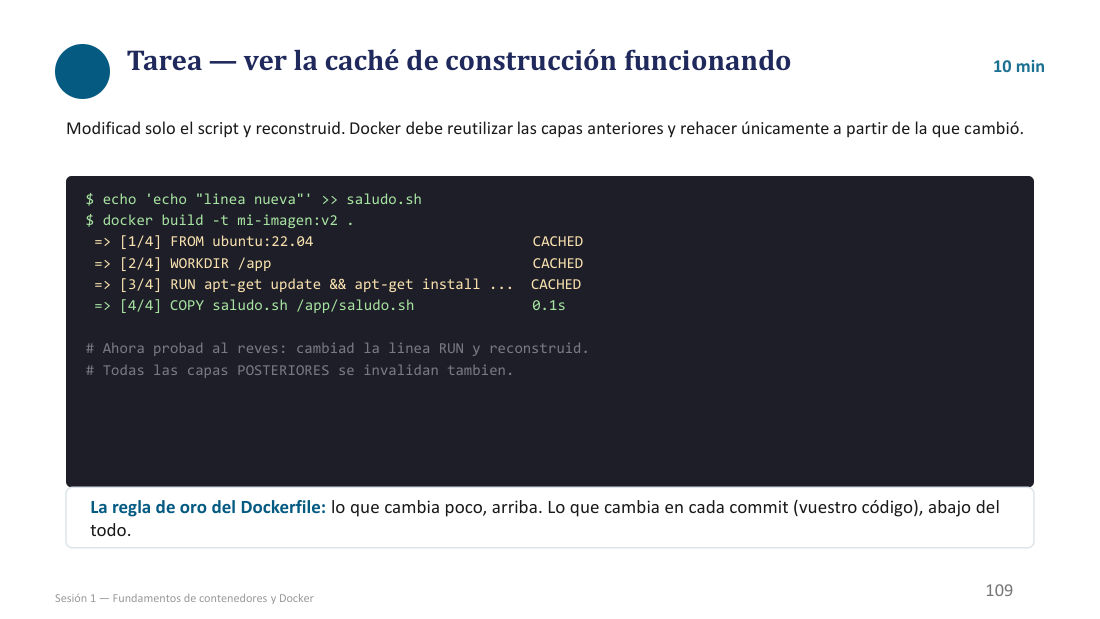
Tarea — ver la
任务:亲眼看到
10 min
限时 10 分钟。
Modificad solo el script y reconstruid. Docker debe reutilizar las capas anteriores y rehacer únicamente a partir de la que cambió.
只改脚本,然后重新构建。Docker 应当复用前面的层,只从「变了的那一层」开始重做。
| 构建步骤(原文输出) | 耗时 | 含义 |
|---|---|---|
| => [1/4] FROM ubuntu:22.04 | CACHED | 基础层没变,直接复用 |
| => [2/4] WORKDIR /app | CACHED | 元数据指令,命中缓存 |
| => [3/4] RUN apt-get update && apt-get install ... | CACHED | 依赖层没变,省下最贵的一步 |
| => [4/4] COPY saludo.sh /app/saludo.sh | 0.1s | 只有这层真的重建 |
$ echo 'echo "linea nueva"' >> saludo.sh
$ docker build -t mi-imagen:v2 .

# Ahora probad al reves: cambiad la linea RUN y reconstruid.
# Todas las capas POSTERIORES se invalidan tambien.
La regla de oro del
十六、再谈隔离:namespace 与 cgroup 实操
p.102–p.106Primera pieza del aislamiento: namespaces · 隔离的第一块拼图:命名空间
▸ 原页截图 p.102(页脚印 110)
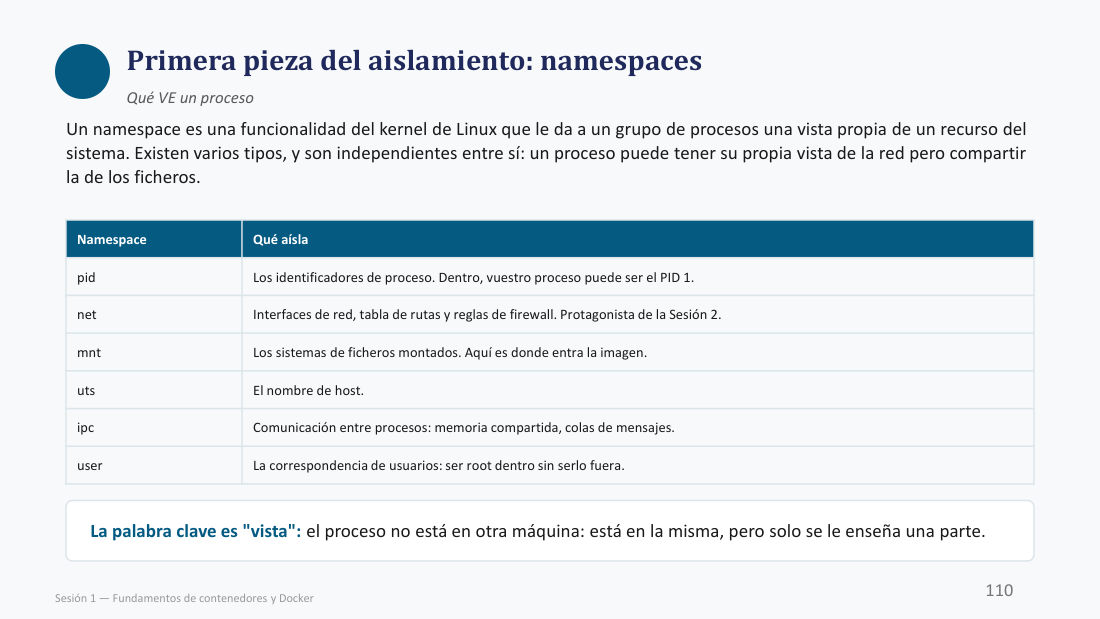
Primera pieza del
Qué VE un proceso
一个进程「看得见什么」。
Un
| Namespace | Qué aísla |
|---|---|
| pid | Los identificadores de proceso. Dentro, vuestro proceso puede ser el PID 1. |
| net | Interfaces de red, tabla de rutas y reglas de firewall. Protagonista de la Sesión 2. |
| mnt | Los sistemas de ficheros montados. Aquí es donde entra la imagen. |
| uts | El nombre de host. |
| ipc | Comunicación entre procesos: memoria compartida, colas de mensajes. |
| user | La correspondencia de usuarios: ser root dentro sin serlo fuera. |
La palabra clave es "
关键词是「
Tarea — ver el namespace pid en acción · 任务:亲眼看 pid 命名空间
▸ 原页截图 p.103(页脚印 112)
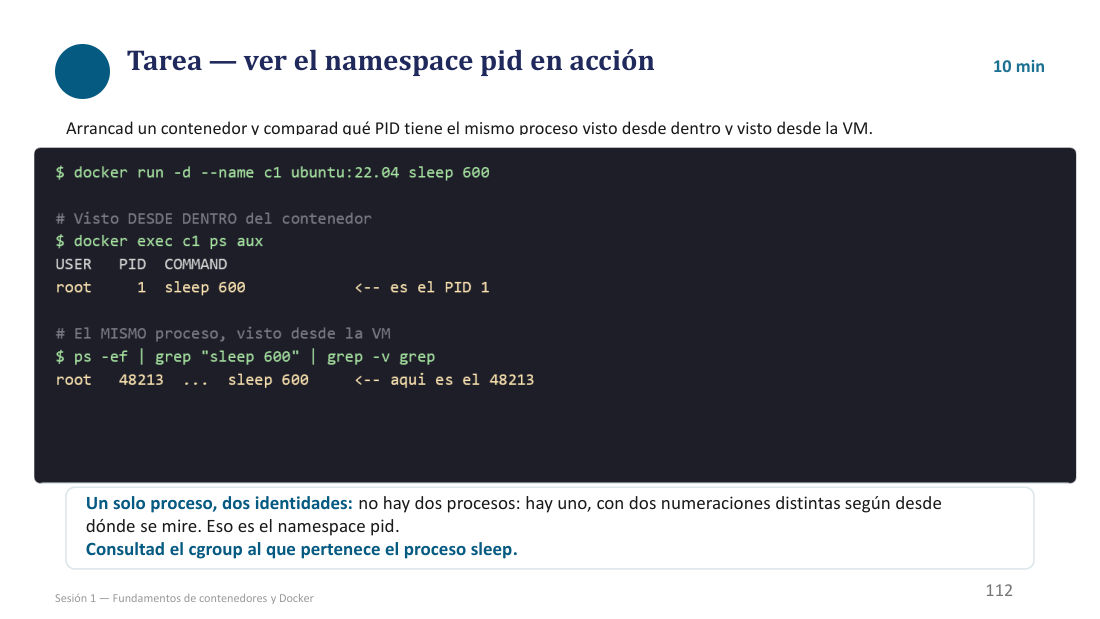
Tarea — ver el
任务:让 pid
10 min
限时 10 分钟。
Arrancad un
起一个
$ docker run -d --name c1 ubuntu:22.04 sleep 600

# Visto DESDE DENTRO del contenedor
$ docker exec c1 ps aux
USER   PID  COMMAND
root     1  sleep 600        <-- es el PID 1

# El MISMO proceso, visto desde la VM
$ ps -ef | grep "sleep 600" | grep -v grep
root  48213  ...  sleep 600   <-- aqui es el 48213
Un solo proceso, dos identidades: no hay dos procesos: hay uno, con dos numeraciones distintas según desde dónde se mire. Eso es el
一个进程,两个身份:根本不是两个进程,只有一个,只是从哪儿看就有两套编号。这就是 pid
Consultad el
再查一下这个 sleep 进程属于哪个
Tarea — ver los namespaces directamente en el kernel · 任务:直接在内核里看命名空间
▸ 原页截图 p.104(页脚印 114)
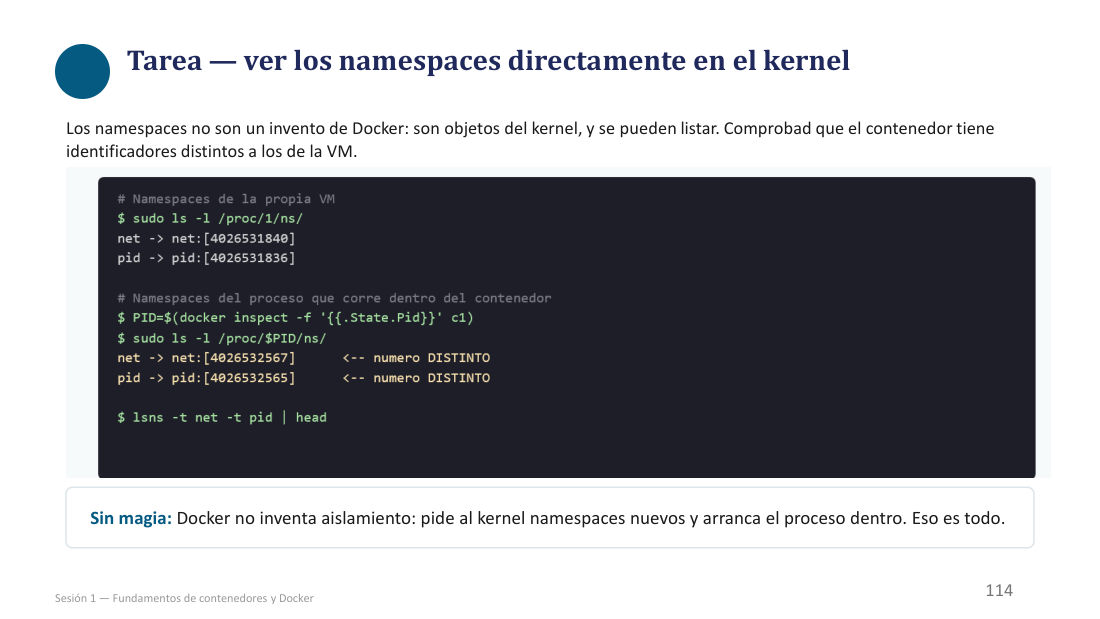
Tarea — ver los namespaces directamente en el kernel
任务:绕过 Docker,直接去内核里看命名空间。
Los namespaces no son un invento de Docker: son objetos del kernel, y se pueden listar. Comprobad que el
命名空间不是 Docker 发明的:它们是内核对象,可以列出来。去验证
# Namespaces de la propia VM
$ sudo ls -l /proc/1/ns/
net -> net:[4026531840]
pid -> pid:[4026531836]

# Namespaces del proceso que corre dentro del contenedor
$ PID=$(docker inspect -f '{{.State.Pid}}' c1)
$ sudo ls -l /proc/$PID/ns/
net -> net:[4026532567]      <-- numero DISTINTO
pid -> pid:[4026532565]      <-- numero DISTINTO

$ lsns -t net -t pid | head
Sin magia: Docker no inventa
没有魔法:Docker 不「发明」
Segunda pieza: cgroups · 第二块拼图:控制组
▸ 原页截图 p.105(页脚印 115)
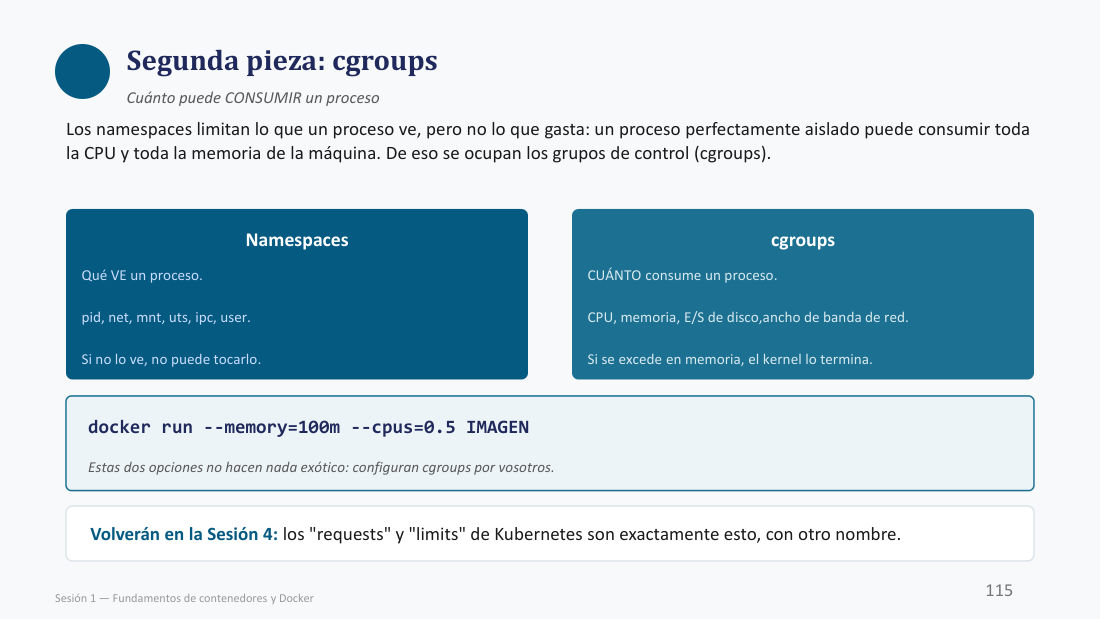
Segunda pieza: cgroups
第二块拼图:cgroups(控制组)。
Cuánto puede CONSUMIR un proceso
一个进程「能吃掉多少」。
Los namespaces limitan lo que un proceso ve, pero no lo que gasta: un proceso perfectamente aislado puede consumir toda la CPU y toda la memoria de la máquina. De eso se ocupan los
命名空间限制「看得见什么」,但不限制「花多少」:一个隔离得再完美的进程,照样能吃掉整台机器的 CPU 和内存。管这件事的,就是
| Namespaces | cgroups |
|---|---|
| Qué VE un proceso. | CUÁNTO consume un proceso. |
| pid, net, mnt, uts, ipc, user. | CPU, memoria, E/S de disco, ancho de banda de red. |
| Si no lo ve, no puede tocarlo. | Si se excede en memoria, el kernel lo termina. |
docker run --memory=100m --cpus=0.5 IMAGEN
Estas dos opciones no hacen nada exótico: configuran cgroups por vosotros.
这两个选项一点也不玄乎:它们只是替你去配置 cgroups。
Volverán en la Sesión 4: los "requests" y "limits" de Kubernetes son exactamente esto, con otro nombre.
第 4 讲还会遇到它们:Kubernetes 里的 requests 和 limits 就是这玩意儿,换了个名字而已。
Tarea — comprobar un límite de cgroups · 任务:验证 cgroup 限额真的会动手
▸ 原页截图 p.106(页脚印 116)
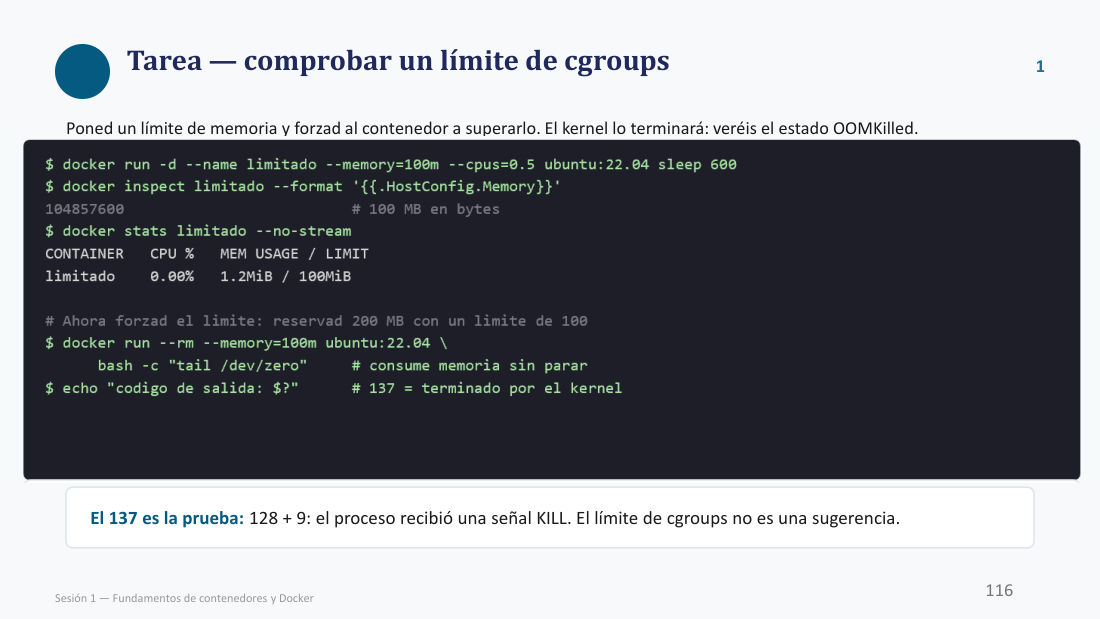
Tarea — comprobar un límite de cgroups
任务:验证 cgroup 内存限额。
1
(左上角孤立的步骤序号「1」)
Poned un límite de memoria y forzad al
给
$ docker run -d --name limitado --memory=100m --cpus=0.5 ubuntu:22.04 sleep 600
$ docker inspect limitado --format '{{.HostConfig.Memory}}'
104857600        # 100 MB en bytes
$ docker stats limitado --no-stream
CONTAINER   CPU %   MEM USAGE / LIMIT
limitado    0.00%   1.2MiB / 100MiB

# Ahora forzad el limite: reservad 200 MB con un límite de 100
$ docker run --rm --memory=100m ubuntu:22.04 \
    bash -c "tail /dev/zero"    # consume memoria sin parar
$ echo "codigo de salida: $?"   # 137 = terminado por el kernel
El 137 es la prueba: 128 + 9: el proceso recibió una
137 就是证据:128 + 9,说明进程收到了 KILL
十七、安全边界与参考书目
p.107–p.108Un contenedor no es una caja fuerte · 容器不是保险箱
▸ 原页截图 p.107(页脚印 120)
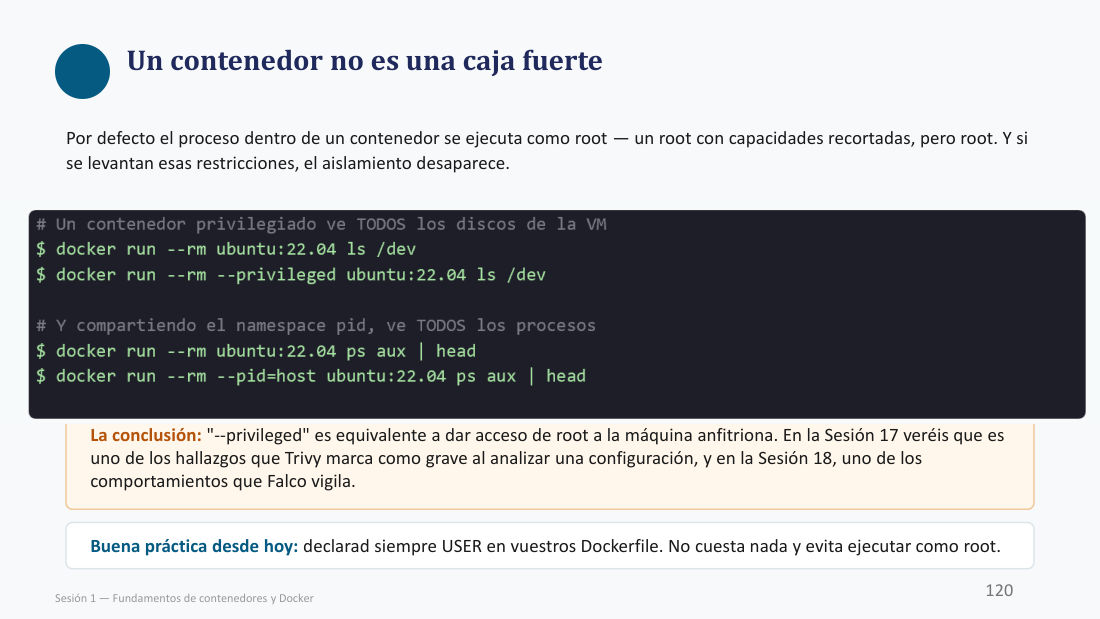
Un
Por defecto el proceso dentro de un
默认情况下
# Un contenedor privilegiado ve TODOS los discos de la VM
$ docker run --rm ubuntu:22.04 ls /dev
$ docker run --rm --privileged ubuntu:22.04 ls /dev

# Y compartiendo el namespace pid, ve TODOS los procesos
$ docker run --rm ubuntu:22.04 ps aux | head
$ docker run --rm --pid=host ubuntu:22.04 ps aux | head
La conclusión: "
结论:
Buena práctica desde hoy: declarad siempre
从今天起的好习惯:
Bibliografía y recursos · 参考书目与资源
▸ 原页截图 p.108(页脚印 122)
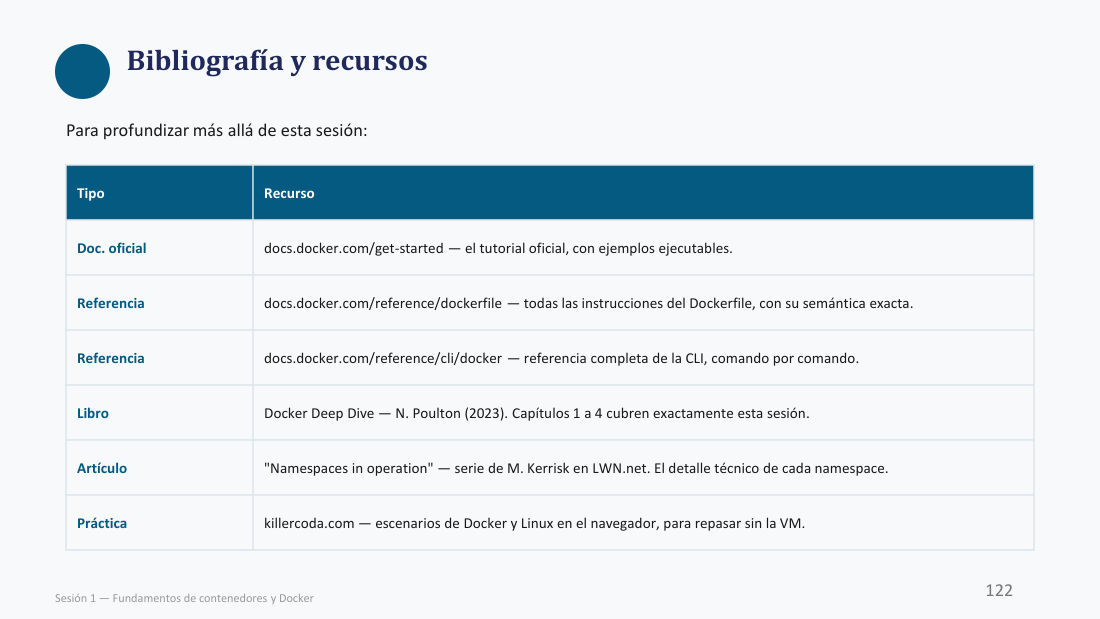
Bibliografía y recursos
参考书目与资源。
Para profundizar más allá de esta sesión:
想在本讲之外继续深入:
| Tipo | Recurso |
|---|---|
| Doc. oficial | docs.docker.com/get-started — el tutorial oficial, con ejemplos ejecutables. |
| Referencia | docs.docker.com/reference/dockerfile — todas las instrucciones del Dockerfile, con su semántica exacta. |
| Referencia | docs.docker.com/reference/cli/docker — referencia completa de la CLI, comando por comando. |
| Libro | Docker Deep Dive — N. Poulton (2023). Capítulos 1 a 4 cubren exactamente esta sesión. |
| Artículo | "Namespaces in operation" — serie de M. Kerrisk en LWN.net. El detalle técnico de cada namespace. |
| Práctica | killercoda.com — escenarios de Docker y Linux en el navegador, para repasar sin la VM. |
十八、专有名词总表
A–Z · 全章 108 页专有名词速记表(A–Z)
共 95 条,覆盖全 108 页的高频术语。按西语字母排序(ñ 排在 n 之后),点页码直接跳回对应页块。末列只写一句话记忆点或易错处,不重复中文列。
| 西语术语 | 中文 | 页 | 一句话记住 / 易错点 |
|---|---|---|---|
| A | |||
| ADD | ADD 指令 | p.65 | 像 COPY 的加强版:能解 tar、能拉 URL,但构建结果不可预测,考试专考它与 COPY 的分界。 |
| aislamiento | 隔离 | p.52 | 容器=普通 Linux 进程+namespaces(隔离)+cgroups(限额),一句背下来。 |
| anfitrión | 宿主机 | p.50 | SO anfitrión 的 kernel 由全部容器共享,这正是容器轻量的根源。 |
| arquitectura cliente-demonio-registro | 客户端-守护进程-注册表三段架构 | p.61 | docker 只是客户端,干活的是 dockerd,镜像来自 registro。 |
| B | |||
| buildx | 构建插件 | p.86 | docker-buildx-plugin 与 docker-ce、containerd.io 一起装。 |
| C | |||
| caché de construcción | 构建缓存 | p.97 | 某层不变就复用;改动上层会让它下面全部失效。 |
| capa | 层 | p.96 | 镜像=只读层叠加;容器=再盖一层可写层。 |
| cgroup | 控制组 | p.8 | 回答「能用多少」:CPU、内存、进程数。 |
| cgroup.controllers | 可用控制器列表 | p.11 | 只读文件,告诉你这个 cgroup 支持哪些控制器。 |
| cgroup.freeze | 冻结开关 | p.17 | 写 1 冻结、写 0 解冻;进程还在,只是不动。 |
| cgroup.kill | 整组击杀 | p.18 | 写 1 把组内所有进程一起杀掉,比逐个 kill 干净。 |
| cgroup.procs | 组内进程列表 | p.11 | 写 PID 进来=把进程加入该组;读它就是成员清单。 |
| cgroup.subtree_control | 子树控制器开关 | p.12 | 决定子 cgroup 能启用哪些控制器,例如写入 +pids。 |
| cgroup.threads | 组内线程列表 | p.11 | 按线程粒度管理,和 procs 的差别只在「线程 vs 进程」。 |
| cgset / cgget | 设置 / 读取 cgroup 参数 | p.16 | cgset -r memory.max=2G,再用 cgget -r 读回来验证。 |
| chroot | 改根目录 | p.41 | 只隔离文件视角,不隔离进程与网络,所以还不是容器。 |
| cliente Docker | Docker 客户端 | p.61 | 只发请求不执行,请求经 socket 交给守护进程。 |
| CNCF | 云原生计算基金会 | p.58 | containerd 是 CNCF graduated 项目,Harbor 也是。 |
| containerd | 容器运行时守护进程 | p.58 | 向下调 runc,向上提供 CRI,是中间管理层。 |
| contenedor | 容器 | p.50 | 不是虚拟机:它是宿主机上一个被限制了视野和配额的普通进程。 |
| controlador | 控制器 | p.12 | cpu / memory / pids / cpuset 等,各自只管一类资源。 |
| CRI | 容器运行时接口 | p.58 | Kubernetes 通过 CRI 调 containerd 或 CRI-O。 |
| CRI-O | 轻量 CRI 实现 | p.74 | 极简 CRI 实现,底层同样用 runc。 |
| crictl | CRI 调试 CLI | p.58 | 与 nerdctl 并列,是 containerd 侧的常用工具。 |
| cpuset.cpus | CPU 亲和 | p.23 | 把 cgroup 绑到指定核,例如只给 0 和 1。 |
| D | |||
| digest | 摘要 | p.81 | SHA256 校验和,内容不变就永不变,生产环境用它锁版本。 |
| Distribution | 分发规范 | p.83 | OCI 三规范之一,规定注册表的 /v2/ 接口。 |
| Docker Desktop | 桌面版 | p.85 | Windows / macOS 上带 GUI 与虚拟机的整套环境。 |
| Docker Engine | Docker 引擎 | p.85 | Linux 上的 docker-ce + dockerd + containerd 组合。 |
| Docker Hub | 官方公共注册表 | p.79 | 默认 registro,library 空间放官方镜像。 |
| docker build | 构建镜像 | p.100 | 按 Dockerfile 逐层构建,命中缓存会显示 CACHED。 |
| docker exec | 进容器执行命令 | p.103 | 在已运行容器里开新进程,验证 pid namespace 就靠它。 |
| docker history | 看层历史 | p.98 | 一行一层,0B 的那些就是元数据指令。 |
| docker images | 列本地镜像 | p.88 | -q 只看 ID,--no-trunc 不截断。 |
| docker inspect | 查配置 | p.92 | --format '{{...}}' 取字段,例如 RootFS.Layers。 |
| docker pull | 拉镜像 | p.88 | 不写标签默认 latest;也可写 digest 精确拉取。 |
| docker run | 运行容器 | p.62 | 等于 pull(必要时)+create+start 的快捷方式。 |
| docker search | 搜镜像 | p.64 | 在 Docker Hub 上按名字搜索。 |
| docker stats | 实时资源 | p.106 | 看到 1.2MiB / 100MiB 就说明 memory.max 生效了。 |
| dockerd | Docker 守护进程 | p.61 | 真正负责构建、运行、分发容器的那一个。 |
| Dockerfile | 构建配方 | p.99 | 一行一条指令,自上而下构建。 |
| E | |||
| ENTRYPOINT | 入口点 | p.68 | 固定入口,CMD 则充当它的默认参数。 |
| ENV | 环境变量 | p.69 | 构建期写入的环境变量,不产生新层。 |
| espacio (library) | 命名空间 / 官方空间 | p.81 | library 是 Docker Hub 留给官方镜像的空间。 |
| etiqueta | 标签 | p.81 | 可以被重新指派,所以不可靠;latest 就是默认标签。 |
| EXPOSE | 声明端口 | p.67 | 只是文档声明,不发布端口;真正发布要靠 -p。 |
| F | |||
| Falco | 运行时安全监控 | p.107 | 第十八讲专讲,监控 --privileged 这类危险行为。 |
| FROM | 基础镜像 | p.64 | Dockerfile 的第一条,决定整栋楼的起点。 |
| G | |||
| gestión de registros | 注册表管理 | p.59 | containerd 的职责之一:镜像与注册表管理。 |
| grupos de control | 控制组(复数) | p.8 | cgroups 的西语全称写法,和 cgroup 指同一件事。 |
| H | |||
| Harbor | 企业级注册表 | p.82 | CNCF graduated,比裸的 Registry v2 安全得多。 |
| I | |||
| imagen | 镜像 | p.77 | 只读模板,跑起来才变成容器。 |
| Image spec | 镜像规范 | p.83 | manifest + configuration + layers 三件套。 |
| K | |||
| Kata Containers | 安全容器 | p.75 | 每个容器配独立内核,兼顾隔离强度与启动速度。 |
| kernel compartido | 共享内核 | p.50 | 所有容器共用宿主机内核,所以不能换成别的内核。 |
| L | |||
| latest | 默认标签 | p.81 | 不写标签就是它,内容随时可能被替换。 |
| libcontainer | 容器库 | p.57 | runc 的前身,由 Docker 开源出来。 |
| library | 官方空间 | p.81 | docker.io/library/nginx 里中间那一段。 |
| LXC | Linux 容器 | p.47 | lxc-create --name 建容器,Docker 之前的主流方案。 |
| lsns | 列出命名空间 | p.29 | 由 util-linux 提供,能列出系统里所有 namespace。 |
| M | |||
| manifest | 清单 | p.83 | JSON 文件,列出各层 digest 与 configuration。 |
| máquina virtual | 虚拟机 | p.49 | 虚拟化硬件、跑完整操作系统,重但隔离强。 |
| memory.events | 内存事件计数 | p.22 | 看 OOM 次数,判断有没有撞上 memory.max。 |
| memory.max | 内存上限 | p.16 | cgset -r memory.max=2G,超了就被内核 OOM 掉。 |
| N | |||
| namespace | 命名空间 | p.25 | 回答「看得见什么」:pid / net / mnt / uts / ipc / user。 |
| namespace de red | 网络命名空间 | p.52 | 第二单元的主角,决定容器网络隔离到什么程度。 |
| nerdctl | containerd 的 CLI | p.58 | 命令习惯贴近 docker,配合 containerd 使用。 |
| nsenter | 进入命名空间 | p.43 | nsenter -t <pid> -m -u -i -p 逐个进入目标进程的 ns。 |
| O | |||
| OCI | 开放容器倡议 | p.54 | Runtime / Image / Distribution 三条规范。 |
| OOMKilled | 被 OOM 杀掉 | p.106 | 内存超限后容器的终止状态,配套退出码 137。 |
| OverlayFS | 叠加文件系统 | p.37 | UnionFS 在 Linux 上的实现,负责分层叠加。 |
| P | |||
| /proc/<pid>/ns/ | 命名空间入口目录 | p.104 | ls -l 看 inode 号,号不同=不是同一个 namespace。 |
| pids.max | 进程数上限 | p.20 | 写 10 就最多 10 个进程,第 11 个直接失败。 |
| Podman | 无守护进程容器工具 | p.73 | rootless、不需要 dockerd,同样兼容 OCI。 |
| --privileged | 特权模式 | p.107 | 等于把宿主机 root 交给容器,最危险的开关。 |
| R | |||
| registro | 注册表 | p.79 | 存镜像的仓库,常见六个:Hub / GHCR / GitLab / ECR / ACR / GAR。 |
| repositorio | 仓库 | p.80 | 同一镜像不同标签的集合,是引用里的一段。 |
| root | 容器内默认用户 | p.99 | 不写 USER 就是 root,只是能力被裁剪过。 |
| RUN | 构建时执行 | p.66 | 构建时跑一次,结果写进镜像层。 |
| runc | 底层运行时 | p.57 | 基于 libcontainer,真正调 kernel 起进程的那一层。 |
| runtime | 运行时 | p.56 | runc / containerd / CRI-O / Podman / Kata 都算这一类。 |
| S | |||
| setns | 加入命名空间 | p.29 | 通过符号链接把进程放进已有的 namespace。 |
| señal | 信号 | p.106 | 137 = 128 + 9,即进程收到 SIGKILL。 |
| skopeo | 镜像搬运工具 | p.84 | inspect / copy / list-tags,不落地就能查和搬。 |
| socket | 套接字 | p.61 | 能读写 socket 就等价于 root,所以 docker 组是高危组。 |
| systemd-nspawn | systemd 容器工具 | p.42 | -D 指定目录启动容器,隔离比 chroot 全得多。 |
| T | |||
| tar | 归档文件 | p.84 | skopeo 可以在 tar 与 OCI 目录之间复制镜像。 |
| Trivy | 漏洞扫描器 | p.107 | 第十七讲专讲,会把 --privileged 标成严重问题。 |
| U | |||
| UnionFS | 联合文件系统 | p.36 | 把多层目录叠加成一个视图,是容器镜像的地基。 |
| unshare | 新建命名空间 | p.29 | 把进程挪到与父进程不同的 ns,也常用来替代 chroot。 |
| USER | 运行用户 | p.99 | 默认 root;最佳实践是显式声明非 root 用户。 |
| util-linux | 基础工具包 | p.29 | lsns / unshare / setns / nsenter 都来自它。 |
| V | |||
| virtualización | 虚拟化 | p.50 | 容器不虚拟化硬件,只限制进程的视野与配额。 |
| vista | 视图 | p.102 | namespace 的关键词:改变进程看到的系统视图。 |
| W | |||
| WORKDIR | 工作目录 | p.69 | 后续 RUN / COPY / CMD 的相对路径基准。 |
编号与常量速记卡
口诀:137 是 128+9,九条指令只有四条建层;三规范、五段式、六注册表、六命名空间。
| 编号 | 原文关键词 | 中文 | 性质归类 | 页 |
|---|---|---|---|---|
| 137 | 128 + 9 · SIGKILL | 退出码=128+信号号 | 进程终止 | p.106 |
| 143 | 128 + 15 · SIGTERM | 被正常终止的退出码 | 进程终止 | p.106 |
| 104857600 | 100m → HostConfig.Memory | 100 MiB 换成的字节数 | 单位换算 | p.106 |
| 0B | SIZE 列 | 元数据指令不建层,体积为零 | 层大小 | p.98 |
| 77.8MB | ubuntu:22.04 | 完整 Ubuntu 镜像的实测体积 | 体积对照 | p.95 |
| [1/4]–[4/4] | 构建步骤计数 | 只数真正建层的步骤 | 构建输出 | p.101 |
| 三 | Runtime / Image / Distribution | OCI 三条规范 | 标准 | p.54 |
| 五 | [registro/][espacio/]repositorio[:etiqueta][@resumen] | 镜像引用的五段式 | 命名 | p.80 |
| 六 | Hub / GHCR / GitLab / ECR / ACR / GAR | 六个常见注册表 | 生态 | p.79 |
| 九 | FROM … CMD | Dockerfile 九条指令 | 指令 | p.99 |
| 四 | FROM / RUN / COPY / ADD | 只有这四条会建层 | 指令 | p.99 |
| 六 | pid / net / mnt / uts / ipc / user | 本讲要记的六类 namespace | 隔离 | p.102 |
易混对照卡
每一对都只差一个词,考试就爱在这里挖坑。先问自己「差在哪个词上」,再往下看。
管「能用多少」:CPU、内存、进程数。差在 量。
管「看得见什么」:pid、net、mnt、uts、ipc、user。差在 视野。
以进程为单位加入或列出。
以线程为单位加入或列出。
写 1 暂停,进程还在,写 0 恢复。
写 1 杀掉整组进程,不可恢复。
只复制本地文件,行为可预测、可缓存。
多出解压 tar 与下载 URL 两个动作,所以不可预测。
构建时执行一次,结果留在镜像层里。
启动时执行,只是默认命令,可被覆盖。
只是声明「我监听这个端口」,不对外发布。
真正发布端口,把宿主机端口映射到容器。
可重新指派,今天指向 A,明天可能指向 B。
不可变,SHA256 锁定内容,生产环境用它。
只读模板,本体不会变。
运行中的实例,顶上多一层可写层。
只改文件根目录,进程与网络照旧可见。
新建整套命名空间,可同时换 pid、mnt、net。
Linux 上的守护进程组合:docker-ce + dockerd + containerd。
Windows / macOS 上的整套桌面环境,内含一台虚拟机。
最底层:真正调 kernel 建 namespace、起进程。
管理层:管镜像、管生命周期,再调 runc。
虚拟化硬件,跑完整 OS,重但隔离强。
限制进程,共享宿主机内核,轻但隔离靠内核。