- 一页一块:页号胶囊是 PDF 物理页序(1–53);幻灯片上印的页码可能另有编号,以胶囊为准。
- 逐句对照:蓝色左框内是西语原句(逐字照抄,含原文笔误),下面带「中」字标的是中文翻译;项目符号统一用 • 表示。
- 提示框:绿色「考点」= 这页怎么考;红色「陷阱」= 易错点与原文勘误;紫色「记忆钩子」= 口诀;橙色「补充」= 前后页串联。
- 术语悬停:西语句里带浅蓝底的词,鼠标停上去出中文;中文句里带虚下划线的词,停上去出西语原词。
- 公式:一律用本地 MathJax 渲染(断网也能显示),每个公式下附「符号 / 西语读法 / 中文含义」三列小表——口语考试念的就是这一列。
一、概念:进程 · 线程 · 任务
p.1–p.9Portada · 封面
▸ 原页截图 p.1
Sistemas Concurrentes y de Tiempo Real
并发与实时系统(课程名称)。
Grado en Ingeniería Telemática
远程通信工程本科专业。
Tema 2: Representación de procesos y soporte de la concurrencia
主题 2:
Índice de contenidos · 目录
▸ 原页截图 p.2
Índice de contenidos
内容目录。
• Conceptos
• 基本概念。
• Modelos de creación
• 创建模型。
• Jerarquía de procesos
•
• Inicialización
• 初始化。
• Terminación
• 终止。
• Creación y representación
• 创建与表示。
• El modelo de proceso/hebras en Unix/Linux
• Unix/Linux 中的
• POSIX
• POSIX 标准。
• Ciclo de vida de una hebra
• 一条
Conceptos · 基本概念
▸ 原页截图 p.3
P || Q || R significa que la ejecución de P, Q y R puede solaparse en el tiempo.
P || Q || R 表示 P、Q、R 三者的执行在时间上可以相互交叠。
¿Cómo se representa esto en un sistema real?
在真实系统中,这一点该如何表示?
Podemos hablar de procesos, hebras, tareas, … pero no son lo mismo
我们可以谈
En la asignatura nos vamos a centrar en concurrencia con hebras
本课程将聚焦于用
Conceptos · 进程的定义
▸ 原页截图 p.4
Proceso: instancia en ejecución de un programa. Contiene su propio espacio de direcciones, recursos asignados (ficheros, memoria) y al menos un flujo de control
Tiene un contexto de ejecución completo
它具有完整的
Registros, pila, heap, datos del programa
Unidad básica de ejecución y aislamiento para el sistema operativo
它是操作系统进行执行与
Ejemplos procesos · 进程示例(C 与 Python)
▸ 原页截图 p.5
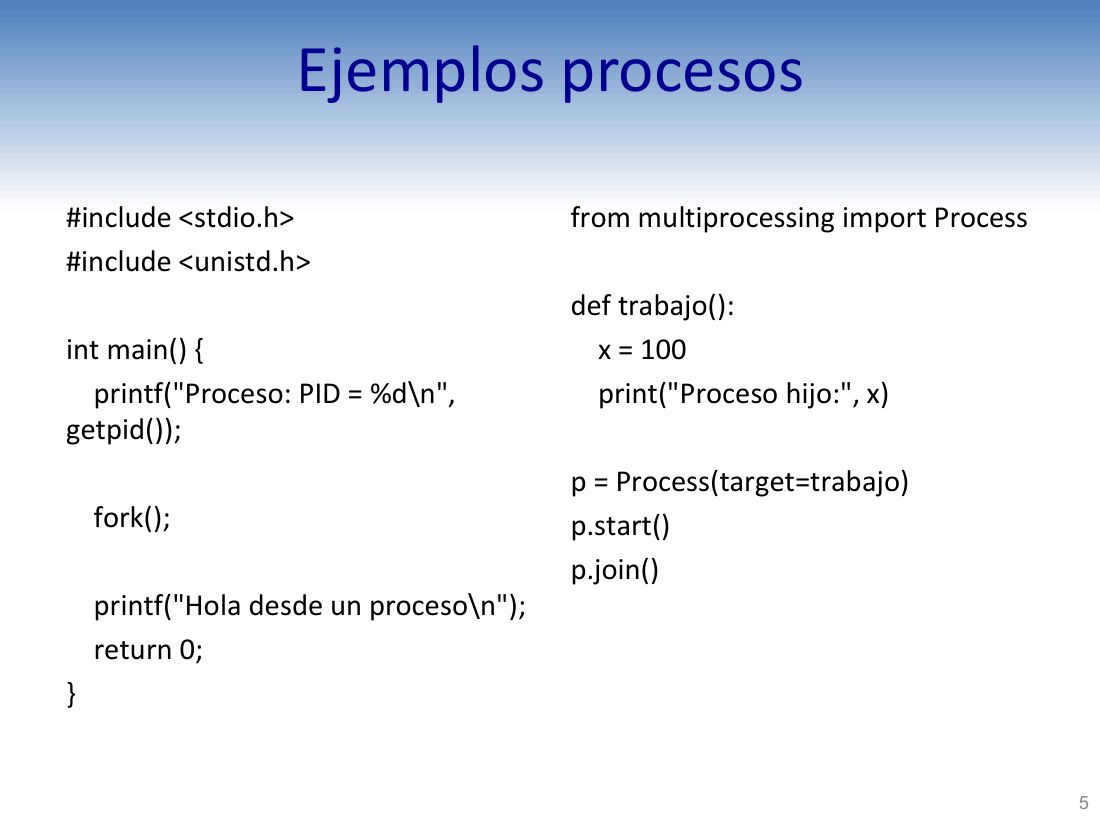
Ejemplos procesos
printf("Proceso: PID = %d\n", getpid());
打印 «Proceso: PID = %d»,其中 getpid() 返回当前进程的
fork();
fork():复制出一个
printf("Hola desde un proceso\n");
打印 «Hola desde un proceso»(来自一个进程的问候)——注意 fork 之后这一行会被父、子两个进程各执行一次。
from multiprocessing import Process
Python 侧导入 multiprocessing.Process,用
p = Process(target=trabajo)
创建一个
p.start()
start() 真正启动子进程(此时才发生创建)。
p.join()
join() 让父进程等待子进程结束——对应 p.12 所说的「父进程可以等待子进程终止」。
Conceptos · 线程(hebra)的定义
▸ 原页截图 p.6
Hebra (hilo, thread): unidad de ejecución más ligera que un proceso. Se ejecuta asociada a un proceso
Las hebras de un proceso comparten su espacio de direcciones y recursos (heap, ficheros, etc.)
同一进程内的各条
Tienen su propio contador de programa, pila y registros
但它们各自拥有
Permiten concurrencia dentro de un mismo proceso (multithreading)
它们使同一个进程内部也能有
Ejemplos hebras · 线程示例(C pthread 与 Python Thread)
▸ 原页截图 p.7
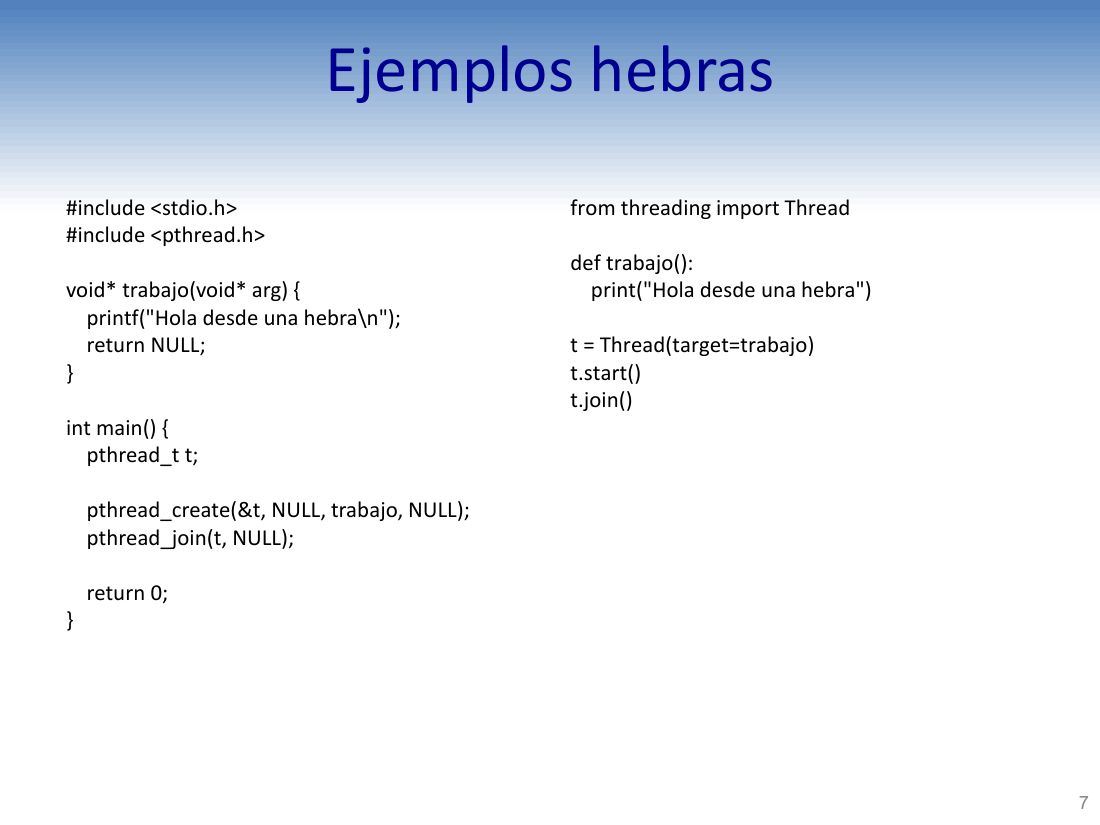
Ejemplos hebras
#include <pthread.h>
引入 POSIX 线程库头文件 pthread.h——p.45 起会正式讲 POSIX。
void* trabajo(void* arg) { printf("Hola desde una hebra\n"); return NULL; }
线程入口函数 trabajo:签名必须是 void* f(void*),内部只打印一句 «Hola desde una hebra»,然后返回 NULL。
pthread_t t;
声明一个
pthread_create(&t, NULL, trabajo, NULL);
pthread_create 创建一个
pthread_join(t, NULL);
pthread_join 等待该线程结束(对应 Python 的 join())。
from threading import Thread
Python 侧改用 threading.Thread(
t.start() / t.join()
start() 启动线程,join() 等待其结束——与进程版写法结构完全一样。
Conceptos · 任务(tarea)
▸ 原页截图 p.8
Tarea: término genérico y dependiente del contexto. Puede referirse, entre otros a:
Trabajo que debe realizarse
需要完成的工作本身。
En algunos lenguajes (p.ej. Ada) se usan como sinónimo de hebra o proceso ligero
在某些语言里(例如 Ada),它被当作
Puede ser también una abstracción de operación asíncrona
它也可以是
En general, los algoritmos y soluciones que se verán a lo largo de la asignatura pueden aplicarse (con sus particularidades) tanto a procesos como a hebras
总体而言,本课程要讲的算法与解法(在各自的具体细节之下)对
Ejemplos tareas · 任务示例(Ada 与 Python asyncio)
▸ 原页截图 p.9
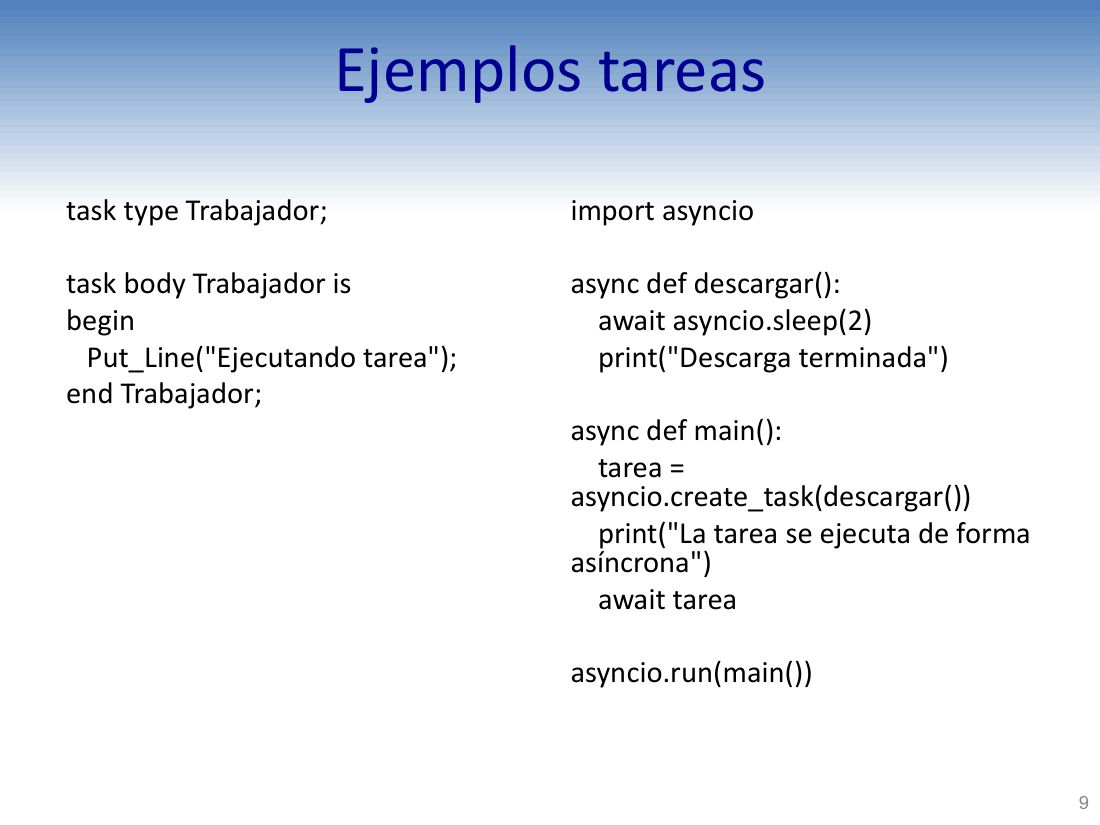
Ejemplos tareas
task type Trabajador;
Ada 里声明一个
task body Trabajador is begin Put_Line("Ejecutando tarea"); end Trabajador;
任务体:执行时只输出 «Ejecutando tarea»(正在执行任务),随后结束。
import asyncio
Python 侧引入 asyncio——把「任务」实现为
async def descargar(): await asyncio.sleep(2)
用 async def 定义协程 descargar,其中 await 挂起 2 秒,模拟一次下载。
tarea = asyncio.create_task(descargar())
create_task 把一个协程包装成可调度的
print("La tarea se ejecuta de forma asíncrona")
打印 «La tarea se ejecuta de forma asíncrona»(任务以异步方式执行)。
await tarea
await tarea:等待该任务完成,等价于线程里的 join。
二、创建模型 · 进程层级 · 初始化与终止
p.10–p.17Modelos de creación · 创建模型
▸ 原页截图 p.10
Pueden utilizarse diferentes estrategias en relación a cuándo se pueden crear los procesos/hebras:
就「何时可以创建
Creación inicial: los procesos/hebras se crean al inicio de nuestro programa
Creación dinámica: los procesos/hebras pueden crearse en cualquier momento para atender nuevas peticiones o cargas de trabajo
El número máximo de procesos/hebras está limitado por los recursos de la máquina (memoria, núcleos, SO)
进程/线程的最大数量受机器资源限制(内存、
Qué estrategia a utilizar depende del tipo de aplicación
采用哪种策略取决于应用的类型。
Por ejemplo, en sistemas de tiempo real, se suelen crear todas las tareas al comienzo para poder analizar su comportamiento temporal más adecuadamente
例如在
Creación inicial vs dinámica · 两种创建方式对照
▸ 原页截图 p.11
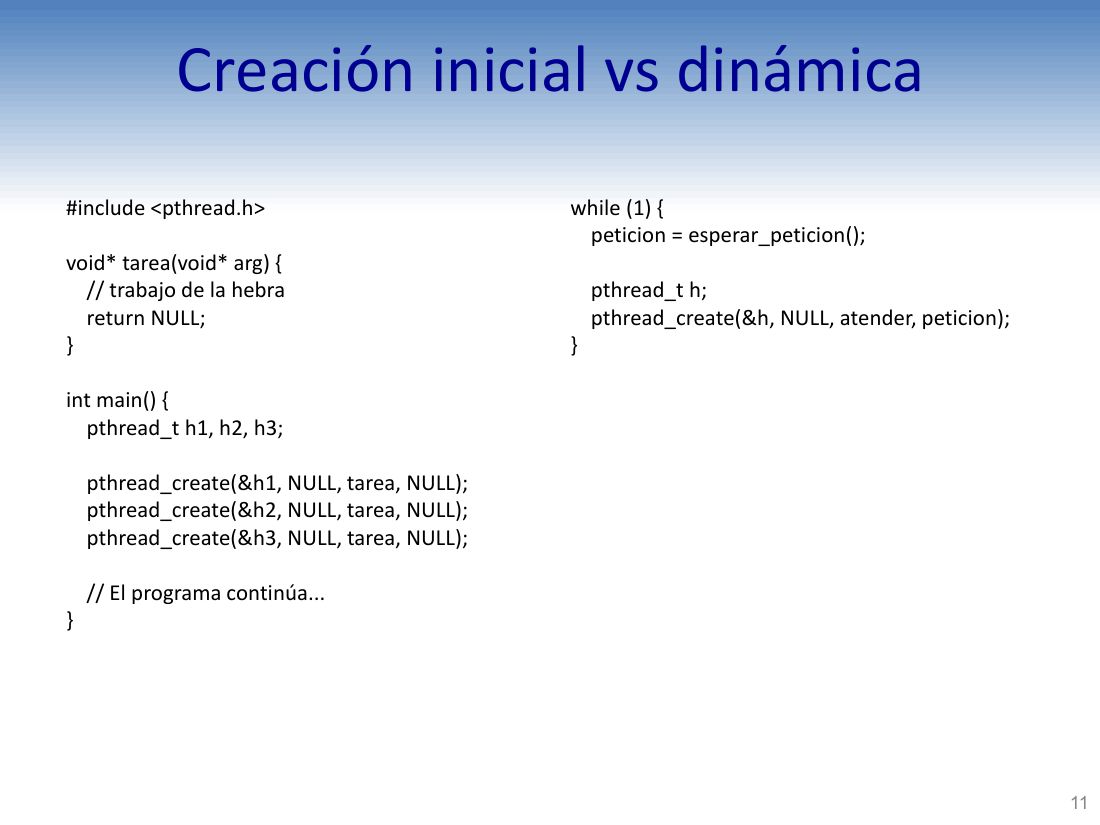
Creación inicial vs dinámica
void* tarea(void* arg) { // trabajo de la hebra return NULL; }
两种模式共用的线程入口函数 tarea(左栏):函数体是注释 «trabajo de la hebra»(线程要做的工作)。
pthread_t h1, h2, h3;
左栏(初始创建):一次性声明 h1, h2, h3 三个线程句柄。
pthread_create(&h1, NULL, tarea, NULL); pthread_create(&h2, NULL, tarea, NULL); pthread_create(&h3, NULL, tarea, NULL);
在 main 里连续创建三条
// El programa continúa...
注释 «El programa continúa...»:程序继续往下走(不再创建新线程)。
while (1) { peticion = esperar_peticion(); pthread_t h; pthread_create(&h, NULL, atender, peticion); }
右栏(动态创建):死循环里每来一个请求就 pthread_create 一条
Jerarquía de procesos · 进程层级
▸ 原页截图 p.12
Jerarquía de procesos
Posibilidad de anidar unos procesos dentro de otros.
即可以把一些进程嵌套在另一些进程之中。
Existe una relación padre/hijo entre el proceso desde el que se crea a otro proceso, y el nuevo proceso creado (llamada fork)
创建者进程与被创建的新进程之间存在
El proceso hijo hereda algunos atributos del padre (p.ej. descriptores de fichero, entorno)
Habitualmente no existen este tipo de jerarquía entre hebras
通常各
Aunque una hebra puede crear a otras, pero es una relación de “origen”
尽管一条线程可以创建别的线程,但那只是「来源」意义上的关系(而非父子层级)。
Esta jerarquía es mantenida por el sistema operativo
该层级由操作系统维护。
P.ej. en Linux el proceso padre conoce el PID de sus hijos y viceversa
例如在 Linux 中,父进程知道其子进程的
La finalización de los hijos puede ser esperada por el padre
子进程的
Cuando iniciamos un programa, el proceso asociado es el padre de todos los procesos creados por él
当我们启动一个程序时,与之对应的进程就是它创建的所有进程之父。
Sí que existe una relación entre un proceso y sus hebras
但
Las hebras no pueden existir sin el proceso
没有该进程,这些线程就不能存在。
Ejemplo jerarquía · 进程层级示例
▸ 原页截图 p.13
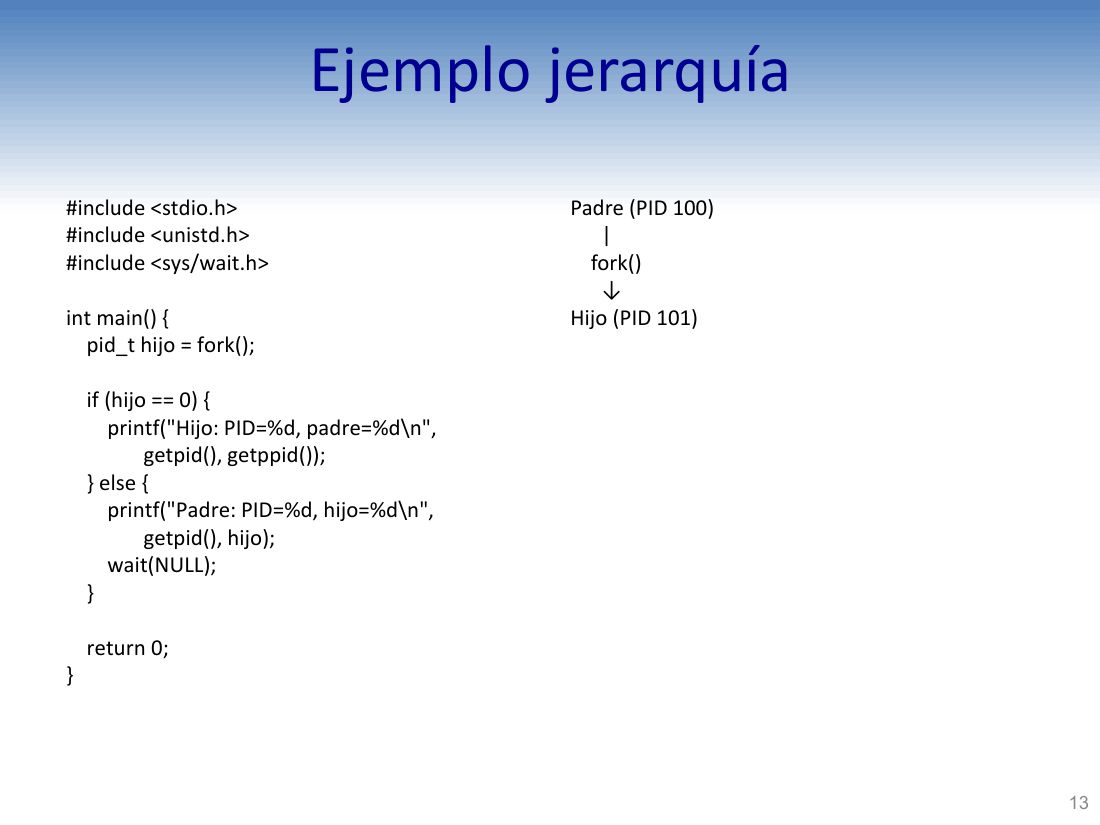
Ejemplo jerarquía
#include <sys/wait.h>
引入 sys/wait.h,才能使用 wait 系列函数等待
pid_t hijo = fork();
fork() 的返回值存在 hijo 里:父进程中它是子进程的
if (hijo == 0) { printf("Hijo: PID=%d, padre=%d\n", getpid(), getppid()); }
分支 hijo == 0 是子进程:打印自己的 getpid() 与父进程 getppid()。
printf("Padre: PID=%d, hijo=%d\n", getpid(), hijo);
父进程分支:打印自己的 PID 以及刚创建的子进程 PID。
wait(NULL);
父进程 wait(NULL) 阻塞,直到某个子进程
Padre (PID 100) | fork() ↓ Hijo (PID 101)
页下图示:父进程(PID 100)经 fork() 派生出子进程(PID 101),即一棵两层的进程树。
Inicialización · 初始化
▸ 原页截图 p.14
Para darle valores iniciales a un proceso/hebra se suelen utilizar dos métodos:
给
Paso de parámetros: como en los procedimientos o métodos
Paso de mensajes: el proceso padre o hebra, cuando crea un proceso/hebra le envía un mensaje para inicializar sus variables
En ambos casos hay que tener cuidado con la reutilización de los parámetros
两种方式都要小心参数的复用问题。
Como distintos valores iniciales pueden dar lugar a distintos comportamientos, es natural introducir el concepto de tipo de proceso/hebra.
由于不同的初值会导致不同的行为,自然会引入「
Podemos definir un patrón de comportamiento común y luego instanciarlo varias veces para obtener distintos procesos/hebras que, aunque comparten el código, pueden comportarse de forma distinta dependiendo de sus valores iniciales.
我们可以定义一个共同的行为
Ejemplos inicialización · 初始化示例(参数传递 / 管道消息)
▸ 原页截图 p.15
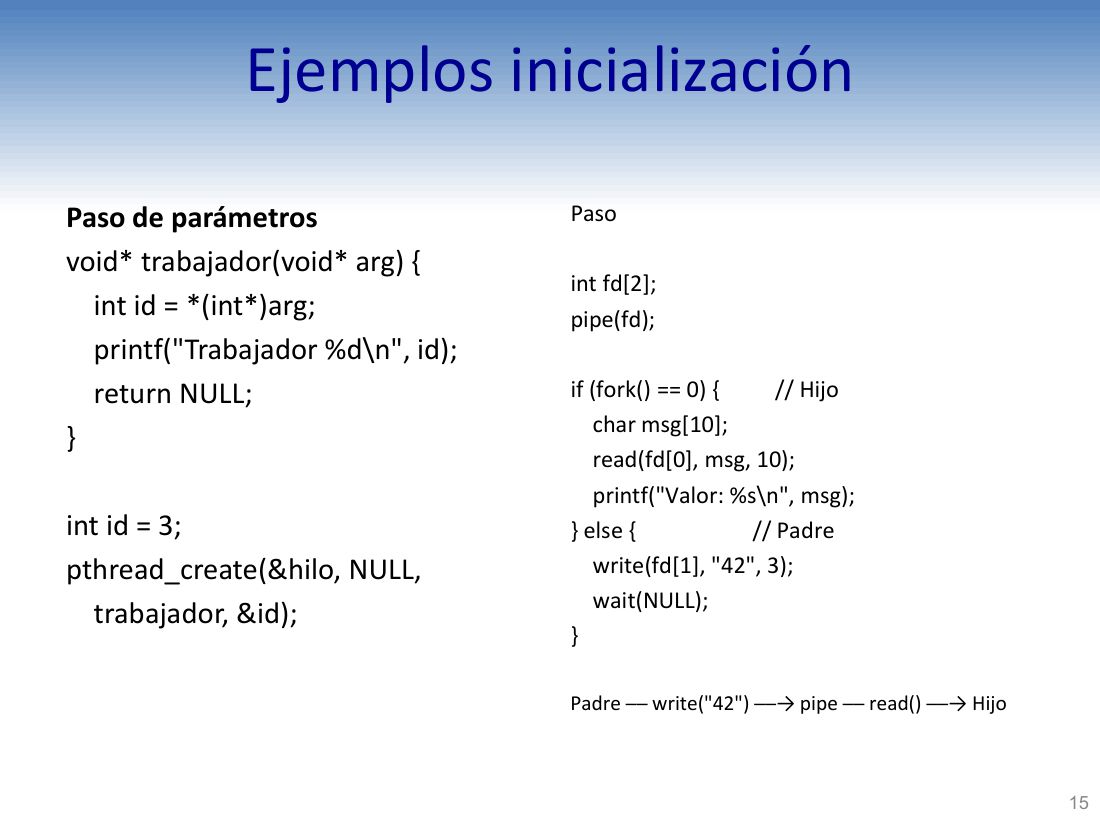
Ejemplos inicialización
Paso de parámetros
int id = *(int*)arg;
线程入口里把 void* 强转成 int* 再解引用,取出传进来的编号。
pthread_create(&hilo, NULL, trabajador, &id);
创建线程时把 &id 作为参数传给 trabajador——初值通过
int fd[2]; pipe(fd);
右栏(消息传递):pipe(fd) 创建一条单向
if (fork() == 0) { // Hijo char msg[10]; read(fd[0], msg, 10); printf("Valor: %s\n", msg); }
子进程从 fd[0] 读最多 10 字节到 msg,再打印收到的值——这就是用消息给新进程赋初值。
else { // Padre write(fd[1], "42", 3); wait(NULL); }
父进程往 fd[1] 写入字符串 «42»,然后 wait(NULL) 等子进程结束。
Padre ── write("42") ──→ pipe ── read() ──→ Hijo
页下流程图:父进程 write("42") → 管道 → 子进程 read(),即
Terminación · 终止
▸ 原页截图 p.16
Un proceso/hebra puede acabar su ejecución por distintas causas:
一个
cuando se acaba su código (terminación con éxito)
代码执行完毕(
cuando tiene un error durante su ejecución (terminación con fallo)
执行过程中出错(
por la ejecución de una instrucción de autodestrucción
执行了一条自我销毁指令(如 exit / pthread_exit);
cuando otro proceso/hebra aborta su ejecución
被另一个进程/线程中止(如 pthread_cancel、kill)。
En muchas ocasiones querremos obtener algún resultado proporcionado por el proceso/hebra que ha terminado
很多时候我们想拿到已结束进程/线程给出的某个结果。
Habrá que esperar a la finalización
那就必须等待它
Un proceso/hebra puede no terminar
进程/线程也可能「不结束」:
siendo éste su comportamiento esperado
这本身就是它期望的行为(如服务器主循环);
como consecuencia de un error en su diseño
或者是设计错误导致的结果(死锁、死循环)。
Ejemplo terminación · 终止示例(退出码与等待)
▸ 原页截图 p.17
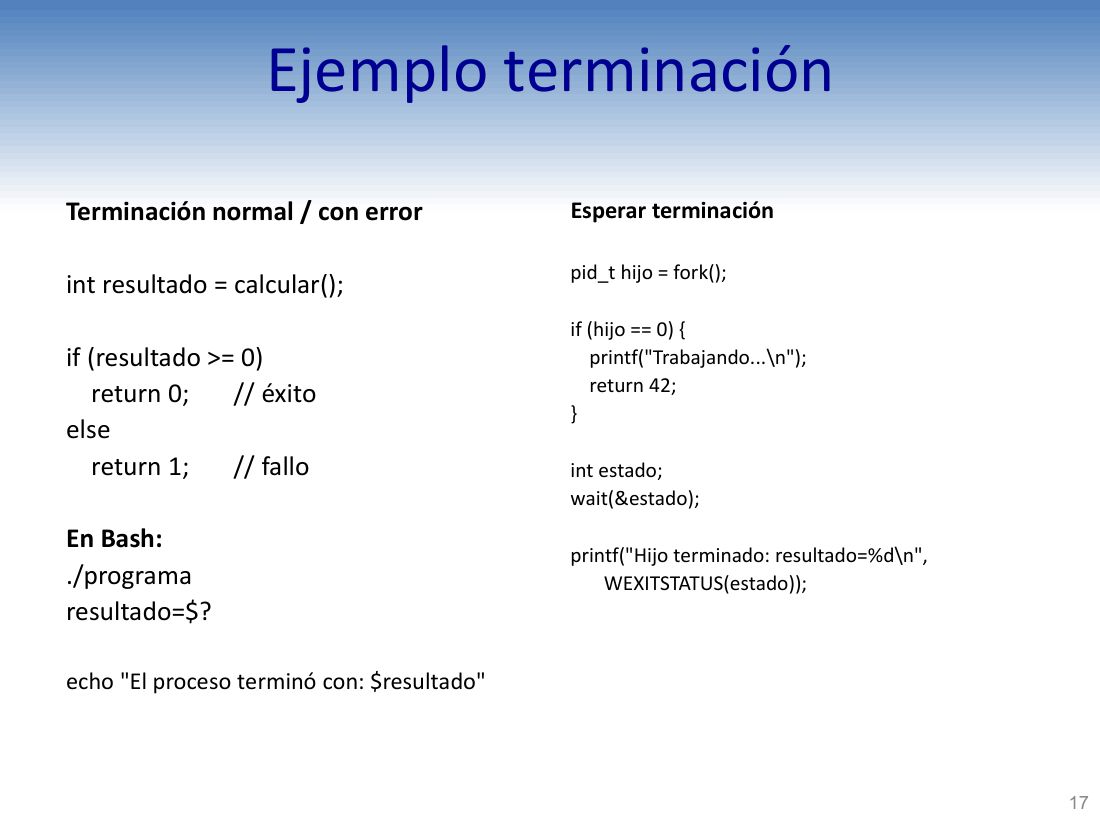
Ejemplo terminación
Terminación normal / con error
正常终止 / 出错终止(左栏标题)。
int resultado = calcular(); if (resultado >= 0) return 0; // éxito else return 1; // fallo
算得 resultado:非负就 return 0(成功),否则 return 1(失败)——返回值即
./programa
在 Bash 里运行程序。
resultado=$?
用 $? 取出上一条命令的退出码。
echo "El proceso terminó con: $resultado"
打印 «El proceso terminó con: …»(进程以此状态结束)。
Esperar terminación
等待终止(右栏标题)。
if (hijo == 0) { printf("Trabajando...\n"); return 42; }
子进程打印 «Trabajando...» 后以状态码 42 结束。
int estado; wait(&estado);
父进程用 wait(&estado) 等待,并把子进程的
printf("Hijo terminado: resultado=%d\n", WEXITSTATUS(estado));
用 WEXITSTATUS 从状态字里抽出真正的退出码,打印 «Hijo terminado: resultado=42»。
Creación y representación · 创建与表示
▸ 原页截图 p.18
La creación de un proceso/hebra suele ser explícita mediante la utilización de alguna función o método
Que hayamos creado el proceso/hebra no quiere decir que comience a ejecutarse de inmediato
但「已创建」并不意味着它立刻开始执行。
Esto depende del “planificador” del Sistema Operativo (o máquina virtual de nuestro lenguaje)
这取决于操作系统的
La representación de los procesos/hebras puede ser
进程/线程的表示方式可以是:
Explícita: el lenguaje proporciona un constructor específico para definir a los procesos
Implícita: se usan otras construcciones del lenguaje como funciones o métodos para delimitar el código de la hebra o proceso.
Más habitual hoy día
如今更常见的是后者(隐式表示)。
Ejemplo creación · Java 显式与隐式表示
▸ 原页截图 p.19
Ejemplo creación
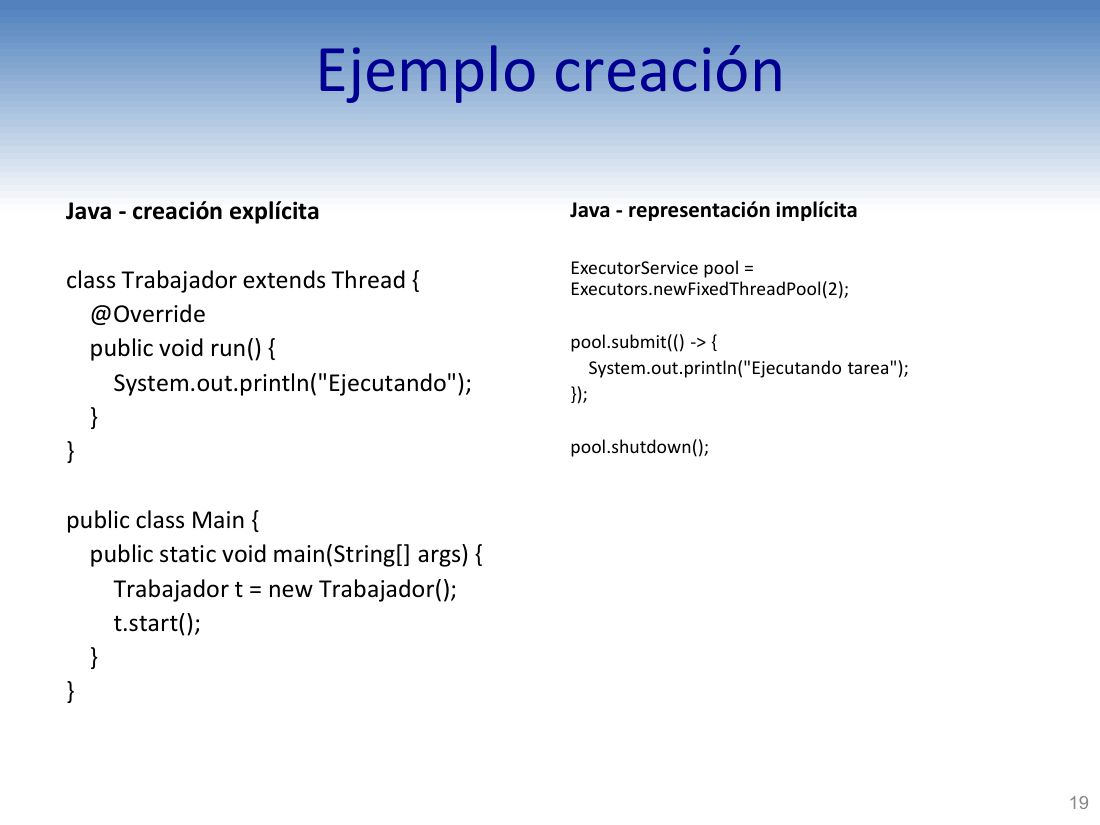
Java - creación explícita
Java ——
class Trabajador extends Thread { @Override public void run() { System.out.println("Ejecutando"); } }
定义类 Trabajador 继承 Thread,重写 run() 作为线程体,输出 «Ejecutando»(执行中)。语言层面有专门的 constructor(extends Thread),故属
Trabajador t = new Trabajador(); t.start();
实例化并通过 t.start() 启动线程;注意 start 只是「交给调度器」,不等它跑(见 p.18)。
Java - representación implícita
Java ——
ExecutorService pool = Executors.newFixedThreadPool(2);
建一个固定 2 条线程的
pool.submit(() -> { System.out.println("Ejecutando tarea"); });
提交一个 lambda 作为任务,打印 «Ejecutando tarea»(正在执行任务)——没有专门的「进程/线程类」,代码块本身就是线程体。
pool.shutdown();
shutdown() 停止接收新任务,等在跑的任务结束后关闭池。
El modelo de proceso/hebras en Unix/Linux · PCB
▸ 原页截图 p.20
El modelo de proceso/hebras en Unix/Linux
Unix/Linux 中的
En sistemas Unix/Linux, un proceso es una instancia en ejecución de un programa.
在 Unix/Linux 系统中,
Información asociada al proceso en el PCB (Process Control Block) gestionado por el SO
与进程相关的信息存放在
Process ID, PPID, UID / GID, process group ID
Contador de programa, registros de CPU y estado del planificador
Instrucciones del programa
程序的指令(代码段)。
Datos estáticos
静态数据。
Pila (stack)
Heap
Variables de entorno y directorio de trabajo
Descriptores de fichero abiertos
已打开的
Acciones de señales
Librerías compartidas cargadas
已加载的
Comunicación entre procesos (colas de mensajes, semáforos, memoria compartida)
El modelo de proceso/hebras en Unix/Linux · top 实测
▸ 原页截图 p.21
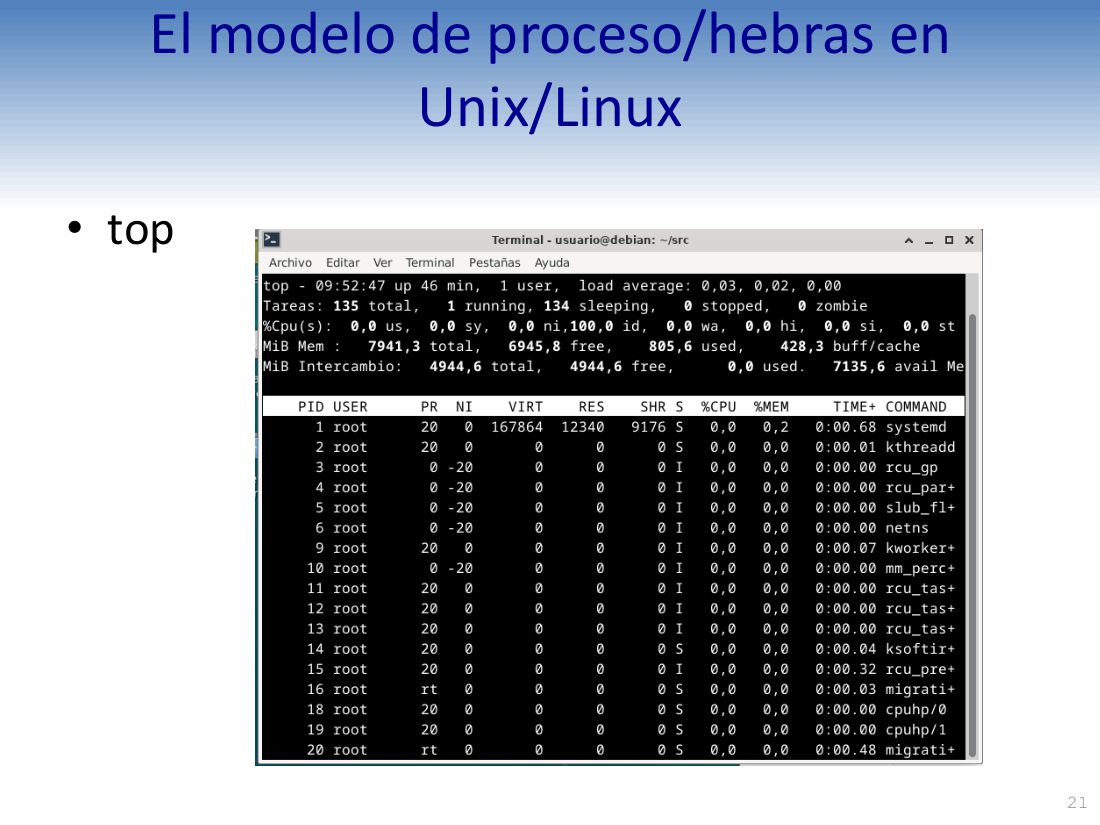
El modelo de proceso/hebras en Unix/Linux
Unix/Linux 中的
• top
• top:Unix/Linux 下实时查看进程的命令行工具。
top - 09:52:47 up 46 min, 1 user, load average: 0,03, 0,02, 0,00
截图首行:当前时间 09:52:47、已开机 46 分钟、1 个用户、
Tareas: 135 total, 1 running, 134 sleeping, 0 stopped, 0 zombie
任务统计:共 135 个,1 个
MiB Mem: 7941,3 total, 6945,8 free, 805,6 used, 428,3 buff/cache
内存(MiB):总量 7941.3、空闲 6945.8、已用 805.6、缓冲/缓存 428.3。
PID USER PR NI VIRT RES SHR S %CPU %MEM TIME+ COMMAND
列头:PID、用户、优先级 PR、nice 值 NI、虚拟内存 VIRT、常驻内存 RES、共享内存 SHR、状态 S、CPU%、内存%、累计 CPU 时间 TIME+、命令名 COMMAND。
1 root 20 0 167864 12340 9176 S 0,0 0,2 0:00.68 systemd
示例行:PID 1 的 systemd(PID 1 是所有用户进程的祖先,对应 p.12 的「父进程」概念),状态 S = sleeping。
Ejemplo procesos Linux · ps 与 /proc
▸ 原页截图 p.22
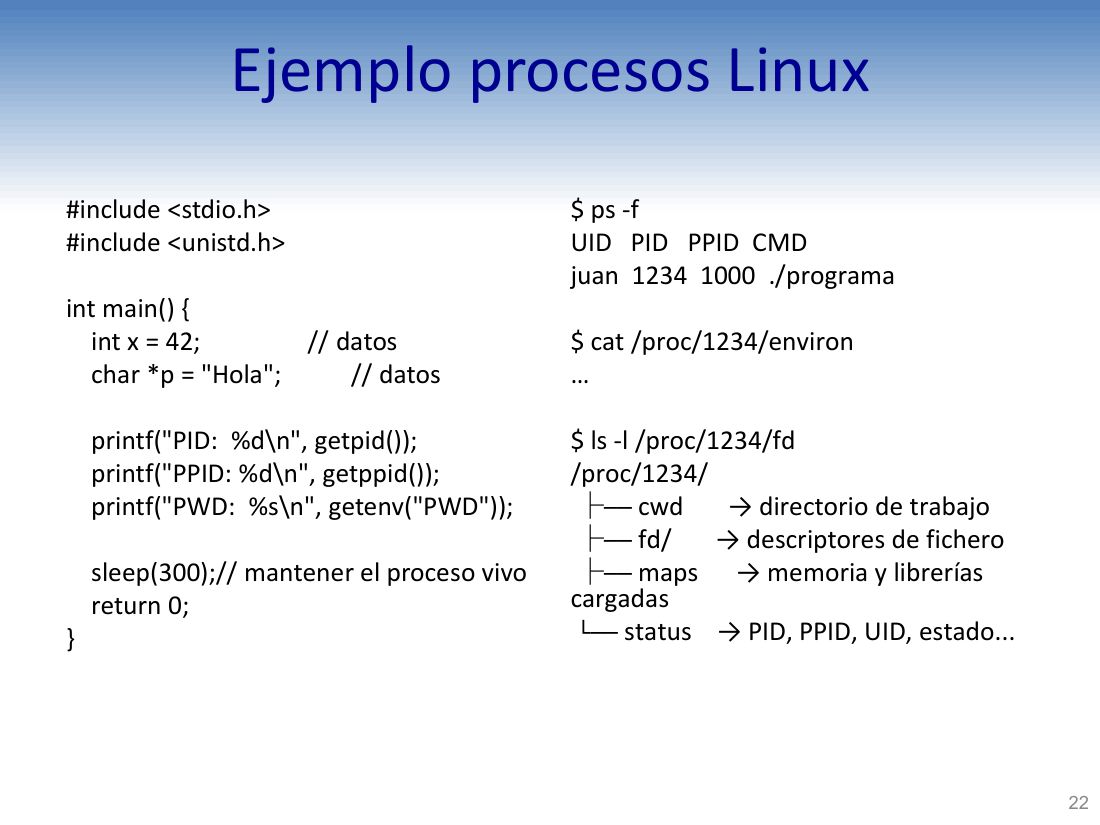
Ejemplo procesos Linux
Linux
int x = 42; // datos
局部变量 x,注释 «datos»(数据,位于栈上)。
char *p = "Hola"; // datos
指向字符串字面量 «Hola» 的指针,注释 «datos»(属静态数据)。
printf("PID: %d\n", getpid()); printf("PPID: %d\n", getppid());
打印自己的 PID 与父进程 PPID——证明 PCB 里确实存着这两个标识。
printf("PWD: %s\n", getenv("PWD"));
用 getenv("PWD") 取出
sleep(300);// mantener el proceso vivo
睡眠 300 秒,注释 «mantener el proceso vivo»(让进程活着,便于另开终端观察)。
$ ps -f
用 ps -f 查看完整格式的进程列表。
UID PID PPID CMD / juan 1234 1000 ./programa
输出:用户 juan、PID 1234、PPID 1000,命令 ./programa——一眼看出父子关系。
$ cat /proc/1234/environ
读取 /proc/1234/environ:进程的环境变量数组(PCB 内容的文件化视图)。
$ ls -l /proc/1234/fd
列出该进程的 fd 目录:所有打开的
/proc/1234/ ├── cwd → directorio de trabajo ├── fd/ → descriptores de fichero ├── maps → memoria y librerías cargadas └── status → PID, PPID, UID, estado...
目录结构:cwd → 工作目录;fd/ → 文件描述符;maps → 内存映射与已加载库;status → PID、PPID、UID、状态等。
El modelo de proceso/hebras en Unix/Linux · 线程与进程的关系
▸ 原页截图 p.23
El modelo de proceso/hebras en Unix/Linux
Unix/Linux 中的
Las hebras se utilizan y definen dentro de los procesos
Pueden ser planificadas por el SO
它们可以由操作系统
Se ejecutan como entidades independientes duplicando los recursos mínimos
它们作为独立实体执行,只复制最少的资源(即「轻量」的由来)。
El modelo de proceso/hebras en Unix/Linux · 每条线程私有什么
▸ 原页截图 p.24
Cada hebra mantiene sus propios
每条
Identificador de hebra
Registros (incluido contador del programa)
Puntero a la pila
指向
Propiedades y estado de planificación (prioridad y política)
调度属性与状态(
Señales pendientes y bloqueadas
挂起与被屏蔽的
Datos de la hebra (argumentos o variables locales)
线程自身的数据(参数或局部变量)。
El modelo de proceso/hebras en Unix/Linux · top -H 观察线程
▸ 原页截图 p.25
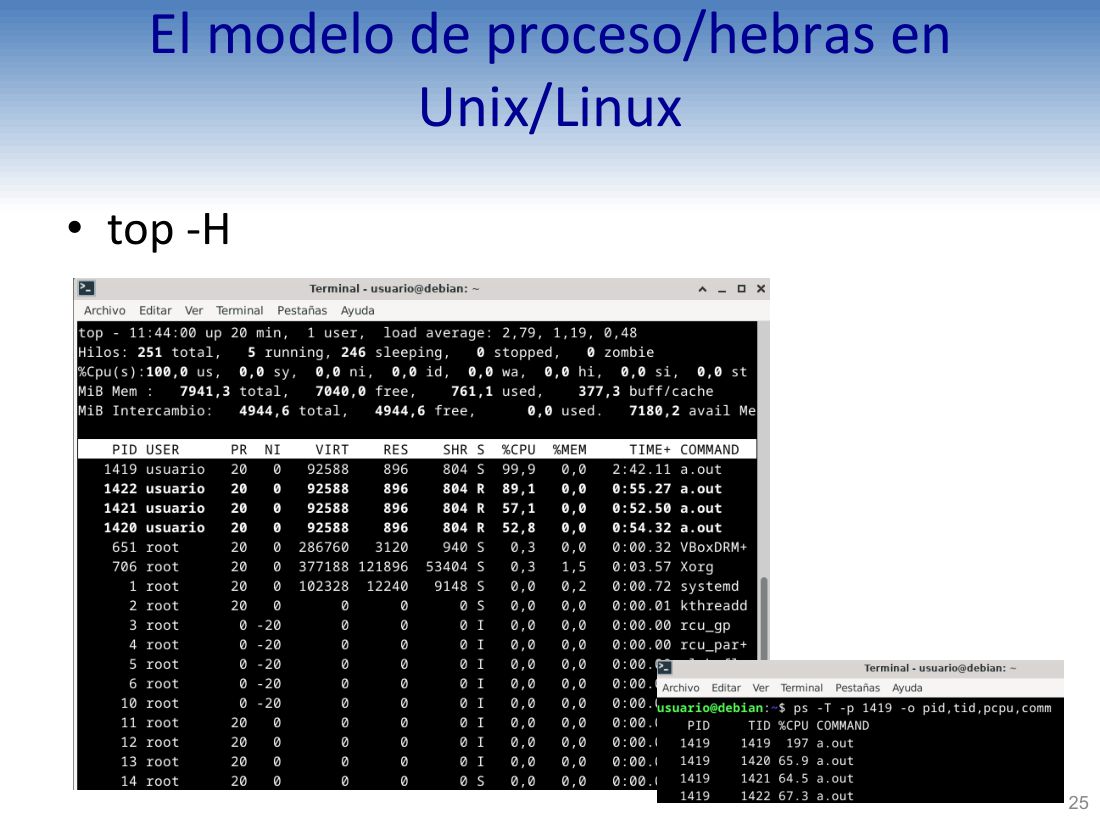
El modelo de proceso/hebras en Unix/Linux
Unix/Linux 中的
• top -H
• top -H:-H 表示按
Hilos: 251 total, 5 running, 246 sleeping, 0 stopped, 0 zombie
截图第二行变成 «Hilos»(线程):共 251 条、5 条
1419 usuario 20 0 92588 896 804 S 99,9 0,0 2:42.11 a.out
截图中的 a.out 进程 PID 1419 下,出现多条同 PID 的行,各自 %CPU 与 TIME+ 不同——同一条
ps -T -p 1419 -o pid,tid,pcpu,comm
右下角用 ps -T 指定 tid 列:输出 PID 1419 + TID 1419/1420/1421/1422,恰好 1 个主线程 + 3 条新线程。
PID TID %CPU COMMAND
列头:进程号 PID、
El modelo de proceso/hebras en Unix/Linux · 单线程 vs 多线程地址空间
▸ 原页截图 p.26
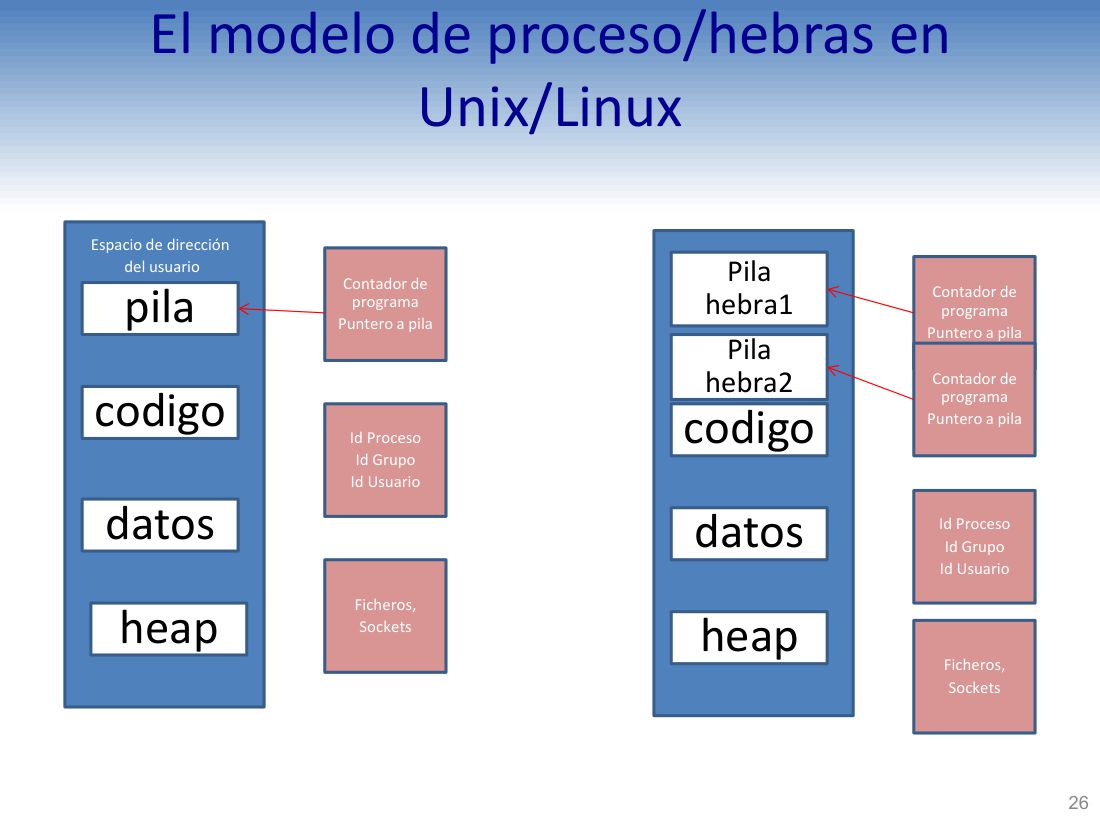
Espacio de dirección del usuario
pila · codigo · datos · heap
左图(单线程):
Pila hebra1 · Pila hebra2
右图(多线程):地址空间上方多出 Pila hebra1、Pila hebra2——每条
codigo · datos · heap
右图中 codigo、datos、heap 仍然只有一份,被所有线程共享。
Contador de programa · Puntero a pila
右侧小方块(线程私有):
Id Proceso · Id Grupo · Id Usuario
进程级标识:Id Proceso、Id Grupo、Id Usuario——所有线程共用同一套。
Ficheros, Sockets
打开的文件与套接字位于进程级,被所有线程共享。
El modelo de proceso/hebras en Unix/Linux · 共享内存与线程私有区
▸ 原页截图 p.27
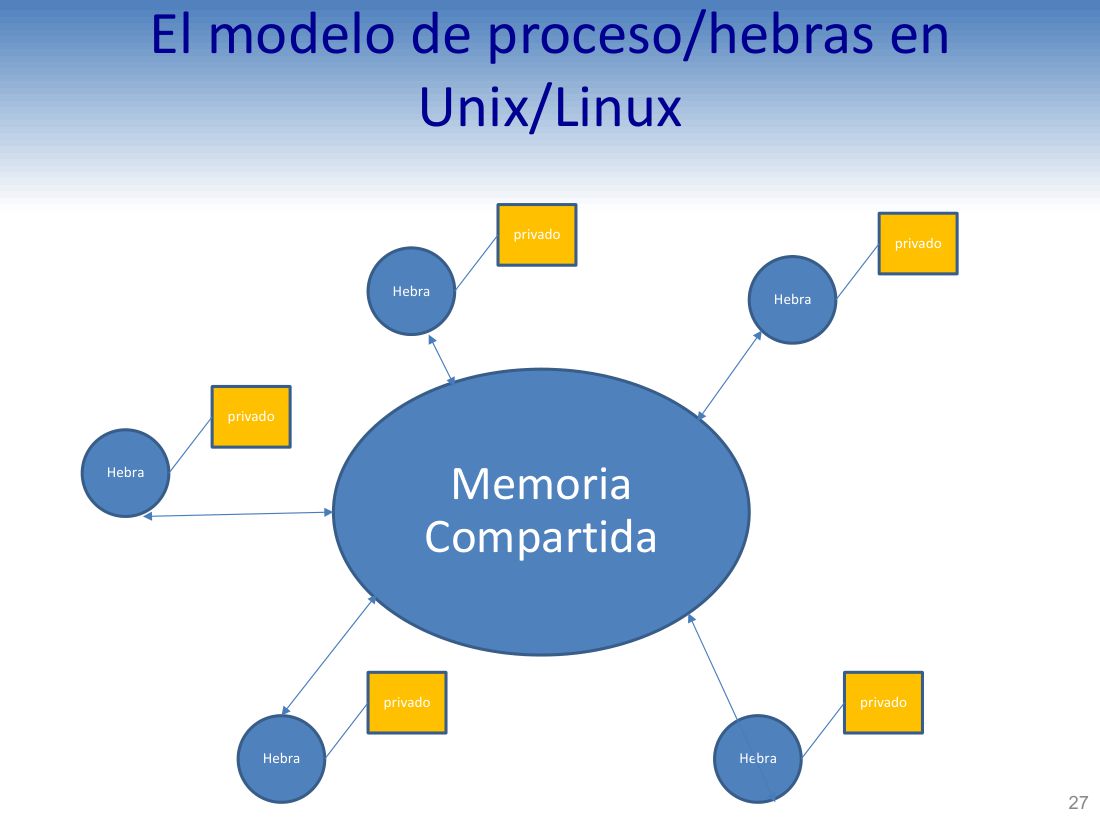
Memoria Compartida
Hebra
周围 5 个圆角方块各代表一条
privado
每条线程外侧的小黄方块标着 privado(私有):即各自的寄存器/栈等不被别人看到的区域。
El modelo de proceso/hebras en Unix/Linux
Unix/Linux 中的
El modelo de proceso/hebras en Unix/Linux · 多条线程调用同一过程
▸ 原页截图 p.28
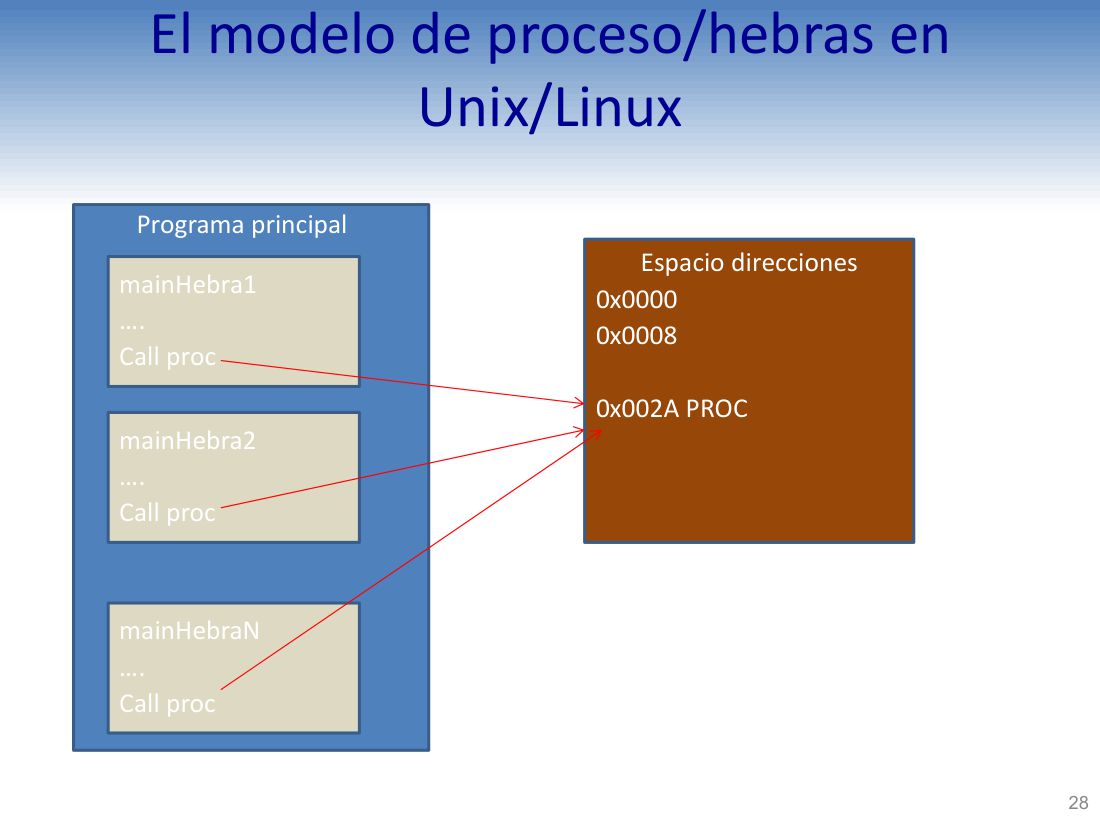
Programa principal
Programa principal:图的左侧大框,代表主程序(进程)的整体结构。
mainHebra1 … mainHebra2 … mainHebraN
框内依次是 mainHebra1、mainHebra2……mainHebraN,即主程序里的 N 条
Call proc
每条线程里都有一行 Call proc:它们都要调用同一个过程(函数)proc。
Espacio direcciones / 0x0000 / 0x0008 / 0x002A PROC
右侧橙色框是
El modelo de proceso/hebras en Unix/Linux
Unix/Linux 中的
Ejemplo hebras Linux · pthread 与 ps -T 实测
▸ 原页截图 p.29
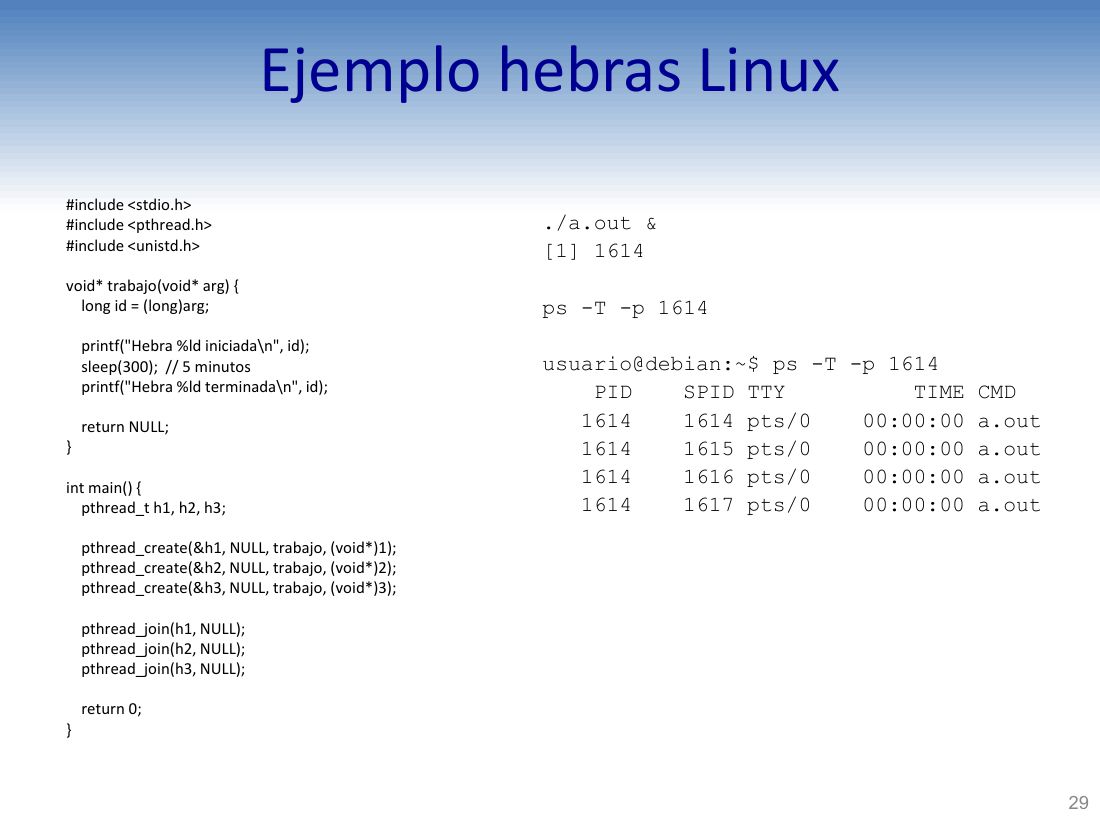
Ejemplo hebras Linux
Linux
long id = (long)arg;
把 void* 实参强转回 long 作为线程编号——本例不走指针,直接传整数。
printf("Hebra %ld iniciada\n", id);
打印 «Hebra %ld iniciada»(线程已启动)。
sleep(300); // 5 minutos
睡眠 300 秒,注释 «5 minutos»(5 分钟)——让线程保持存活以便观察。
printf("Hebra %ld terminada\n", id);
醒来后打印 «Hebra %ld terminada»(线程已结束)。
pthread_create(&h1, NULL, trabajo, (void*)1);
三条线程分别以 (void*)1/2/3 为参数创建——同一入口函数、不同初值(对应 p.14 的 tipo de hebra)。
pthread_join(h1, NULL); pthread_join(h2, NULL); pthread_join(h3, NULL);
主线程依次 join 三条线程,保证它们都结束后 main 才返回。
./a.out & / [1] 1614
后台运行程序,作业号 [1]、
ps -T -p 1614
用 ps -T -p 1614 列出该进程的所有
PID SPID TTY TIME CMD / 1614 1614 pts/0 00:00:00 a.out
输出里 PID 均为 1614,而 SPID 依次为 1614、1615、1616、1617 —— 1 条主线程 + 3 条 pthread_create 线程。
El modelo de proceso/hebras en Unix/Linux · 小结
▸ 原页截图 p.30
En resumen:
小结:
Una hebra pertenece a un proceso y usa sus recursos
一条
Tiene su propio flujo de control independiente mientras que su proceso exista
只要其进程还存在,它就拥有独立的
Duplica sólo recursos esenciales
它只复制本质性的资源(寄存器、栈等最小集合)。
Pueden compartir recursos del proceso con otras hebras que también actúan de forma independiente
它可以与同样独立行动的其他线程共享进程资源。
Muere cuando su proceso padre muere
当它所属的进程(父)死亡时,它也随之死亡。
Son “ligeras”, la sobrecarga es del proceso al que pertenecen
它们是「轻量」的:
POSIX · 为什么要标准化
▸ 原页截图 p.31
POSIX (Portable Operating System Interface), desarrollado por Computer Society IEEE (IEEE-P1003)
En Unix, antes de POSIX (y de Linux) cada fabricante desarrollaba sus propias librerías para diferentes áreas del sistema operativo
在 Unix 中,POSIX(以及 Linux)出现之前,各厂商针对操作系统的不同领域各自开发自己的库。
Diferencias en los comportamientos y en las interfaces
结果导致行为与
Con POSIX, se desarrolla un interfaz de programación estándar para resolver esas diferencias
有了 POSIX,就制定出一套标准的
POSIX
POSIX(本节标题)。
POSIX · 标准族与覆盖范围
▸ 原页截图 p.32
POSIX
POSIX(本节标题)。
La interfaz base se especifica originalmente en IEEE POSIX.1 (1988) con revisiones posteriores
基础接口最初规定于 IEEE POSIX.1(1988),此后多次修订。
POSIX.1-2024 es la última, siendo una actualización (sin cambios significativos) de POSIX.1-2008
POSIX.1-2024 是最新版本,是对 POSIX.1-2008 的更新(无重大变化)。
En realidad, POSIX es un grupo de estándares y cada uno cubre diferentes aspectos de los sistemas operativos compatibles con Unix incluyendo
实际上 POSIX 是一组标准,每个标准覆盖与 Unix 兼容的操作系统的不同方面,包括:
Gestión de procesos y hebras
Entrada/salida y sistema de archivos
输入/输出与文件系统。
Manejo de señales y sincronización
Utilidades de línea de comandos
命令行工具。
A partir de ese momento los vendedores ofrecen esta interfaz además de sus propias librerías
从此之后,厂商除自家库之外,还额外提供这套标准接口。
三、进程的创建与表示 · PCB · 线程模型 · POSIX
p.18–p.32POSIX(续)· pthreads 与 C11/C++11
▸ 原页截图 p.33
POSIX
POSIX(本页标题)。
En el caso de las hebras, las implementaciones de este estándar se denominan POSIX threads o pthreads
就线程而言,该标准的实现被称为
Las funcionalidades de hebras están incluidas en POSIX.1
线程相关功能都包含在 POSIX.1 中。
Originalmente, la parte de hebras se definió en POSIX.1c y POSIX.1b contenía las extensiones de tiempo real
最初线程部分定义在 POSIX.1c 中,而 POSIX.1b 包含
Al margen de pthreads, C11 y C++11 fueron las primeras versiones de C y C++ que introdujeron soporte estándar para concurrencia
除 pthreads 之外,C11 与 C++11 是 C 和 C++ 最早引入标准
Pero pthreads sigue siendo la opción más popular (sobre todo en C)
但 pthreads 仍是最流行的选择(尤其在 C 语言中)。
Ciclo de vida completo · 完整生命周期
▸ 原页截图 p.34
Ciclo de vida completo
完整生命周期(本页标题)。
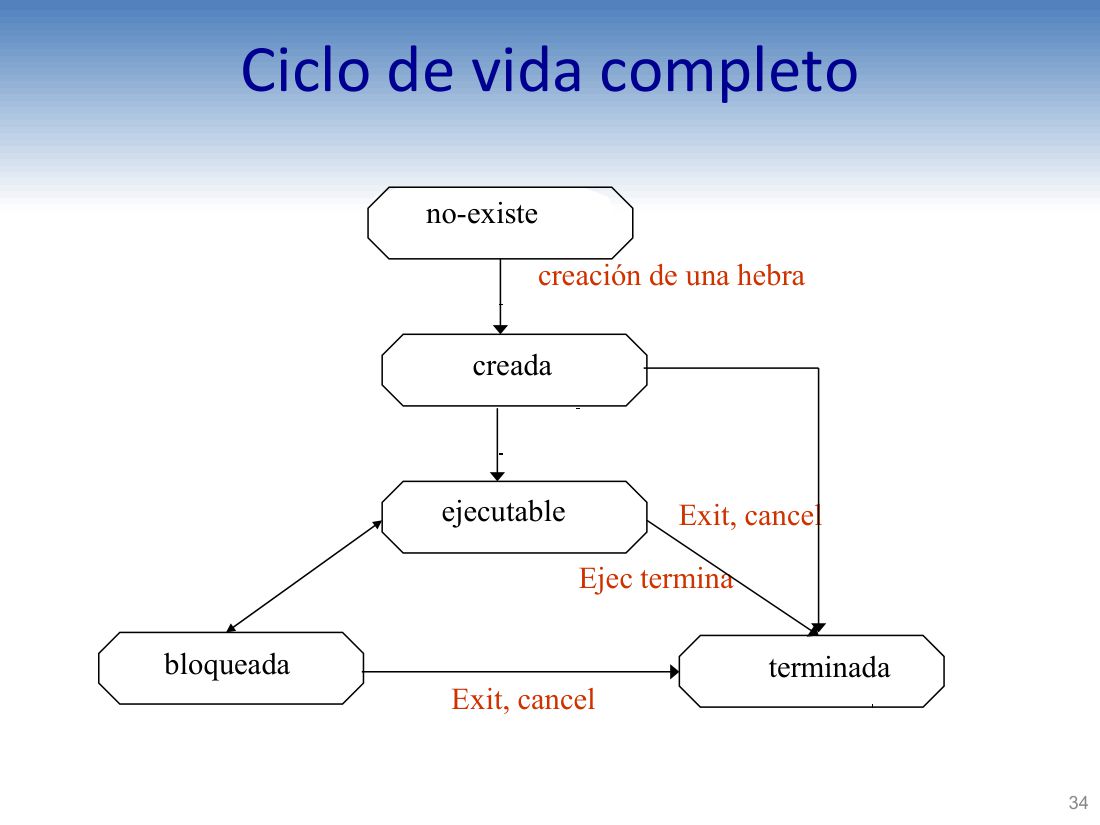
no-existe
creación de una hebra
创建线程(no-existe → creada 的转移)。
creada
ejecutable
Ejec termina
执行结束(ejecutable → terminada)。
bloqueada
terminada
Exit, cancel
退出(exit)或被取消(cancel):图中 creada、bloqueada 也有指向 terminada 的该标注。
Estado creado · 已创建状态与 pthread_create
▸ 原页截图 p.35
Estado creado
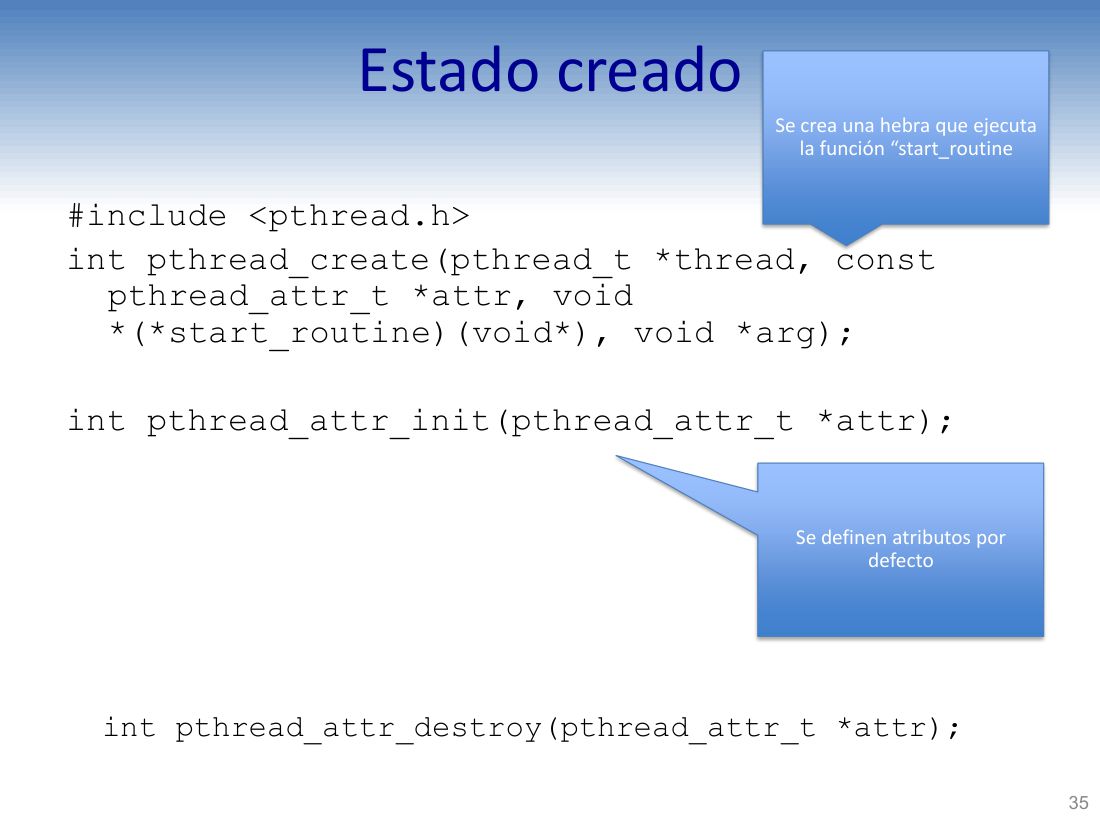
#include <pthread.h>
引入 pthreads 头文件。
int pthread_create(pthread_t *thread, const pthread_attr_t *attr, void *(*start_routine)(void*), void *arg);
创建线程:thread 回填线程标识,attr 为属性,start_routine 是线程函数,arg 是传给它的参数。
Se crea una hebra que ejecuta la función “start_routine
创建一个执行函数 “start_routine 的线程(原文引号未闭合,照抄)。
int pthread_attr_init(pthread_attr_t *attr);
初始化线程属性对象。
Se definen atributos por defecto
设定
int pthread_attr_destroy(pthread_attr_t *attr);
销毁属性对象,释放其内部资源。
Estado creado(续)· 线程数量与无层级依赖
▸ 原页截图 p.36
Estado creado
Estado creado(承接上页)。
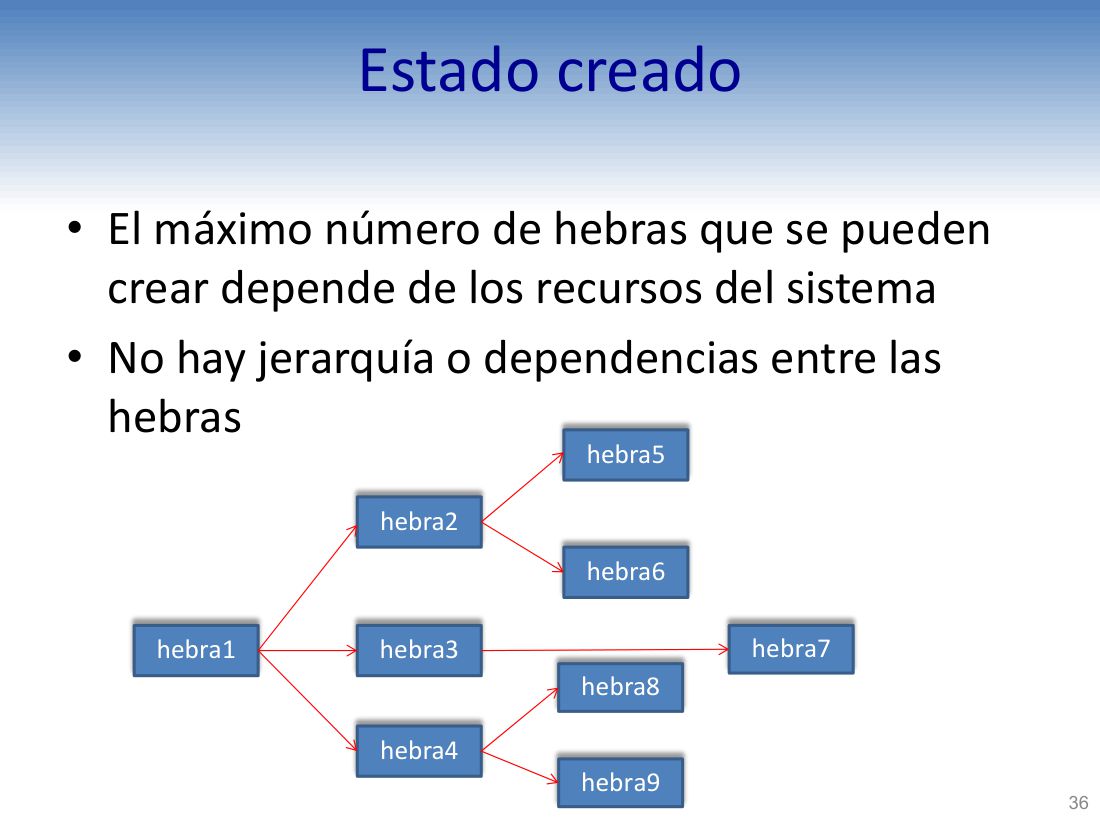
El máximo número de hebras que se pueden crear depende de los recursos del sistema
可创建的线程
No hay jerarquía o dependencias entre las hebras
线程之间
hebra1 · hebra2 · hebra3 · hebra4 · hebra5 · hebra6 · hebra7 · hebra8 · hebra9
图中 hebra1…hebra9 九个线程彼此独立并列,没有任何父子连线。
Estado creado(续)· 线程属性
▸ 原页截图 p.37
Estado creado
Estado creado(承接上页)。
Otras funciones se utilizan para definir los atributos:
还有其他函数用于定义线程属性:
Estado “detached” o “joinable”
Políticas de planificación
Parámetros de planificación
Tamaño de la pila
Dirección de la pila
Estado ejecutable · 可执行状态:lista 与 en-ejecución
▸ 原页截图 p.38
Estado ejecutable
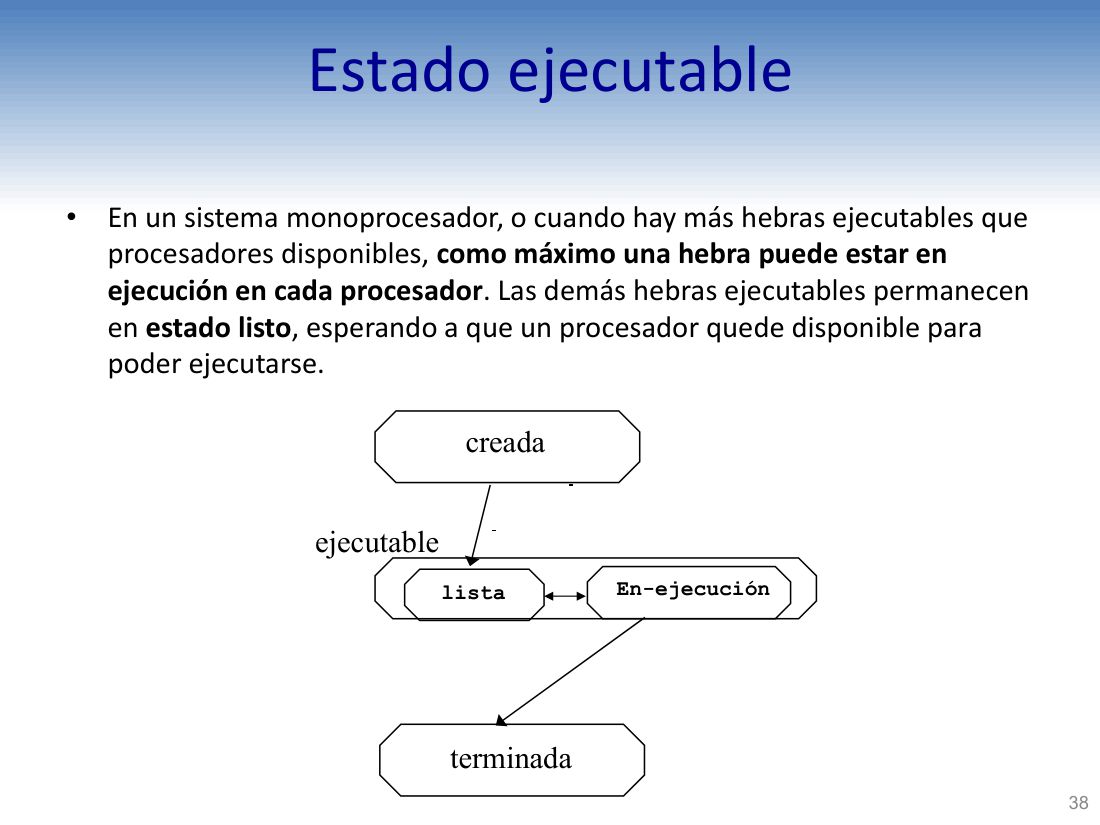
En un sistema monoprocesador, o cuando hay más hebras ejecutables que procesadores disponibles, como máximo una hebra puede estar en ejecución en cada procesador.
在单处理器系统中,或可执行线程数多于可用处理器时,每个处理器上
Las demás hebras ejecutables permanecen en estado listo, esperando a que un procesador quede disponible para poder ejecutarse.
其余可执行线程停留在
creada → ejecutable → terminada · lista / En-ejecución
图中把 ejecutable 拆成
Estado ejecutable(续)· 状态转换与上下文切换
▸ 原页截图 p.39
Estado ejecutable
Estado ejecutable(承接上页)。
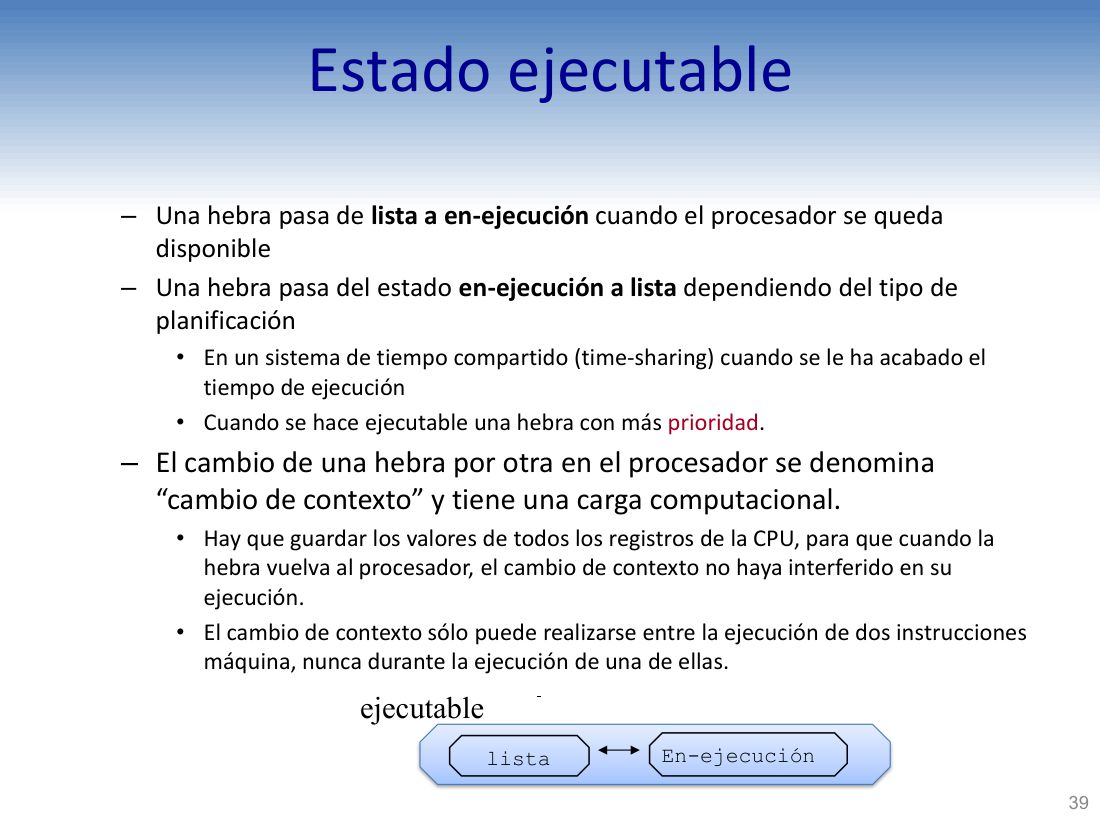
Una hebra pasa de lista a en-ejecución cuando el procesador se queda disponible
当处理器空出来时,线程从 lista 转入 en-ejecución。
Una hebra pasa del estado en-ejecución a lista dependiendo del tipo de planificación
线程从 en-ejecución 退回 lista,取决于
En un sistema de tiempo compartido (time-sharing) cuando se le ha acabado el tiempo de ejecución
在
Cuando se hace ejecutable una hebra con más prioridad.
或当出现一个
El cambio de una hebra por otra en el procesador se denomina “cambio de contexto” y tiene una carga computacional.
处理器上由一个线程换为另一个线程称为
Hay que guardar los valores de todos los registros de la CPU, para que cuando la hebra vuelva al procesador, el cambio de contexto no haya interferido en su ejecución.
必须保存 CPU 全部寄存器的值,这样线程再回到处理器时,上下文切换不会干扰其执行。
El cambio de contexto sólo puede realizarse entre la ejecución de dos instrucciones máquina, nunca durante la ejecución de una de ellas.
上下文切换只能发生在两条
Estado Bloqueado · 阻塞状态与解除条件
▸ 原页截图 p.40
Estado Bloqueado
Una hebra se encuentra en un estado bloqueado cuando no puede continuar su ejecución hasta que ocurra “algún evento”.
当线程必须等到「某个事件」发生才能继续时,它就处于阻塞状态。
Bloqueos por E/S (acceso a disco o dispositivos)
因
Bloqueos por uso de primitivas de sincronización (mutex o semáforos)
因使用
Para que una hebra bloqueada vuelva a estar disponible para ejecución,
要让阻塞线程重新可执行:
En el caso de completarse una solicitud de E/S el planificador del SO vuelve a poner a la hebra en el estado “lista”
若 I/O 请求完成,操作系统
En el caso de usar primitivas de sincronización, otra hebra debe utilizar alguna primitiva específica para ello (según se usen semáforos o variables condición)
若用的是同步原语,则必须由另一个线程调用相应原语来唤醒它(视用信号量还是
El que la hebra vuelva a estar disponible no quiere decir que pase a ejecutarse de momento, sino que pasaría a la lista de hebras disponibles para ejecución
「重新可用」并不意味着马上就执行,而是进入可执行线程队列(lista)。
Terminación de una hebra · 线程终止的五种情形
▸ 原页截图 p.41
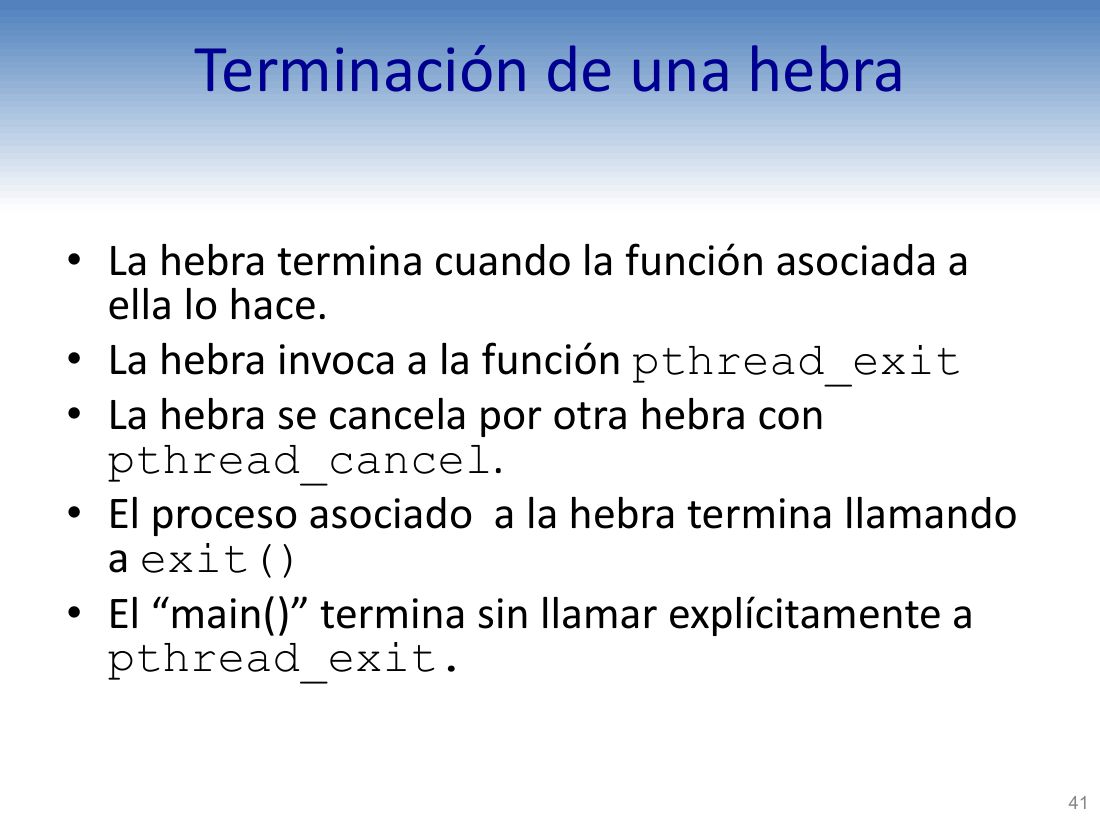
Terminación de una hebra
线程的
La hebra termina cuando la función asociada a ella lo hace.
当线程所关联的函数结束时,线程就结束。
La hebra invoca a la función pthread_exit
线程主动调用 pthread_exit。
La hebra se cancela por otra hebra con pthread_cancel.
线程被另一个线程用 pthread_cancel 取消。
El proceso asociado a la hebra termina llamando a exit()
线程所属的进程调用 exit() 结束。
El “main()” termina sin llamar explícitamente a pthread_exit.
或 main() 结束且没有显式调用 pthread_exit(此时整个进程退出,所有线程随之消亡)。
Terminación de una hebra(续)· pthread_exit 与 pthread_cancel
▸ 原页截图 p.42
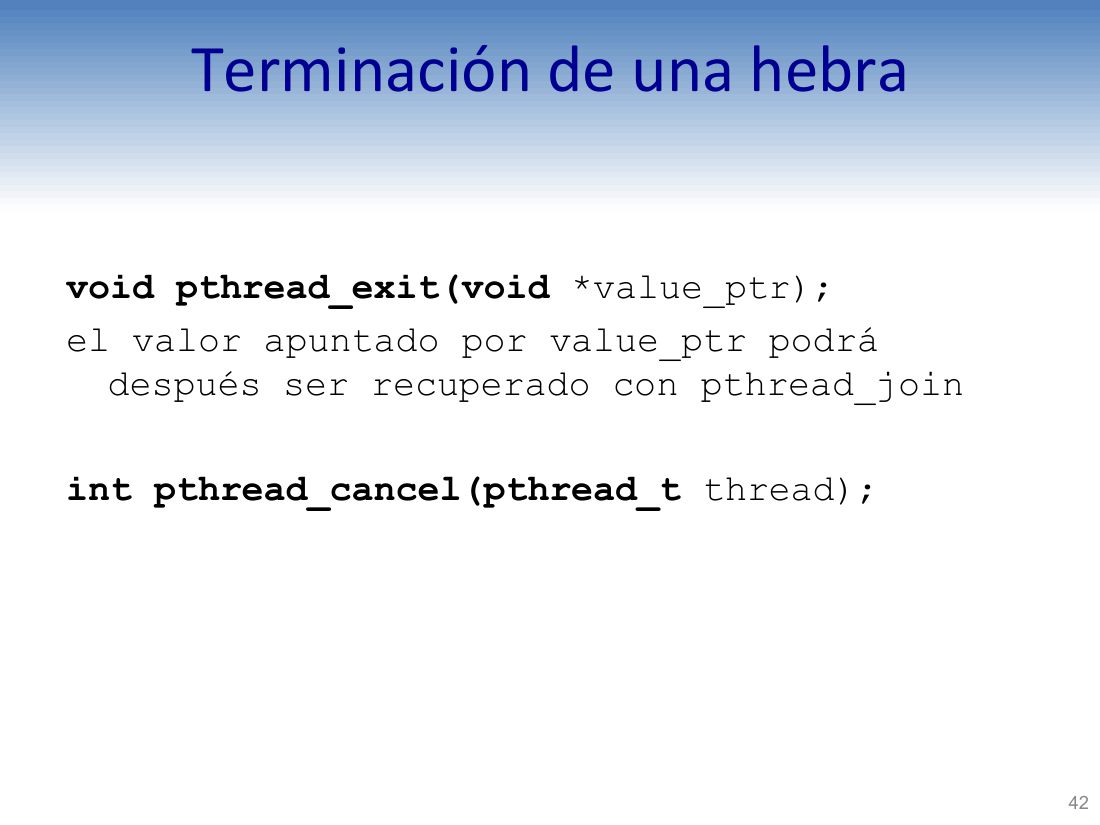
Terminación de una hebra
线程的终止(承接上页)。
void pthread_exit(void *value_ptr);
线程主动退出,并通过 value_ptr 交回一个退出值。
el valor apuntado por value_ptr podrá después ser recuperado con pthread_join
value_ptr 所指的值之后可由 pthread_join 取回。
int pthread_cancel(pthread_t thread);
请求取消指定线程(thread 为线程标识)。
Ejemplo Creación/Terminación · 创建与终止完整示例
▸ 原页截图 p.43
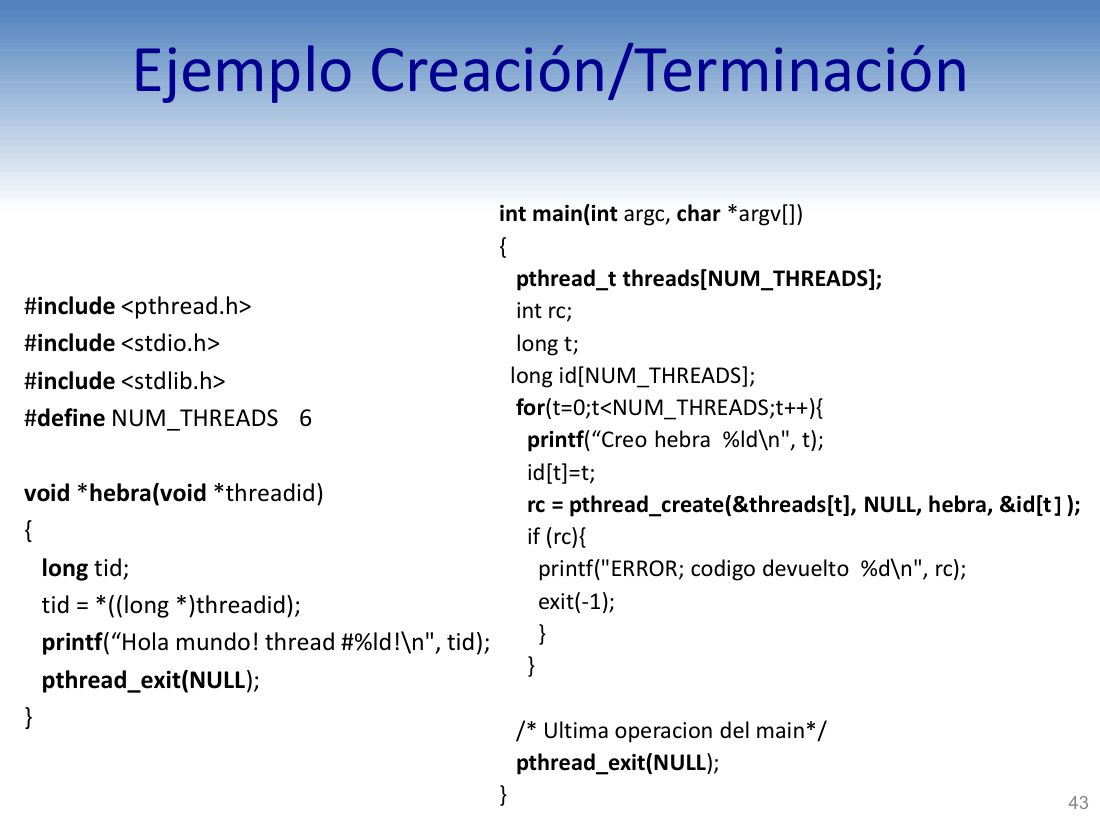
Ejemplo Creación/Terminación
创建/终止示例(本页标题)。
#include <pthread.h> #include <stdio.h> #include <stdlib.h>
引入 pthreads、标准输入输出与通用工具三个头文件。
#define NUM_THREADS 6
宏定义线程数为 6。
void *hebra(void *threadid)
线程入口函数 hebra:参数与返回值都是 void*。
long tid; tid = *((long *)threadid);
把传入的 void* 转成 long* 再解引用,得到本线程编号。
printf(“Hola mundo! thread #%ld!\n", tid);
打印问候语与线程号(原文左引号为弯引号,照抄)。
pthread_exit(NULL);
线程主动结束,不返回退出值。
int main(int argc, char *argv[])
主函数入口。
pthread_t threads[NUM_THREADS]; int rc; long t; long id[NUM_THREADS];
线程标识数组、返回码、循环变量,以及给每个线程传参用的 id 数组。
for(t=0;t<NUM_THREADS;t++){
循环 6 次,逐个创建线程。
printf(“Creo hebra %ld\n", t); id[t]=t;
先打印「Creo hebra t」,再把编号写入 id[t]。
rc = pthread_create(&threads[t], NULL, hebra, &id[t]);
用默认属性创建线程,入口为 hebra,参数是 &id[t]。
if (rc){ printf("ERROR; codigo devuelto %d\n", rc); exit(-1); }
若返回码非 0 就打印错误并终止整个进程。
/* Ultima operacion del main*/ pthread_exit(NULL);
main 的最后一步是 pthread_exit(NULL):让主线程结束但不杀掉其它线程。
四、线程的生命周期与 pthreads 编程
p.33–p.43五、pthreads 实战:编译 · 参数传递 · join 与 detached
p.44–p.53Compilación con pthreads · pthreads 的编译
▸ 原页截图 p.44
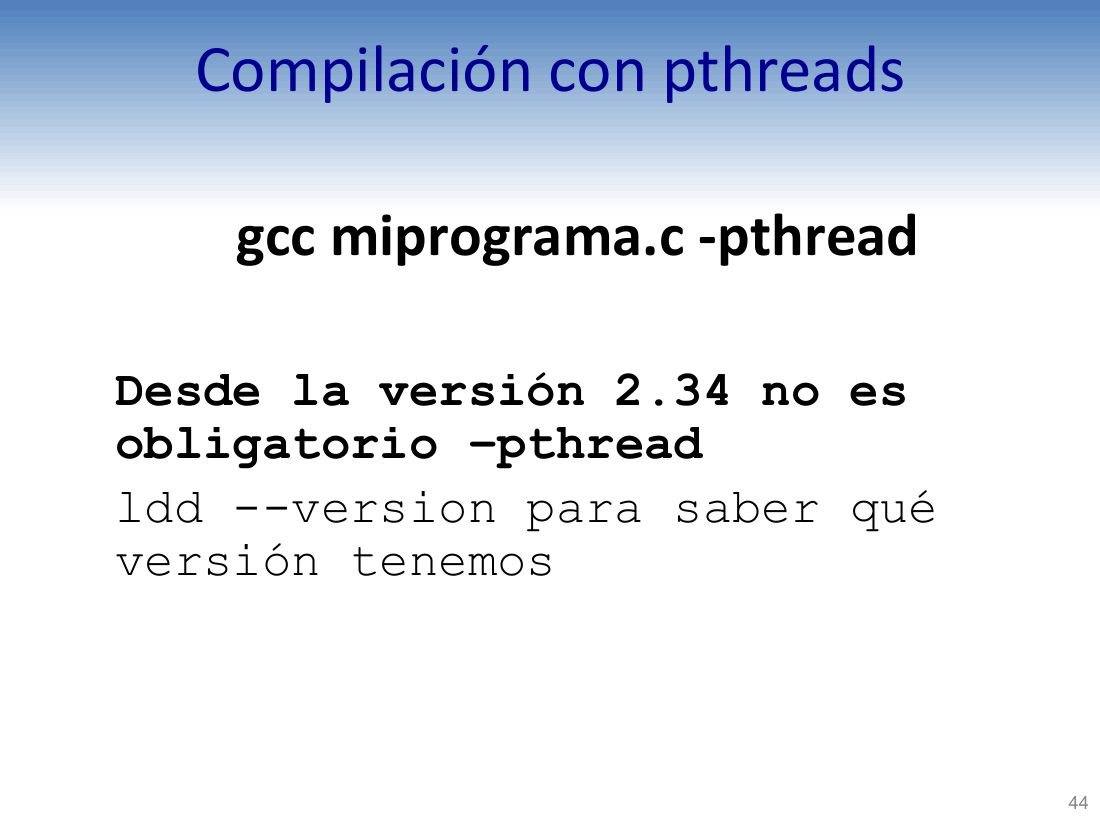
Compilación con pthreads
使用 pthreads 的
gcc miprograma.c -pthread
经典编译命令:gcc miprograma.c -pthread。
Desde la versión 2.34 no es obligatorio –pthread
从(glibc)2.34 版本起,–pthread 不再是必需的。
ldd --version para saber qué versión tenemos
用 ldd --version 查看当前系统的版本。
Paso de parámetros · 参数传递(线性查找示例)
▸ 原页截图 p.45
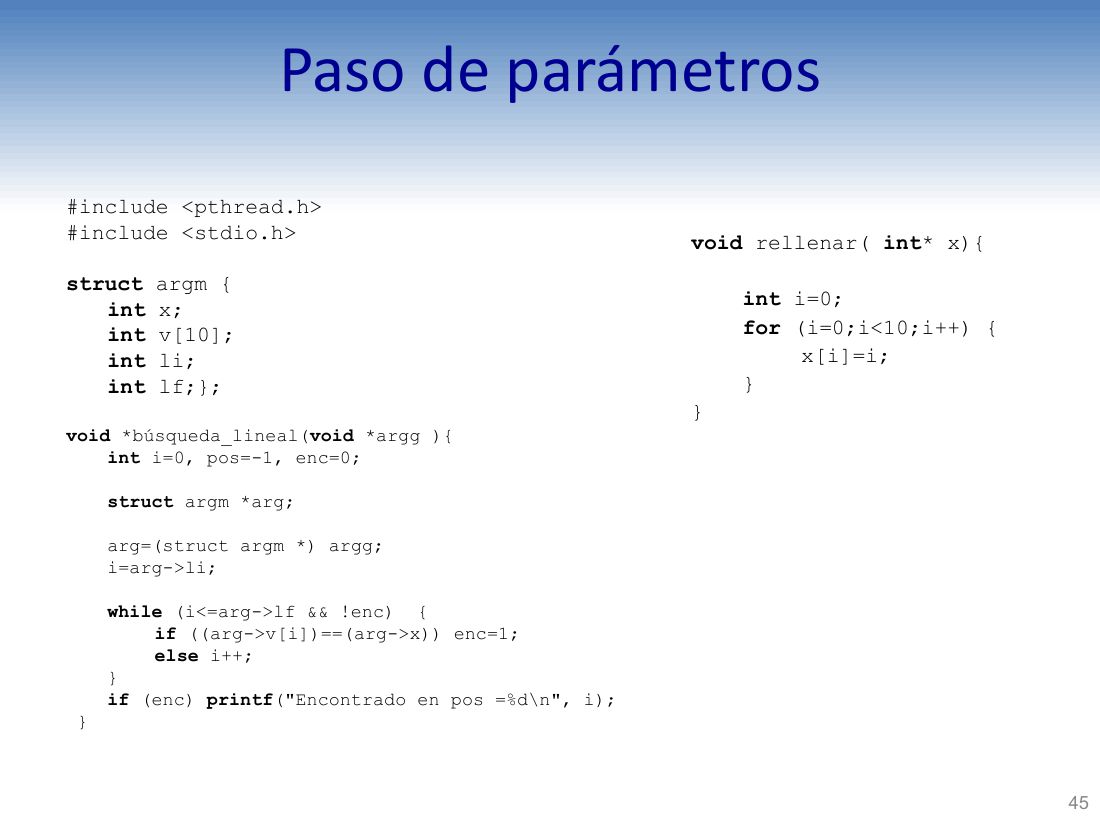
Paso de parámetros
#include <pthread.h> #include <stdio.h>
引入 pthreads 与标准 I/O 头文件。
struct argm { int x; int v[10]; int li; int lf; };
自定义结构体 argm:待查值 x、数组 v[10]、查找区间 li 与 lf。
void *búsqueda_lineal(void *argg ){
线程入口 búsqueda_lineal(线性查找),参数为 void*。
int i=0, pos=-1, enc=0;
局部变量:下标、位置(初值 −1)、是否找到的标志 enc。
struct argm *arg; arg=(struct argm *) argg;
把 void* 强转为 struct argm*,得到参数结构体指针。
i=arg->li;
从区间下界 li 开始查找。
while (i<=arg->lf && !enc) {
只要没超过上界且还没找到就继续循环。
if ((arg->v[i])==(arg->x)) enc=1; else i++;
命中则置 enc=1,否则下标加一。
if (enc) printf("Encontrado en pos =%d\n", i);
若找到就打印位置。
void rellenar( int* x){ int i=0; for (i=0;i<10;i++) { x[i]=i; } }
辅助函数:把数组填成 0…9。
Paso de parámetros(续)· main 中的创建与 join
▸ 原页截图 p.46
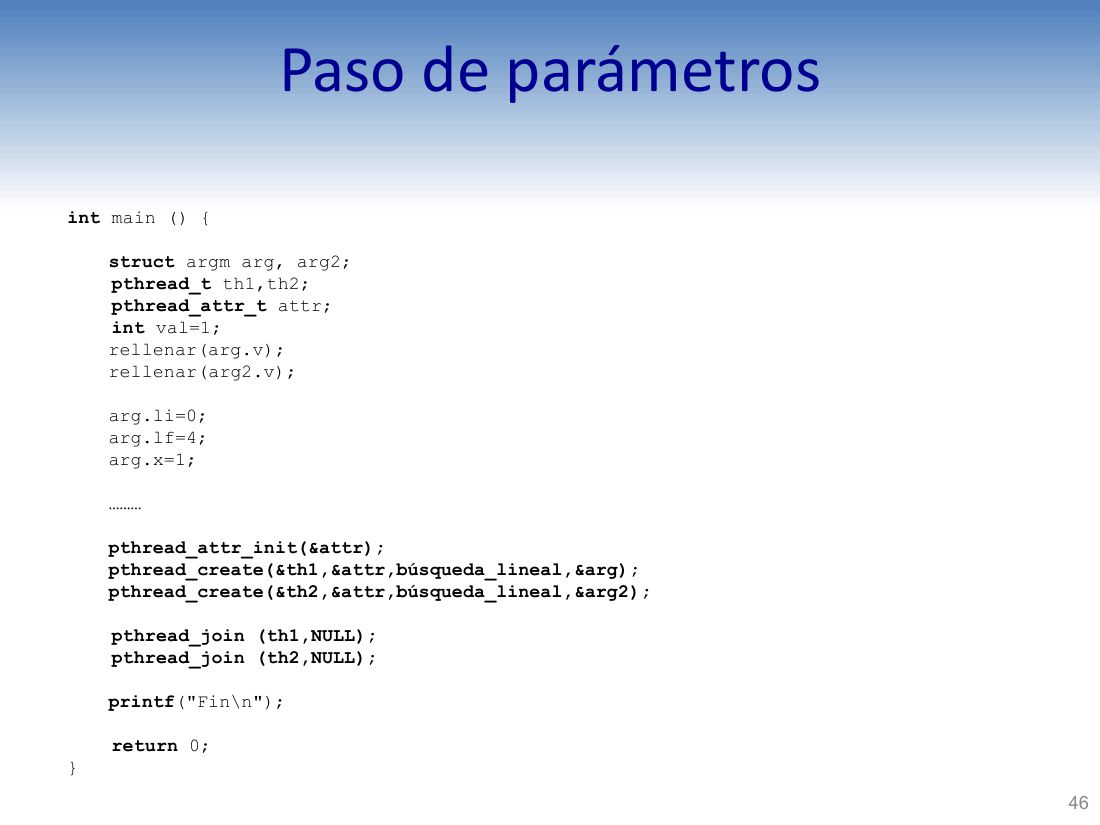
Paso de parámetros
Paso de parámetros(承接上页)。
int main () { struct argm arg, arg2; pthread_t th1,th2; pthread_attr_t attr; int val=1;
main 中声明两份参数结构体、两个线程标识、一个属性对象,以及 val。
rellenar(arg.v); rellenar(arg2.v);
给两份数组都填入 0…9。
arg.li=0; arg.lf=4; arg.x=1; ………
为第一份设定查找区间 [0,4] 与待查值 1;省略号处对 arg2 做类似设置。
pthread_attr_init(&attr);
初始化线程属性对象(
pthread_create(&th1,&attr,búsqueda_lineal,&arg);
创建 th1,用刚初始化的属性,参数是 &arg。
pthread_create(&th2,&attr,búsqueda_lineal,&arg2);
创建 th2,参数是 &arg2。
pthread_join (th1,NULL); pthread_join (th2,NULL);
主线程分别等待 th1、th2 结束(不接收退出值)。
printf("Fin\n"); return 0;
打印 «Fin» 后正常返回。
La función join · join 函数
▸ 原页截图 p.47
La función join
Una hebra puede esperar (en estado bloqueado) a que otra hebra termine llamando a join sobre esta otra hebra.
一个线程可以对另一个线程调用 join,从而(以阻塞状态)等待后者结束。
Es un mecanismo de sincronización entre hebras.
这是一种线程间的
Existen otras alternativas que veremos más adelante
还有其他替代机制,后面再讲。
La función pthread_join()bloquea la hebra hasta que la hebra que se indica en su parámetro no termine.
pthread_join() 会把调用线程阻塞,直到其参数所指的线程结束(原文 «no termine» 多了一个 no,照抄)。
Ejemplo suma vector · 向量求和的 join 示例
▸ 原页截图 p.48
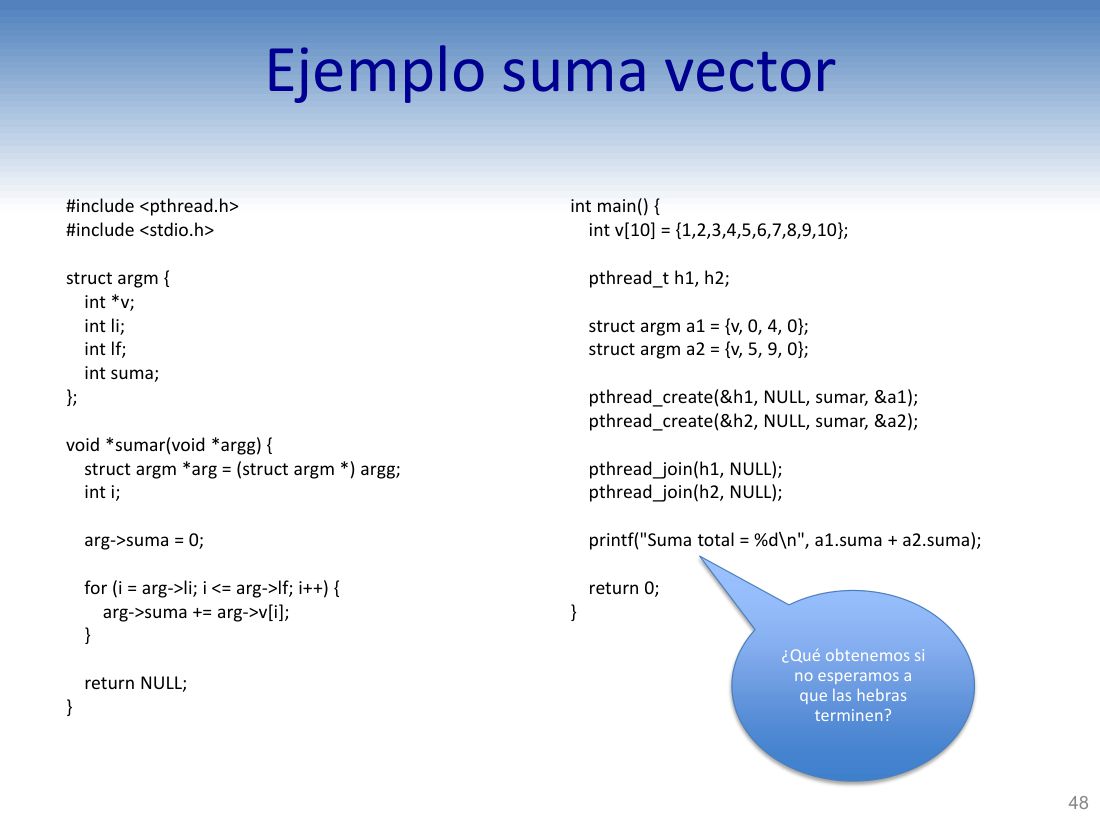
Ejemplo suma vector
向量求和示例(本页标题)。
#include <pthread.h> #include <stdio.h>
引入所需头文件。
struct argm { int *v; int li; int lf; int suma; };
参数结构体:数组指针、区间下界、上界,以及存放部分和的 suma。
void *sumar(void *argg) {
线程入口 sumar。
struct argm *arg = (struct argm *) argg; int i;
拆包:把 void* 还原成 struct argm*。
arg->suma = 0;
部分和清零。
for (i = arg->li; i <= arg->lf; i++) { arg->suma += arg->v[i]; }
只累加 [li, lf] 区间内的元素。
return NULL;
线程正常返回(等价于退出值为 NULL)。
int main() { int v[10] = {1,2,3,4,5,6,7,8,9,10}; pthread_t h1, h2;
main 中定义 1…10 的数组与两个线程标识。
struct argm a1 = {v, 0, 4, 0}; struct argm a2 = {v, 5, 9, 0};
把数组切成两半:[0,4] 给 a1,[5,9] 给 a2。
pthread_create(&h1, NULL, sumar, &a1); pthread_create(&h2, NULL, sumar, &a2);
用默认属性创建两个求和线程。
pthread_join(h1, NULL); pthread_join(h2, NULL);
等两个线程都算完。
printf("Suma total = %d\n", a1.suma + a2.suma); return 0;
把两个部分和相加打印,即 55。
¿Qué obtenemos si no esperamos a que las hebras terminen?
页面右下提问:如果不等待线程结束,会得到什么结果?
Joinable vs detached · 可汇合与分离
▸ 原页截图 p.49
Joinable vs detached
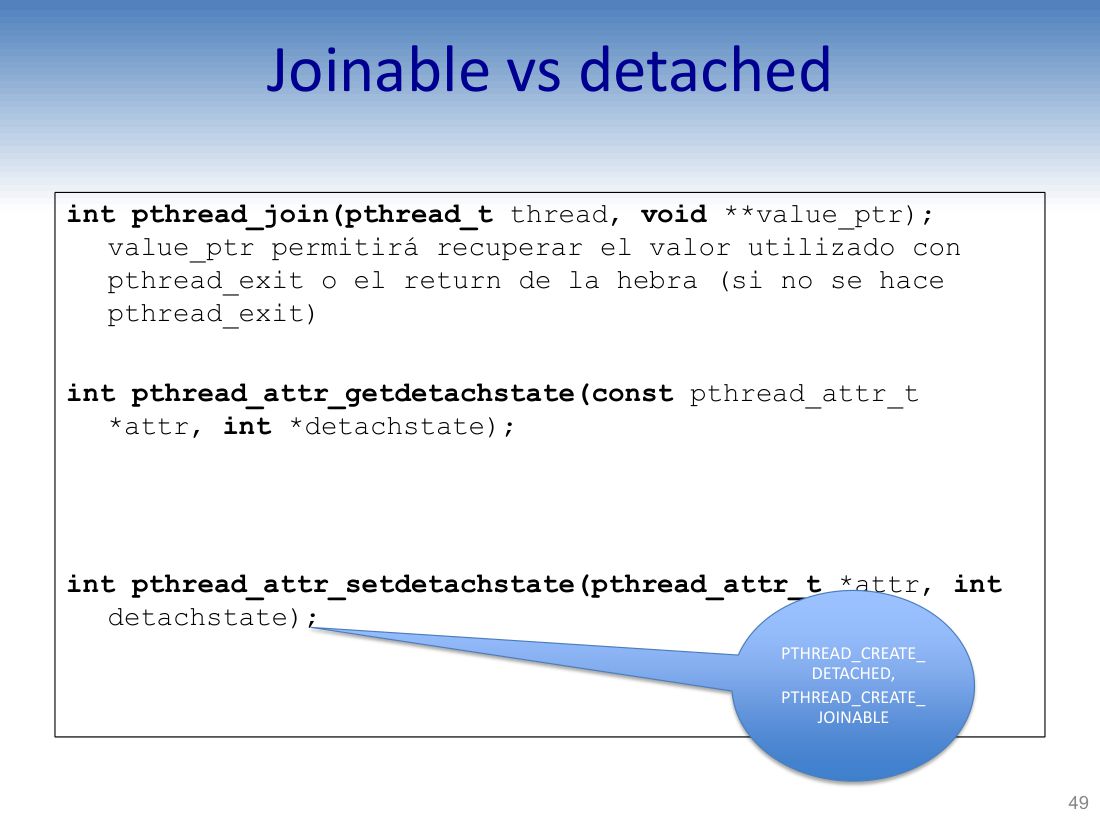
int pthread_join(pthread_t thread, void **value_ptr);
等待线程结束:thread 指定目标线程,value_ptr 用于接收退出值。
value_ptr permitirá recuperar el valor utilizado con pthread_exit o el return de la hebra (si no se hace pthread_exit)
value_ptr 可取得线程经 pthread_exit 交回的值,或(未调用 pthread_exit 时)return 返回的值。
int pthread_attr_getdetachstate(const pthread_attr_t *attr, int *detachstate);
读取属性对象中的分离状态。
int pthread_attr_setdetachstate(pthread_attr_t *attr, int detachstate);
设置属性对象中的分离状态。
PTHREAD_CREATE_DETACHED, PTHREAD_CREATE_JOINABLE
两个合法取值:
Joinable vs detached(续)· 显式设为 joinable 并创建
▸ 原页截图 p.50
Joinable vs detached
Joinable vs detached(承接上页)。
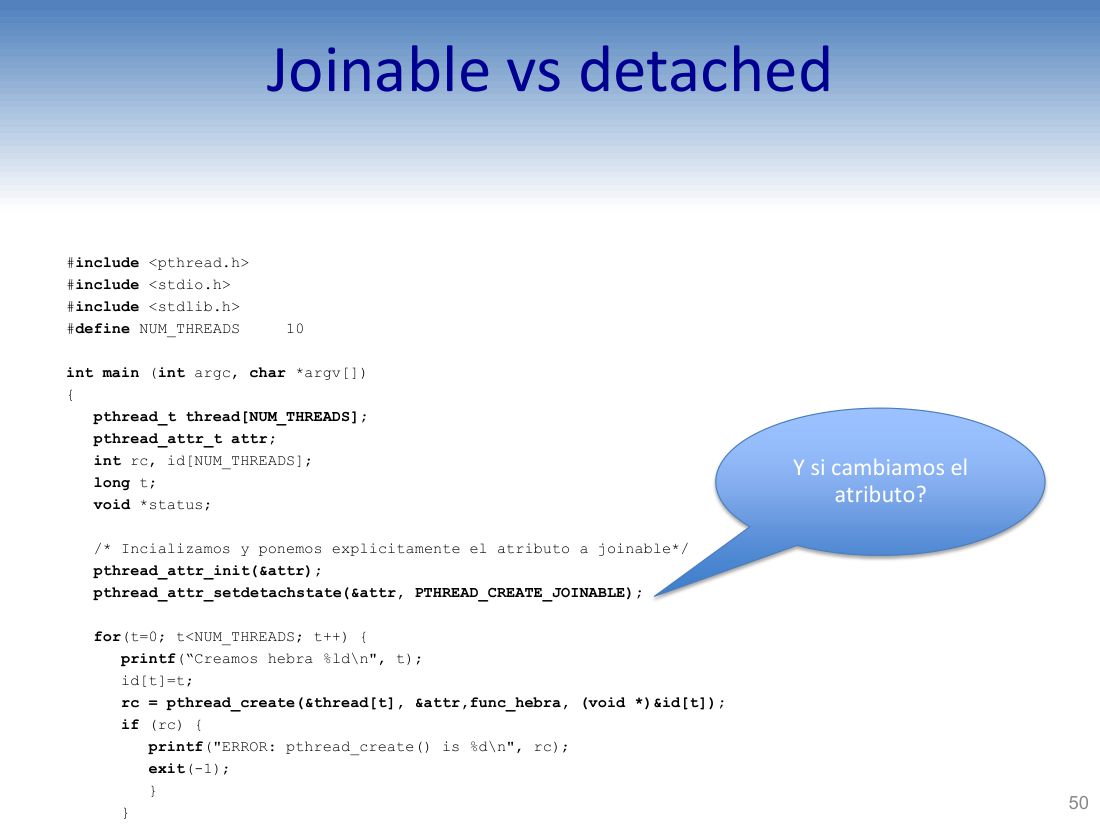
#include <pthread.h> #include <stdio.h> #include <stdlib.h>
三个头文件。
#define NUM_THREADS 10
线程数宏定义为 10(原文换行排版,照抄数值)。
int main (int argc, char *argv[]) {
主函数入口。
pthread_t thread[NUM_THREADS]; pthread_attr_t attr; int rc, id[NUM_THREADS]; long t; void *status;
线程标识数组、属性对象、返回码与编号数组、循环变量、退出值指针。
/* Incializamos y ponemos explicitamente el atributo a joinable*/
注释:初始化属性,并显式设为 joinable(原文 Incializamos 少一个 i,照抄)。
pthread_attr_init(&attr);
初始化属性对象。
pthread_attr_setdetachstate(&attr, PTHREAD_CREATE_JOINABLE);
把分离状态设为
for(t=0; t<NUM_THREADS; t++) {
循环创建 10 个线程。
printf(“Creamos hebra %ld\n", t); id[t]=t;
打印「Creamos hebra t」,并记录编号。
rc = pthread_create(&thread[t], &attr,func_hebra, (void *)&id[t]);
用设定好的属性创建线程,入口 func_hebra,参数为 &id[t]。
if (rc) { printf("ERROR: pthread_create() is %d\n", rc); exit(-1); }
创建失败则打印错误码并退出进程。
Y si cambiamos el atributo?
页面右下提问:如果把属性改掉(改成 detached)会怎样?
Joinable vs detached(续)· 回收与退出值
▸ 原页截图 p.51
Joinable vs detached
Joinable vs detached(承接上页)。
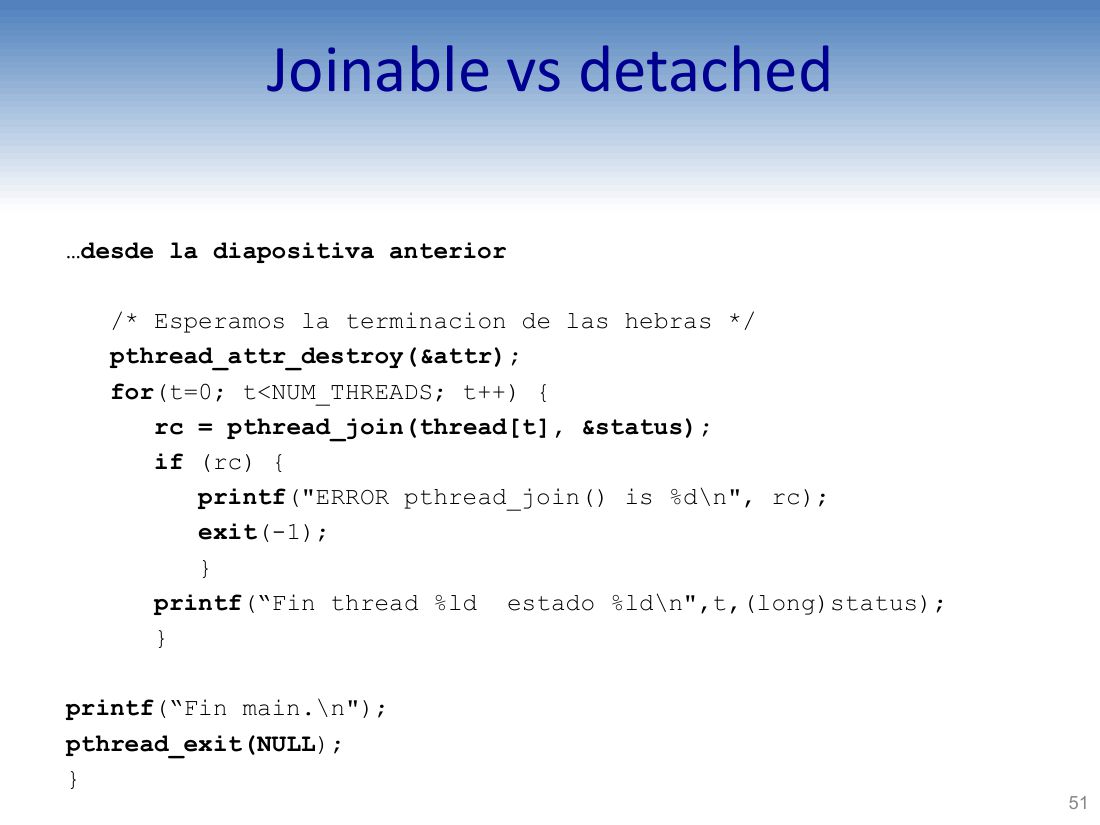
…desde la diapositiva anterior
……接上一页(代码续)。
/* Esperamos la terminacion de las hebras */
注释:等待各线程结束。
pthread_attr_destroy(&attr);
属性用完即销毁(创建阶段已结束)。
for(t=0; t<NUM_THREADS; t++) { rc = pthread_join(thread[t], &status);
逐个 join,并把退出值存入 status。
if (rc) { printf("ERROR pthread_join() is %d\n", rc); exit(-1); }
join 失败则报错退出。
printf(“Fin thread %ld estado %ld\n",t,(long)status);
打印线程号与其退出状态(把 void* 转成 long)。
printf(“Fin main.\n"); pthread_exit(NULL); }
打印 «Fin main.» 后主线程以 pthread_exit(NULL) 收尾(不是 return)。
Joinable vs detached(续)· func_hebra 线程函数
▸ 原页截图 p.52
Joinable vs detached
Joinable vs detached(承接前两页)。
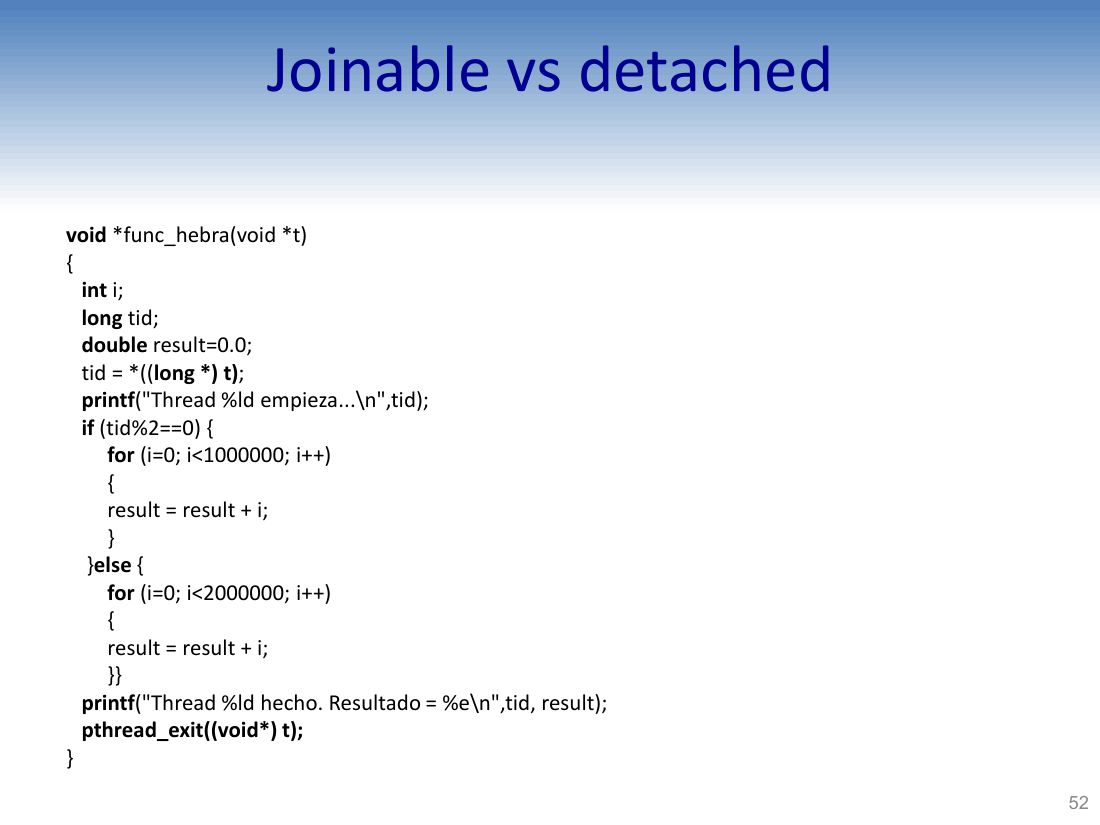
void *func_hebra(void *t) { int i; long tid; double result=0.0;
线程函数:局部变量 i、线程号 tid、累加结果 result。
tid = *((long *) t);
解引用参数,取回线程号。
printf("Thread %ld empieza...\n",tid);
打印「Thread tid empieza...」(开始)。
if (tid%2==0) {
偶数号线程走第一支:
for (i=0; i<1000000; i++) { result = result + i; }
累加 0…999999(较轻的活)。
}else { for (i=0; i<2000000; i++) { result = result + i; }}
奇数号线程累加 0…1999999(两倍的活),用来制造不均衡负载。
printf("Thread %ld hecho. Resultado = %e\n",tid, result);
打印「Thread tid hecho. Resultado = …」(已完成)。
pthread_exit((void*) t);
把传入的 t 原样作为退出值交回(供 p.51 的 status 接收)。
En resumen… · 本章小结
▸ 原页截图 p.53
En resumen…
小结……(本页标题)。
Necesitamos nuevas abstracciones para la programación concurrente:
我们需要新的抽象来支撑
Procesos
Hebras
En nuestro caso, vamos a utilizar POSIX con C y hebras
本课程选用
Debemos conocer bien cómo funciona la creación de hebras, el paso de parámetros y la sincronización con su finalización
必须熟练掌握三件事:
专有名词速记表(A–Z)
共 114 条,覆盖全 53 页的高频术语。第三列点页码直接跳回原页;最后一列只写「一句话 + 最容易被扣分的点」。
| 西语术语 | 中文 | 页码 | 一句话记住 · 易错点 |
|---|---|---|---|
| # | |||
| “cambio de contexto” | 上下文切换 | p.39 | 换线程=保存全部寄存器再恢复;只能发生在两条机器指令之间,不能一条指令执行到一半就换。 |
| 线程号 TID | 线程号 | p.25 | top -H / ps -T 里每行一个线程,SPID 就是 TID;同一进程内各线程 TID 不同。 |
| A | |||
| aislamiento | 隔离 | p.4 | 进程之间地址空间相互隔离;线程之间不隔离,共享同一地址空间。 |
| atributos por defecto | 默认属性 | p.35 | pthread_create 第 2 参数传 NULL 即默认属性;要自定义就先 attr_init 再填。 |
| B | |||
| bloqueada | 阻塞 | p.34 | 等事件(E/S 或同步原语);事件到来只回 lista,不会直接跳到运行。 |
| C | |||
| código de salida | 退出码 | p.17 | wait(&status) 后用 WEXITSTATUS(status) 取;只有正常终止时才有意义。 |
| como máximo | 最多 | p.38 | 「每个处理器最多一个线程在运行」的前提是单核,或可运行线程多于核。 |
| Compilación | 编译 | p.44 | gcc miprograma.c -pthread;glibc 2.34 起可省略,版本用 ldd --version 查。 |
| Comunicación entre procesos | 进程间通信 | p.20 | PCB 之外的另一类进程信息:管道、信号、共享内存、信号量都算 IPC。 |
| concurrencia | 并发 | p.1 | 多个控制流在时间上重叠;并发不等于并行,并行还要求多核同时执行。 |
| contador de programa | 程序计数器 | p.6 | PC 指向下一条待执行指令;每个线程各有一份,属于私有上下文。 |
| contador del programa | 程序计数器 | p.24 | p.24 的另一种写法;线程私有寄存器清单的第一项。 |
| contexto de ejecución | 执行上下文 | p.4 | 寄存器+PC+栈指针等构成的一张快照;切换线程时整张保存、整张恢复。 |
| corrutina | 协程 | p.9 | 用户态协作式让出,没有内核抢占;不要与操作系统的抢占式线程混为一谈。 |
| creación de hebras | 线程创建 | p.53 | pthread_create:函数指针+void* 参数;创建完只是 creada,是否运行看调度器。 |
| Creación dinámica | 动态创建 | p.10 | 运行期间按需创建(fork、pthread_create);与之相对的是初始创建。 |
| creación explícita | 显式创建 | p.19 | 直接调用创建函数或 new 一个线程对象,代码里看得见「创建」这个动作。 |
| Creación inicial | 初始创建 | p.10 | 程序启动时就存在的那组进程/线程,静态确定,不靠运行中再创建。 |
| creada | 已创建 | p.34 | 生命周期第二站:对象已存在但还没进入就绪队列;属性已在此时定好。 |
| D | |||
| descriptores de fichero | 文件描述符 | p.12 | fork 后父子共享同一批打开文件,文件偏移也共享;这是易考的继承点。 |
| detached | 分离 | p.49 | 退出即自动回收,不能 join;常量是 PTHREAD_CREATE_DETACHED。 |
| Dirección de la pila | 栈地址 | p.37 | 线程属性之一;需要自己提供栈区时才设置,默认由系统分配。 |
| directorio de trabajo | 工作目录 | p.20 | PCB 记录的进程信息之一;fork 子进程继承父进程的当前目录。 |
| E | |||
| E/S | 输入/输出 | p.40 | 阻塞的两大来源之一;I/O 完成后由 OS 调度器把线程放回 lista。 |
| ejecutable | 可执行 | p.34 | 它是 lista 与 En-ejecución 的合称,不是单一状态。 |
| En-ejecución | 运行中 | p.38 | 真正占用 CPU 的子状态;一个核同一时刻最多一个。 |
| entorno | 环境 | p.12 | 环境(变量表);fork 复制一份,exec 默认原样保留。 |
| Espacio de dirección del usuario | 用户地址空间 | p.26 | p.26 图里线程共享的那一大块;代码、数据、堆都在一起。 |
| espacio de direcciones | 地址空间 | p.4 | 进程私有;同一进程的所有线程共用同一份。 |
| Espacio direcciones | 地址空间 | p.28 | p.28 图标题的简写;图中标出共享区与各线程私有栈。 |
| estado | 终止状态 | p.17 | wait 取回的状态字;用 WIFEXITED / WEXITSTATUS 等宏解析,不能直接当退出码。 |
| Estado Bloqueado | 阻塞状态 | p.40 | 等 E/S 或 mutex/信号量;被唤醒后进 lista,仍要排队等 CPU。 |
| Estado creado | 已创建状态 | p.35 | 刚 create、尚未被调度;detached/joinable、优先级等属性在此确定。 |
| Estado ejecutable | 可执行状态 | p.38 | 含 lista 与 En-ejecución;何时切换取决于调度策略与优先级。 |
| Estado “detached” o “joinable” | 分离 / 可汇合 | p.37 | 线程属性五项之首;决定退出后资源是否需要别人 join 回收。 |
| Explícita | 显式表示 | p.18 | 语言提供专门的 constructor 来描述进程/线程(如 extends Thread)。 |
| F | |||
| finalización | 终止 | p.16 | 终止分正常(exit/return)与异常(信号)两路;父进程都要 wait 收尸。 |
| flujo de control | 控制流 | p.4 | 一条指令执行序列;线程就是进程内部的多条控制流。 |
| H | |||
| heap | 堆 | p.4 | 动态分配区,进程内共享;多线程同时 malloc 需要注意线程安全。 |
| hebra | 线程 | p.1 | 进程内的执行流,共享地址空间、私有栈与寄存器。 |
| hebras | 线程 | p.2 | 复数形式;本课程用 POSIX 的实现,叫 pthreads。 |
| I | |||
| Implícita | 隐式表示 | p.18 | 用普通函数/方法界定线程代码,如今更常见;与「专门的 constructor」相对。 |
| instrucciones máquina | 机器指令 | p.39 | 上下文切换只能发生在两条之间,不能打断一条指令的执行。 |
| interfaces | 接口 | p.31 | POSIX 规定的是接口(API),不是具体实现;厂商各自实现。 |
| interfaz de programación | 编程接口 | p.31 | 即 API;POSIX 就是一组标准化的编程接口,不是某个库的名字。 |
| J | |||
| Jerarquía de procesos | 进程层级 | p.2 | 进程有父子树(p.12);线程之间没有层级,别把两者混用。 |
| Joinable | 可汇合 | p.49 | 默认形态,退出后等别人 pthread_join 回收;无人 join 会残留资源。 |
| L | |||
| La función join | join 函数 | p.47 | 阻塞调用者直到目标线程结束,同时取回退出值;它本身就是一种同步机制。 |
| Las hebras | 线程 | p.23 | p.23 标题:线程在进程内部运行,由 OS 调度。 |
| librerías compartidas | 共享库 | p.20 | 映射进地址空间的 .so;fork 后父子共享代码段,写时复制数据段。 |
| lista | 就绪 | p.38 | 就绪队列,只等 CPU;与「等事件」的 bloqueada 有本质区别。 |
| listo | 就绪 | p.38 | p.38 正文用的形容词形式,与 lista 同义。 |
| load average | 平均负载 | p.21 | top 首行三个数:1、5、15 分钟平均负载,可运行+不可中断进程数。 |
| M | |||
| máximo número | 最大数量 | p.36 | 可创建线程数上限由系统资源决定,不是固定常数。 |
| mecanismo de sincronización | 同步机制 | p.47 | join 是最简单的线程同步;后续还有 mutex、信号量、条件变量。 |
| memoria compartida | 共享内存 | p.20 | 线程间默认共享(p.27 图);进程间要显式申请 shm 段。 |
| multithreading | 多线程 | p.6 | 一个进程内多个执行流;相对多进程更轻,但共享带来同步问题。 |
| N | |||
| No hay jerarquía | 没有层级关系 | p.36 | 线程之间无父子、无依赖;joinable 只是「需被回收」而非从属关系。 |
| no-existe | 不存在 | p.34 | 生命周期起点;创建动作把 no-existe 变成 creada。 |
| núcleos | 核心 | p.10 | 核数决定真正并行度;线程数超过核数就只能分时复用。 |
| O | |||
| operación asíncrona | 异步操作 | p.8 | 发起后不阻塞等待结果,完成时再通知或回调;与同步调用相对。 |
| P | |||
| Parámetros de planificación | 调度参数 | p.37 | 如优先级数值,必须与调度策略(policy)配合设置才有意义。 |
| Paso de mensajes | 消息传递 | p.14 | 通过管道等把数据交给新进程,是初始化的两条路线之一(另一条是参数传递)。 |
| Paso de parámetros | 参数传递 | p.14 | pthread_create 第 4 参数只能是一个 void*,多参数要打包成 struct 传地址。 |
| patrón | 模式 | p.14 | 固定套路,如 fork+exec、生产者-消费者;答题时先点名模式再展开。 |
| PCB | 进程控制块 | p.20 | OS 记录进程全部信息的结构(p.20 列了 11 组信息),进程的「档案袋」。 |
| PID | 进程号 | p.5 | 进程唯一标识;fork 后子进程 PID 不同,getpid() 可取。 |
| pila | 栈 | p.4 | 线程私有,存局部变量与调用链;大小可通过属性设置。 |
| planificadas | 调度 | p.23 | 被操作系统选中执行;创建不等于被调度。 |
| planificador | 调度器 | p.18 | 决定下一个谁上 CPU;创建完是否立刻运行由它说了算,不是 create 决定。 |
| política | 调度策略 | p.24 | 如 FIFO、轮转;与优先级参数成对出现,写进线程私有属性。 |
| Políticas de planificación | 调度策略 | p.37 | 线程属性五项之一;实时系统里这一项尤其关键。 |
| pool | 线程池 | p.19 | 预先创建一批线程反复复用,避免频繁 create 的开销(隐式表示常用)。 |
| POSIX | POSIX 标准 | p.31 | 一组 IEEE 标准;基础接口 POSIX.1(1988),最新 POSIX.1-2024 无重大变化。 |
| POSIX threads | POSIX 线程 | p.33 | 即 pthreads;线程部分最初在 POSIX.1c,实时扩展在 POSIX.1b。 |
| primitivas de sincronización | 同步原语 | p.40 | mutex、信号量、条件变量;阻塞的第二大来源,唤醒要别的线程动手。 |
| prioridad | 优先级 | p.24 | 高优先级线程一旦就绪,可能把当前线程赶回 lista(p.39)。 |
| proceso | 进程 | p.1 | 运行中的程序实例,拥有独立地址空间与资源;并发的基本抽象之一。 |
| proceso hijo | 子进程 | p.5 | fork 的产物,继承父进程资源但有自己的 PID,退出后要靠父进程 wait。 |
| proceso ligero | 轻量级进程 | p.8 | 线程的另一种叫法;切换开销比进程小,因为不换地址空间。 |
| procesos | 进程 | p.1 | 复数;另一种并发抽象是线程(hebras)。 |
| Process ID | 进程号 | p.20 | PCB 中的 PID 字段;ps/top 第一列就是它。 |
| programación concurrente | 并发编程 | p.53 | 需要进程/线程等新抽象;本课程路线是 POSIX + C + 线程。 |
| PTHREAD_CREATE_DETACHED | 分离态 | p.49 | 传给 pthread_attr_setdetachstate 的常量;设了它就不能再 join。 |
| PTHREAD_CREATE_JOINABLE | 可汇合态 | p.49 | 默认可 join;p.50 示例显式设置它,再在 p.51 逐个 join。 |
| pthreads | pthreads 线程库 | p.33 | POSIX 线程实现;C11 有了标准线程后,C 里它仍是主流。 |
| Puntero a pila | 栈指针 | p.26 | ESP/RSP 之类,指向当前栈顶;线程私有,切换时必须保存。 |
| R | |||
| registro de activación | 活动记录 | p.28 | 即栈帧,每次函数调用生成;p.28 图中可见其在栈上的位置。 |
| Registros | 寄存器 | p.4 | CPU 寄存器组;上下文切换必须全部保存,少存一个都可能算错。 |
| relación padre/hijo | 父子关系 | p.12 | 由 fork 建立;父进程负责 wait 回收子进程的退出状态。 |
| representación explícita | 显式表示 | p.19 | Java 的 class X extends Thread 就是代表,语言有专门构造。 |
| representación implícita | 隐式表示 | p.19 | 用 lambda/函数交给 pool.submit,代码里没有线程类。 |
| running | 运行中 | p.21 | top 的 R 状态;与讲义里的 En-ejecución 对应。 |
| S | |||
| semáforos | 信号量 | p.20 | 同步原语,P/V 操作;也是线程阻塞的常见原因。 |
| señales | 信号 | p.20 | 进程收到的异步通知(如 SIGKILL);PCB 中记录待处理/被阻塞信号。 |
| sincronización | 同步 | p.32 | 协调多个执行流的顺序;POSIX 覆盖领域之一。 |
| sincronización con su finalización | 终止同步 | p.53 | 用 join 等线程结束,p.53 三件套之一。 |
| sistemas de tiempo real | 实时系统 | p.10 | 有截止期约束,倾向静态/初始创建,避免运行中创建带来的不确定性。 |
| sobrecarga | 开销 | p.30 | 创建线程、上下文切换都有成本;线程比进程轻,但不是零成本。 |
| T | |||
| Tamaño de la pila | 栈大小 | p.37 | 线程属性之一;线程多时栈总和会吃掉地址空间。 |
| Tarea | 任务 | p.8 | Ada 的 task、Python 的 asyncio task;并发抽象的第三种叫法。 |
| tareas | 任务 | p.3 | p.3 列出的概念之一;答题时先区分进程/线程/任务三种抽象。 |
| task type | 任务类型 | p.9 | Ada 中定义任务的类型,可声明多个 task 实例。 |
| terminación | 终止 | p.12 | 进程/线程的结束;父进程(或 join)负责回收。 |
| terminación con éxito | 正常终止 | p.16 | exit(0) 或 main 返回 0;wait 后 WEXITSTATUS 为 0。 |
| terminación con fallo | 异常终止 | p.16 | exit(非 0) 或被信号杀死;后者 WIFEXITED 为假,不能读退出码。 |
| terminada | 已终止 | p.34 | 生命周期终点;joinable 线程此时等 join 回收,detached 自动回收。 |
| tiempo compartido | 分时系统 | p.39 | 时间片轮转;时间片用完就回 lista,这是最常见的让出原因。 |
| tiempo real | 实时 | p.33 | 实时扩展最初在 POSIX.1b;与「分时」相对,强调截止期。 |
| tipo de planificación | 调度类型 | p.39 | 决定线程何时从运行退回 lista 的依据。 |
| tipo de proceso/hebra | 进程/线程类型 | p.14 | 创建时需要指定的类型信息,影响后续资源与调度。 |
| V | |||
| variables condición | 条件变量 | p.40 | 与 mutex 配合,在条件不满足时阻塞、被 signal/broadcast 唤醒。 |
| Variables de entorno | 环境变量 | p.20 | PCB 记录的信息之一;fork 继承,exec 默认保留。 |
| Z | |||
| zombie | 僵尸进程 | p.21 | 已终止但父进程未 wait 的进程,top 中显示为 Z;父进程回收后消失。 |
数量速记卡(考卷里的「列举 N 项」)
口诀:一核一线程 · 二因二态二法二模 · 三规范 · 四参数 · 五态五属性五终止 · 十一组 PCB。下表「数量」列就是题干里的 N,右侧页码点回原页。
| 数量 | 原文关键词 | 中文 | 性质归类 | 页 |
|---|---|---|---|---|
| 1 | como máximo una hebra puede estar en ejecución en cada procesador | 每个处理器最多一个线程在运行 | 调度事实(单核或线程多于核时成立) | p.38 |
| 2 | Bloqueos por E/S / por uso de primitivas de sincronización | 阻塞的两个成因:I/O、同步原语 | 状态迁移原因 | p.40 |
| 2 | joinable o detached | 可 join / 已分离两种线程属性 | 线程属性(决定能否回收) | p.49 |
| 2 | Creación inicial / Creación dinámica | 程序启动即建 / 运行中按需建 | 创建时机模型 | p.10 |
| 2 | creación explícita / representación implícita | 显式创建 / 隐式(交给池) | 创建方式 | p.19 |
| 3 | POSIX.1c · POSIX.1b · C11 | 线程定义来源与实时扩展、C 语言标准 | 规范来源 | p.33 |
| 4 | pthread_create 的四个形参 | 线程句柄 / 属性 / 入口函数 / 参数 | 函数签名(背原型) | p.35 |
| 5 | no-existe · creada · ejecutable · bloqueada · terminada | 不存在 / 已创建 / 可执行 / 阻塞 / 已终止 | 完整生命周期状态机 | p.34 |
| 5 | detached/joinable · políticas · parámetros · tamaño de pila · dirección de pila | 五项可设属性 | 属性清单 | p.37 |
| 5 | return · pthread_exit · pthread_cancel · exit() · main 未调 pthread_exit | 线程终止的五条途径 | 终止方式 | p.41 |
| 11 | Información asociada al proceso en el PCB | PCB 的 11 组信息 | 进程档案字段 | p.20 |
最容易混的 14 组概念
每张卡只回答一件事:差别落在哪一个词上。答题时先把那个词说出来,再展开。